在 AI 工厂中,高带宽内存(HBM)是最快、最昂贵、竞争最激烈的内存层级。每一个字节,无论是花在冗余的权重副本上、空闲会话的 KV 缓存上,还是重新计算的前缀上,都是没有用于生成 token 的字节。问题不再是 GPU 拥有多少内存,而是每个字节能交付多少有用的工作。
下图 1 中的代际数据说明了原因。从 GB300 到 NVIDIA Rubin,容量保持在 288 GB,而带宽提升至 19.2 TB/s。
每兆瓦的智能体吞吐量增长要快得多。在 SemiAnalysis AgentX 上(该基准测试回放录制的编码智能体会话,包含真实的工具调用间隔和不断增长的上下文),NVIDIA Vera Rubin NVL72 在每用户每秒 160 token 的条件下,每兆瓦吞吐量最高可达 GB300 NVL72 的 30 倍。
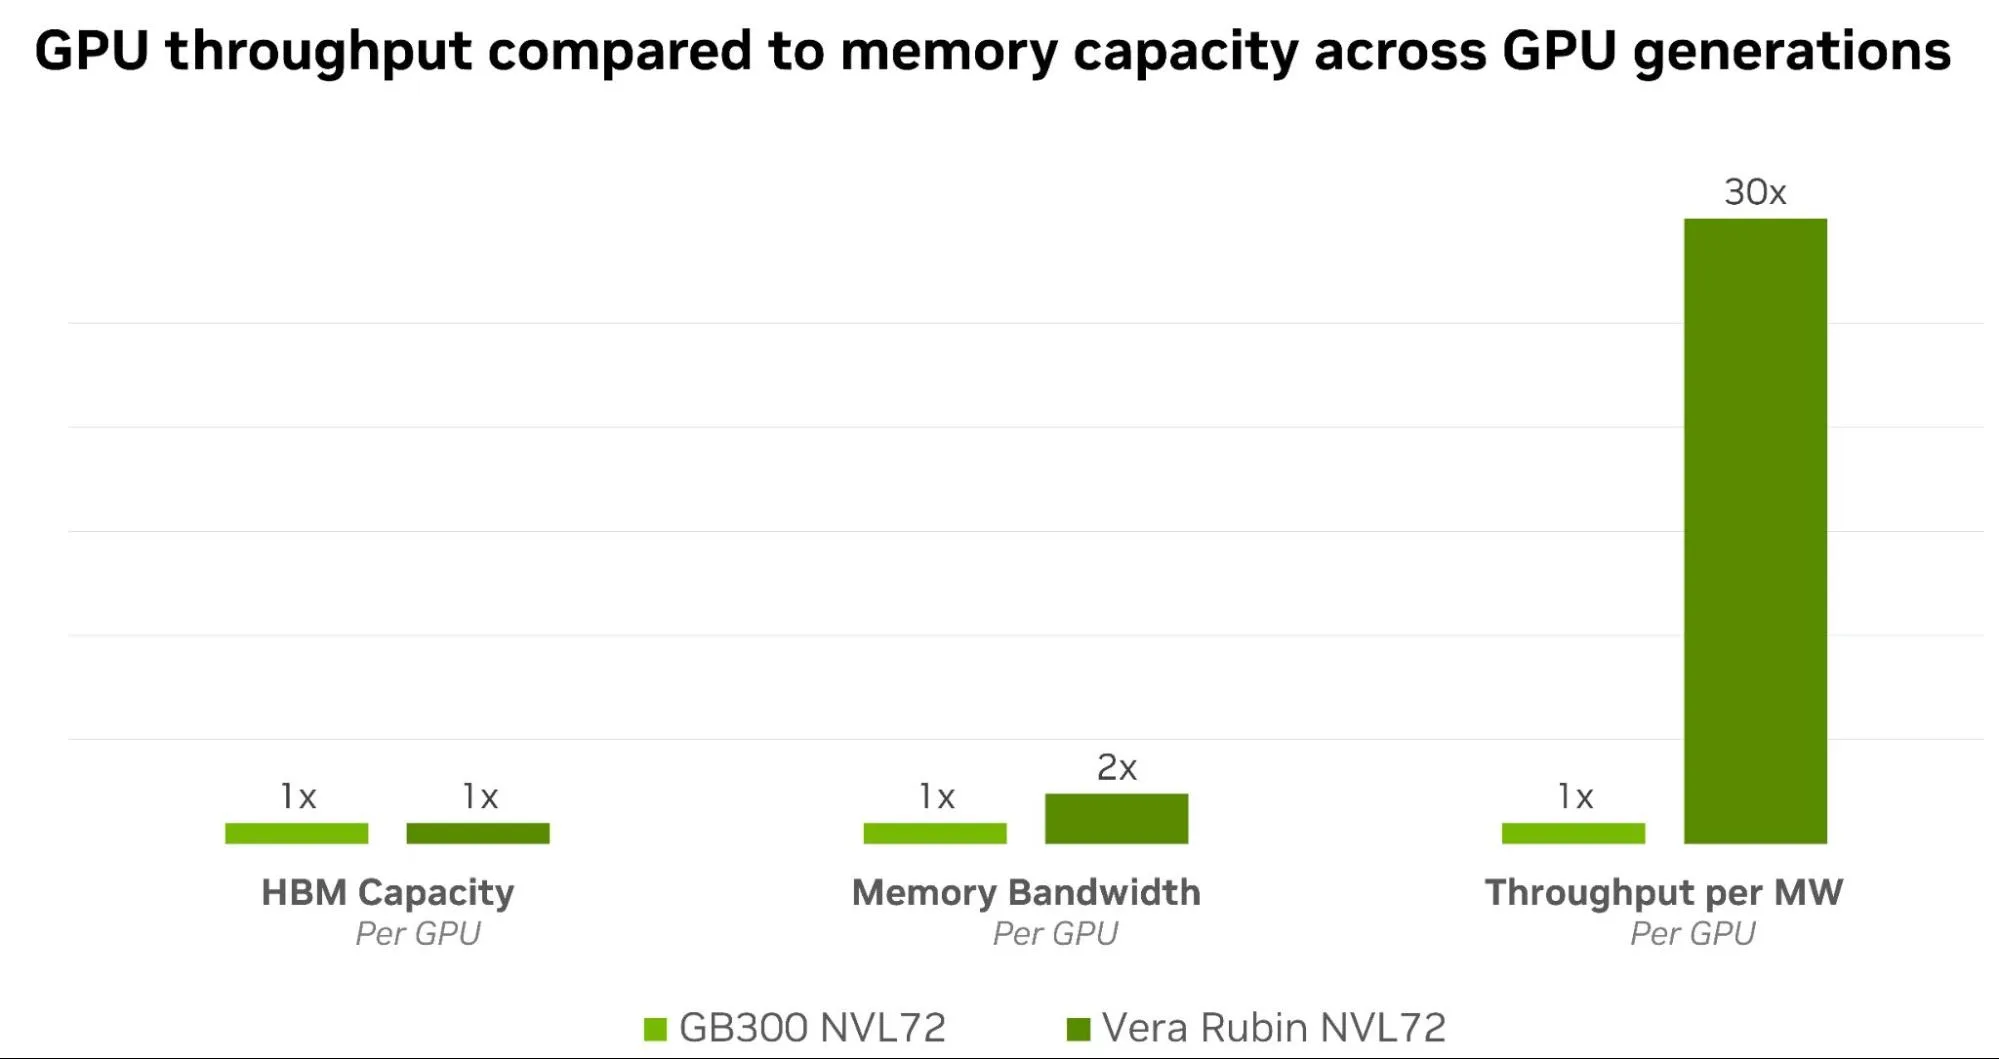
仅凭容量无法解释在每 GPU 同样 288 GB 的情况下实现 30 倍增益。差异在于每个字节能交付多少有用的工作。
NVIDIA 将此视为一个协同设计问题,涵盖 GPU 架构、纵向扩展互连、服务软件、CPU 和存储。本文探讨协同设计最大化每字节内存价值的五种方式,从编码单个权重的比特,到在智能体轮次和节点之间保存并复用上下文的共享存储。
1. NVFP4 如何用更少的字节存储更多智能?
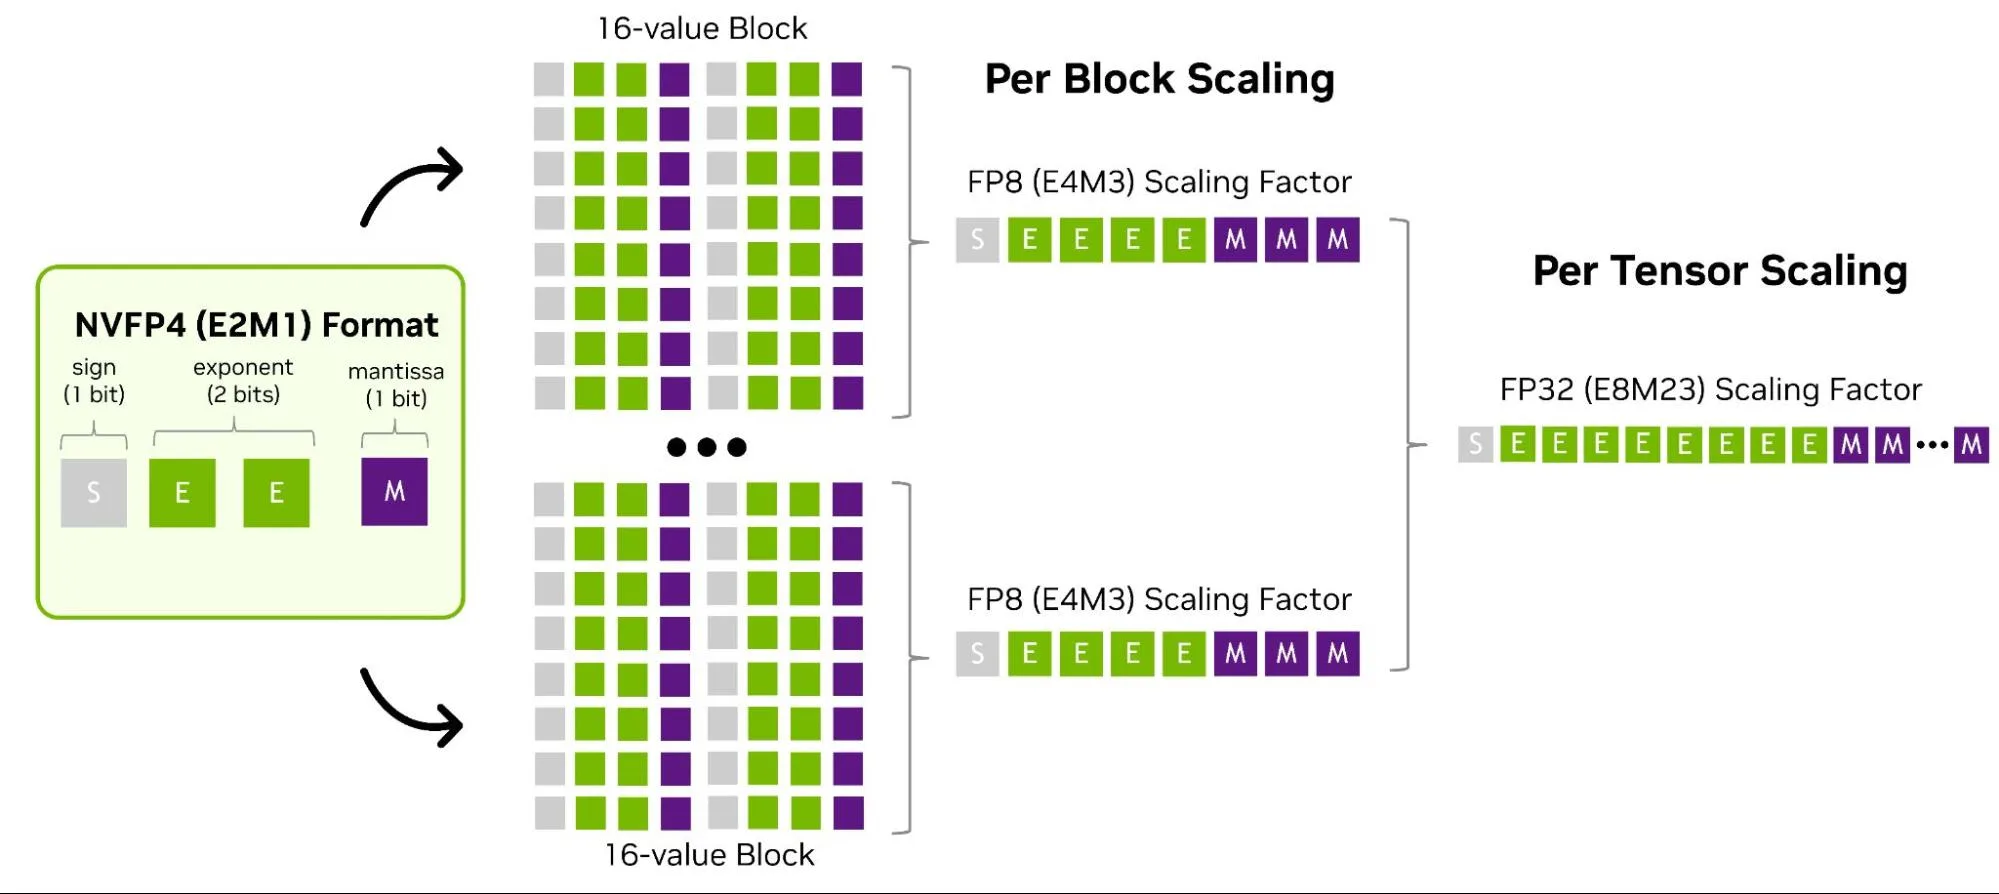
提升字节价值最直接的方法是让每个值更小,同时不丢失其所编码的信息。NVFP4 通过 4 位 E2M1 元素和两级缩放实现这一点:每 16 个值组成的微块共享一个 FP8(E4M3)缩放因子,顶层还有一个按张量的 FP32 缩放因子。由此得到的格式足够小,可以释放大量 HBM,同时粒度足够细,能在朴素 4 位格式无法胜任的地方保持精度。
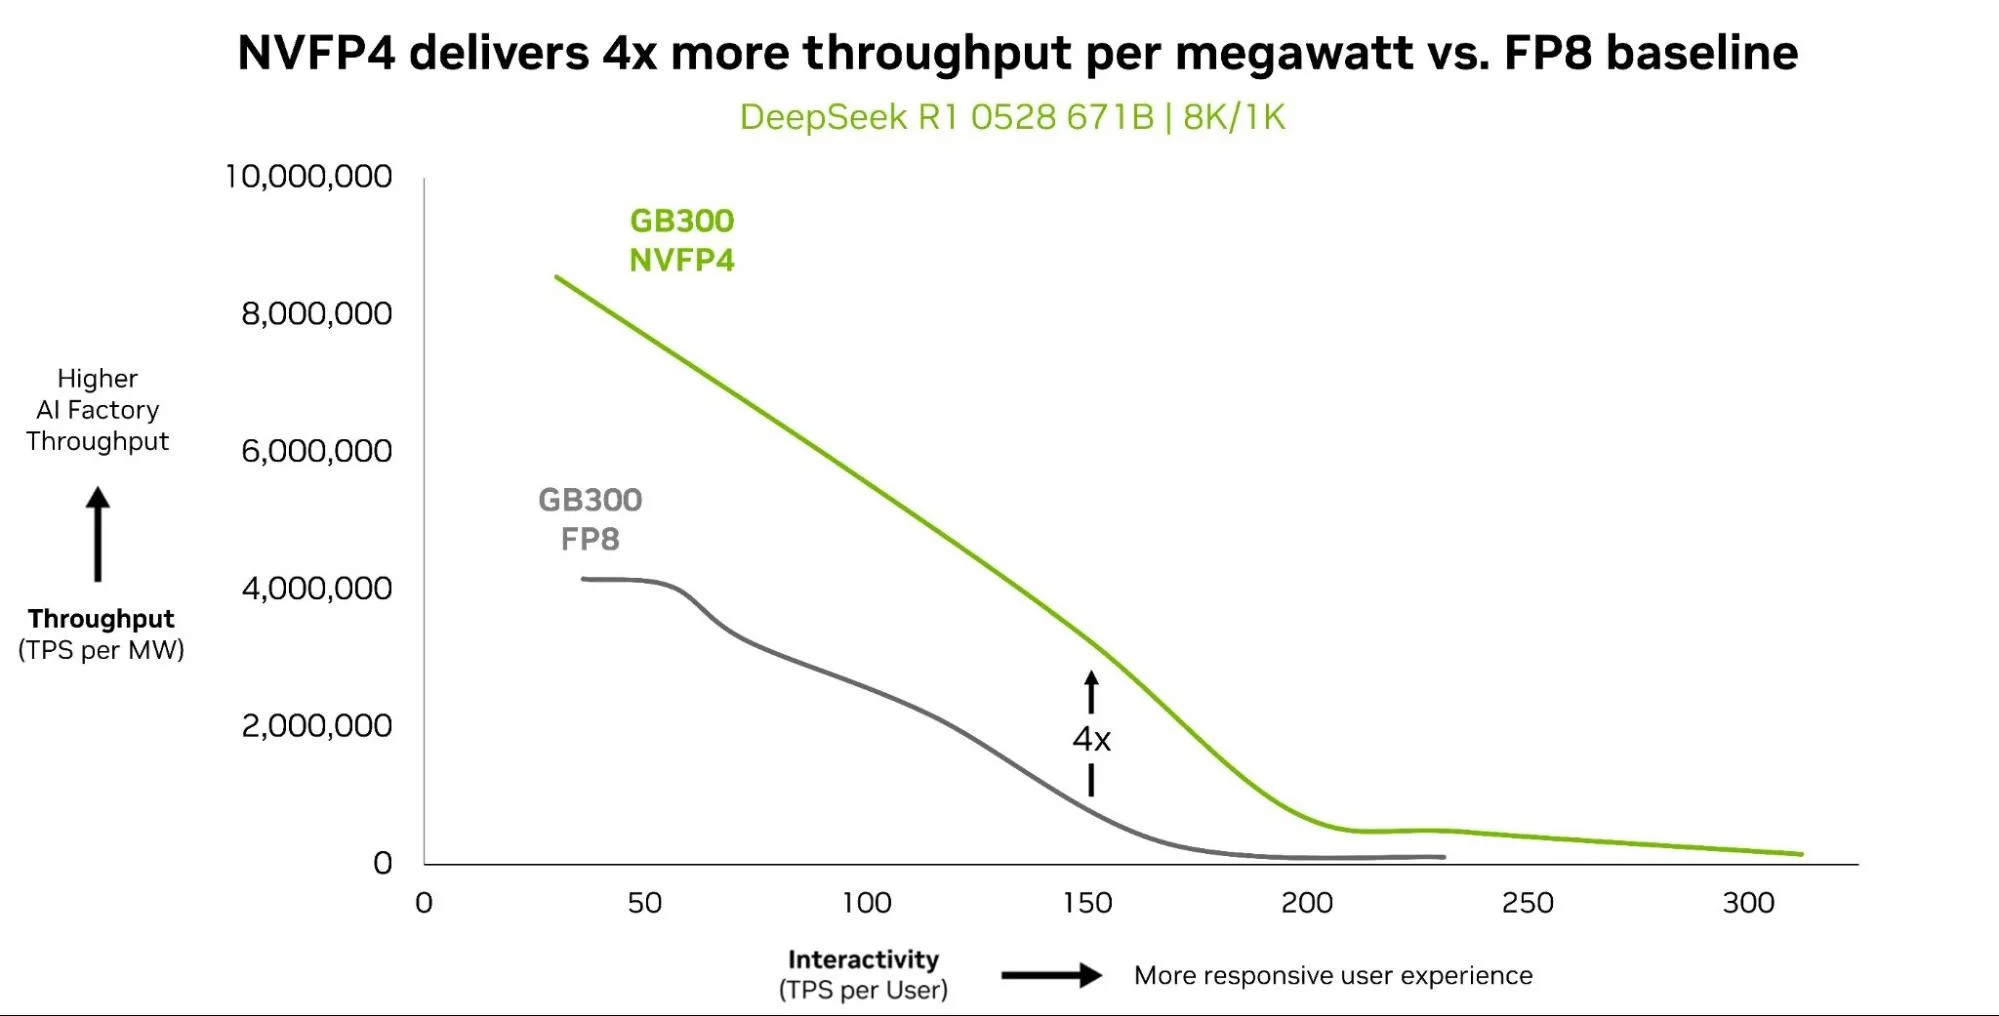
应用于权重时,NVFP4 相对于 FP16 将模型占用空间减少约 3.5 倍,相对于 FP8 减少 1.8 倍,从而为智能体推理最需要的东西释放内存:更大的 KV 缓存容量、更大的批次和更高的并发度。NVFP4 已成为具有严格精度要求的开放智能体基准测试的默认精度,包括 AA-AgentPerf、SemiAnalysis AgentX 和 MLPerf Endpoints。在这些基准测试和领先的混合专家(MoE)架构上,它在相同交互性下可提供 FP8 基线最高 4 倍的吞吐量(下图 3)。
同样的原则也适用于 KV 缓存本身。NVFP4 KV 缓存与 FP8 相比将缓存占用减少最高 50%,因此约 2 倍的上下文可以常驻设备。更少的逐出意味着预填充期间更高的缓存命中率,而更小的缓存意味着解码期间消耗更少的带宽。
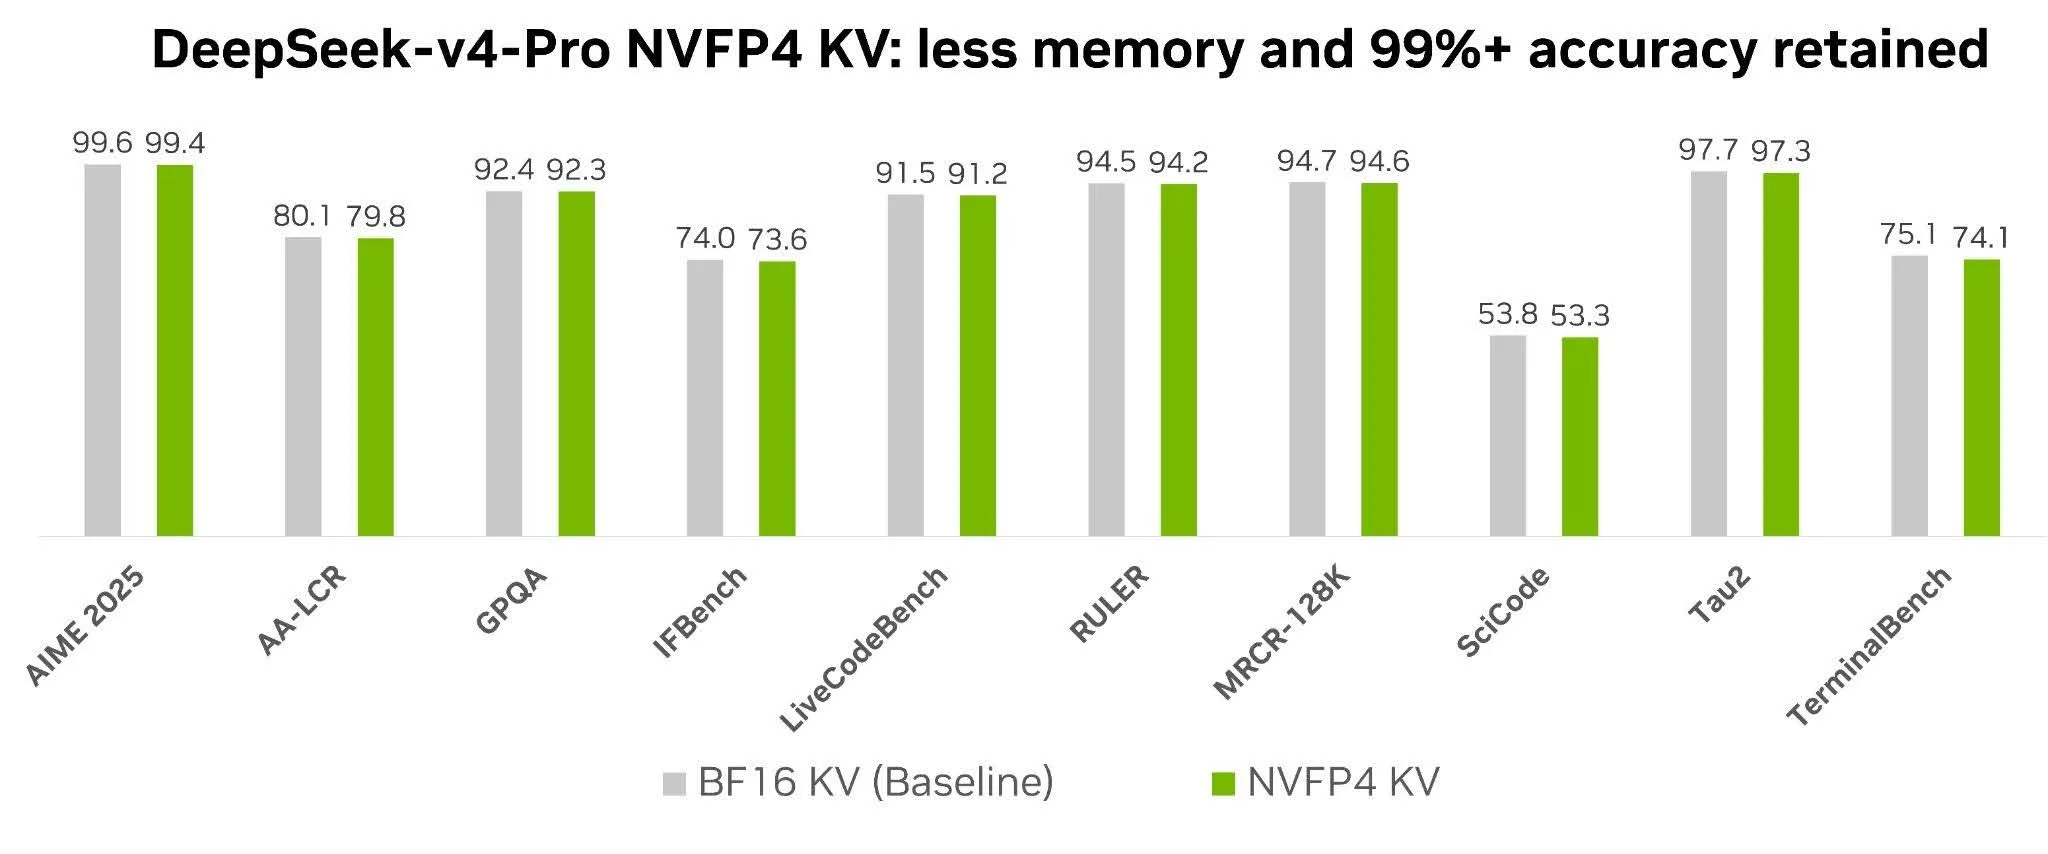
NVFP4 缩小了字节。下一个问题是这些字节存放在哪里,以及 AI 工厂需要保留多少份副本。
2. NVLink 纵向扩展域如何将 72 个 GPU 变成一个内存池?
MoE 模型每个 token 只激活一部分参数,但每个专家的权重仍然必须存放在 HBM 的某个地方。当专家被打包到少量 GPU 上时,每个 GPU 的大部分内存都花在权重上,每个解码步骤都要为 MoE GroupGEMM 付出沉重的权重加载成本。字节虽然常驻,但并没有高效工作。
NVIDIA TensorRT-LLM 中的宽专家并行(Wide-EP)通过将专家分散到八个或更多 GPU 上来改变这一比例。在 EP64 下运行 DeepSeek-R1 时,每个 GPU 每层持有四个专家,即 58 个 MoE 层中共 232 个专家块,而完整模型共有 14,848 个。每个 GPU 更少的专家权重意味着:
- 容量:每个 GPU 有更多 HBM 留给 KV 缓存、更大的批次和更高的并发度。
- 算术强度:GroupGEMM 内核在更多 token 上复用每个加载的权重,提高每字节的 FLOPs。
- 均衡:专家并行负载均衡器(EPLB)在前向传递之间重新分配热专家和冷专家,因此不会出现某个 GPU 内存过度占用而另一个空闲的情况。
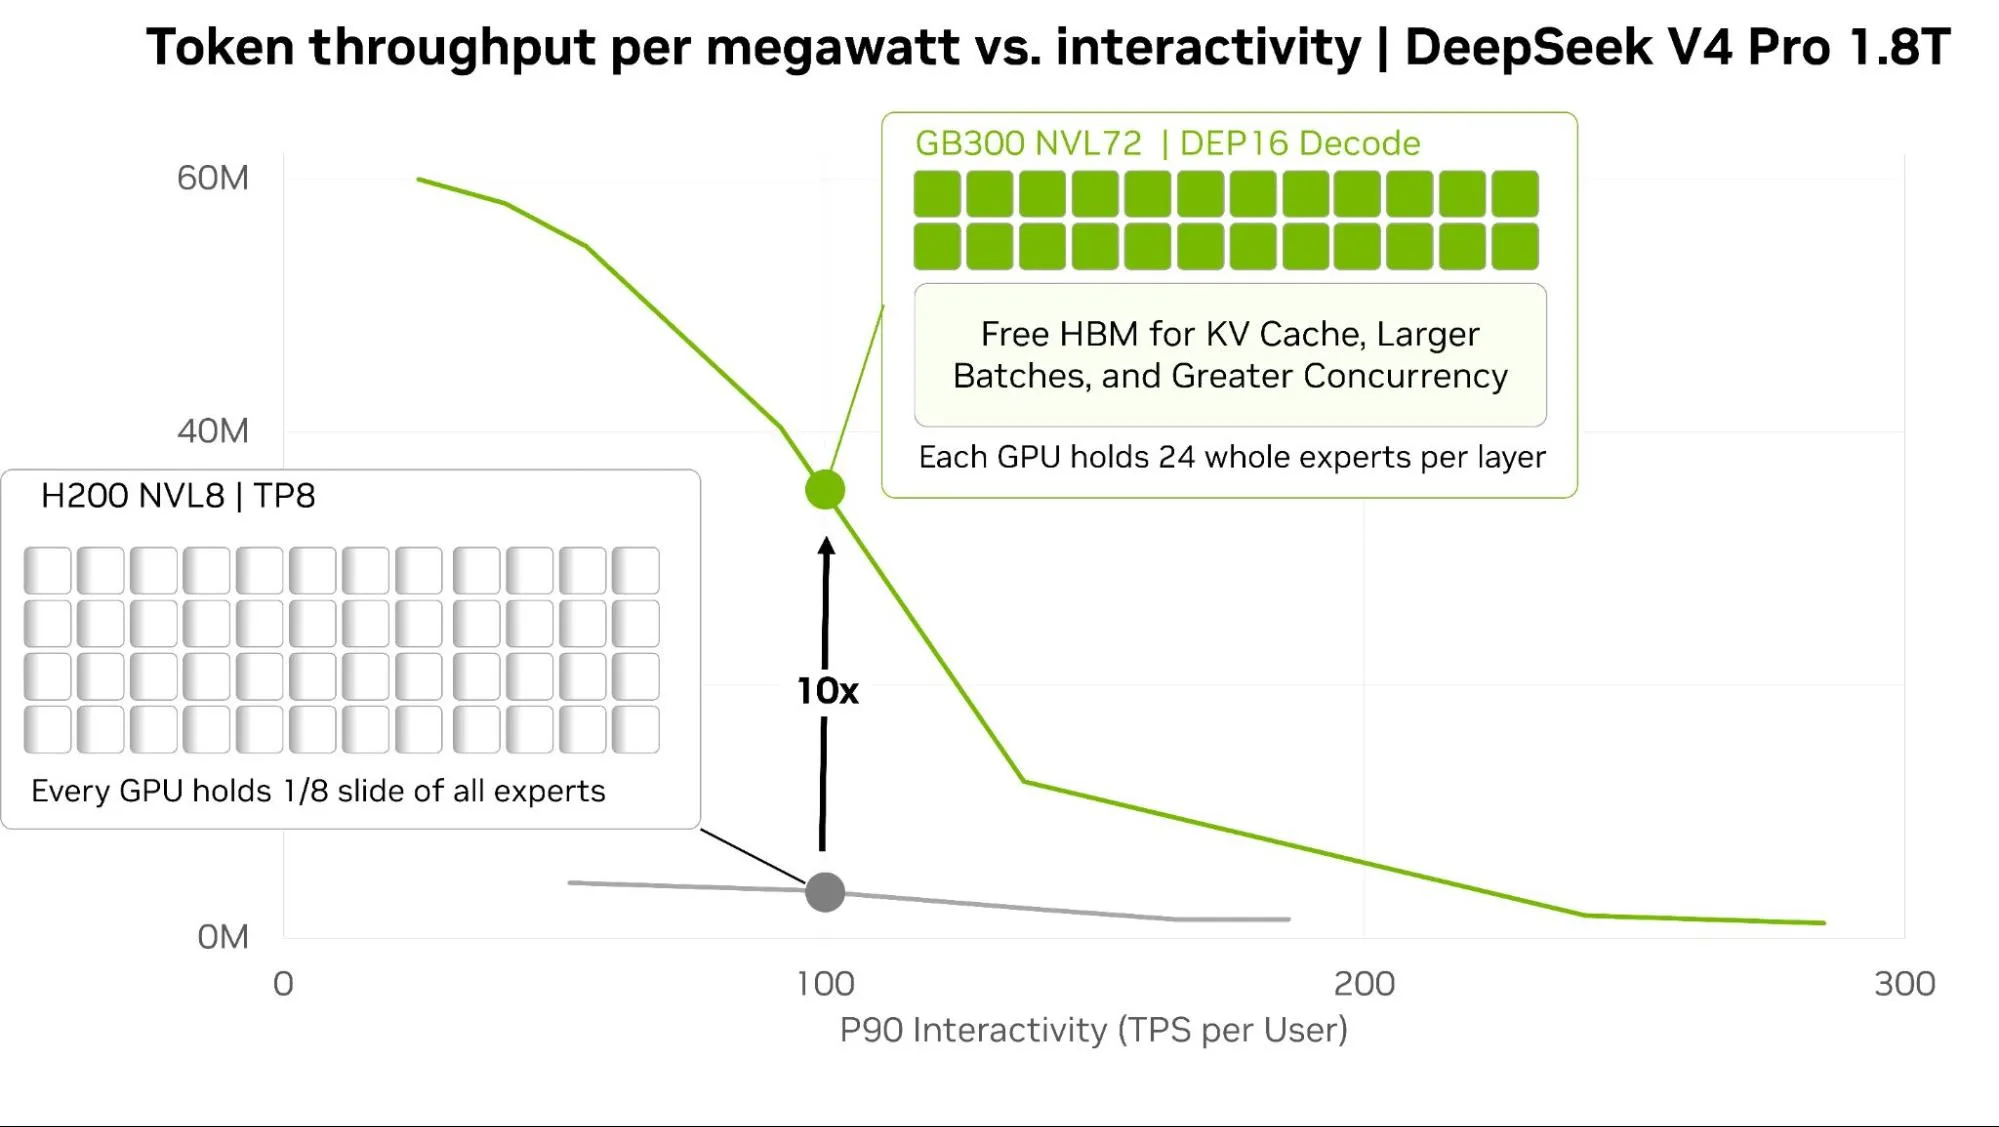
这之所以可行,是因为纵向扩展域使远程字节几乎和本地字节一样有用。每个 MoE 层都会触发全对全分发和合并流量,如果没有高带宽网络结构,这些集合通信会抵消收益。在 GB200 NVL72 上,130 TB/s 的聚合 NVLink 带宽吸收了这些流量,在每用户每秒 100 token 时,大 EP(EP32)每 GPU 每秒输出的 token 数比小 EP(EP8)最高多 1.8 倍。
Vera Rubin NVL72 延续了相同的设计点。每个 Rubin GPU 提供高达 288 GB 的 HBM4 和 3.0 TB/s 的 NVLink 6 带宽,整个机架约提供 20.7 TB 的 HBM4。Rubin 还新增了内联内存张量加速器(TMA)描述符更新,使一个共享描述符能以通用布局服务每个专家,从而减少随专家数量增长而增加的元数据开销。
宽 EP 决定了权重字节存放在哪里。下一个杠杆决定 KV 缓存字节一旦计算完成,是否还会被再次计算。
3. NVIDIA Dynamo 如何让每个缓存字节都发挥作用?
键值(KV)缓存存储先前已处理 token 的中间注意力计算结果,使模型可以复用这些结果,而不必重新计算。这种推理状态是短暂的,可以在需要时被逐出并重新计算,但 KV 缓存只有在被复用时才有价值。智能体工作负载充满复用机会:系统提示、工具模式、共享文档,以及多步任务不断增长的历史记录。但是,如果请求落到不持有其前缀的 GPU 上,或者该前缀刚刚被逐出,系统就要再次为预填充付出代价。这些字节曾经存在,只是位置不对。
NVIDIA Dynamo 是弥合这一差距的分布式服务层。它将 KV 缓存视为整个集群范围的资源,而不是每个 GPU 的副作用,并通过三项协同设计的能力实现这一点:
- KV 感知路由: Dynamo 路由器跟踪 KV 块所在位置,并在放置请求时同时考虑缓存前缀重叠和工作节点负载。它在现有上下文与将工作发送到已使用 GPU 的成本之间进行平衡,将潜在的重计算转化为缓存命中。
- 分离式服务: 预填充和解码在独立的 GPU 池上运行,每个池根据自身的计算和内存特征进行规模配置。解码 GPU 可以将 HBM 专用于 KV 缓存和批大小,而不必为突发预填充预留余量。
- KV 缓存运行器(KVCR): 它跟踪每个块在已配置的 GPU、固定 CPU 和存储层级(包括本地 SSD 和挂载的网络文件系统)中的位置。保存在 HBM 之外的前缀可以在后续请求需要时恢复,使有用的上下文在 GPU 逐出后仍能存活,并继续节省预填充工作。KVCR 使用 NVIDIA Inference Xfer Library(NIXL) 作为其存储传输路径,使缓存块能够在 GPU 处理其他工作时移动。KVCR 还支持分布式复用,路由器提供的提示可帮助选定的工作节点从对等节点检索缓存上下文,同时推理引擎保留对 GPU 内存和本地主机卸载的控制。额外的 KVCR-Guard 功能可在引擎故障期间保留已提交的、由 KVCR 管理的主机内存缓存,只要保护服务和主机仍然可用。
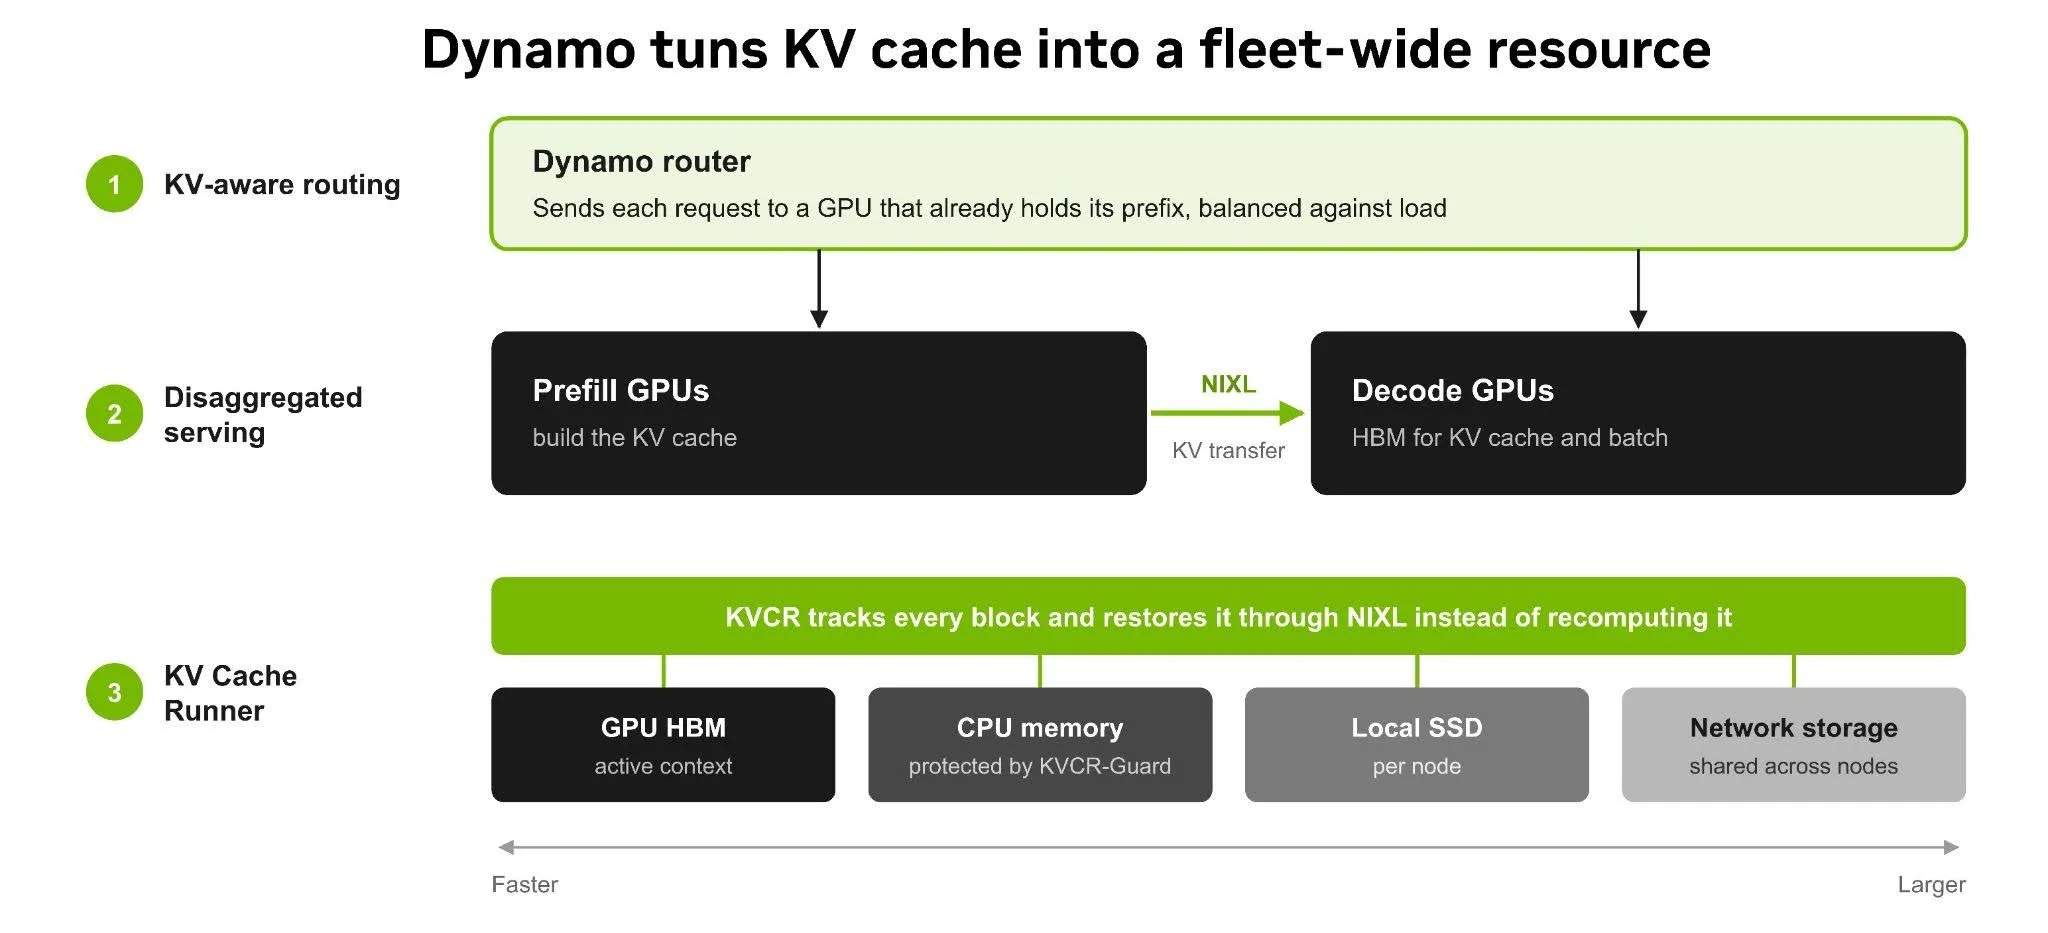
Dynamo 的 KV 缓存卸载依赖于快速检索:当加载前缀比重复预填充更快时,将前缀保存在 HBM 之外才能节省时间。NIXL 将这条卸载路径连接到外部存储系统。在各自的验证测试中,存储厂商 VAST Data 和 WEKA 分别展示了使用 GPUDirect Storage 向单个 H100 GPU 提供 35 GB/s 的带宽,以及通过自定义 NIXL 插件在八个 H100 GPU 上实现高达 270 GB/s 的聚合读取吞吐量。这些测试表明,外部存储可以向受测 GPU 系统提供 KV 缓存,而不会成为传输瓶颈,从而支持超出 HBM 的缓存容量。另一项 VAST 测试展示了响应时间方面的收益:在 DGX H100 系统上使用 vLLM 和 LMCache,加载已存储的 KV 缓存而不是重新计算,缩短了 Qwen3-32B 在 130K token 提示下的首 token 时间。
Dynamo 协调缓存字节的去向以及何时返回。接下来的两个杠杆扩展可用于该上下文的容量,首先从 CPU 内存开始。
4. NVIDIA Vera CPU 如何防止空闲上下文浪费 HBM?
智能体推理并非以一次不间断的过程运行。单个会话在 GPU 模型步骤和 CPU 侧工作之间交替:工具调用、代码执行、检索、数据库查询和沙箱评估。在每个间隙期间,保留在 HBM 中的任何会话 KV 缓存都会占用容量,却不服务于活跃的 token 生成,而其他请求则在竞争相同的字节。
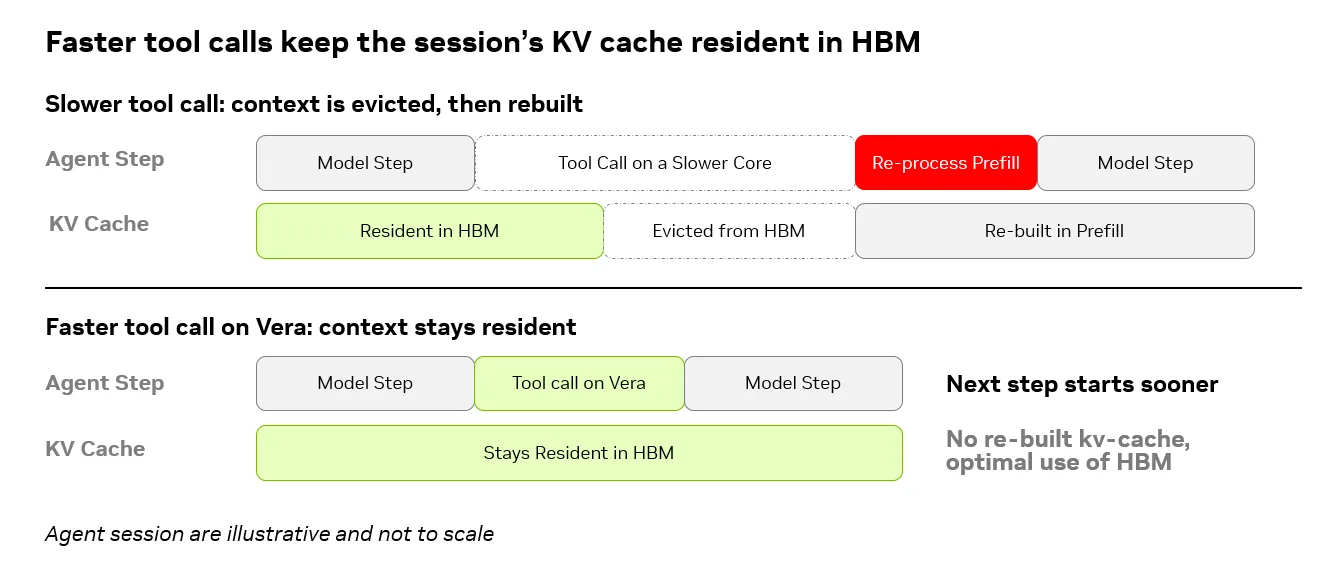
在完全订阅的 AI 工厂中,GPU 不会等待。它在工具调用运行期间接受新请求,间隙越长,原始会话的 KV 缓存被逐出以腾出空间的可能性就越大。当工具返回时,GPU 可能不得不通过完整的预填充重建该上下文,而不是从缓存状态恢复。因此,缓慢的 CPU 会两次消耗 HBM:首先是空闲驻留,然后是重新计算。
NVIDIA Vera CPU 从两个方面解决这个问题:
- 缩短间隙: 88 个 Olympus 核心提供 1.8 倍更快的单线程性能、比 x86 CPU 低 40% 的峰值负载延迟,以及每核心高达 14 GB/s 的内存带宽。更快、更可预测的工具调用缩短了 KV 缓存暴露于逐出压力的窗口。
- 停放上下文的快速场所: 每个 Vera CPU 提供高达 1.5 TB 的 LPDDR5X,是单个 Rubin GPU 的 HBM4 容量的 5 倍以上。NVIDIA NVLink-C2C 以 1.8 TB/s 将其与 Rubin 一致连接,约为 x16 PCIe Gen 6 链路 256 GB/s 的 7 倍。
这些能力共同改变了空闲会话的经济性。Dynamo 的 KV Block Manager 不再将 KV 缓存保留在 HBM 中或将其丢弃,而是可以在工具调用期间将其暂存到 Vera 内存中,并在代理恢复时通过 NVLink-C2C 将其取回。HBM 保持专用于正在积极生成 token 的会话,而暂停的会话则避免了重复支付预填充成本。

Vera 内存是温层,其容量针对将在一个轮次内返回的上下文而设定。对于必须跨轮次、代理和节点存活的上下文,AI 工厂需要一个更大的层级。
5. NVIDIA CMX 如何在整个 pod 内扩展上下文内存?
将每个可复用的 KV 缓存字节保留在 GPU 或主机内存中会限制活动推理的容量,但丢弃它则可能强制重新计算。多轮会话、长周期任务以及共享工作内存的多代理工作流都会生成 KV 缓存,这些缓存之后会再次需要,通常是在几分钟后,且通常位于不同的节点上。更长的上下文窗口和更多的并发会话使 KV 缓存容量需求超出 GPU HBM(下图 9 中的 G1)和主机内存(G2)。传统的层级结构并非为此类数据而设计。本地 SSD(G3)绑定到单个节点,而共享企业存储(G4)是为持久数据而构建的,并带有复制和元数据开销,而临时 KV 缓存并不需要这些。
NVIDIA CMX 上下文内存存储通过新的 G3.5 层级填补了这一空白:以太网连接的闪存,在 pod 级别共享,并专门针对 KV 缓存进行了优化。它基于 NVIDIA STX 参考设计构建,并跨四个层面进行协同设计:
- 存储处理: NVIDIA BlueField-4 STX 存储处理器管理 NVMe SSD、运行存储服务,并卸载 KV 缓存数据移动、数据完整性和加密。其集成的 NVIDIA Vera CPU 加速 CPU 侧存储处理,将用于代理执行的相同 CPU 架构扩展到存储数据路径中。
- 网络: NVIDIA Spectrum-X 以太网在计算节点和 CMX 存储节点之间提供低延迟、高带宽的 RDMA 访问。
- KV 感知服务: NVIDIA DOCA Memos 在 BlueField-4 上提供 KV 感知服务和 I/O 控制,将上下文视为用于放置和共享的一等资源。
- 服务集成: Dynamo 和 NIXL 使 CMX 在整个 pod 内呈现为一个无缝的上下文层级,预暂存上下文并将请求路由到 KV 缓存已存在的位置。
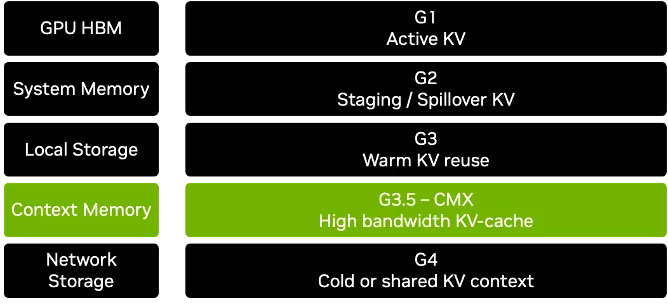
pod 级设计正是提升每个字节价值的关键。在一个节点上计算一次的前缀可以在 pod 内兼容的模型实例之间复用,因此共享文档、工具或工作内存的代理可以避免重复预填充。在整个 pod 内池化上下文存储可减少 KV 缓存重复和跨节点的搁浅容量,从而为推理扩展有效的 GPU 内存。通过将可复用上下文预暂存到 GPU 或主机内存中,CMX 减少了推理停顿,而其针对 KV 缓存优化的存储层级则降低了服务该上下文的功耗开销。这些能力共同帮助 CMX 在长上下文推理中相比传统存储实现高达 5 倍的每秒 token 数和高达 5 倍的能效提升。
这五个杠杆如何协同工作?
每个杠杆消除不同种类的浪费。NVFP4 消除值不需要的位,Wide-EP 消除冗余的权重副本,Dynamo 消除重新计算,Vera 消除工具调用期间的闲置驻留,而 CMX 实现跨节点的 KV 缓存共享和复用。由于这些杠杆被设计为一个内存系统而非独立部件,收益可以叠加:一个 4 位 KV 块在 HBM、Vera 内存和 CMX 中同样节省空间。
结果是一个不仅按容量衡量内存,还按每个字节产生的有用 token 来衡量内存的 AI 工厂。Vera Rubin NVL72 展示了这一点:在相同的每 GPU 288 GB 容量下,每兆瓦吞吐量高达 GB300 NVL72 的 30 倍。随着代理工作负载的增长,每个字节都至关重要。
▶ https://www.youtube.com/watch?v=Ud3gdKrbdgw
视频 1. 在本期 Inside the Architecture 中,我们探讨 NVIDIA 在整个 AI 工厂中优化内存使用的五种方式。了解模型权重、KV 缓存和内存层级如何协同工作,以及为什么效率取决于整个系统。
了解更多
- 深入 NVIDIA Rubin GPU 架构:赋能代理 AI 时代
- 使用 NVFP4 KV 缓存优化长上下文和大批量推理
- 推出 NVFP4,实现高效准确的低精度推理
- 在 NVL72 机架级系统上通过宽专家并行扩展大型 MoE 模型
- 如何使用 NVIDIA Dynamo 减少 KV 缓存瓶颈
- NVIDIA Vera CPU 提升 AI 工厂吞吐量以加速代理工作负载
- 推出由 NVIDIA BlueField-4 驱动的 CMX 上下文内存存储平台,面向 AI 的下一个前沿
- NVIDIA BlueField-4 为代理 AI 工厂提供新型横向扩展网络基础设施
- NVIDIA Vera 存储基准测试:为 AI 原生存储提供更快的加密、压缩、完整性检查和恢复
这项工作得益于 Wei-ming Chen、Shiyang Chen、Chao Ni、Mengdi Wang 和 Jeff Pool 的专业知识和工程贡献。