在集群规模下,GPU 故障是现实。一个 Xid 错误、一个双位 ECC 错误、一个 GPU 从 PCIe 总线上掉线或一个 InfiniBand 链路抖动,都可能使分布式训练任务停滞或使推理副本下线。发现问题通常容易。困难的是从故障到节点恢复健康之间的一切。
今年早些时候,我们宣布推出全自动节点修复功能。我们的 GPU 集群客户和我们的内部推理平台一直在使用此功能来帮助提高工作负载弹性并最大限度地减少停机时间。我们的客户喜欢这个功能,我们想花点时间分解这个系统,解释它如何工作以及我们为什么这样设计。
我们首先实现了“被动健康”检查系统,它持续监视每个节点,无论是在你的 VM 内部还是在其下的主机上。当检查发现故障时,自动修复会推荐最轻量的修复操作,并向你展示推荐背后的支持证据。你可以预先决定,针对每个故障,修复是等待批准还是自行运行。你还可以决定自动修复等待运行中的工作负载完成多长时间。你自己的检测器可以通过在节点上写入单个注解,通过同一管道发起修复。
可用性
现已正式可用:被动健康检查、修复建议、自动修复策略(包括按故障和按节点同意)、等待空闲控制、升级阶梯、安全护栏以及 API 和控制台修复。
预览:基于节点标签的修复契约,允许你自带检测系统,例如 NVSentinel 或自定义控制器。
我们不断添加新的检测信号和修复操作,以确保最大覆盖范围和最短恢复时间。
为什么 NotReady 不够
大多数节点自动修复依赖于单一信号:节点变为 NotReady。无论节点是损坏还是只是短暂不可达,该信号看起来都一样。当存储或网络事件同时影响许多节点时,每个受影响的节点都会降为 NotReady。我们的系统内置了断路器,以防止大规模替换节点。NotReady 也没有说明节点失败的原因,因此没有依据在重启和新机器之间进行选择。
因此自动修复遵循一条规则:没有失败的健康检查作为依据,就不进行节点修复,并且每次修复都携带其支持证据。
管道
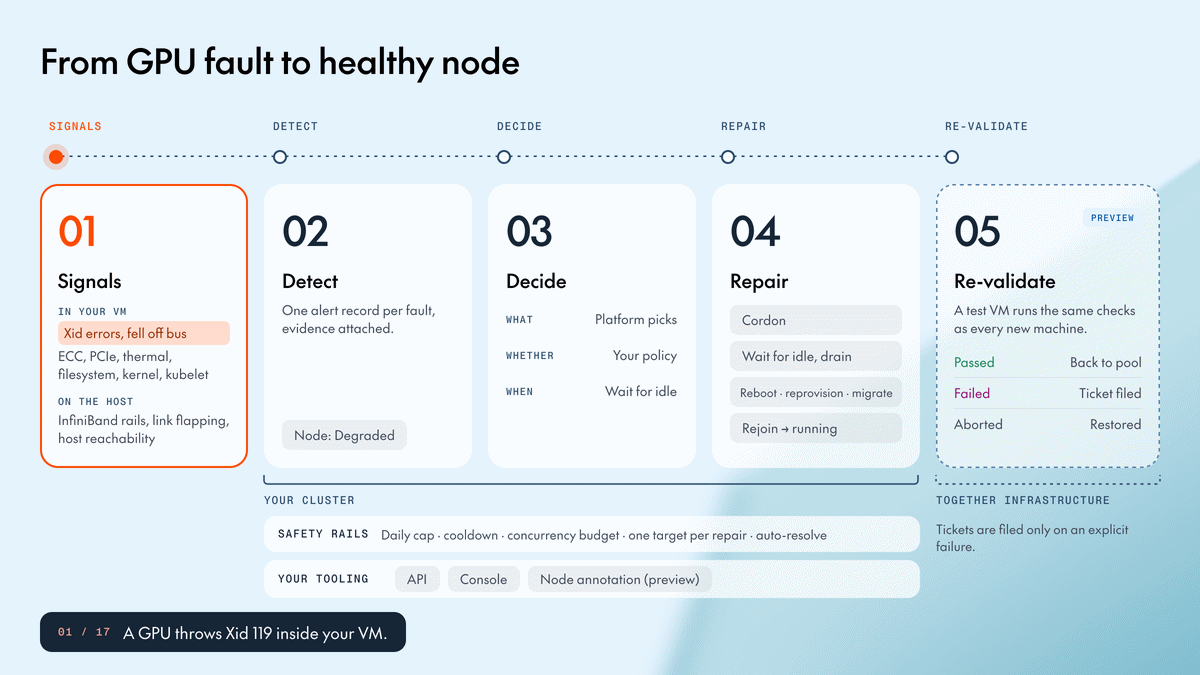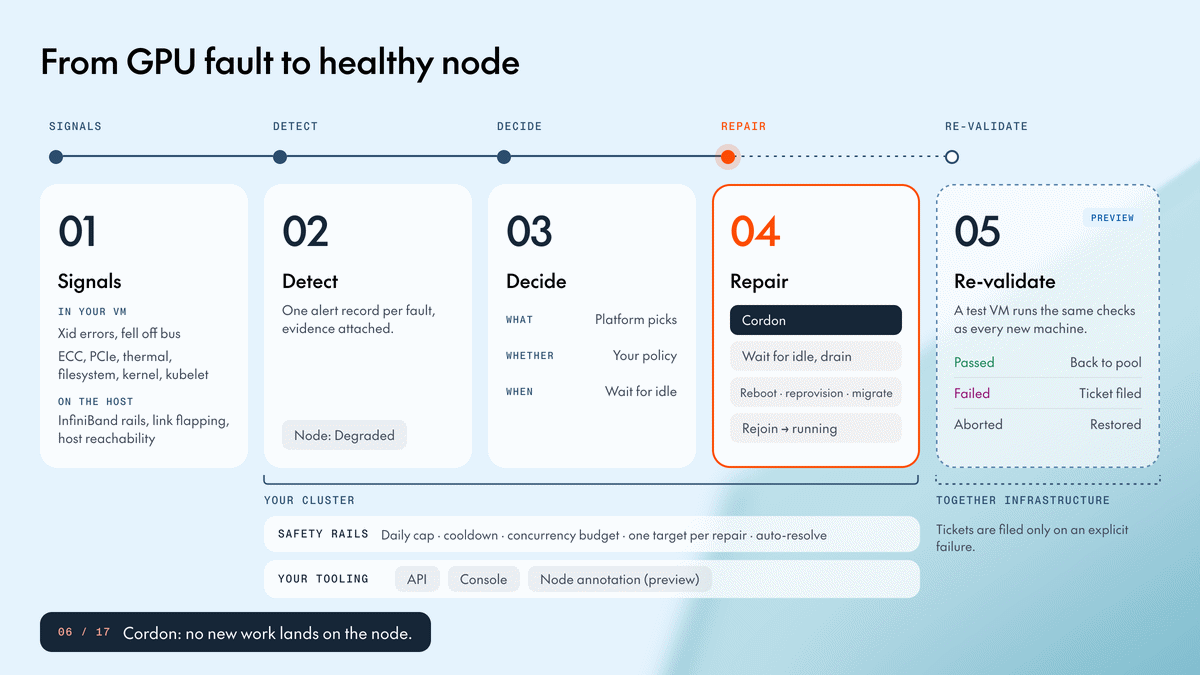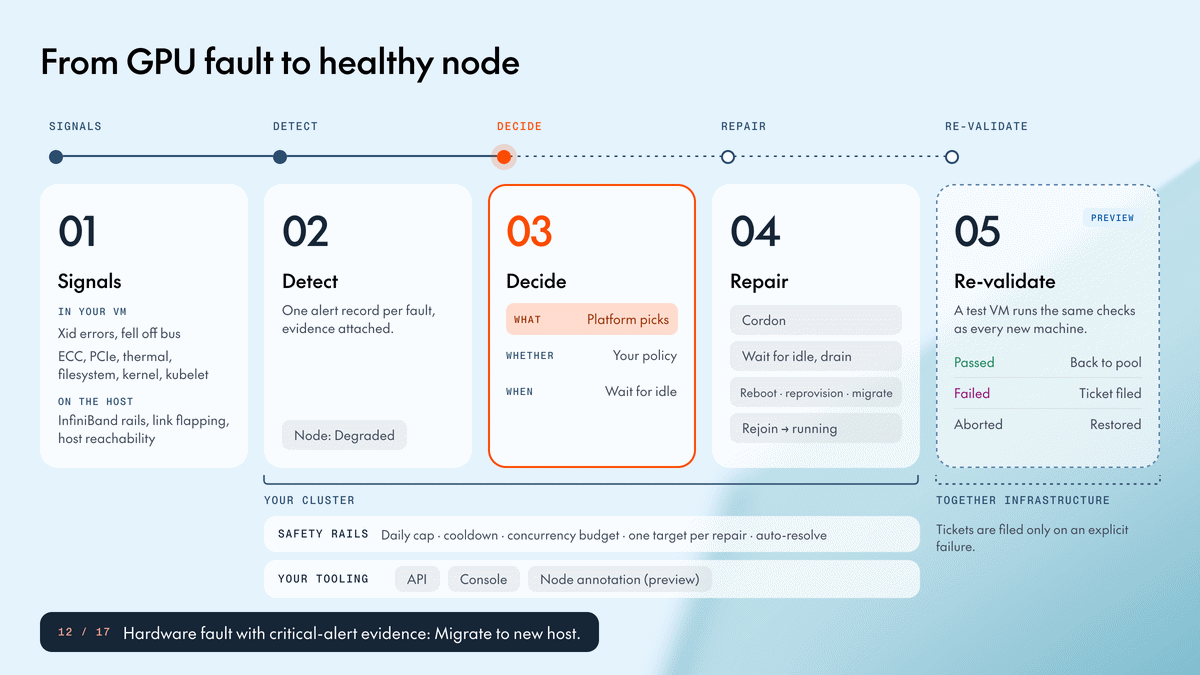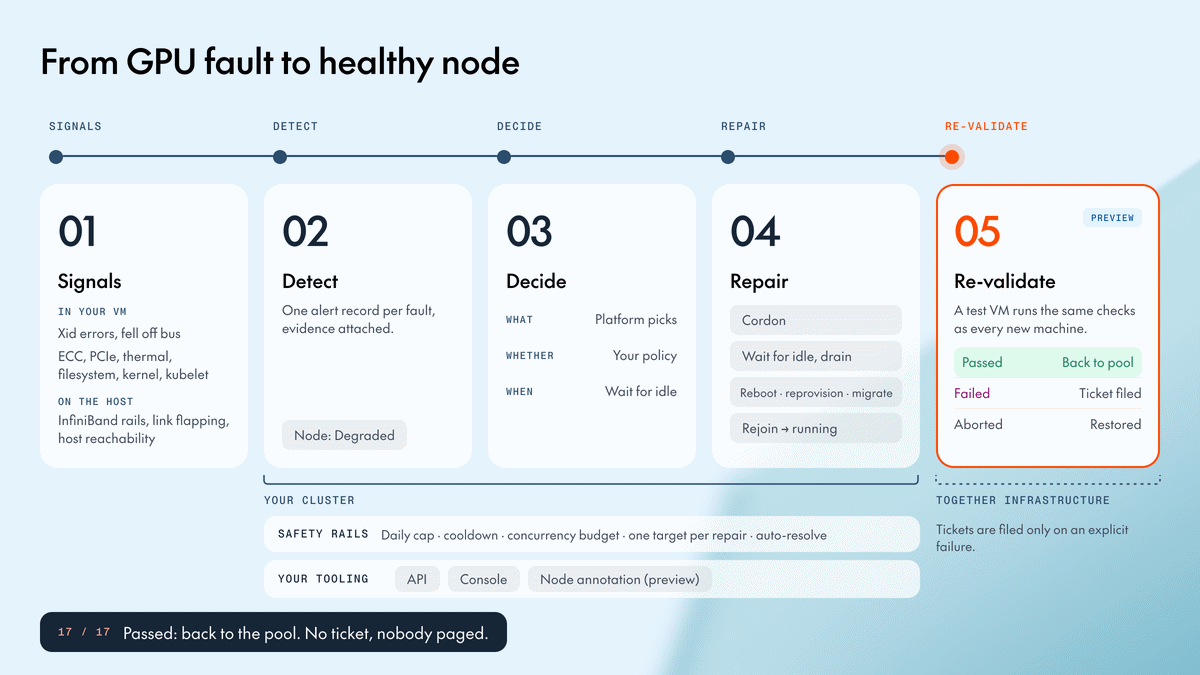
该管道有四个阶段:检测故障、决定是否以及何时采取行动、修复节点以及重新验证机器。前三个阶段针对您的集群运行。第四个阶段在我们这边运行,在您的节点刚刚腾出的物理主机上。来自您自己的检测工具的节点标签请求在决策阶段进入,并获得与我们的请求完全相同的处理。
1. 从管理程序两侧进行检测
Together GPU 集群中的 GPU 直接透传到您的 VM 以实现裸金属性能。这意味着 GPU 故障从 VM 内部可见,而主机和结构故障从主机可见。因此检测在管理程序的两侧运行并汇聚到一个地方。
在您的 VM 内部,导出器监视:
- 内核日志,用于 Xid 错误和 GPU 从 PCIe 总线掉线
- DCGM,用于 ECC 双位错误、行重映射失败、PCIe 重放率和热节流
- 节点问题检测器,用于只读文件系统、XFS 关闭、内核死锁以及重复的 kubelet 或 containerd 重启
在 Slurm 上,导出器报告标记为 DOWN 或 DRAIN 的节点。
在主机上,我们监视 InfiniBand 轨道状态和链路抖动,并将其归因于拥有这些轨道的 VM。我们还监视主机可达性,因此死机主机会在您的节点上显示为问题,而不是沉默。
每个警报都附带稳定的摘要、通俗语言的描述和机器可读的证据负载。对于 Xid,那是每个代码及其 NVIDIA 助记符。对于热节流,那是峰值温度和节流计数。控制平面原样传递这些字符串,因此控制台、API(作为 linked_alerts)和您的通知始终说同样的事情。
我们将观察到的与可操作的分开。每个与修复相关的警报都会被记录并将您的节点标记为 降级。只有具有操作映射的信号才会创建修复。例如,磁盘压力会出现但不会触发重启,因为重启无法解决它。没有映射的警报会被计数和记录,绝不会被静默丢弃,并会路由到我们的支持团队进行调查。
2. 策略:我们决定做什么,你决定是否以及何时
做什么由平台拥有。每个信号映射到修复它的最轻量操作,因此你永远不需要知道哪个 Xid 意味着什么:
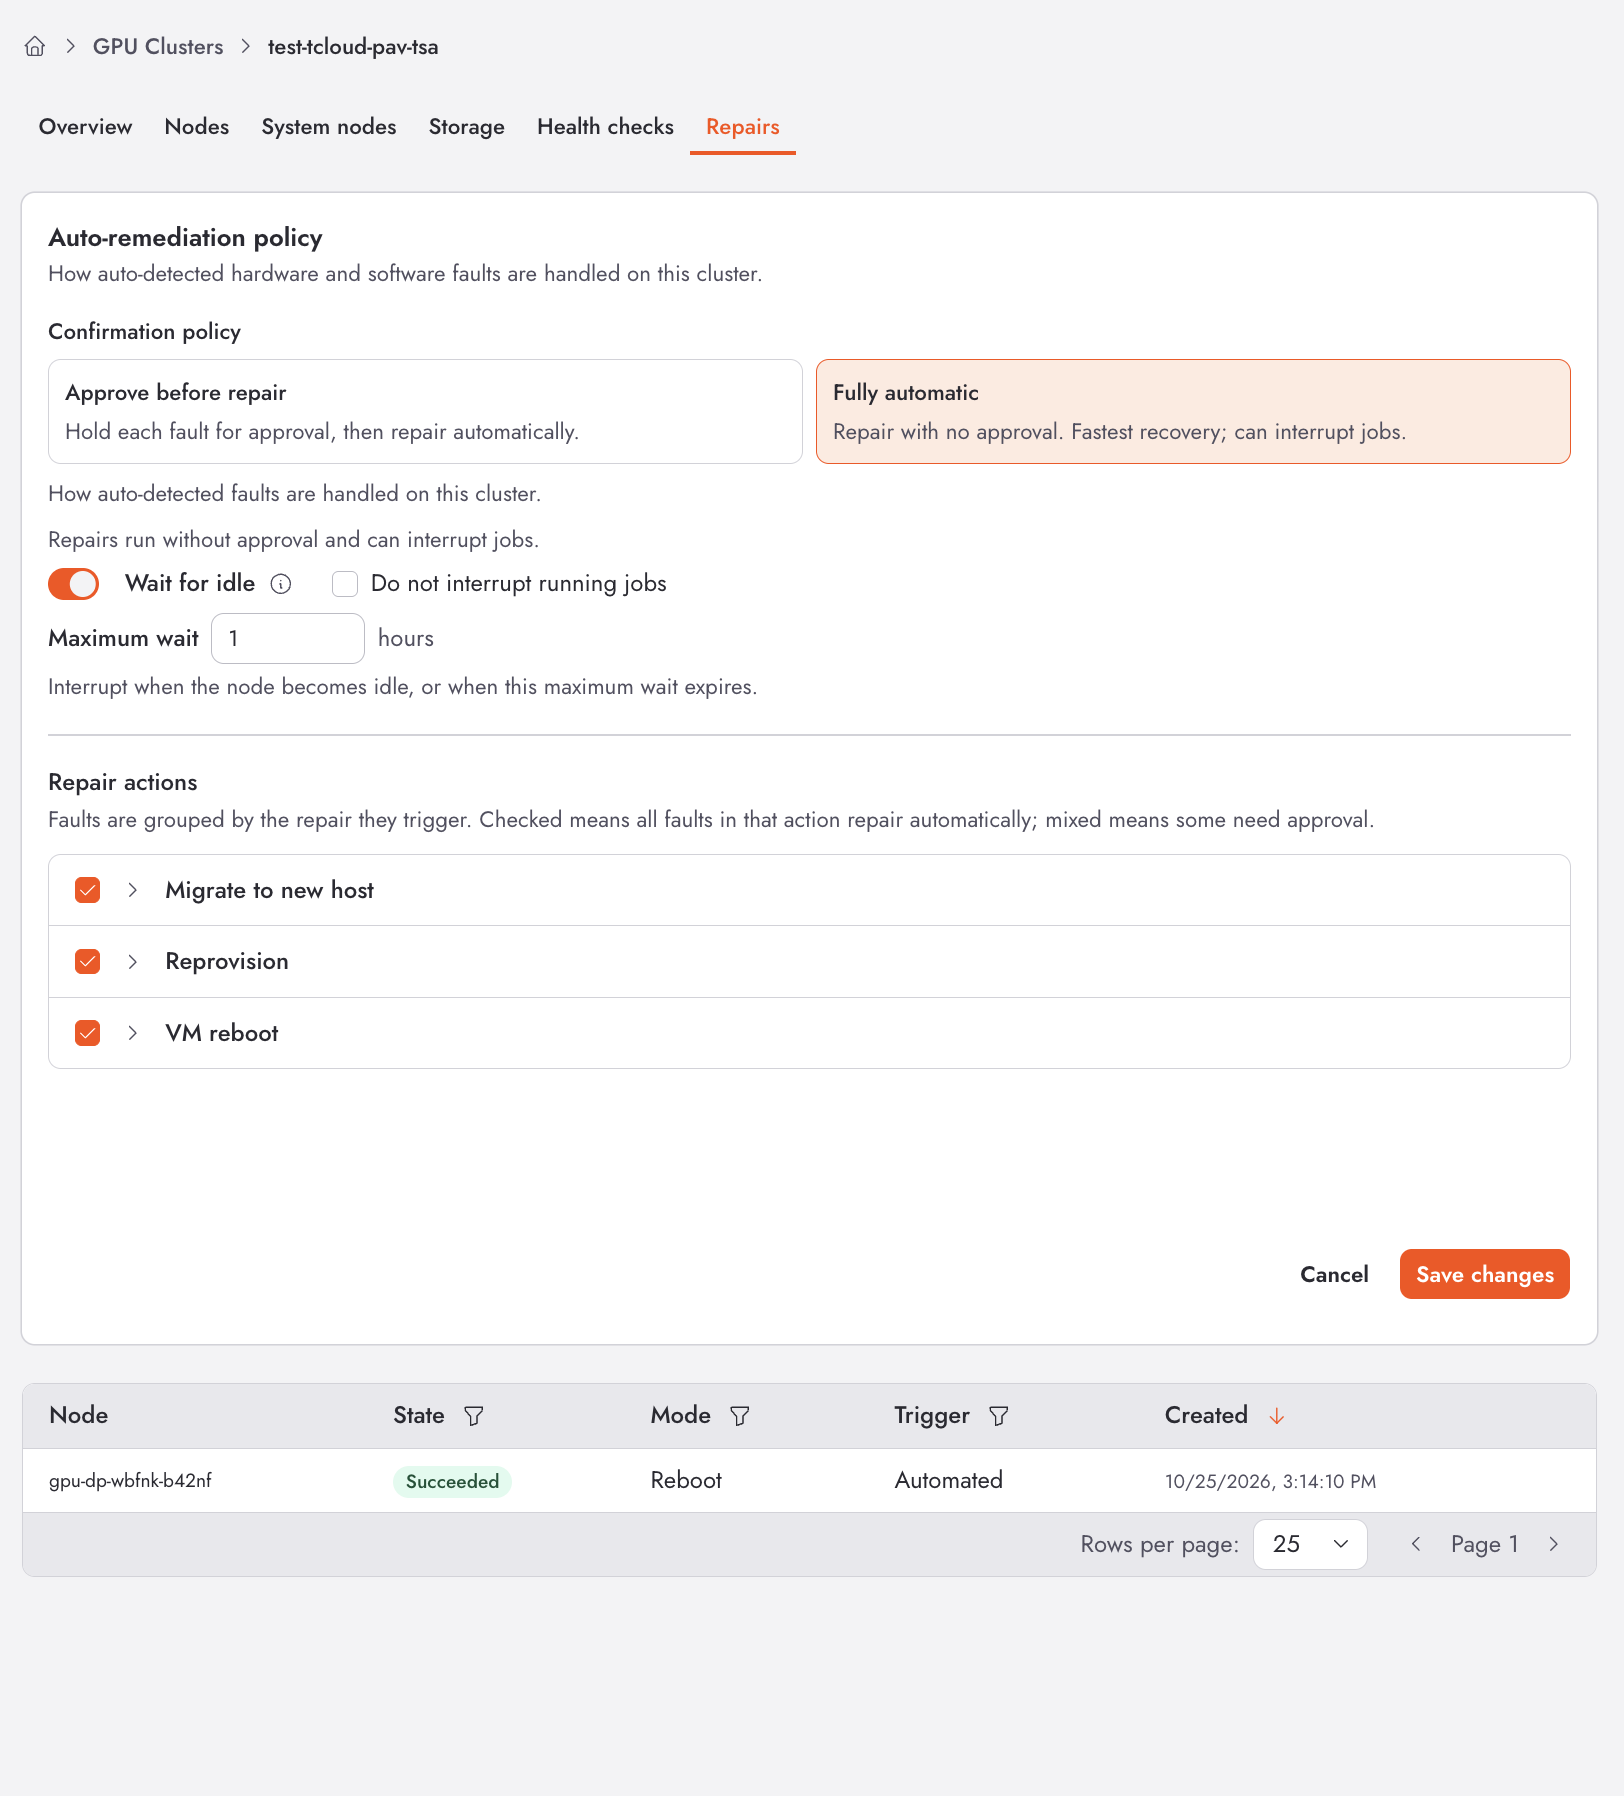
是否由你决定。在修复选项卡中,自动修复策略默认为修复前批准:每个建议都等待人员,人员可以接受或覆盖操作。你可以将默认值切换为全自动,但它不是一刀切的开关。修复操作检查表按触发的修复对故障进行分组,你选择你信任可无人值守运行的那些。在 Xid 组内,你可以按代码设置同意。一种常见设置自动批准 Xid 119 和 95 的重启,并保持迁移受控。如果你想要一个自动运行的故障短列表,而其他所有故障等待你的审查,Xid 检查表也可以在修复前批准下工作。
何时也由你决定。修复会排空节点,因此等待空闲会一直保持,直到节点真正空闲。在 Kubernetes 上,这意味着节点上没有正在运行的 Pod 请求 GPU。在 Slurm 上,这意味着调度器报告该节点上没有分配。最长等待限制保持时间,默认 2 小时,上限 24 小时。不中断正在运行的作业会完全移除该限制。将等待时间设置为至少等于你的检查点间隔。如果限制到期,修复将继续进行,并记录超时。
每次修复都会记录谁请求了它(自动修复为 Together Health Checker)、谁批准了它(具名用户或自动批准)、由哪条规则决定以及何时决定。
3. 自带检测器
运行大型 GPU 集群的团队已经拥有他们信任的检测手段:DCGM 仪表板、NVSentinel、内部扫描器、作业级检查。每次修复,无论来源如何,都会在我们的控制平面中成为同一条记录。这为容量检查、审计和安全护栏提供了唯一的归属。
有三种接入方式:
- API。 针对实例创建修复,需提供模式、可选的客户端提供 ID(用于幂等性),以及可选的你作为证据引用的健康检查运行或告警。你还可以列出、获取、批准、拒绝和取消修复。
- 控制台。 任意节点上的 ⋮ 菜单会打开修复对话框,其中包含检测到的问题和推荐操作。
- 节点标签(预览)。 任何具有写入节点元数据 RBAC 权限的检测器都可以通过向节点添加一个注解和一个标签来发起修复。注解携带检测器名称、稳定的请求 ID、修复模式、故障检测时间以及人类可读的原因。
我们的集群操作员将节点 label 镜像到控制平面。修复会以检测器作为外部请求者记录,因此始终可归因,且永远无法冒充用户。检测器名称加请求 ID 是集群范围内的幂等键,包括已完成的修复,因此每次扫描都重新断言同一故障的检测器无法重启节点两次。授权使用你集群自己的 RBAC,无需 API 密钥,也无需入职工单。
注解请求可以要求重启、快速重新配置或迁移。移除仍仅限人工。与控制台点击一样,这些请求会跳过审批队列,但它们仍会像其他所有请求一样通过相同的证据门、容量检查和预算。每集群上限意味着有缺陷的检测器造成的损害有限,而不是灾难。
4. 修复操作与升级阶梯
每次修复都遵循相同的生命周期:封锁、等待(按你的策略)、排空、执行操作、重新加入。控制台显示节点依次经过封锁中 → 排空中 → 修复中 / 迁移中 → 加入中 → 运行中。
操作从最轻到最重:
- 重启。 就地重启 VM。本地
/scratch和/tmp数据保留。 - 快速重新配置。 在健康主机上从干净镜像重建 VM。本地数据丢失。
- 迁移到新主机。 在不同硬件上重建 VM,并将旧主机送去重新验证。
- 移除。 将节点拉出以进行 RMA。始终由人工发起。
相同的修复不会循环。 如果同一操作已经运行两次后故障在同一台机器上再次出现,下一次推荐会上升一级。第三轮 Xid 重启会变为重新配置,第三次重新配置会变为迁移。阶梯按机器、集群、告警和 Xid 代码跟踪。超过一周的尝试不计入,已取消或自行解决的推荐也不计入。
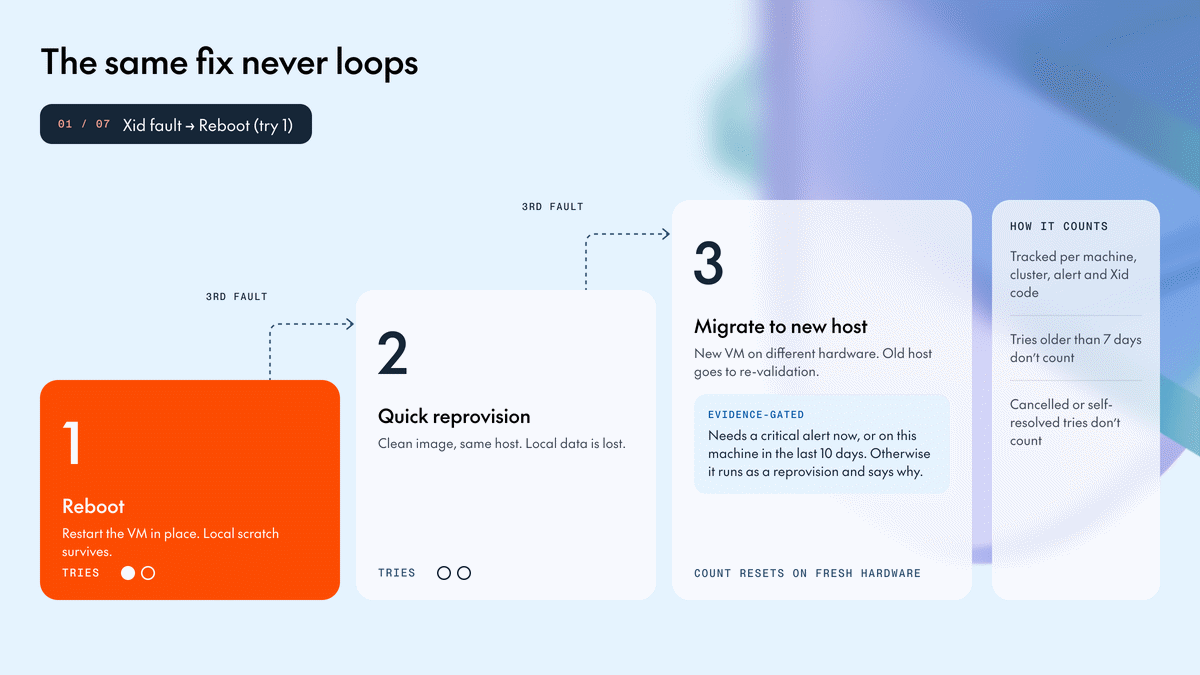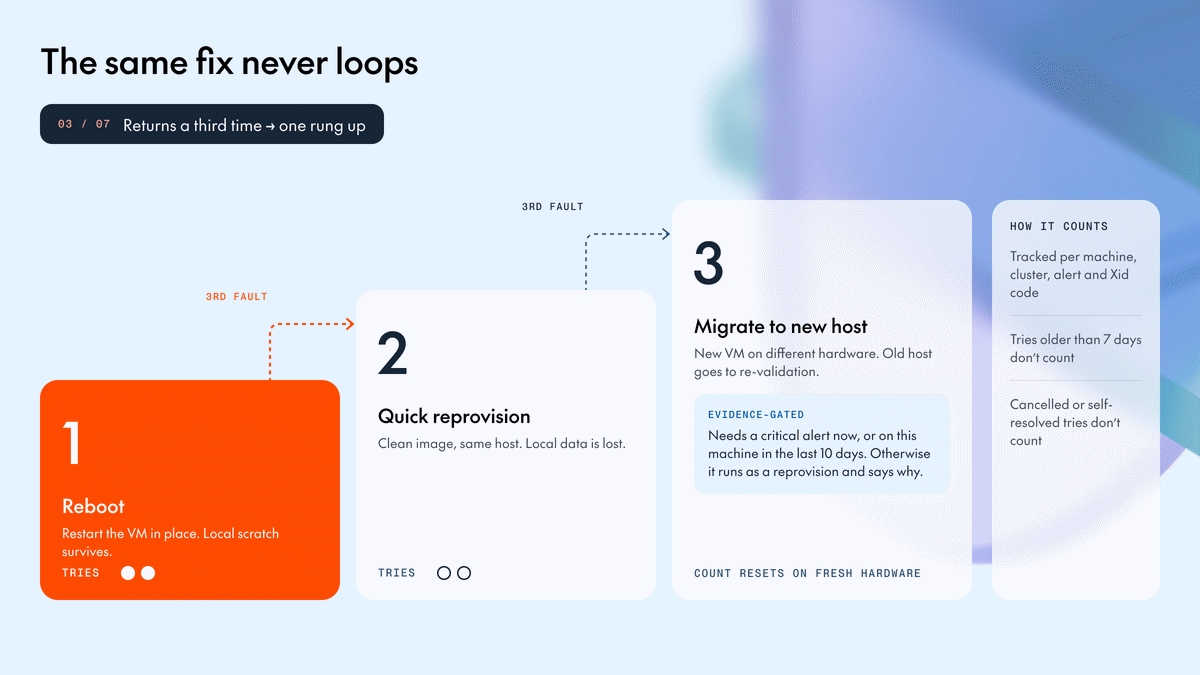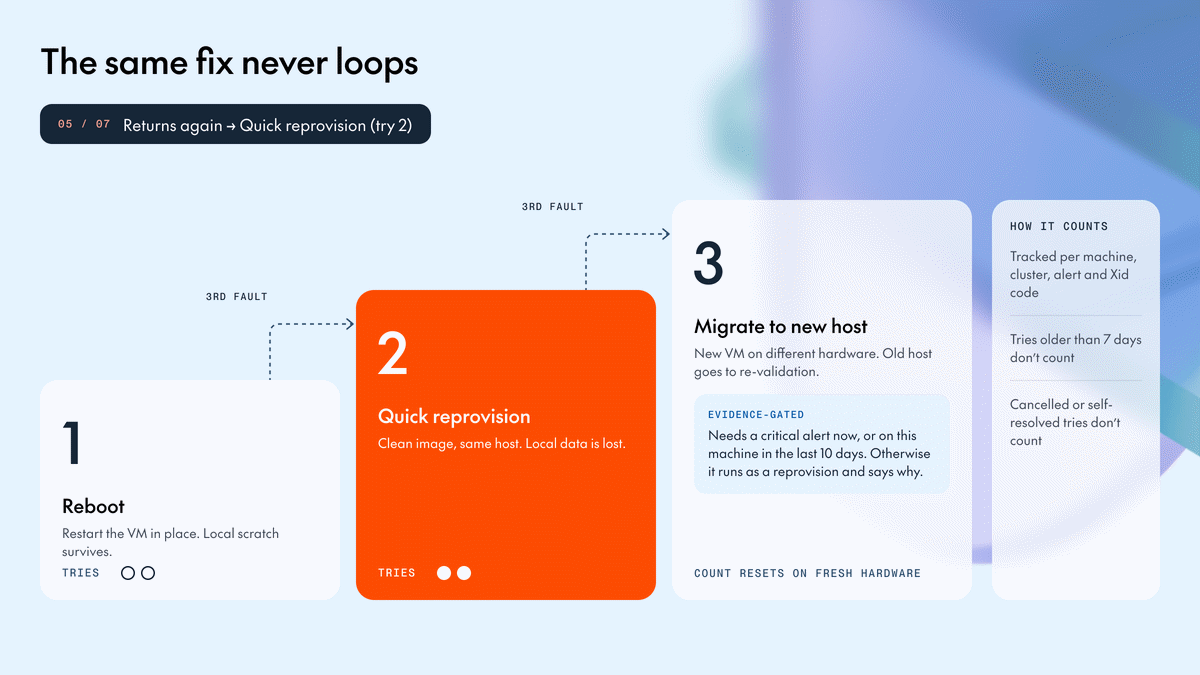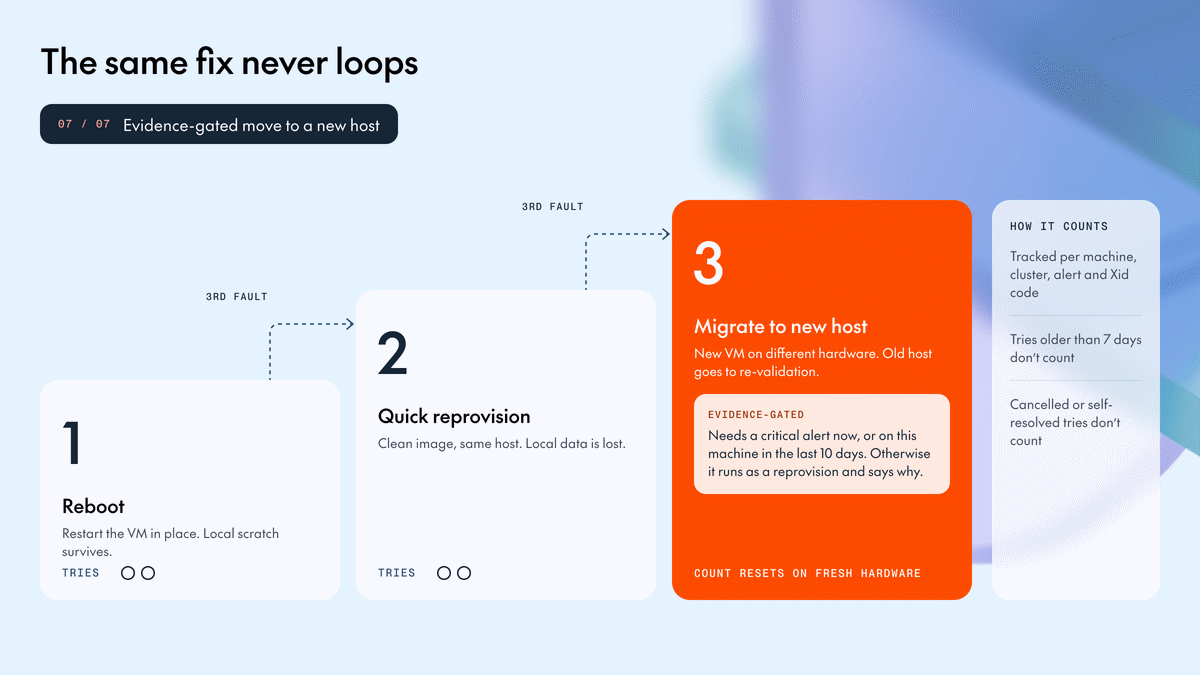
迁移受证据门控。 迁移是唯一消耗真实容量的操作。它要求节点上当前有严重告警正在触发,或同一机器在过去十天内有过严重告警。两个条件都不满足的请求将改为作为快速重新配置运行。
主机电源循环(预览)。 某些故障,包括 Xid 79,需要 GPU 断电,而 VM 重启无法做到这一点,即使硬件可能完好。我们不必消耗新主机,而是可以对当前所在主机进行电源循环。系统中任何地方都不存在 BMC 凭据。启动 ID 检查可防止重试对已经恢复的主机进行循环。
需要保证替换窗口的集群可以预留热备容量,这样迁移会从该预留中获取,而不是从一般可用容量中获取。详情请咨询你的客户团队。
5. 假设告警风暴会发生的护栏
糟糕的驱动推送、存储中断或网络分区可能使数十个节点同时看起来不健康。节点级修复无法解决集群级原因,因此护栏是分层且独立的:
- 持续性。 信号必须持续每个信号特定的时长,才能成为推荐。
- 冷却。 任何修复后,节点大约有 30 分钟才能生成新的推荐。
- 并发预算。 预算根据集群节点数量设定,操作员每个节点池一次只运行一个修复。
- 断路器。 当一个集群产生一批相关的自动修复时,断路器会跳闸。许多节点同时故障指向集群级原因,逐个修复节点无法解决。
- 每次修复一个目标。 模式强制要求这一点,因此缺陷无法在节点间扩散。
- 自动解决。 在任何人采取行动之前告警已清除的推荐会自行消失。
控制平面是复制的,每次写入都是幂等的,并会对照预期的状态进行检查。两个副本在同一节点上竞争会产生一次修复,而不是两次。
6. 机器自我重新验证
当节点从一台机器上迁移走,或从某台机器上被移除时,那台机器不应直接回到资源池,也不应坐在队列里等人去读诊断信息。旧 VM 一消失,机器就自动进入验证。测试 VM 会运行每台全新机器加入集群前都要通过的相同 GPU、NCCL、InfiniBand 和存储检查。从你的节点离开到结论落地之间,没有人碰这台机器。
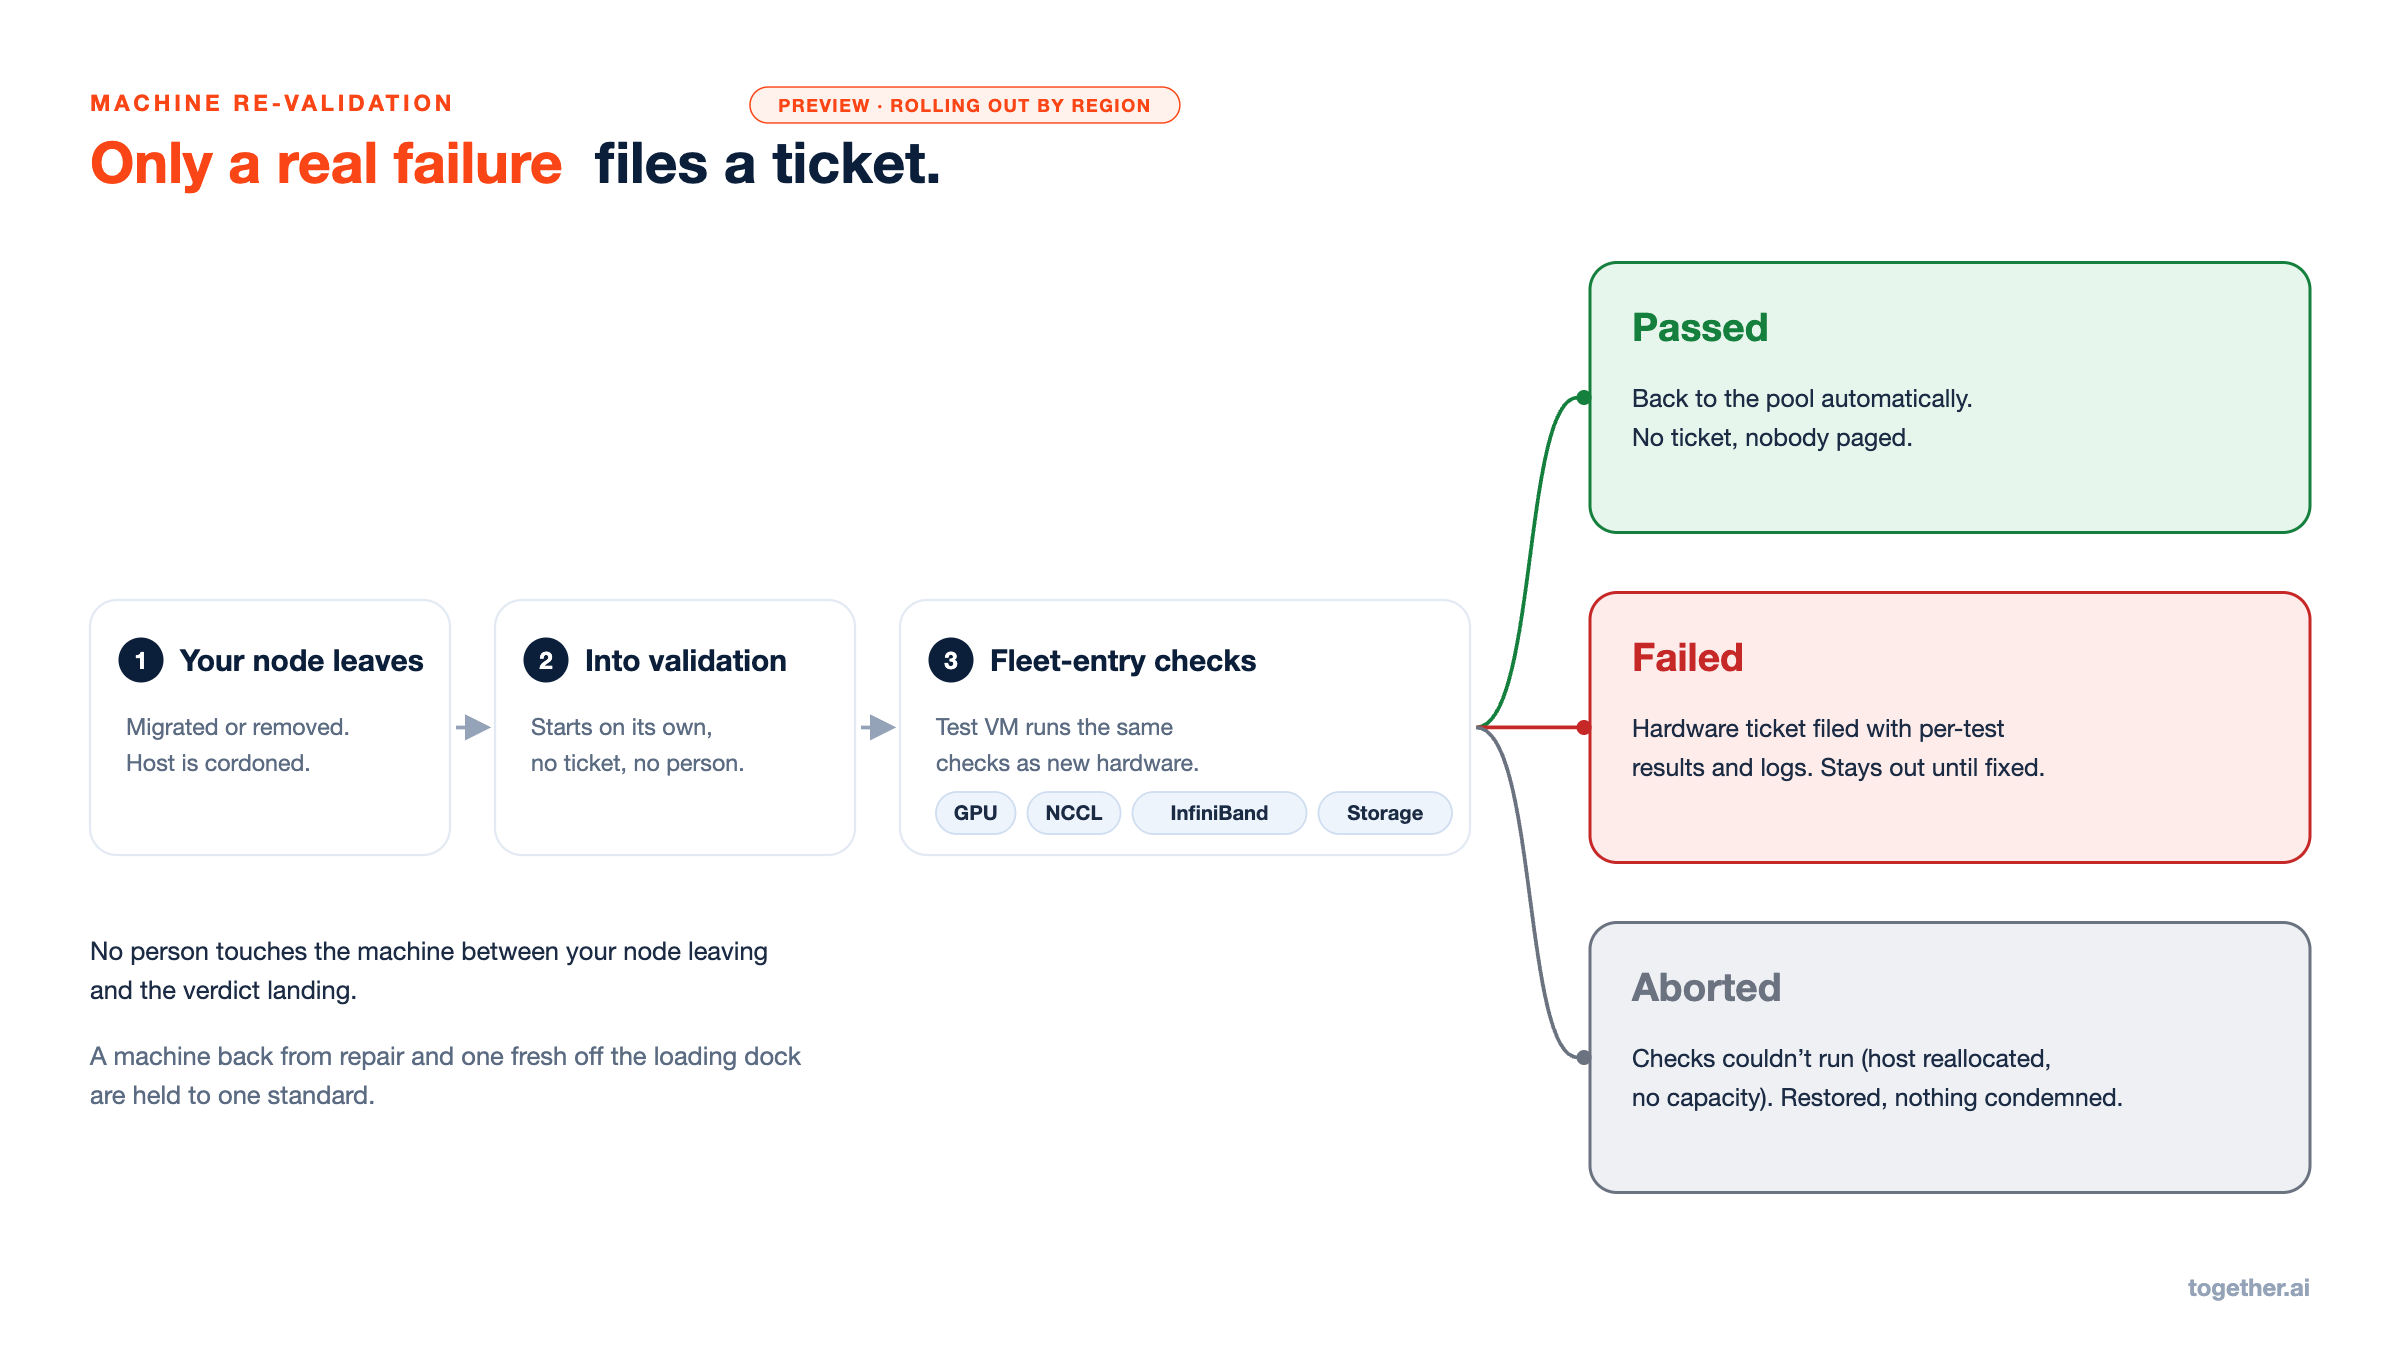
共有三种结论:
- 通过。 机器返回资源池。不提交工单,也不呼叫任何人,因此瞬时故障保持为瞬时故障。
- 失败。 自动提交硬件工单,并附上每项测试的结果和日志。机器保持停用,直到修复并再次通过。
- 中止。 检查无法运行,例如因为主机被重新分配或测试 VM 无法放置。机器恢复到之前的状态,不会判定任何东西有问题。
只有明确的失败才会产生工单。
设计上可扩展到单一加速器之外
修复决策以告警、节点和机器为依据,而不是以 GPU 供应商为依据。GPU 类型对放置和容量有影响,但推荐、策略、升级、预算、触发器和重新验证都不对它做特殊处理。供应商相关的部分是检测(Xid 和 DCGM 导出器)和诊断测试组。接入新的加速器意味着添加这些部分,下游的一切都会沿用。
使用方式
在控制台中打开你的集群,进入 Repairs 标签页。待处理的推荐和历史记录都在那里,顶部是 Auto-remediation policy。API 中的每个修复都带有其 linked_alerts,因此你自己的工具能看到与控制台相同的证据。
后续计划
- NVSwitch 覆盖。 SXid 故障,按节点合并,并提供可读的描述。
- 状态回写到节点。 修复进度作为节点元数据写回,以便外部检测器能在它们开启闭环的地方关闭闭环。
- 统一健康视图。 从失败的检查点击到它导致的修复再返回,外加每个节点的健康、事件和修复历史视图。
告诉我们你的集群上还有哪些我们尚未捕获的故障。那份清单将决定我们接下来构建什么。