我们推出 Together Post-Training,这是一项在我们平台上构建自定义模型的新服务——既可以通过 RL 从环境奖励中构建,也可以通过 SFT 从监督数据中构建。该服务旨在为你提供灵活高效的模型塑造能力,而无需承担沉重的基础设施负担。
Together Post-Training 让定义训练循环变得简单,同时我们在底层协同优化系统与基础设施,以兼顾模型质量和训练速度。现在,你与那个独一无二属于你的最佳模型之间再无阻碍。
自定义模型的价值
到 2026 年,为你的 AI 工作负载训练自定义模型已不再是冷门话题。企业正在积极探索这一方向,以降低成本并提升特定任务的表现。许多 AI 原生和 AI 前沿组织不再通过上下文或 harness 工程来修正模型行为、提升其效率,而是训练专用智能体,以极低的成本和运行时间达到前沿模型的质量。除此之外,自行训练模型还能带来更强的自主权和灵活性:得到的 checkpoint 可以部署在任何位置、进一步精炼,甚至可以在本地使用。
在 Together,我们希望赋能每一位 AI 开发者,让他们尽可能便捷地获得最适合其任务的模型。对优秀模型进行后训练需要在数据整理、训练算法和评估协议上进行多次迭代。除此之外,RL 的基础设施正变得日益复杂,“效率优化”与“拖慢你运行的隐蔽 bug”之间只有一线之隔。可靠且大规模地对大模型进行后训练,本身也带来了一系列挑战。
前沿实验室有专门的团队来解决上述每一个问题。由于一次性应对所有挑战是一项巨大的投入,许多本可从后训练中受益的公司从未开始,或者开始后便停滞不前。Together Post-Training 在不干扰你的前提下处理所有优化和基础设施,我们的前置部署团队与客户合作,协助完成端到端工作流。这让每一位研究员或领域专家都能专注于自己最擅长的事,其余的交给我们。
Together Post-Training 概览
随着后训练的复杂性不断演变,围绕它的工具也应随之演进。Together Post-Training 提供了一套 ML 开发者熟悉的通用抽象,以及对每次实验所用资源的控制,同时确保底层所有计算都快速、经济,最重要的是正确。
我们构建该服务,旨在为你的实验提供最高程度的灵活性。你可以运行 LoRA 训练,包括多个 LoRA 适配器共享同一 GPU 容量,也可以对部分模型进行全权重实验。与我们的微调服务不同,Together Post-Training 的整个训练循环由你定义。你可以使用最适合自身设置的任何数据、环境或智能体 harness,并在训练过程中添加任何所需步骤(例如日志记录或外部基准测试)。整个工作流如下:
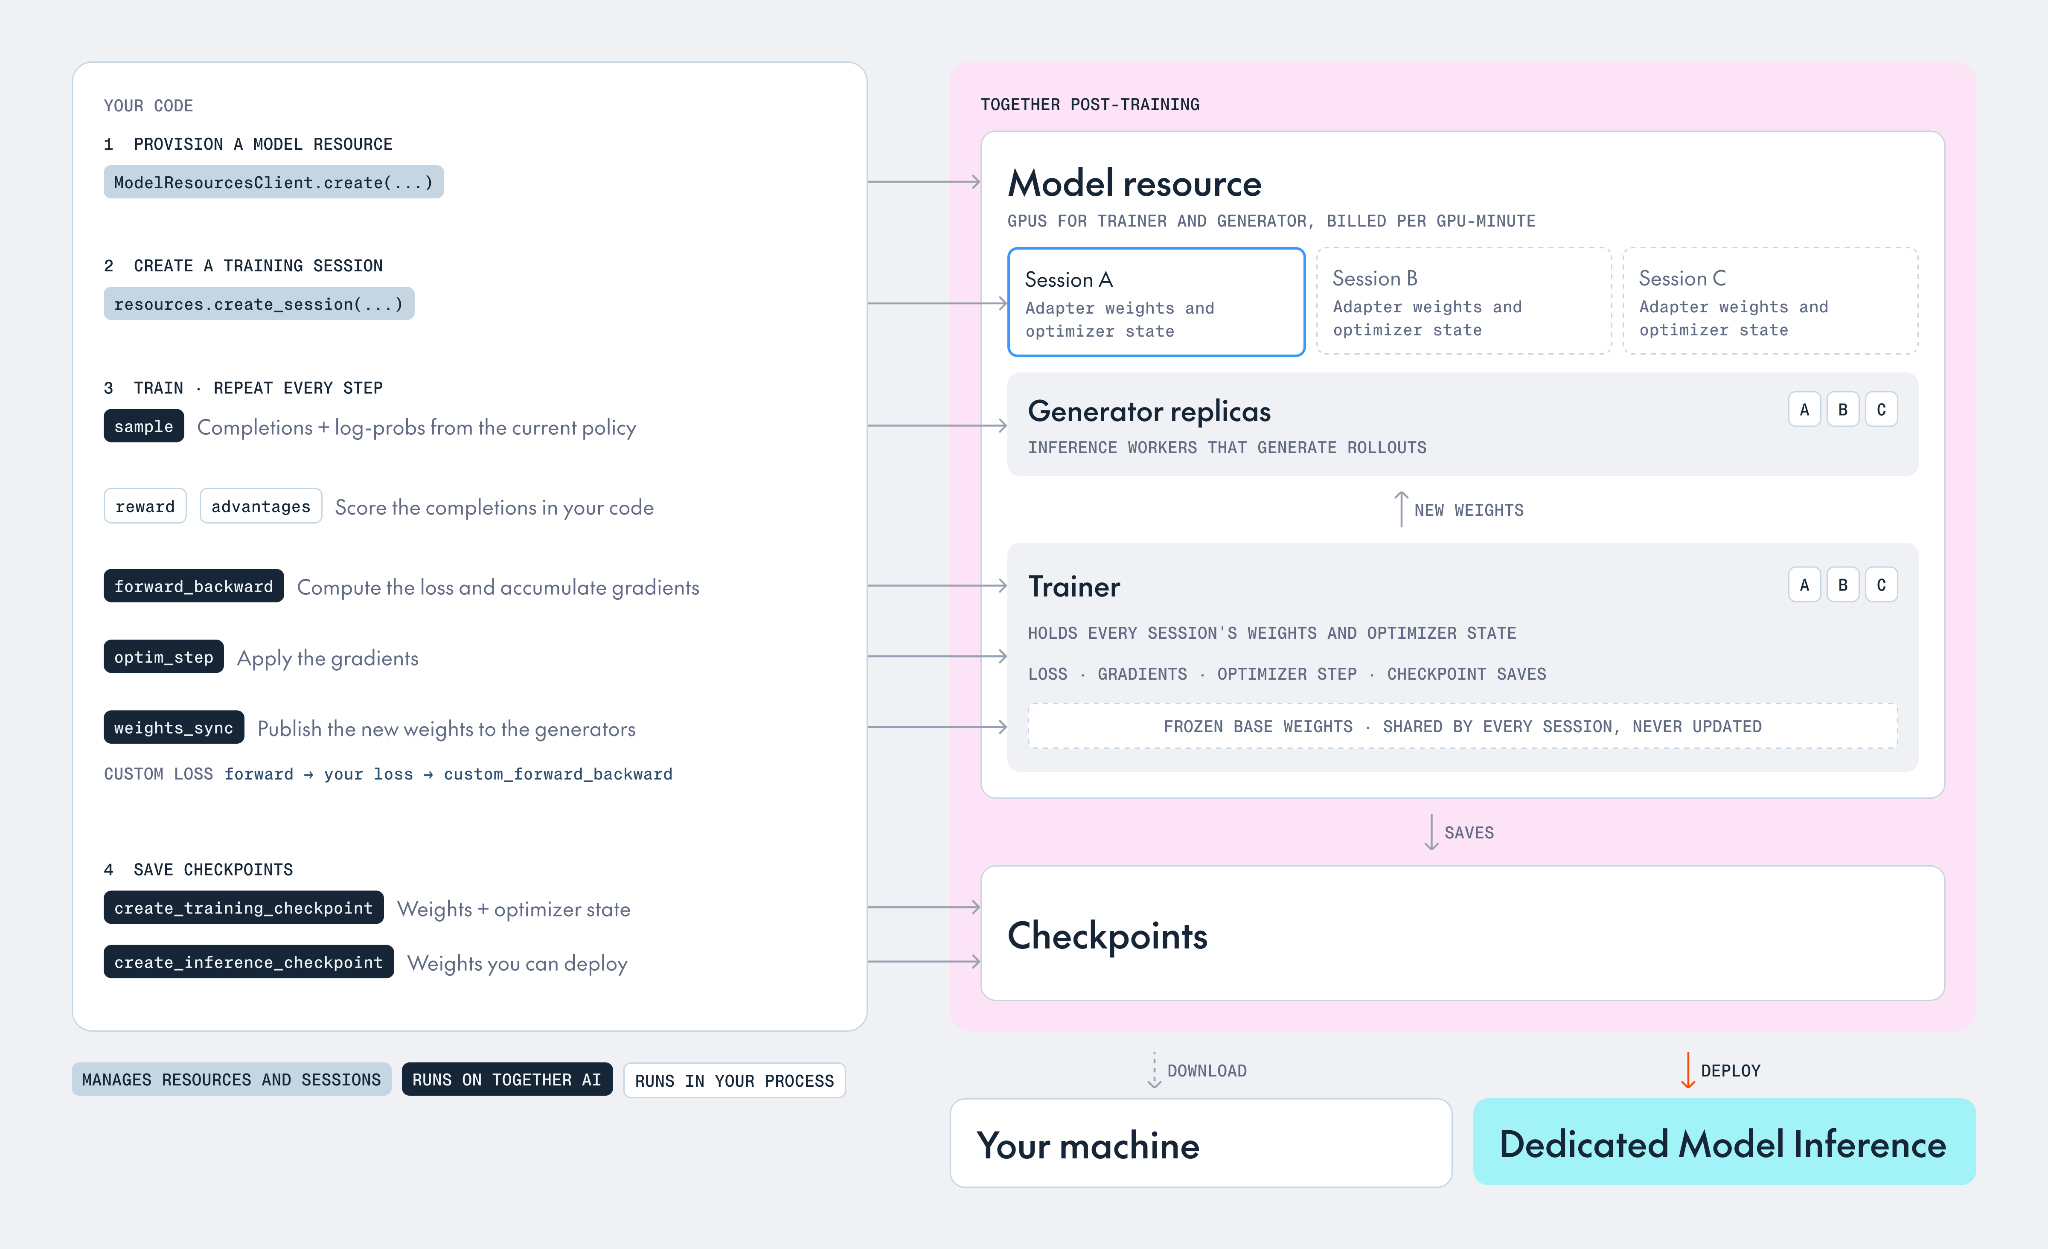
所有实验都运行在 Model Resources 上——完全属于你的 GPU 分配,无需与其他请求争夺优先级。每个 Model Resource 可以承载一个或多个 Training Session,每个 Session 对应使用同一基础模型的一次实验(例如一组 LoRA 适配器)。这意味着你能获得最佳的 rollout 和训练性能,因为你永远不必与其他用户在同一硬件上执行的请求竞争。同时,专用的 GPU 分配意味着你可以运行全权重微调,在适配大型知识密集型任务时超越 LoRA。
分配好模型资源并启动 session 后,你就可以执行训练循环的每一步。每个 session 包含一个 Trainer 实例,负责运行前向/反向步骤并更新权重,以及若干 Generator 实例,用于从策略执行 rollout。对于每个模型,我们都大力优化训练和 rollout 性能,确保所有操作快速且在各技术栈之间数值对齐。在 SFT 的情况下,你可以启动 0 个 generator 的模型资源以节省成本。由你决定在何时将 trainer 参数发送给 generator;我们还支持异步 RL,以始终保持两个组件的高 GPU 利用率,尤其是在长时间的智能体 rollout 中。
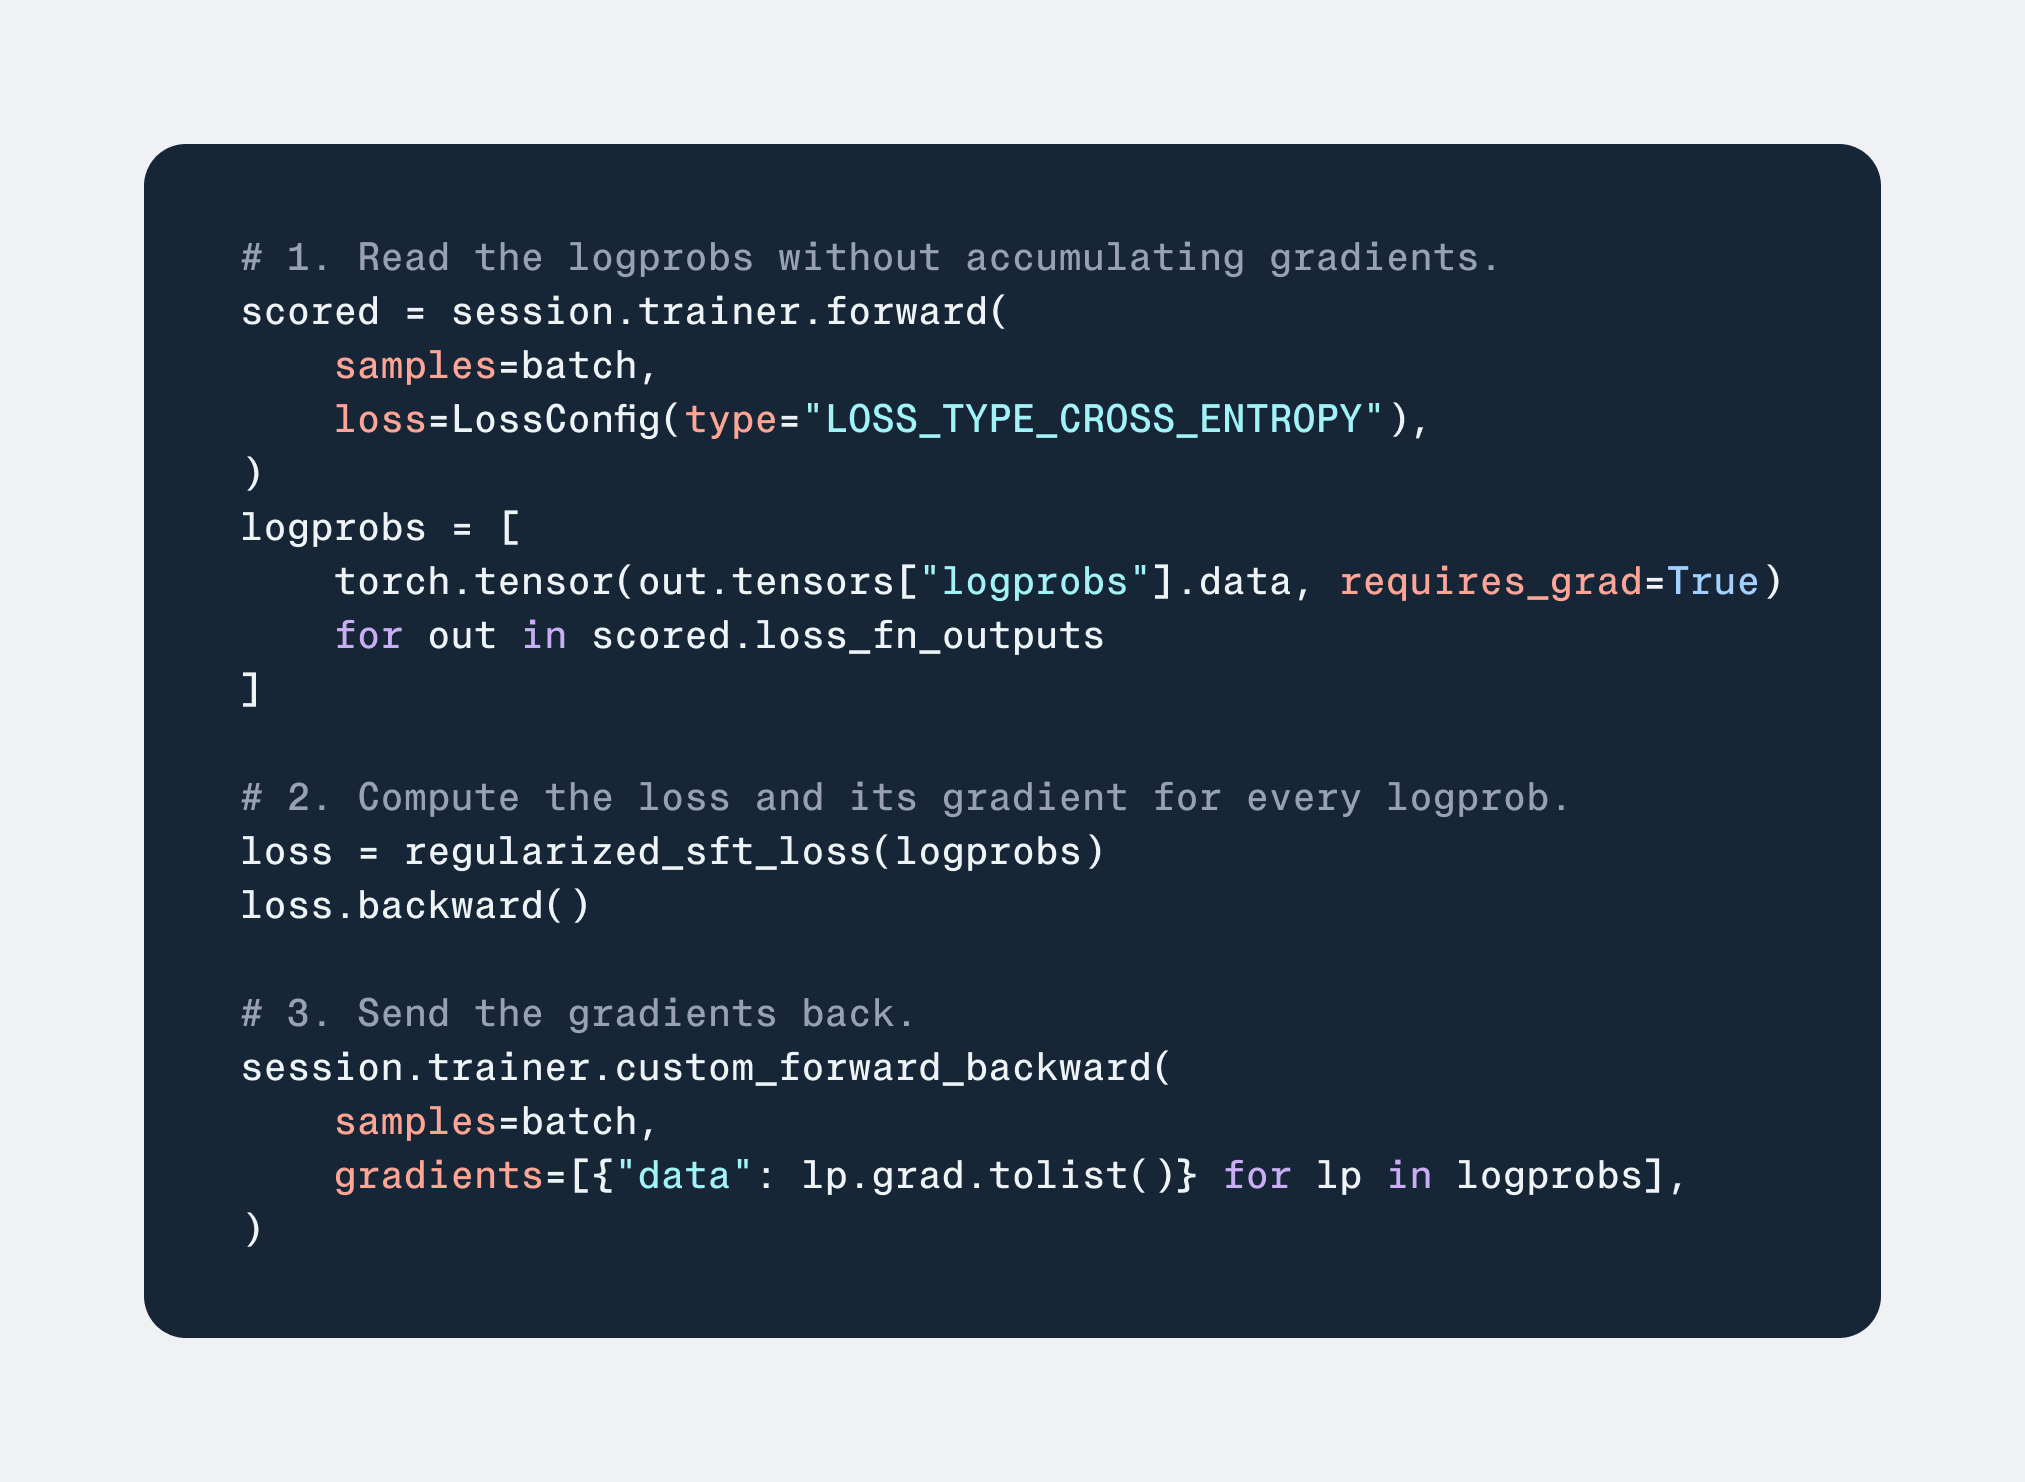
我们支持多种标准损失(从交叉熵和 GRPO 到 CISPO 和 DPPO),同时也允许在本地计算自定义训练目标,并将其梯度发送给 Trainer 以计算更新。
Together Post-Training 上线时支持一系列领先的开源权重模型,包括 Muse Spark Open、GLM 5.3、Kimi K3 和 Qwen 3.8-27B。我们将在未来几周内扩大选择范围,确保你既能使用能力最强的前沿 LLM,也能使用高效的小型模型。
质量、性能与效率
将后训练基础设施的内部实现委托出去可能是一个令人望而生畏的决定。我们的团队在捕捉复杂机器学习系统中的隐蔽 bug 方面拥有第一手经验,从推动 RL 研究的前沿到训练已服务数百万用户的 LLM。我们深知最好的训练技术栈就是能让你获得最佳模型的那一个,而构建这样的基础设施需要在所有组件上进行细致的实现与协同设计。
出于这些原因,我们在开发该服务时将输出模型的质量作为我们的北极星指标。影响 RL 结果的一个著名问题示例是训练引擎与推理引擎之间的对齐:如果相同的模型权重由于数值不匹配而产生略有不同的输出,整个运行可能会表现不佳甚至崩溃。我们消除了训练与推理之间众多策略漂移的来源,既使用了 Rollout Routing Replay 等标准技术,也使用了由我们在训练稳定性方面的研究驱动的先进优化。
除了模型质量之外,我们还努力让每次运行尽可能快速和高效,因为后训练需要多次迭代:运行完成得越快、成本越低,你能测试的想法就越多。RL 中的大部分时间花在生成 rollout 上,这让我们能够利用 Together 推理产品背后多年的研究与工程积累。我们的 rollout 引擎采用了与我们的服务技术栈相同的优化。对于多轮智能体,智能缓存与路由可最大限度地减少冗余计算,同时保持内存成本可控。在训练方面,优化的并行与序列打包可加速 SFT 和 RL 步骤。
借助 Together Post-Training,你可以按每个实验的实际需求来配置规模,而无需多付费用。如果你的实验受限于 rollout 并发,你可以请求精确数量的采样器副本。多个 LoRA 实验可以共享一个模型资源,因此运行一轮扫描并不意味着要为每个配置预留更多 GPU。我们按 GPU 分钟对每个模型资源计费,但得益于我们对专用及多 LoRA 服务技术栈的多项优化,一旦你扩大实验规模,整体训练成本就会低于按 token 计费的价格。
训练后的优化部署
当后训练实验完成后,并排运行每个生成的模型以比较它们的输出可能很重要。我们现在在 Dedicated Model Inference 中支持 多 LoRA 适配器服务:无需为每次运行启动单独的生产部署,你可以在单个 GPU 部署中按需切换适配器,从而帮助你降低服务成本。
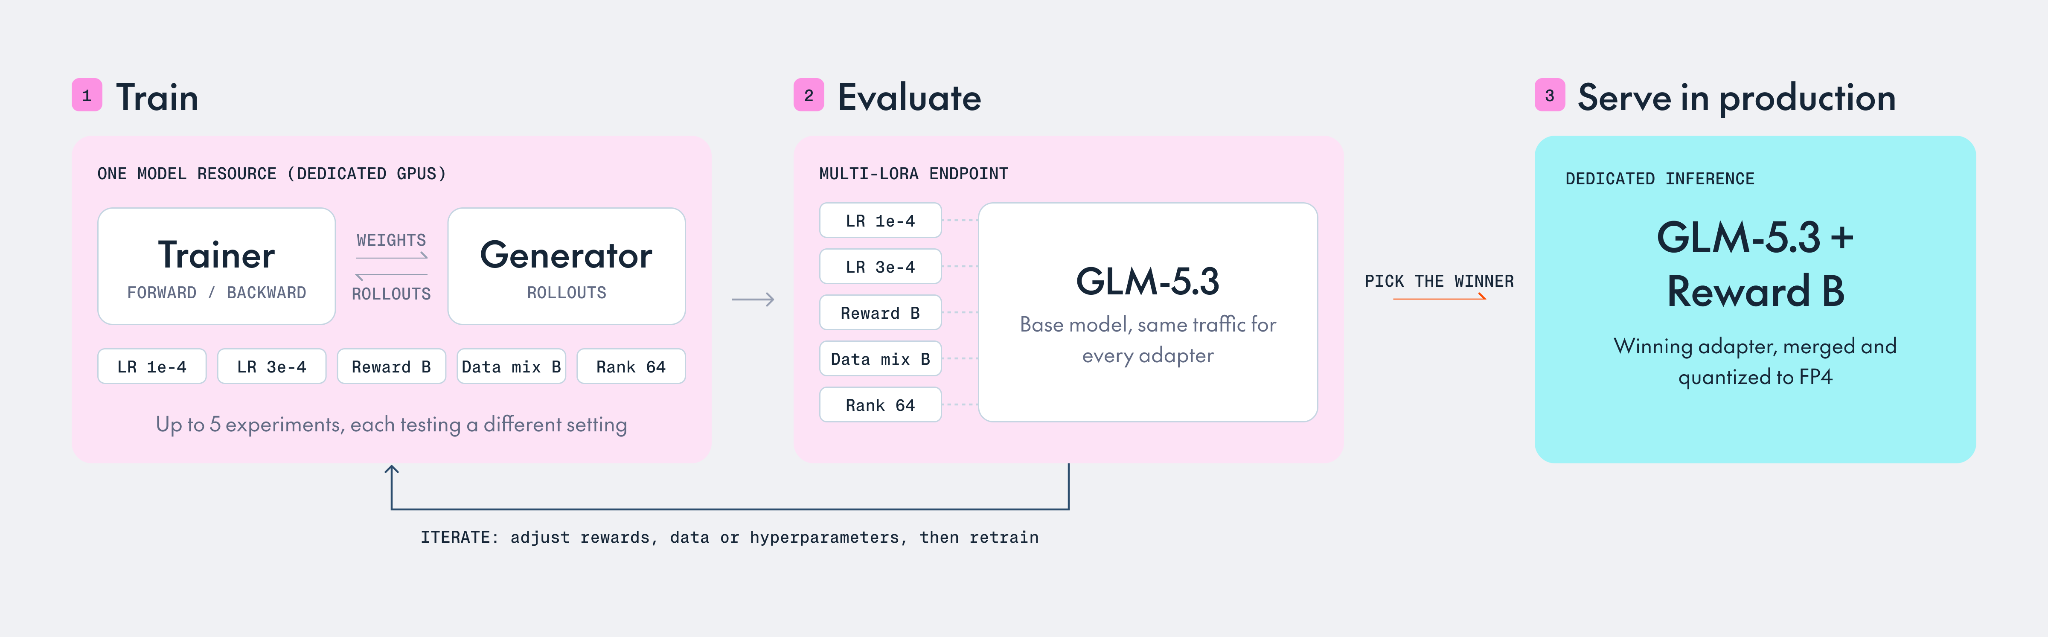
最后,将模型转换为在生产中以最高吞吐量运行,意味着它可能以更低的精度、在不同的硬件配置下、并使用与 rollout 生成不同的内核来执行。通过算法与系统改进的结合,我们确保每个训练检查点在服务中保持质量,即使从多 LoRA 采样切换到完全高性能的 FP4 精度合并推理。
开始使用
要开始你的第一个后训练实验,请安装最新的 Together SDK 并阅读文档。我们还提供了一系列 cookbook,可帮助你开始使用 Together Post-Training,可在 github.com/togethercomputer/post-training-cookbook 获取。这些 cookbook 提供了在标准 GSM8K 基准测试上使用 GRPO 进行训练、将 DPO 实现为自定义损失,或在同一模型资源内训练多个 LoRA 适配器的示例。如果你已有使用 Tinker API 等后训练服务的设置,我们也提供了一种简单的迁移方式。你可以替换脚本中的一行,其他一切保持不变:
-import tinker
+import together.post_training.tinker as tinker
阅读我们的Tinker 迁移指南以了解更多。
AI 原生公司如今如何使用 Together Post-Training
在此次发布之前,我们与一组精选的组织合作,他们正在推动自定义模型的前沿。在过去几个月中,我们授予了他们我们服务的早期访问权限;我们收到的反馈对开发这款如今人人可用的产品非常宝贵。以下是这些团队的反馈:
“从第一天起,我们就在 Together Post-Training 平台上获得了很棒的体验。高度的控制力和灵活性让我们在几个小时内就开始运行真正的 RL 实验。该服务非常高效,使我们能够在相同的 GPU 容量上同时运行多达五个 RL 实验。Together Research 团队在整个训练过程中都是出色的合作者,在模型选择、训练技术、奖励函数和训练效率方面给了我们反馈。”
– Anthony Li,数据科学副总监,Deel
“在 Jack & Jill,我们构建了两个 AI 智能体:Jack 面向专业人士,Jill 面向公司,后者从 Jack 的网络中招募已同意被介绍的专业人士。我们使用 Together Post-Training 对一个模型进行后训练,该模型预测招聘经理希望会见哪些候选人,这是 Jill 搜索中的核心步骤。上手很容易,他们的团队帮助设计了我们的实验,他们的前向部署工程师编写了让我们获得初步结果的脚本。我们在离线评估中匹配了闭源模型的质量,使用的是服务成本显著更低的开源模型。”
– Oliver Normand,创始工程师,Jack & Jill
“自 4 月 Post-Training 测试版发布以来,我们一直与 Together 团队合作。在最新迭代中,无缝的自助上手让我们能够轻松快速地启动全规模智能体 RL 运行。Post-Training 服务已被证明在扩展复杂智能体工作负载方面异常直观、灵活且强大。”
– Adit Jain,研究员,Collinear AI
使用 Together Post-Training 构建
随着 Together Post-Training 的发布,我们正在将前沿级模型定制转变为一款可靠、灵活且高效的服务。下一步就是让你充分利用它。在最初的八周内,我们以每 GPU 小时 B200 使用量 9 美元的优惠价格提供 Together Post-Training。立即了解如何开始使用——我们期待看到你将构建什么。
但你不必独自完成这件事。对于希望有合作伙伴的公司,我们的前置部署工程师会在整个后训练生命周期中与你的团队并肩工作。他们会先帮助为你的用例选择合适的开源模型和 agent harness,与你一起处理数据和训练环境,然后协助进行评估并交付你自己优化的端点。
如果你希望与 Together 合作,为你的组织训练模型,欢迎联系我们。