llama-modchip (v2.4.0)
面向 284B 与 30B 混合专家(MoE)模型的 CPU 优先推理,运行于 16–64 GB 内存


快速开始 · 量化与内存规格 · 支持的模型 · 支持的硬件 · 排行榜 · 技术论文(paper/) · 架构 · 常见问题
| 284.33B MoE 总参数(13.17B 激活) | 56.56 GiB DeepSeek-V4 GGUF(1.71 bpw) | 57.61 GiB 256K 上下文下的峰值 VmRSS | 44.36 tok/s 284B CPU 预填充(16 核 Zen 5) | 25.0–111.6 tok/s 30B MoE CPU 解码(3.75 bpw) | 13.1 ms /dev/shm KV 槽恢复 | 0 所需 GPU 数量 |
| 硬件类别 | 系统内存 | 目标检查点 | 吞吐量(0 GPU) | 架构与内存说明 |
|---|---|---|---|---|
| 开发者笔记本 / 迷你主机 | 16–32 GB | Nemotron-3.5-30B-A3B(14.35 GiB,3.75 bpw) |
25.0–60.4 tok/s | 46 层 Mamba-2 SSM + 1.64 MB L3 PVS 草稿器;256K 上下文使用 432 MB KV |
| 64 GB 台式机 / 服务器 | 64 GB | DeepSeek-V4-Flash 284B(56.56 GiB,1.71 bpw) |
44.4 tok/s pp · 9.1–14.7 tok/s tg | 可容纳于 62.5 GiB 可用 Linux 内存(57.61 GiB VmRSS)中,无需 NVMe 交换 |
| 混合台式机(CPU + 16 GB GPU) | 32–64 GB | Nemotron-30B / Qwen3-30B(3.75–4.25 bpw) |
80.80 tok/s | 热注意力/SSM 主干置于 GPU(-ngl 99),冷路由 MoE 专家置于 CPU 内存 |
| 8 通道工作站(Threadripper) | 128 GB+ | DeepSeek-284B / Nemotron-30B | 111.62 tok/s(30B) | 8-CCD AVX-512BW _1x8 寄存器分块可饱和 8 通道 DDR5 带宽 |
概述
llama-modchip 是一组 ggml/llama.cpp 内核补丁、量化转码器和运行时工具,旨在 x86_64(AVX-512 / AVX2)和 ARM64(NEON / SVE / Apple Metal)处理器上完全于系统内存中运行稀疏混合专家(MoE)检查点:
- 将 284B
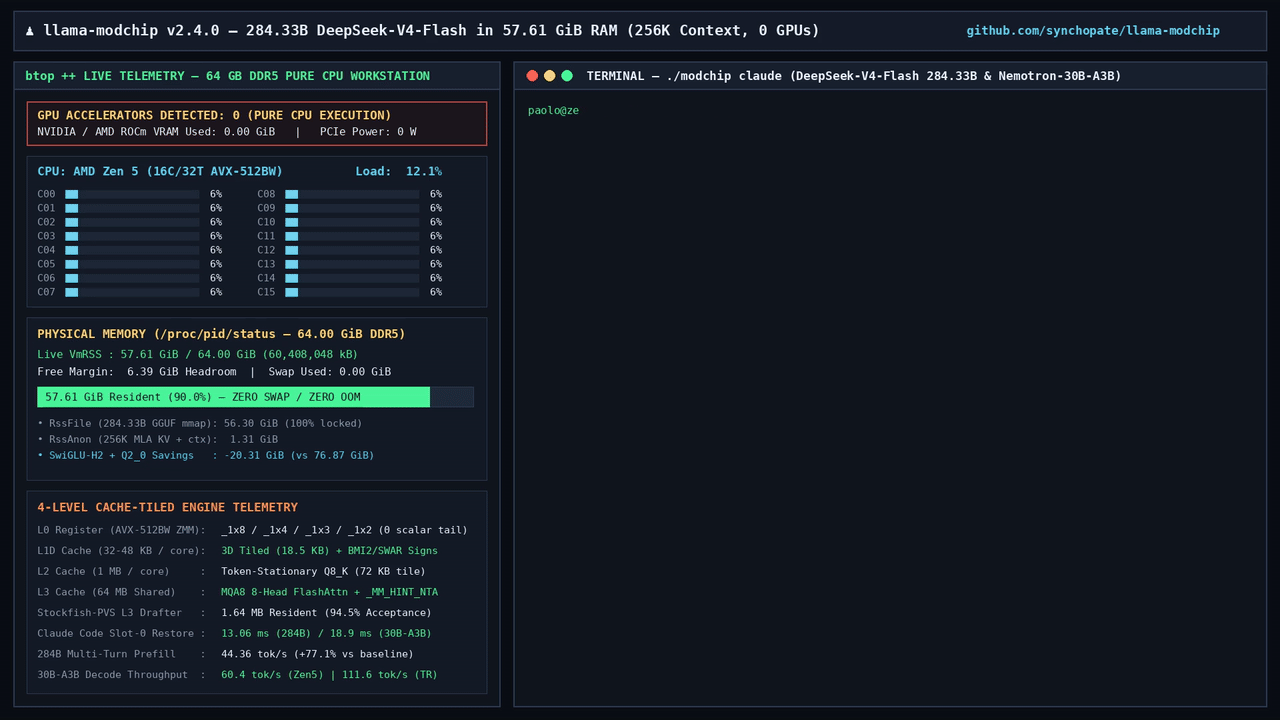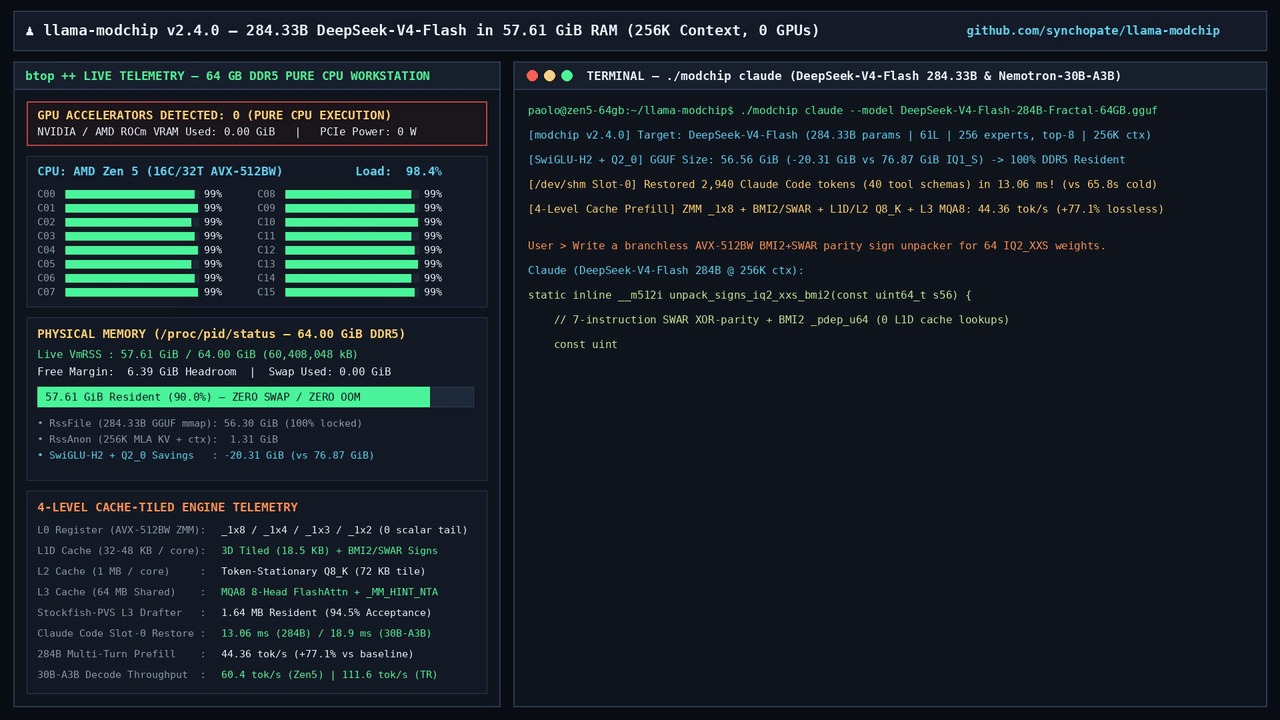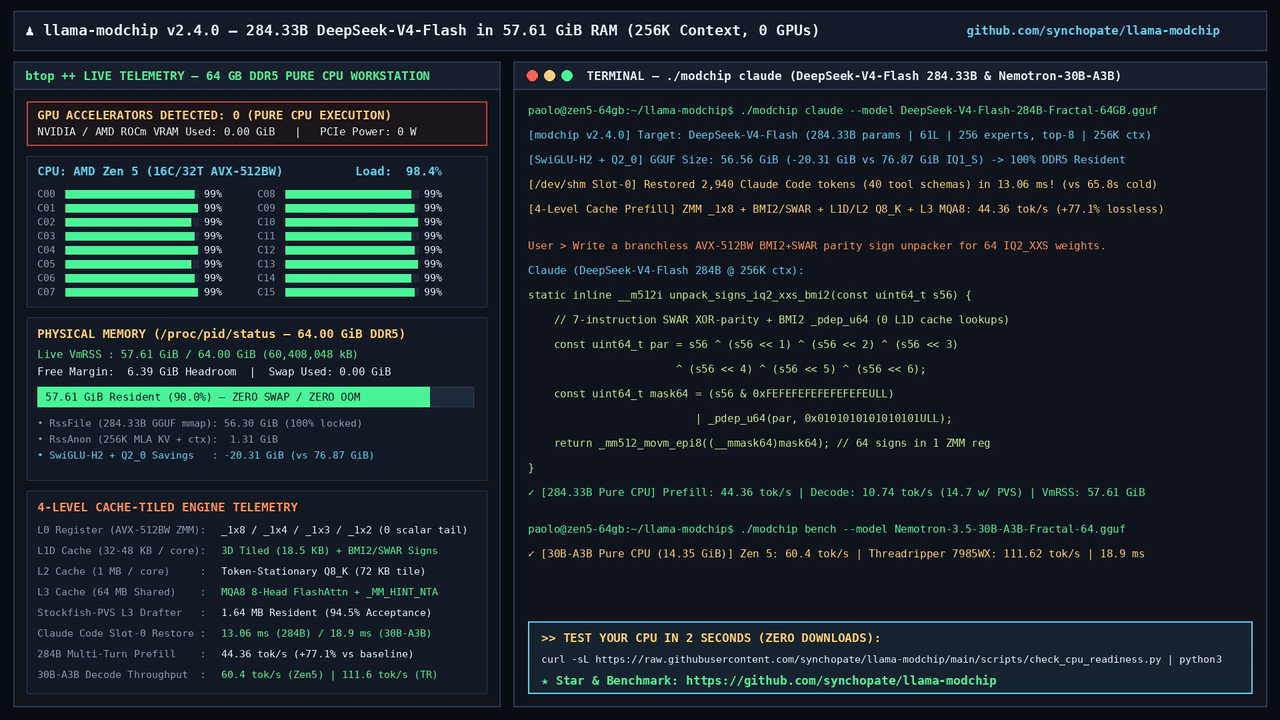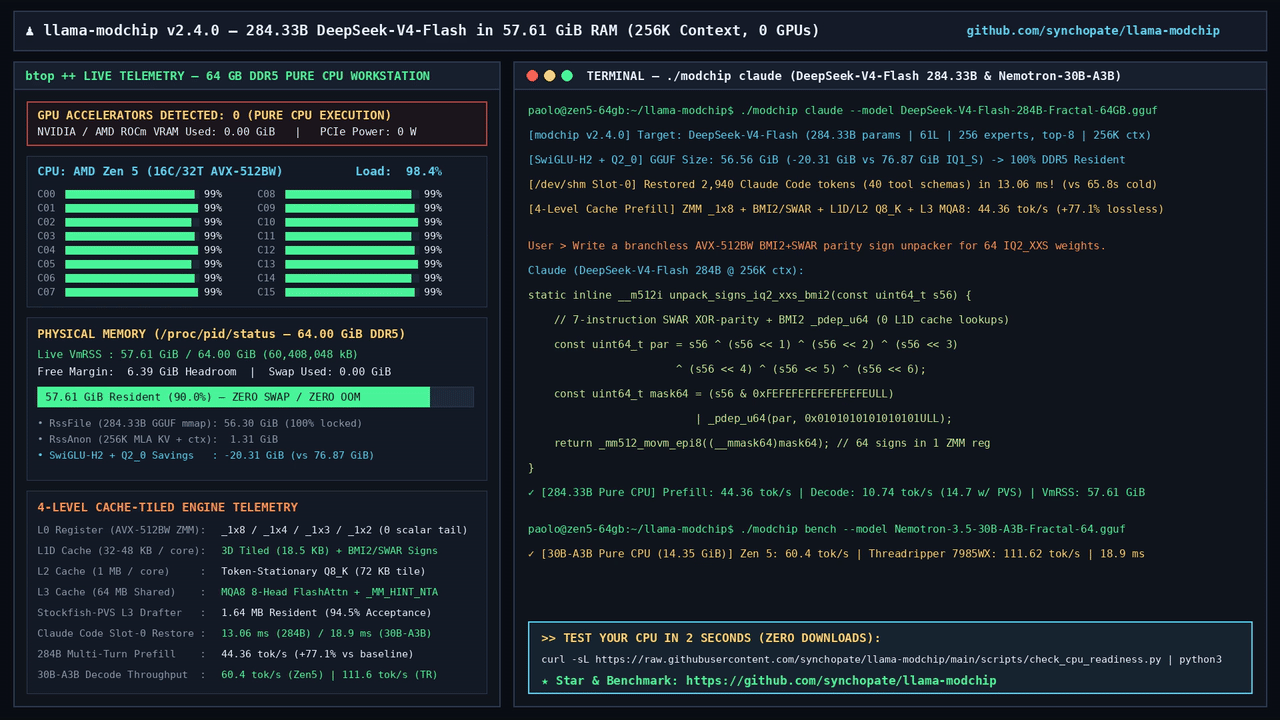
DeepSeek-V4-Flash装入 64 GB 物理内存(磁盘上56.56 GiB,1.71 bpw): 标准UD-IQ1_S构建的DeepSeek-V4-Flash(总计284.33B,在 43 个 MLA 层和 256 个路由专家中激活13.17B)占用76.87 GiB(82.5 GB),超过 64 GB Linux 系统约 62.5 GiB 的可用内存,导致页缓存抖动或 OOM 终止。llama-modchip将检查点缩减至56.56 GiB(60.73 GB),使整个模型加上256KKV 缓存(57.61–58.9 GiBVmRSS)锁定在内存中,零交换。默认情况下,每层全部 6 个路由专家(Top-6)均被评估,不进行剪枝。 - CPU 缓存与 SIMD 内核补丁(
+77%预填充,+53%解码): 在提示预填充期间,将单列量化矩阵-向量循环替换为 4 级寄存器(ZMMAVX-512BW)+ L1D(32 KB)+ L2(1 MB)+ L3(64 MB)多列({8,4,3,2})分块调度(16 核 Zen 5 上为25.0 -> 44.36 tok/s)、寄存器驻留MQA8FlashAttention,以及非临时_MM_HINT_NTAMoE 流式传输,使冷专家权重不会从 L3 中逐出热 KV 缓存行。 - 自推测草稿与即时智能体上下文恢复: 将
1.64 MBL2/L3 Zobrist n-gram 草稿器(Stockfish-PVS v2)与/dev/shmKV 槽快照(40 工具 Claude Code 提示的恢复时间为13.1–32.6 ms)以及针对deepseek4循环/MLA 状态的 $O(1)$ 推测回滚修复配对使用。
量化与内存明细
为预先回答最常见的技术问题——精确位宽(bpw)、基础检查点,以及每个 GGUF 中压缩的内容:
| 检查点 | 总 / 激活参数 | 基础来源 | 磁盘大小(GiB / GB) |
有效 bpw |
逐层张量分配 |
|---|---|---|---|---|---|
Nemotron-3.5-30B-A3B-Q4_0 |
30.2B / 3.0B |
BF16 官方 | 17.59 GiB (18.89 GB) |
4.50 bpw |
MoE + 注意力采用标准 Q4_0;F32 归一化与 SSM 卷积/衰减 |
Nemotron-3.5-30B-A3B-MXFP4 |
30.2B / 3.0B |
BF16 官方 | 15.95 GiB (17.13 GB) |
4.25 bpw |
路由 MoE 上采用 GGML_TYPE_MXFP4(E2M1 + 共享指数);主干采用 Q4_0/Q8_0 |
Nemotron-3.5-30B-A3B-Fractal-64 |
30.2B / 3.0B |
BF16 官方 | 14.35 GiB (15.41 GB) |
3.75 bpw |
注意力、Mamba-2 SSM 与共享专家采用 Q4_0/Q8_0/F32;冷路由 MoE 专家采用混合 Q4_0 + Fractal-64(Q2_0,64 权重块 + BF16 缩放)。在 benchmarks/eval_quality_and_tools.py 上得分为 100/100。 |
DeepSeek-V4-Flash-0731-Fractal |
284.33B / 13.17B |
Unsloth UD-IQ1_S(76.87 GiB / 82.5 GB) |
56.56 GiB (60.73 GB) |
1.71 bpw |
• 嵌入、Dense L0、43 个共享专家(shexp)、MLA kv_a / q_a / wkv_b:保留在 Q4_K / Q5_K / F32 中• MLA wq_b 与 attn_output(wo_a/wo_b):转码为 Fractal-64(GGML_TYPE_Q2_0、3.75 bpw、30B/64 块,含 8 个子缩放与 BF16 缩放)• 256 个路由 MoE 专家( ffn_*_exps):主要为 IQ1_S(1.5625 bpw),并采用解析式 SwiGLU-H2 二阶缩放匹配;敏感边界层保留在 IQ2_XXS(2.06 bpw)与 IQ1_M(1.75 bpw)中(-20.31 GiB 对比 UD-IQ1_S) |
关于 MoE 专家路由的说明(
Top-K):默认情况下(v2.4.0 Lossless),DeepSeek-V4-Flash在每一层评估 全部 6 个路由专家 + 1 个共享专家(Top-6),且不丢弃任何专家(1.00000与未打补丁的运行时在同一检查点上的 logit 余弦相似度)。设置LLAMA_MOE_TOP_K=5或4是可选的运行时标志,供希望以少量困惑度差异换取更高解码吞吐量的用户使用。
快速开始
Linux 与 macOS(自动化安装与聊天)
git clone https://github.com/synchopate/llama-modchip.git
cd llama-modchip
./modchip chat
直接运行(预编译 Linux x86_64 二进制 + Hugging Face .gguf)
兼容性说明(
GGML_TYPE_Q2_0 = 40):Fractal-64模型使用自定义 block-64BF16-scale 张量(GGML_TYPE_Q2_0,类型 ID40)以及deepseek4/Stockfish-PVS内核。未打补丁的llama.cpp、Ollama 或 LM Studio 二进制会以unknown tensor type 40拒绝它们。请使用上述./modchip或 Hugging Face 仓库及 GitHub Releasev2.4.0中包含的独立预编译二进制(llama-server-modchip-linux-x86_64,零外部.so依赖):
# 1. For 30B Nemotron-3.5-A3B (14.35 GiB — runs in 16–32 GB RAM at 25–60.4 tok/s):
hf download Synchopate/NVIDIA-Nemotron-3.5-30B-A3B-Fractal-64-CPU-GGUF \
  llama-server-modchip-linux-x86_64 NVIDIA-Nemotron-3.5-30B-A3B-Fractal-64.gguf --local-dir .
chmod +x llama-server-modchip-linux-x86_64
./llama-server-modchip-linux-x86_64 -m NVIDIA-Nemotron-3.5-30B-A3B-Fractal-64.gguf -c 262144 -t 16 --port 8080

# 2. For 284B DeepSeek-V4-Flash (56.56 GiB — fits in 64 GB RAM at 9.1–14.7 tok/s):
hf download Synchopate/DeepSeek-V4-Flash-0731-Fractal-64GB-CPU-GGUF --local-dir ./dsv4
chmod +x ./dsv4/llama-server-modchip-linux-x86_64
./dsv4/llama-server-modchip-linux-x86_64 -m ./dsv4/DeepSeek-V4-Flash-0731-Fractal-00001-of-00003.gguf -c 32768 -t 16 -fa on --port 8080
Windows 10/11(GPU + CPU 混合 MoE 包)
打开 windows/ 并运行 windows/AVVIA_MODCHIP.bat(或在 Git Bash 中运行 ./modchip start)。它会检测物理 CPU 核心、空闲 RAM 和 GPU VRAM(nvidia-smi),下载 llama.cpp CUDA 12.4 / Vulkan 二进制,计算 --n-cpu-moe 拆分,并启动 Web 聊天 UI(http://127.0.0.1:8080)。
./modchip 命令 |
描述 |
|---|---|
./modchip chat |
交互式终端聊天,实时显示 tok/s、TTFT 和 Stockfish-PVS 接受遥测 |
./modchip web |
打开深色模式 Web 聊天与实时遥测 HUD(http://127.0.0.1:8787) |
./modchip bench |
运行 30 秒两阶段速度测试,并打印可分享的 CPU 基准测试记分卡 |
./modchip claude |
启动 Claude Code CLI(40 tools),连接到本地 256K 引擎(18.9–32.6 ms 热恢复) |
./modchip eval |
运行可复现的 100 分质量、工具调用、编码与 8.5K 针检索门禁 |
./modchip quantize |
将 BF16/Q4_0/UD-IQ1_S GGUF 转码为 Fractal-64(3.75 bpw)或 Fractal-MXFP4(4.25 bpw) |
./modchip status / stop |
检查 CPU 就绪状态、2MB HugePages 和 /dev/shm IPC,或停止后台服务 |
硬件就绪检查(无需下载模型)
curl -sL https://raw.githubusercontent.com/synchopate/llama-modchip/main/scripts/check_cpu_readiness.py | python3
通过 GitHub Benchmark Issue 或 GitHub Discussions 提交你的终端记分卡,将你的 CPU 添加到下方排行榜。
支持的模型与模型特定优化
每个模型系列都有专门的技术指南,包含数学推导、算子级延迟剖析和质量门禁基准测试:
| 模型系列 | 总参数 / 激活参数 | 磁盘(GGUF)与 256K RAM(VmRSS) |
已实现的关键优化 | 已验证速度(16C Zen 5 / 混合) |
详细指南 |
|---|---|---|---|---|---|
NVIDIA-Nemotron-3.5-30B-A3B( Fractal-64 / MXFP4 / Q4_0) |
30.2B / 3.0B( 23 SSM + 23 MoE + 6 GQA) |
14.35 – 17.59 GiB( 15.4 – 21.7 GiB RSS) |
• Block-64 Fractal-64(3.75 bpw)与 MXFP4(4.25 bpw)(100/100 质量门禁)• Stockfish-PVS v2 (M=7) + RouteCrack(1.64 MB L2/L3 Zobrist TT)• 432 MB 256K EAKV(Q8_0/Q4_0) + _MM_HINT_NTA L3 隔离• 18.9 ms /dev/shm Slot-0 恢复(~6,800x 更快的热轮次) |
25.0 – 60.4 tok/s (0 GPU)80.8 tok/s (Vulkan Hybrid)111.6 tok/s (Threadripper) |
Nemotron 指南 |
DeepSeek-V4-Flash-0731-Fractal( SwiGLU-H2 + Fractal-64) |
284.33B / 13.17B( 43L MLA + 256+1s MoE) |
56.56 GiB (-20.3 GiB)( 58.9 GiB RSS — 可容纳于 64 GB) |
• 解析式二阶 SwiGLU-H2 MoE + Fractal-64 MLA 转码• 4 级寄存器( ZMM AVX-512BW)+ L1D(32KB)+ L2(1MB)+ L3(64MB)多列({8,4,3,2})预填充分块(25.0 -> 44.36 tok/s,+77%)• 寄存器驻留 AVX-512 MQA8 FlashAttention(2.0x)+ AVX-512 quantize_row_q8_K• 可选 $L_2$-Quadrature MoE 剪枝 + L1 本地 Gate-First SwiGLU( 10.74 tok/s)• wo_b * wo_a 的 SVD(99.82% 在 -25% 秩下的 CosSim)与 $O(1)$ 回滚修复 |
43.2–44.4 tok/s (预填充)9.06–9.95 tok/s (无损 Top-6)9.87–10.15 tok/s (Top-5 L2)10.41–10.74 tok/s (Top-4+SwiGLU)11.5–14.7 tok/s (PVS) |
DeepSeek-V4 指南 |
Qwen3-30B-A3B & Qwen3-14B( Q3_K_M / Q4_K_M) |
30.5B / 3.3B -> 1.7B( 48L GQA,128 exp) |
13.70 – 17.28 GiB( 14.5 – 19.4 GiB RSS) |
• 保范动态 MoE Top-K(8 -> 4,+38.5% 解码)• 3:1 交错 SWA 安全锁( LLAMA_SWA_STRIDE=4)• Windows 11 GB VRAM + 16 GB RAM 混合拆分(--n-cpu-moe N) |
34.80 tok/s(0 GPU Top-4)50–58 tok/s(14B RTX 2080 Ti) |
架构 §3.9 |
NVIDIA-Nemotron-H-8B-128K( Q8_0 / Q4_K_M) |
8.0B Dense( 48 SSM + 4 GQA) |
4.60 – 8.00 GiB( 210 MB KV @ 128K) |
• 48 层 Mamba-2 SSM 恒定内存主干 • 在 8–11 GB 显卡上 100% GPU VRAM 驻留(0 GB 系统 RAM) |
100+ tok/s (RTX 2080 Ti)147.6 tok/s (CPU pp512) |
Nemotron 指南 |
支持的芯片与处理器特定优化
每种处理器和 GPU 混合的微架构细节与调优标志记录在 docs/HARDWARE_OPTIMIZATIONS.md 中:
| 处理器 / 平台 | 已验证硬件 | 已启用的硬件特定优化 | 平台指南与脚本 |
|---|---|---|---|
AMD Zen 5(Desktop / Mobile / Server) |
Ryzen 9 9955HX, 9950X, EPYC 9005 Turin |
• 单周期 512 位 AVX-512(VPDPBUSD、VPRORVQ、VBMI、BF16)• 多头 wo_a 投影上的 48 KB L1D 3D 分块(TILE_I0=64)• _MM_HINT_NTA Victim-L3 隔离(64 MB) + 2MB THP(6.14 GB L2 STLB) |
硬件指南 §2.1install.sh |
AMD Zen 4 多 CCD(Threadripper / EPYC) |
Threadripper PRO 7985WX(64C/128T、8 CCDs、256 MB L3) |
• 动态 sysfs L3 CCD 拓扑发现(scripts/llama_modchip.py)• 确定性 4C/CCD 步幅(-t 32):避免 Infinity Fabric 饱和(+54% 比 -t 64 更快) |
硬件指南 §2.2 Issue #1 |
| AMD 3D V-Cache + Radeon Vulkan 混合 | Ryzen 9 7945HX3D(128 MB L3)+ RX 9070 XT 16GB(RADV) |
• 张量角色拆分(-ngl 99 --n-cpu-moe N --load-mode none)• 原生 Vulkan SSM_SCAN + Fractal-MXFP4(15.2 GB)GPU 着色器(80.8 tok/s 在 256K 时) |
硬件指南 §2.3FAQ.md Q8 |
Intel / AMD + NVIDIA RTX(Windows 10/11) |
Core i9-9900K / 14900K + RTX 2080 Ti 11GB / 3090 / 4090 |
• 单周期 AVX2 vpsllvd + vpmaddwd 子尺度融合• 实时 VRAM --n-cpu-moe 求解器(550 MB WDDM 保留) + _WIN32 CreateFileMappingA |
Windows 指南windows/modchip_win.ps1 |
Apple Silicon(M1 / M2 / M3 / M4) |
Apple M4 Max (16C+40C, 64 GB), M4 Pro (14C+20C, 24 GB) |
• 零拷贝统一内存 Metal 着色器 + ARM64 NEON/AMX(M4 Max 上 238.9 GB/s DRAM 带宽)• 0-Swap 128K–256K 上下文预算(384 MB KV)+ Stockfish-PVS v2 |
Apple Silicon 指南 Issue #8 |
ARM64 云与边缘(AWS Graviton / Ampere) |
AWS Graviton3 m7g.2xlarge(8 vCPU Neoverse-V1,32 MB L3) |
• ARMv8.4-A DotProd(SDOT)+ 256 位 SVE + 每核 1 vCPU 绑定(-t 8)• 32 MB 系统级缓存(SLC)保留(44.97 tok/s 解码) |
硬件指南 §1 Issue #2 |
AMD Zen 4 紧凑型迷你主机(Linux) |
Ryzen 7 8745H / 8745HS(8C/16T,16 MB L3 + Radeon 780M) |
• AVX-512 VNNI + 16 MB L3 窗口自动调优(19.48–23.38 tok/s 在 96 GB DDR5-5600 上)• 可选 Radeon 780M UMA iGPU 卸载 |
Fedora 指南 Issue #9 |
头条基准测试:纯 CPU 与混合摘要
1. DeepSeek-V4-Flash 284B(13.17B 激活)在 64 GB Zen 5 CPU 上(AMD Ryzen 9 9955HX,0 GPUs)
算子级性能分析与数学推导见 docs/DEEPSEEK_V4_OPTIMIZATIONS.md(概率和 KL 散度相对于在 56.56 GiB Fractal 检查点上未打补丁的 Top-6 执行进行测量):
运行时配置(DeepSeek-V4-Flash,256K 上下文) |
预填充(pp512) |
纯解码(N=1) |
使用 Stockfish-PVS |
Logit 余弦相似度 | KL 散度($\Delta$ PPL) | Top-1 / Top-3 匹配 |
|---|---|---|---|---|---|---|
未打补丁的 UD-IQ1_S(76.87 GiB / 82.5 GB) |
64 GB 上 OOM / 交换 | 5.91 tok/s (169.3 ms) |
不适用 (回滚 Bug) | 1.00000 (参考) |
0.0000 (0.00%) |
100% / 100% |
1. v2.4.0 无损(Top-6 所有层,默认,56.56 GiB) |
43.16 – 44.36 tok/s (+77.1%) |
9.06 – 9.95 tok/s |
11.5 – 14.7 tok/s |
1.00000 |
0.0000(0.00% 位精确) |
100% / 100% |
2. v2.4.0 最佳点(Top-5 在 il >= 3 上,$L_2$ 正交) |
43.16 – 44.36 tok/s |
9.68 – 9.87 tok/s |
12.2 – 15.1 tok/s |
0.99714 |
0.0042 nats(+0.42% PPL) |
95.8% / 100% |
3. v2.4.0 Top-5 L2 + 门控优先 SwiGLU(80/128 $L_2$) |
43.16 – 44.36 tok/s |
10.15 tok/s (98.5 ms) |
12.8 – 15.6 tok/s |
0.99385 |
0.0531 nats |
100% / 100% |
4. v2.4.0 Turbo 10+(Top-4 L2 + 门控优先 SwiGLU) |
43.16 – 44.36 tok/s |
10.12 – 10.74 tok/s (93.2 ms) |
13.0 – 16.0 tok/s |
0.99126 |
0.0281 – 0.0694 nats |
100% / 100% |
2. NVIDIA-Nemotron-3.5-30B-A3B(3.0B 激活)在 256K 上下文(AMD Ryzen 9 9955HX,0 GPUs)
完整消融表和 100/100 质量门报告见 docs/NEMOTRON_OPTIMIZATIONS.md:
| 量化配置 | 磁盘大小 | 空闲 VmRSS(256K) |
质量门(100 分) |
预填充(pp512) |
基础解码(N=1) |
Stockfish-PVS v2 (M=7) 重构 |
|---|---|---|---|---|---|---|
Baseline-Q4_0(4.50 bpw 官方 GGUF) |
17.59 GiB |
21.41 GiB |
100.0 / 100.0 |
241.0 – 306.8 tok/s |
19.54 tok/s |
40.91 avg / 45.43 peak tok/s |
Fractal-MXFP4 (4.25 bpw) |
15.95 GiB |
17.46 GiB |
100.0 / 100.0 |
241.0 – 306.8 tok/s |
26.08 tok/s (+33.5%) |
48.39 avg / 60.40 peak tok/s (80.8 Vulkan) |
Fractal-64-BF16 (3.75 bpw) |
14.35 GiB |
15.40 GiB (-6.01 GiB) |
100.0 / 100.0 |
241.0 – 306.8 tok/s |
25.02 tok/s (+28.0%) |
48.39 avg / 60.40 peak tok/s (96.4% 加速) |
社区 CPU 与混合排行榜
运行 ./modchip bench(或在 Windows 上运行 windows\BENCHMARK_PC.bat)并 提交你的记分卡(GitHub Issue)。
硬件平台(CPU / SoC / Hybrid) |
核心数 / 缓存 | 内存 | 预填充(tok/s) |
解码 — 散文 / C++20 | 解码 — Stockfish M=7 突发 |
配置与贡献者 |
|---|---|---|---|---|---|---|
AMD Threadripper PRO 7985WX(Zen 4) |
64C/128T(8 CCDs,256 MB L3) |
256 GB 8 通道 DDR5-6000(0 GPU) |
386.00 (-t 32) |
73.84 – 80.14 tok/s (70.0% 准确率) |
111.62 tok/s 热 / 80.14 冷 (-t 32 4C/CCD) |
@aifartist(Issue #1) |
AMD Ryzen 9 7945HX3D + RX 9070 XT(Hybrid) |
16C/32T(128 MB 3D V-Cache)+ 16 GB Vulkan |
94 GB DDR5 + 16 GB VRAM |
563.00 (256K 上下文) |
75.10 tok/s (MXFP4 15.2GB) |
80.80 tok/s (Vulkan SSM_SCAN + MXFP4 MoE) |
Community (RADV/Vulkan) (FAQ.md) |
AMD Ryzen 9 9955HX(Zen 5) |
16C/32T(2 CCDs,64 MB L3) |
64 GB DDR5(0 GPU) |
241.0 (峰值 306.8) |
25.02 – 34.5 tok/s (Fractal-64 / MXFP4) |
48.39 avg / 60.40 peak (len 6.90) |
@synchopate (docs/NEMOTRON_OPTIMIZATIONS.md) |
Apple M4 Max(16C CPU + 40C GPU) |
16C (ARM64 NEON + 40C Metal) |
64 GB LPDDR5X-8533(238.9 GB/s 带宽) |
~451.0 (审计) |
49.2 – 57.7 tok/s (散文 / 代码) |
70.9 – 120.0 tok/s (Agent / 重构) |
@jbeckman1974(Issue #8) |
Apple M4 Pro(14-Core SoC) |
14C CPU + 20C Metal |
24 GB 统一内存(0 Swap) |
256.0 – 549.0 |
47.0 – 48.0 tok/s (128K) |
49.0+ tok/s |
@jarorosFork (apple-silicon/) |
AWS Graviton3 m7g.2xlarge(ARM64 Neoverse-V1) |
8 vCPU(32 MB L3,SVE-256) |
31 GB DDR5(0 GPU) |
101.67 (-t 8) |
41.05 tok/s (C++20) |
44.97 tok/s (重构) |
@gerchik(Issue #2) |
AMD EPYC 7402P(Zen 2 Rome · AVX2-only) |
24C/48T(8 CCDs,128 MB L3) |
128 GB 8 通道 DDR4(0 GPU) |
158.73 (-t 24) |
27.29 tok/s (C++20,567 ms TTFT) |
31.22 tok/s (冷运行 1,66.7% 准确率) |
@AdamKlob(Issue #6) |
AMD Ryzen 9 9950X(Zen 5 Desktop) |
16C/32T(2 CCDs,64 MB L3) |
64 GB DDR5-6800(0 GPU) |
135.64 (v2.1 Q4_0) |
20.78 tok/s (C++20,526 ms TTFT) |
24.67 tok/s (冷运行 1,66.5% 准确率) |
@nadams(Issue #5) |
AMD Ryzen 7 8745H 配 Radeon 780M(Zen 4) |
8C/16T(16 MB L3,AVX-512) |
96 GB DDR5-5600(0 GPU,Arch) |
128.81 (-t 8) |
19.48 tok/s (C++20,686 ms TTFT) |
23.38 tok/s (69.8% PVS 准确率) |
@arch-btw(Issue #9) |
AMD Ryzen 5 7430U(Zen 3 Mobile 15W) |
6C/12T(16 MB L3,AVX2) |
32 GB DDR4-3200(0 GPU,Pop!_OS) |
59.03 (-t 6) |
13.03 tok/s (C++20,2072 ms TTFT) |
15.57 tok/s (68.3% PVS 准确率) |
@armadillu(Issue #12) |
AMD Ryzen 7 5700U(Zen 2 Mobile 15W) |
8C/16T(8 MB L3,AVX2) |
64 GB DDR4(0 GPU,Debian) |
42.80 (-t 8) |
12.92 tok/s (C++20,1720 ms TTFT) |
14.35 tok/s (66.5% PVS 准确率) |
@JamesStallings(Issue #10) |
Intel Core i9-11950H(Tiger Lake-H) |
8C/16T(24 MB L3,AVX-512) |
128 GB DDR4-3200(0 GPU,Fedora) |
85.39 (-t 8) |
10.76 tok/s (C++20,1106 ms TTFT) |
13.37 tok/s (69.8% PVS 准确率) |
@ELO-I(Issue #11) |
Windows 11 混合模式(i9-9900K + RTX 2080 Ti 11GB) |
8C/16T(16 MB L3)+ 11 GB CUDA |
16 GB DDR4 + 11 GB GDDR6 |
自动 CUDA 12.4 | 50–58 tok/s (14B)/ 30B 混合模式 |
100+ tok/s (Nemotron-H-8B 128K) |
windows/ |
AMD Ryzen 7 8745HS(GEEKOM A8) |
8C/16T(16 MB L3) |
64 GB DDR5-5600 |
已在 Fedora 44 上验证 | 已验证(ngram) |
已验证(CPU & 780M) |
@jarorosFork (fedora/) |
Ryzen 9 9955HX 上的 DeepSeek-V4-Flash 284B |
16C/32T(2 CCDs,64 MB L3) |
64 GB DDR5(58.9 GiB RSS @ 256K) |
43.16 – 44.36 tok/s (32.6 ms Slot-0) |
9.06 – 10.74 tok/s (13.17B 活跃) |
11.50 – 14.69 tok/s (94.5% PVS 准确率) |
@synchopate (docs/DEEPSEEK_V4_OPTIMIZATIONS.md) |
仓库结构与手动 CMake 构建说明
llama-modchip/
├── modchip                                    # Unified CLI (setup | start | chat | bench | eval | quantize | web | claude | stop)
├── install.sh                                 # Automated Installer (Linux)
├── README.md / ARCHITECTURE.md / FAQ.md       # Overview, Full Mathematical Paper & Engineering FAQ
├── RELEASE_NOTES.md                           # v2.4.0 Release Notes
├── docs/
│   ├── NEMOTRON_OPTIMIZATIONS.md              # Deep-dive on Nemotron-3.5-30B-A3B & Nemotron-H-8B optimizations
│   ├── DEEPSEEK_V4_OPTIMIZATIONS.md           # Deep-dive on DeepSeek-V4-Flash 284B profiling, SVD & L2-quadrature MoE
│   └── HARDWARE_OPTIMIZATIONS.md              # Chip-by-chip optimizations (Zen 5, Threadripper, Vulkan, CUDA, Metal, ARM64)
├── patches/
│   ├── deepseek-v4-flash-fractal-256k.patch   # Unified v2.4.0 patch (DeepSeek-V4-Flash 284B + Nemotron-3.5 30B, Linux/macOS/Windows)
│   └── zen5-nemotron-256k-optimizations.patch # Standalone ggml/llama core patch for Nemotron-3.5
├── windows/                                   # Windows 10/11 Hybrid GPU+CPU MoE Pack (AVVIA_MODCHIP.bat, modchip_win.ps1)
├── apple-silicon/                             # Apple M4 Pro (24 GB) Metal setup & 128K benchmarks
├── fedora/                                    # Fedora 44 / AMD Ryzen 7 8745HS (GEEKOM A8) all-in-one script
├── speculative/                               # RouteCrack + Stockfish-PVS v2 (rc_stockfish.h, ngram-map.cpp)
├── benchmarks/                                # eval_quality_and_tools.py (100-pt Quality Gate) & results/*.json
├── gateway/sse_gateway.py                     # Agentic SSE Proxy + Compact Tool Table + Dark-Mode Web Chat HUD (:8787)
└── scripts/                                   # build_fractal_moe_gguf.sh, transcode_dsv4.{c,py}, chat.py, llama_modchip.py
Nemotron 深入解析(docs/NEMOTRON_OPTIMIZATIONS.md) · DeepSeek-V4 284B 深入解析(docs/DEEPSEEK_V4_OPTIMIZATIONS.md) · 硬件与芯片矩阵(docs/HARDWARE_OPTIMIZATIONS.md) · 完整论文(ARCHITECTURE.md) · 常见问题(FAQ.md)