讨论精选
WithoutReason1729 (0↑): 你的帖子越来越受欢迎,我们已在 Discord 上推荐了它! 快来查看吧!
你的贡献还为你赢得了一个特殊徽章。我们感谢你的帖子!
我是机器人,此操作自动执行。
SrijSriv211 (0↑): 这看起来太棒了!!期待 2B 模型
LA_rent_Aficionado (0↑): 在 v3 中将偏见报告更新为种族偏见,全世界都想知道…… 这东西可能比 Grok 更种族主义
使用160GB历史文本训练LLM,探索模型在特定时代语料下的表现与偏见。
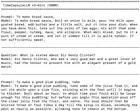
探讨历史文本训练可能带来的种族偏见问题,引发对AI伦理的思考。
深入阅读
讨论精选
WithoutReason1729 (0↑): 你的帖子越来越受欢迎,我们已在 Discord 上推荐了它! 快来查看吧!
你的贡献还为你赢得了一个特殊徽章。我们感谢你的帖子!
我是机器人,此操作自动执行。
SrijSriv211 (0↑): 这看起来太棒了!!期待 2B 模型
LA_rent_Aficionado (0↑): 在 v3 中将偏见报告更新为种族偏见,全世界都想知道…… 这东西可能比 Grok 更种族主义