现代大语言模型(LLM)通过预训练和上下文学习(ICL)取得了令人瞩目的性能。然而,一旦部署,它们在很大程度上保持静态,以固定的知识截止日期运行,这使它们无法获得长期能力或适应新信息。
虽然用新数据更新模型似乎是显而易见的解决方案,但持续的参更新往往会触发灾难性遗忘,这是一个根本性问题:学习新任务会严重降低在先前学习任务上的性能。或者,严格依赖ICL会将知识保留限制在即时上下文窗口内:一旦上下文会话结束,所获得的短期信息就会被遗忘。
受人类大脑在休息期间如何处理和稳定记忆的启发,我们在持续学习中引入了睡眠框架:一种学习范式,为大语言模型(LLM)配备连续的周期性生命周期,使它们能够持续学习,将脆弱的短期上下文巩固为稳定的长期参数。借助这一框架,我们证明,在主动交互和离线记忆巩固之间交替,可使LLM持续获取新事实、保留长达1000万token的长上下文知识,并提升复杂推理能力。
重新思考机器学习:主动(清醒)阶段与睡眠阶段
传统机器学习依赖于训练与推理之间的严格分离。在持续学习框架中,这种区分变得人为化;智能体必须不断学习、适应和处理信息。
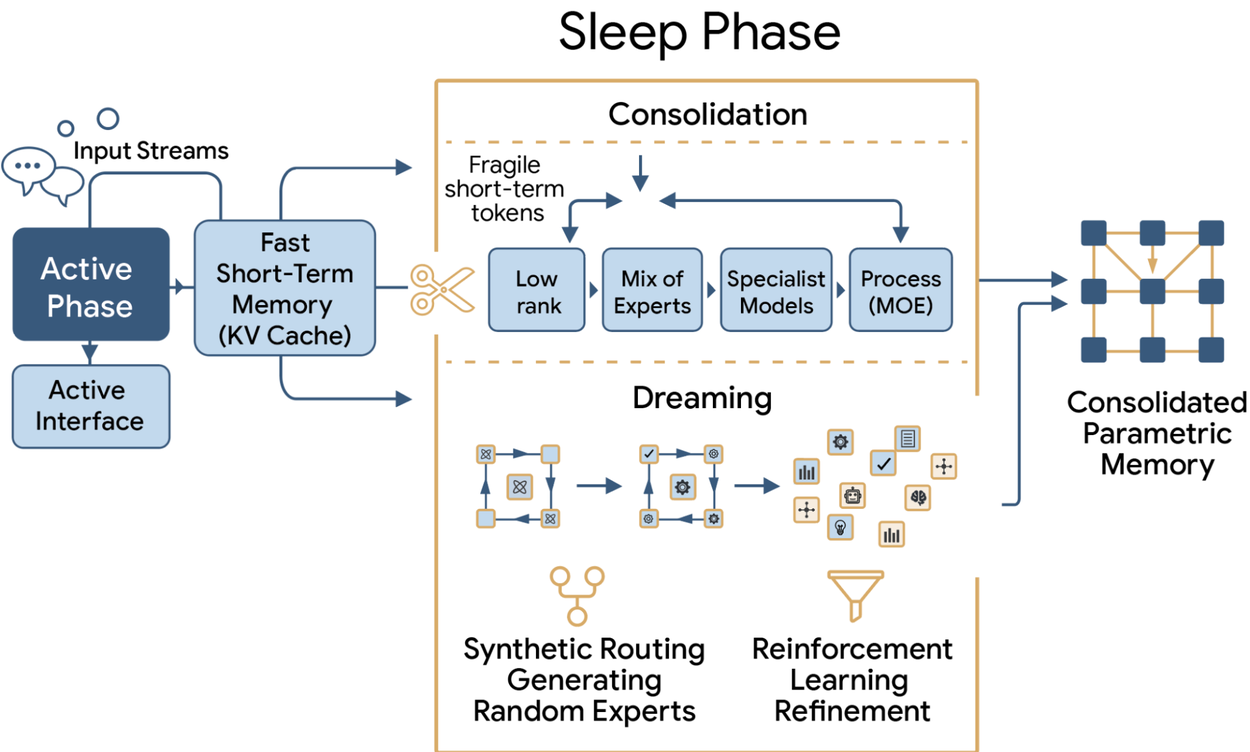
在睡眠范式下,LLM在两种主要状态之间运行:
- 主动(清醒)阶段:模型主动接收、处理输入并与之交互,将临时信息存储在快速、短期的记忆组件中。
- 睡眠阶段:模型暂停处理新输入,并将内部计算转向记忆巩固和自我改进。
虽然“睡眠”“做梦”和“自我改进”等术语借自神经科学,但我们的框架完全在固定的模型架构和人工定义的训练规则内运行。在离线睡眠阶段,模型解锁预分配的多专家混合(MoE)记忆块,并使用自生成的练习示例更新其数值权重。这一自动化后训练循环帮助已部署的模型吸收新事实并提升其推理准确性,同时保持其核心代码库和设计不变。
睡眠过程的关键组件
睡眠范式通过两个阶段解决灾难性遗忘和持续适应问题:记忆巩固和做梦。
1. 记忆巩固
在人类大脑中,非快速眼动(NREM)慢波睡眠通过抽象和蒸馏将脆弱的记忆巩固为长期结构。我们提出的睡眠框架通过两个关键技术机制镜像了这一自然现象:
- 参数扩展与连续记忆层次结构:为防止灾难性遗忘,模型在睡眠期间动态扩展其容量。使用多专家混合(MoE)和Hope架构,新解锁的低秩专家被集成到稳定的低频记忆块中,以存储传入知识而不干扰较旧的参数。
- 知识播种(向上蒸馏):存储在高频层(例如上下文记忆)中的脆弱短期记忆被转移到新扩展的长期参数中。这是通过广义知识蒸馏(GKD)结合基于强化学习(RL)的模仿学习实现的:
- 同策略蒸馏:扩展后的学生模型从在自采样序列上生成的教师分布中学习token特定的反馈。
- 学习模仿(LTI):在完成教师生成文本的前缀时,学生模型根据语义和绝对相似度(Levenshtein距离)获得奖励。
- 突触修剪:一旦向低频模块的记忆巩固完成,高频临时参数被重置,为未来的主动会话释放容量。
2. 用于自我改进的做梦
在快速眼动睡眠期间,人类大脑主动模拟场景、巩固情感/语义连接并探索新的神经通路。与此镜像,在“做梦阶段”,睡眠框架实现了一个自主自我改进循环:
- 随机专家选择:在合成数据生成期间,MoE路由器随机激活非标准专家。这迫使模型混合不同领域的知识并发现潜在模式。
- 精选排练:模型生成合成训练样本(“梦”),并使用基于梯度的数据选择对其进行过滤,以优先选择最有可能提升整体模型能力的样本。
- RL精炼:模型对评分最高的梦样本进行监督微调,并评估生成是否改善了下游任务的性能。
理论基础
除了实证结果之外,我们的睡眠范式还建立在一个理论之上,该理论阐明了为什么其两个阶段(记忆巩固和做梦)能够支持持续学习,而不是简单地以新知识换取旧能力。
对于记忆巩固,分析表明知识播种可以理解为一个结构化的低秩压缩问题。模型不被要求将短期痕迹的每个细节复制到其参数中。相反,它识别出一组紧凑的方向,这些方向最能同时保留模型自身的同策略行为和由学习目标所奖励的语义质量。
这一视角解释了两种信号的互补作用:同策略蒸馏使巩固与模型在推理时实际产生的轨迹对齐,减少了仅基于教师生成分布训练时可能出现的失配;同时,语义奖励改变了值得保留的内容,优先考虑保留含义和任务相关行为的方向,而不仅仅是匹配词元概率。参数扩展则提供了写入这些选定记忆所需的能力,而不会覆盖先前已巩固的知识。
对于做梦,该理论将随机专家激活和基于奖励的样本选择描述为改善学习几何的机制。注入不同的MoE拓宽了在合成生成过程中探索的梯度方向集合,使模型接触到比仅由其常规清醒时数据所诱导的更丰富的更新集合。基于梯度的过滤随后强调携带最有用的学习信号的合成经验,加强信息丰富的方向,同时保留底层梯度空间的结构。
这些步骤共同产生了一个更平衡的优化景观:学习较少被少数方向主导,梯度条件更好,模型在精炼其能力时能够取得更稳定的进展。在这一观点下,做梦不仅仅是自生成的数据增强;它是一个有意的过程,用于多样化、选择和巩固模型自我改进所通过的更新。
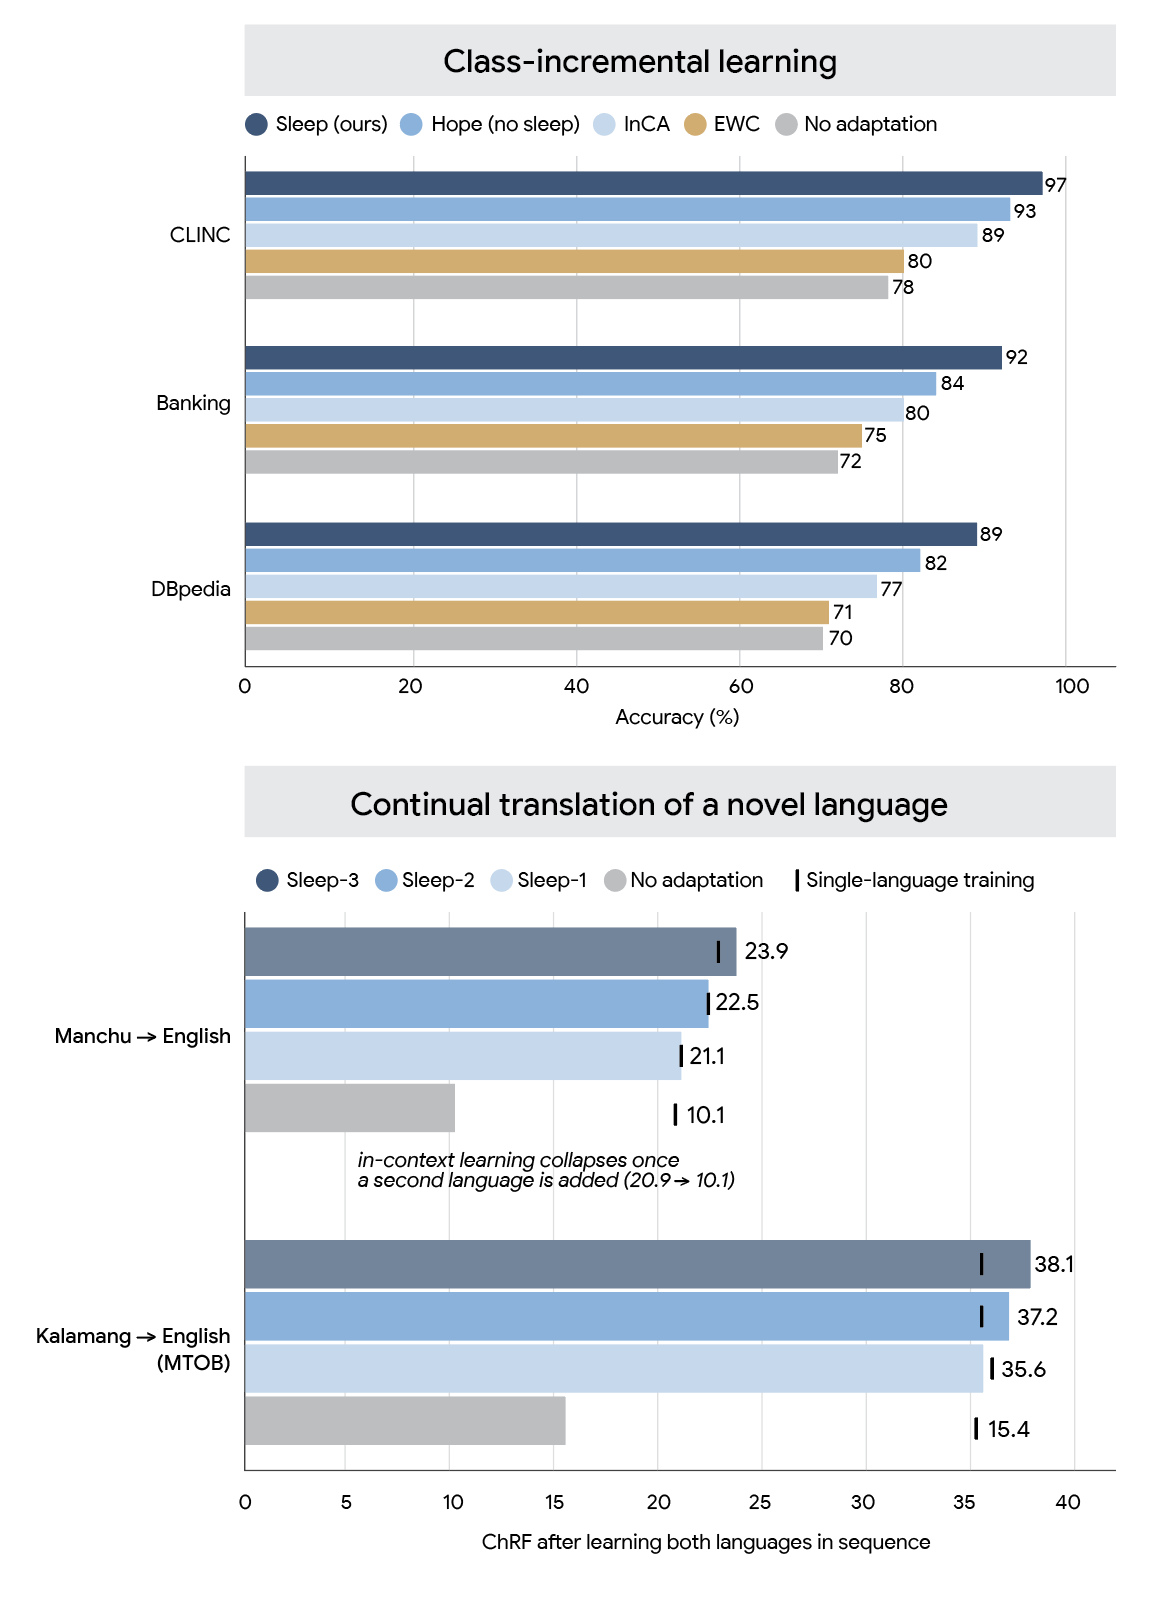
对于持续翻译,在满语和Kalamang等未见语言中,sleep框架在多阶段评估中保持了接近零的性能下降,而ICL、Cartridges和监督微调(SFT)等标准基线在顺序学习过程中遭受了严重的灾难性遗忘。
在BABILong基准测试的长上下文理解中,我们的睡眠方法展示了高达10M词元的近乎完美的扩展,通过使用睡眠时巩固将长上下文信息直接压缩到参数记忆中,优于GPT-4和Titans等强基线。
对于在SQuAD和持续预训练(CPT)上评估的事实知识整合,我们的睡眠方法在单任务上达到48.9%,在CPT评估上达到46.2%,优于包括基础模型、SFT和自适应语言模型(SEAL)在内的基线方法,成功整合了新的事实信息而不降低现有模型表示。
最后,在包括AIME 24/25和HMMT 25在内的数学推理基准测试中,睡眠增强的基础模型分别达到了79.2%、69.0%和46.1%的准确率分数。这优于SFT、组相对策略优化(GRPO)和同策略自蒸馏(OPSD)等基线,表明将记忆巩固与模仿学习配对可驱动卓越的推理性能。
结论
我们的睡眠范式为自主、持续学习的AI系统提供了一条路径。通过超越静态预训练和脆弱的上下文窗口,在主动学习和离线休息之间交替,使LLM能够保留短期记忆,将新技能抽象为长期参数结构,并在没有灾难性遗忘的情况下持续自我改进。
致谢
本研究由Ali Behrouz(Google和康奈尔大学)、Farnoosh Hashemi(康奈尔大学)、Adel Javanmard(Google和南加州大学)和Vahab Mirrokni进行。我们感谢Yuan Deng和Corinna Cortes审阅本工作并提供宝贵建议。我们还感谢Mark Simborg、Kimberly Schwede和Tim Herrmann在撰写本博客文章方面的帮助。