随着 GPU 集群规模扩大,运维工作横跨计算、网络、硬件和调度。站点可靠性工程师(SRE)往往需要查看多个仪表盘,才能找出训练性能下降的原因。如果一组 AI 智能体能够通过一个界面完成这种关联分析,会怎样?
NVIDIA 开发了 AI Factory Operations Agent,用于简化其内部 NVIDIA DGX SuperPOD 的运维,并减少 NVIDIA SRE 的人工投入。子智能体通过 Model Context Protocol(MCP)通信,任何组织都可以采用该协议来最大化 AI 工厂的正常运行时间和性能。
AI Factory Operations Agent 不需要 SRE 分别检查 AI 工厂软件和硬件的每一层,而是针对不同的运维领域使用专门的智能体。在生产环境中,这些智能体检测故障、跨层关联根因,并通过聊天界面给出清晰的建议。SRE 可以使用自然语言与任何智能体交互、在调查之间切换,并跟踪每一项操作以便审计。
本博客将分享经验教训,并教你如何在自己的工作流中实施 AI Factory Operations Agent。
架构:使用 NVIDIA 蓝图和开放模型
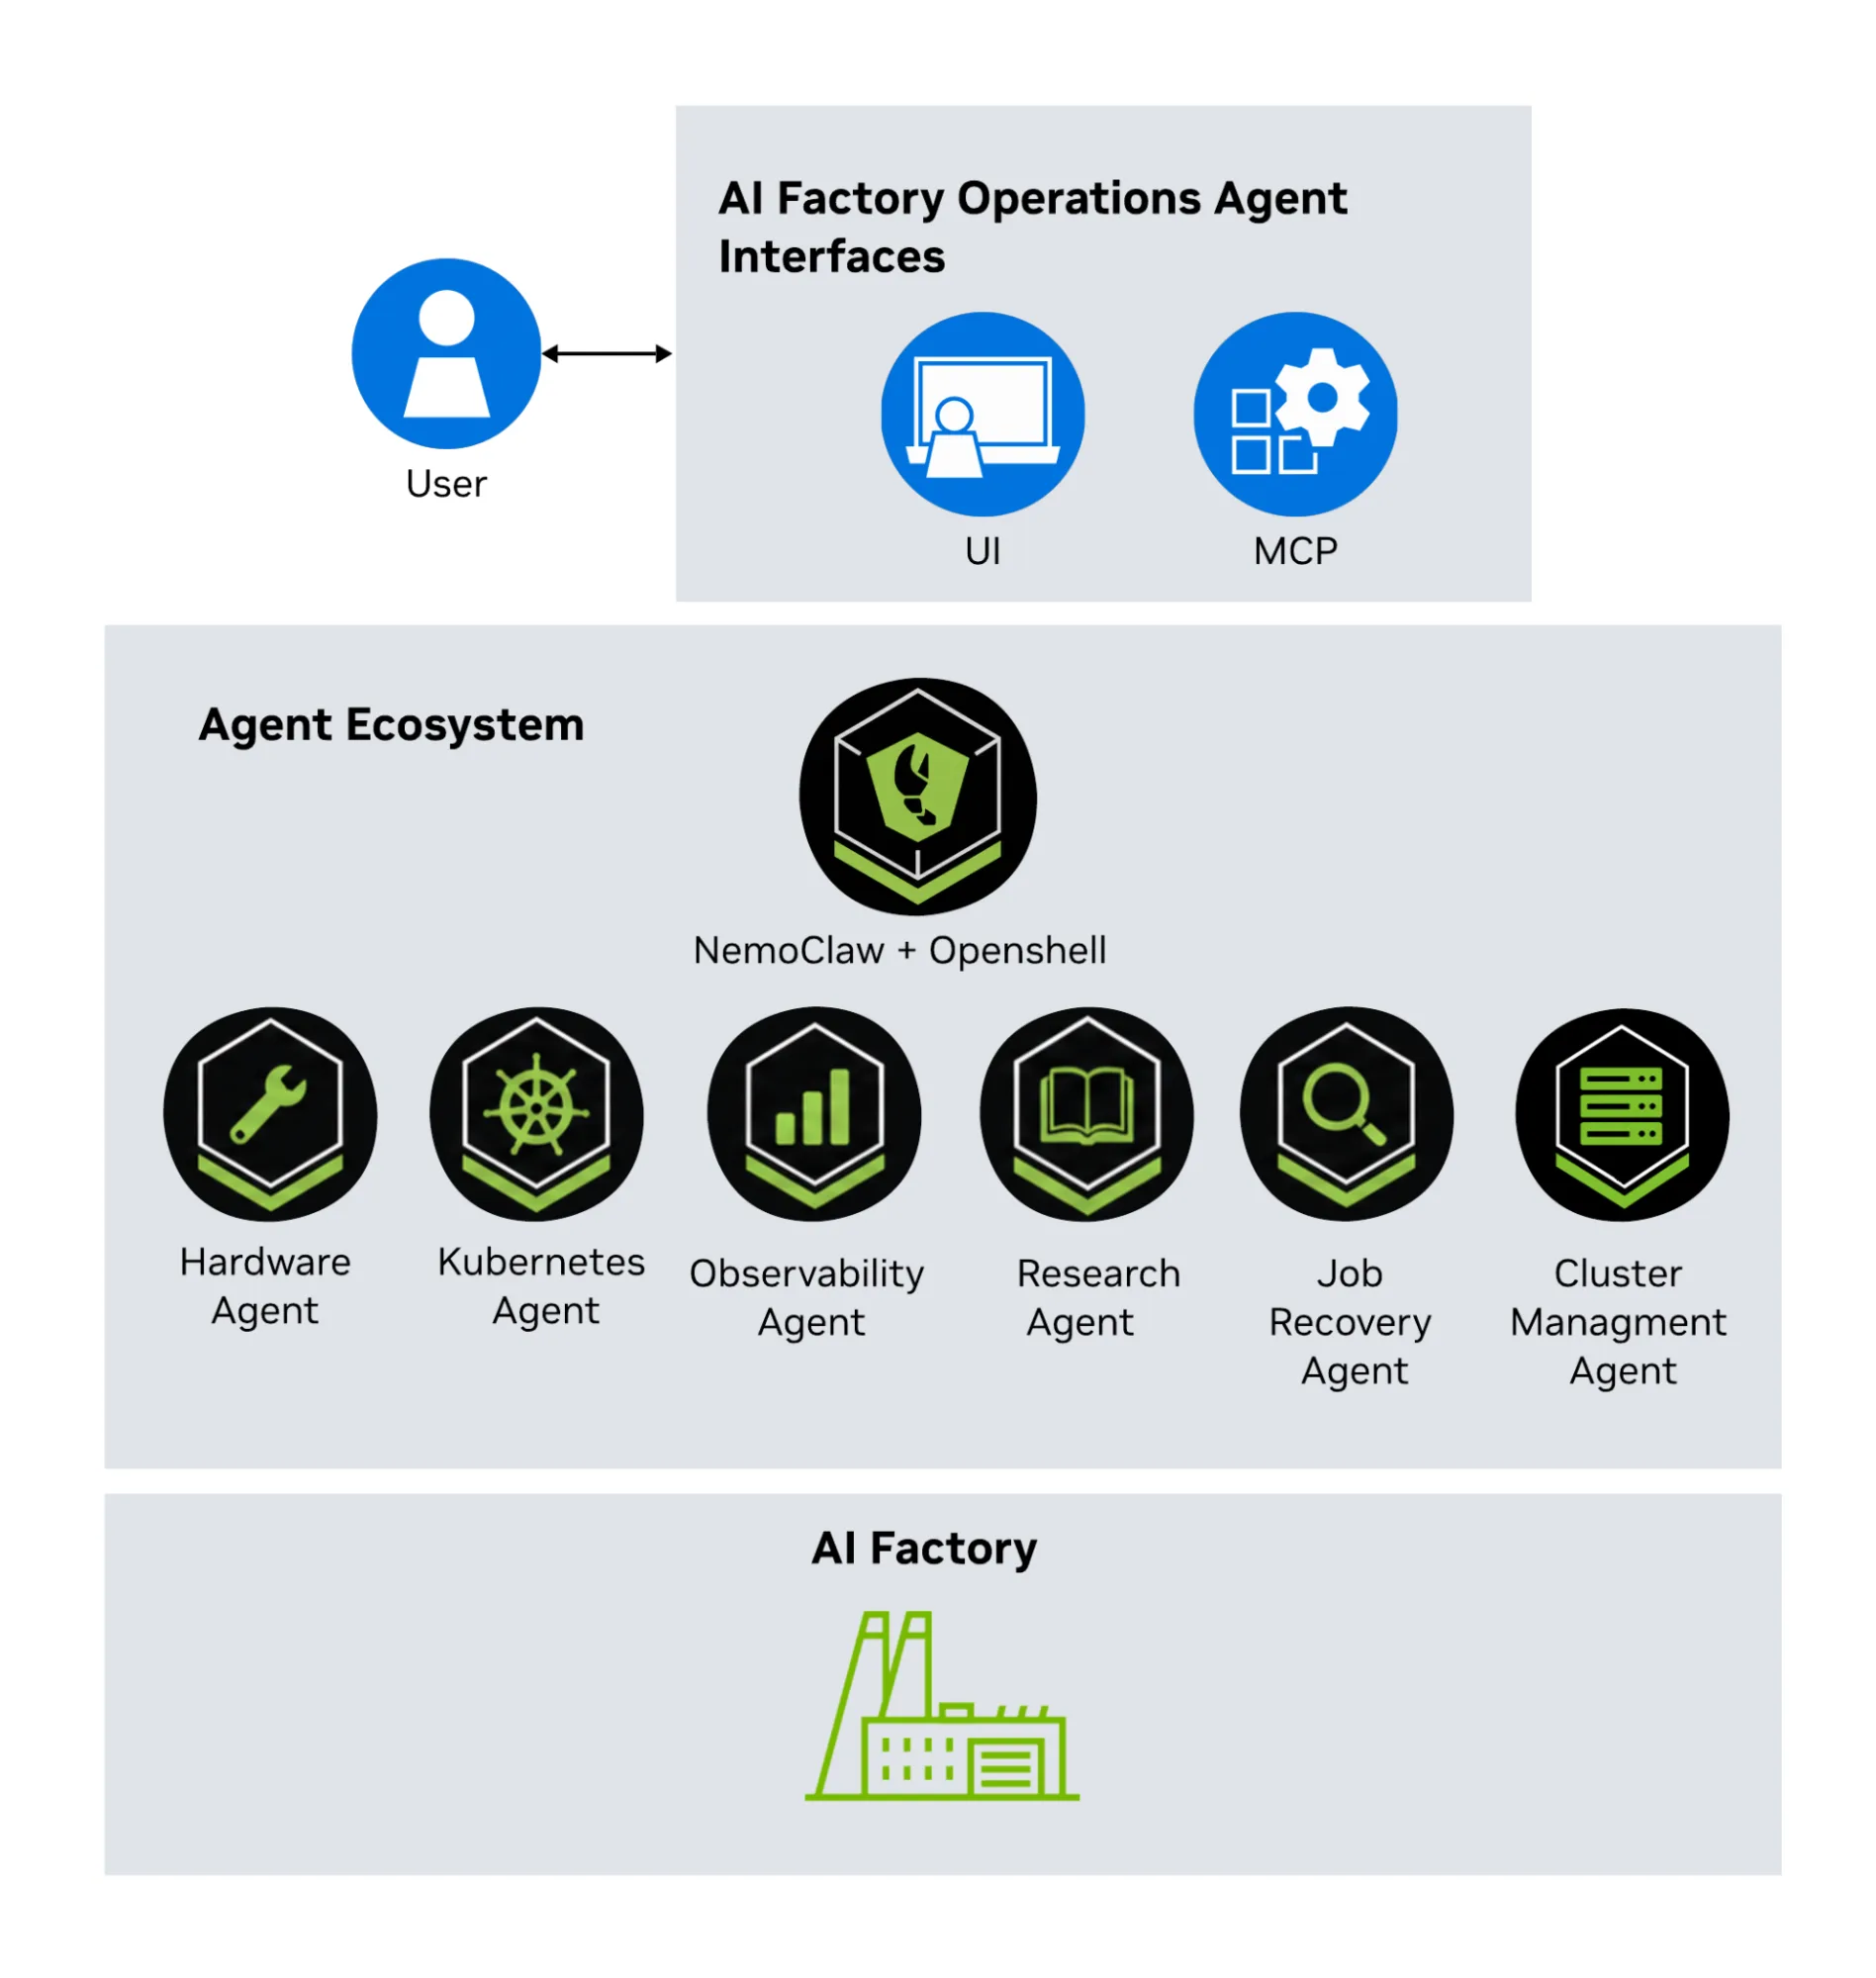
AI Factory Operations Agent 开发者示例围绕 NVIDIA NemoClaw 蓝图构建。中心是面向用户的智能体运行时,它通过聊天界面接收 SRE 查询,并调用相应的领域智能体和工具。
智能体通过 OpenClaw 插件和 MCP 服务器连接基础设施,每个 MCP 暴露一组聚焦的、经批准的操作工具。你可以使用内置的 Web UI,也可以通过 API 集成现有的编码智能体接口。这种模块化设计让你无需更改现有智能体,就能添加新的智能体和基础设施集成。
该框架使用 NVIDIA OpenShell 构建,完全支持本地部署,支持可扩展性和数据主权。智能体推理使用本地提供的 NVIDIA Nemotron 开放模型,而该框架运行在 NVIDIA 内部的 DGX H100、NVIDIA DGX B200 和 NVIDIA DGX GB300 生产集群上。下一节将介绍 OpenShell 如何提供智能体治理和控制,使智能体安全地工作。
NVIDIA 如何构建它
AI Factory Operations Agent 作为 Kubernetes 控制平面应用运行。Helm 将 UI、OpenClaw 网关、MCP 工具服务器、推理端点和 NVIDIA OpenShell 运行时部署为 Kubernetes 服务。聊天 UI 将每个请求发送给 NemoClaw,后者将其路由到相应的领域智能体。
对于 shell 执行,OpenShell 会为每个会话创建一个 Kubernetes 沙箱,而不是在主网关 Pod 中运行命令。运行时接收 AI Factory Operations Agent 工作区、选定的技能和命令策略。其生命周期不会修改现有服务或生产工作负载。
安全是分层实施的。Kubernetes 检查使用服务器端 run_kubectl 工具,该工具使用固定的 kubectl 二进制文件,并针对已注册的只读凭据运行。OpenShell 既不接收 kubectl,也不接收 Kubernetes 凭据。Kubernetes 服务账户和基于角色的访问控制(RBAC)定义了该工具可以检查的集群资源。
由于这些检查通过运行时使用的同一 Kubernetes 访问路径运行,结果显示了智能体在集群内能做什么、不能做什么。
(agent) $ kubectl auth can-i get pods
yes
(agent) $ kubectl auth can-i get configmaps
yes
(agent) $ kubectl auth can-i get secrets
no
(agent) $ kubectl auth can-i create pods
no
(agent) $ kubectl auth can-i update pods
no
AI Factory Operations Agent、子智能体和工具
NVIDIA 内部部署的 AI Factory Operations Agent 使用不断增长的 NVIDIA 数据中心领域特定智能体生态系统,每个智能体都提供建议。
作业恢复智能体:检测训练作业失败和有效吞吐量下降;跨调度器、应用、硬件和网络层执行多层根因分析;并在确认根因后建议恢复步骤。
硬件智能体:在设备级别对硬件故障进行分诊——PCIe 错误、ECC 错误、GPU 问题、NVMe 故障和热异常——将症状追踪到具体组件。
可观测性智能体:查询历史 Prometheus、遥测数据和集成的 Grafana Loki 日志,动态创建仪表盘并直接在 Web UI 中显示。
研究智能体:搜索预加载的文档,包括 NVIDIA Mission Control 手册以及 DGX SuperPOD 参考架构和部署指南。你也可以上传自己的运行手册和站点特定指南。
Kubernetes 智能体:提供跨 Pod、服务、部署、GPU 资源、节点状态和调度状态的只读运维感知。
集群管理智能体:通过诊断 MCP 工具与 NVIDIA Base Command Manager API 交互,以提供咨询性集群管理和故障排除。
除了领域智能体之外,该框架还集成了跨领域的 MCP 工具,包括 Web 搜索、代码执行和 Grafana 仪表盘。
你还可以连接自己的 MCP 服务器和 API,使框架适应这些环境中已在使用的调度器、可观测性平台、集群管理器和运维流程。
在数据中心使用智能体的经验教训
NVIDIA 通过衡量根因分析(RCA)准确性、跟踪 SRE 认同度并扩展智能体生态系统,持续改进该框架。从生产使用中,有五条经验尤为突出:
- 清晰的智能体边界:重叠的职责范围产生的是噪声,而不是信号。
- 只读优先:准确的调查能在自动化之前建立 SRE 的信任。
- 跨层关联:该框架连接工作负载、硬件和网络信号,以发现孤立工具所遗漏的根本原因。
- 精确的 MCP 工具:清晰的工具定义可改善路由并减少错误的工具选择。
- 透明的推理过程:SRE 需要在采取行动之前看到工具调用、证据和结论。
▶ https://www.youtube.com/watch?v=a9S8HdwIQ2g
视频 1. AI Factory Operations Agent 事件故障排查示例,已注入 NVIDIA DGX 集群用于内部演示。
将智能体驱动的运维引入你的 AI 工厂
对于大规模运行 AI 工厂的组织,首选的部署模型是与生产集群隔离的专用 GPU 加速控制平面。控制平面负责智能体编排和推理,而生产集群提供遥测数据,且不消耗训练 GPU 或中断工作负载。
NVIDIA 内部部署在专用 GPU 容量上运行模型推理,并使用现有控制平面 CPU Kubernetes 管理空间来运行运行时服务。其他部署可根据数据主权、集群规模和可用 GPU 容量,使用本地或云端推理端点,较小规模的部署可使用 RTX PRO Workstation 或 DGX Spark。
对于多租户 AI 工厂,限定范围的智能体、工具、沙箱和 Kubernetes 权限控制每个租户可用的集群数据、工具和节点。租户 SRE 只能看到自己的命名空间、作业和节点,而中央运维则保留更广泛的集群可见性。每个租户在需要时可使用自己的一组领域特定智能体和专用推理硬件。OpenShell 通过在具有内核级限制的隔离沙箱中运行每个租户的智能体和工具来强制执行这些边界。
开始使用
要开始简化集群运维管理,请探索 AI Factory Operations Agent 开发者示例,或直接在 GitHub 上访问开源框架和代码。该编排框架以实验性开源软件形式提供;API、配置和部署要求可能因版本而异。NVIDIA 客户可联系其客户经理,申请访问 NVIDIA 开发的集群运维智能体。