描述
该项目为 Google 的张量处理单元(TPU)提供了一个 PyTorch 后端,使用户能够在 TPU 设备上运行 PyTorch 模型和操作。它包含针对各种 PyTorch 操作的自定义 ATen 内核、用于优化执行的编译缓存,以及分布式训练和模型推理的示例。
特性
- 面向 TPU 的 PyTorch ATen 内核实现。
- 用于优化 XLA 计算执行的编译缓存。
- 支持分布式训练(数据并行、张量并行)。
- 各种模型的示例(Llama、Qwen、ResNet、DLRM、minGPT、UNet)。
- 与
torch.compile()集成以支持图模式执行。 - 用于调试和基准测试的实用工具。
用户指南与交互式 Notebook
用户指南可在 https://torchtpu.readthedocs.io/ 获取。这是交互式 Notebook 的静态版本。它们位于 docs 文件夹中。
这些 Notebook 是 Marimo(类似于 Jupyter)。可以用 marimo edit file.py 运行它们,然后在浏览器中访问。你需要从 TPU VM 上运行,v6e GCE 实例是最简便的选择。
安装
相同的说明可在上面链接的用户指南中获取。
TorchTPU 的 Python 版本支持策略与 PyTorch 的发布兼容性矩阵 一致。目前支持 Python 3.11+。更多详情请参阅 Python 版本支持策略。
首先创建一个 Python 虚拟环境:
python -m venv .venv
source .venv/bin/activate
或者,使用 uv
uv venv .venv
source .venv/bin/activate
通过 pip 安装
安装最新的公开发行版(PyPI 上的 0.2.0)(对于 uv,在所有 pip 命令前加上 uv):
pip install torch_tpu==0.2.0 --extra-index-url https://download.pytorch.org/whl/cpu
从源码构建
可以通过以下方式构建 wheel:
bazel build --config=wheel_common //ci/wheel:torch_tpu_wheel
所有 OSS Bazel 构建都会通过 .bazelrc 自动默认为优化模式(-c opt)。未优化的构建(-c fastbuild、-c dbg)会降低性能,不用于 wheel 构建。如果你正在开发或调试 C++ 代码并明确想要未优化的 wheel,请传入 --//:allow_unoptimized_wheel=True:
bazel build -c dbg --config=wheel_common //ci/wheel:torch_tpu_wheel \
    --//:allow_unoptimized_wheel=True
需要 --config=wheel_common,没有它构建时就会失败。该配置会设置 --//:wheel_build=True,它通过 torch_version-reset 转换来路由共享的 XLA/MLIR 后端,以便 pywrap 将其合并为单个 libxla_base.so;如果不带该标志构建,每个按版本区分的 common 都会自带一份后端副本,生成的 wheel 会在 import torch 上因重复的静态注册而中止。
wheel_common 还会开启远程构建执行(RBE)远程缓存和远程执行器。如果你没有 RBE 凭据,请追加 --config=no_rbe 以移除这些标志:
bazel build --config=wheel_common //ci/wheel:torch_tpu_wheel --config=no_rbe
这里的顺序很重要:--config=no_rbe 必须放在 --config=wheel_common 之后,因为对于它们都设置的远程缓存和远程执行器标志,后出现的配置会生效。
通过以下方式安装 wheel:
cd <path_to_repo>
python -m venv .venv; source .venv/bin/activate
# The extra-index-url provides the CPU version of torch rather than the default CUDA build.
pip install ../bazel-bin/ci/wheel/*.whl --extra-index-url https://download.pytorch.org/whl/cpu
请注意,不带 --extra-index-url https://download.pytorch.org/whl/cpu 安装会安装 CUDA 版本的 torch;请如上所示传入 --extra-index-url,或单独安装 CPU 构建。
快速开始
一些入门指引:
依赖项
该项目使用 Bazel 进行依赖管理。关键的 Python 依赖项包括:
待定
Bazel 设置
该项目使用 Bazel 进行构建和依赖管理。
要安装 Bazel,我们实际上安装的是 Bazelisk,它是一个透明包装器,负责下载和安装 Bazel 本身。
有几种方式可以安装 Bazelisk。以下是一些常见方式:
如果你安装了 Go:
go install github.com/bazelbuild/bazelisk@latest直接下载二进制文件:
wget -O ~/bin/bazel https://github.com/bazelbuild/bazelisk/releases/download/v1.27.0/bazelisk-linux-amd64
更多安装说明请参阅 Bazelisk README
无论你如何安装,请将其位置添加到 PATH。
要验证安装,请在仓库根目录运行 bazel info:
bazel info
它应该会打印有关该仓库的信息,且不报错。
VSCode clangd 设置
对于 C++ 代码导航,建议使用 VSCode 搭配 clangd 扩展。依靠从 Bazel 操作图生成的编译数据库,clangd 能够为编辑器提供各种智能功能,包括代码补全、跳转到定义等。
通过 UI 或以下命令安装 VSCode 扩展:
code --install-extension llvm-vs-code-extensions.vscode-clangd
# Uninstall Microsoft C++ extensions to avoid interference.
code --uninstall-extension ms-vscode.cpptools
生成初始的
compile_commands.json:tools/setup_clangd.py
首次运行进行完整构建可能需要一段时间(> 30 分钟),但重新运行将是增量的,开销很小。如果你最近运行过 bazel build,生成的文件已经存在,因此你可以传入 --no-build 来跳过等待繁重的构建(请注意,在全新的工作区中,跳过构建可能会导致 clangd 无法解析生成的文件)。更多选项请参阅脚本的文件级注释。
或者,你可以通过 nox 调用该脚本(-- 之后的参数会被转发):
nox -s refresh_compile_commands -- --no-build
nox -s refresh_compile_commands -- //src/torch_tpu/ops/...
贡献
我们欢迎对 PyTorch on TPU 项目的贡献!请参阅我们的 CONTRIBUTING.md 了解如何贡献的指南,包括签署我们的贡献者许可协议(CLA)和代码审查流程。
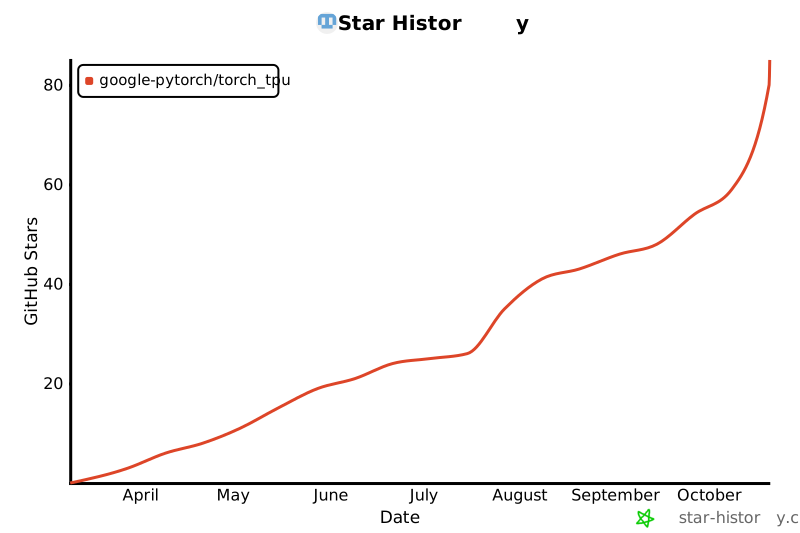
Star 历史
许可证
该项目采用 Apache 2.0 许可证。详情请参阅 LICENSE 文件。