几个月前,我们在Open ASR Leaderboard中加入了私有数据:来自Appen和DataOceanAI的11个分割,涵盖五种口音的脚本和对话语音(博客)。社区反响热烈,许多人强调了保留集对于可信评估的重要性。此后,我们又与Voice Arena为印度口音英语增加了一个私有分割(博客)。
我们很高兴宣布与Liva AI的新合作,以添加更多私有数据,涵盖两种新口音:埃及 🇪🇬 和 尼日利亚 🇳🇬。
| 数据集 | 口音 | 时长 [小时] | 风格 | 转写 |
|---|---|---|---|---|
| Liva AI Conversational EG | 埃及 | 1.34 | 对话,自发 | 带标点、大小写,包含不流畅。 |
| Liva AI Conversational NG | 尼日利亚 | 1.55 | 对话,自发 | 带标点、大小写,包含不流畅。 |
这是我们持续努力的一部分,旨在改善ASR评估中的代表性(更多口音和更多语言)并提升信任(新的私有数据以最小化benchmaxxing,以及新的数据提供者)。我们很高兴看到社区继续推动全球ASR性能的提升 🤗
私有标签页中更丰富的口音细分
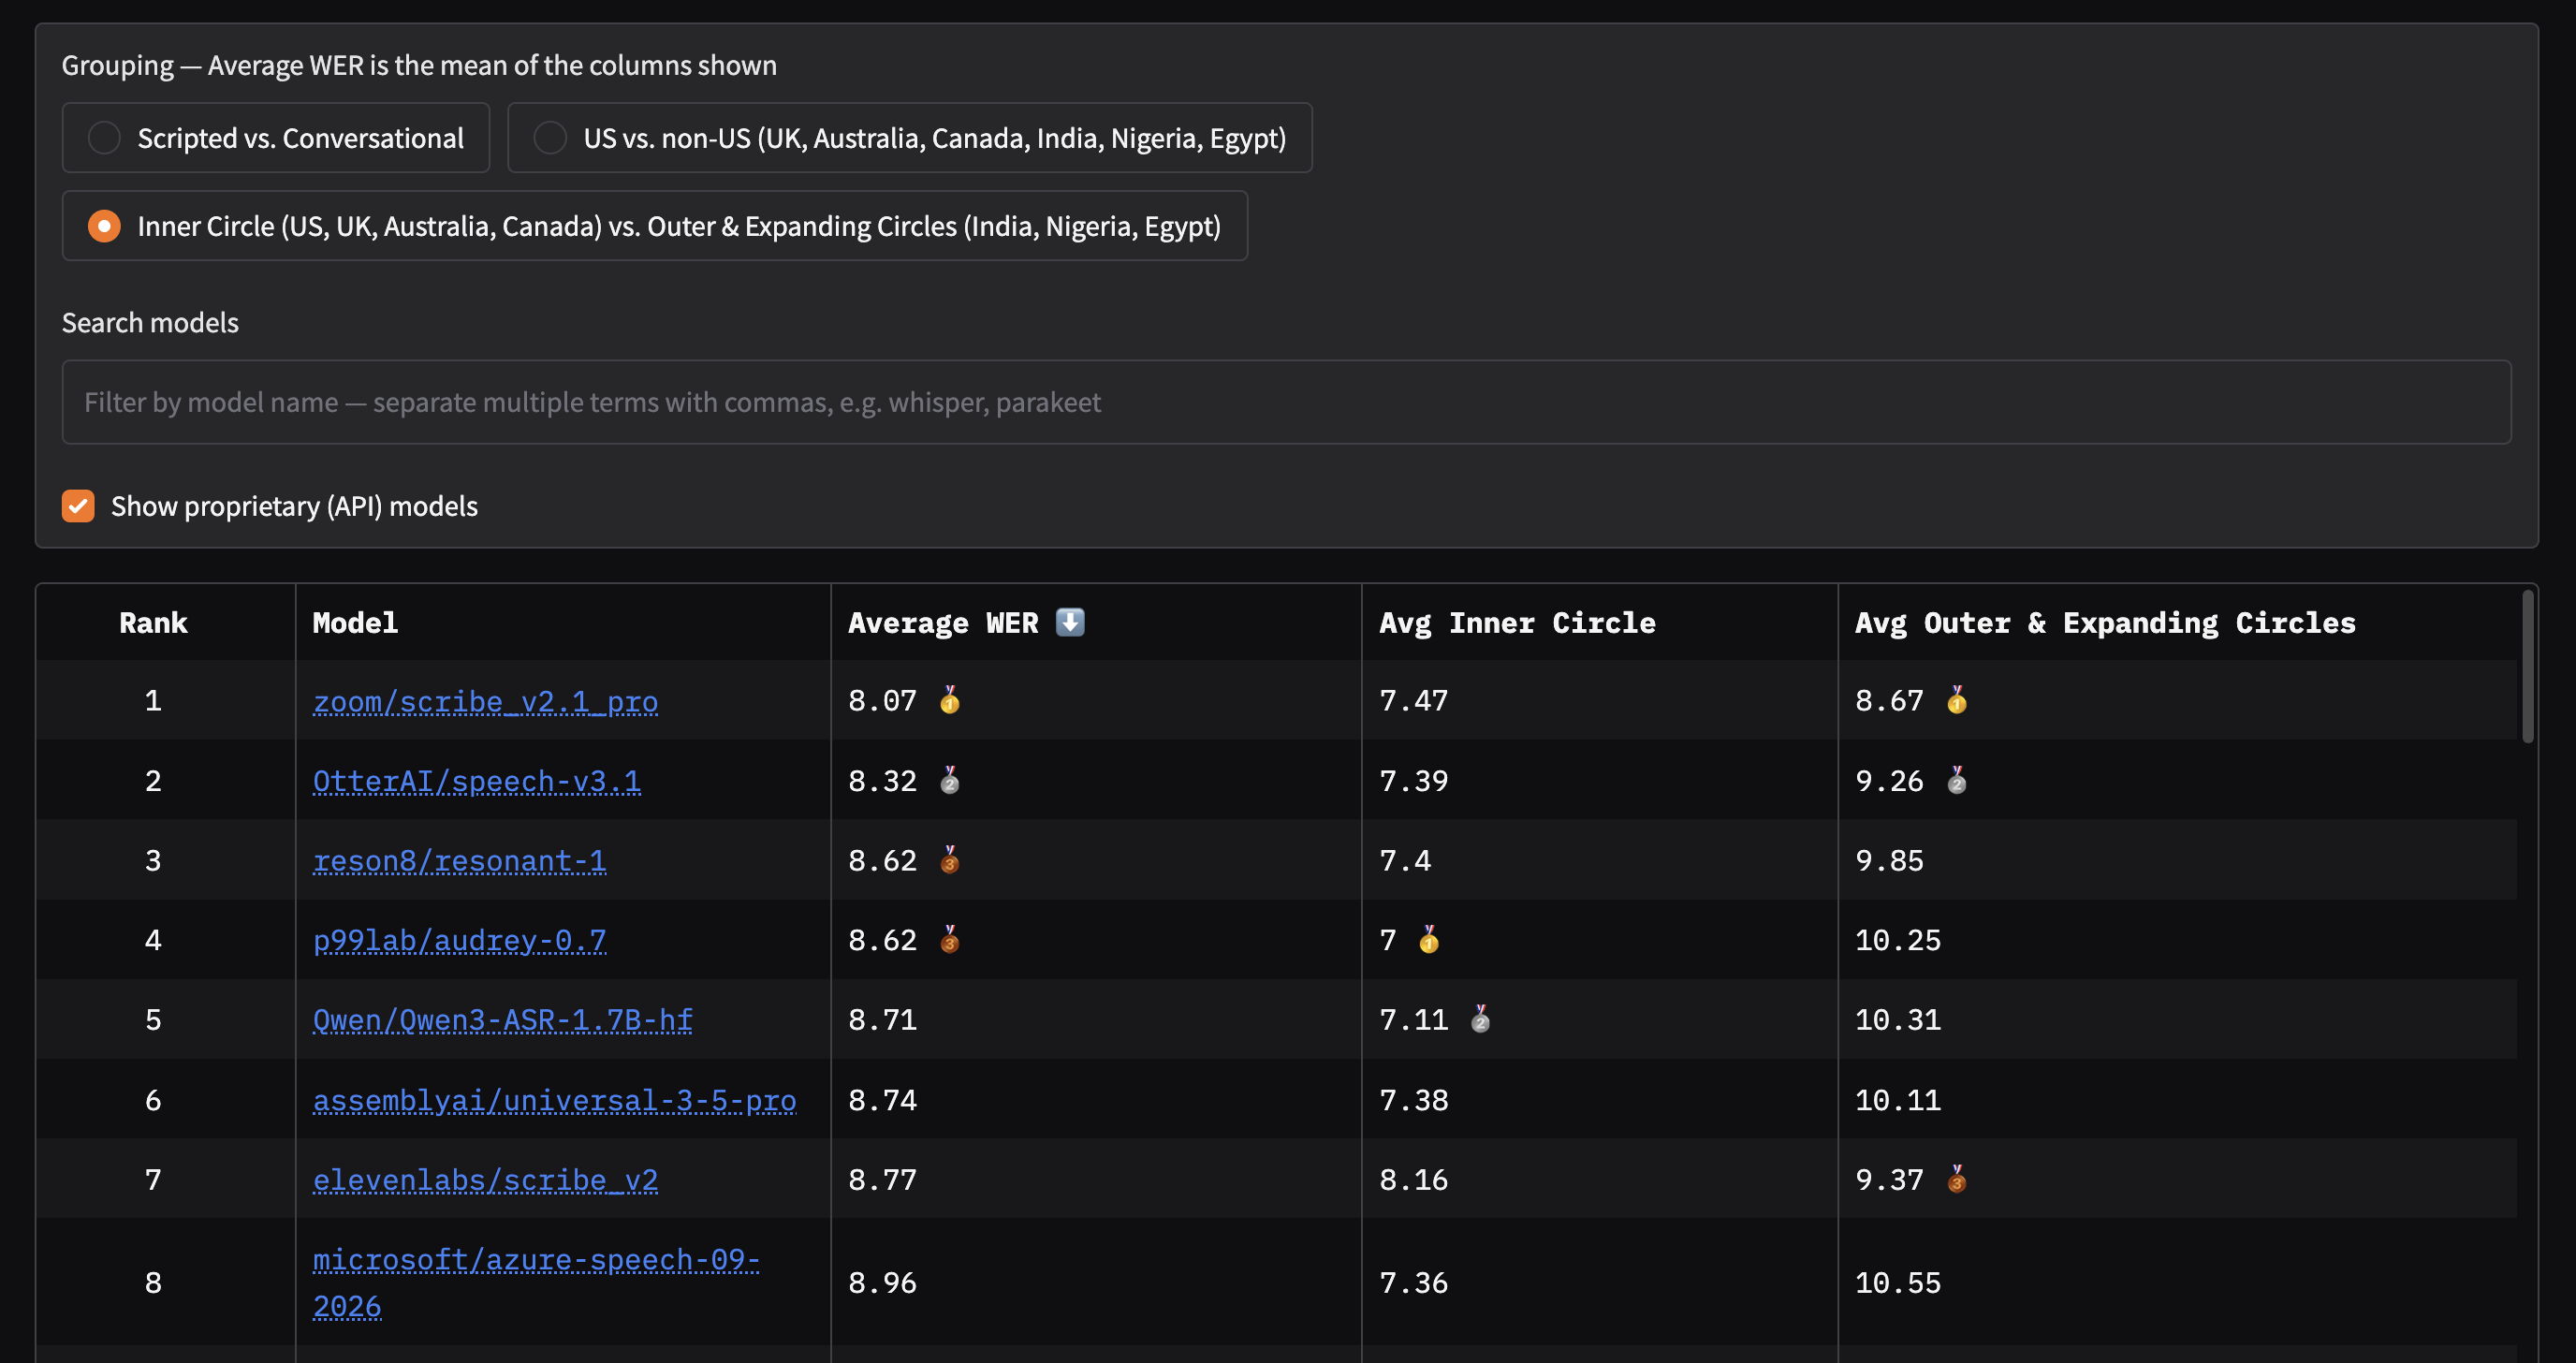
有了这些新口音,我们现在可以基于Kachru的三圈模型呈现更丰富的口音细分(感谢Hume AI在其排行榜中提出的这个想法)。Open ASR Leaderboard现在将报告:
- 美国 vs. 非美国(英国、澳大利亚、加拿大、印度、尼日利亚、埃及)
- 内圈(美国、英国、澳大利亚、加拿大)vs. 外圈与扩展圈(印度、尼日利亚、埃及)
随着更多口音的加入,我们将拆分外圈和扩展圈。
关于Liva AI
Liva AI通过真实用户使用的消费产品收集多模态交互数据。由于Liva拥有收集环境和分发渠道,它可以围绕跨领域、行业、语言、模态和交互类型的特定模型缺口设计产品。这使其能够获取通过真实产品使用中涌现的自然、高上下文行为,而非人工诱导或基于任务的交互。