今天,我们宣布下一代前沿模型:Gemini 4 Carbon,这是我们最强的模型,具备最先进的网络安全能力和长程能力。
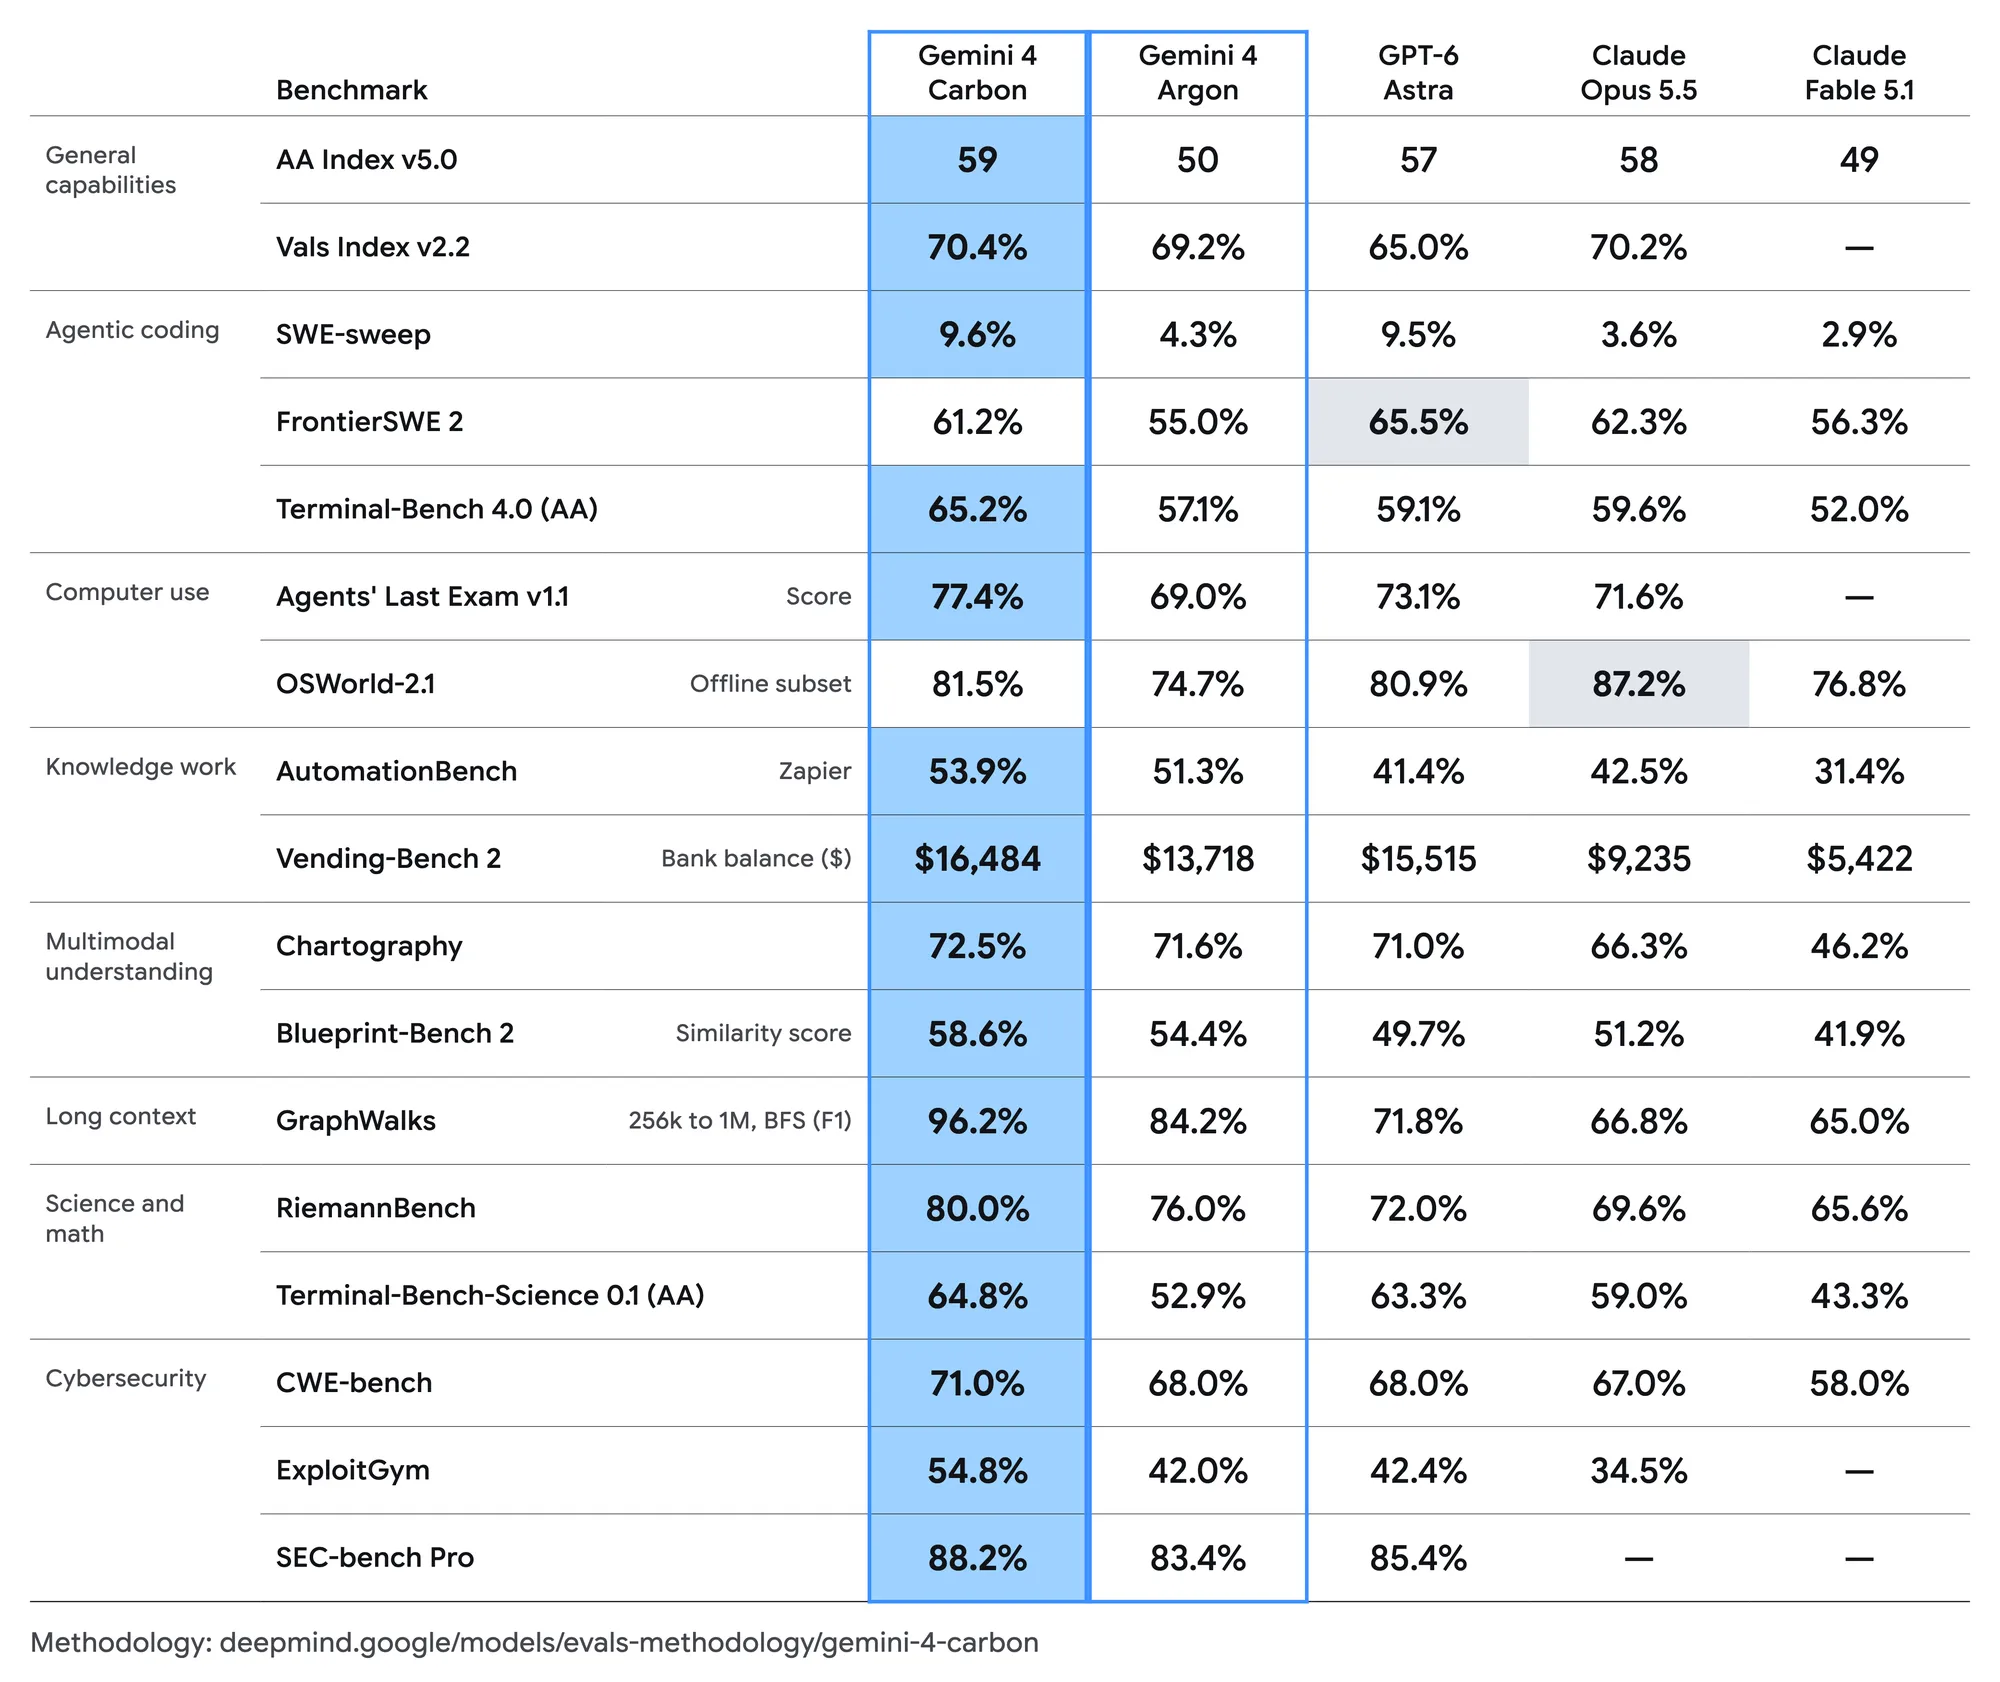
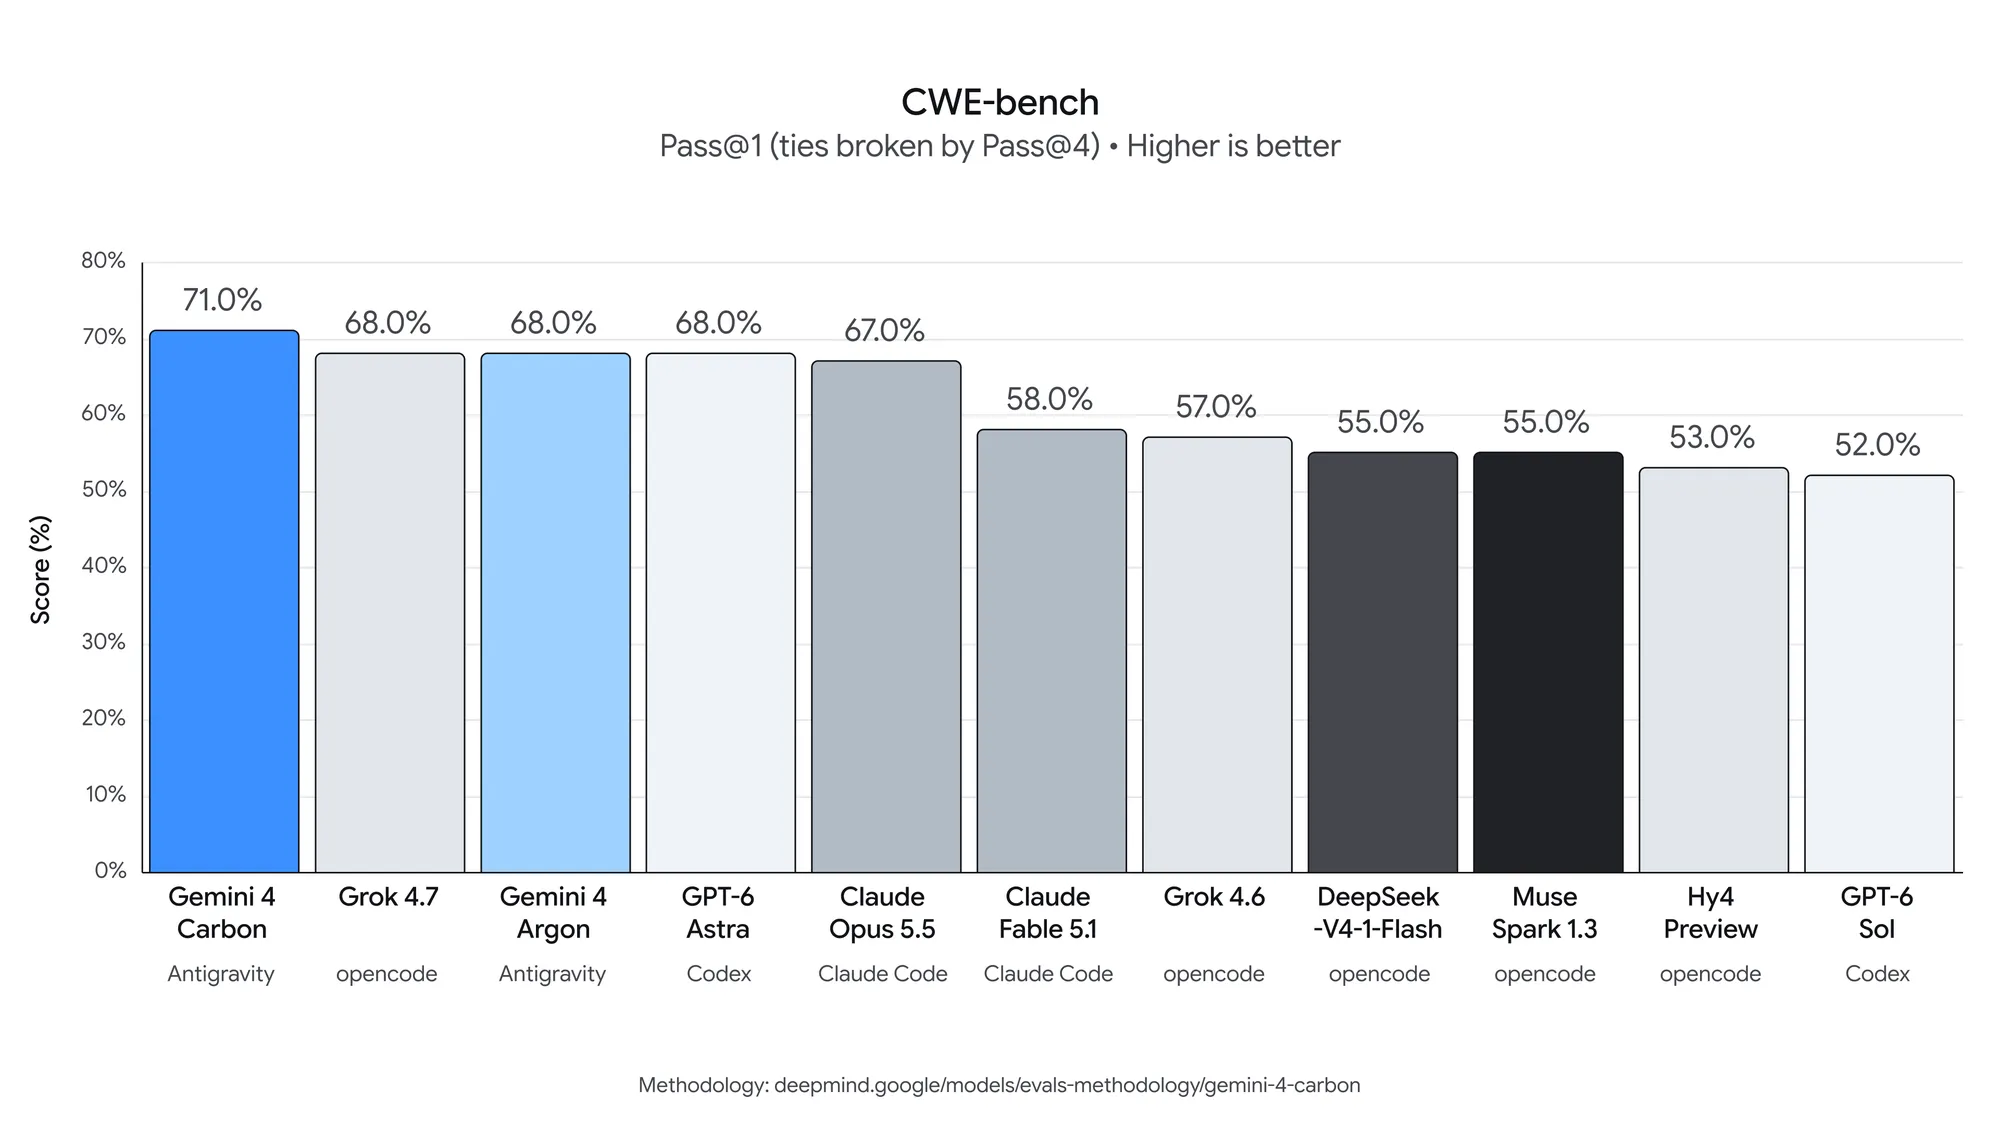
Carbon 在最近更新的 v5.0 Artificial Analysis Intelligence Index 上以 59 分排名第 1。它在编程和智能体任务上,以及在网络安全防御至关重要的关键能力上均展现出显著提升,在漏洞发现的 SEC-bench Pro(88.2%)、漏洞利用的 ExploitGym(54.8%)和补丁修复的 CWE-bench(71.0%)上均取得明显领先。在内部基准测试中,Carbon 在生成安全代码方面带来强劲提升,并且在我们自己团队的实时编程环境中,它表现出更低的对齐偏差和捏造率。
Carbon 建立在两周前发布的 Gemini 4 Argon 之上,体现了我们推进前沿的速度。我们的研究人员与模型携手并进,更快地提升能力,同时同步加强我们的防护措施。
我们对发布采取审慎的方式,并积极参与美国政府发布前模型测试的自愿流程。从本周开始,我们将向一部分网络防御者提供 Carbon,并通过我们的 Fairwind Program 逐步向更多可信合作伙伴开放访问。我们将继续收集反馈并迭代防护措施,然后尽快通过我们的产品界面向开发者、企业和消费者提供 Carbon。
Gemini 4 Carbon 将以与 Argon 相同的 introductory price 1 发布,即每百万输入 token 2 美元、每百万输出 token 10 美元,缓存输入 token 的价格为输入 token 价格的 95% 折扣。
提升编程和推理能力,应对具有挑战性的长程任务
Carbon 旨在应对更困难、长程的工程问题,专为持续性的智能体工作流而构建。在内部,我们的团队已看到 Carbon 连续运行数天,坚持穿过死胡同,以处理复杂的多步骤工程任务,例如在大型代码库和底层系统中对细微缺陷进行根因分析和修补。
基于用户反馈,我们专注于提升模型在多个领域中的表现,包括编程、智能体和科学任务,以及全栈 Web 开发和多模态理解。随着 Web 开发中输出和产物的质量提升,Carbon 跃升 +89 elo 分,在 WebDev Arena 上以 1768 分位列第 4。
最先进的网络安全性能,助力构建安全系统
Gemini 4 Carbon 在网络安全能力上实现了重大飞跃。它在网络安全防御生命周期——漏洞检测、验证和修复——中均达到最先进的性能。
我们的团队已经在网络防御中看到强劲收益。在内部基准测试中,Carbon 在生成安全代码方面的成功率相比 Argon 提升超过 2 倍。另一个例子是,Chrome 团队报告称,在生成高质量补丁时,Carbon 的表现比另一家实验室的大型前沿模型好 10 倍以上。我们领先的云安全平台 Wiz 也观察到,Carbon 在 Web 渗透测试基准测试中领先,这是 Wiz's Scan for Good 计划的核心能力。
Carbon 在关键外部基准测试中表现出色(评估时未启用防护措施):
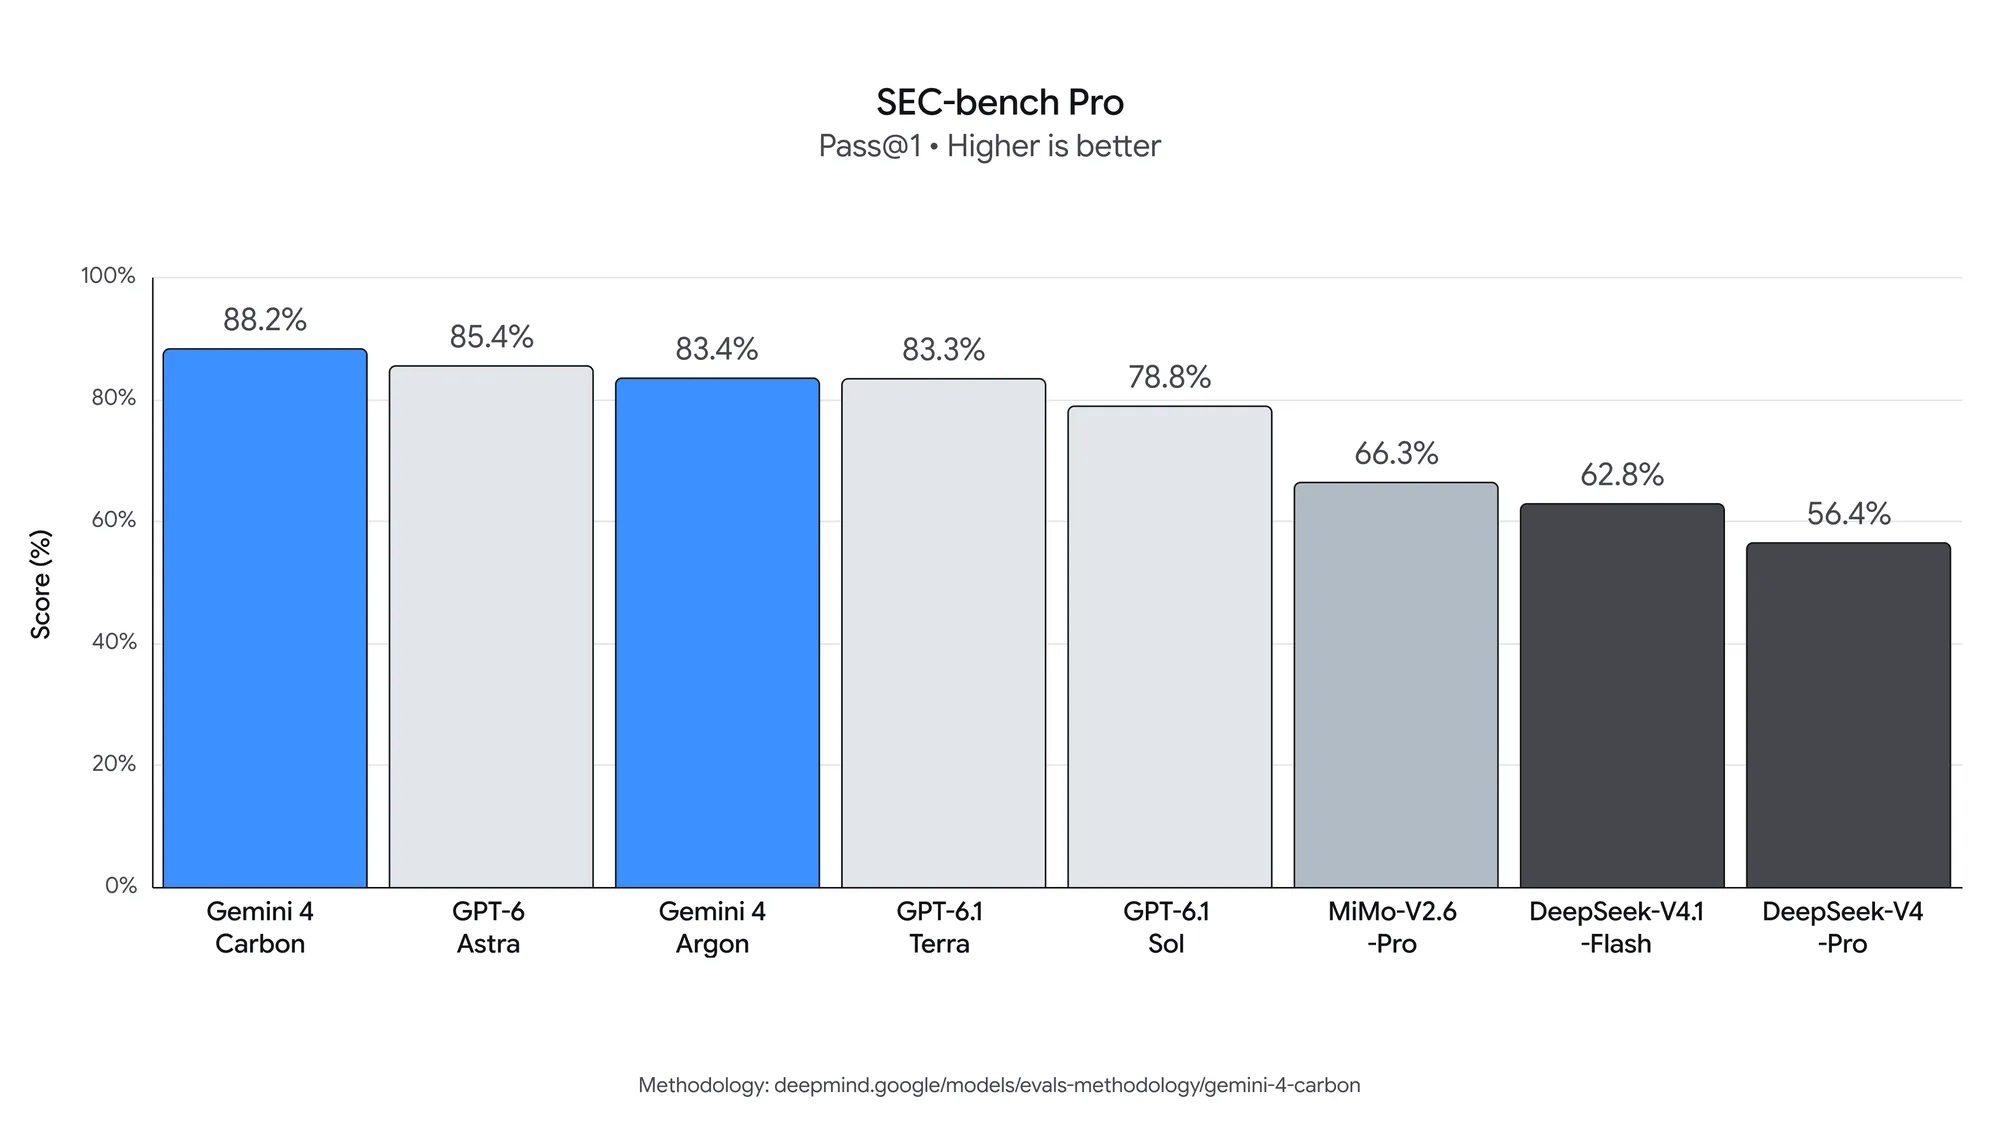
- 发现真实漏洞: 网络安全防御的核心是发现真实漏洞。Carbon 在 SEC-bench Pro 上达到最先进的 88.2%,自主发现深藏于真实世界软件中的复杂缺陷。
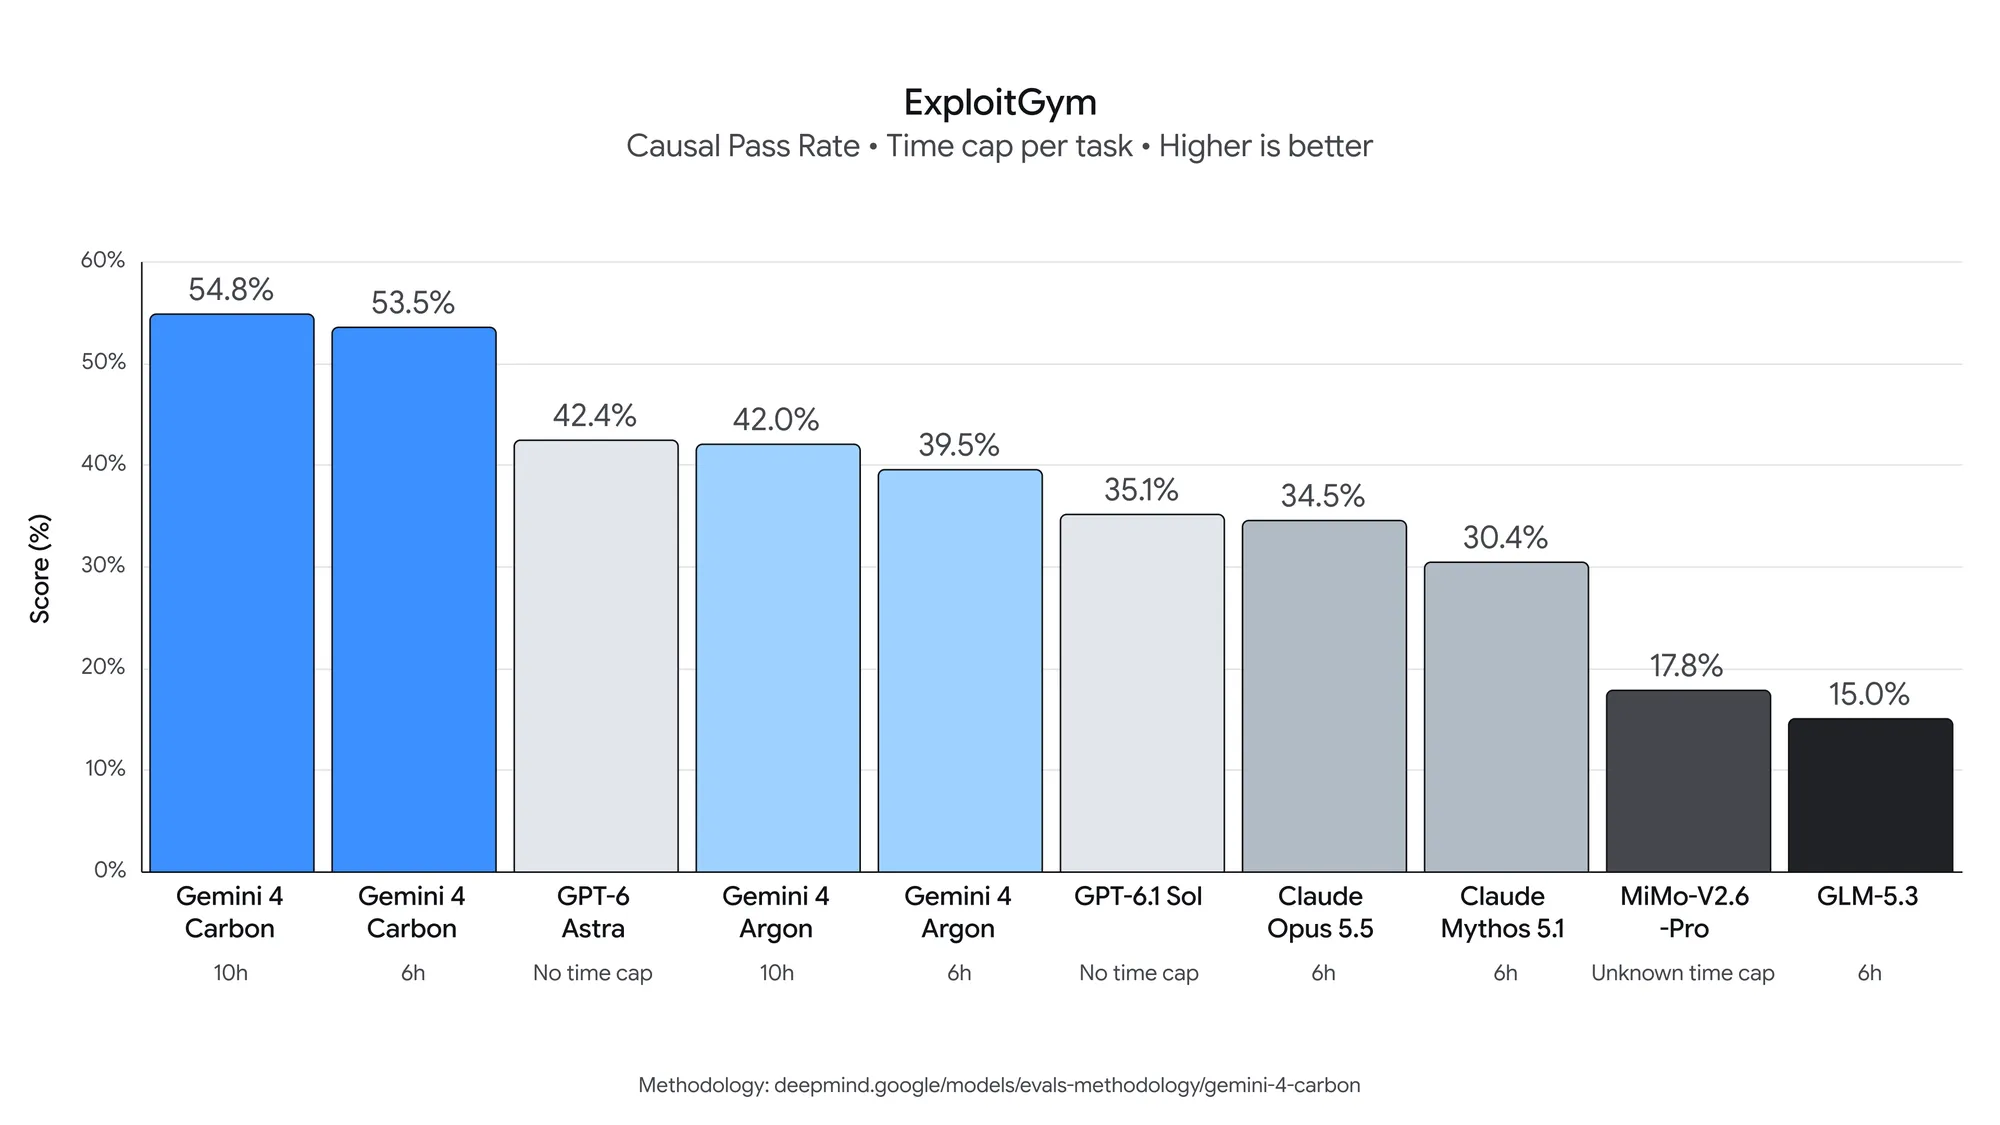
- 通过漏洞利用验证风险: 为了确定哪些漏洞应优先修复或是否修复,网络防御者越来越依赖模型来检查哪些漏洞可被利用。Carbon 在流行的漏洞利用基准测试 ExploitGym 上创下新的最先进水平(54.8%)。
- 从根因处修补: 最终,在识别漏洞之后,修复根因是网络安全防御生命周期中的关键一步。Carbon 在 Collinear 的 CWE-bench 上达到 71.0%,将已验证的发现直接转化为可用的代码修复。
推进前沿模型的安全与保障
Gemini 4 Carbon 建立在 Argon 相同的多层安全与保障体系之上——结合模型训练、实时滥用防御、提示注入韧性和思维链监控。特别是,我们在 Argon 的模型对齐方面取得了重大进展,并在我们的 Safety and Security report 中报告了其以对齐方式行事的倾向。借助 Carbon,我们挑战自己在对齐方面更进一步,并训练模型以正确方式响应复杂或高压任务。
- 减少捷径和漏洞利用: 借助 Carbon,我们进一步减少了训练中的捷径尝试,同时确保高质量的编程性能。Carbon 将 Terminal-Bench 4.0 上的成功作弊降至 0.0%,作弊尝试降至 0.4%——同时提升了整体准确率。在我们内部团队的实时编程环境中,我们观察到高严重性对齐偏差警报下降了近 80%。
- 更高的透明度和诚实性: 在我们的内部测试中,Carbon 将无依据声明相比 Argon 减少约 2 倍。它直接将方法学上的注意事项写入交付物,或在阻止某些操作时明确列出仍需完成的事项,而不是捏造或围绕缺失证据含糊其辞。
- 在模糊情况下改善与用户的协作: Carbon 不会猜测或强行推进某条路径,而是先检索相关来源并向用户呈现差异,然后再采取行动——因此,用户应能体验到与 Carbon 更好的协作体验。
- 坚持执行而不越界: Carbon 同时将越界行为减少了 26%,将服务不足减少了 29%,从而在端到端执行多步骤计划时更加可靠,同时尊重项目约束并严格保持在范围内。
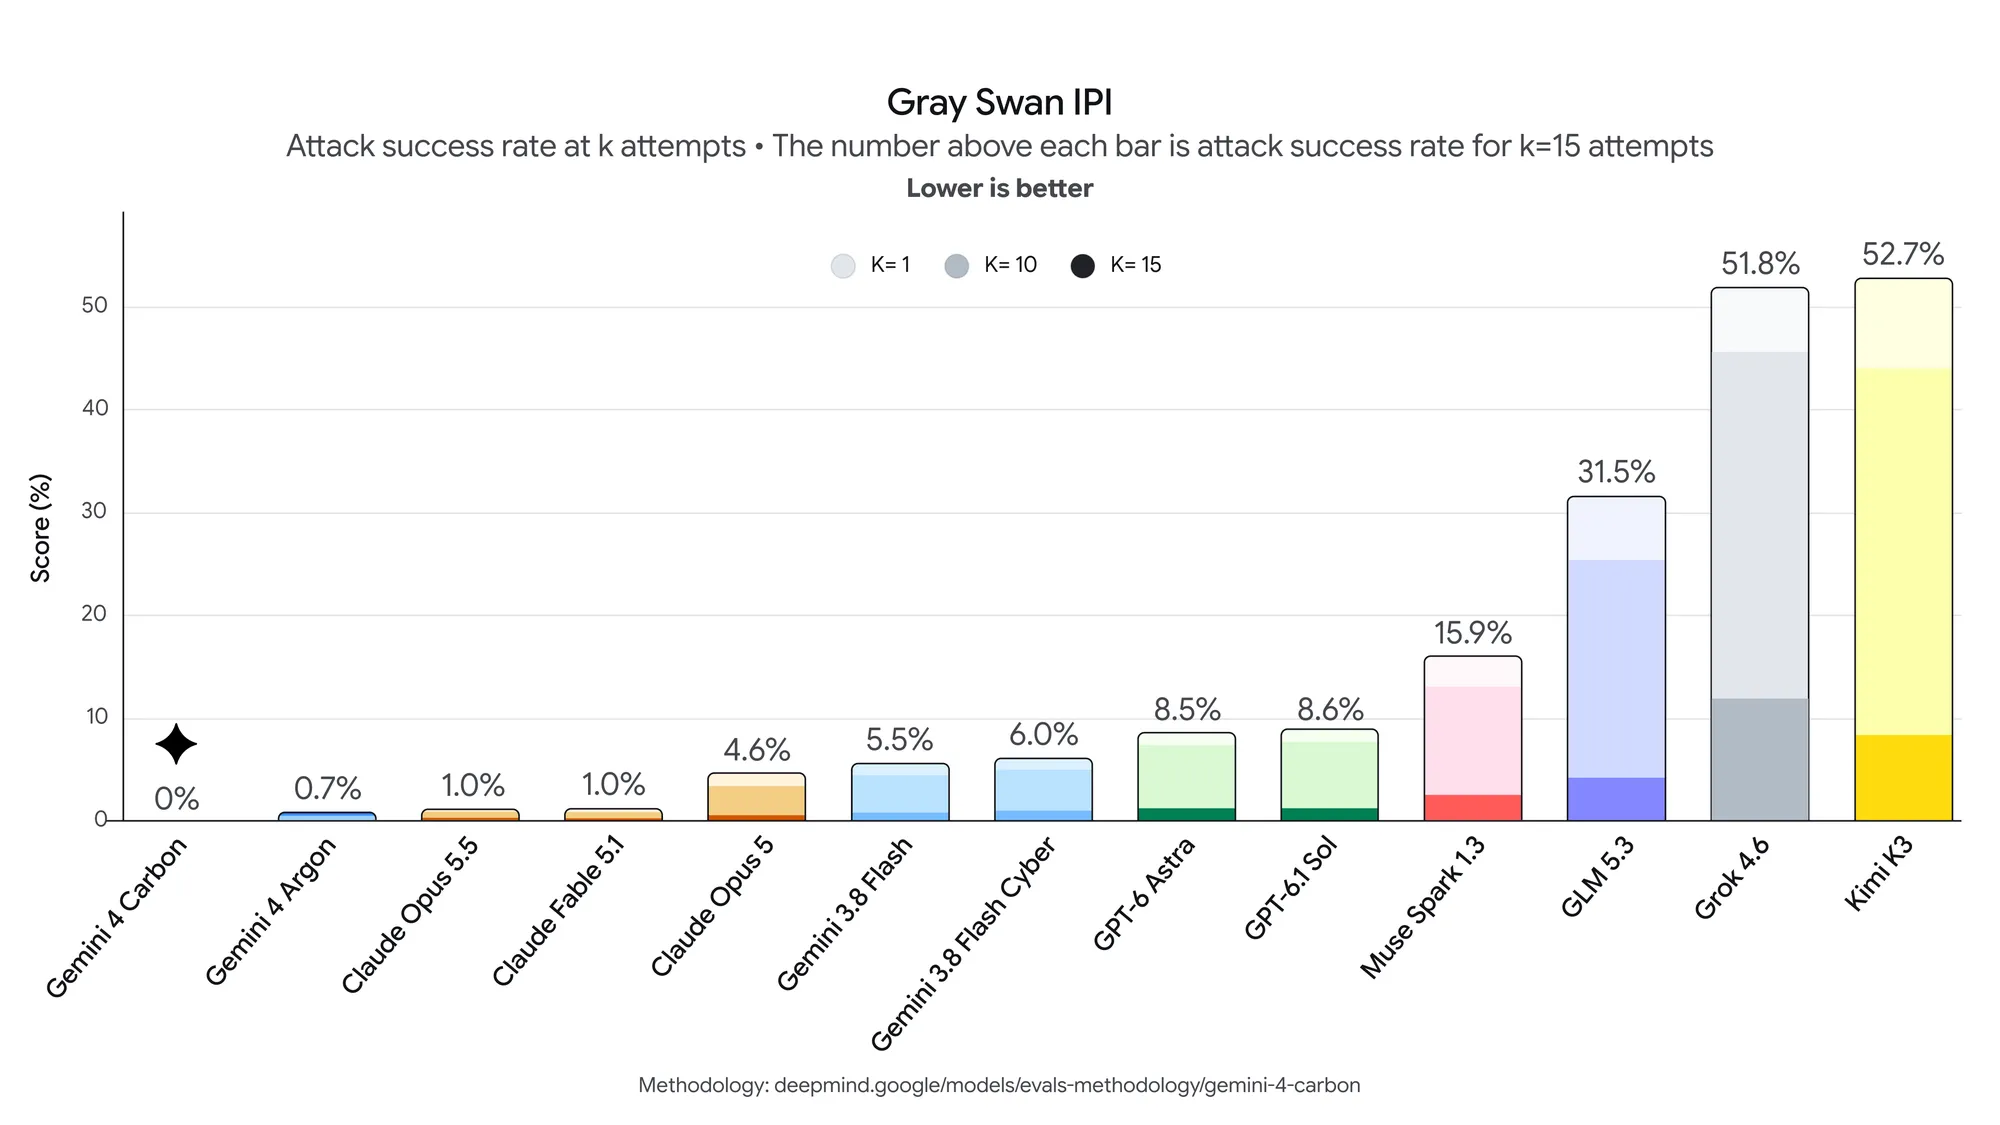
- 抵御提示注入: Argon 此前以 0.7% 的极低攻击成功率在 Gray Swan 的间接提示注入(IPI)基准测试中领先,而 Carbon 达到了 0.0%——抵御了所有被评估的攻击尝试。
即将面向开发者、企业和消费者推出
推动前沿发展需要快速行动,同时在部署上保持审慎。借助 Gemini 4 Carbon,我们的目标是在软件工程和网络安全防御方面实现有意义的飞跃,同时不牺牲安全性或可靠性。我们期待看到首批网络安全防御者如何使用这一模型,并期待很快将 Carbon 带给开发者、企业和消费者。
发布于: