随着开发者构建新一代智能体在边缘端执行任务,AI 正在从数据中心向外扩展:监控驾驶员注意力与座舱状况、帮助机器人理解周围环境并规划任务,以及在生产线上协调机器集群。这些物理 AI 应用依赖于能够在严格的内存、功耗和延迟预算内进行感知、推理和行动的模型。但要让模型准备好运行,可能需要大量的环境配置工作。
NVIDIA DGX Spark 现已提供 64GB 配置,为嵌入式开发者提供了一个用于原型设计、微调和测试模型与智能体的平台。NVIDIA TensorRT Edge-LLM 提供了一个专为嵌入式工作负载设计的轻量级 C++ 推理运行时,将相同的推理框架带到 Spark 上的开发以及 NVIDIA Jetson Thor、NVIDIA DRIVE AGX Thor 和 NVIDIA IGX Thor 等平台上的部署中。
只需几条命令,即可通过 trtedge 命令行界面(CLI)开始使用。它会下载你选定的模型,并构建针对 Spark 上推理优化的 TensorRT 引擎。
在本教程中,你将使用 TensorRT Edge-LLM 在 Spark 上运行 NVIDIA Nemotron-3.5 Lightning,这是一个纯文本模型。你将在终端中测试提示词,并通过 API 提供模型服务以进行应用原型设计。你还将启用 DSpark 投机解码来加速生成。
前提条件:设置开发环境
开始之前,你需要一台搭载受支持 NVIDIA 软件栈的 DGX Spark、NVIDIA CUDA 13、10.x 系列中 TensorRT 10.16.1.11 或更新版本,以及 Python 3.10 至 3.12。以下示例已使用 TensorRT Edge-LLM 0.11.1 和 TensorRT 10.16.1.11 进行测试。
在 DGX Spark 上打开终端,创建并激活虚拟环境,然后安装 TensorRT Edge-LLM:
python3 -m venv --system-site-packages .venv-edgellm
source .venv-edgellm/bin/activate
python -m pip install --upgrade pip
python -m pip install "tensorrt-edgellm[server]==0.11.1"
注意:虚拟环境会将新安装的包隔离开来,同时允许访问所有系统 Python 包,包括 TensorRT。
检查 TensorRT 版本,并确认 TensorRT Edge-LLM 运行时可以加载:
python -c "import tensorrt as trt; v = tuple(map(int, trt.__version__.split('.'))); assert (10, 16, 1, 11) <= v < (11,), f'TensorRT >=10.16.1.11 and <11 required; found {trt.__version__}'; from tensorrt_edgellm import runtime; runtime.load()"
注意:如果兼容的系统 TensorRT 绑定不可用,请按照NVIDIA TensorRT pip 安装说明在已激活的环境中安装兼容的 TensorRT 10.x 版本,然后重新运行验证命令。
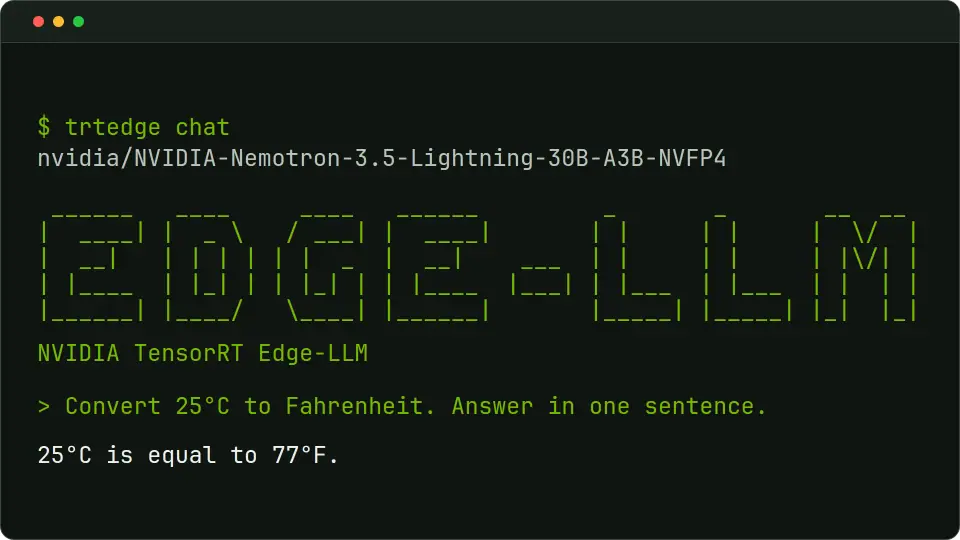
在虚拟环境仍处于激活状态时,启动与 Nemotron-3.5 Lightning 的对话:
trtedge chat nvidia/NVIDIA-Nemotron-3.5-Lightning-30B-A3B-NVFP4
首次启动时,请等待模型下载(约 21GB)和引擎构建完成。文件默认存储在 ~/.cache/tensorrt-edgellm 中,因此请为模型和引擎预留空间。后续启动将复用匹配的缓存引擎。
出现聊天提示符后,输入:
Convert 25°C to Fahrenheit. Answer in one sentence.
示例响应:
25°C is equal to 77°F.
继续提出后续问题以进行对话,或输入 /exit 结束会话。
提供模型服务
在 Spark 上通过本地 OpenAI 兼容 API 提供模型服务,用于应用开发和测试。
在虚拟环境处于激活状态时,启动服务器:
trtedge serve nvidia/NVIDIA-Nemotron-3.5-Lightning-30B-A3B-NVFP4 \
  --host 127.0.0.1 \
  --port 8000
服务器会为此配置构建或复用引擎。启动完成后,在 DGX Spark 上打开第二个终端,检查其是否就绪:
curl -fsS http://127.0.0.1:8000/health/ready
包含 "status":"ready" 的响应确认服务器已就绪。向聊天 completions 端点发送你的第一个提示词:
curl -fsS -N http://127.0.0.1:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
  "model": "nvidia/NVIDIA-Nemotron-3.5-Lightning-30B-A3B-NVFP4",
  "messages": [
    {
      "role": "user",
      "content": "Convert 25°C to Fahrenheit. Answer in one sentence."
    }
  ],
  "stream": true,
  "temperature": 0,
  "max_tokens": 128
}'
响应以 JSON 事件流的形式返回。保持服务器运行以处理更多请求,或在服务器终端中按 Ctrl+C 停止它。
可选:启用投机解码
你可以使用 DSpark 投机解码来加速生成,它使用草稿模型提出多个 token,供主模型在单次前向中验证。要启用它并使用三个草稿 token,请在服务器终端中按 Ctrl+C,然后以启用 DSpark 的方式重启服务器:
trtedge serve nvidia/NVIDIA-Nemotron-3.5-Lightning-30B-A3B-NVFP4 \
  --host 127.0.0.1 \
  --port 8000 \
  --speculative-config '{
    "method": "dspark",
    "model": "nvidia/NVIDIA-Nemotron-3.5-Lightning-30B-A3B-NVFP4-DSpark",
    "num_speculative_tokens": 3
  }'
服务器就绪后,向聊天 completions 端点发送另一个提示词,以尝试启用 DSpark 的生成。
你可以尝试调整 num_speculative_tokens 和其他设置,以针对你的工作负载调优生成速度。请参阅投机解码文档以了解更多信息。
DGX Spark 64GB 上的性能
TensorRT Edge-LLM 在 DGX Spark 64GB 上配合 NVIDIA Nemotron-3.5 Lightning 可实现低响应延迟和快速 token 生成。
下表报告了启用和不启用 DSpark 投机解码时的首 token 时间(TTFT)和生成速度。
表 1. Nemotron-3.5 Lightning 在 DGX Spark 64GB 上启用和不启用 DSpark 投机解码时的性能。
| 解码 | 工作负载 | 中位 TTFT(ms) | 平均生成速度(tokens/s) |
|---|---|---|---|
| DSpark 关闭 | SpeedBench 1K | 201.0 | 73.3 |
| DSpark 关闭 | SpeedBench 2K | 329.5 | 72.8 |
| DSpark 关闭 | HumanEval 提示词 | 98.1 | 73.4 |
| DSpark 开启 | SpeedBench 1K | 203.0 | 108.5 |
| DSpark 开启 | SpeedBench 2K | 331.6 | 105.3 |
| DSpark 开启 | HumanEval 提示词 | 98.7 | 126.9 |
生成速度是每个请求的平均 token 生成速率,不包括首 token 时间。DSpark 使用三个草稿 token。启用 DSpark 推理期间的系统总内存峰值使用量为 27.9GB,包括操作系统。
在运行 DGX OS 7.6.0(Ubuntu 24.04.4 LTS)的 DGX Spark 64GB 上测量,使用 NVFP4 并启用思考功能,批大小为 1,一个并发流式请求,输出限制为 128 个 token。SpeedBench 1K 的平均输入长度为 1,153 个 token,SpeedBench 2K 为 2,247 个,HumanEval 为 139 个。
后续步骤
尝试受支持模型列表中的另一个模型,并在 Spark 上继续开发你的应用。可选模型包括可解读图像和视频的视觉语言模型,以及语音识别和文本转语音模型。
浏览 TensorRT Edge-LLM 文档,了解目标嵌入式平台上特定模型的工作流程和要求。
并访问 Nemotron 开发者页面获取入门资源。在 Hugging Face 和 build.nvidia.com 上的 Blueprints 中探索开放的 Nemotron 模型和数据集。