对大规模 AI 工厂的运营者来说,最大化持续产出是提升生产力的关键。在超大规模 AI 训练中,集群里的每块 GPU 都必须每秒在数千次集合操作中同步梯度。同样,在推理阶段,计划外的停机会直接减少所能处理的请求总量,严重限制营收。
随着 AI 模型呈指数级增长,训练和部署它们所需的网络基础设施也必须同步扩展。然而在超大规模部署中,瞬时错误、链路劣化和节点中断是必然会发生的事。
为了维持最佳的集群利用率,网络必须保证这些紧密耦合的工作负载不间断地推进。单个丢包不能导致推理延迟飙升,也不能打断一次训练中的集合通信。在大规模场景下,即便是罕见的丢包也可能累积成显著的有效吞吐量(goodput)下降。这正是真正无损的网络结构成为生产级 AI 基础设施前提条件的原因。
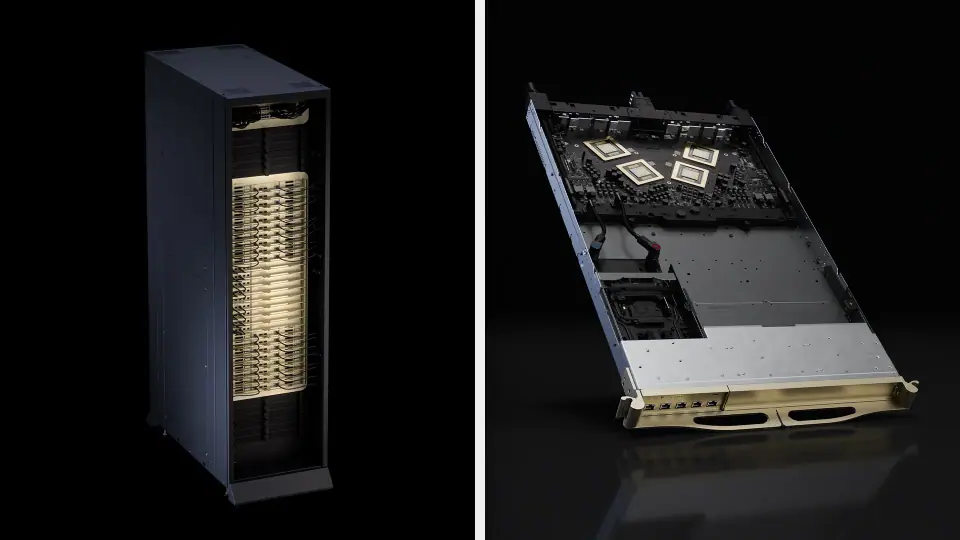
NVIDIA Vera Rubin 是一个全栈 AI 工厂平台,能在所有 AI 和加速计算工作负载之间灵活调配算力。针对 AI 工作负载,它旨在以 ¼ 的 GPU 数量完成训练,并以最低的 token 成本提供每瓦最高的推理吞吐量。Vera Rubin NVL72 是该平台的核心机架级计算引擎,通过 NVIDIA NVLink 6 纵向扩展(scale-up)网络结构,将 72 块 Rubin GPU 连接成单一的纵向扩展域,使它们能够作为一个整体计算单元运行。
NVIDIA NVLink 6 通过一套完整的弹性框架,为这些工作负载提供了毫不妥协的可靠性。NVLink 能够原生地检测、遏制瞬时信号错误并从中恢复,从而确保持续运行和集群生产力最大化。
为什么多层弹性是唯一出路
在现代 AI 工厂的规模下,被动响应式的协议和单点修复从根本上就不够用。作为 AI 互连领域的行业领导者,NVIDIA 将 NVLink 的弹性设计为一个精心整合的多层栈,横跨硬件、系统设计和软件。
首先,在物理层和链路层,NVLink 实现了原生无损的网络结构。它结合了前向纠错(FEC)、物理层重传(PLR)和通用物理层(UPHY)恢复,实现快速纠错和链路稳定。此外,它还采用基于信用的流控(CBFC),从机制上消除丢包,并部署主动的错误遏制,在故障级联扩散之前立即将其隔离。
其次,由于任何低于完全系统冗余的设计都是隐患,该架构被设计为不存在任何单点故障。冗余的交换托盘、分布式 NMX Controller 以及双路带外管理通道,确保即使个别组件失效,整个域仍能保持运行。
最后,在应用层和软件层,Dynamo Shadow Engine Recovery 等功能利用预热好的副本进程实现近乎即时的故障切换,而应用级的检查点与恢复机制则确保长时间运行的任务得到严格保全。这种紧密整合的多层方法,是让硬件异常被无缝遏制、让运行中的工作负载不受中断,并提供超大规模 AI 所需的毫不妥协的正常运行时间的唯一经过验证的途径。

下面我们详细介绍这套多层架构在实际中是如何运作的。
通过物理层在源头化解错误
在最底层的物理层,NVLink 直接在硅片层面应对电气噪声和信号劣化。在极高的信号速率下,噪声引起的比特错误不可避免。现成的网络结构依赖标准的重量级 FEC 算法,会带来显著的处理开销和多跳延迟。相比之下,NVLink 是专为紧密耦合的纵向扩展 AI 工作负载而设计的。
关键在于,NVLink 之所以能避开这些重量级 FEC 算法,是因为它把 PLR 用作快速的第二道防线。这种架构上的协同,使 NVLink 能够采用轻量、高效的 FEC 架构。这种做法不像简单的奇偶校验那样只做故障检测,而是让发送端口在数据流中附加高级纠错码。
接收端随后利用这些纠错码,通过数学方法就地重建被破坏的比特,以几乎为零的延迟代价纠正单比特或多比特错误。这种高效率直接促成了 NVLink 相比通用以太网方案实现 3 倍更低的端到端延迟和 10 倍更高的数据包速率。
当错误突发超出这种轻量 FEC 的纠正能力时,第二道防线会立即启动。PLR 是一种成熟且久经验证的物理层数据包重传机制。由于直接在物理层处理重传,PLR 无需调用任何上层软件栈,就能有效地将丢包降为零。
最后,如果严重劣化触发了物理层 Link Down 事件,UPHY 恢复会迅速重新校准物理参数,同时数据包被安全地保存在硬件重放缓冲区中,以确保零数据丢失。
通过链路层确保无损传输
再往上一层,NVLink 依靠链路层来管理网络拥塞,而无需上层软件介入。支撑这一层的是 CBFC,它是 NVLink 与传统协议相比建立原生无损网络结构的关键区别所在。基于以太网的标准纵向扩展方案,试图通过优先级流控(PFC)和显式拥塞通知(ECN)等外挂机制来近似实现无损。
然而,这些被动响应式的做法本身会引入新的故障模式,例如队头阻塞、PFC 风暴和死锁。这些弱点使拥塞管理本身变成了弹性风险。此外,传统基于确认的方案要求接收方事后通报成功或失败,在缓冲区溢出并需要重传时会增加延迟。
有了 CBFC,发送方只有在持有信用、表明下一跳有缓冲空间可以接收数据包时,才会向网络注入数据包。这种主动式做法从设计上消除了丢包,在硬件层面保证无损传输,而且不会出现以太网 PFC 那样的网络暂停。
由于传输中不会有数据被悄悄丢弃,网络行为始终高度可预测,延迟稳定且低。与此同时,如果底层物理链路发生劣化,Link Manager 会通过执行接入链路和主干链路再平衡,自主修复 NVLink 网络结构。
最重要的是,它确保硬件故障能够就地遏制在发生之处,而不会引发困扰现成以太网 AI 集群的级联重传、超时或集合通信停滞。

通过应用层软件恢复隔离故障
应用层提供智能的、由软件驱动的事务恢复(SW Recovery),耗时约 1.5 秒。发生链路错误时,NMX Controller 会直接与 GPU 驱动交互,将受影响的链路置于“遏制并排空”(contain and drain)状态。这使硬件能够在不破坏数据的情况下自动重新训练劣化的链路,同时防止整个网络结构范围的反压。
为了消除控制平面的单点故障,NVLink SDN 控制器(NMX-C)采用了 NMX 高可用性(NMX-HA)。NMX-C 运行在某个交换托盘上,如果主宿主出现故障,它会在数秒内自动将其功能控制器迁移到另一个托盘。此外,NVLink 交换托盘的数据平面与运行 NVOS 的交换机管理 CPU 完全解耦。即使发生计划外的 CPU 重置或操作系统故障,数据平面也会继续不间断转发,使 NVOS 能够在没有丢包、不中断工作负载的情况下恢复。
借助 Shadow Engine Recovery 实现 NCCL 软件层面的弹性
虽然 NVLink 的物理层和链路层成功遏制并纠正了绝大多数信号错误,但无法纠正的链路劣化偶尔仍会到达软件栈。在多 GPU 推理部署中,LLM 依靠 NVIDIA Collective Communications Library(NCCL)在 NVLink 网络结构上快速同步数据。如果 NVLink 连接发生严重中断,可能引发瞬时通信故障,导致 NCCL 操作失败,并迫使正在运行的 LLM 引擎中止。
过去,这需要对推理引擎进行完整的冷启动。这一过程包括把模型权重重新加载到 HBM、重新编译内核以及重新捕获 CUDA graph,所有这些都可能使推理服务中断数分钟,并严重影响 token 吞吐量。为消除这一瓶颈,软件弹性栈采用了 Shadow Engine Recovery,这是 NVIDIA Dynamo 中的一项功能,旨在绕过冷启动,在数秒内恢复推理能力。
由于 NCCL 通信器与创建时正在运行的那一组特定活动进程紧密绑定,在进程崩溃后无法动态移交给替代进程。
Shadow Engine 架构的解决办法是:在活动推理引擎旁边维护一个完全初始化的空闲副本进程。启动期间,这个待命引擎会预先建立自己独立的 NCCL 和 NIXL 通信器。如果硬件故障中断了主进程的通信上下文,shadow engine 已经拥有一个健康的、预热好的、绑定到 NVLink 网络结构的网络拓扑。这使它能够立即恢复分布式运算(例如张量并行,TP),而无需等待重建 NCCL 通信器或重新加载模型权重。在 NVIDIA B200 GPU 上的基准测试部署中,shadow engine 恢复把推理停机时间从 283 秒缩短到仅 7.3 秒。
此外,对于需要在硬件故障期间适应节点数量变化的工作负载,软件栈集成了 NCCL 弹性支持,以动态伸缩通信器,让任务保持平稳运行。

借助 CUDA 检查点实现 NCCL 软件层面的弹性
中断偶尔确实会发生,并需要在新节点上重启推理引擎的部分或全部进程。为加速这类场景,CUDA 支持基于 CRIU 的进程级检查点。这使完整的 LLM 工作进程可以在 GPU 上被快速地做检查点和恢复,绕过启动开销。Dynamo Snapshot 整合了这项工作,将启动时间改善了一个数量级。
直到最近,这种检查点方法还只包含节点本地状态,并且必须在创建任何网络连接或 CUDA graph 之前进行。为突破这一限制,NCCL 引入了对 cuda-checkpoint 的原型支持(预计年底前正式发布),使多节点检查点能够捕获启动和加载 LLM 推理引擎过程中几乎所有的工作。这种方法显著降低了推理服务和智能体等对延迟敏感的工作负载的启动与重启开销。
在这一有弹性的软件基础之上,应用还可以可靠地利用通过 NVIDIA NeMo 框架实现的异步检查点,或通过 NVComp 实现的检查点压缩,借助高带宽的 NVLink 网络结构保存状态,进一步节省时间。对于大规模前沿模型,这种组合极大地缩短了同步阻塞时间,把检查点开销从数分钟降到数秒,并确保在发生故障时快速恢复。

通过机架可维护性维持正常运行时间
在宏观层面,系统层负责长期状态保全以及机架级的物理健康与可维护性,处理耗时超过一分钟的重大恢复。这种宏观层面的弹性依赖于网络与计算栈的深度整合。NCCL 天然感知 NVLink 拓扑,因此能够通过重建集合通信的环或树来绕开故障硬件,动态适应劣化的链路。
与此协同,CUDA 为有序内存操作提供了更丰富的错误报告和弹性模型。CUDA 将硬件故障干净地暴露给运行时,而不是任由系统悄无声息地挂起,从而确保应用保持感知并能够响应。
对于数据中心的物理运维,Switch Admin State 把 NVSwitch 托盘维护变成了有针对性的、不中断业务的操作。系统管理员可以更换单个交换托盘,而无需排空整个 NVLink 域,也不会中断正在运行的 AI 任务。管理状态会让被更换的链路保持在非运行模式,在被明确验证并启用之前,防止其过早加入。
此外,NVLink 原生支持部分装配的机架。NMX Controller 会自动发现可用硬件,并为当前存在的任何计算或交换托盘配置路由,使分阶段部署或维护周期中也能无缝运行。
通过 NVLink Fusion 将多层弹性扩展到自研 XPU
上文详述的完整弹性栈并不局限于使用 NVIDIA GPU 的部署。随着超大规模云厂商和 AI 原生公司越来越多地为专门的工作负载构建自研 XPU,他们同样需要大规模下毫不妥协的可靠性水平。过去,把最先进的容错纵向扩展网络集成到自研芯片中一直是一道巨大的工程难关。
NVLink Fusion 通过把 XPU 连接到 NVIDIA AI 基础设施来应对这些挑战。这种集成让第三方芯片能够无缝继承本文通篇讨论的同一套 NVLink 纵向扩展网络结构和多层弹性栈。借助这一经过验证的成熟平台,NVLink Fusion 帮助超大规模云厂商和 AI 原生公司提升性能、加快上市时间,并集成当今 AI 工厂所需的可靠性。
在大规模下确保毫不妥协的可靠性
当各组织为超大规模 AI 和加速计算工作负载评估纵向扩展架构时,仅比较简单的带宽指标是不够的。真正的规模化需要全栈式的容错方法。
NVLink 6 专为通过整体的多层容错方法最大化 MTBI 而打造。从亚毫秒级的物理层纠错和原生的基于信用的流控,到解耦的管理平面和机架级可维护性,NVLink 提供了让全球最复杂的 AI 工厂不间断运行所需的弹性。
详细了解 NVIDIA Vera Rubin 平台、NVLink 和 NVLink Fusion。
或者看看纵向扩展网络如何决定 AI 工厂的经济性。