开发者的工作方式正在发生真实的转变。智能体打开了过去难以涉足的工作领域,原因并非技术上不可能,而是这些工作需要我们大多数人不具备的小众专业知识。容器化、推理服务器配置、特定模型的环境搭建:这类任务过去要么需要深厚的专业积累,要么得先花上几个小时自学,才能真正动手。智能体提供了一种优雅的方式,帮我们弥补这些前置知识的缺口。你描述想要什么,智能体来补上知识的空白。
这才是真正的突破。不是速度,而是可及性。
Netflix 发布新模型的那一天
Netflix 最近在 Hugging Face 上发布了 void-model。它发布当天,我的第一反应一如既往:我想试试。但想试一个新模型和真正把它跑起来是两回事。把它放进可用的环境、搞定推理服务器的配置、弄清楚容器配置、再把一切正确地串起来:这些环节通常会让“看起来不错”和“好,我真的在用了”之间产生一两天的时间差。
这一次,这个时间差几乎为零。
我借助命令行智能体运行器 Goose,再配合 Together 的专用容器 skill,在一次会话里就从“Netflix 刚发布了一个模型”走到了“我有了一个跑着它的容器”。智能体生成了在 Together 的专用容器推理(Dedicated Container Inference,DCI)基础设施上部署 void-model 所需的全部代码,基本上就在模型发布当天。
成果放在这里:github.com/blainekasten/together-void-model-container
具体做法
整个过程只需三步。
第一步:安装 Together 专用容器 skill。
npx skills add togethercomputer/skills
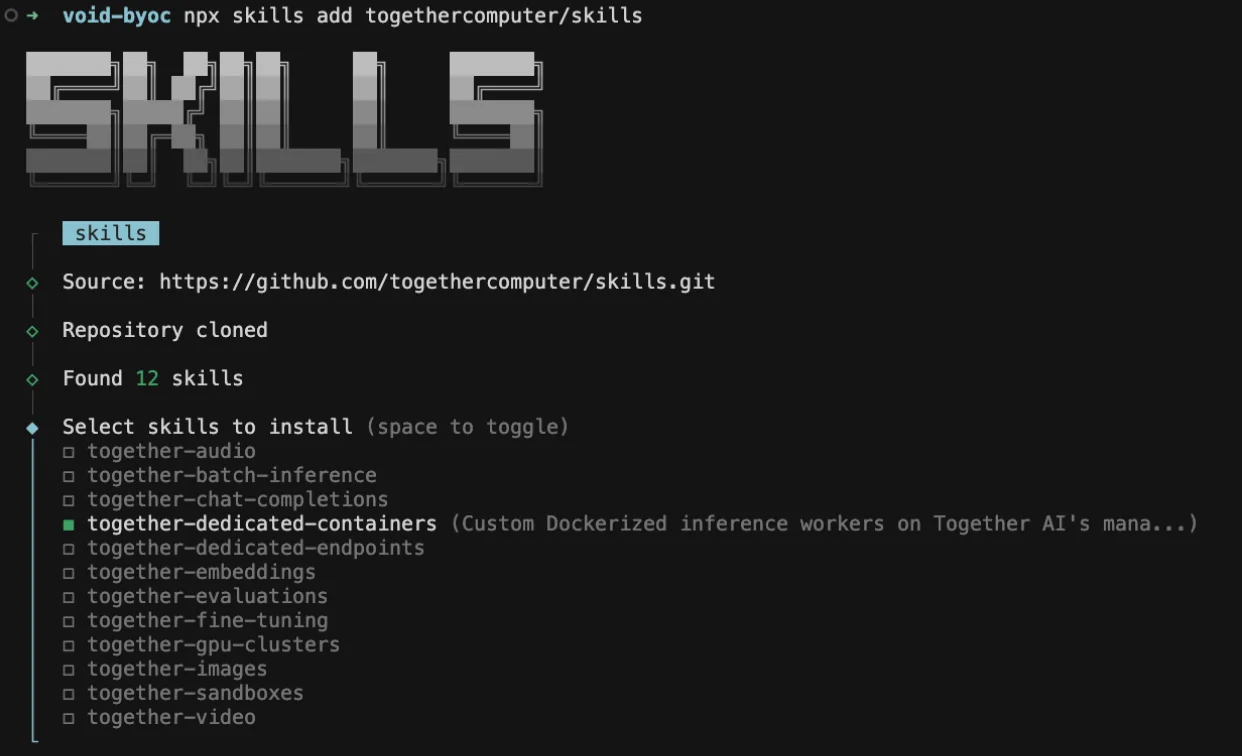
这会引入 together-dedicated-containers skill,让 Goose 掌握与 Together 基础设施打交道所需的具体知识:如何配置推理服务器、容器规范应该是什么样、如何针对某个模型把一切串起来。
第二步:启动一个 Goose 会话,运行一条提示词。
I want to deploy this model on togethers dedicated containers https://huggingface.co/netflix/void-model
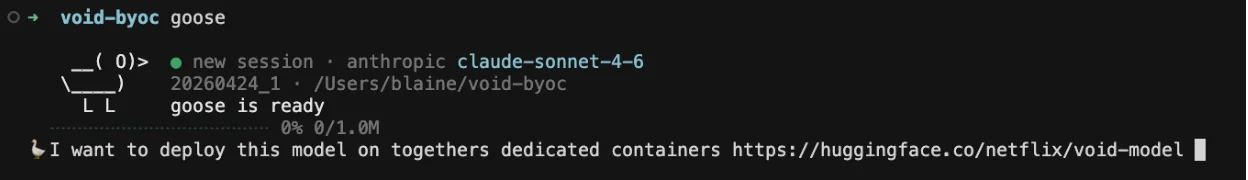
就这样,一句话。
第三步:坐下来看它干活。
接下来,智能体从 Hugging Face 拉取了模型详情,针对该模型架构确定了合适的推理服务器配置,生成了容器配置文件,并产出了完整、可运行的方案。整个过程我不用查任何资料,也不用一步步指导它。
结果是:blainekasten/together-void-model-container,一个干净、可用的仓库,任何人都可以用它在 Together 基础设施上运行 void-model。
第四步:使用你的模型!
智能体部署好应用后,你就可以开始对它运行推理了。Together CLI 提供了便于测试推理的命令。
tg beta jig submit --watch --payload '{
    "video_url": "https://github.com/Netflix/void-model/raw/refs/heads/main/sample/lime/input_video.mp4",
    "quadmask_url": "https://github.com/Netflix/void-model/raw/refs/heads/main/sample/lime/quadmask_0.mp4",
    "prompt": "Empty park bench with fallen leaves on the ground",
    "use_pass2": false
  }'
这个模型可以把物体从视频中移除,同时移除它们对场景产生的所有交互影响,不仅包括阴影和倒影这类次要效应,还包括物理层面的交互,比如把人移除后,原本由人支撑的物体会掉落。
我们对该模型的推理调用是异步的。因此这个请求的响应会返回一个带有标识符的载荷,我们可以据此轮询。响应如下所示:
{
  "model": "void-byoc",
  "request_id": "019dc0f3-3c73-7a3f-b4b6-87ad06091180",
  "status": "running",
  "claimed_at": "2026-04-24T19:24:19.447457Z",
  "created_at": "2026-04-24T19:24:19.444567Z",
  "done_at": null,
  "info": null,
  "inputs": {
    "prompt": "Empty park bench with fallen leaves on the ground",
    "quadmask_url": "https://github.com/Netflix/void-model/raw/refs/heads/main/sample/lime/quadmask_0.mp4",
    "use_pass2": false,
    "video_url": "https://github.com/Netflix/void-model/raw/refs/heads/main/sample/lime/input_video.mp4"
  },
  "outputs": null,
  "priority": 1,
  "retries": null,
  "warnings": null
}
推理完成后,输出会包含托管视频的 URL。我们可以用 cURL 和 Together API 密钥下载它:
curl -L -O \
  https://api.together.ai/v1/storage/019dc0f3-3c73-7a3f-b4b6-87ad06091180-tmpddmhtvar.mp4 \
  --header "Authorization: Bearer $TOGETHER_API_KEY"
注意:-L 用于跟随存储 URL 中的 HTTP 重定向,-O 会把输出写入本地文件。
▶ https://together-website.b-cdn.net/video/019dc0f3-3c73-7a3f-b4b6-87ad06091180-tmpddmhtvar.mp4
为什么选择 Together 专用容器推理
这个故事之所以成立,是因为 Together 的专用容器推理(DCI)确实非常适合运行这类模型,有必要解释一下原因。
DCI 为你提供一个私有的、由 GPU 支撑的环境,运行你选择的模型,并由 Together 全面托管。你不用去争抢共享资源,不用自己配置集群,也不会被限定在固定的可用模型清单里。模型由你带来,基础设施交给 Together。
对想要快速行动的团队来说,这意义重大。当 Netflix、某个研究实验室或开源社区发布新模型时,你几乎可以立刻在生产级环境中把它跑起来。不用自己启动 GPU 虚拟机,不用和推理服务器的依赖搏斗,也不用等别人在托管端点中添加支持。DCI 在设计上就很灵活:只要模型存在,你就能部署它。
成本模式也便于试验。你只为用到的部分付费,用的是属于你自己的容器,而且无需承担管理底层算力的开销。有了这样的配置,你才能对测试新模型说“好”,而不是把它归入“等有空再说”。
如果你对 Together 的 DCI 感兴趣,欢迎联系我们进行配置。