部署大语言模型只是迈向生产级服务的第一步。生产团队还需要在现有 GPU 基础设施上服务尽可能多的并发用户,同时保持让应用响应灵敏的交互性。
对于智能体(agentic)AI 工作负载,这种权衡更为重要:提示词可能很长,上下文会在多个步骤间复用,应用还常常需要向用户流式返回较长的响应。
NVIDIA NIM 将针对特定模型和 GPU 的服务选择打包成可部署的微服务。开发者无需从空白的运行时配置起步,而是直接获得经过验证的服务配置和受支持的部署路径,同时仍可用自己的流量对 NIM 进行基准测试。
NIM 的附加价值:性能工程与生产就绪
推理性能是一种系统属性。精度与内核、并行方式、调度、批处理、内存分配、前缀复用、模型专属的状态缓存以及解码策略,彼此相互影响。只有在满足应用延迟目标的前提下提升吞吐量,一套配置才有价值。
NIM 把这些优化工作变成一个经过测试的起点。NVIDIA 工程师针对受支持的模型、GPU 和精度组合验证配置,再把运行时和模型制品封装在标准 API 之后。对于生产部署,NIM Certified 还通过 NVIDIA AI Enterprise 提供定期的推理栈更新、CVE 处理、更广泛的硬件验证以及商业支持。
NIM 在同一条部署路径上带来两项收益:经过验证的性能工程,以及面向企业的容器生命周期和支持模式。
案例研究:Nemotron 3 Ultra NIM 将智能体工作负载的吞吐量最高提升 2.5 倍
本文通篇使用的基准测试定义如下:
- 硬件:4xB200
- 智能体工作负载:64K/400/76% KV 复用/50 TPS/用户(20 ms ITL)
这张 Pareto 图对比了开源基线服务栈(NIM Off)与完全优化的 NIM 2.0.12 服务栈(NIM On)。
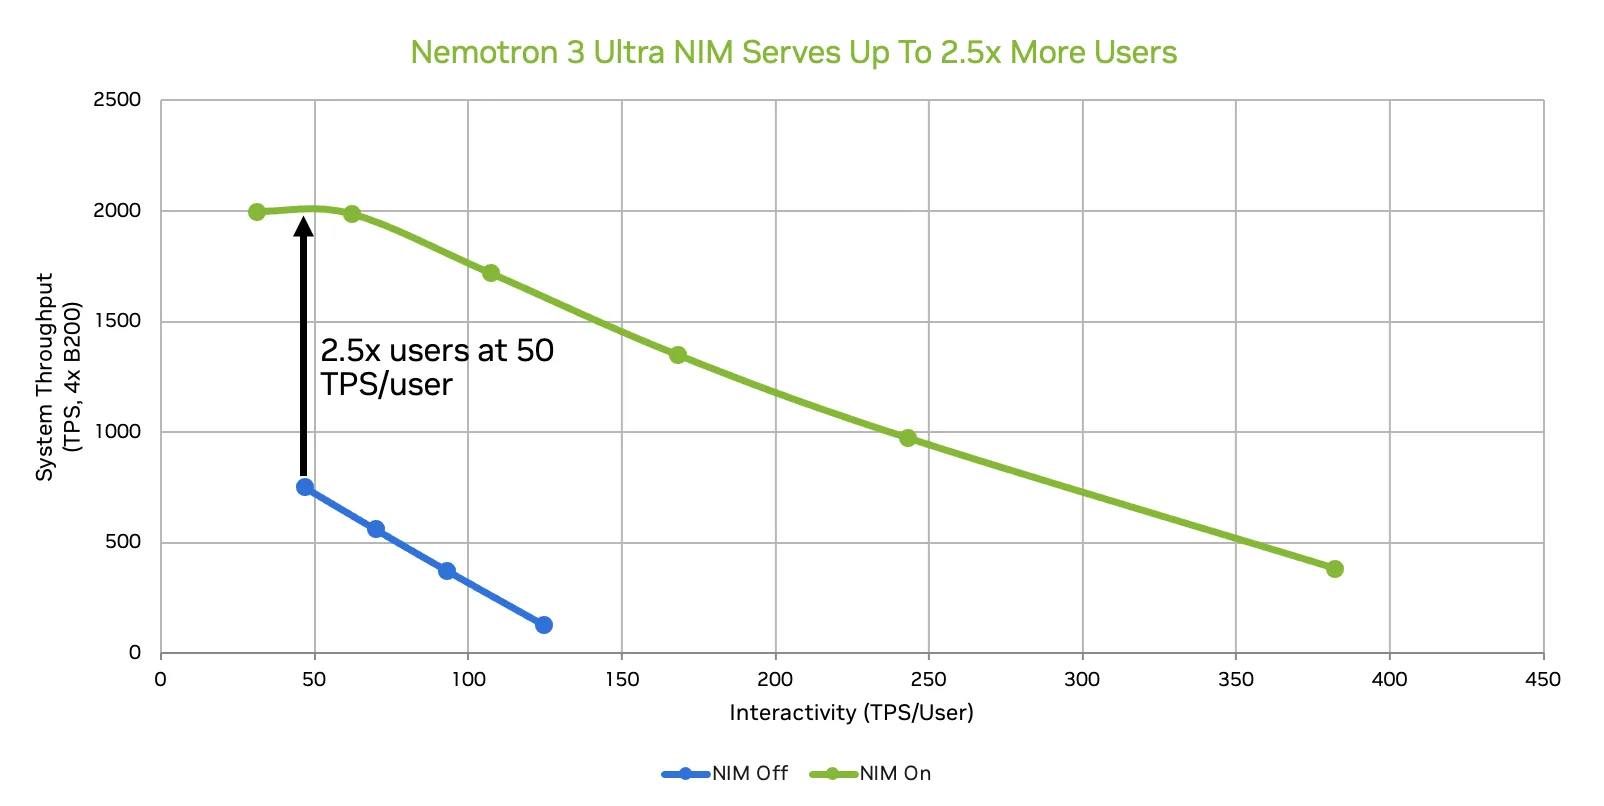
表 1. 在 50 TPS/用户目标下,四块 B200 GPU 的系统输出词元吞吐量
| 配置 | 原生 256K 最大上下文 | 含义 |
|---|---|---|
| NIM Off 基线 | 718 tok/s | 不含任何 NIM 优化 |
| NIM On(2.0.12)优化服务栈 | 1,997 tok/s,为基线的 2.5 倍 | 优化后的 NIM 栈:缓存/状态复用、MTP 推测解码及相关修复、自动调优内核、部分前缀匹配,以及调度器、批处理、内存和并行方式的调优 |
NIM 2.0.12 优化服务栈的工作原理
实测收益来自相互作用的配置组合,而不是各自独立、百分比可以直接相加的开关。主要的优化层包括:
- 精度与自动调优的模型感知内核。自动调优的混合专家(MoE)和 Mamba 内核,把这种混合架构高效地映射到 NVIDIA Blackwell GPU 上。
- 并行执行。张量并行将模型分布到四块 GPU 上,而专家感知(expert-aware)执行则提高了混合专家层的利用率。
- 前缀与模型状态复用。前缀缓存避免重复计算相同的上下文,部分前缀匹配则在仅有一部分前缀匹配时仍能找回复用,Mamba 状态缓存的设置也针对该模型架构做了调优。
- 调度器、批处理与内存调优。并发序列数上限、批处理词元数上限、块大小和 GPU 内存分配,使更多任务得以同时进行,又不会突破延迟目标。
- MTP 推测解码。NIM 2.0.12 优化服务栈(含 MTP)在同一优化服务栈中加入了 MTP 及其相关修复。其增量收益取决于接受率和可用的内存余量。
用你自己的工作负载对 NIM 做基准测试
公布的曲线只是一个起点,并不保证每个应用都能得到同样的结果。判断是否适用的最快办法,是回放有代表性的流量,并针对用户关心的延迟指标绘制 Pareto 曲线。
- 部署确切的软件版本。使用 NIM 2.0.12(或更新版本),并在每次运行时固定镜像标签或摘要(digest)。
- 准备有代表性的流量。使用 Mooncake 格式的 JSONL 追踪文件,或捕获受控的 NIM 请求,并对敏感数据采取适当的访问控制和脱敏处理。
- 测量性能。使用 NVIDIA AIPerf 回放有代表性的流量,获取性能基准数据。
- 选出满足 SLO 的 Pareto 点。在满足 SLO/延迟约束的点之间比较输出吞吐量,并判断是否适合部署:
for C in 1 4 8 16 32 64; do
   aiperf profile \
 	--model nvidia/nemotron-3-ultra-550b-a55b \
 	--endpoint-type chat --streaming \
 	--url localhost:8000 \
 	--input-file ./agentic-trace.jsonl \
 	--custom-dataset-type mooncake_trace \
 	--no-fixed-schedule \
 	--concurrency "$C"
 done
AIPerf 并发扫描示例。请把追踪文件、请求数量和端点信息替换为你要建模的工作负载。
下载并运行 Nemotron 3 Ultra NIM
从 Nemotron 3 Ultra NIM 页面开始,接受适用条款,然后选择 NIM 2.0.12 标签或已发布的确切摘要。下载完成后,查找并选择一个配置档(profile)。下面列出了 NIM 中打包的所有配置档:
 export NGC_API_KEY=<your-personal-api-key>
 export LOCAL_NIM_CACHE=$HOME/.cache/nim
 export NIM_TAG=2.0.12
 mkdir -p "$LOCAL_NIM_CACHE"
 echo "$NGC_API_KEY" | docker login nvcr.io \
   --username '$oauthtoken' --password-stdin
 docker run --gpus all --shm-size=16GB \
   -e NGC_API_KEY \
   -e NIM_MODEL_PROFILE \
   -v "$LOCAL_NIM_CACHE:/opt/nim/.cache" \
   -p 8000:8000 \
   nvcr.io/nim/nvidia/nemotron-3-ultra-550b-a55b:$NIM_TAG list-model-profiles
要为四卡 B200 系统上的智能体工作负载选择优化配置档,可以将 NIM_MODEL_PROFILE 设为 vllm-nvidia-b200-nvfp4-tp4-pp1-throughput-90.0,并启用推测解码:
 export NGC_API_KEY=<your-personal-api-key>
 export LOCAL_NIM_CACHE=$HOME/.cache/nim
 export NIM_TAG=2.0.12
 export NIM_MODEL_PROFILE=vllm-nvidia-b200-nvfp4-tp4-pp1-throughput-90.0
 mkdir -p "$LOCAL_NIM_CACHE"
 echo "$NGC_API_KEY" | docker login nvcr.io \
   --username '$oauthtoken' --password-stdin
 docker run --gpus all --shm-size=16GB \
   -e NGC_API_KEY \
   -e NIM_MODEL_PROFILE \
   -e NIM_SPECDEC_ENABLE=1 \
   -v "$LOCAL_NIM_CACHE:/opt/nim/.cache" \
   -p 8000:8000 \
   nvcr.io/nim/nvidia/nemotron-3-ultra-550b-a55b:$NIM_TAG
面向生产、经过性能工程的起点
NVIDIA NIM 将针对特定模型和 GPU 的服务优化打包成可部署的微服务。对于 4xB200 系统上的 Nemotron 3 Ultra,这些优化使企业在 50 TPS/用户下能比 NIM 关闭的基线多服务最多 2.5 倍的用户,同时让部署路径对真实的多用户服务保持切实可行。
NIM 将经过验证的性能工程与定期的推理栈更新、CVE 处理、硬件验证以及通过 NVIDIA AI Enterprise 提供的商业支持结合在一起。NVIDIA 还计划为更多模型推出经过性能优化的 NIM 配置,为开发者针对自身延迟、吞吐量和成本目标提供更多经过验证的起点。
开始使用
从 NGC 下载 Nemotron 3 Ultra NIM 2.0.12,在你的 NVIDIA GPU 基础设施上运行,并用 NVIDIA AIPerf 回放有代表性的流量,选出满足应用目标的 Pareto 点。
资源