太长不看
Mamba-3 是一种以推理效率为首要目标设计的新型状态空间模型(SSM),这与以训练速度为优化目标的 Mamba-2 不同。其关键升级包括表达能力更强的递推公式、复数值状态跟踪,以及一个能在不拖慢解码的前提下提升精度的 MIMO(多输入、多输出)变体。
结果是:在 1.5B 规模下,无论序列长度如何,Mamba-3 SISO 在预填充加解码的延迟上都优于 Mamba-2、Gated DeltaNet,甚至优于 Llama-3.2-1B(Transformer)。
团队还开源了这些内核,它们混合使用 Triton、TileLang 和 CuTe DSL 构建,以获得最高的硬件性能。
这篇博客同步发布在 Goomba Lab 博客上,内容涵盖卡内基梅隆大学、普林斯顿大学、Cartesia AI 和 Together AI 研究人员的合作成果。
自 2024 年年中发布 Mamba-2 以来,大多数架构都已从 Mamba-1 切换过来。为什么?Mamba-2 押注训练效率是状态空间模型(SSM)最大的瓶颈,因此简化了底层 SSM 机制,使训练速度比前代快 2−8 倍,从而得到更广泛的采用。
此后,LLM 的格局开始变化。预训练固然依旧非常重要,但更多的关注转向了后训练和部署,两者都极度依赖推理。后训练方法的扩展,尤其是面向代码或数学的可验证奖励强化学习(RLVR),需要海量生成的 rollout;而最近的智能体工作流,如 Codex、Claude Code,甚至 OpenClaw,更是让推理需求飙升。
尽管推理的重要性显而易见且与日俱增,许多线性架构(包括 Mamba-2)却是从训练优先的角度开发的。为了加速预训练,底层 SSM 被逐步简化(例如,对角转移矩阵被简化为标量乘以单位矩阵)。这带来了训练速度,却让推理这一步“过于简单”,彻底受限于内存带宽:GPU 大部分时间不是在飞速计算,而是在搬运内存。
在这个推理的新时代,我们非常在意推动质量与效率前沿的边界:我们希望更好的模型运行得更快。
于是自然产生一个问题:
一个以推理为出发点设计的 SSM 会是什么样子?
Mamba-3 模型
缺了什么?线性模型的吸引力就在名字里:由于状态大小固定,计算量随序列长度线性增长。遗憾的是,天下没有免费的午餐。正是这种固定的状态大小实现了高效计算,也迫使模型把所有过去的信息压缩进同一个表示中,这与 Transformer 恰好相反,后者通过不断增长的状态(KV 缓存)存储所有过去的信息,这是一个根本性的差异。那么,如果不能让状态增长,如何让这个固定的状态承担更多工作?
我们发现,早期的设计为了让训练变快而简化了递推和转移矩阵。然而,这一改动也削弱了动力学的丰富性,并让解码受限于内存:相对于内存搬运,每个 token 的更新只做很少的计算。这给了我们三个可以拉动的杠杆:(1) 让递推本身更具表达力,(2) 使用更丰富的转移矩阵,(3) 在每次更新中加入更多并行(且几乎免费)的工作。
基于这些洞察,我们从三个核心方面改进了 Mamba-2:
- 通过由我们的指数梯形离散化方案(exponential-trapezoidal discretization)推导出的更一般的递推,提升 SSM 机制的表达能力;
- 通过建模复数值 SSM 系统,扩展状态跟踪能力;
- 使用多输入、多输出(MIMO)SSM,即并行建模多个 SSM,而不是目前的单输入、单输出(SISO)SSM,在几乎不影响解码延迟的情况下提升模型的整体性能。
通过这三项改动,Mamba-3 在保持相近推理延迟的同时,推进了性能前沿。
值得注意的是,这三项改动都受到更“经典”的控制理论和状态空间模型文献的启发。
我们的工作与许多现代线性架构背道而驰,后者采用对递推的另类解释(如线性注意力或测试时训练),而这些解释很难捕捉这些概念。
架构
Mamba-2 层有哪些变化?除了上面讨论的对核心 SSM 的三项方法论升级之外,我们还对架构做了一些改造,使其更贴近传统的现代语言模型。
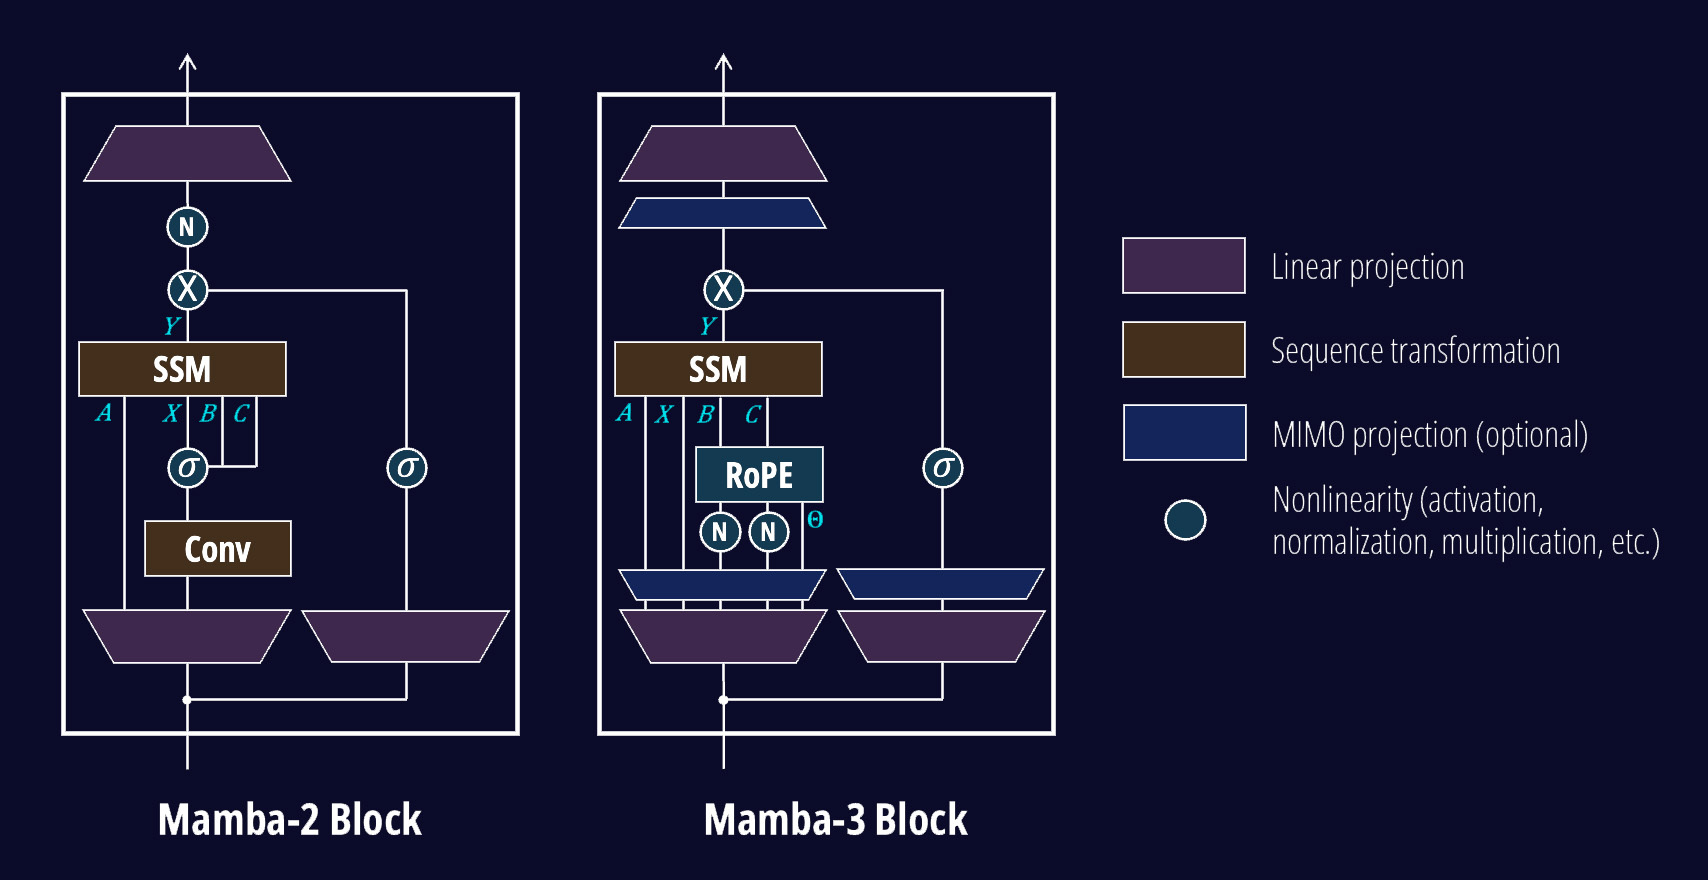
从示意图可以看出,我们改动了几处。概括来说,
归一化。我们加入了 QKNorm(用 SSM 的术语说是“BCNorm”),经验上它能稳定 Mamba-3 模型的训练。加入这一归一化使 Mamba-3 与当代 Transformer 和 Gated DeltaNet(GDN)模型保持一致。有了 QKNorm,Mamba-2 中的 RMSNorm 就变成可选项。不过我们通过实验发现,由于有助于长度外推能力,在混合模型中保留它可能仍然值得。稍后会详细介绍。
告别短卷积。通过把 (1) BCNorm 之后对 B 和 C 的简单偏置,与 (2) 我们基于离散化的新递推相结合,我们得以去掉 Mamba-1/2 中烦人的短因果卷积。新的递推隐式地对输入到隐藏状态的过程施加了卷积,我们会在博客第二部分说明为何如此。
短卷积真的可以去掉吗?
Mamba-3 的改动在 SSM 递推内部加入了类似卷积的成分,但与置于 SSM 递推外部的标准短卷积并不完全等价、不能互换。
后者仍然可以与 Mamba-3 一起使用,不用它是我们根据实验做出的决定。我们发现把标准短卷积加回去:
- 并不会提升性能,反而略微使其变差;
- 也不会削弱在更贴近真实世界的任务(如 NIAH)上的检索能力。不过,没有短卷积时,在 MQAR 这类小规模合成任务上训练会稍难一些。但由于真实世界的检索表现不受影响,我们不认为这是一个主要的局限。
至于原因?我们没有研究其理论机制,但在论文中我们推测,BC 偏置和指数梯形递推都实现了类似卷积的机制,在经验上起到了与外部短卷积相同的作用。
关于短卷积的简短历史课。
短卷积如今已是当下大多数高性能线性模型的核心组件。短卷积的各种版本最早用于循环架构,见于 H3(以“移位 SSM”的形式,其灵感来自 Anthropic 关于“涂抹式”归纳头的工作)和 RWKV-4(通过其“token 移位”机制),之后由 Mamba-1 以现在的形式推广开来。
它之所以如此普遍,是因为此前的工作反复表明,短卷积既能在经验上提升性能,也能在理论上支持归纳式检索能力。
最后,你会注意到几个新组件,即 RoPE 和 MIMO 投影。RoPE 模块通过把复数转移解释为旋转来表达复数值 SSM,从而避免了代价高昂的内核重新实现。MIMO 投影则把 B 和 C 矩阵扩展为 MIMO SSM 所需的相应表示。
我们会在博客第二部分更详细地探讨这两者的动机和具体实现(那里有很多好东西 🎁),所以现在先把它们看作各自独立的基础性改进,各自都有助于提升模型的性能和/或能力。
最后,我们的整体架构现在采用交错的 MLP 层,沿用 Transformer 和其他线性模型的标准做法。
实验结果
我们将最终的 Mamba-3 模型与其他流行的线性替代方案以及 Transformer 基线进行了评估。
语言建模
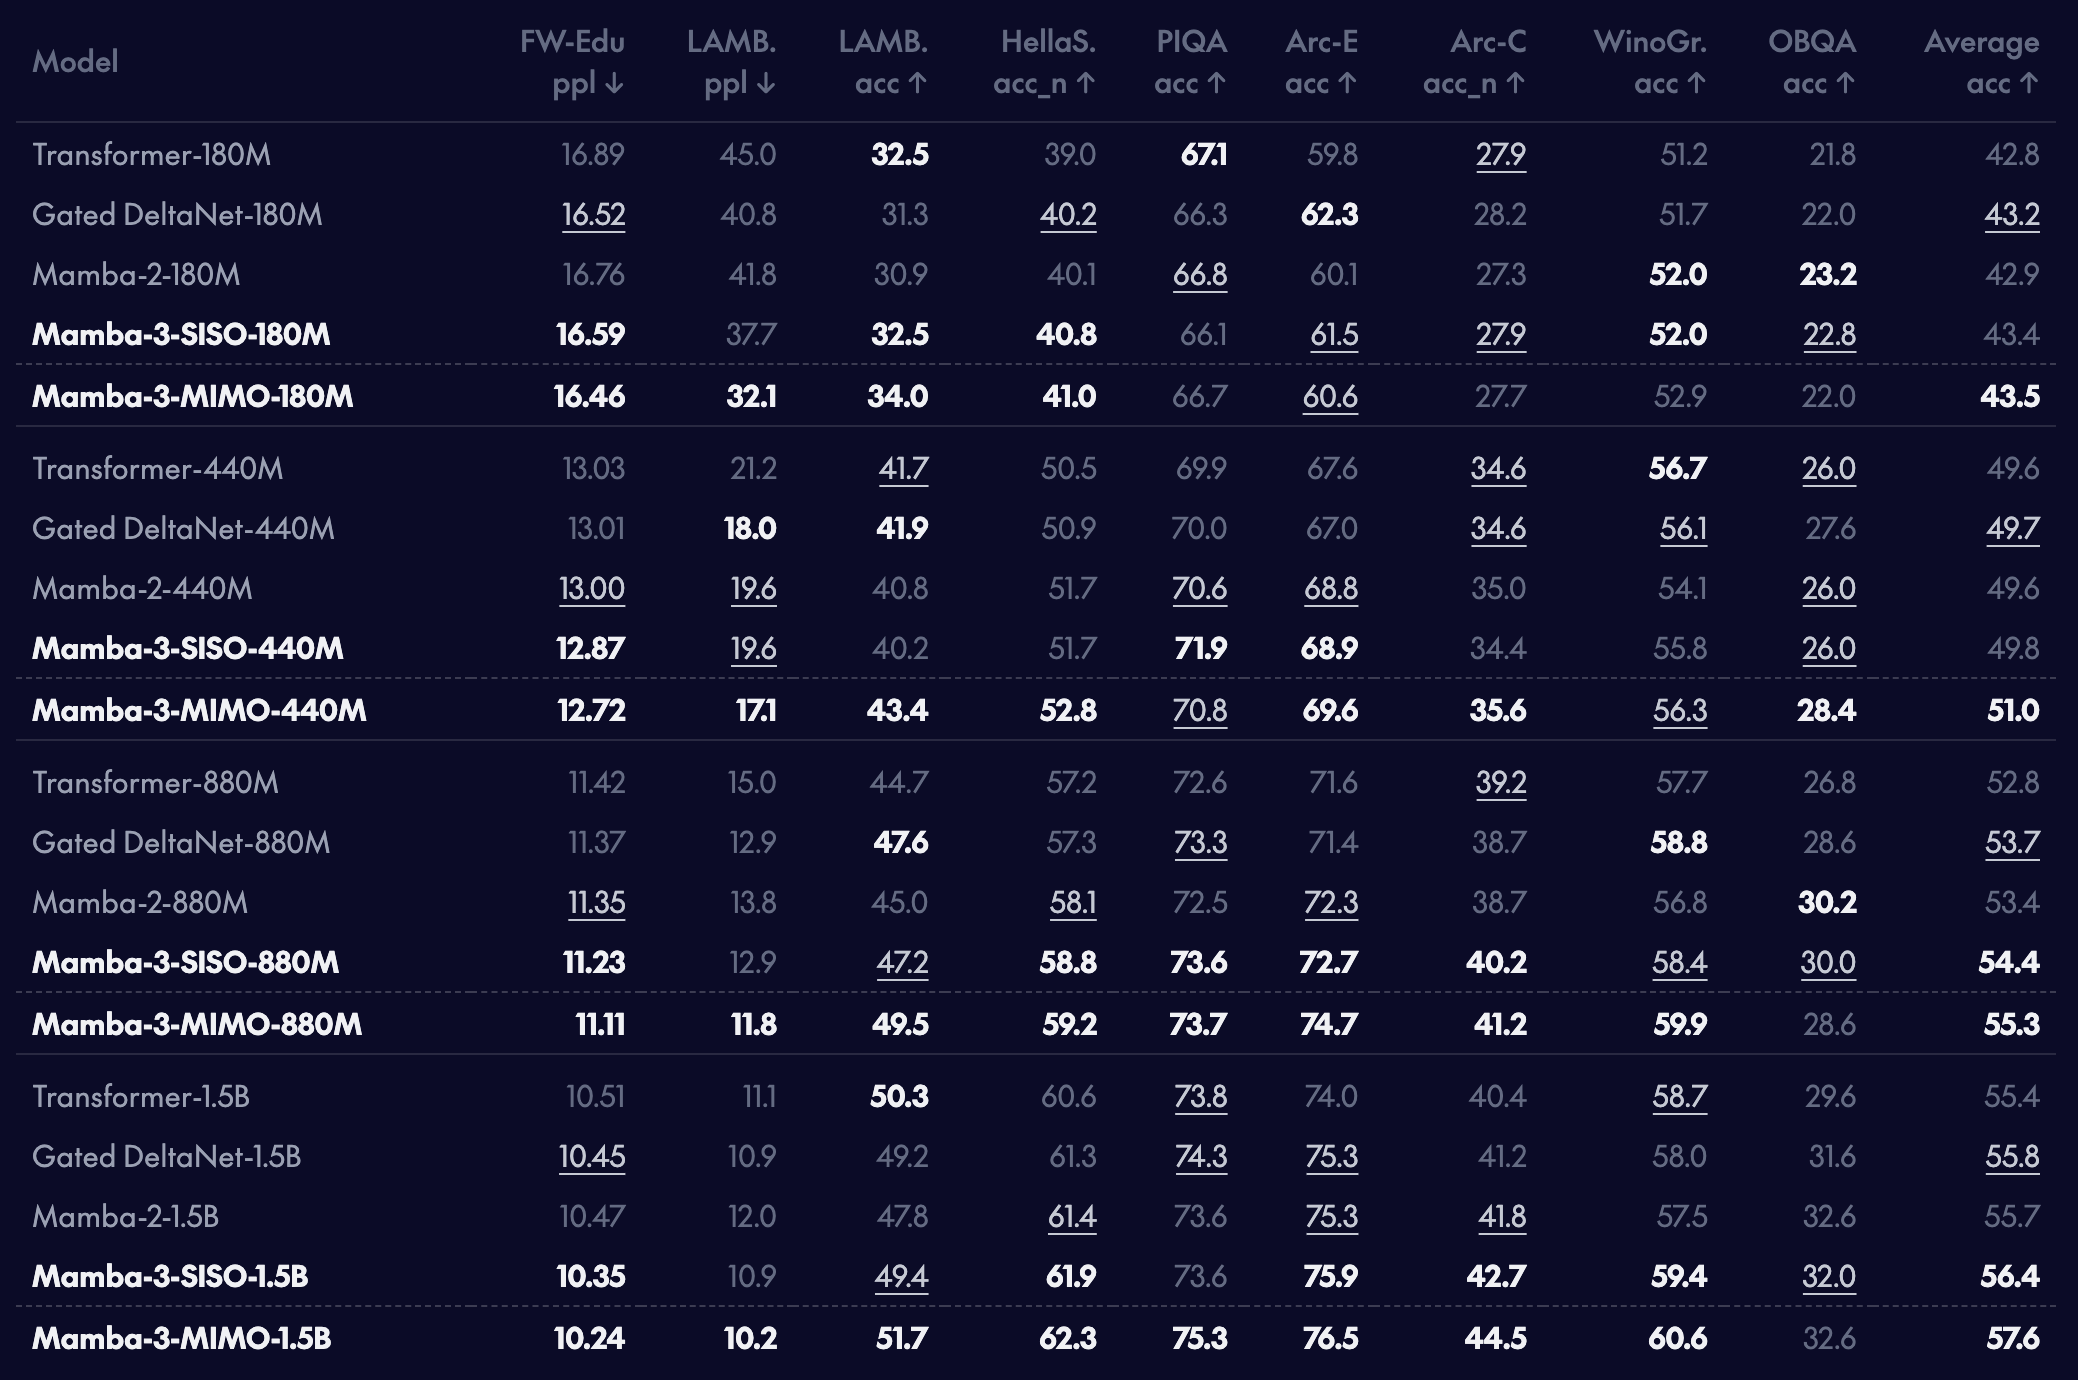
我们发现,在各种预训练模型规模下,新的 Mamba-3 模型在语言建模上优于之前的 Mamba-2 模型以及 GDN 等强大的线性注意力替代方案。Mamba-3-SISO 可与之前的线性模型直接比较;例如,它在架构形状(模型维度、状态大小等)上与 Mamba-2 完全一致,训练时间也相当。我们的 Mamba-3 MIMO 变体在 1B 规模上,将下游任务的准确率比常规 Mamba-3 又提高了超过 1 个百分点,需要说明的是,MIMO 需要更长的训练时间,但不需要更长的解码延迟!
训练成本上升而推理成本不变,这是怎么做到的?
我们会在博客第二部分详细讨论这一点,这里先给读者一个预览:
这种二分现象可以追溯到训练和推理各自受计算限制与受内存限制的不同本质。目前的线性模型为了快速训练,被设计成大量使用 GPU 张量核心(这是 Mamba-2 的主要贡献之一),但在解码时,每个时间步所需的计算量太少,硬件大部分时间都处于“冷”状态。
因此,如果我们围绕“仅增加每个时间步所需的 FLOPs”来设计架构,推理延迟大致保持不变,因为我们可以直接利用一部分闲置的核心;训练就不是这样了!
检索任务
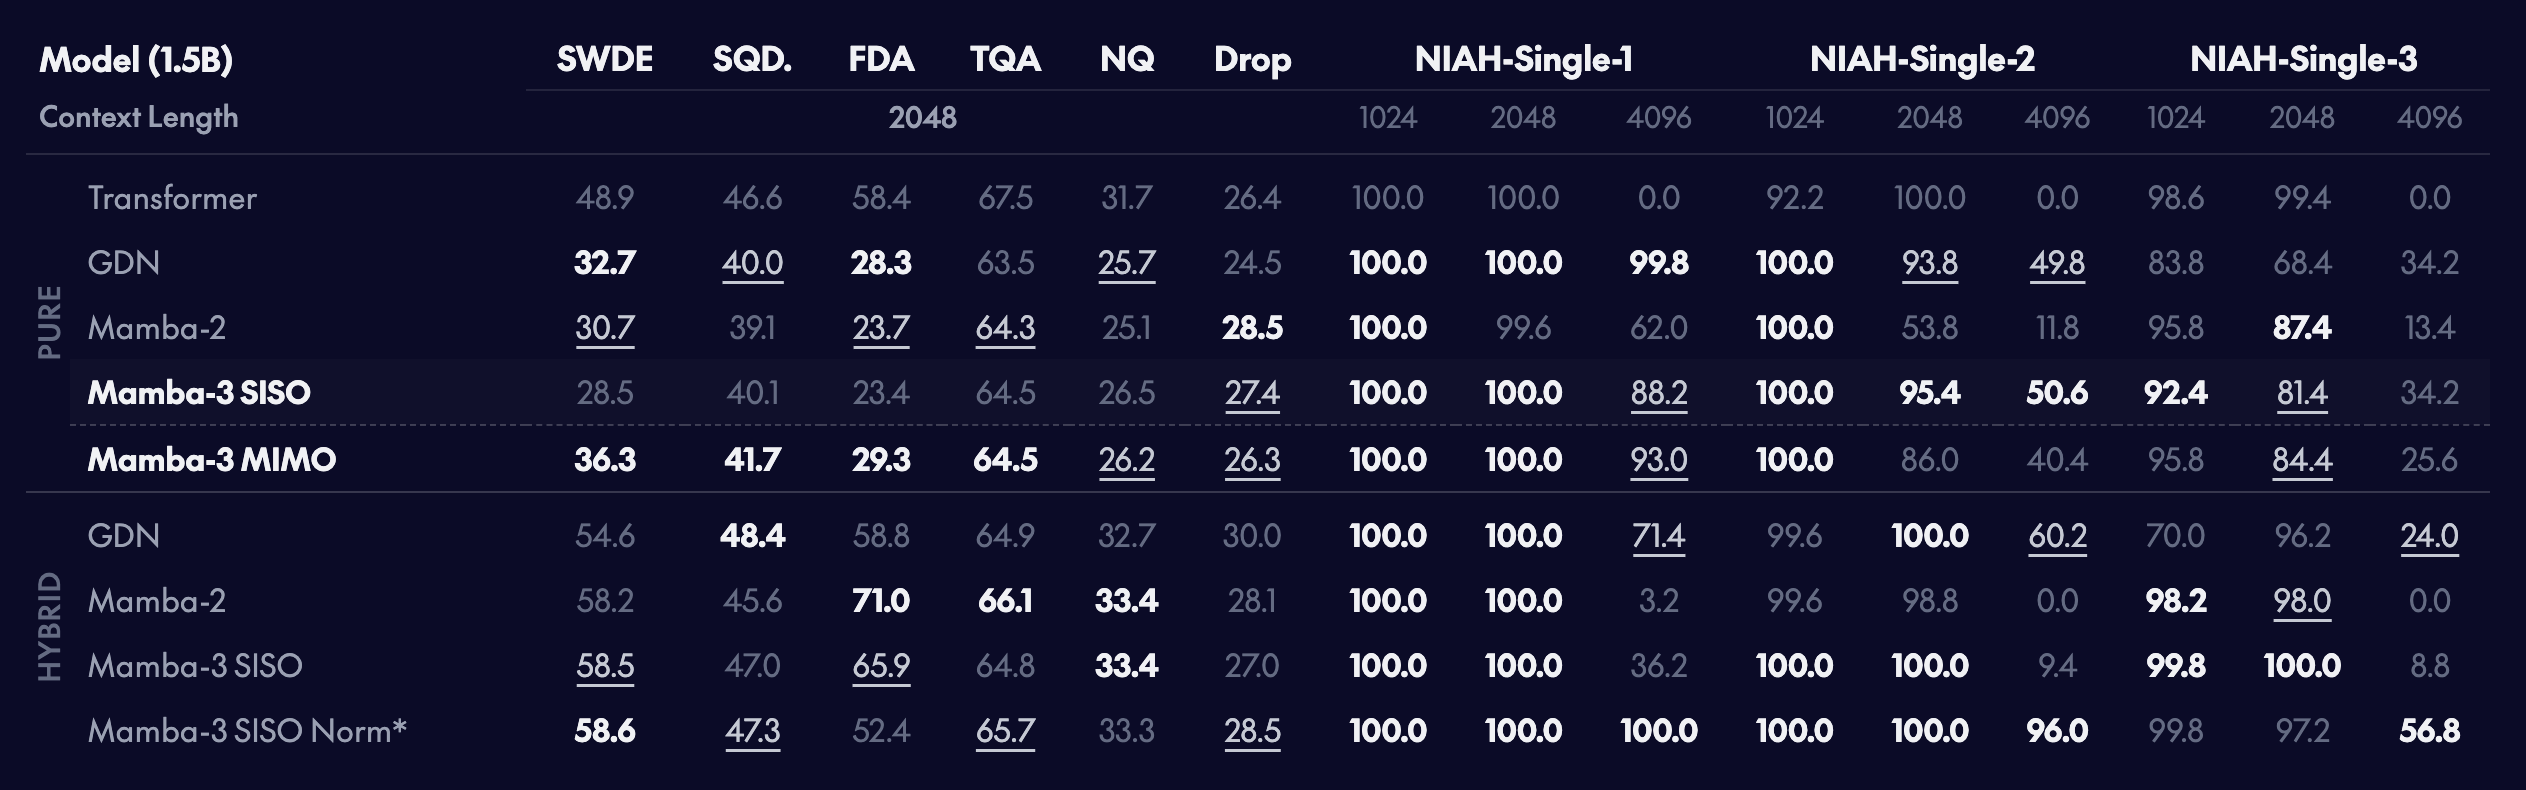
线性模型由于状态大小固定,在基于检索的任务上天然不如对应的 Transformer。正如预期,在纯模型中,Transformer 在检索任务上更胜一筹,但在次二次复杂度的替代方案这一类别中,Mamba-3 表现良好。有趣的是,加入 MIMO 后,检索性能进一步提升,而且无需增大状态大小。
鉴于这种与生俱来的短板,但整体建模性能很强,
我们预测,未来线性层将主要与全局自注意力层搭配使用。*
$^*$至少在语言建模方面如此
混合模型把线性层通用的类记忆特性与自注意力 KV 缓存精确的类数据库存储结合起来,已被实验证明优于纯模型,同时能显著节省内存和计算。我们在这里也发现,线性层与自注意力的组合,比普通 Transformer 能实现更好的检索。
不过,我们要强调,这些线性模型与自注意力交互的确切方式尚未被完全理解。例如,我们发现 Mamba-3 使用可选的输出前投影(pre-output projection)能提升在合成 NIAH 任务上的长度泛化性能,但代价是在真实世界的上下文内检索任务上略有损失。此外,即使是返回的归一化的细节,比如位置(门控之前还是之后)和类型(分组还是常规),也会对由半结构化和非结构化数据组成的任务(如 FDA 和 SWDE)的准确率产生不可忽视的影响。
内核无处不在
我们很期待看到大家用 Mamba-3 构建出什么。为此,我们开源了内核,其速度与原版 Mamba-2 的 Triton 内核相当。
延迟基准测试
预填充延迟
| 模型 | n=512 | 1024 | 2048 | 4096 | 16384 |
|---|---|---|---|---|---|
| vLLM (Llama-3.2-1B) | 0.26 | 0.52 | 1.08 | 2.08 | 12.17 |
| Gated DeltaNet | 0.51 | 1.01 | 2.01 | 4.00 | 16.21 |
| Mamba-2 | 0.51 | 1.02 | 2.02 | 4.02 | 16.22 |
| Mamba-3 (SISO) | 0.51 | 1.01 | 2.02 | 4.01 | 16.22 |
| Mamba-3 (MIMO r=4) | 0.60 | 1.21 | 2.42 | 4.76 | 19.44 |
预填充加解码延迟
| 模型 | n=512 | 1024 | 2048 | 4096 | 16384 |
|---|---|---|---|---|---|
| vLLM (Llama-3.2-1B) | 4.45 | 9.60 | 20.37 | 58.64 | 976.50 |
| Gated DeltaNet | 4.56 | 9.11 | 18.22 | 36.41 | 145.87 |
| Mamba-2 | 4.66 | 9.32 | 18.62 | 37.22 | 149.02 |
| Mamba-3 (SISO) | 4.39 | 8.78 | 17.57 | 35.11 | 140.61 |
| Mamba-3 (MIMO r=4) | 4.74 | 9.48 | 18.96 | 37.85 | 151.81 |
单块 H100-SXM 80GB GPU 上,1.5B 模型在不同序列长度下的预填充延迟,以及预填充加解码延迟(预填充和解码的 token 数相同)。所有序列长度均使用 128 的批大小,墙钟时间(单位为秒)取三次重复的结果。在 1.5B 规模下比较各模型时,Mamba-3(SISO 变体)在所有序列长度上都取得了最快的预填充加解码延迟,优于 Mamba-2、Gated DeltaNet,甚至优于拥有高度优化的 vLLM 生态的 Transformer。此外,Mamba-3 MIMO 在速度上与 Mamba-2 相当,但性能要强得多。
Mamba-3 SISO 基于 Triton 的预填充保持了与 Mamba-2 几乎相同的性能,说明新的离散化和数据相关的 RoPE 嵌入没有引入额外开销;而 Mamba-3 MIMO 由于采用了高效的 TileLang 实现,预填充仅有适度的减速。两种 Mamba-3 变体出色的解码性能,部分要归功于 CuTe DSL 实现,而 Mamba-3 各组件的简洁性大大降低了这一实现的难度。
设计选择
我们花了大量时间思考,如何在不牺牲易用性的前提下让内核尽可能快。最终我们采用了以下技术栈:Triton、TileLang 和 CuTe DSL。
选择 Triton 相当容易。它几乎是架构开发的标准(出色的 flash linear attention 仓库完全基于 PyTorch 和 Triton),这是有原因的:它支持可控的分块和内核融合,因此性能优于标准 PyTorch,同时还是一门平台无关的语言。Triton 还有一些相当巧妙的特性,比如 PTX(面向 GPU 的汇编语言)注入,以及对张量内存加速器(Tensor Memory Accelerator,用于 Hopper GPU)的支持,可实现从全局内存到共享内存的批量异步传输。
我们的 MIMO 预填充内核则是用 TileLang 开发的。该变体对应的额外投影,提供了一个机会:通过在 GPU 内存层次结构上有策略地操作,来减少内存 IO。遗憾的是,Triton 没有提供我们想要的内存控制粒度,所以我们选了 TileLang。它允许我们显式声明和控制共享内存分块并创建寄存器片段,更高效地复用内存,同时抽象层次又足够高,让我们能快速开发内核。
由于我们一直在强调推理和解码的重要性,我们决定用 CuTe DSL 编写解码内核。借助它的 Python 接口,我们可以利用 CUTLASS 的高层抽象生成底层内核。在这里,我们几乎拥有 CUDA 级别的控制力,能够开发出针对我们硬件规格(本例中为 Hopper GPU)量身定制的高性能内核。凭借对张量布局和 warp 特化的细粒度控制,我们构建出了一个充分利用 GPU 各种特性的内核。
重要的是,这些处于不同 GPU 抽象层次上的实现之所以成为可能,要归功于 Mamba-3 简单、轻量的新增部分及其巧妙实例化所体现的底层算法设计。关于确切的融合结构和内核 DSL 等细节,我们会在完整发布中更深入地讨论。
接下来
很高兴你读到了第一部分的结尾!关于我们的内核、实验结果和消融实验,还有很多细节没来得及在这篇文章中介绍,不过不用担心!一切都可以在我们的论文中找到,内核也已在 mamba-ssm 开源!
接下来是该系列的第二部分(也是最后一部分),将深入探讨 Mamba-3 的三项核心改进及其 SSM 基础,并给出一些我们特别感兴趣的方向。
参考文献
- Mamba:基于选择性状态空间的线性时间序列建模 [PDF]
Gu, A. 和 Dao, T.,2024年。 - Transformer 即 SSM:通过结构化状态空间对偶性得到的广义模型与高效算法 [PDF]
Dao, T. 和 Gu, A.,2024年。 - 门控 Delta 网络:用 Delta 规则改进 Mamba2 [PDF]
Yang, S.、Kautz, J. 和 Hatamizadeh, A.,2025年。 - 学会(在测试时学习):具有表达力隐藏状态的 RNN [PDF]
Sun, Y., Li, X., Dalal, K., Xu, J., Vikram, A., Zhang, G., Dubois, Y., Chen, X., Wang, X., Koyejo, S., Hashimoto, T. 和 Guestrin, C.,2025年。 - 饥饿的河马:迈向基于状态空间模型的语言建模 [PDF]
Fu, D.Y., Dao, T., Saab, K.K., Thomas, A.W., Rudra, A. 和 Ré, C.,2023年。 - 上下文学习与归纳头
Olsson, C., Elhage, N., Nanda, N., Joseph, N., DasSarma, N., Henighan, T., Mann, B., Askell, A., Bai, Y., Chen, A., Conerly, T., Drain, D., Ganguli, D., Hatfield-Dodds, Z., Hernandez, D., Johnston, S., Jones, A., Kernion, J., Lovitt, L., Ndousse, K., Amodei, D., Brown, T., Clark, J., Kaplan, J., McCandlish, S. 和 Olah, C.,2022年。Transformer Circuits Thread。 - RWKV:为 Transformer 时代重塑 RNN [PDF]
Peng, B., Alcaide, E., Anthony, Q., Albalak, A., Arcadinho, S., Biderman, S., Cao, H., Cheng, X., Chung, M., Grella, M., GV, K.K., He, X., Hou, H., Lin, J., Kazienko, P., Kocon, J., Kong, J., Koptyra, B., Lau, H., Mantri, K.S.I., Mom, F., Saito, A., Song, G., Tang, X., Wang, B., Wind, J.S., Wozniak, S., Zhang, R., Zhang, Z., Zhao, Q., Zhou, P., Zhou, Q., Zhu, J. 和 Zhu, R.,2023年。 - 测试时回归:设计具有联想记忆的序列模型的统一框架 [PDF]
Wang, K.A., Shi, J. 和 Fox, E.B.,2025年。 - 基于 Mamba 的语言模型实证研究 [PDF]
Waleffe, R., Byeon, W., Riach, D., Norick, B., Korthikanti, V., Dao, T., Gu, A., Hatamizadeh, A., Singh, S., Narayanan, D., Kulshreshtha, G., Singh, V., Casper, J., Kautz, J., Shoeybi, M. 和 Catanzaro, B.,2024年。