摘要
A/B 实验可以把一个端点的线上流量切分成固定的分组:一个对照组加最多 20 个变体,每组按百分比分配流量。这样你就能在自己选定的曝光比例下,衡量候选模型在真实用户面前的表现。提升某个变体的流量占比只需一次调用,还可以通过蓝绿发布(blue-green rollout)把胜出者升级为正式版本。删除实验会让 100% 的流量回到对照组,之后无需在客户端或路由逻辑中做任何改动来收尾。下文我们将在一个线上端点上运行一次实验:以 95%/5% 创建,依次提升到 80%/20% 和 50%/50%,最后删除,并在每个阶段检查实际观测到的流量占比。
在生产环境中为 LLM 实施 A/B 测试
每个团队迟早都会想回答同一个问题:对我们的用户来说,新模型真的比现有模型更好吗?这里的“更好”不是指基准测试上的得分,而是指留存率、点赞率、任务完成率,以及你的产品实际衡量的任何指标。
影子流量(shadow traffic)回答不了这个问题。影子测试只能告诉你候选模型在延迟、错误率、吞吐量方面运行上是否稳健,但它的响应会被丢弃,没有任何用户会据此行动。质量问题需要让终端用户真实接触到模型:一部分用户用上模型 B,然后你对比会发生什么。
通常,团队会自己在应用层搭建这套机制,常见做法是组合使用以下几种手段:
- 客户端代码中的功能开关(feature flag),或对用户 ID 做 hash 后模 100。
- 客户端在两个端点(或两个硬编码的模型字符串)之间切换。
- 某处的一张电子表格,说明 A 组和 B 组分别是什么意思。
这样做能用,但会把实验与基础设施纠缠在一起,日后带来麻烦:路由逻辑随应用一起发布,客户端缓存分组决策会让分组比例发生漂移,而且即便实验“结束”了,分支代码也会在很长时间里继续存在,因为没人确定能否安全删除。
Together AI 平台允许你在端点级别运行 A/B 实验逻辑。
工作原理
A/B 实验附着在一个端点上,声明若干成员:恰好一个对照组(control)和一个或多个变体(variant)。每个成员指向一个部署,并各有一个 percent 设置,所有成员的取值之和必须为 100,用于控制流量路由。
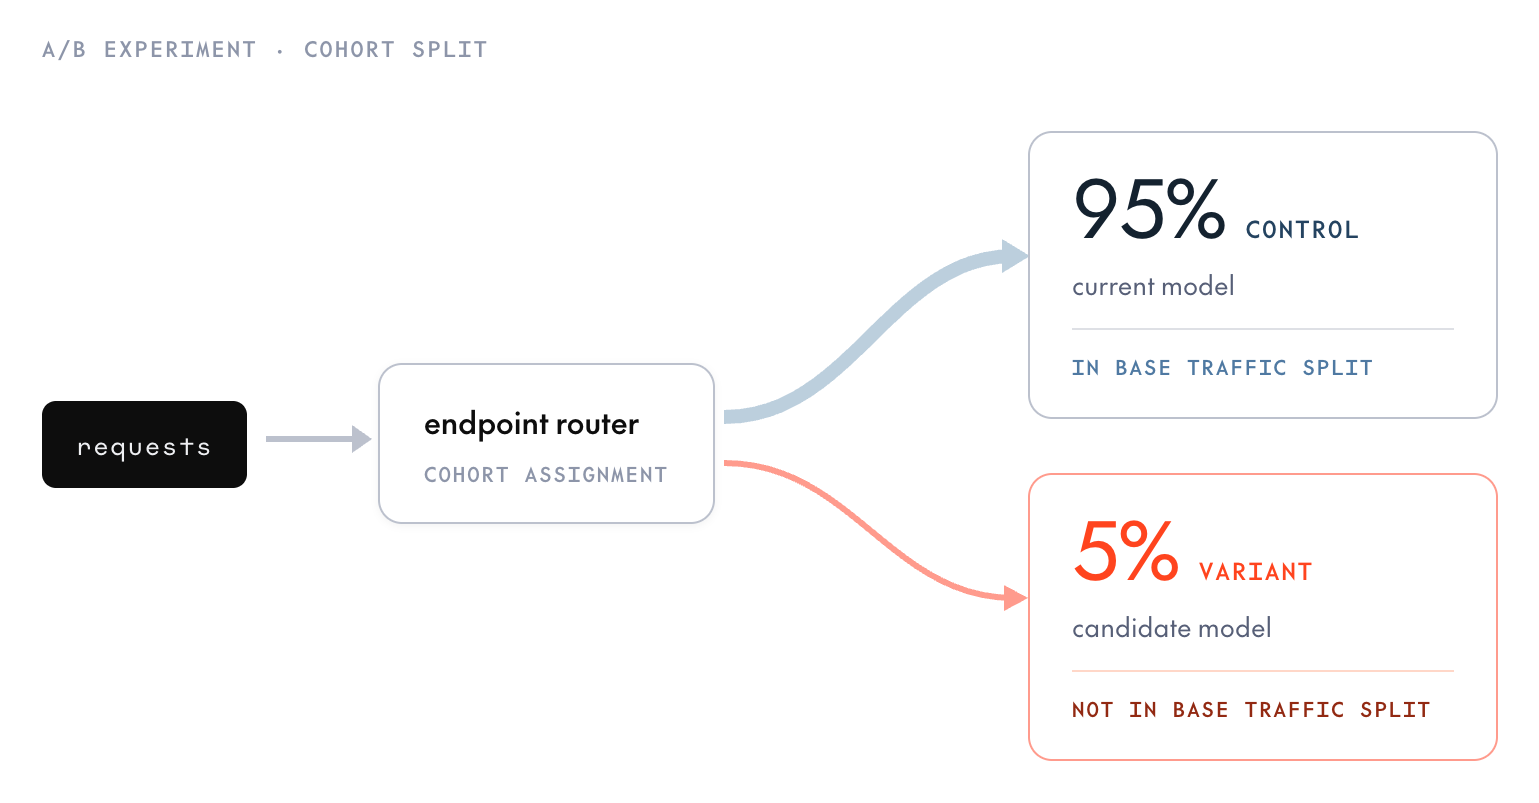
端点路由器的工作方式是:每当基础流量把请求发给对照组时,实验会在各组之间重新抽样并重新分配,使 95% 留在对照组,5% 去往变体。
▶ https://together-website.b-cdn.net/video/a-b-test-models-production-how-it-works.mp4
准确地说明这一机制:实验是对对照组在基础流量切分中所占份额的再细分。路由首先通过权重切分来确定请求的去向;当结果是某个 A/B 实验的对照组时,请求会按各组的百分比在实验的各个分组之间重新抽样。因此,当对照组是切分中唯一的入口时,成员百分比就是绝对的流量占比。还要注意,如果对照组在切分中的权重为零,实验就没有可细分的内容,整个实验因而得不到任何流量。
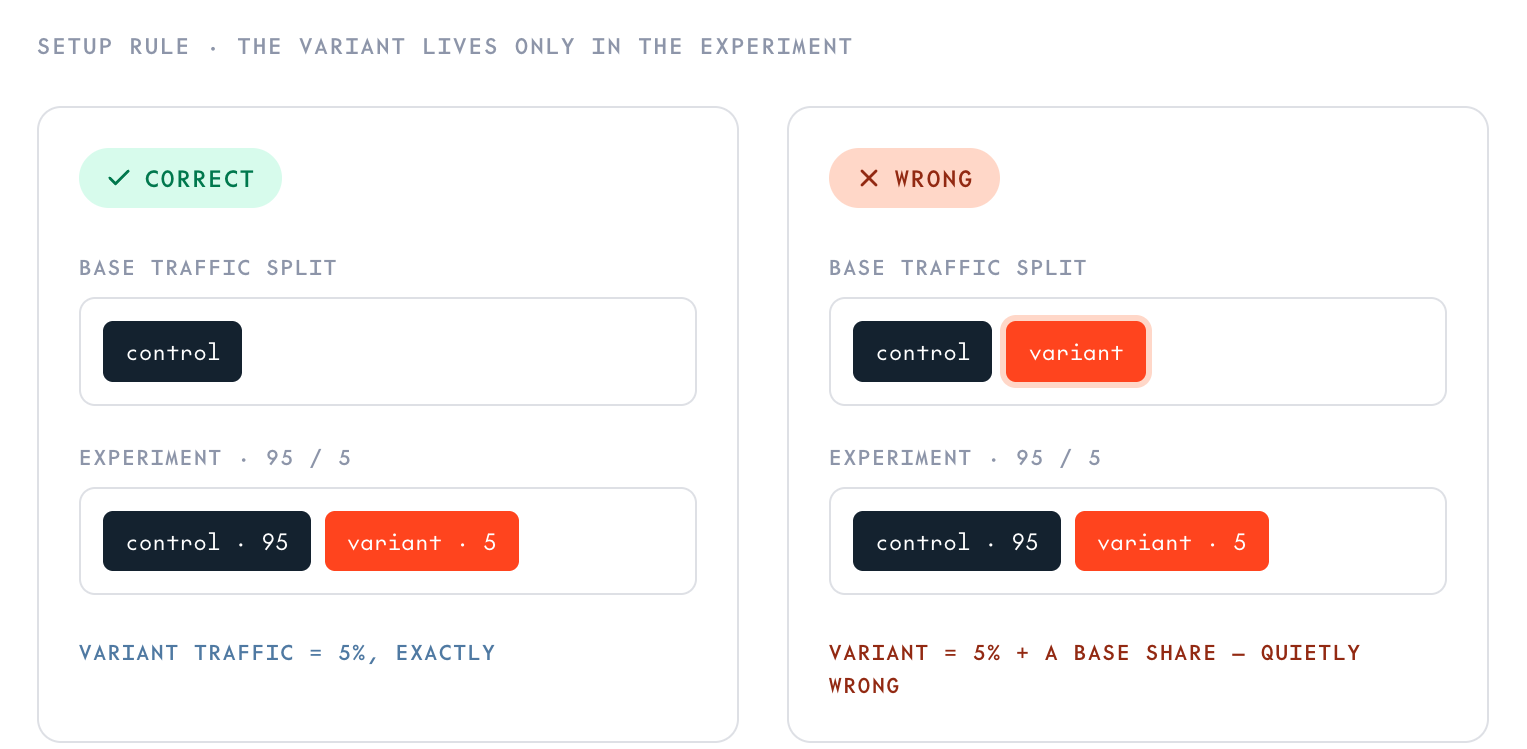
重要的是,变体部署不得出现在端点的流量切分中,平台要求变体的权重为零;只有对照组存在于基础切分里。实验完全掌管路由到变体的流量,其百分比就是它的流量占比。如果变体还能从切分中按容量权重获得流量,你的测量结果就会悄悄出错。一种理解方式是,应当把变体设置得像一个影子部署:创建好、READY、权重为零,然后让实验的百分比设置把流量路由给它。
另一个要点是,A/B 百分比是总和为 100% 的真实固定流量占比,与副本数无关。我们有意让它与流量切分权重(按每个就绪副本计算,随容量变化)不同。实验是一种测量工具;你希望测量期间分流比例保持恒定,而不是随自动扩缩容漂移。
创建一个 95/5 的实验:
tg beta endpoints ab my-org/candidate-model --control $CONTROL_DEPLOYMENT --percent 5
你的客户端不会察觉到这个实验,因为表面上端点名称、API 和密钥都保持不变。在后端,现在有 5% 的请求将由候选变体来应答。
底层机制:提升、测量、结束
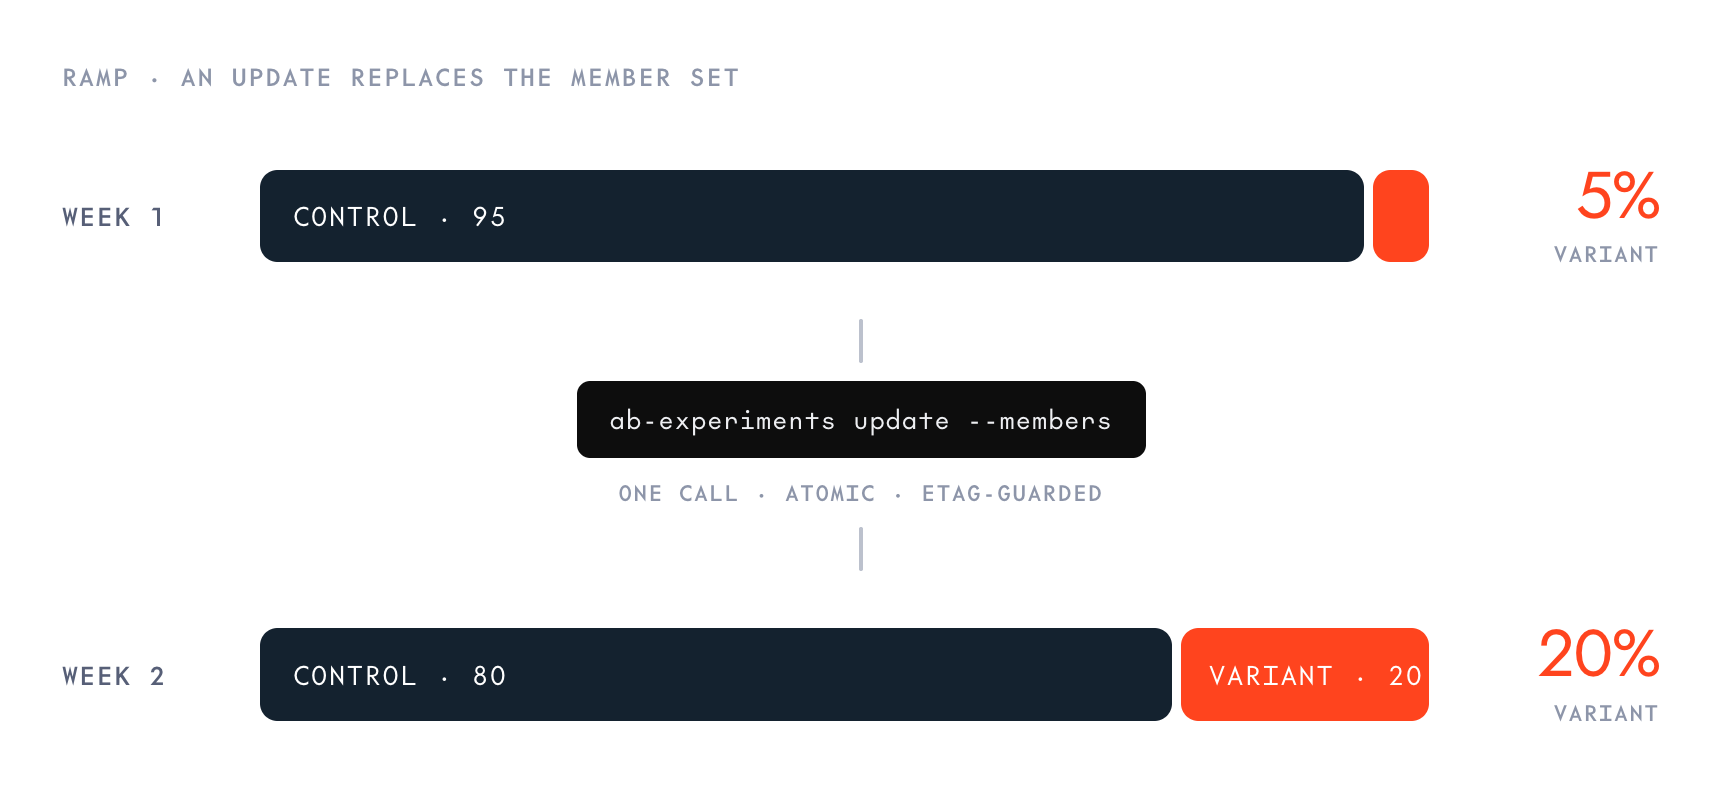
提升就是重新发送成员集合
没有单独的“提升”API,一次更新会替换整个成员列表,这让心智模型保持简单(实验始终恰好等于其成员所描述的样子),也让每次提升都成为一次明确、可审阅的变更:
      # Week 2: candidate looks good at 5% —> go to 20%
client.beta.endpoints.ab_experiments.update(
    id=experiment_id,
    endpoint_id=endpoint_id,
    update_mask="members",
    etag=experiment.etag,   # a teammate's concurrent ramp gets rejected, not overwritten
    members=[
        {"deployment_id": control_dep, "percent": 80, "role": "AB_EXPERIMENT_MEMBER_ROLE_CONTROL"},
        {"deployment_id": variant_dep, "percent": 20, "role": "AB_EXPERIMENT_MEMBER_ROLE_VARIANT"},
    ],
)
更新由 etag 保护:如果你在撰写更新的同时,有队友已经提升了实验,你的更新会被拒绝,而不是悄无声息地覆盖对方的改动。
有了这套 API 设计,你仍然需要做出常见的曝光选择,即决定把多少流量路由给 B 组:
| 分流比例 | 信号速度 | 风险 | 适用场景 |
|---|---|---|---|
| 95/5 | 慢(需要流量和时间) | 极小 | 新模型,首次真实曝光 |
| 80/20 | 中等 | 可控 | 候选模型在 5% 阶段表现稳定,你想要更显著的读数 |
| 50/50 | 最快 | 一半的用户 | 在两个已知可靠的方案之间做后期确认 |
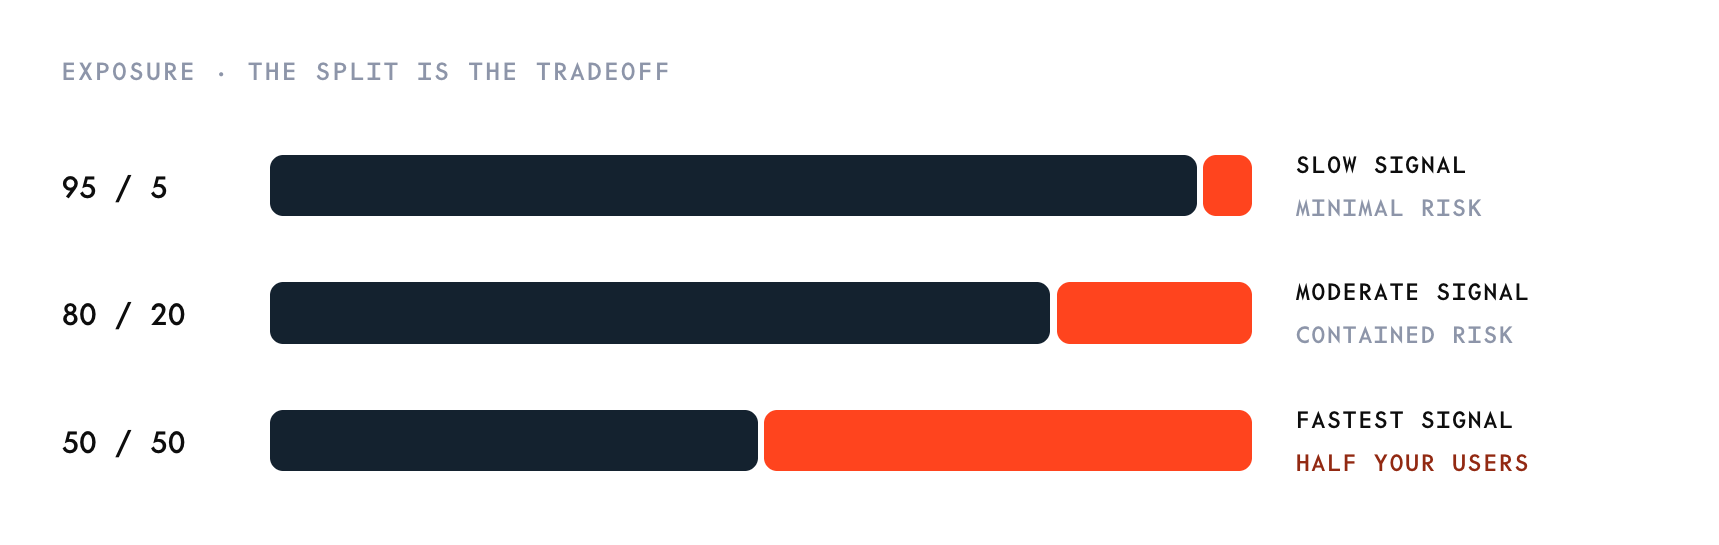
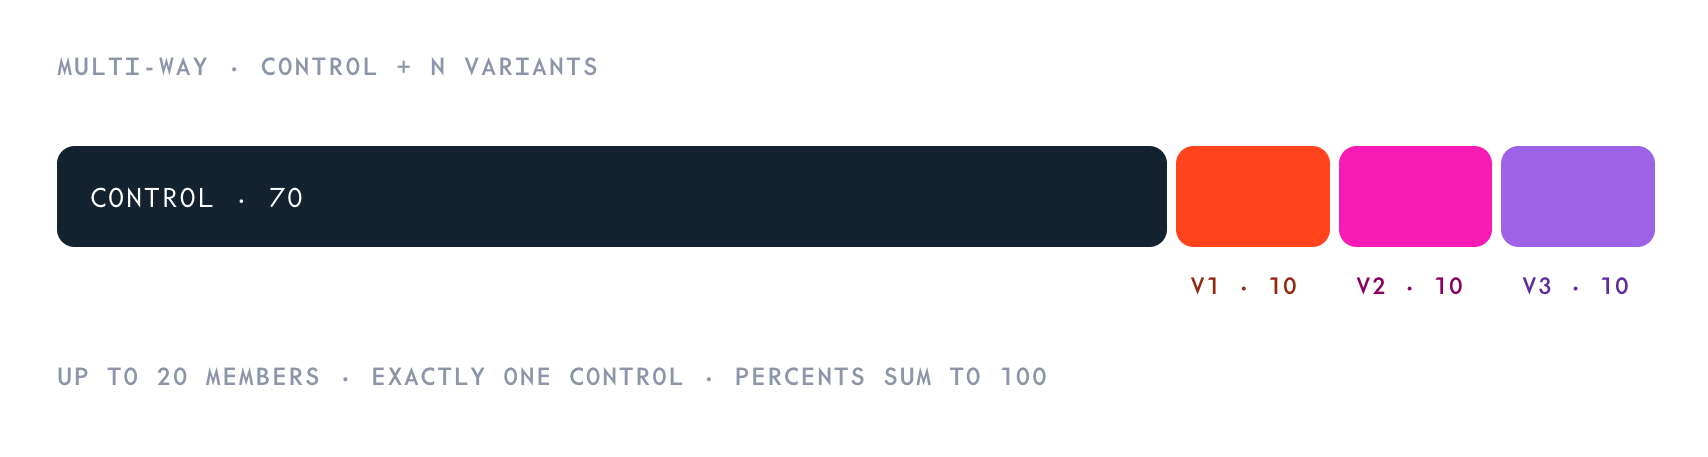
有了最多 20 个变体成员,你还可以运行多路测试,例如想把一个全精度端点与另外三个量化变体(V1、V2、V3)一起试一试。只要百分比总和仍为 100%,且恰好有一个对照组,这就能按预期工作。
测量:把平台指标与产品指标关联起来
每个请求都由某个特定部署来服务,而每一项平台指标都可以按部署查看,因此对比中的基础设施部分(每个分组的延迟、错误率、吞吐量)只是一个筛选条件,无需另起一个项目。产品部分则由你自己负责:把每个响应由哪个部署提供(这在响应元数据里)与你的质量信号(评分、重试、任务完成情况)一起记录下来,关联键就是部署 ID。平台有意不去猜测你的质量指标,它只是让归因变得轻而易举,由你的分析来做判断。
结束:升级,然后删除
假设实验表明变体胜出。结束实验分两步:
- 通过 rollout 升级。从对照组部署到变体部署执行一次蓝绿 rollout。健康检查关卡、传播等待和回滚保护都照常适用。
- 删除实验。所有实验路由随之消失,100% 的流量转而遵循端点的基础流量切分,而在 rollout 之后,该切分指向的就是你的胜出者。
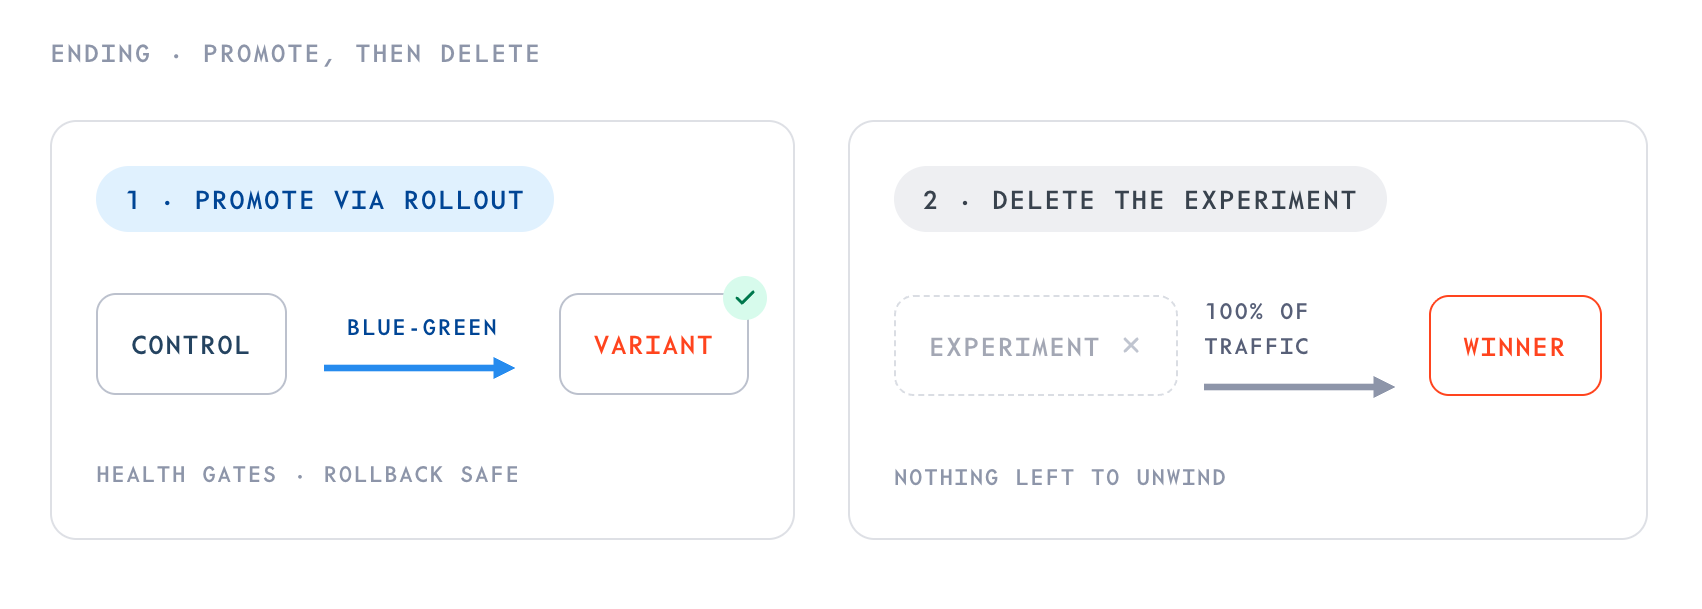
如果变体落败,你只需删除实验,流量就会完全回到对照组。在后端,变体部署会缩容到零或被删除。
tg beta endpoints rm abx_abc123        # delete the experiment; 100% returns to the base split
tg beta endpoints rm dep_variant123    # or delete the variant — auto-unwinds experiment + split
边界情况
实验过程中变体性能下降,影响范围有多大?
只影响它自己的分组。各部署被独立监控、独立自动扩缩容,这意味着表现不佳的变体不会拖累对照组。要解决问题,你可以重新发送不含问题变体的成员集合,经过一定的传播时间后,其用户就会回到对照组。这也是从 5% 起步是个好主意的原因。
观测到的占比真的和配置的百分比一致吗?
在足够大的流量下,是的!想看实际效果,可以查看下方的实验。在小窗口内,你应当预期会有抽样噪声:1,000 个请求中占 5% 只是一个很小的样本。如果观测到的占比偏差很大且持续偏离,请检查上面提到的配置规则。
同一个端点上可以同时运行 A/B 实验和 rollout 吗?
可以,其组合顺序定义如下:路由先解析基础切分,然后是 A/B 实验(细分对照组的份额),最后是 rollout(在源部署与其 rollout 目标之间重新抽样)。平台仍然限制每个端点同时只能有一个活跃的 rollout,但这些阶段被设计为在重叠时可以组合使用。
分组对每个用户是固定的吗?
分配依据请求的抽样键(sampling key),例如请求体顶层的 prompt_cache_key 或 user 字段,所以携带相同键的请求会被一致地路由,同一个用户可以在整个会话期间停留在同一个测试分组。不带键的请求实际上是按请求随机分配的(我们下面的实验测量使用的是不带键的流量,所以观测到的占比与百分比非常接近)。如果每用户一致性对你的研究很重要,尤其是做多轮对话的质量比较时,请发送稳定的 user 字段。
分流时自动扩缩容会怎样?
每个成员部署按各自的策略独立扩缩容,规模由它自己的流量占比决定。占比 5%、副本范围 1-2 的变体,加上占比 95%、副本范围 2-8 的对照组,是一种完全正常的形态。你应当分别观察每个分组的副本数,这也是下面图表所记录的内容。
完整演示一次 A/B 实验
我们在一个线上端点上跑完了完整的生命周期:以 95/5 创建,提升到 80/20,再提升到 50/50,然后删除。整个过程中我们保持 3 RPS 的稳定请求流,每个请求都归因到为其服务的部署。下图显示变体所接收的流量,绿点表示变体的流量占比:

以下是各阶段配置的流量占比与观测到的流量占比:
| 配置(对照组 / 变体) | 观测值 | 请求数 |
|---|---|---|
| 95 / 5 | 95.3 / 4.7 | 1,330 |
| 80 / 20 | 79.2 / 20.8 | 1,348 |
| 50 / 50 | 50.2 / 49.8 | 1,348 |
| 已删除 | 100.0 / 0 | 360 |
这次运行中有三个细节值得一提:
- 每次提升确实只需一次调用,你可以连同当前的
etag一起重新发送完整的成员集合。etag 在两次提升中依次推进1 → 2 → 3;过期的 etag 会被拒绝,而不是悄悄覆盖队友的改动。 - 传播很快,但并非瞬时。每次更新后我们等待了约 75 秒再测量;路由层获取实验变更的时间尺度,与流量切分变更相同,为 30 到 60 秒。
- 删除:移除实验后,我们连续发送了 360 个请求,它们全部落在对照组上。除了需要收尾的删除操作本身,没有遗留任何分组逻辑。
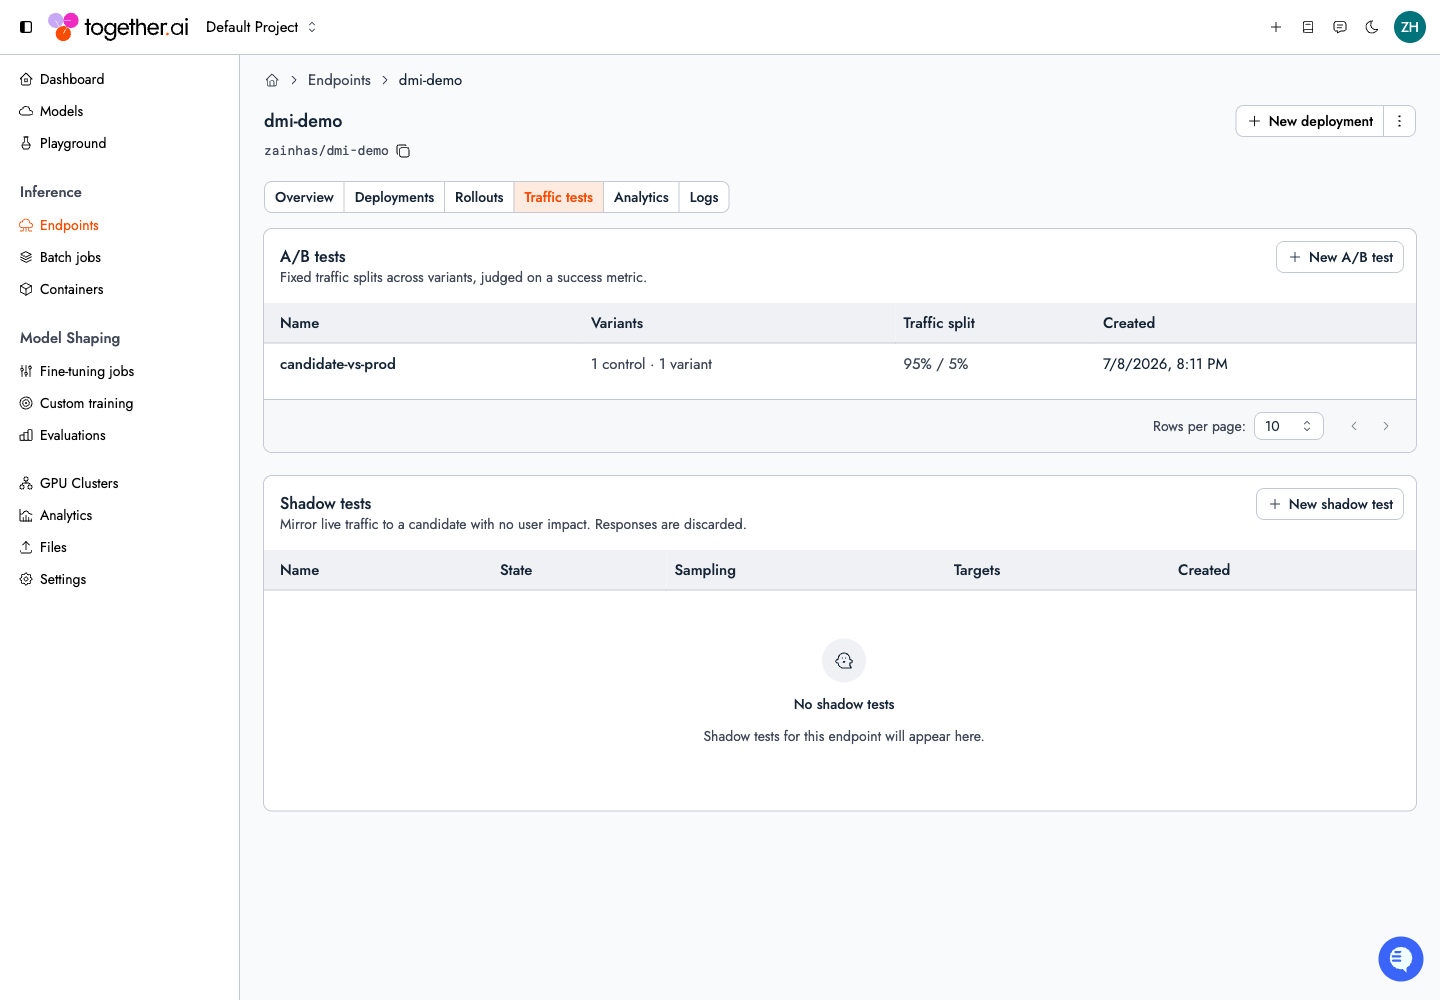
下面是控制台在端点的流量测试(Traffic tests)标签页上展示的这次实验(A/B 测试和影子测试共用该页面):
亲自试试吧!
你需要一个正在服务流量的对照组部署,外加一个候选部署(已创建、READY,且不在流量切分中)。然后:
- 以 95/5 创建实验。
- 让它运行,直到积累足够的流量,5% 的意义就在于,在收集数据的同时让曝光保持在较低水平。
- 当数据显示时机成熟,用一次更新来提升比例。结论明确时,通过 rollout 升级。完成后删除,无需其他清理工作。
📚 文档:Dedicated Model Inference → A/B 测试