在大多数大型 Rails 单体应用中,组织往往优先编写新功能,而不是为功能补写测试。久而久之,未经测试的代码越来越多,团队不得不花更多时间去排查棘手的缺陷。
我们构建了一个自主智能体来弥补这一缺口。它读取 Rails 源文件,生成或改进 RSpec 测试,对照风格规则和覆盖率目标进行校验,并在 CI/CD 流水线中运行,全程无需人工干预。为了应对这种规模的代码库,它采用并行方式运行:多个实例同时处理不同的文件。
从智能体的视角看 RSpec
Ruby 是动态类型语言:没有编译步骤,错误只会在运行时暴露。对我们的智能体来说,这意味着验证测试语法的唯一办法就是执行它。RSpec是 Rails 的标准测试框架,能让测试表达力强、易于阅读,但它的领域特定语言(DSL)很容易写错。
智能体读取 Ruby on Rails 代码库时,会遇到五种主要的文件类型(模型、序列化器、控制器、邮件器、辅助模块),它们的结构各不相同(因此测试方式也不同)。智能体需要针对每种类型给出不同的指令。
一个好处是:源文件到 spec 文件的映射几乎是一对一的。通行的约定如下:
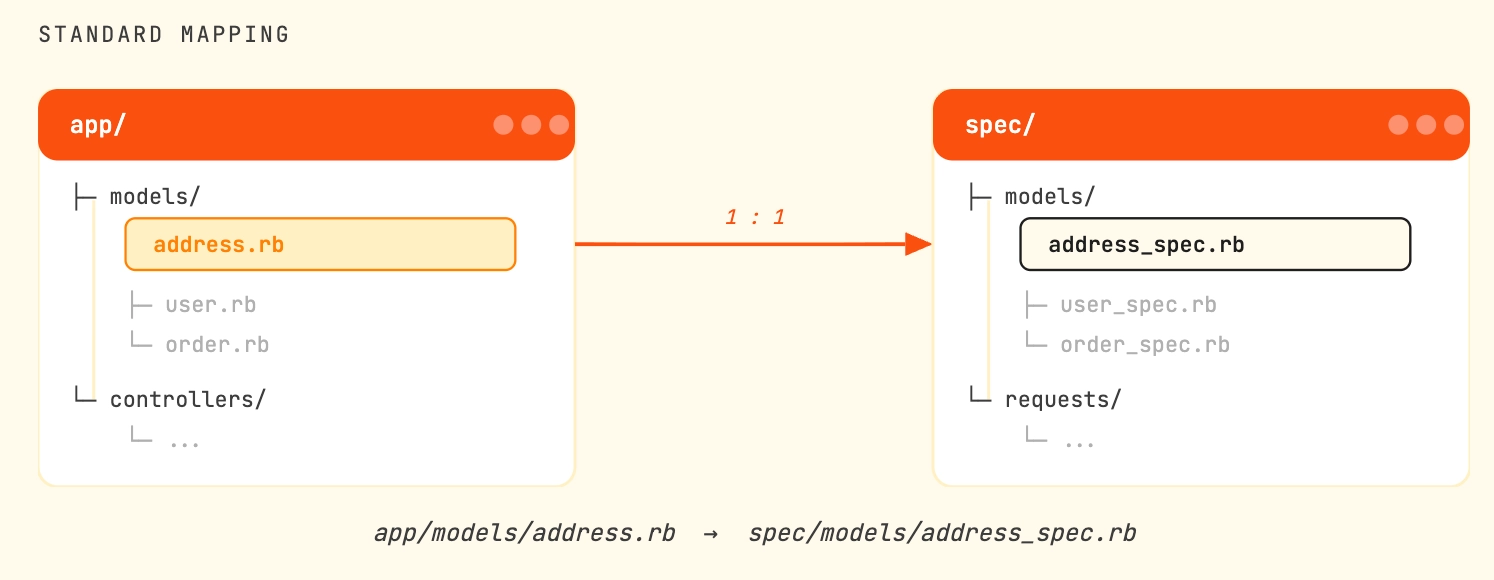
不过这条规则也有少数例外,比如 app/controllers/ 有时会映射到 spec/requests/,或者一个源文件有时会对应多个 spec 文件,此时的约定是:
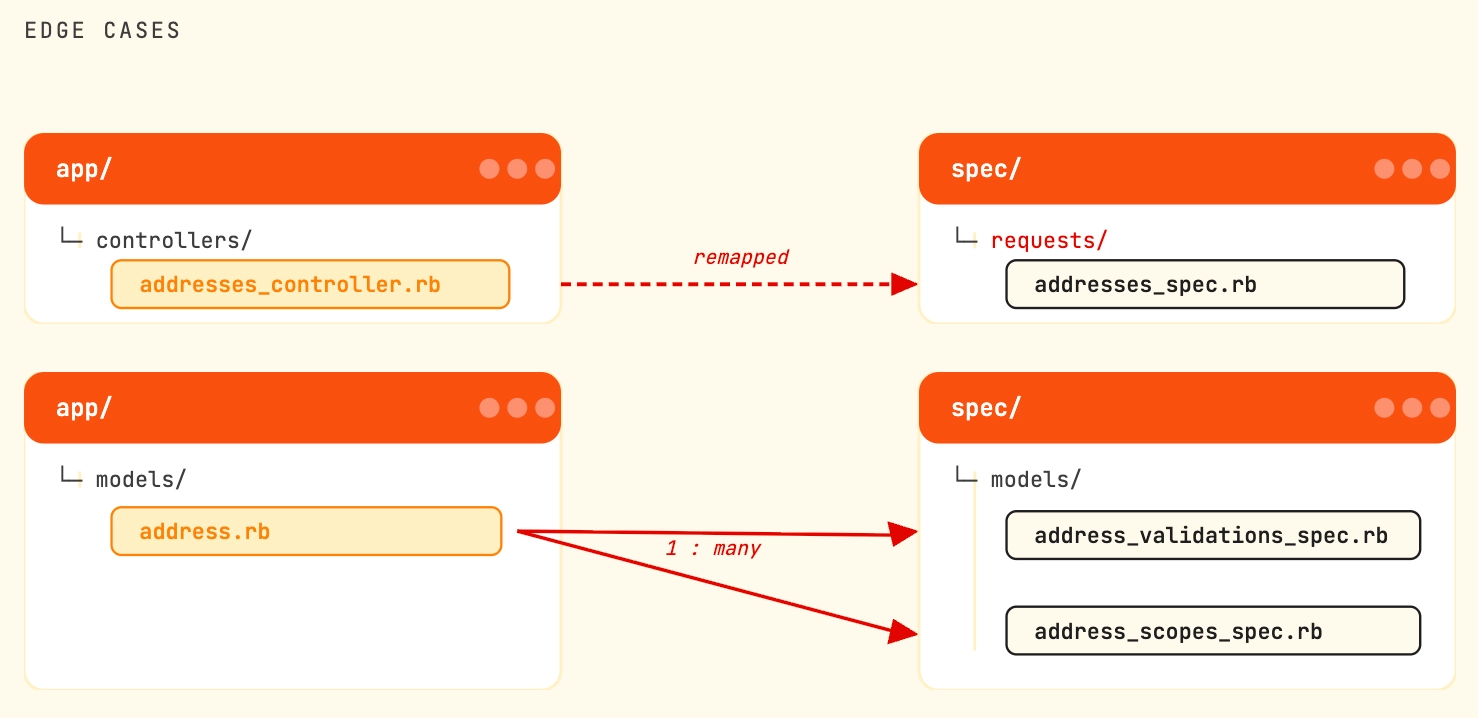
这种直观的映射让我们很容易找到任意文件对应的测试,也很容易找出完全没有测试的文件。
对智能体来说更难的是,为了避免重复代码,RSpec 高度依赖共享上下文:工厂(factory)、夹具(fixture)、数据库 schema……
- 工厂(Factories):用预定义属性创建测试对象的可复用模板,便于生成一致的测试数据。
- 夹具(Fixtures):预先加载测试数据库记录的静态数据文件,为测试提供固定的基线。
如果工厂文件不存在,智能体就创建它;如果已存在,就复用。由于工厂会被许多测试共享(与 spec 文件不同),草率的改动很容易破坏其他地方的测试,因此修改这些文件时必须格外谨慎。
用 Vibe 构建智能体
我们基于 Mistral 的开源编码助手Vibe构建了这个智能体。默认的系统提示词已经足够满足本项目,因此我们把精力放在三个着力点上:仓库级上下文、专用技能(skills)和自定义工具。
上下文工程
上下文工程是我们方法的核心。Vibe 支持仓库级的 AGENTS.md 文件:在根目录包含该文件的仓库上运行时,其内容会自动追加到系统提示词中。
我们使用的 AGENTS.md 提供了目标仓库的一些基本信息,但更主要的是给了智能体一份分步执行计划:
1. Read the source file
2. Read the documentation (if it exists)
3. Check if a spec already exists
4. Choose and read exactly one skill based on the source file location
5. Find existing patterns, factories, and helpers
6. Execute the skill (Extract → Factory → Generate tests)
7. Validate with Rubocop tool
8. Validate with SimpleCov tool
每一步都写明了要做什么以及成功标准。对于我们认为需要引导智能体的地方,我们还加入了一些 RSpec 最佳实践。示例:
- **NEVER** use `be_present`, `be_truthy`, `be_between`, or `include(:key)`
These are vague. Use `eq(exact_value)` always
我们发现智能体有时会漏掉某些方法,或者遗漏边界情况:它生成的 spec 看起来很完整,却悄悄忽略了源文件中的几个公开方法。为此,AGENTS.md 的最后设置了一道强制自检:智能体在结束前必须重新读一遍源文件,并明确问自己“我是否测试了每一个公开方法?数一数。”如果有遗漏,就返回补上。
有了这个通用的 AGENTS.md 文件强制智能体严格按计划行事,我们的质量得分从 0.68 提升到了 0.74,而这一切只靠一个包含框架级指令的 markdown 文件。
使用 SKILLS 文件:
回顾我们 AGENTS.md 中的第 4 步:
4. Choose and read exactly one skill based on the source file location
单一的通用技能只能产出平庸的结果:适合测试模型文件的指令,对控制器文件来说是错误的指令。
真正有效的做法是为每一类文件分别创建一个技能文件,另外再为普通 Ruby 文件创建一个。
下面是一个用于测试控制器的基础技能文件示例:
---
name: "Generate Request Spec"
description: "Generate RSpec request tests for a Rails controller. Use when the source file is in app/controllers/."
---

# Generate Request Spec

## File Scope

- `spec/requests//_spec.rb` — drop `_controller` from the filename
- `spec/factories/.rb` — create or update if needed

## Example tests for Controllers

# frozen_string_literal: true
require 'rails_helper'

describe 'Admin::Users', type: :request do
  let(:user) { create(:user, :admin) }
  before { sign_in user }

  # Unauthorized access — one test per action
  describe '#authorized?' do
    let(:user) { create(:user) }
    it 'GET /admin/users redirects' do
      get '/admin/users'
      expect(response).to have_http_status(:redirect)
    end
  end

  # Each action: happy + sad paths
  describe 'POST /admin/users' do
    let(:valid_params)   { { user: attributes_for(:user) } }
    let(:invalid_params) { { user: { email: '' } } }

    context 'with valid params' do
      it 'creates a record' do
        expect { post '/admin/users', params: valid_params }.to change(User, :count).by(1)
        expect(response).to have_http_status(:created)
      end
    end

    context 'with invalid params' do
      it 'returns unprocessable entity with errors' do
        post '/admin/users', params: invalid_params
        expect(response).to have_http_status(:unprocessable_entity)
        json = JSON.parse(response.body, symbolize_names: true)
        expect(json[:errors]).to include("Email can't be blank")
      end
    end
  end
end

## Critical Rules

- **Assert content, not just status:** always parse JSON and verify exact values
- **Test exact error messages:** `include("Email can't be blank")`, not `be_present`
- **Verify state changes:** use `.by(1)` and check the created record's attributes
- **Cover all actions:** index, show, create, update, destroy, and any custom actions
- **Test auth on every action:** verify unauthorized users get the correct status code
- Use `let` only, never `@instance_variables`; `sign_in user` again before `follow_redirect!`
添加自定义工具
Vibe 内置了读写文件、运行 bash 命令和编辑代码的工具,同时也支持自定义工具 & MCP 来扩展其行动空间。对这个项目而言,自定义工具至关重要。
经过一番尝试,我们最终采用了:
- 一个 RuboCop 代码检查工具,它运行
rubocop命令检测风格违规,让智能体回到代码中修复这些问题。 - 一个与 RSpec 集成的 SimpleCov 工具,同时检查代码覆盖率和测试正确性。把它放在最后一步是关键:这保证了智能体写出的每个测试都真的能运行。
下面是我们实现 Rubocop 检查工具的精简版本:
import asyncio
from pathlib import Path

from pydantic import BaseModel
from vibe.core.tools.base import BaseTool, ToolError

class RubocopLintResult(BaseModel):
    command: str
    output: str
    success: bool
    exit_code: int | None = None

class RubocopLint(BaseTool):
    description = "Lint spec files using Rubocop."

    async def run(self, spec_path: str):
        spec_path = Path(spec_path)

        cmd = ["rubocop", "--format", "simple", str(spec_path)]
        proc = await asyncio.create_subprocess_exec(
            *cmd, stdout=asyncio.subprocess.PIPE, stderr=asyncio.subprocess.PIPE
        )

        try:
            stdout, stderr = await asyncio.wait_for(proc.communicate(), timeout=60)
        except TimeoutError:
            proc.kill()
            await proc.wait()
            raise ToolError("Rubocop timed out after 60s")

        output = stdout.decode("utf-8", errors="ignore")

        yield RubocopLintResult(
            command=" ".join(cmd),
            output=output,
            success=proc.returncode == 0,
            exit_code=proc.returncode
        )
SimpleCov 工具遵循同样的模式,但做得更多:它用 RSpec 运行 spec 文件,收集每个测试的通过/失败结果,并报告源文件的覆盖率百分比。智能体能得知哪些测试失败了(附带错误信息),以及源文件中哪些行从未被执行到。这足以让它在需要时自我纠正。
我们刚接入这个工具时,生成的测试只有大约三分之一在首次执行时通过。智能体在几轮迭代内自行纠正了所有失败。如果没有这一步,其中一些测试根本不会运行。
衡量测试质量
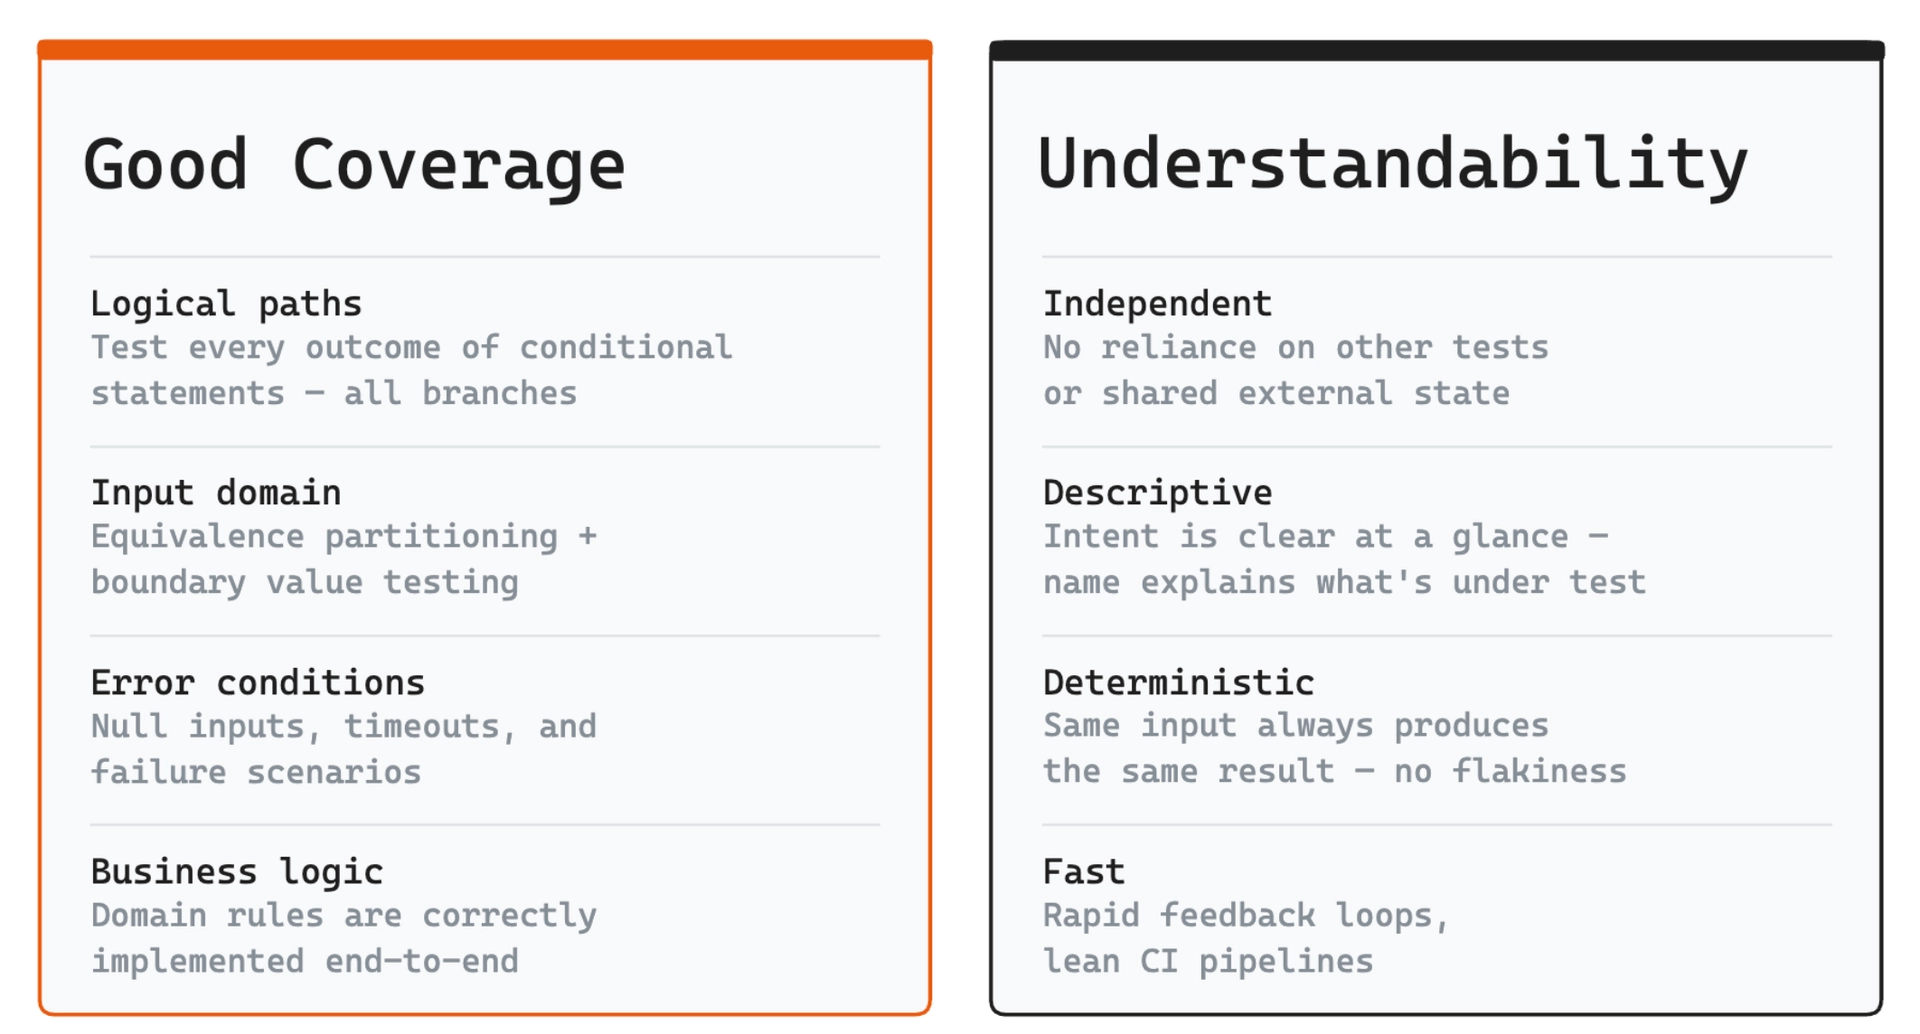
好的单元测试遵循Arrange-Act-Assert(准备-执行-断言)模式:设置状态、执行一个行为、验证结果。它应使用精确的断言,同时覆盖正常路径和错误路径,并且在失败时能清楚地指出哪里出了问题。
基于工具的指标
现有的 Ruby on Rails 工具让我们可以轻松获得若干指标:
- RSpec:Ruby 最流行的测试框架。语法表达力强,便于编写可读、结构良好的测试。
- RuboCop:Ruby 静态代码分析器和格式化工具,帮助落实风格规范并保持代码一致
- SimpleCov:Ruby 的代码覆盖率工具,衡量测试套件执行了多少代码。
从这些工具中,我们可以提取出几个有用的量化指标:测试通过的比例、每个文件的 RuboCop 违规数、单元测试套件覆盖的代码比例,以及执行速度。这些指标为衡量测试套件的整体表现提供了可靠的基线。
但仅凭这些数字,无法判断一个测试文件究竟好不好。两个文件的 RuboCop 违规数都是零、覆盖率都是 100%、测试全部通过,我们该如何比较?量化指标可能完全一样,测试质量上却仍可能存在定性差异。
LLM-as-a-judge(以 LLM 为评判者)
LLM-as-a-judge 的思路是向 LLM 提问:“所有错误条件都测试到了吗?”或“这是一个好测试吗?”然后根据明确的标准得到一个 0 到 1 的分数。
示例提示词:
## Good Tests

Precise values: `eq(100)`, not `be_present` or `be_a(Float)`.
State changes: `change { User.count }.by(1)`.
Error paths: `raise_error(ArgumentError, "message")`.
Boundary cases: Test exact values at thresholds (e.g., `page(0)`).
Public interface: No `.send(:private_method)`.

## Bad Tests

Vague assertions: `be_truthy`, `be_an(Array)`.
"Doesn't crash" tests: `not_to raise_error`.
Testing private methods.
Over-mocking (tests mocks, not behavior).
No assertions on return values.

## Scoring Rules

- 1.0: Precise assertions on return values/state + all key paths covered (happy, error, boundaries).
- 0.8: Precise assertions on all tested paths, but 1-2 edge cases missing entirely.
- 0.6: All key paths covered, but 1-2 tests use vague assertions (e.g., `be_truthy` instead of `eq(expected)`) or minor over-mocking.
- 0.4: Some tests have precise assertions; others are vague, over-mocked, or skip return value checks.
- 0.2: Most tests lack meaningful assertions: vague matchers, stubbed-out logic, no verification of actual output.
- 0.0: Tests are structurally broken: testing private methods, no real assertions, or verifying mocks instead of behavior.
这里的“评分规则(Scoring Rules)”部分尤其重要,因为它能让多次运行之间的分数更加一致。没有它,智能体就缺乏对评分是严格还是宽松的明确界定。
这样的分数不如工具的输出或开发者的细致评审那样权威。但它能很好地反映我们智能体当前版本的表现,尤其是在对仓库中每个文件大规模运行时。
LLM-as-a-judge 评估的局限:
任何能用文字表达的东西都可以用 LLM-as-a-judge 打分,这使它用途广泛。但分数输出并不是确定性的。即便设置 temperature=0,由于内核运算顺序的缘故,结果仍会有波动。实际上,同一评估的输出总是很接近,但这种不确定性对某些场景可能是个问题。
对我们的场景来说,由于我们评分的对象不是单个测试,而通常是几十到几百个测试,这一局限是可以接受的。汇总后的分数保持稳定。
“缺失括号”问题
LLM-as-a-judge 还有另一个核心问题:一个测试可能质量很高,却无法运行,或者其背后的逻辑根本就是错的。
示例:
RSpec.describe User, "#full_name" do
  it "combines first and last name with a space" do
    user = User.new(first_name: "Ada", last_name: "Lovelace"

    expect(user.full_name).to eq("Ada Lovelace")
  end
end
这个测试看起来很棒。它只测试一个行为,有一段读起来像文档的清晰描述,遵循 Arrange-Act-Assert,并且一旦出错会给出有用的信息。
我们用前面定义的评分提示词,让多个模型对这个测试打分。平均得分是 0.75。快速看一眼的开发者很可能也会认同。
但这个测试有一个致命缺陷:它根本无法运行。原因仅仅是 User.new() 上缺了一个右括号 )。这是一个严重的缺陷,使这个测试绝对不可用。
这个例子很容易规避。但还有很多其他可能导致语法错误的情形:
- 版本错误:使用了与当前 Ruby 或 Rails 版本不兼容的方法或语法
- 不存在的方法:有些方法可能已被移除、重命名,或者根本从未存在过。
- 工厂/夹具错误:引用了不存在的工厂、错误的属性或缺失的关联
- 缺失依赖:使用了测试环境中未包含的 gem 或模块
实验
我们做了一个实验,检验这个智能体能否应对真实代码库。目标仓库包含 275 个源文件,其中一半已有测试覆盖,另一半没有任何测试。
我们让智能体处理每一个文件,无论它是否已有测试。对于未覆盖的文件,它成功地从零生成了 spec;对于已有测试的文件,它重写并改进了测试。
我们用 LLM-as-a-judge 为每个 spec 文件在处理前后分别打分。已有测试的文件的汇总得分从 0.49 提升到 0.74,覆盖率达到 100%。仍有改进空间,但结果验证了这一方法。
| 指标 | 结果 |
|---|---|
| 处理的文件数 | 275 |
| 测试通过率 | 100% |
| 平均行覆盖率(SimpleCov) | 100% |
| 自我纠正后的 RuboCop 违规数 | 0 |
| LLM-as-a-judge 得分 | 0.74 |
按文件类型划分
并非所有文件类型都同样容易测试。模型得分最高:它们的业务逻辑自成一体,测试模式也可预测。控制器则更难,HTTP 请求处理带来了更多出错的空间。
| 文件类型 | LLM-as-a-judge |
|---|---|
| 模型 | 0.81 |
| 控制器 | 0.67 |
| 序列化器 | 0.80 |
它能运行吗?
把 SimpleCov 与 RSpec 执行捆绑为最后一步,迫使智能体运行它写的每一个测试,这是影响最大的单个决策。只有三分之一的测试在首次执行时通过,智能体在几轮迭代内自行纠正了所有失败。
如果没有这一步,LLM-as-a-judge 会把这些无法运行的测试评为高质量:这就是大规模场景下的“缺失括号”问题。
Vibe 是开源的。这里描述的智能体、工具和技能都运行在它之上。立即试用。