AI 智能体的未来,是模型能够在成百上千个工具之间无缝工作:一个 IDE 助手,集成 git 操作、文件处理、包管理器、测试框架和部署流水线;一个运维协调员,同时连接 Slack、GitHub、Google Drive、Jira、公司数据库以及数十个 MCP 服务器。
要构建高效的智能体,它们需要能使用规模不受限的工具库,而不必预先把每个工具定义都塞进上下文。我们此前关于结合 MCP 使用代码执行的博客文章提到,工具结果和工具定义有时会在智能体读取请求之前就消耗 50,000 多个 token。智能体应当按需发现并加载工具,只保留与当前任务相关的部分。
智能体还需要能够通过代码调用工具。使用自然语言调用工具时,每次调用都需要一次完整的推理,而且无论中间结果是否有用,它们都会堆积在上下文中。代码天然适合用来编写编排逻辑,例如循环、条件判断和数据转换。智能体需要能够根据手头的任务,灵活地在代码执行与推理之间做出选择。
智能体还需要从示例中学习正确的工具用法,而不仅仅是依赖 schema 定义。JSON schema 能定义结构上什么是合法的,却无法表达使用模式:何时应包含可选参数、哪些参数组合是合理的,或者你的 API 期望遵循什么约定。
今天,我们发布三项功能,让这一切成为可能:
- Tool Search Tool(工具搜索工具),让 Claude 可以通过搜索工具访问数千个工具,而不占用其上下文窗口
- Programmatic Tool Calling(程序化工具调用),让 Claude 可以在代码执行环境中调用工具,从而减少对模型上下文窗口的影响
- Tool Use Examples(工具使用示例),提供一套通用标准,用于演示如何有效使用某个工具
在内部测试中,我们发现这些功能帮助我们构建出了传统工具使用模式下无法实现的东西。例如,Claude for Excel 利用 Programmatic Tool Calling 读取和修改包含数千行的电子表格,而不会撑爆模型的上下文窗口。
根据我们的经验,我们相信这些功能为你用 Claude 构建的东西打开了新的可能。
Tool Search Tool
挑战
MCP 工具定义提供了重要的上下文,但随着连接的服务器增多,这些 token 会不断累积。以一个五服务器的配置为例:
- GitHub:35 个工具(约 26K token)
- Slack:11 个工具(约 21K token)
- Sentry:5 个工具(约 3K token)
- Grafana:5 个工具(约 3K token)
- Splunk:2 个工具(约 2K token)
也就是说,58 个工具在对话开始之前就消耗了大约 55K token。再加上 Jira 等更多服务器(仅它一个就用掉约 17K token),开销很快就会逼近 100K 以上。在 Anthropic,我们见过工具定义在优化前消耗 134K token。
但 token 成本并不是唯一的问题。最常见的失败是选错工具和参数不正确,尤其是当工具名称相似时,例如 notification-send-user 与 notification-send-channel。
我们的方案
Tool Search Tool 不再预先加载所有工具定义,而是按需发现工具。Claude 只会看到当前任务真正需要的工具。
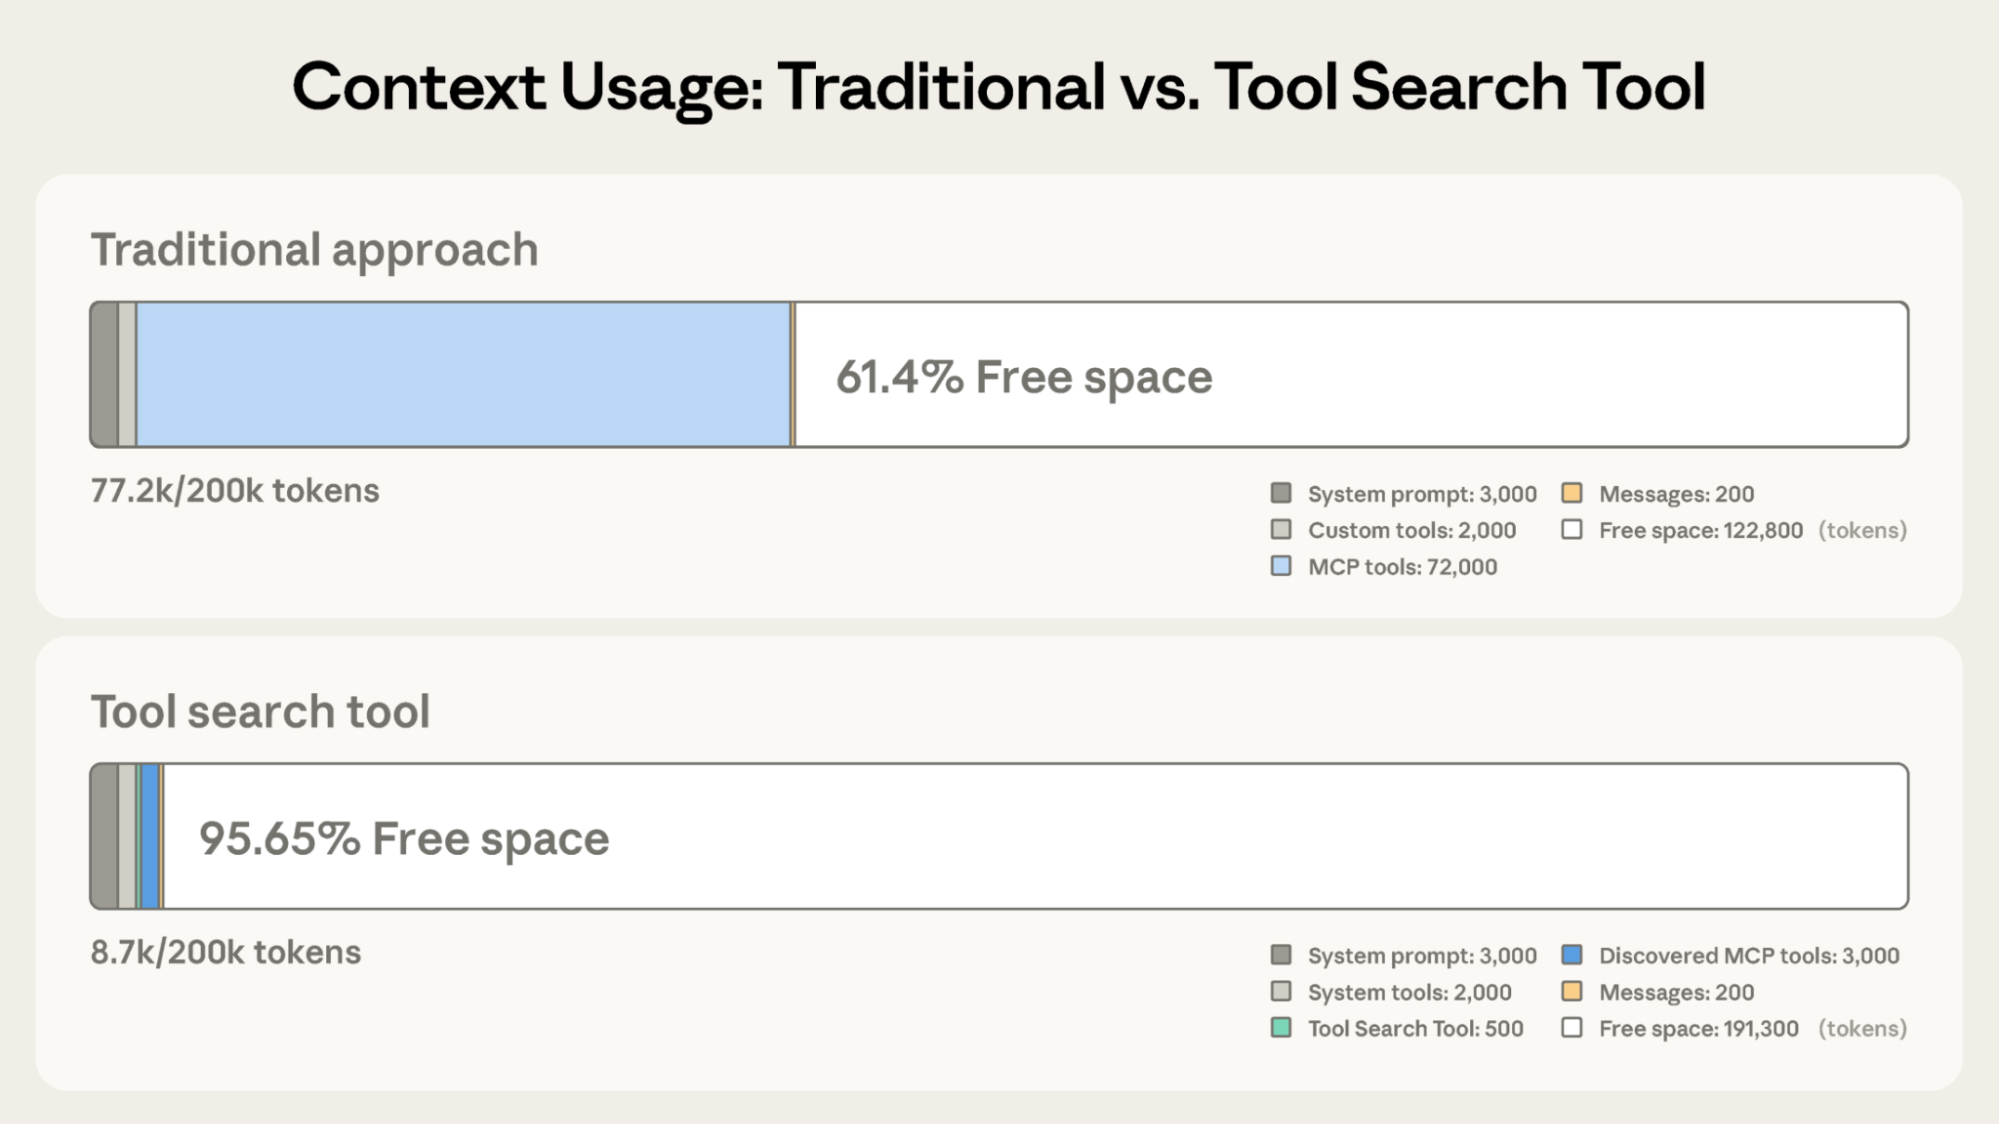
传统方式:
- 预先加载所有工具定义(50 多个 MCP 工具约 72K token)
- 对话历史和系统提示词争夺剩余空间
- 上下文总消耗:开始工作之前约 77K token
使用 Tool Search Tool:
- 预先只加载 Tool Search Tool(约 500 token)
- 按需发现所需工具(3-5 个相关工具,约 3K token)
- 上下文总消耗:约 8.7K token,保留了 95% 的上下文窗口
这意味着 token 使用量减少了 85%,同时仍能访问完整的工具库。内部测试显示,在处理大型工具库时,MCP 评测的准确率显著提升:启用 Tool Search Tool 后,Opus 4 从 49% 提升到 74%,Opus 4.5 从 79.5% 提升到 88.1%。
Tool Search Tool 的工作原理
Tool Search Tool 让 Claude 动态发现工具,而不是预先加载所有定义。你把全部工具定义提供给 API,但用 defer_loading: true 标记那些可按需发现的工具。被延迟加载的工具起初不会进入 Claude 的上下文。Claude 只会看到 Tool Search Tool 本身,以及所有带有 defer_loading: false 的工具(即你最关键、最常用的工具)。
当 Claude 需要某项具体能力时,它会搜索相关工具。Tool Search Tool 返回匹配工具的引用,这些引用随后会被展开成完整定义,进入 Claude 的上下文。
例如,如果 Claude 需要与 GitHub 交互,它会搜索“github”,此时只有 github.createPullRequest 和 github.listIssues 会被加载,而不会加载你来自 Slack、Jira 和 Google Drive 的其他 50 多个工具。
这样,Claude 既能访问你的完整工具库,又只需为真正用到的工具支付 token 成本。
关于提示词缓存:Tool Search Tool 不会破坏提示词缓存,因为被延迟加载的工具完全不在初始提示词中。它们只会在 Claude 搜索之后才被加入上下文,因此你的系统提示词和核心工具定义仍然可以被缓存。
实现方式:
{
  "tools": [
    // Include a tool search tool (regex, BM25, or custom)
    {"type": "tool_search_tool_regex_20251119", "name": "tool_search_tool_regex"},

    // Mark tools for on-demand discovery
    {
      "name": "github.createPullRequest",
      "description": "Create a pull request",
      "input_schema": {...},
      "defer_loading": true
    }
    // ... hundreds more deferred tools with defer_loading: true
  ]
}
对于 MCP 服务器,你可以延迟加载整个服务器,同时保留某些高频使用的特定工具处于已加载状态:
{
  "type": "mcp_toolset",
  "mcp_server_name": "google-drive",
  "default_config": {"defer_loading": true}, # defer loading the entire server
  "configs": {
    "search_files": {
"defer_loading": false
    }  // Keep most used tool loaded
  }
}
Claude 开发者平台开箱即用地提供基于正则表达式和基于 BM25 的搜索工具,你也可以使用嵌入(embedding)或其他策略实现自定义搜索工具。
何时使用 Tool Search Tool
和任何架构决策一样,启用 Tool Search Tool 也需要权衡。该功能会在调用工具之前增加一个搜索步骤,因此当上下文节省和准确率提升超过额外延迟时,投入产出比最高。
适合使用的情况:
- 工具定义消耗 >10K token
- 遇到工具选择准确率问题
- 构建由 MCP 驱动、包含多个服务器的系统
- 可用工具 10 个以上
收益较小的情况:
- 工具库很小(<10 个工具)
- 每次会话中所有工具都被频繁使用
- 工具定义很精简
Programmatic Tool Calling
挑战
随着工作流越来越复杂,传统的工具调用会带来两个根本性问题:
- 中间结果造成上下文污染:当 Claude 分析一个 10MB 的日志文件以查找错误模式时,整个文件都会进入它的上下文窗口,尽管 Claude 只需要错误频率的汇总。在跨多张表获取客户数据时,无论相关与否,每条记录都会堆积在上下文里。这些中间结果会消耗大量 token 预算,甚至可能把重要信息完全挤出上下文窗口。
- 推理开销与人工式综合:每次工具调用都需要一次完整的模型推理。收到结果后,Claude 必须“目测”数据以提取相关信息,推理各部分之间如何衔接,并决定下一步做什么,这一切都通过自然语言处理完成。一个包含五次工具调用的工作流,意味着五次推理,加上 Claude 解析每个结果、比较数值并综合出结论。这既慢又容易出错。
我们的方案
Programmatic Tool Calling 让 Claude 通过代码来编排工具,而不是通过一次次独立的 API 往返。Claude 不再一次请求一个工具并让每个结果都返回到上下文中,而是编写代码来调用多个工具、处理它们的输出,并控制哪些信息真正进入上下文窗口。
Claude 擅长编写代码,让它用 Python 表达编排逻辑,而不是通过自然语言的工具调用,你就能获得更可靠、更精确的控制流。循环、条件判断、数据转换和错误处理都在代码中显式表达,而不是隐含在 Claude 的推理里。
示例:预算合规检查
考虑一个常见的业务任务:“哪些团队成员超出了第三季度的差旅预算?”
你有三个可用的工具:
get_team_members(department)- 返回团队成员列表及其 ID 和职级get_expenses(user_id, quarter)- 返回某位用户的费用明细条目get_budget_by_level(level)- 返回某一员工职级对应的预算上限
传统方式:
- 获取团队成员 → 20 人
- 对每个人获取其第三季度费用 → 20 次工具调用,每次返回 50-100 条明细(机票、酒店、餐饮、收据)
- 按员工职级获取预算上限
- 所有这些都会进入 Claude 的上下文:2,000 多条费用明细(50 KB 以上)
- Claude 手动汇总每个人的费用,查找其预算,并将费用与预算上限进行比较
- 与模型的往返次数更多,上下文消耗显著
使用 Programmatic Tool Calling:
每个工具结果不再返回给 Claude,而是由 Claude 编写一个 Python 脚本来编排整个工作流。该脚本在 Code Execution 工具(一个沙箱环境)中运行,需要你的工具返回结果时会暂停。当你通过 API 返回工具结果时,它们由脚本处理,而不是被模型消耗。脚本继续执行,Claude 只会看到最终输出。
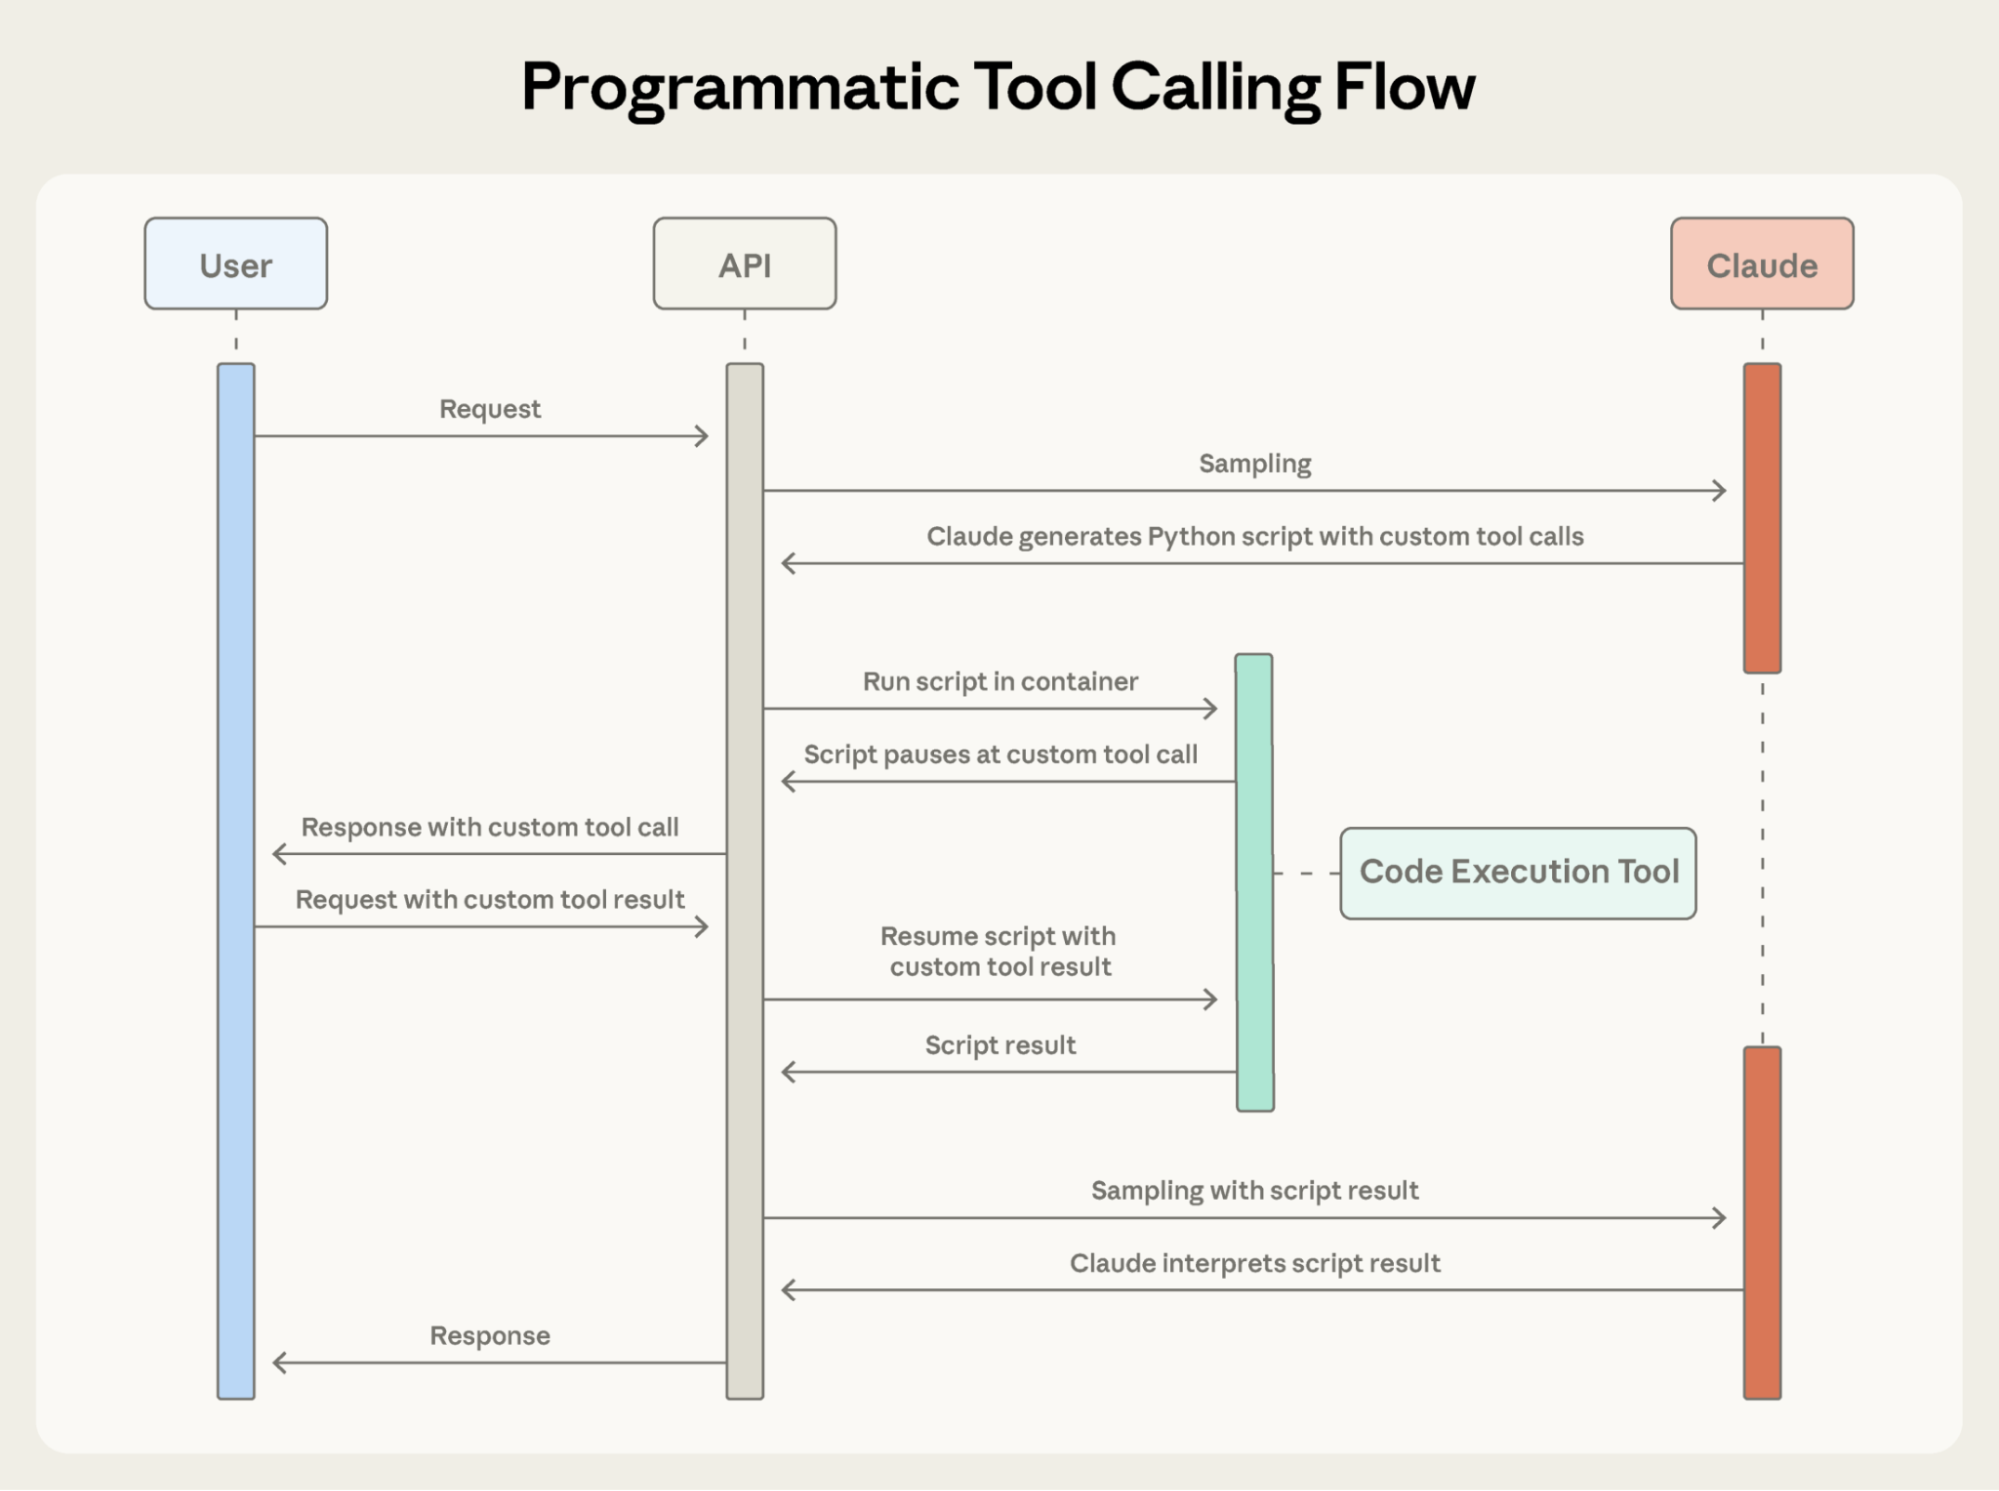
下面是 Claude 为预算合规任务编写的编排代码:
team = await get_team_members("engineering")

# Fetch budgets for each unique level
levels = list(set(m["level"] for m in team))
budget_results = await asyncio.gather(*[
    get_budget_by_level(level) for level in levels
])

# Create a lookup dictionary: {"junior": budget1, "senior": budget2, ...}
budgets = {level: budget for level, budget in zip(levels, budget_results)}

# Fetch all expenses in parallel
expenses = await asyncio.gather(*[
    get_expenses(m["id"], "Q3") for m in team
])

# Find employees who exceeded their travel budget
exceeded = []
for member, exp in zip(team, expenses):
    budget = budgets[member["level"]]
    total = sum(e["amount"] for e in exp)
    if total > budget["travel_limit"]:
        exceeded.append({
            "name": member["name"],
            "spent": total,
            "limit": budget["travel_limit"]
        })

print(json.dumps(exceeded))
Claude 的上下文只会收到最终结果:超出预算的两三个人。2,000 多条明细、中间汇总和预算查询都不会影响 Claude 的上下文,使消耗从 200KB 的原始费用数据降到仅 1KB 的结果。
效率提升十分可观:
- 节省 token:由于中间结果不进入 Claude 的上下文,PTC 大幅降低了 token 消耗。在复杂的研究任务上,平均用量从 43,588 降至 27,297 token,降幅 37%。
- 降低延迟:每次 API 往返都需要模型推理(数百毫秒到数秒)。当 Claude 在单个代码块中编排 20 多次工具调用时,可以省去 19 次以上的推理。API 负责处理工具执行,而无需每次都回到模型。
- 提高准确率:通过编写显式的编排逻辑,Claude 比用自然语言同时处理多个工具结果时出错更少。内部知识检索从 25.6% 提升到 28.5%;GIA 基准测试从 46.5% 提升到 51.2%。
生产环境的工作流涉及杂乱的数据、条件逻辑,以及需要规模化的操作。Programmatic Tool Calling 让 Claude 以程序化方式处理这些复杂性,同时把注意力放在可执行的结果上,而不是原始数据的处理上。
Programmatic Tool Calling 的工作原理
1. 将工具标记为可从代码中调用
在 tools 中添加 code_execution,并设置 allowed_callers,让指定工具可被程序化执行:
{
  "tools": [
    {
      "type": "code_execution_20250825",
      "name": "code_execution"
    },
    {
      "name": "get_team_members",
      "description": "Get all members of a department...",
      "input_schema": {...},
      "allowed_callers": ["code_execution_20250825"] # opt-in to programmatic tool calling
    },
    {
      "name": "get_expenses",
 	...
    },
    {
      "name": "get_budget_by_level",
	...
    }
  ]
}
API 会把这些工具定义转换为 Claude 可以调用的 Python 函数。
2. Claude 编写编排代码
Claude 不再一次请求一个工具,而是生成 Python 代码:
{
  "type": "server_tool_use",
  "id": "srvtoolu_abc",
  "name": "code_execution",
  "input": {
    "code": "team = get_team_members('engineering')\n..." # the code example above
  }
}
3. 工具执行时不触及 Claude 的上下文
当代码调用 get_expenses() 时,你会收到一个带有 caller 字段的工具请求:
{
  "type": "tool_use",
  "id": "toolu_xyz",
  "name": "get_expenses",
  "input": {"user_id": "emp_123", "quarter": "Q3"},
  "caller": {
    "type": "code_execution_20250825",
    "tool_id": "srvtoolu_abc"
  }
}
你提供结果,由 Code Execution 环境而非 Claude 的上下文来处理。代码中的每次工具调用都会重复这个请求-响应循环。
4. 只有最终输出进入上下文
代码运行结束后,只有代码的结果会返回给 Claude:
{
  "type": "code_execution_tool_result",
  "tool_use_id": "srvtoolu_abc",
  "content": {
    "stdout": "[{\"name\": \"Alice\", \"spent\": 12500, \"limit\": 10000}...]"
  }
}
这就是 Claude 看到的全部内容,而不是过程中处理的 2000 多条费用明细。
何时使用 Programmatic Tool Calling
Programmatic Tool Calling 会在你的工作流中增加一个代码执行步骤。当 token 节省、延迟改善和准确率提升都足够显著时,这笔额外开销才划算。
最适合的情况:
- 处理大型数据集,而你只需要汇总或摘要
- 运行包含三次或更多相互依赖的工具调用的多步骤工作流
- 在 Claude 看到工具结果之前对其进行过滤、排序或转换
- 处理中间数据不应影响 Claude 推理的任务
- 对大量对象并行执行操作(例如检查 50 个端点)
收益较小的情况:
- 只做简单的单工具调用
- Claude 应当查看所有中间结果并据此推理的任务
- 响应很小的快速查询
Tool Use Examples
挑战
JSON Schema 擅长定义结构,如类型、必填字段、允许的枚举值,但它无法表达使用模式:何时应包含可选参数、哪些组合是合理的,或者你的 API 期望遵循什么约定。
以一个支持工单 API 为例:
{
  "name": "create_ticket",
  "input_schema": {
    "properties": {
      "title": {"type": "string"},
      "priority": {"enum": ["low", "medium", "high", "critical"]},
      "labels": {"type": "array", "items": {"type": "string"}},
      "reporter": {
        "type": "object",
        "properties": {
          "id": {"type": "string"},
          "name": {"type": "string"},
          "contact": {
            "type": "object",
            "properties": {
              "email": {"type": "string"},
              "phone": {"type": "string"}
            }
          }
        }
      },
      "due_date": {"type": "string"},
      "escalation": {
        "type": "object",
        "properties": {
          "level": {"type": "integer"},
          "notify_manager": {"type": "boolean"},
          "sla_hours": {"type": "integer"}
        }
      }
    },
    "required": ["title"]
  }
}
该 schema 定义了什么是合法的,却让一些关键问题悬而未决:
- 格式歧义:
due_date应该使用“2024-11-06”、“Nov 6, 2024”,还是“2024-11-06T00:00:00Z”? - ID 约定:
reporter.id是 UUID、“USR-12345”,还是只是“12345”? - 嵌套结构的用法:Claude 应在什么时候填充
reporter.contact? - 参数之间的关联:
escalation.level和escalation.sla_hours与优先级是什么关系?
这些歧义可能导致工具调用格式错误和参数使用不一致。
我们的方案
Tool Use Examples 让你直接在工具定义中提供示例调用。你不再仅仅依赖 schema,而是向 Claude 展示具体的使用模式:
{
    "name": "create_ticket",
    "input_schema": { /* same schema as above */ },
    "input_examples": [
      {
        "title": "Login page returns 500 error",
        "priority": "critical",
        "labels": ["bug", "authentication", "production"],
        "reporter": {
          "id": "USR-12345",
          "name": "Jane Smith",
          "contact": {
            "email": "jane@acme.com",
            "phone": "+1-555-0123"
          }
        },
        "due_date": "2024-11-06",
        "escalation": {
          "level": 2,
          "notify_manager": true,
          "sla_hours": 4
        }
      },
      {
        "title": "Add dark mode support",
        "labels": ["feature-request", "ui"],
        "reporter": {
          "id": "USR-67890",
          "name": "Alex Chen"
        }
      },
      {
        "title": "Update API documentation"
      }
    ]
  }
从这三个示例中,Claude 学到了:
- 格式约定:日期使用 YYYY-MM-DD,用户 ID 遵循 USR-XXXXX,标签使用 kebab-case
- 嵌套结构模式:如何构造带有嵌套 contact 对象的 reporter 对象
- 可选参数之间的关联:严重 bug 带有完整的联系信息,并附带 SLA 严格的升级处理;功能请求有 reporter,但没有 contact 和升级处理;内部任务只有标题
在我们自己的内部测试中,工具使用示例将复杂参数处理的准确率从 72% 提升到了 90%。
何时使用 Tool Use Examples
Tool Use Examples 会给你的工具定义增加 token,因此当准确率提升超过额外成本时,它们最有价值。
最适合的情况:
- 复杂的嵌套结构,其中合法的 JSON 并不意味着用法正确
- 带有许多可选参数、且参数的包含模式很重要的工具
- 带有 schema 无法涵盖的领域特定约定的 API
- 相似工具之间,用示例厘清该用哪一个(例如
create_ticket与create_incident)
收益较小的情况:
- 用法显而易见的简单单参数工具
- URL、电子邮件等 Claude 本来就能理解的标准格式
- 更适合用 JSON Schema 约束来处理的校验问题
最佳实践
构建能在现实世界中采取行动的智能体,意味着要同时应对规模、复杂性和精确性。这三项功能协同工作,分别解决工具使用工作流中的不同瓶颈。下面介绍如何有效地组合使用它们。
有策略地分层使用功能
并非每个智能体在每个任务中都需要用到全部三项功能。先从你最大的瓶颈入手:
- 工具定义造成的上下文膨胀 → Tool Search Tool
- 大型中间结果污染上下文 → Programmatic Tool Calling
- 参数错误和格式错误的调用 → Tool Use Examples
这种有针对性的做法让你能解决真正限制智能体表现的那个约束,而不是一开始就增加复杂性。
然后再根据需要叠加其他功能。它们是互补的:Tool Search Tool 确保找到正确的工具,Programmatic Tool Calling 确保高效执行,Tool Use Examples 确保正确调用。
设置 Tool Search Tool 以改善工具发现
工具搜索会匹配名称和描述,因此清晰、有描述性的定义能提升发现的准确率。
// Good
{
    "name": "search_customer_orders",
    "description": "Search for customer orders by date range, status, or total amount. Returns order details including items, shipping, and payment info."
}

// Bad
{
    "name": "query_db_orders",
    "description": "Execute order query"
}
在系统提示词中加入引导,让 Claude 知道有哪些可用工具:
You have access to tools for Slack messaging, Google Drive file management,
Jira ticket tracking, and GitHub repository operations. Use the tool search
to find specific capabilities.
让最常用的三到五个工具始终保持加载,其余的延迟加载。这样既能让常见操作立即可用,又能让其他一切按需发现。
设置 Programmatic Tool Calling 以确保正确执行
由于 Claude 会编写代码来解析工具输出,请清楚地记录返回格式,这有助于 Claude 写出正确的解析逻辑:
{
    "name": "get_orders",
    "description": "Retrieve orders for a customer.
Returns:
    List of order objects, each containing:
    - id (str): Order identifier
    - total (float): Order total in USD
    - status (str): One of 'pending', 'shipped', 'delivered'
    - items (list): Array of {sku, quantity, price}
    - created_at (str): ISO 8601 timestamp"
}
以下是适合启用程序化编排的工具类型:
- 可以并行运行的工具(相互独立的操作)
- 可以安全重试的操作(幂等)
设置 Tool Use Examples 以提高参数准确性
精心编写示例,使行为清晰明确:
- 使用真实的数据(真实的城市名、合理的价格,而不是“string”或“value”)
- 展示多样性,涵盖最小、部分和完整的指定模式
- 保持简洁:每个工具 1-5 个示例
- 聚焦于有歧义之处(只在 schema 无法让人明显看出正确用法时才添加示例)
开始使用
这些功能目前处于 beta 阶段。要启用它们,请添加 beta 请求头并包含你需要的工具:
client.beta.messages.create(
    betas=["advanced-tool-use-2025-11-20"],
    model="claude-sonnet-4-5-20250929",
    max_tokens=4096,
    tools=[
        {"type": "tool_search_tool_regex_20251119", "name": "tool_search_tool_regex"},
        {"type": "code_execution_20250825", "name": "code_execution"},
        # Your tools with defer_loading, allowed_callers, and input_examples
    ]
)
有关详细的 API 文档和 SDK 示例,请参阅:
这些功能让工具使用从简单的函数调用迈向智能编排。随着智能体处理的工作流越来越复杂,涉及数十个工具和大型数据集,动态发现、高效执行和可靠调用将成为基础能力。
我们期待看到你的作品。
致谢
本文由 Bin Wu 撰写,Adam Jones、Artur Renault、Henry Tay、Jake Noble、Noah Picard、Sam Jiang 以及 Claude Developer Platform 团队参与贡献。这项工作建立在 Chris Gorgolewski、Daniel Jiang、Jeremy Fox 和 Mike Lambert 的基础研究之上。我们也从整个 AI 生态中汲取了灵感,包括 Joel Pobar 的 LLMVM、Cloudflare 的 Code Mode 和 Code Execution as MCP。特别感谢 Andy Schumeister、Hamish Kerr、Keir Bradwell、Matt Bleifer 和 Molly Vorwerck 的支持。