AI 工厂必须支持越来越大的模型和越来越复杂的推理工作负载。为了满足 AI 工作负载永无止境的算力需求,超大规模云厂商和 AI 原生公司正在开发定制 AI 加速器,即 XPU。大规模部署这些加速器,需要高带宽内存(HBM)来持续喂饱算力,需要足够的封装和硅片面积来容纳更多计算单元,需要高效的供电,还需要有韧性的供应链。同时也需要一种机架级架构,把 XPU 部署到数据中心基础设施中。
NVIDIA NVLink Fusion 是一项连接技术和 IP,让超大规模云厂商和 AI 原生公司能够把定制 XPU 和 CPU 部署到 NVIDIA AI 基础设施平台中。他们可以使用 NVIDIA 的纵向扩展(scale-up)和横向扩展(scale-out)技术栈、生态系统以及 MGX 机架级架构,降低开发和部署的复杂度,提升性能,并加快半定制 AI 工厂的上市时间。
在封装层面,NVHBM 是对这一统一架构的补充。NVHBM 是一项与领先的内存厂商共同设计并验证的定制 HBM 基底裸片(base die)技术,可提高内存带宽,更好地节省面积,并降低功耗。这些改进能帮助定制 XPU 支持更大的模型,更快地读取 KV 缓存数据,并提升训练和大规模推理的表现。
为什么带宽、裸片面积和功耗决定加速器设计
训练、推理和智能体 AI 工作负载越来越依赖对模型权重、KV 缓存和激活数据的高吞吐访问。当 AI 系统从单个加速器扩展到机架级计算域时,加速器封装必须在计算逻辑、供电、散热设计和高带宽内存之间取得平衡。
HBM 把至关重要的内存带宽放在加速器近旁,但对领先内存技术的资质认证、封装集成和验证,可能成为定制加速器项目的瓶颈。通过 NVLink Fusion,客户可以获得与领先内存制造商共同验证过的 NVHBM 基底裸片,有助于缓解集成和认证的瓶颈。
表 1. NVHBM 为 AI 加速器项目带来三大平台级优势:更高的内存带宽、更多的封装和硅片面积,以及更低的 HBM 功耗
| 特性 | NVHBM 优势 |
|---|---|
| 带宽 | 与标准 HBM4e 相比,内存带宽最高提升 30% |
| 面积 | 更高效的接口连接,使计算裸片面积最多可增加 25%,用于容纳更多 XPU 功能 |
| 功耗 | 与标准 HBM4e 相比,HBM 功耗最高降低 15%,在数千颗 XPU 上累积起可观的节省 |
现代 AI 加速器的内存带宽瓶颈
AI 加速器的性能取决于计算引擎能否持续获得数据。更高的 HBM 速度会在既定的封装预算内提高可用内存带宽,增强应对训练和推理中带宽密集阶段的能力。与标准 HBM4e 相比,NVHBM 的每堆栈内存带宽最高提升 30%。对于受内存限制或部分受内存限制的 AI 工作负载,这意味着更高的加速器利用率和吞吐量。通过更快地在 HBM 与计算核心之间搬运数据、让核心始终有数据可算,它可以提高大模型推理时的单用户词元吞吐量。
NVHBM 提高的是每个加速器内部的内存带宽,而 NVLink Fusion 则在更大的范围内连接各个加速器,使工作负载能更高效地利用分布式的算力和内存。
在使用专家并行(EP)或 WideEP 等高级路由技术时,这种纵向扩展域尤为关键。在这些场景中,不同的专家位于不同的 GPU 上,需要在整个机架范围内实现无缝、高速的同步。NVIDIA NVLink 是 AI 工厂的纵向扩展网络互连结构,负责在专家之间传输激活值和隐藏状态,并帮助在整个纵向扩展互连中同步分布式缓存。NVHBM 则通过让本地计算引擎持续有数据可用,尽量避免数据饥饿。
更多封装面积,更大灵活性
对定制 AI 芯片而言,每一平方毫米都很宝贵。加速器设计者必须决定把多少面积分配给矩阵引擎、向量单元、片上 SRAM、缓存层级、控制逻辑、内存接口、片上网络和纵向扩展连接。定制的内存实现有助于减少访问 HBM 所带来的设计和封装开销,腾出面积用于面向特定工作负载的能力。
随着 AI 工作负载日益多样化,这部分额外的裸片面积让超大规模云厂商可以更灵活地针对推理服务、推荐系统、多模态流水线或内部训练工作负载优化 XPU。通过减少内存接口所需的面积,NVHBM 让团队能把芯片上更多的面积直接用于提升性能。
面积的节省主要来自重新设计的物理内存接口(PHY)。标准 HBM 依赖更宽的接口连接,增加了整体封装占用面积。NVHBM 采用了针对效率优化的定制基底裸片,将内存控制器移入 3D HBM 堆栈并集成定制 PHY,从而降低了 I/O 面积需求。
与 JEDEC HBM4e 标准相比,该设计将 PHY 及配套区域的面积最多减少 67%。更窄的接口还简化了中介层(interposer)布线,在整个版图上最多可多出 80% 的可用硅片。
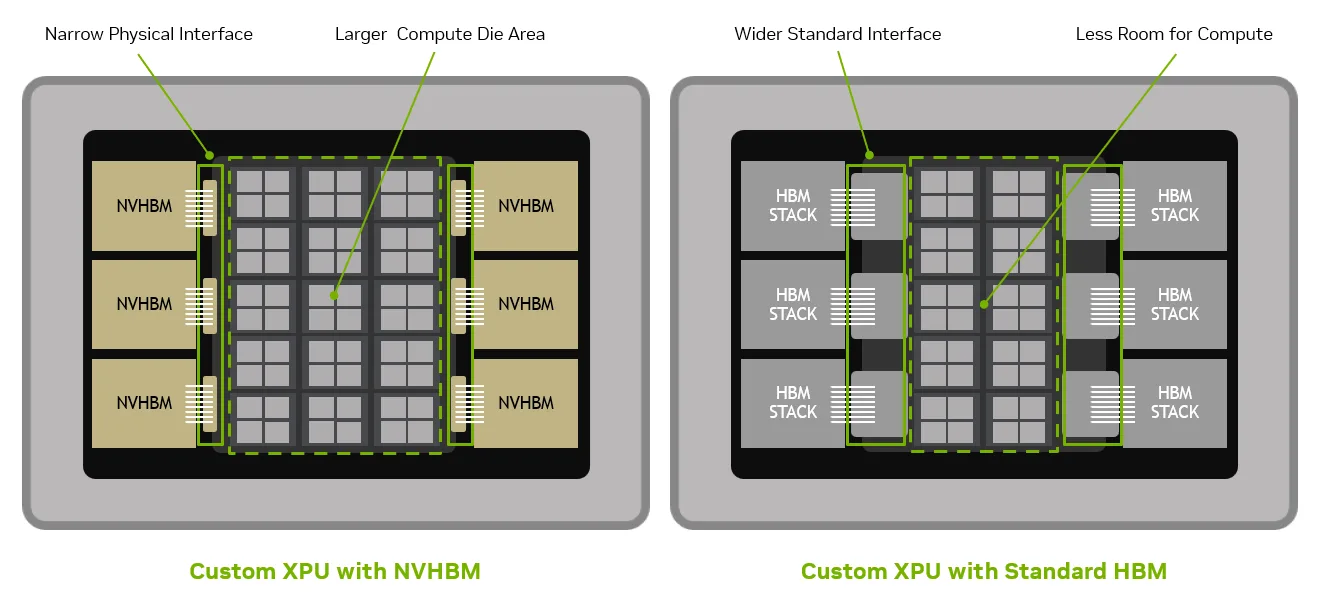
如图 1 所示,缩小内存接口连接后,中央的 AI 计算裸片可以向新腾出的空间扩展。这样回收的面积,使可用于计算或其他功能的主裸片硅片最多增加 30%。额外的硅片面积让 XPU 设计者能在固定的封装占用面积内加入更多功能。
节能,实现高效扩展
功耗是现代 AI 基础设施中最难突破的约束之一。HBM 的功耗会影响加速器功耗预算、封装散热设计、机架功率包络和数据中心的冷却方案。与标准 HBM4e 相比,NVHBM 可使 HBM 功耗降低 15%,为计算留出更多功耗和散热余量。
节能在多个层面都有意义。在 XPU 层面,更低的 HBM 功耗可以提升每瓦性能,并为更多计算或更高的持续利用率腾出空间。在机架层面,有助于缓解供电和冷却系统的压力。在 AI 工厂规模上,即使内存子系统功耗只是小幅下降,也会在数千个加速器上累积起来。当它被放大到整个使用 2,000W XPU 的 1 吉瓦数据中心时,节省下的功耗最多可在算力余量中多容纳 15,000 颗XPU。
这一收益对大模型推理尤为重要。XPU 在以低延迟、高吞吐为用户提供服务时,必须反复读取模型权重和 KV 缓存数据。减少搬运这些数据所耗费的能量,有助于支持大模型更快的推理、更大的批处理规模,以及对已部署功率更高效的利用。
在机架规模上结合 NVLink Fusion 与 NVHBM
NVHBM 在芯片层面提升 XPU 的性能和效率。NVLink Fusion 则让超大规模云厂商和 AI 原生公司能把自己的 XPU 连接到 NVIDIA AI 平台的其余部分。内存带宽提高 30%、裸片面积增加 25%、HBM 功耗节省 15%,这些协同设计的架构改进叠加之后,使每颗 XPU 的端到端整体性能显著提升 30%。
这种连接通过 NVLink Fusion 小芯片(chiplet)实现,它在定制 XPU 与 NVLink 互连结构之间架起桥梁,把机架内所有 XPU 连接成单一的纵向扩展域。NVLink 如今已发展到第六代,是唯一经过验证、专为 AI 工厂打造的纵向扩展网络互连结构,提供领先的性能和智能化的韧性。在上游,XPU 可以通过 NVLink-C2C 连接到 CPU。
NVLink Fusion 的采用者可以把定制 XPU 和 CPU 与 NVIDIA 的纵向扩展和横向扩展技术栈及生态系统结合起来,降低开发和部署的复杂度,提升性能,并加快半定制 AI 工厂的上市时间。通过统一采用单一架构,NVLink Fusion 还简化了整个数据中心的运维,使数据中心容量可以灵活重新调配,并让定制 AI XPU 能与 GPU 集成,实现异构计算。
定制 AI 芯片的下一阶段
NVLink Fusion 为 GPU、定制 XPU 和 CPU、网络以及机架级软件提供了共同的纵向扩展基础。NVHBM 则以更强的内存性能、更高的计算密度、更高的 HBM 能效和更有韧性的供应,为下一代加速器补强了这一基础。这些技术为合作伙伴提供了一条从定制 AI 加速器设计到机架级部署和量产的更直接的路径。
详细了解 NVLink Fusion 和业界对 NVHBM 的采用情况。