研究
隆重推出
OCR 4
2026 年 6 月 23 日
作者:Mistral
返回博客
阅读时长 12 分钟
标题
副标题
正文
图像
表格
思考
摘要
Mistral OCR 4 带来了突破性的文档解析能力,支持边界框、块分类和内联置信度分数,覆盖 170 种语言,并且只需一个容器即可完成自托管部署。在人工评估和基准测试中,它都优于领先的 OCR 系统,同时为企业搜索、RAG 和智能体工作流提供高性价比、高吞吐量的处理能力。它可通过 API 或 Document AI 使用,既能为自定义流水线提供结构化输出,也能用于无代码应用,并提供自托管选项以保护数据隐私。
今天,我们发布 Mistral OCR 4,除提取文本外,还提供边界框、块分类和内联置信度分数。该模型支持 10 个语系共 170 种语言,只需一个容器即可实现完全自托管部署,可作为企业搜索、RAG 和特定领域检索流水线的摄取组件。OCR 4 是一个小巧而专注的模型,本文将介绍它有哪些新特性、在公开和内部基准测试中的表现、这些基准测试已知的局限,以及该何时使用模型 API、何时使用 Document AI。
▶ https://www.youtube.com/watch?v=bEt4wczgGR8
亮点
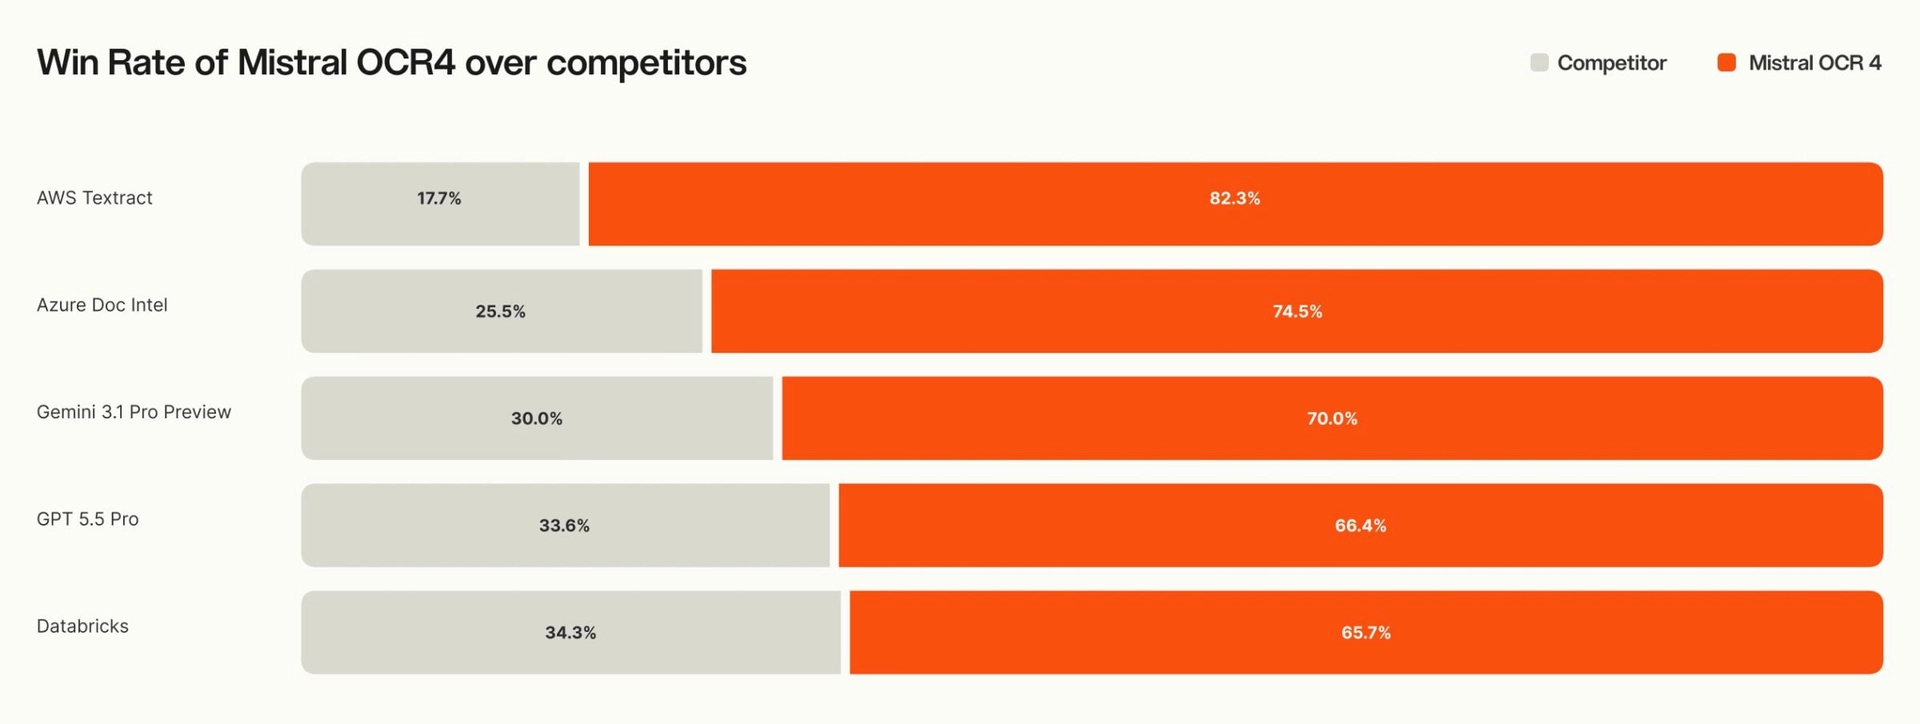
- 突破性的性能。独立标注人员在所有被测的领先 OCR 和文档 AI 系统中更偏好 OCR 4,平均胜率达 72%,同时在 OlmOCRBench 上取得最高总分(85.20)。评测方法和已知的评分局限见下文“基准测试”。
- 不只是文本,还有分割。除提取的文本外,OCR 4 还会返回边界框、带类型的块分类(标题、表格、公式、签名等)以及内联置信度分数。边界框是呼声最高的功能,可为文本定位,用于上下文内高亮和可靠的数据流水线。与此同时,块类型和置信度分数可用于基于来源的引用、脱敏和人工介入的核验。
- 与 Mistral Search Toolkit 集成(公开预览)。OCR 4 是 Search Toolkit 的摄取组件,后者是 Mistral 在 AI Now Summit 上发布的开源、可组合的搜索框架。OCR 4 的结构化输出可为该工具包面向 RAG 和企业搜索的摄取、检索与评估工作流提供可直接用于引用的输入。
- 多语言覆盖。支持 10 个语系共 170 种语言,在多个竞品性能下滑的专门语言和低资源语言上取得了可衡量的提升。
- 在自己的基础设施上运行。OCR 4 足够紧凑,单个容器即可部署,文档数据留在您自己的环境中,满足数据驻留、主权和合规要求,同时支持高性价比、高吞吐量的批量处理。企业客户可使用自托管部署。
概览
Mistral OCR 4 可从各类文档中提取内容并将其结构化。前几代产品侧重于把一页内容转换成干净的文本和表格,而 OCR 4 返回的是文档的结构化表示:每个块都带有边界框定位并按类型分类,同时按页和按词生成内联置信度分数。因此,下游系统不仅能获知文档说了什么,还能知道每个元素位于何处、扮演什么角色,以及模型对每个区域有多大把握。
这种结构化能力可支撑多种下游工作负载:
- 面向 RAG 的语义分块:干净且已分类的块是更好的检索单元。
- 面向智能体的结构化基础单元:智能体可以从阅读文档进阶到基于文档采取行动(填表、发票处理、合规检查)。
- 面向连接器的结构化内容:为摄取和索引流水线提供一致的、带类型的输出。
OCR 4 支持常见的企业文档格式,包括 PDF、DOC、PPT 和 OpenDocument,覆盖 10 个语系共 170 种语言,其中包括许多系统处理不佳的专门语言和低资源语言。作为可在单个容器中部署的紧凑模型,它既适合对成本敏感的场景,也适合大规模部署。它可以完全自托管,让有数据主权要求的组织把文档数据留在自己的基础设施内。
开发者可通过 API 集成该模型,团队也可以在 Mistral Studio 中使用 Document AI,以应用层面的无代码方式使用同一套引擎。通过 API 使用 Mistral OCR 4 的定价为每 1,000 页 4 美元,使用 Batch API 可享 50% 折扣,即每 1,000 页 2 美元。Document AI 的定价为每 1,000 页 5 美元。
基准测试
“我们在一个图表和图形密集的金融问答数据集上,将 Mistral OCR 4 与领先的智能体式文档解析器做了基准对比,在准确率相当的情况下,成本约低 8 倍,延迟约低 17 倍。对于大规模的生产场景,这种差距会迅速累积。”
- Aidan Donohue,Rogo 的 AI 工程师
为评估 OCR 4,我们将其与领先的 AI 原生 OCR 模型、前沿通用模型、企业文档服务以及我们自己的 Mistral OCR 3 进行了比较。
人类偏好评估
自动化基准测试带有上述评分偏差,因此我们又补充了一项在反映真实使用场景的文档上进行的人工对比评估。我们汇集了 600 多份文档,涵盖 12 种以上语言,均来自第三方供应商,代表真实的行业用例,并请独立标注人员逐份文档,以盲测方式将每个竞品的输出与 OCR 4 的输出进行排名。
在所有被测系统中,标注人员在大多数文档上都更偏好 OCR 4。由于这是人类对真实文档的判断,而不是与固定参考答案的字符串比对,因此规避了影响自动评分的大部分标注和格式噪声。
整体表现
“Mistral OCR 每页的速度大约比我们现用的供应商快 4 倍,对于大批量的案卷登记工作流来说,这个结果令人印象深刻,因为速度对于管理客户的知识产权时间线至关重要。”
- Ivan Mihailov,Anaqua 的 AI 工程师
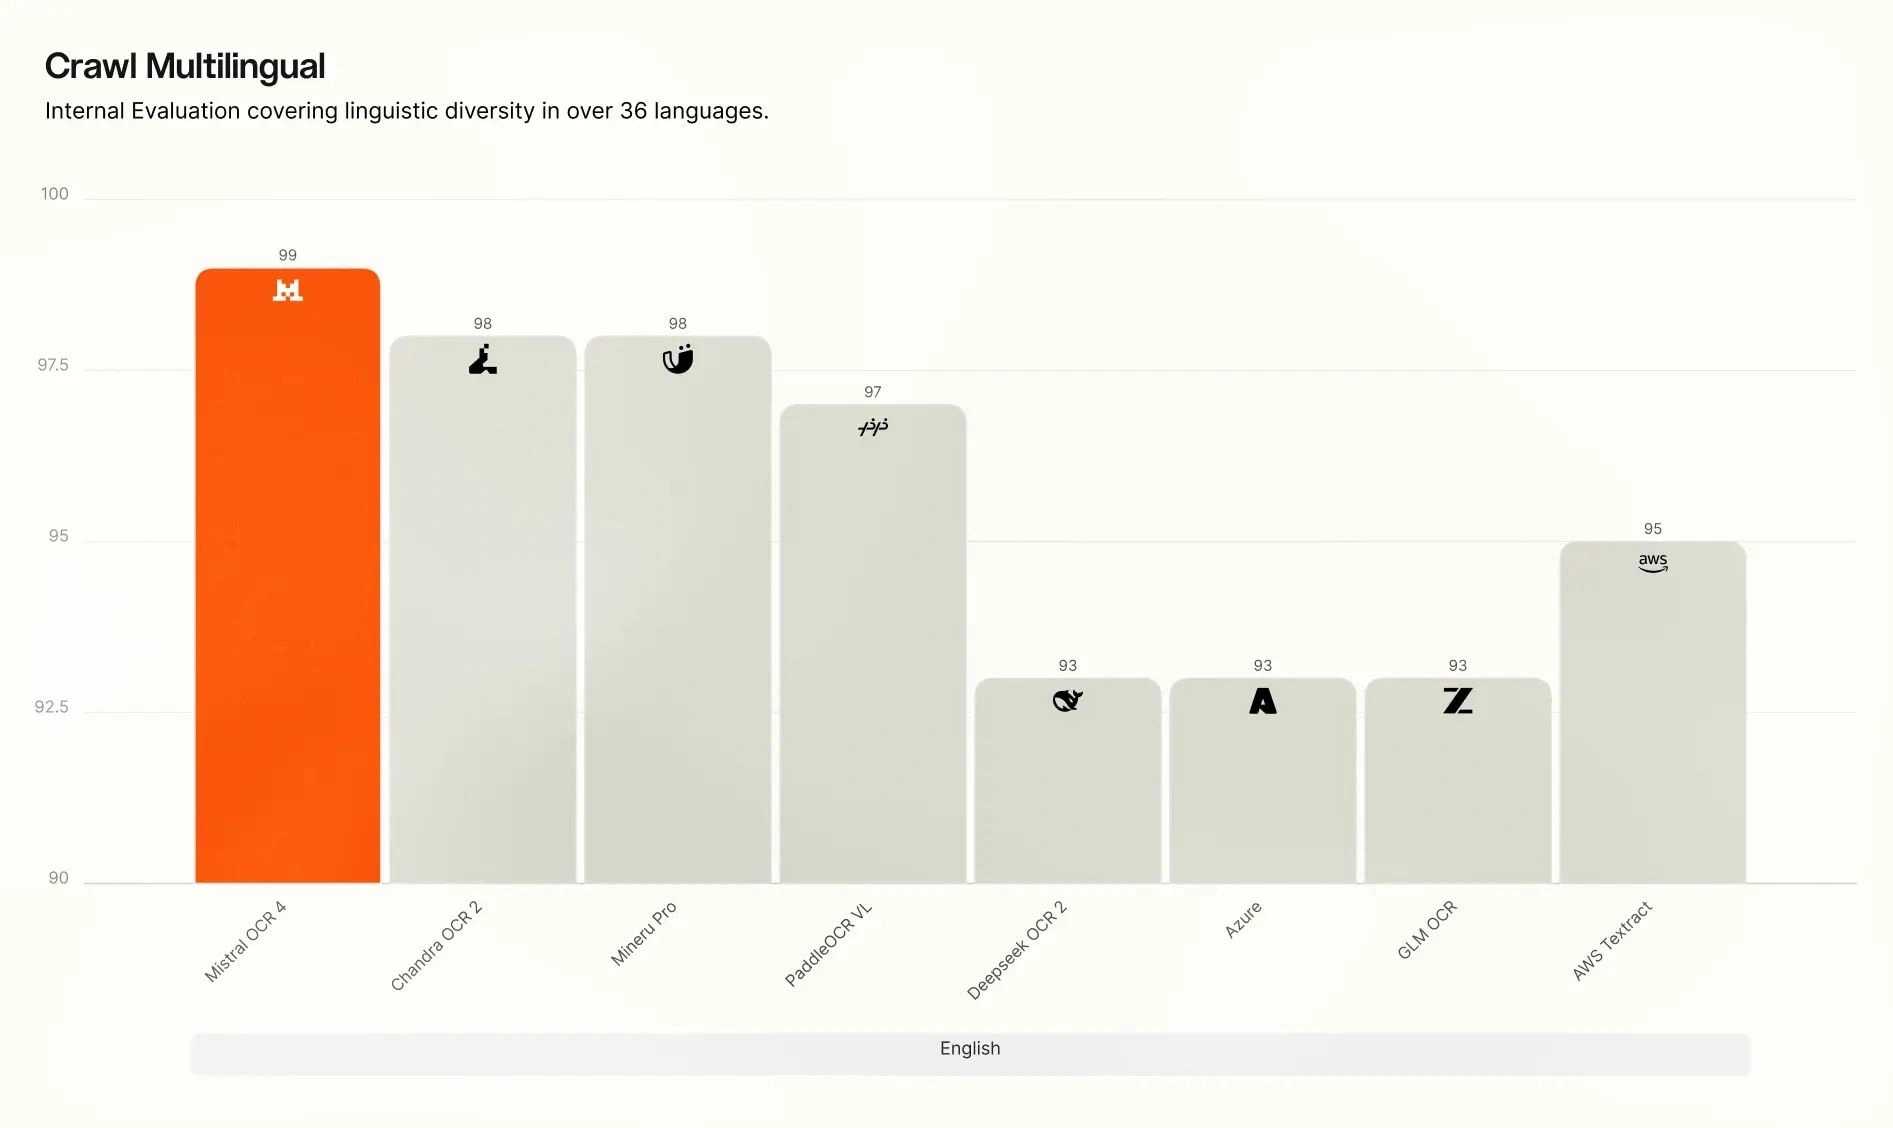
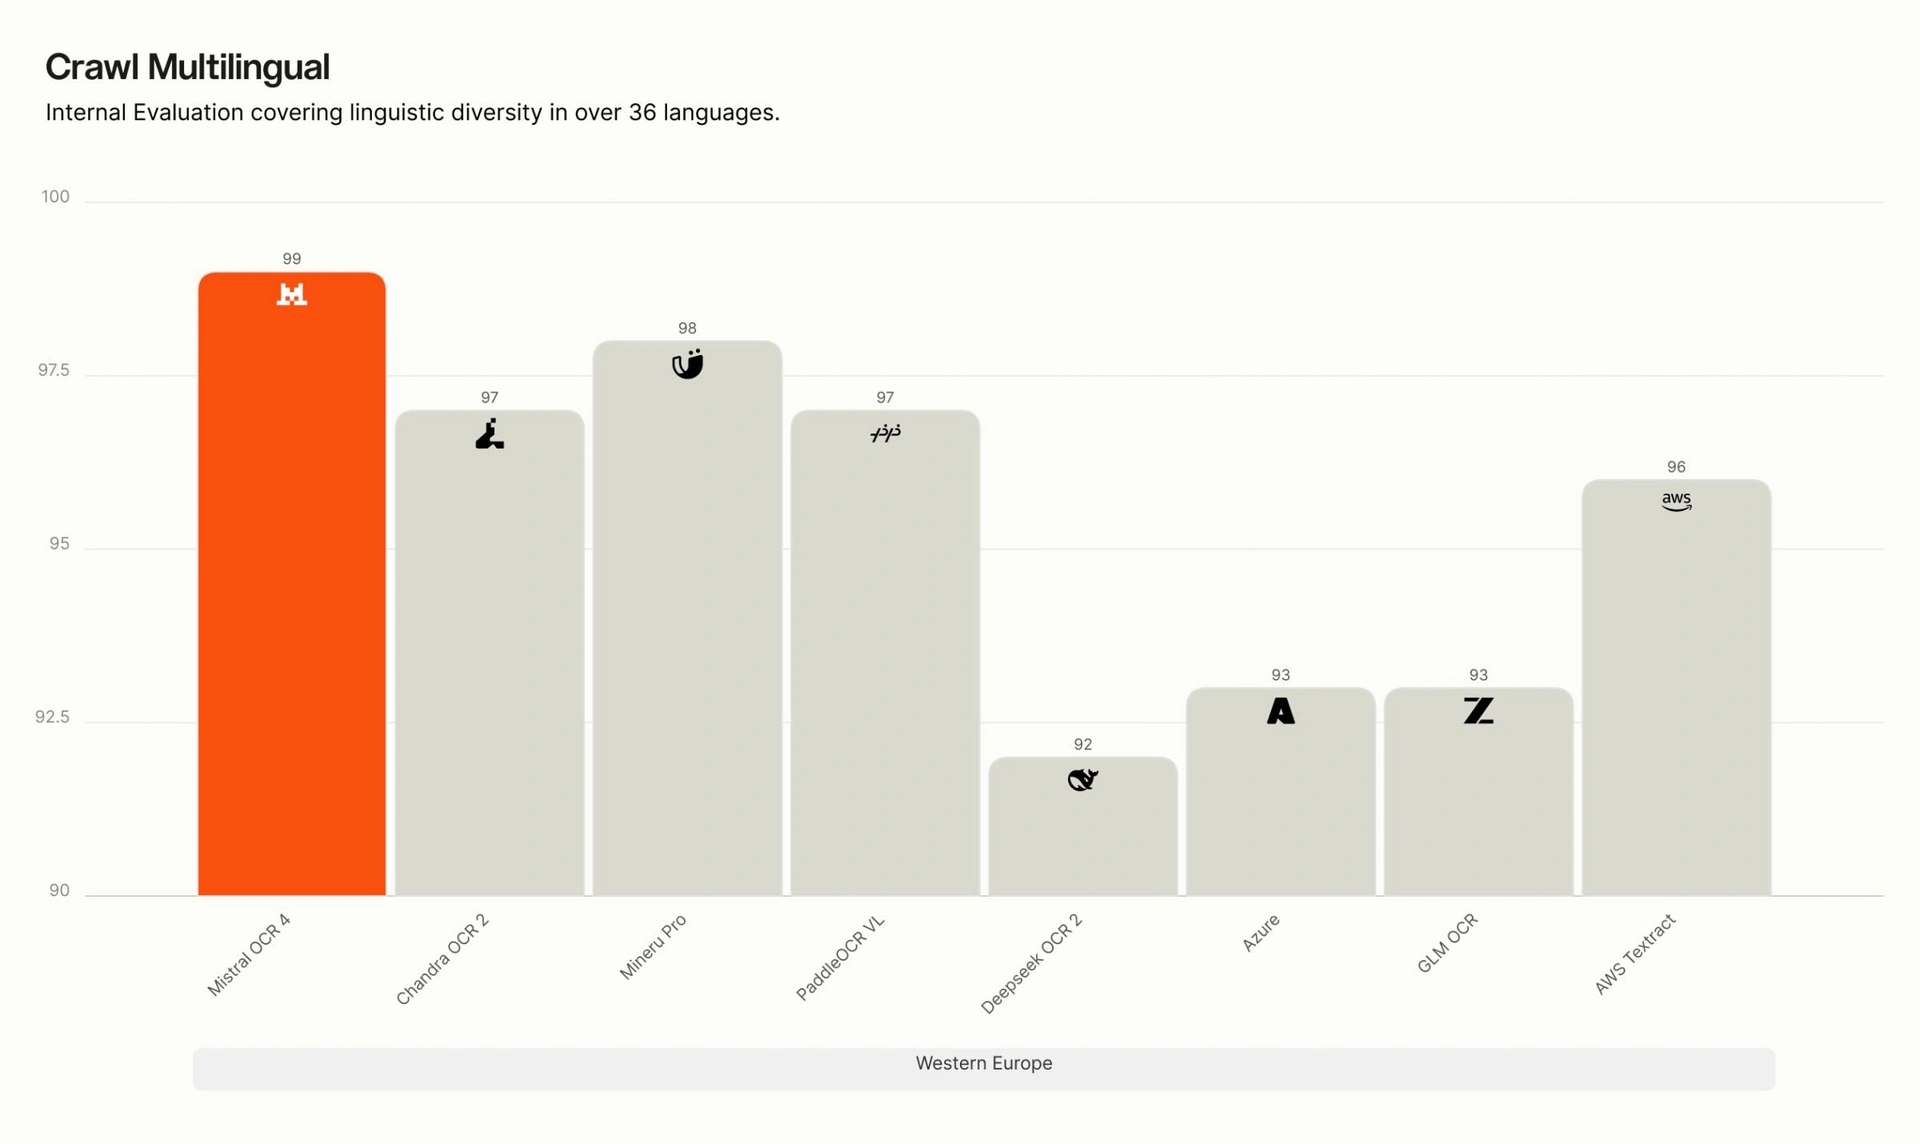
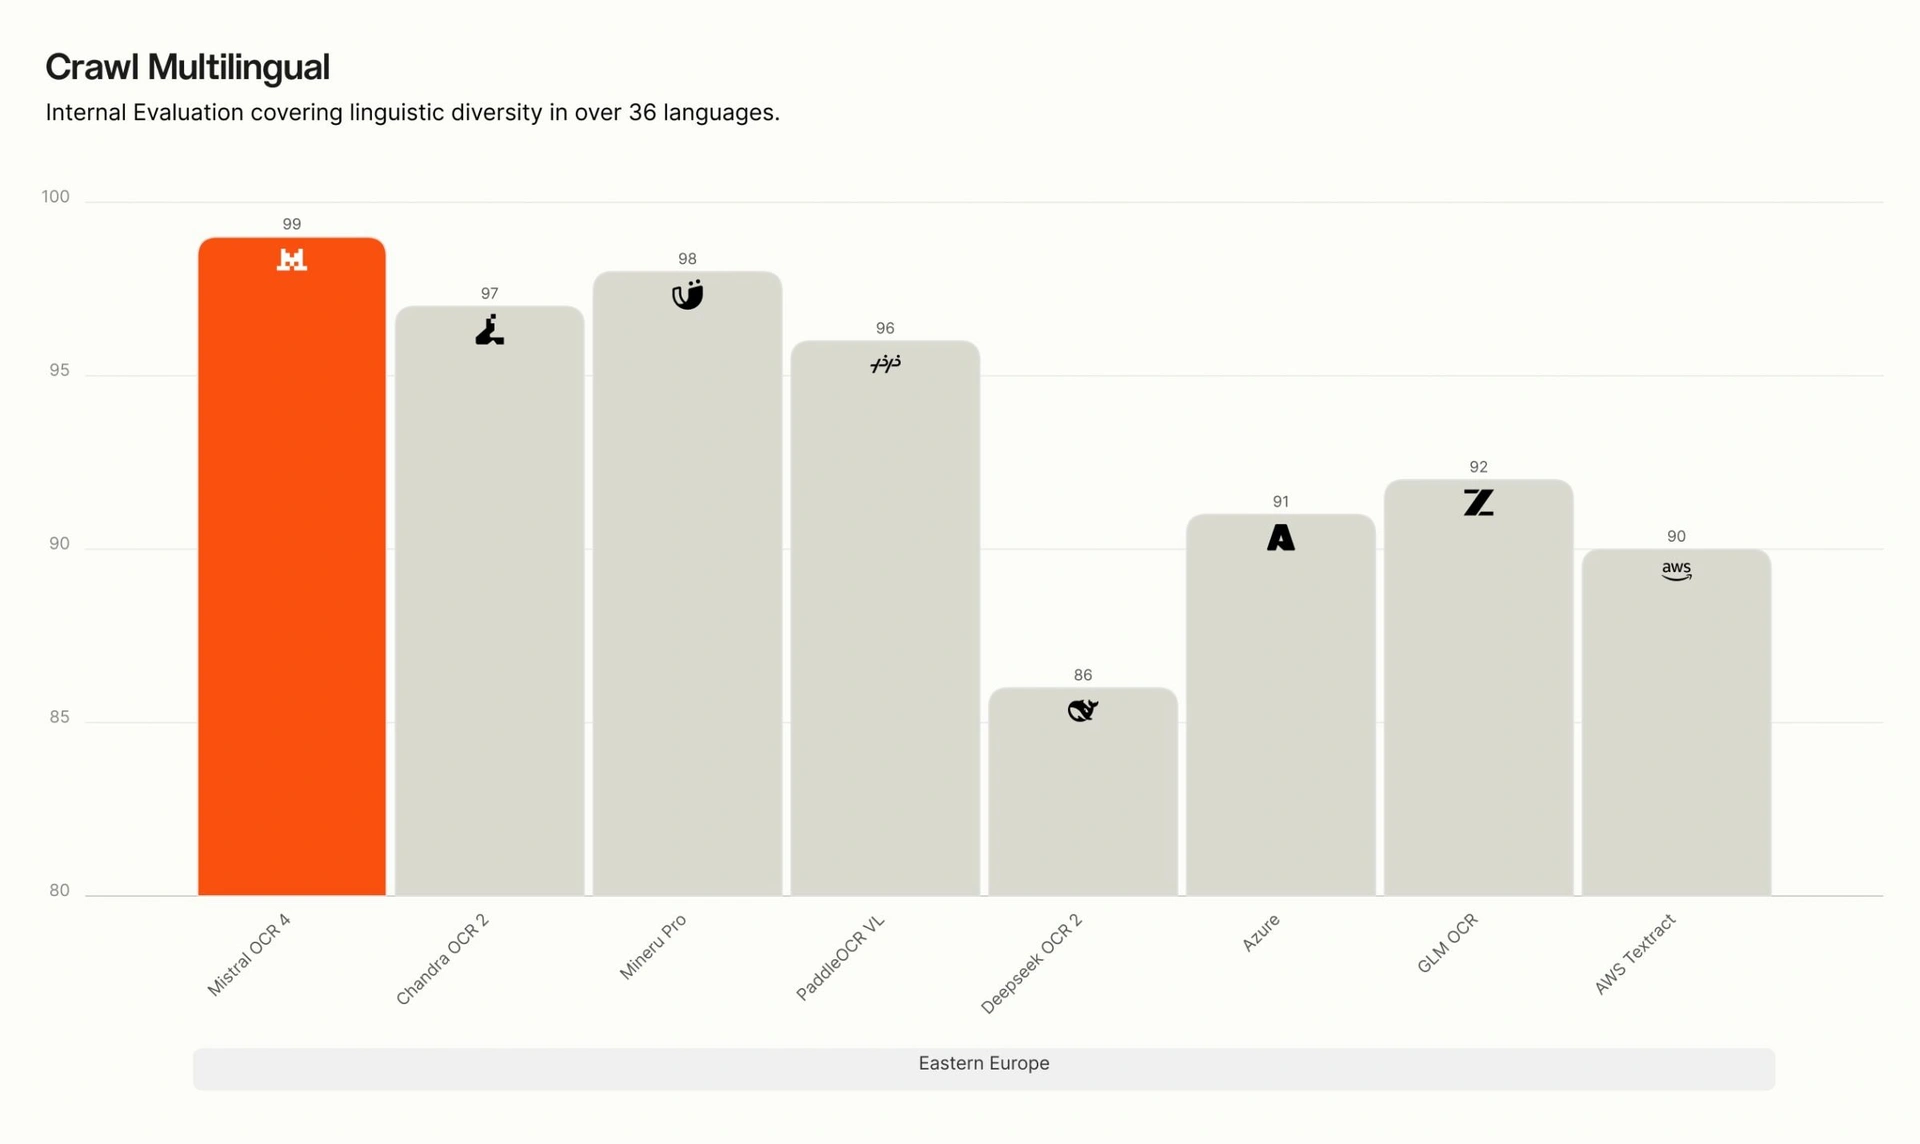
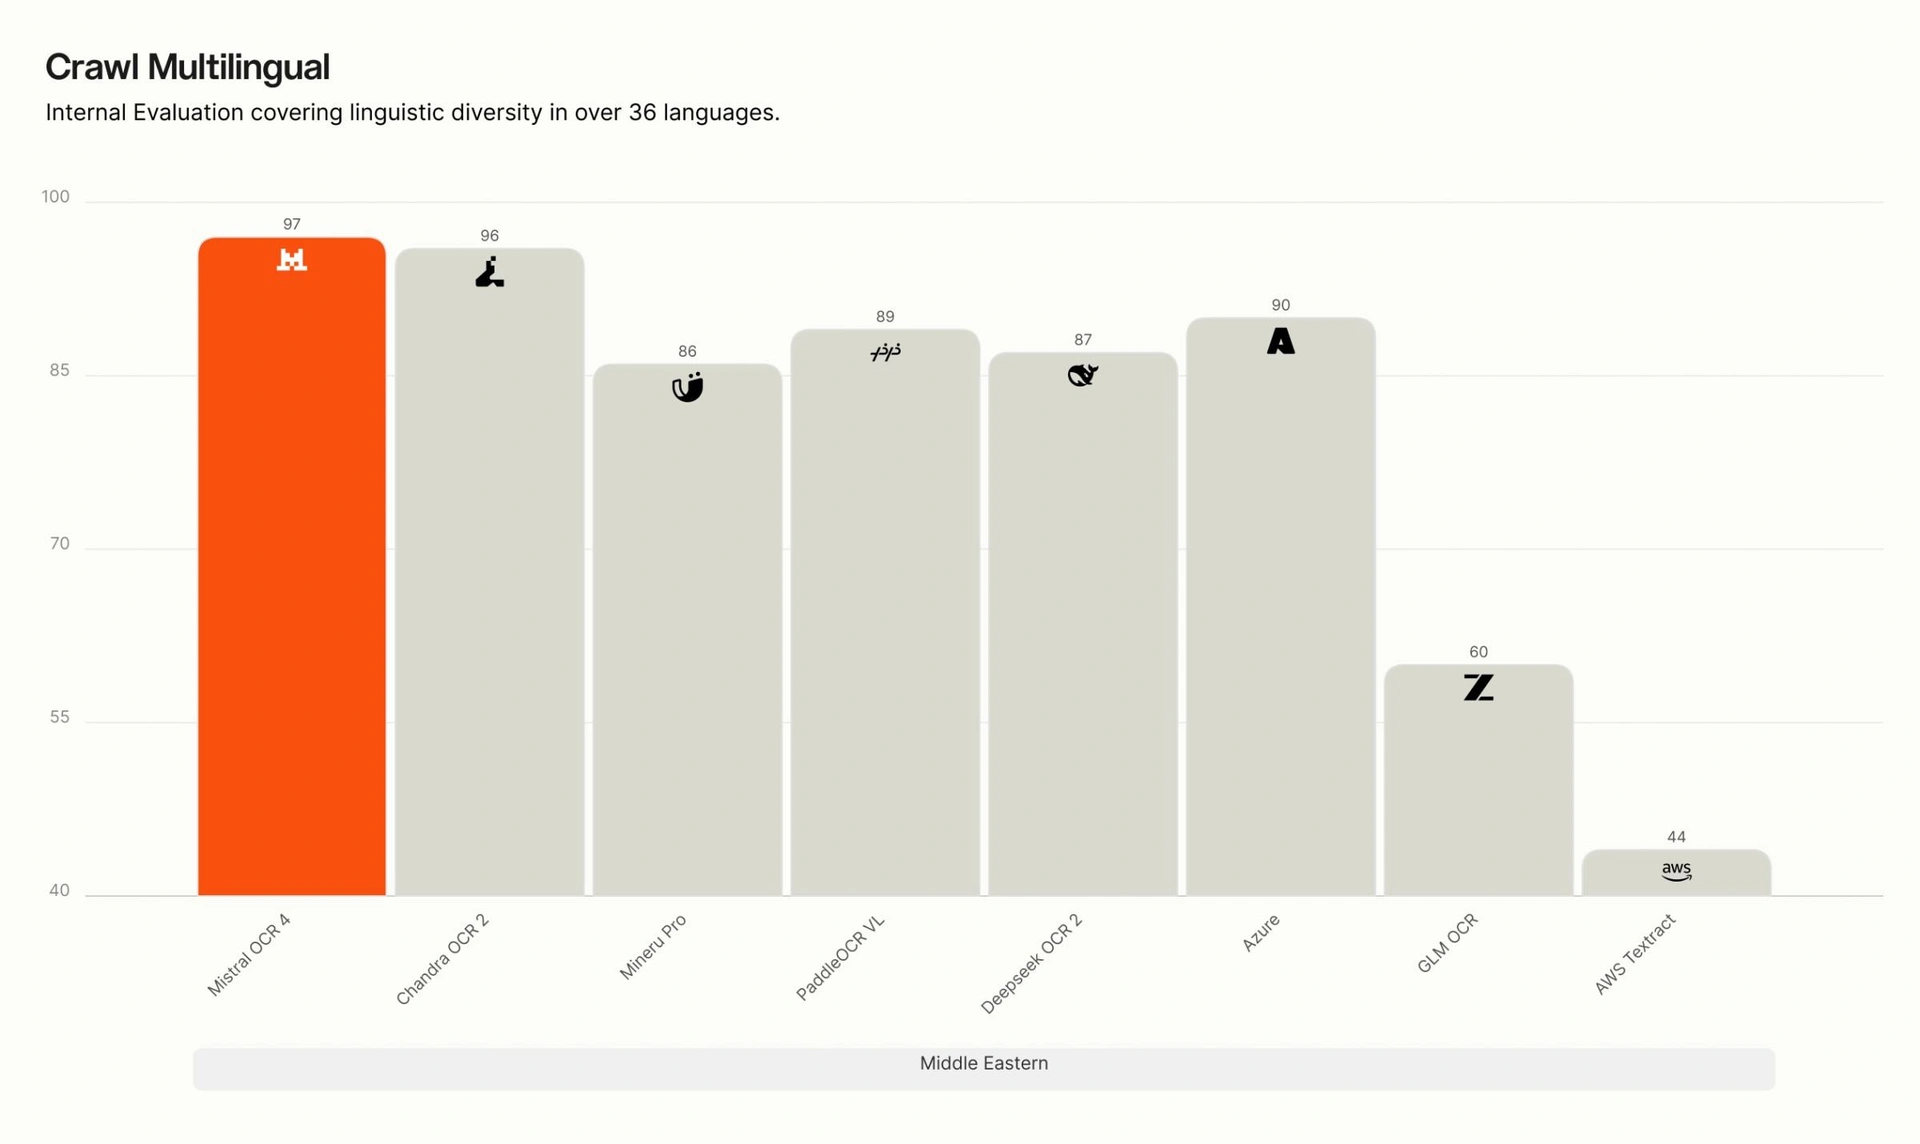
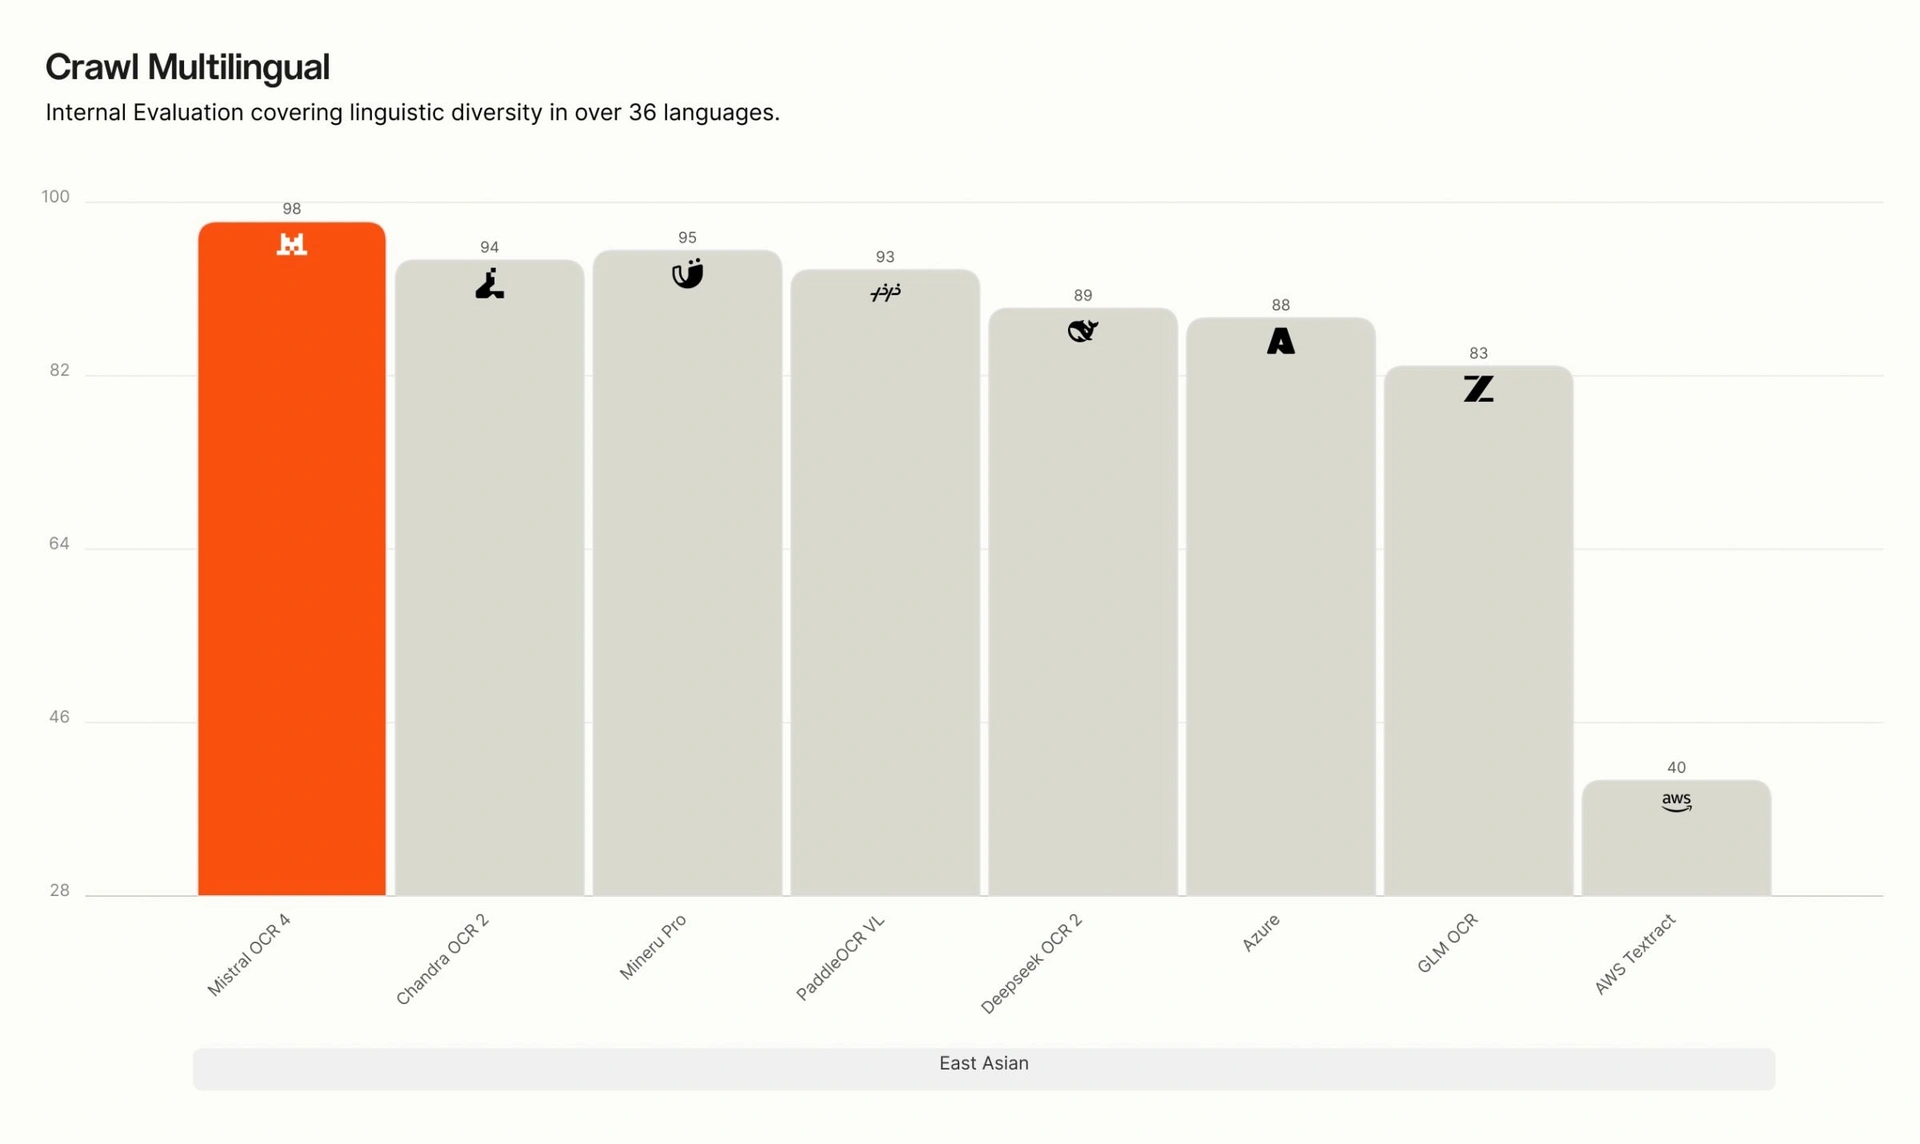
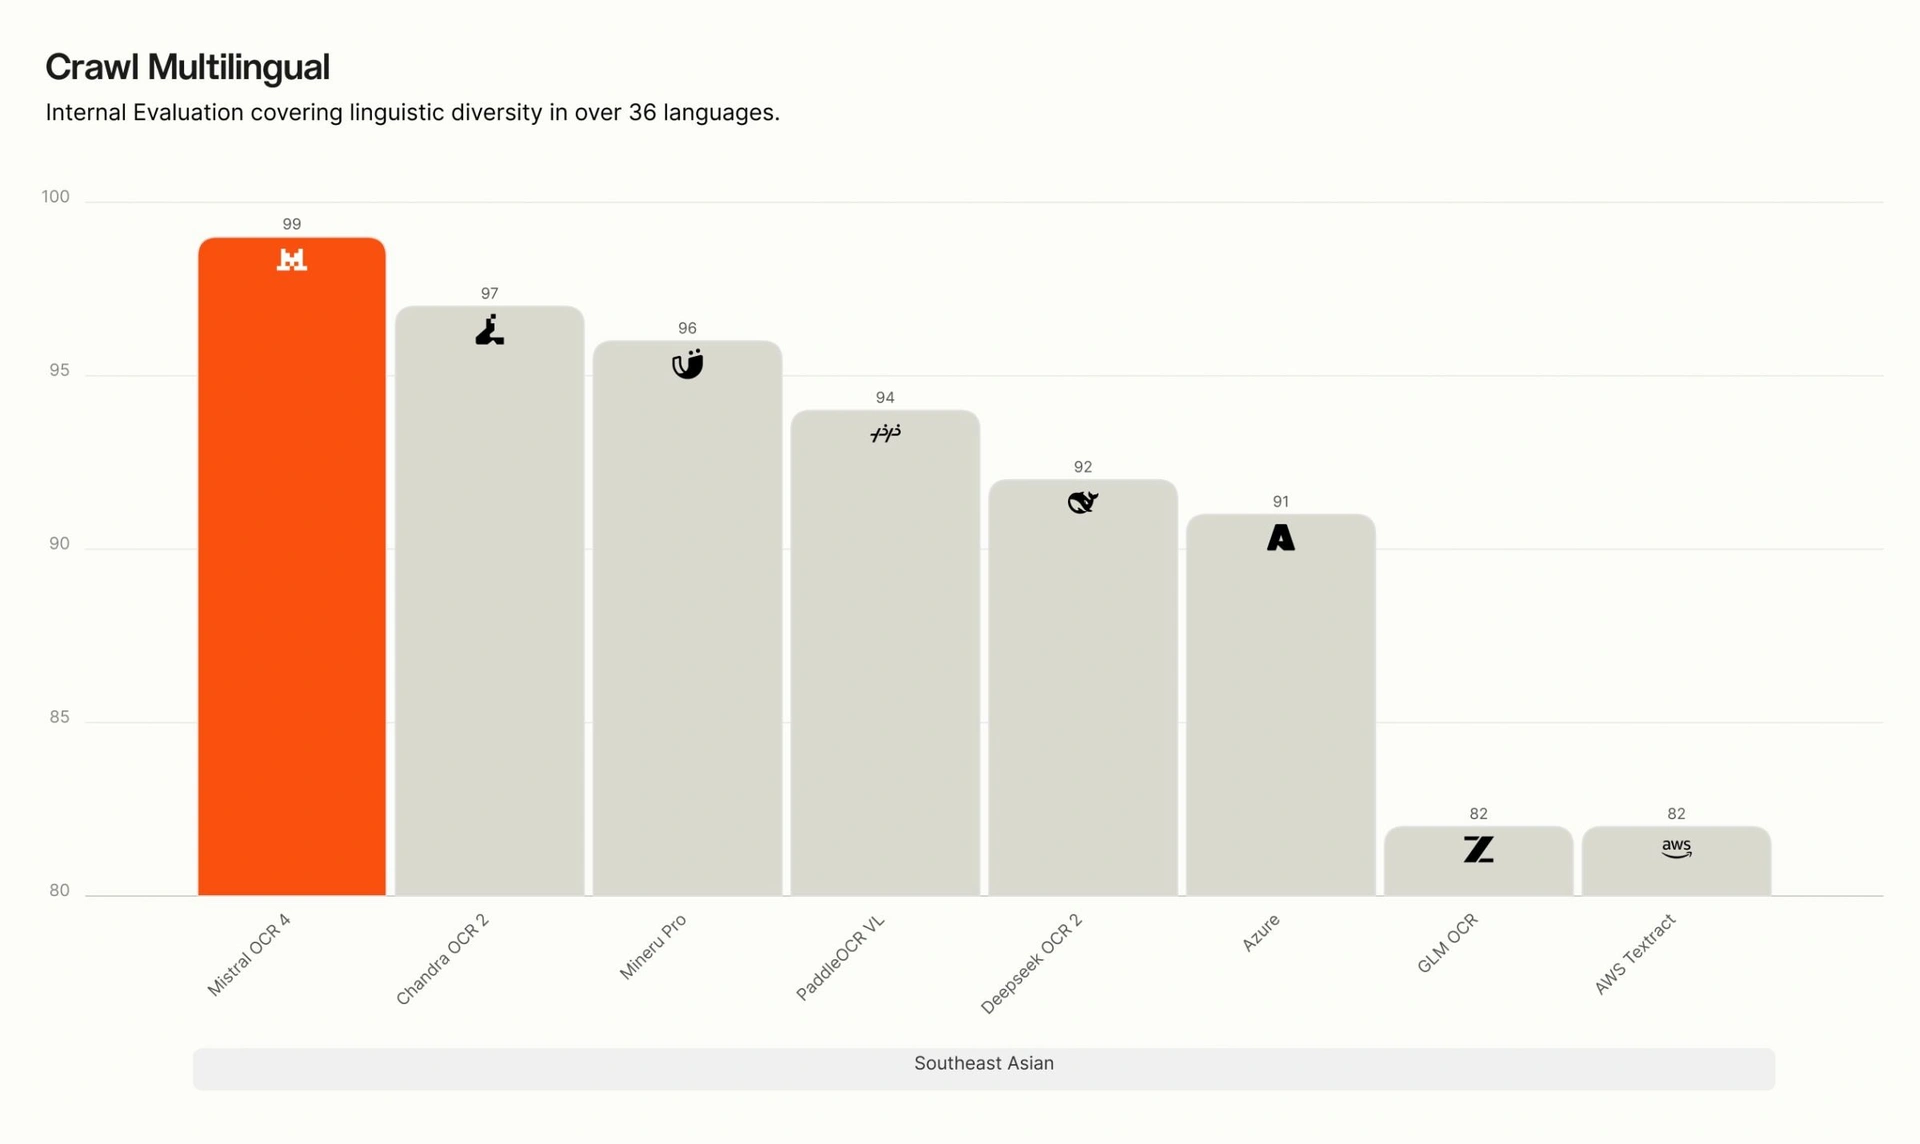
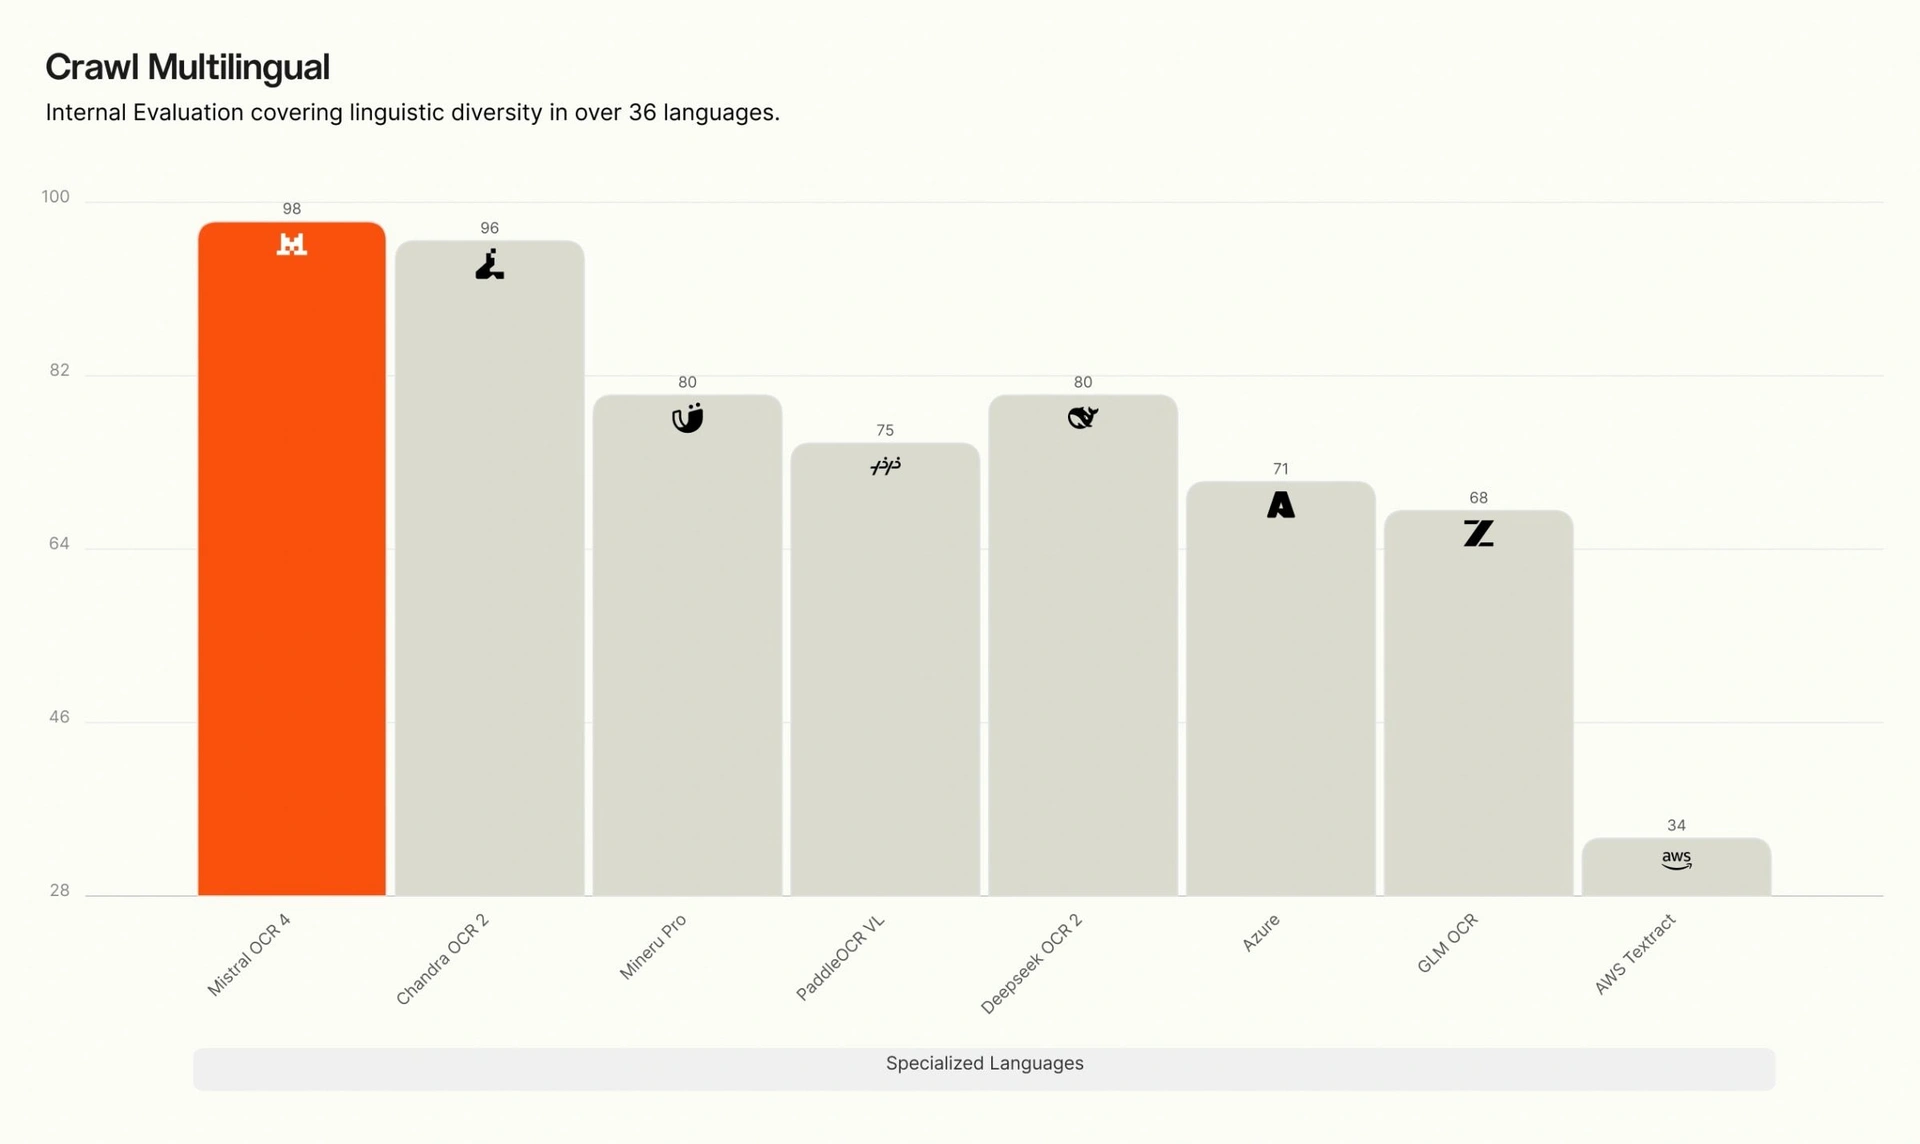
除了在人类偏好评估中排名第一之外,OCR 4 在公开的 OlmOCRBench(85.20)上还取得了我们所测模型中的最高总分,并在我们内部的 Crawl Multilingual 评测(.98)中领先,超过了 AI 原生方案和企业级方案。
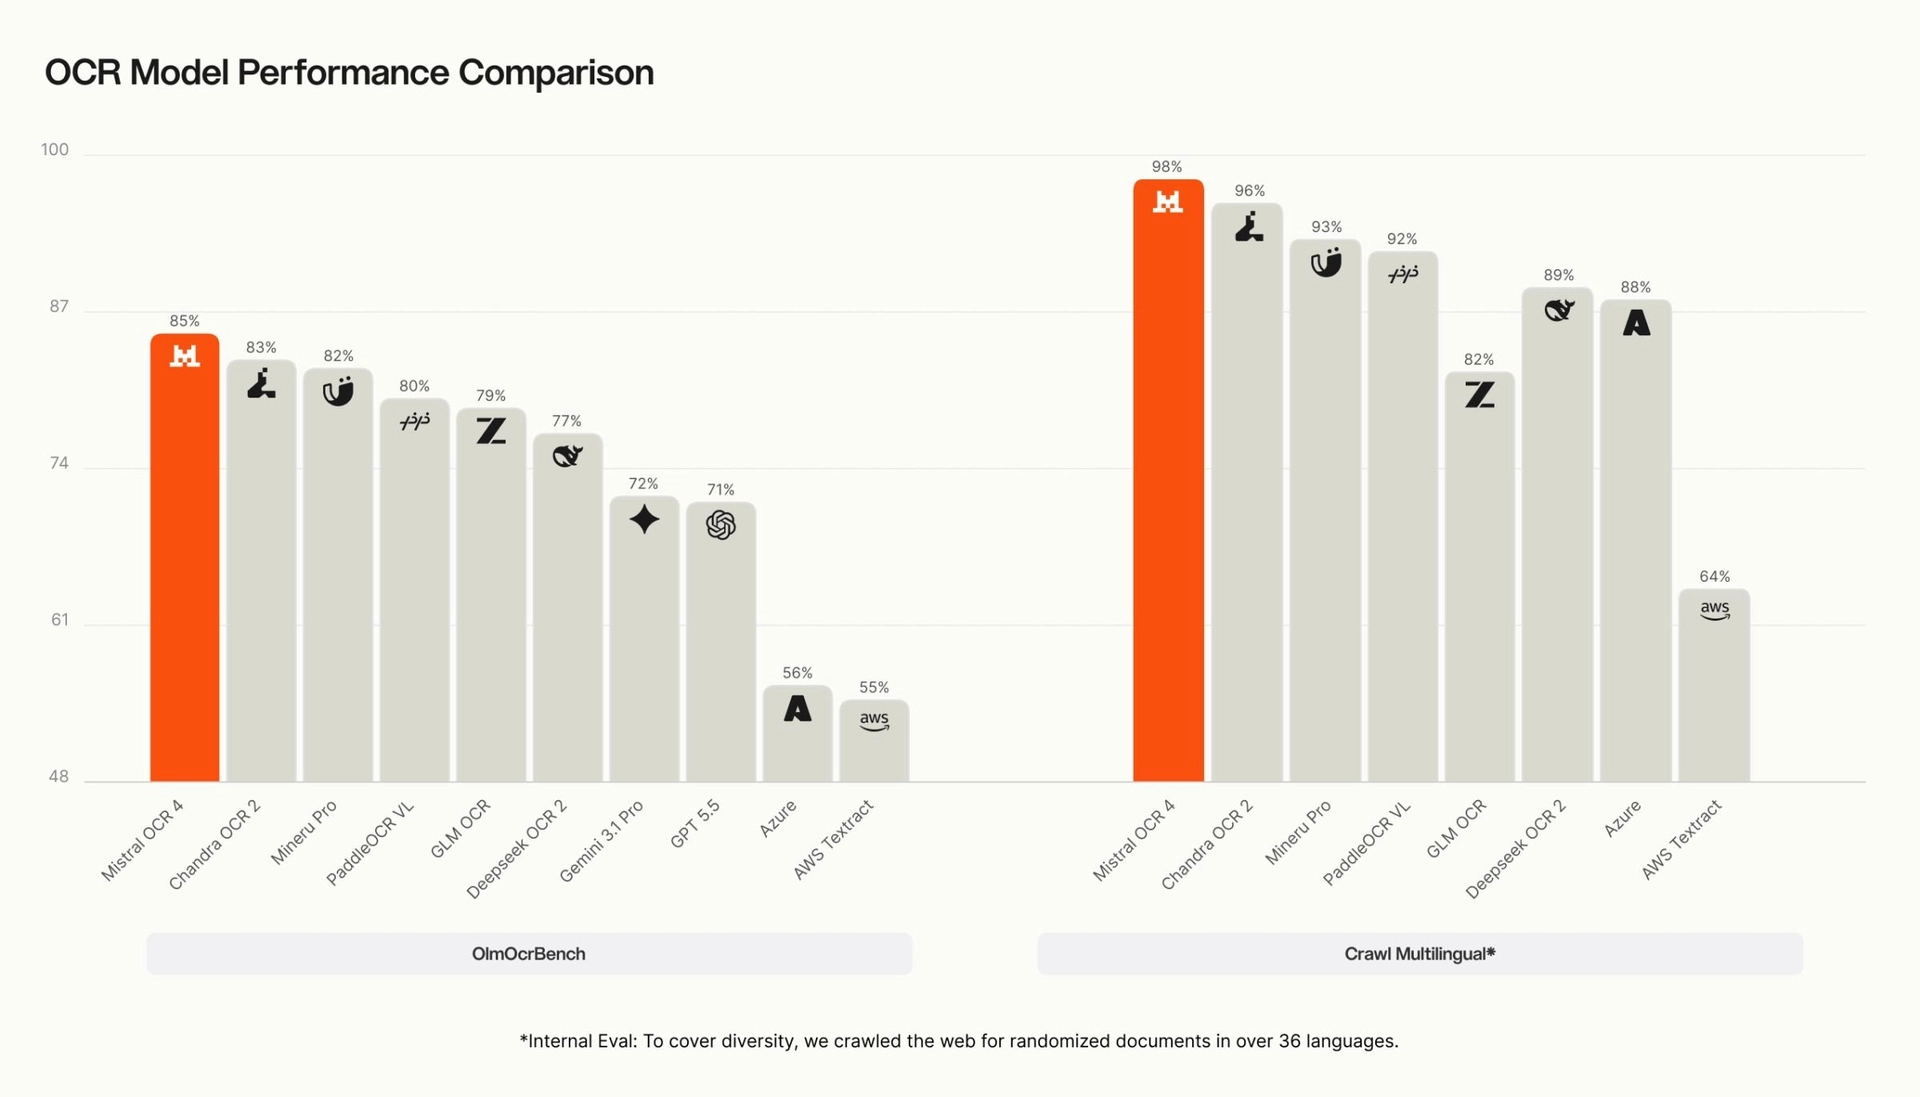
在 OmniDocBench 上,OCR 4 的得分为 93.07。我们在报告这一数字时有一点需要说明:OlmOCRBench 和 OmniDocBench 在对某些输出的评分方式上都存在已知局限,单一的汇总数字既可能低估也可能高估真实场景中的表现。
我们审查了得分背后的不匹配项,发现大多数并不是模型错误,而是基准测试比较输出方式所造成的偏差。反复出现的类别有:
- 标准答案错误。有些参考标注本身就是错的:文本缺失或多余、对被涂黑区域的转录,或拼写错误(例如,所引作者的姓名在参考答案中拼错了,而模型从页面上读对了)。输出与源文档一致,却仍被判为错误。
- 等价的数学记法。渲染结果相同的不同 LaTeX 写法被算作不匹配。渲染出的公式是正确的,字符串比对则不然。
- 公式分段。一个表达式是作为单个公式输出,还是拆成多个行内片段,会影响匹配结果,即使渲染出的内容完全相同,因为匹配器无法对齐这些片段。
- 多栏阅读顺序。跨栏边界被拆开的单词(例如“certifi-cates”)以及对栏序的假设,会导致正确的提取结果被判为阅读顺序错误。
- 块类型归属。该基准测试不期望输出中包含页眉/页脚。为解决这一点,我们在评分前会从输出中去掉页眉页脚。但测试随后会检查某个字符串,而这个字符串恰好也是本应保留的页面标题,于是被错误地标记为问题。
这些偏差集中在数学、科学和多栏文档中,而且更多时候是惩罚了正确的输出,而不是奖励了错误的输出。因此,我们把汇总得分视为方向性参考,而非定论。
这些基准测试仅供参考。所有竞品的得分均为内部复现的结果。我们建议您在自己的文档上进行评估。
性能详情
Crawl Multilingual 细分结果。在我们内部的多语言评测中,OCR 4 在全部八个语言组中均领先——英语、西欧、东欧、中东、中文、东亚、东南亚,以及专门语言(印地语、日语、格鲁吉亚语、孟加拉语、亚美尼亚语、希伯来语、希腊语、古吉拉特语、泰米尔语、马拉雅拉姆语、卡纳达语、泰卢固语)。差距在专门语言和低资源语言上最大,许多竞品在这些语言上性能急剧下降,而 OCR 4 仍保持高准确率。
推荐使用场景
OCR 4 既支持高吞吐量的批处理流水线,也支持交互式文档工作流,典型场景包括:
- 文档解析与提取:复杂的多语言文档。
- 检索增强生成(RAG):提供结构化、已分类、可直接引用的内容,用于语义分块和有据可依的回答。借助 Search Toolkit,OCR 4 的输出可以直接接入检索流水线。
- 智能体工作流:为智能体提供结构化的基础能力,使其能够完成表单填写、发票处理和合规检查等任务,尤其适用于法律、金融服务和医疗领域。
- 利用置信度分数、高效调度人工审核的结构化数据流水线:表单/发票提取、内容涂黑(redaction)以及合规驱动的流程。
- 企业搜索与知识库:将 OCR 作为数据源组件,用于自定义数据摄取和实体抽取。
早期用户已将 OCR 4 用于把发票转成结构化字段、将企业档案数字化、从技术和科学报告中提取干净的文本,以及支撑企业搜索。
关于超出适用范围的用法。OCR 4 是一个文档理解模型,而不是决策者。它不适用于医疗诊断、法律建议或判断、高风险的金融决策、安全关键系统、实时/对延迟敏感的处理,也不适用于非文档输入(原始音频、视频等)。
OCR 4 API:了解你的选择
Mistral 的 OCR 4 通过单一 API 端点提供。每个请求运行的都是同一个底层 OCR 模型,并且始终返回提取的内容、边界框、块类型、置信度分数以及 Markdown 结构的文本。不同之处在于你在其上叠加多少处理。
在以下情况下,使用纯提取模式的 OCR 4:
- 将快速、准确的文档提取直接嵌入你的应用、智能体或数据流水线。
- 直接使用原始响应、边界框、块类型和置信度分数,驱动自定义的下游逻辑。
- 通过 Batch API 运行大批量或批量摄取任务,完全掌控吞吐量和成本。
- 在有严格数据隐私、主权或合规要求时自行托管部署。
在以下情况下,启用 Document AI 能力(同一端点,附加参数):
- 按你定义的 schema 返回结构化 JSON——将 JSON schema 与文档一起传入,OCR 输出会交给
mistral-small-2603生成符合你要求的内容。 - 传入图像标注 schema,为检测到的图像生成结构化 JSON 标注,每张图像会额外触发一次视觉语言模型调用。
- 将自定义提示词与 JSON schema 搭配使用,引导模型如何解读或总结整份文档提取出的内容。
- 让业务人员、解决方案团队或试点项目无需编写下游解析逻辑,就能产出结构化结果。
实用的决策规则是:如果你需要原始的提取内容,直接使用 OCR 4 即可;如果你需要把输出重塑为结构化格式、加上特定领域的字段标注,或按自定义指令处理,就在同一次调用中加入 Document AI 参数。无论如何你都会得到 OCR 结果,Document AI 只是在其之上增加了结构化的层。
现已上线
“Mistral Document AI 搭载 OCR 4 登陆 Microsoft Foundry,是我们合作关系中的一个重要里程碑。我们携手让客户能够把先进的结构化文档理解能力直接带入其 AI 工作流,将 Mistral 的创新与 Microsoft 的企业级平台结合起来,为真实的业务需求提供可扩展且值得信赖的解决方案。”
——Kimmi Grewal,Microsoft AI 生态合作伙伴关系副总裁
Mistral OCRv4 和 Document AI(由 OCRv4 驱动)均可通过 API 在 Mistral Studio、Amazon SageMaker、Microsoft Foundry 使用,Snowflake Parse Document 也即将上线。对于有严格数据隐私要求的组织,OCR 4 还提供自托管选项,让敏感信息始终留在你自己的基础设施内。如需了解自行部署,请联系我们。
快速上手
我们提供几种方式,帮助你更快上手和了解更多。
- 试用 OCR 4。全新的 OCR 4 入门 Cookbook 会带你完成首次提取、边界框的使用以及块分类。
- OCR 4 网络研讨会。我们将在 7 月 7 日欧洲中部时间下午 6:00 介绍 OCR 4 的新变化,并提供演示和问答(Q&A)环节。注册 OCR4 in Production 网络研讨会。
- 联系销售了解更多信息。
OCR 4.1
新
全球最好的文档提取与理解模型。
OCR
多模态
文本到文本
OCR
$4
/ 1000 页
Document AI
$5
/ 1000 页