Model Context Protocol(MCP)是一项用于将 AI 智能体连接到外部系统的开放标准。传统上,把智能体连接到工具和数据,每一对组合都需要定制集成,这会造成碎片化和重复劳动,让真正互联的系统难以规模化。MCP 提供了一套通用协议:开发者只需在智能体中实现一次 MCP,就能解锁整个集成生态。
自 2024 年 11 月推出 MCP 以来,采用速度很快:社区已构建了数千个 MCP 服务器,所有主流编程语言都有可用的 SDK,业界也已把 MCP 当作连接智能体与工具和数据的事实标准。
如今,开发者经常构建能够访问数百乃至数千个工具、横跨数十个 MCP 服务器的智能体。然而,随着连接的工具越来越多,预先加载所有工具定义,并让中间结果经由上下文窗口传递,会拖慢智能体并推高成本。
在这篇博客中,我们将探讨代码执行如何让智能体更高效地与 MCP 服务器交互,在处理更多工具的同时使用更少的 token。
工具带来的过量 token 消耗会降低智能体的效率
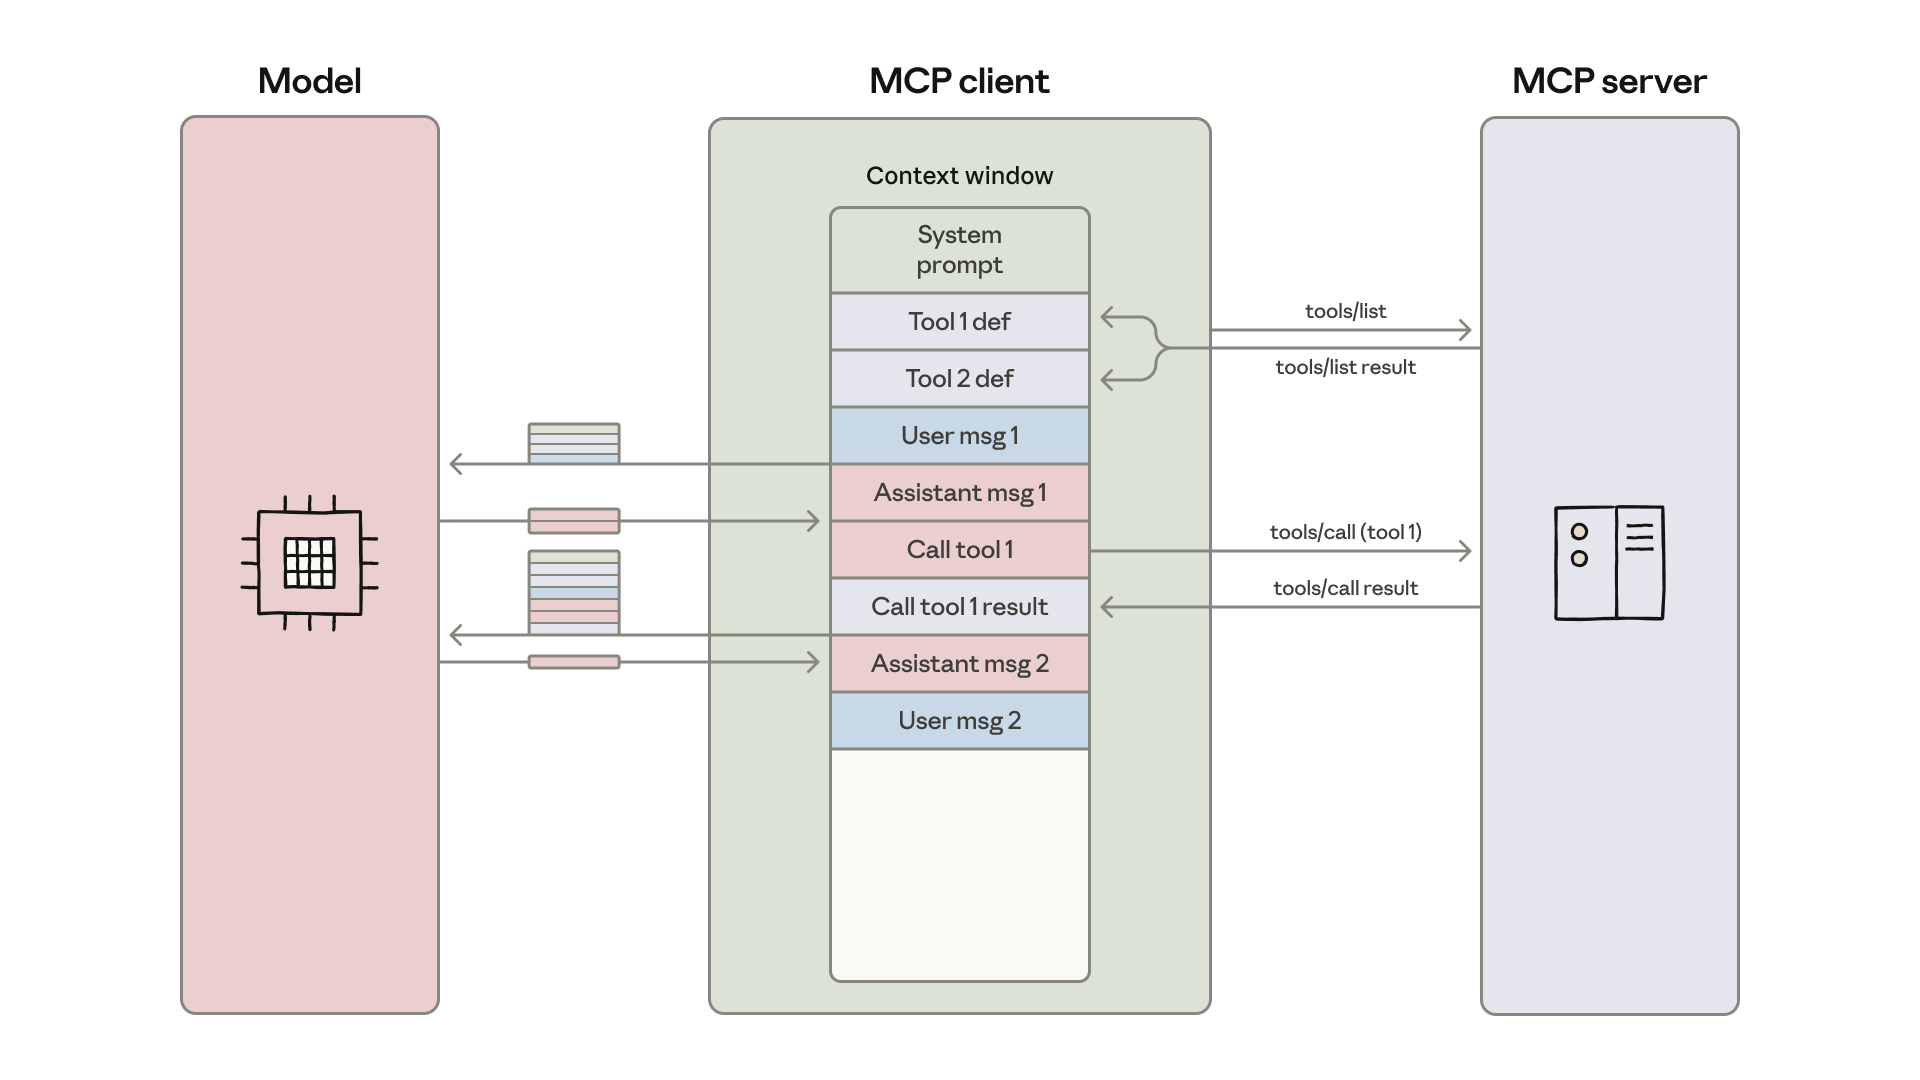
随着 MCP 使用规模扩大,有两种常见模式会增加智能体的成本和延迟:
- 工具定义使上下文窗口不堪重负;
- 中间工具结果消耗额外的 token。
1. 工具定义使上下文窗口不堪重负
大多数 MCP 客户端会把所有工具定义预先直接加载进上下文,并通过直接工具调用语法把它们暴露给模型。这些工具定义可能是这样的:
gdrive.getDocument
     Description: Retrieves a document from Google Drive
     Parameters:
                documentId (required, string): The ID of the document to retrieve
                fields (optional, string): Specific fields to return
     Returns: Document object with title, body content, metadata, permissions, etc.
salesforce.updateRecord
    Description: Updates a record in Salesforce
    Parameters:
               objectType (required, string): Type of Salesforce object (Lead, Contact,      Account, etc.)
               recordId (required, string): The ID of the record to update
               data (required, object): Fields to update with their new values
     Returns: Updated record object with confirmation
工具描述占用更多的上下文窗口空间,既增加响应时间,也推高成本。当智能体连接了数千个工具时,它在读取请求之前就需要处理数十万个 token。
2. 中间工具结果消耗额外的 token
大多数 MCP 客户端允许模型直接调用 MCP 工具。例如,你可能会让智能体:“从 Google Drive 下载我的会议记录,并把它附加到 Salesforce 的销售线索上。”
模型将发出如下调用:
TOOL CALL: gdrive.getDocument(documentId: "abc123")
        → returns "Discussed Q4 goals...\n[full transcript text]"
           (loaded into model context)

TOOL CALL: salesforce.updateRecord(
			objectType: "SalesMeeting",
			recordId: "00Q5f000001abcXYZ",
  			data: { "Notes": "Discussed Q4 goals...\n[full transcript text written out]" }
		)
		(model needs to write entire transcript into context again)
每个中间结果都必须经过模型。在这个例子中,完整的通话记录要流经模型两次。对于一场 2 小时的销售会议,这可能意味着要额外处理 50,000 个 token。更大的文档甚至可能超出上下文窗口的限制,导致工作流中断。
面对大型文档或复杂的数据结构,模型在工具调用之间复制数据时可能更容易出错。
借助 MCP 进行代码执行可提升上下文效率
随着代码执行环境在智能体中日益普遍,一种解决办法是把 MCP 服务器呈现为代码 API,而不是直接的工具调用。智能体随后可以编写代码来与 MCP 服务器交互。这种方法同时解决了上述两个难题:智能体可以只加载所需的工具,并在执行环境中处理数据后,再把结果传回模型。
实现方式有很多种。一种做法是为所连接 MCP 服务器上的所有可用工具生成一棵文件树。下面是一个使用 TypeScript 的实现:
servers
├── google-drive
│   ├── getDocument.ts
│   ├── ... (other tools)
│   └── index.ts
├── salesforce
│   ├── updateRecord.ts
│   ├── ... (other tools)
│   └── index.ts
└── ... (other servers)
这样,每个工具都对应一个文件,大致如下:
// ./servers/google-drive/getDocument.ts
import { callMCPTool } from "../../../client.js";

interface GetDocumentInput {
  documentId: string;
}

interface GetDocumentResponse {
  content: string;
}

/* Read a document from Google Drive */
export async function getDocument(input: GetDocumentInput): Promise<GetDocumentResponse> {
  return callMCPTool<GetDocumentResponse>('google_drive__get_document', input);
}
我们上面的 Google Drive 到 Salesforce 的例子就变成了这样的代码:
// Read transcript from Google Docs and add to Salesforce prospect
import * as gdrive from './servers/google-drive';
import * as salesforce from './servers/salesforce';

const transcript = (await gdrive.getDocument({ documentId: 'abc123' })).content;
await salesforce.updateRecord({
  objectType: 'SalesMeeting',
  recordId: '00Q5f000001abcXYZ',
  data: { Notes: transcript }
});
智能体通过浏览文件系统来发现工具:列出 ./servers/ 目录以找到可用的服务器(如 google-drive 和 salesforce),然后读取所需的具体工具文件(如 getDocument.ts 和 updateRecord.ts),以了解每个工具的接口。这样智能体就只需加载当前任务所需的定义。token 用量因此从 150,000 降到 2,000,节省了 98.7% 的时间和成本。
Cloudflare 发布了类似的发现,把借助 MCP 的代码执行称为“Code Mode”。其核心洞见是一致的:LLM 擅长编写代码,开发者应当发挥这一长处,构建能更高效地与 MCP 服务器交互的智能体。
借助 MCP 进行代码执行的好处
借助 MCP 进行代码执行,可以让智能体更高效地利用上下文:按需加载工具,在数据到达模型之前先行过滤,并在单个步骤中执行复杂逻辑。采用这种方法在安全和状态管理方面也有好处。
渐进式披露
模型很擅长浏览文件系统。把工具以代码的形式呈现在文件系统上,模型就可以按需读取工具定义,而不必一次性全部读完。
另一种做法是在服务器上增加一个 search_tools 工具来查找相关定义。例如,在使用上文假设的 Salesforce 服务器时,智能体搜索“salesforce”,只加载当前任务需要的那些工具。在 search_tools 工具中加入一个详细程度参数,让智能体选择所需的细节层级(如仅名称、名称加描述,或带 schema 的完整定义),也有助于智能体节省上下文并高效地找到工具。
上下文高效的工具结果
处理大型数据集时,智能体可以先在代码中过滤和转换结果,再返回。比如获取一个有 10,000 行的电子表格:
// Without code execution - all rows flow through context
TOOL CALL: gdrive.getSheet(sheetId: 'abc123')
        → returns 10,000 rows in context to filter manually

// With code execution - filter in the execution environment
const allRows = await gdrive.getSheet({ sheetId: 'abc123' });
const pendingOrders = allRows.filter(row =>
  row["Status"] === 'pending'
);
console.log(`Found ${pendingOrders.length} pending orders`);
console.log(pendingOrders.slice(0, 5)); // Only log first 5 for review
智能体看到的是五行,而不是 10,000 行。类似的模式同样适用于聚合、跨多个数据源的联接,或提取特定字段,而且都不会让上下文窗口膨胀。
更强大、更节省上下文的控制流
循环、条件判断和错误处理可以用熟悉的代码模式完成,而不必把一个个工具调用串联起来。例如,如果你需要在 Slack 中收到部署通知,智能体可以这样写:
let found = false;
while (!found) {
  const messages = await slack.getChannelHistory({ channel: 'C123456' });
  found = messages.some(m => m.text.includes('deployment complete'));
  if (!found) await new Promise(r => setTimeout(r, 5000));
}
console.log('Deployment notification received');
这种方法比通过智能体循环在 MCP 工具调用和 sleep 命令之间来回切换更高效。
此外,能够写出一棵可被执行的条件树,也能节省“首个 token 时间”(time to first token)延迟:智能体不必等待模型去评估一条 if 语句,而是可以交给代码执行环境来完成。
保护隐私的操作
当智能体借助 MCP 使用代码执行时,中间结果默认保留在执行环境中。这样,智能体只能看到你明确记录或返回的内容,也就是说,你不希望与模型共享的数据可以在工作流中流转,而不会进入模型的上下文。
对于更敏感的工作负载,智能体运行框架(agent harness)可以自动对敏感数据进行令牌化。例如,假设你需要把电子表格中的客户联系方式导入 Salesforce。智能体会这样写:
const sheet = await gdrive.getSheet({ sheetId: 'abc123' });
for (const row of sheet.rows) {
  await salesforce.updateRecord({
    objectType: 'Lead',
    recordId: row.salesforceId,
    data: {
      Email: row.email,
      Phone: row.phone,
      Name: row.name
    }
  });
}
console.log(`Updated ${sheet.rows.length} leads`);
MCP 客户端会拦截数据,并在数据到达模型之前对 PII 进行令牌化:
// What the agent would see, if it logged the sheet.rows:
[
  { salesforceId: '00Q...', email: '[EMAIL_1]', phone: '[PHONE_1]', name: '[NAME_1]' },
  { salesforceId: '00Q...', email: '[EMAIL_2]', phone: '[PHONE_2]', name: '[NAME_2]' },
  ...
]
之后,当这些数据在另一次 MCP 工具调用中被共享时,会通过 MCP 客户端中的查找表还原。真实的电子邮件地址、电话号码和姓名从 Google Sheets 流向 Salesforce,却从不经过模型。这可以防止智能体意外记录或处理敏感数据。你还可以借此定义确定性的安全规则,指定数据可以流向何处、来自何处。
状态持久化与技能
具备文件系统访问能力的代码执行,让智能体能够跨操作保持状态。智能体可以把中间结果写入文件,从而恢复工作并跟踪进度:
const leads = await salesforce.query({
  query: 'SELECT Id, Email FROM Lead LIMIT 1000'
});
const csvData = leads.map(l => `${l.Id},${l.Email}`).join('\n');
await fs.writeFile('./workspace/leads.csv', csvData);

// Later execution picks up where it left off
const saved = await fs.readFile('./workspace/leads.csv', 'utf-8');
智能体还可以把自己的代码保存为可复用的函数。一旦智能体为某项任务写出了可用的代码,就可以保存这一实现以供将来使用:
// In ./skills/save-sheet-as-csv.ts
import * as gdrive from './servers/google-drive';
export async function saveSheetAsCsv(sheetId: string) {
  const data = await gdrive.getSheet({ sheetId });
  const csv = data.map(row => row.join(',')).join('\n');
  await fs.writeFile(`./workspace/sheet-${sheetId}.csv`, csv);
  return `./workspace/sheet-${sheetId}.csv`;
}

// Later, in any agent execution:
import { saveSheetAsCsv } from './skills/save-sheet-as-csv';
const csvPath = await saveSheetAsCsv('abc123');
这与技能(Skills)的概念紧密相关:技能是由可复用的指令、脚本和资源组成的文件夹,用来提升模型在专门任务上的表现。给这些已保存的函数添加一个 SKILL.md 文件,就构成了模型可以引用和使用的结构化技能。久而久之,你的智能体就能积累起一个更高层能力的工具箱,不断演进其高效工作所需的脚手架。
请注意,代码执行本身也会带来复杂性。运行智能体生成的代码,需要一个安全的执行环境,配以适当的沙箱、资源限制和监控。这些基础设施要求会带来直接工具调用所没有的运维开销和安全考量。代码执行的好处,即降低 token 成本、减少延迟和改善工具组合,应当与这些实现成本权衡。
总结
MCP 为智能体连接众多工具和系统提供了基础协议。然而,一旦连接的服务器过多,工具定义和结果可能消耗过量的 token,从而降低智能体的效率。
尽管这里的许多问题看起来很新颖,比如上下文管理、工具组合和状态持久化,但软件工程早已有了成熟的解决方案。代码执行把这些既有模式应用到智能体上,让它们借助熟悉的编程结构,更高效地与 MCP 服务器交互。如果你采用了这种方法,欢迎与 MCP 社区分享你的发现。
致谢
本文由 Adam Jones 和 Conor Kelly 撰写。感谢 Jeremy Fox、Jerome Swannack、Stuart Ritchie、Molly Vorwerck、Matt Samuels 和 Maggie Vo 对本文草稿提出的反馈。