要让 AI 模型在特定场景中发挥作用,往往需要让它获取背景知识。例如,客服聊天机器人需要了解其所服务的具体业务,法律分析机器人则需要了解大量过往案例。
开发者通常使用检索增强生成(Retrieval-Augmented Generation,RAG)来增强 AI 模型的知识。RAG 是一种从知识库中检索相关信息并将其附加到用户提示词中的方法,能显著改善模型的回复。问题在于,传统的 RAG 方案在对信息编码时会丢失上下文,这常常导致系统无法从知识库中检索到相关信息。
本文介绍一种能显著改进 RAG 检索环节的方法。该方法称为“上下文检索”(Contextual Retrieval),包含两个子技术:上下文嵌入(Contextual Embeddings)和上下文 BM25(Contextual BM25)。该方法可将检索失败的次数减少 49%,与重排序结合使用时可减少 67%。这代表检索准确率的显著提升,并将直接转化为下游任务中更好的表现。
借助我们的 cookbook,你可以轻松地用 Claude 部署自己的上下文检索方案。
关于直接使用更长提示词的说明
有时最简单的方案就是最好的。如果你的知识库小于 200,000 个 token(约 500 页材料),你可以直接把整个知识库放进提供给模型的提示词中,无需 RAG 或类似方法。
几周前,我们为 Claude 发布了提示词缓存,让这种做法显著更快、成本效益更高。开发者现在可以在 API 调用之间缓存常用的提示词,使延迟降低 > 2 倍,成本最多降低 90%(阅读我们的提示词缓存 cookbook 可了解其工作原理)。
不过,随着知识库增长,你需要一种更具扩展性的方案。这正是上下文检索的用武之地。
RAG 入门:扩展到更大的知识库
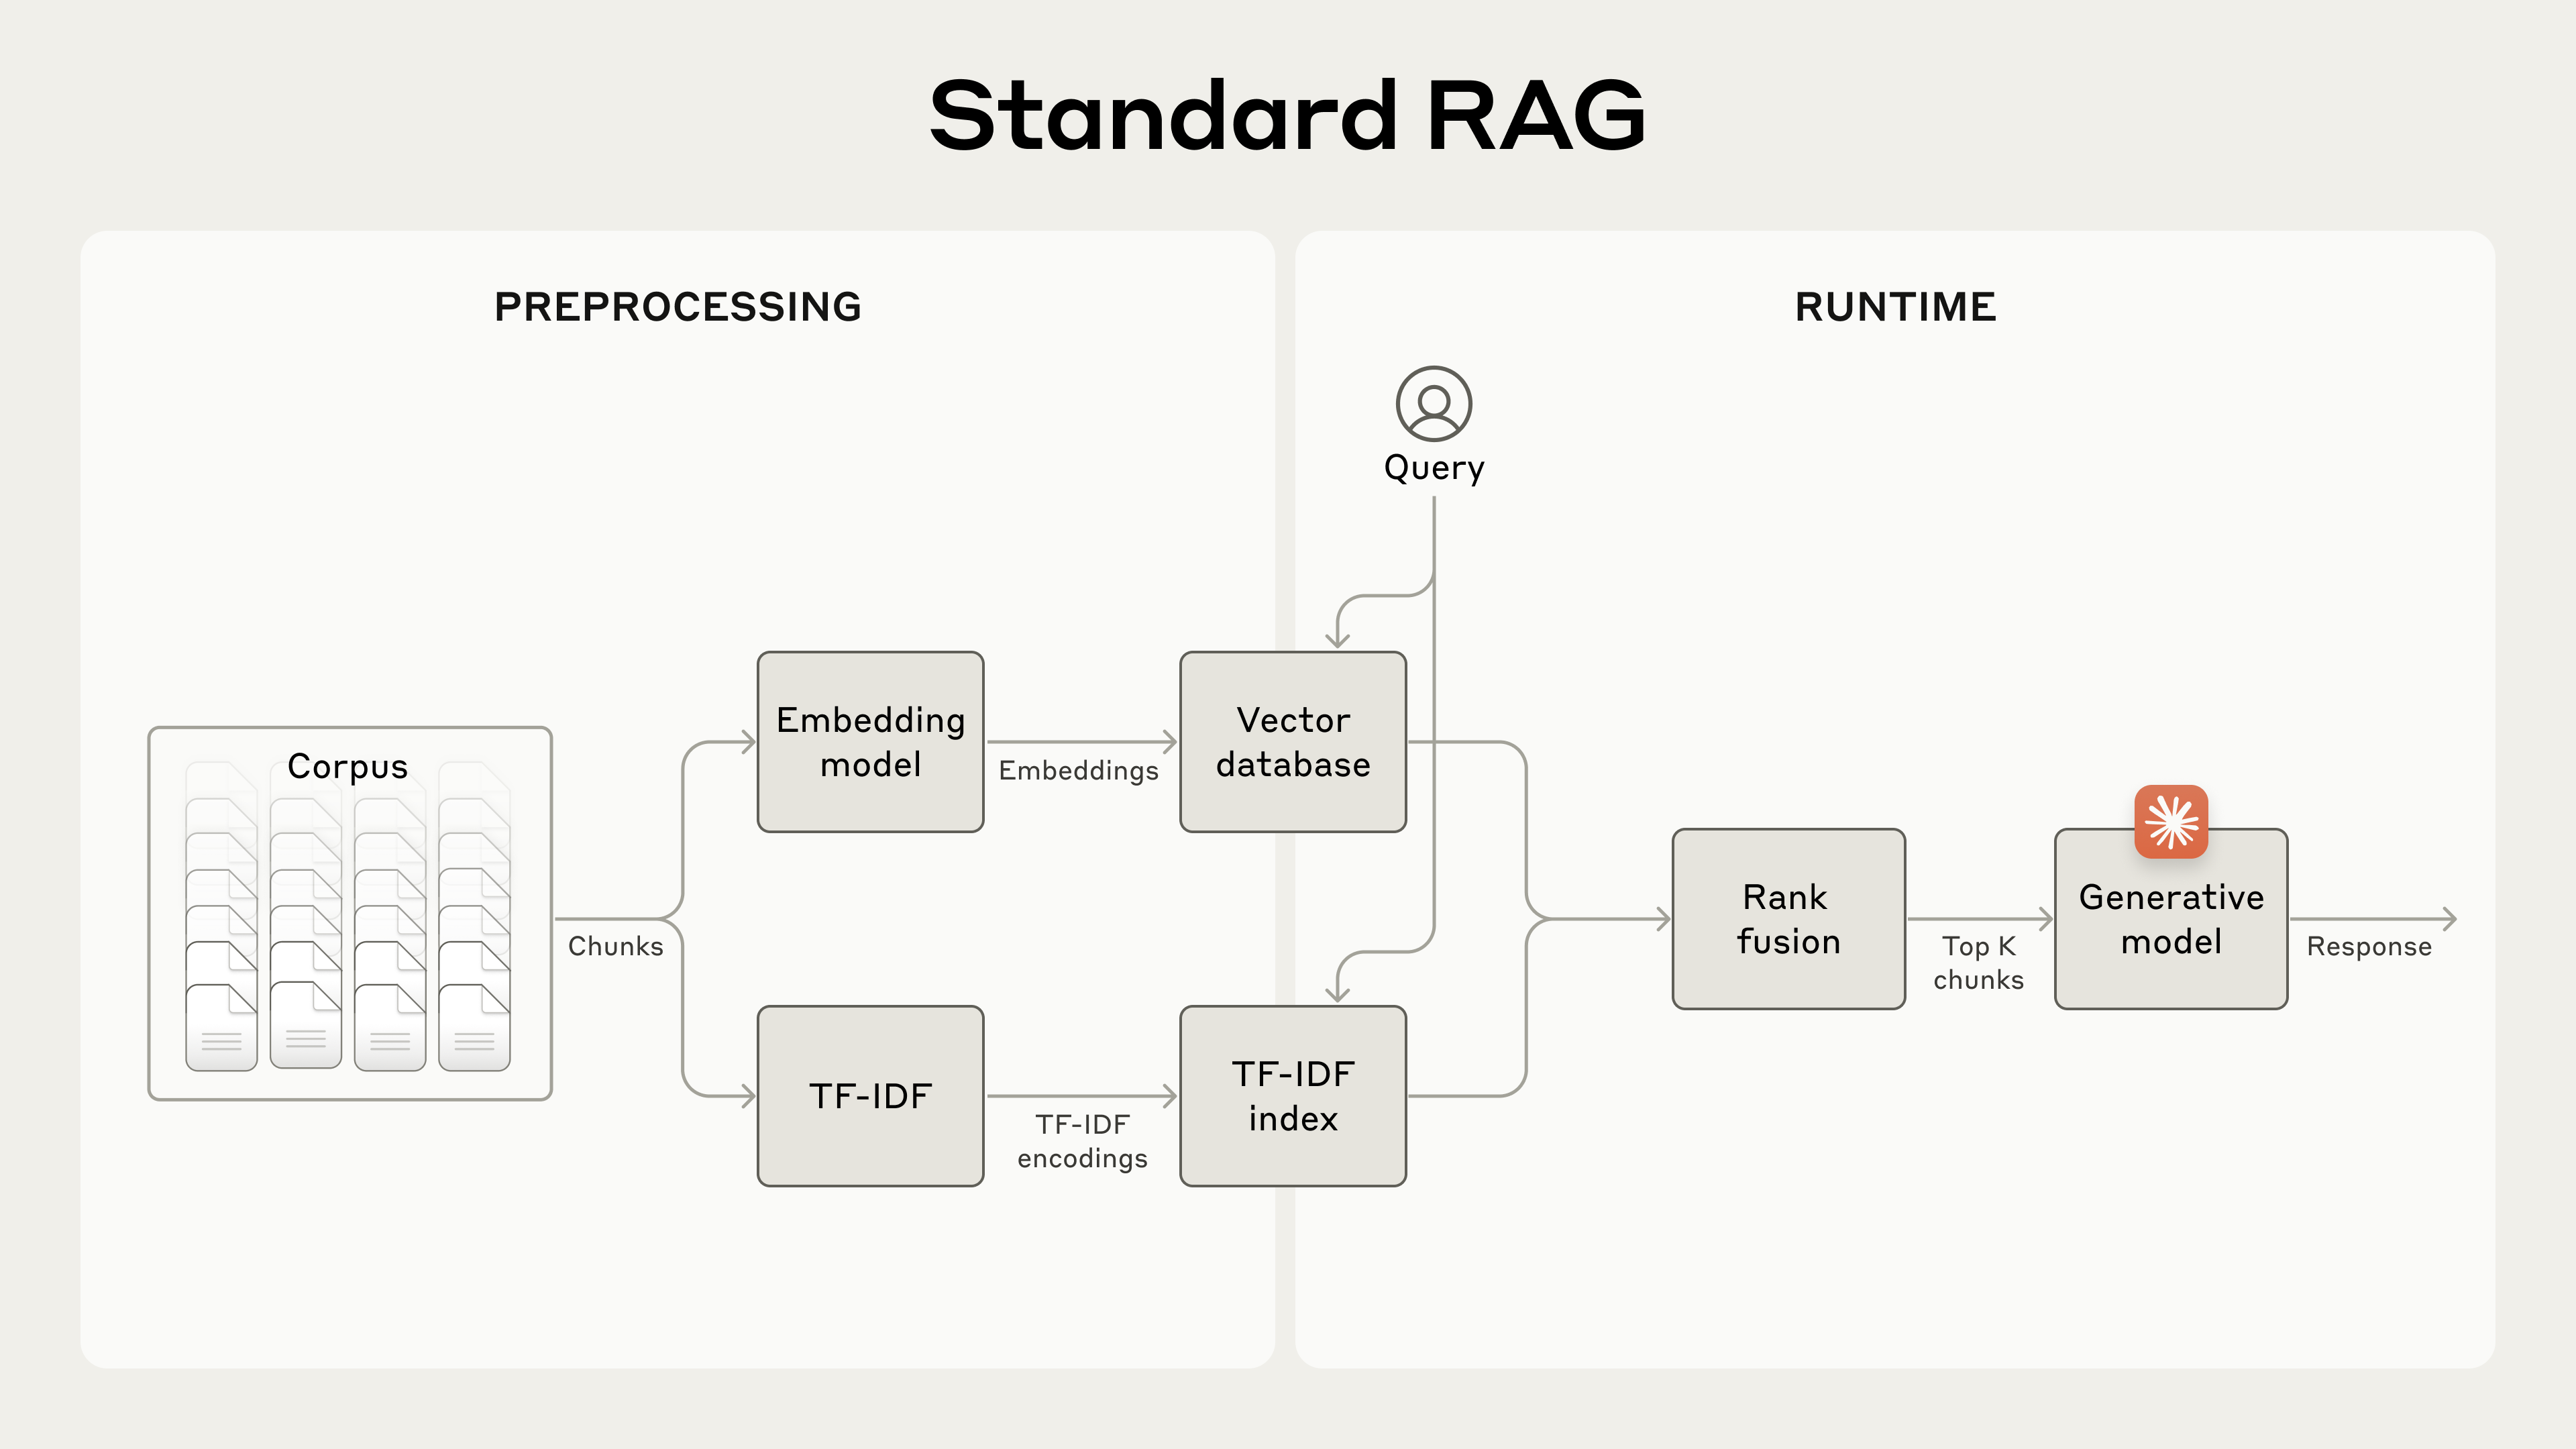
对于无法放入上下文窗口的较大知识库,RAG 是典型的解决方案。RAG 通过以下步骤对知识库进行预处理:
- 把知识库(文档的“语料库”)拆分成较小的文本块,通常每块不超过几百个 token;
- 使用嵌入模型把这些文本块转换成编码语义的向量嵌入;
- 把这些嵌入存入向量数据库,以便按语义相似度进行搜索。
运行时,当用户向模型输入查询时,向量数据库会根据与查询的语义相似度找出最相关的文本块。然后,最相关的文本块被添加到发送给生成式模型的提示词中。
嵌入模型虽然擅长捕捉语义关系,却可能漏掉关键的精确匹配。好在有一种较老的技术可以在这些情形下提供帮助。BM25(Best Matching 25)是一种排序函数,使用词汇匹配来查找精确的单词或短语匹配。它对包含唯一标识符或技术术语的查询尤其有效。
BM25 建立在 TF-IDF(词频-逆文档频率,Term Frequency-Inverse Document Frequency)概念之上。TF-IDF 衡量一个词对集合中某篇文档的重要程度。BM25 对此加以改进,考虑了文档长度,并对词频应用饱和函数,从而避免常见词主导结果。
下面说明 BM25 如何在语义嵌入失效的地方取得成功:假设用户在技术支持数据库中查询“Error code TS-999”。嵌入模型可能会找到有关错误代码的一般内容,却可能漏掉精确的“TS-999”匹配。BM25 则会查找这个特定的文本字符串,从而定位相关文档。
通过以下步骤把嵌入与 BM25 技术结合起来,RAG 方案可以更准确地检索出最适用的文本块:
- 把知识库(文档的“语料库”)拆分成较小的文本块,通常每块不超过几百个 token;
- 为这些文本块创建 TF-IDF 编码和语义嵌入;
- 使用 BM25 基于精确匹配找出排名靠前的文本块;
- 使用嵌入基于语义相似度找出排名靠前的文本块;
- 使用排名融合(rank fusion)技术合并并去重 (3) 和 (4) 的结果;
- 把前 K 个文本块添加到提示词中以生成回复。
同时利用 BM25 和嵌入模型,传统 RAG 系统可以提供更全面、更准确的结果,在精确的词项匹配与更广泛的语义理解之间取得平衡。
这种方法让你能以低成本扩展到庞大的知识库,规模远超单个提示词所能容纳的范围。但这些传统 RAG 系统有一个显著的局限:它们常常破坏上下文。
传统 RAG 中的上下文难题
在传统 RAG 中,文档通常被拆分成较小的文本块以便高效检索。虽然这种做法适用于许多应用,但当单个文本块缺乏足够的上下文时,就可能产生问题。
例如,假设你的知识库中嵌入了一批金融信息(比如美国 SEC 的申报文件),然后收到了这样一个问题:“ACME Corp 在 2023 年第二季度的收入增长是多少?”
某个相关的文本块可能包含这样的文字:“该公司的收入较上一季度增长了 3%。”然而,这个文本块本身并未说明它指的是哪家公司或哪个时间段,因此很难检索到正确的信息,也难以有效地使用这些信息。
上下文检索简介
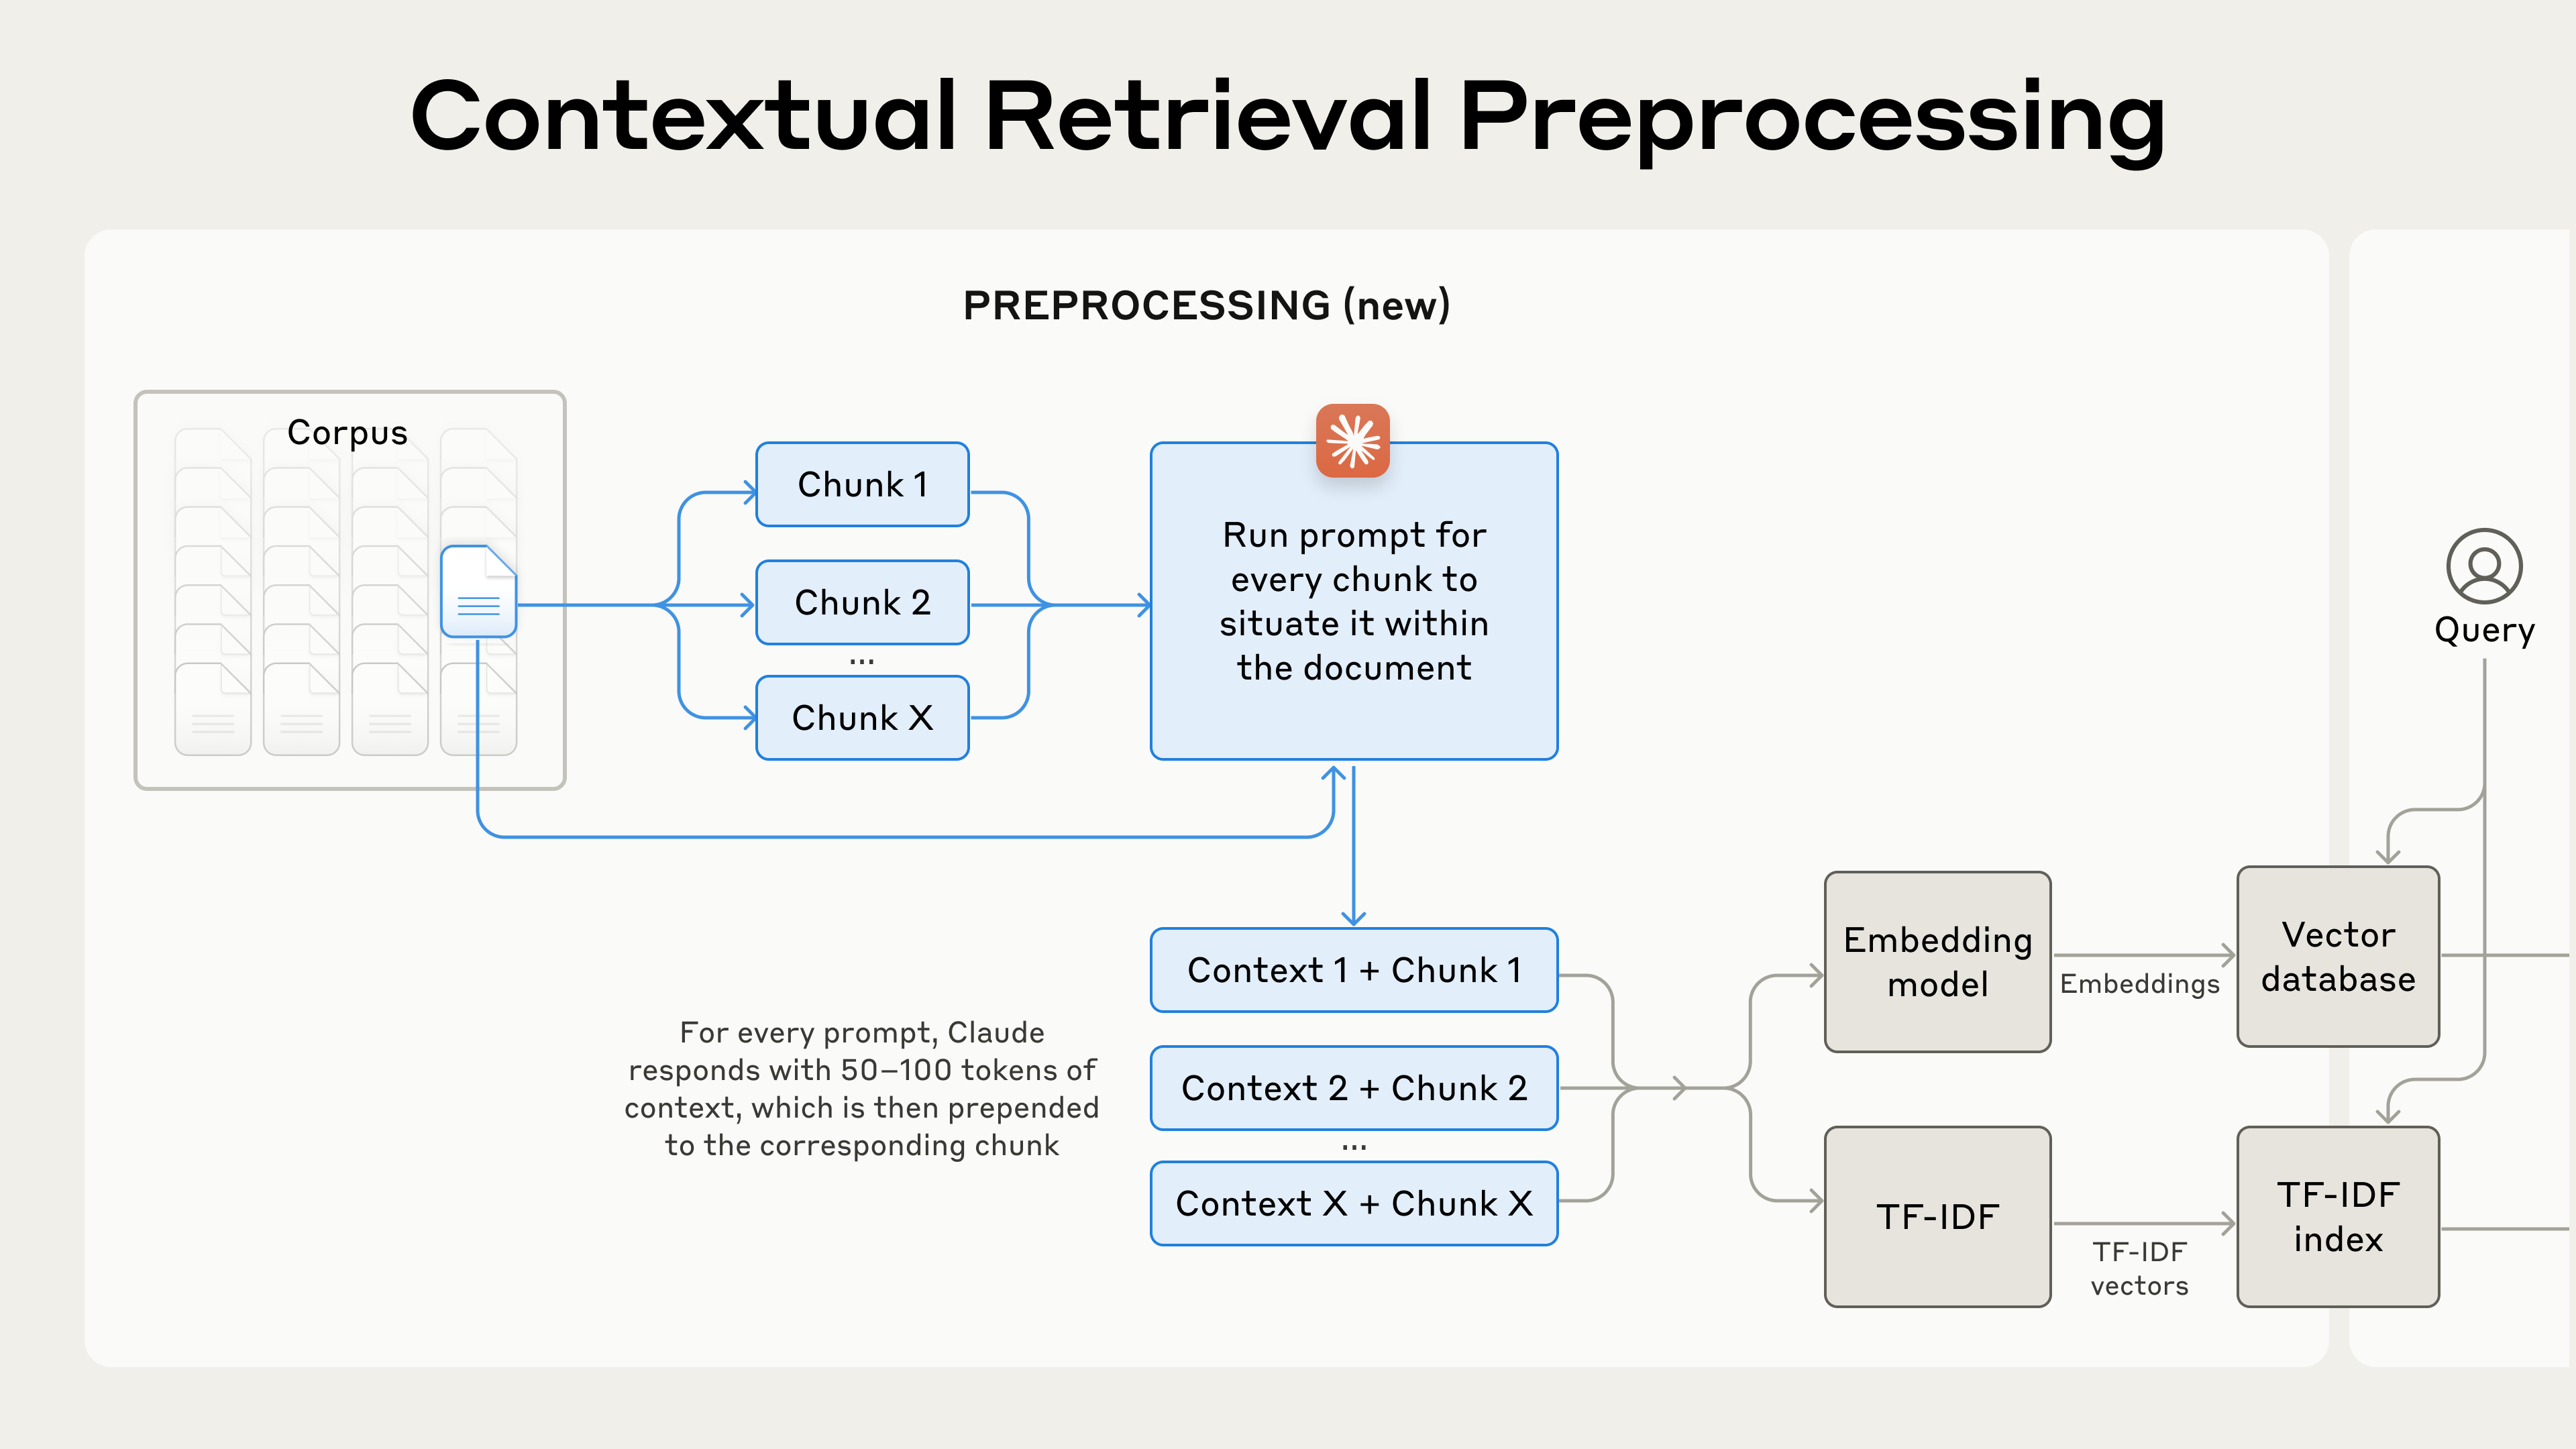
上下文检索通过在嵌入(“上下文嵌入”)和创建 BM25 索引(“上下文 BM25”)之前,为每个文本块预置该块专属的解释性上下文,来解决这个问题。
让我们回到 SEC 申报文件集合的例子。下面是一个文本块可能如何被转换的示例:
original_chunk = "The company's revenue grew by 3% over the previous quarter."

contextualized_chunk = "This chunk is from an SEC filing on ACME corp's performance in Q2 2023; the previous quarter's revenue was $314 million. The company's revenue grew by 3% over the previous quarter."
值得注意的是,过去也有人提出过其他利用上下文来改进检索的方法。其他方案包括:为文本块添加通用的文档摘要(我们做过实验,收益非常有限)、假设性文档嵌入,以及基于摘要的索引(我们评估后发现效果不佳)。这些方法与本文提出的方法不同。
实现上下文检索
当然,手工标注知识库中成千上万甚至数百万个文本块,工作量实在太大。为了实现上下文检索,我们求助于 Claude。我们编写了一个提示词,指示模型利用整篇文档的上下文,为每个文本块提供简洁的、针对该块的上下文来解释它。我们使用下面这个 Claude 3 Haiku 提示词为每个文本块生成上下文:
<document>
{{WHOLE_DOCUMENT}}
</document>
Here is the chunk we want to situate within the whole document
<chunk>
{{CHUNK_CONTENT}}
</chunk>
Please give a short succinct context to situate this chunk within the overall document for the purposes of improving search retrieval of the chunk. Answer only with the succinct context and nothing else.
生成的上下文文本通常为 50-100 个 token,会在嵌入之前以及创建 BM25 索引之前,预置到文本块前面。
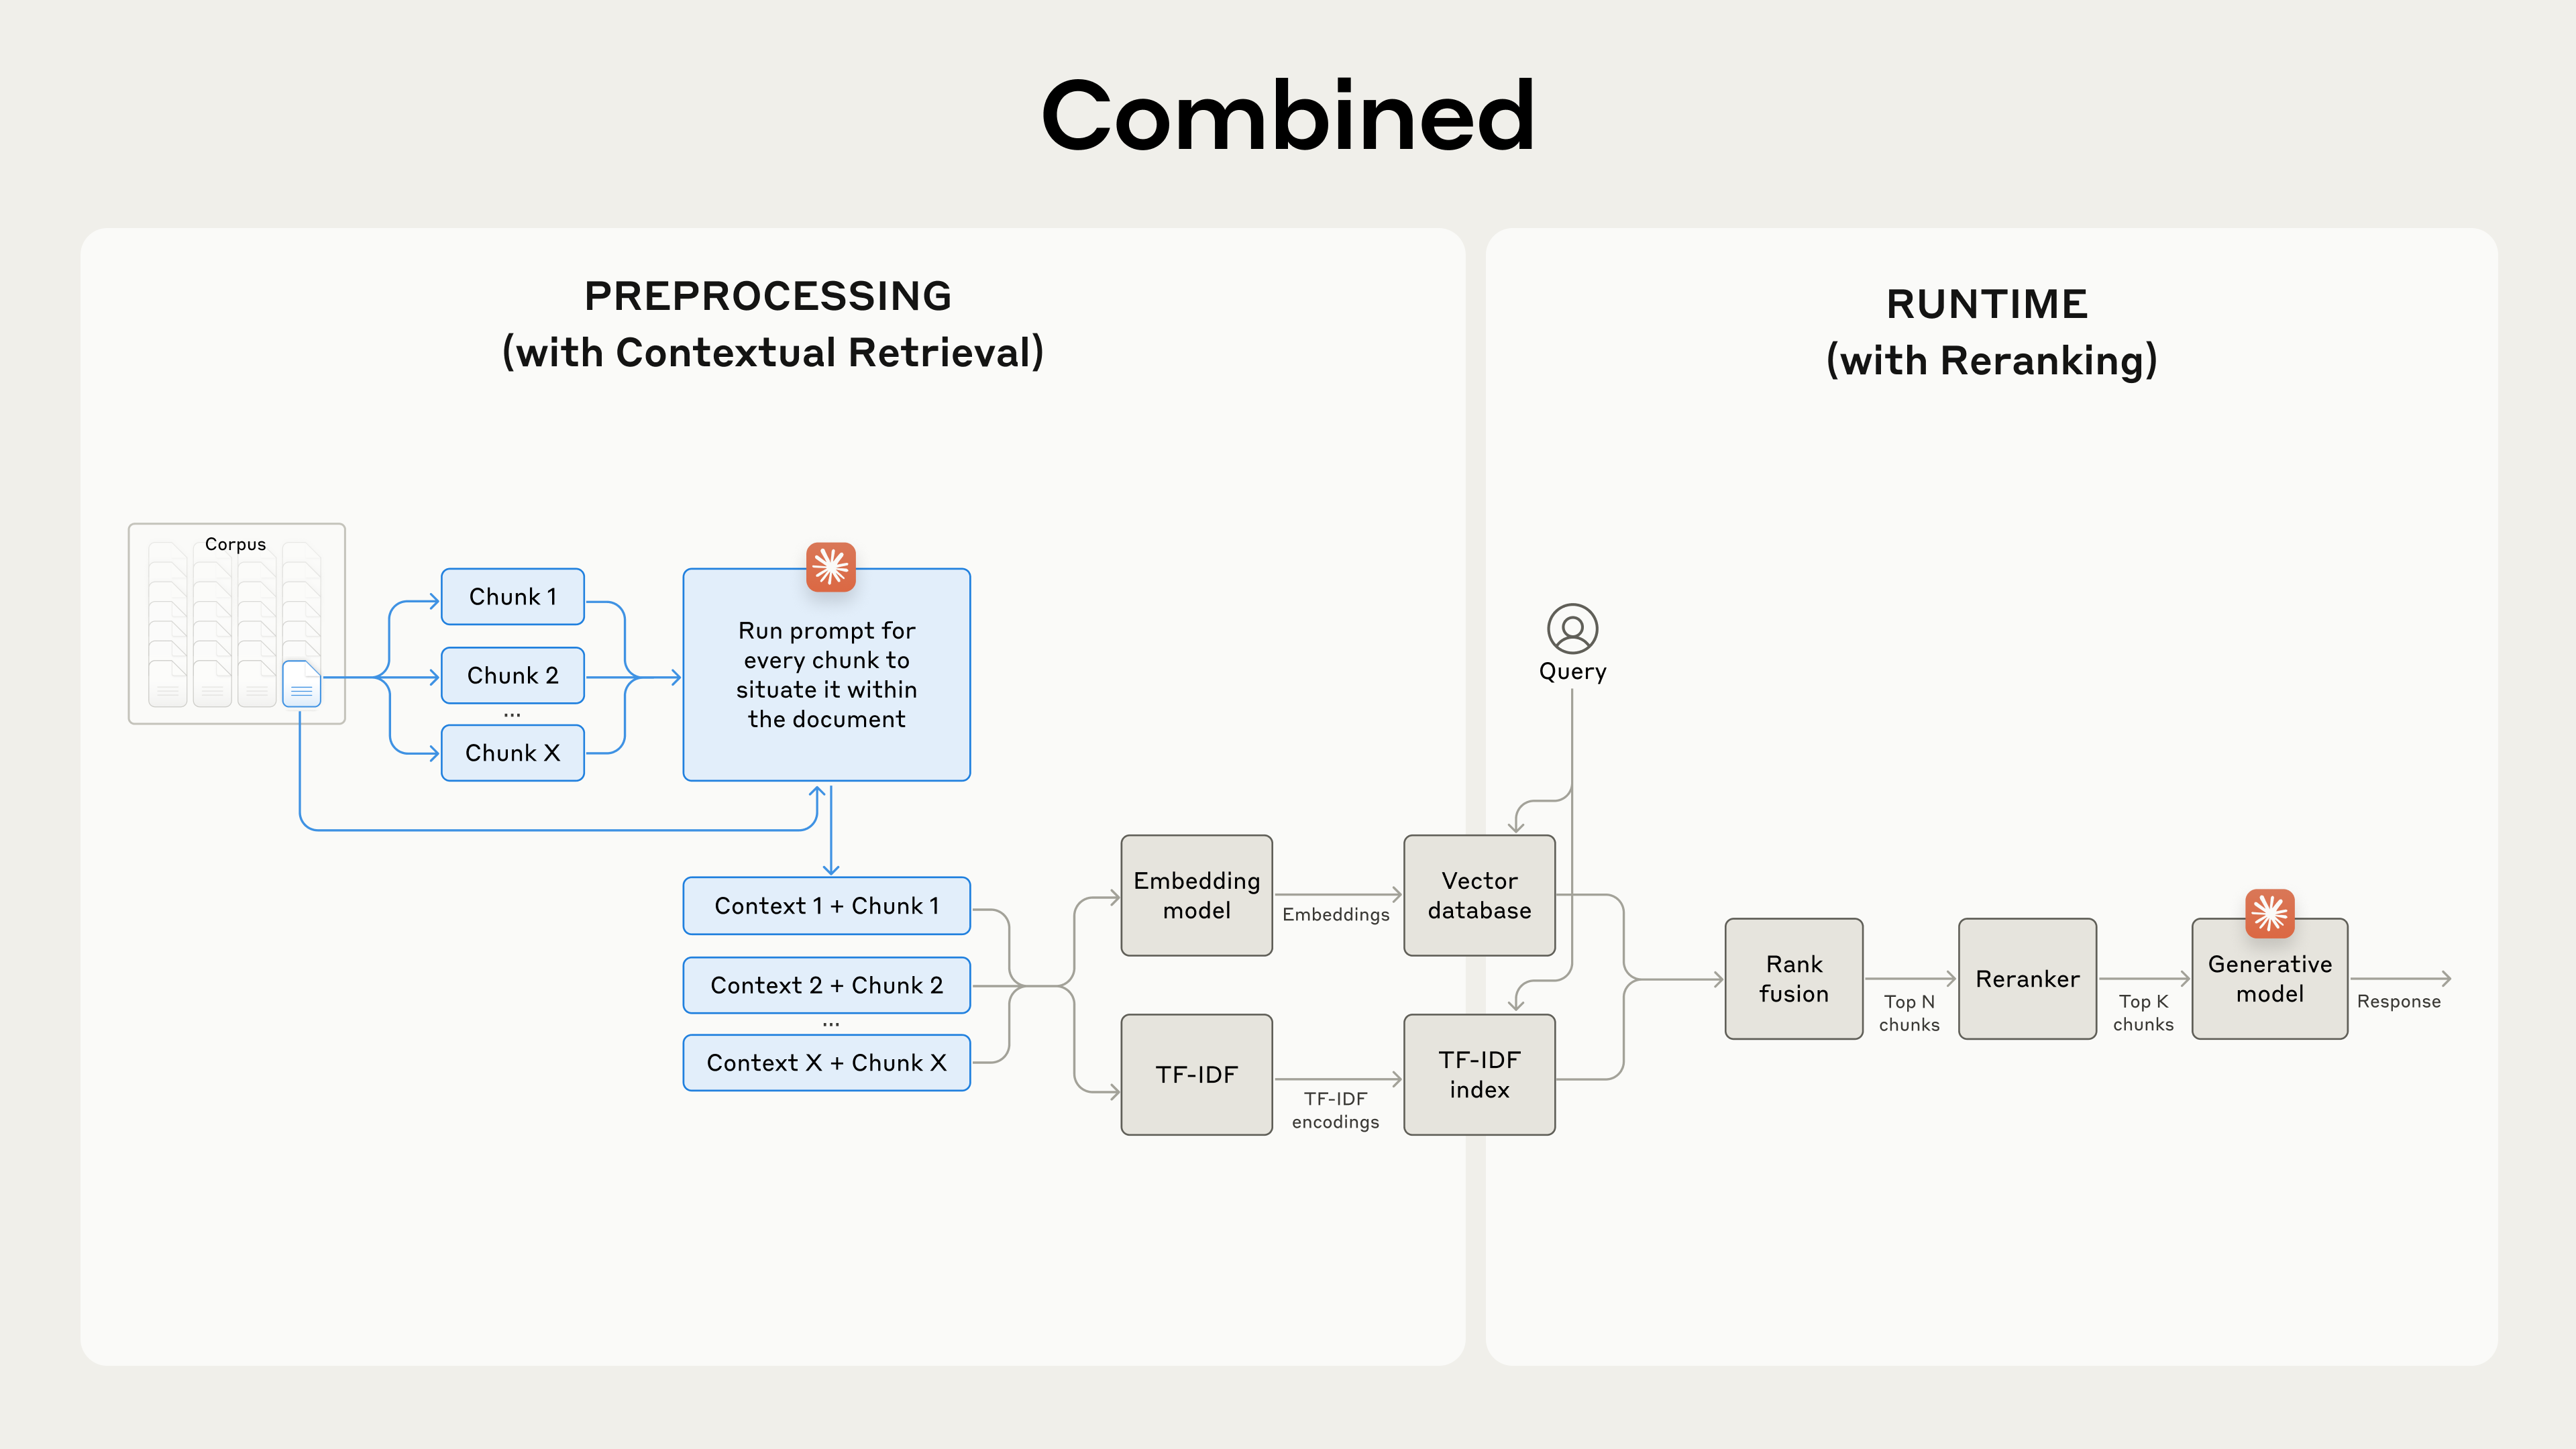
下面是预处理流程在实践中的样子:
如果你有兴趣使用上下文检索,可以从我们的 cookbook 入手。
使用提示词缓存降低上下文检索的成本
得益于前面提到的特殊的提示词缓存功能,上下文检索在 Claude 上能以较低成本实现,这是独有的优势。有了提示词缓存,你无需为每个文本块都传入参考文档,只需把文档一次性加载到缓存中,然后引用先前缓存的内容即可。假设文本块为 800 个 token、文档为 8k 个 token、上下文指令为 50 个 token、每个文本块的上下文为 100 个 token,生成带上下文文本块的一次性成本为每百万文档 token 1.02 美元。
方法论
我们在多种知识领域(代码库、小说、ArXiv 论文、科学论文)、嵌入模型、检索策略和评估指标上进行了实验。我们在附录 II 中收录了每个领域所用的若干问题和答案示例。
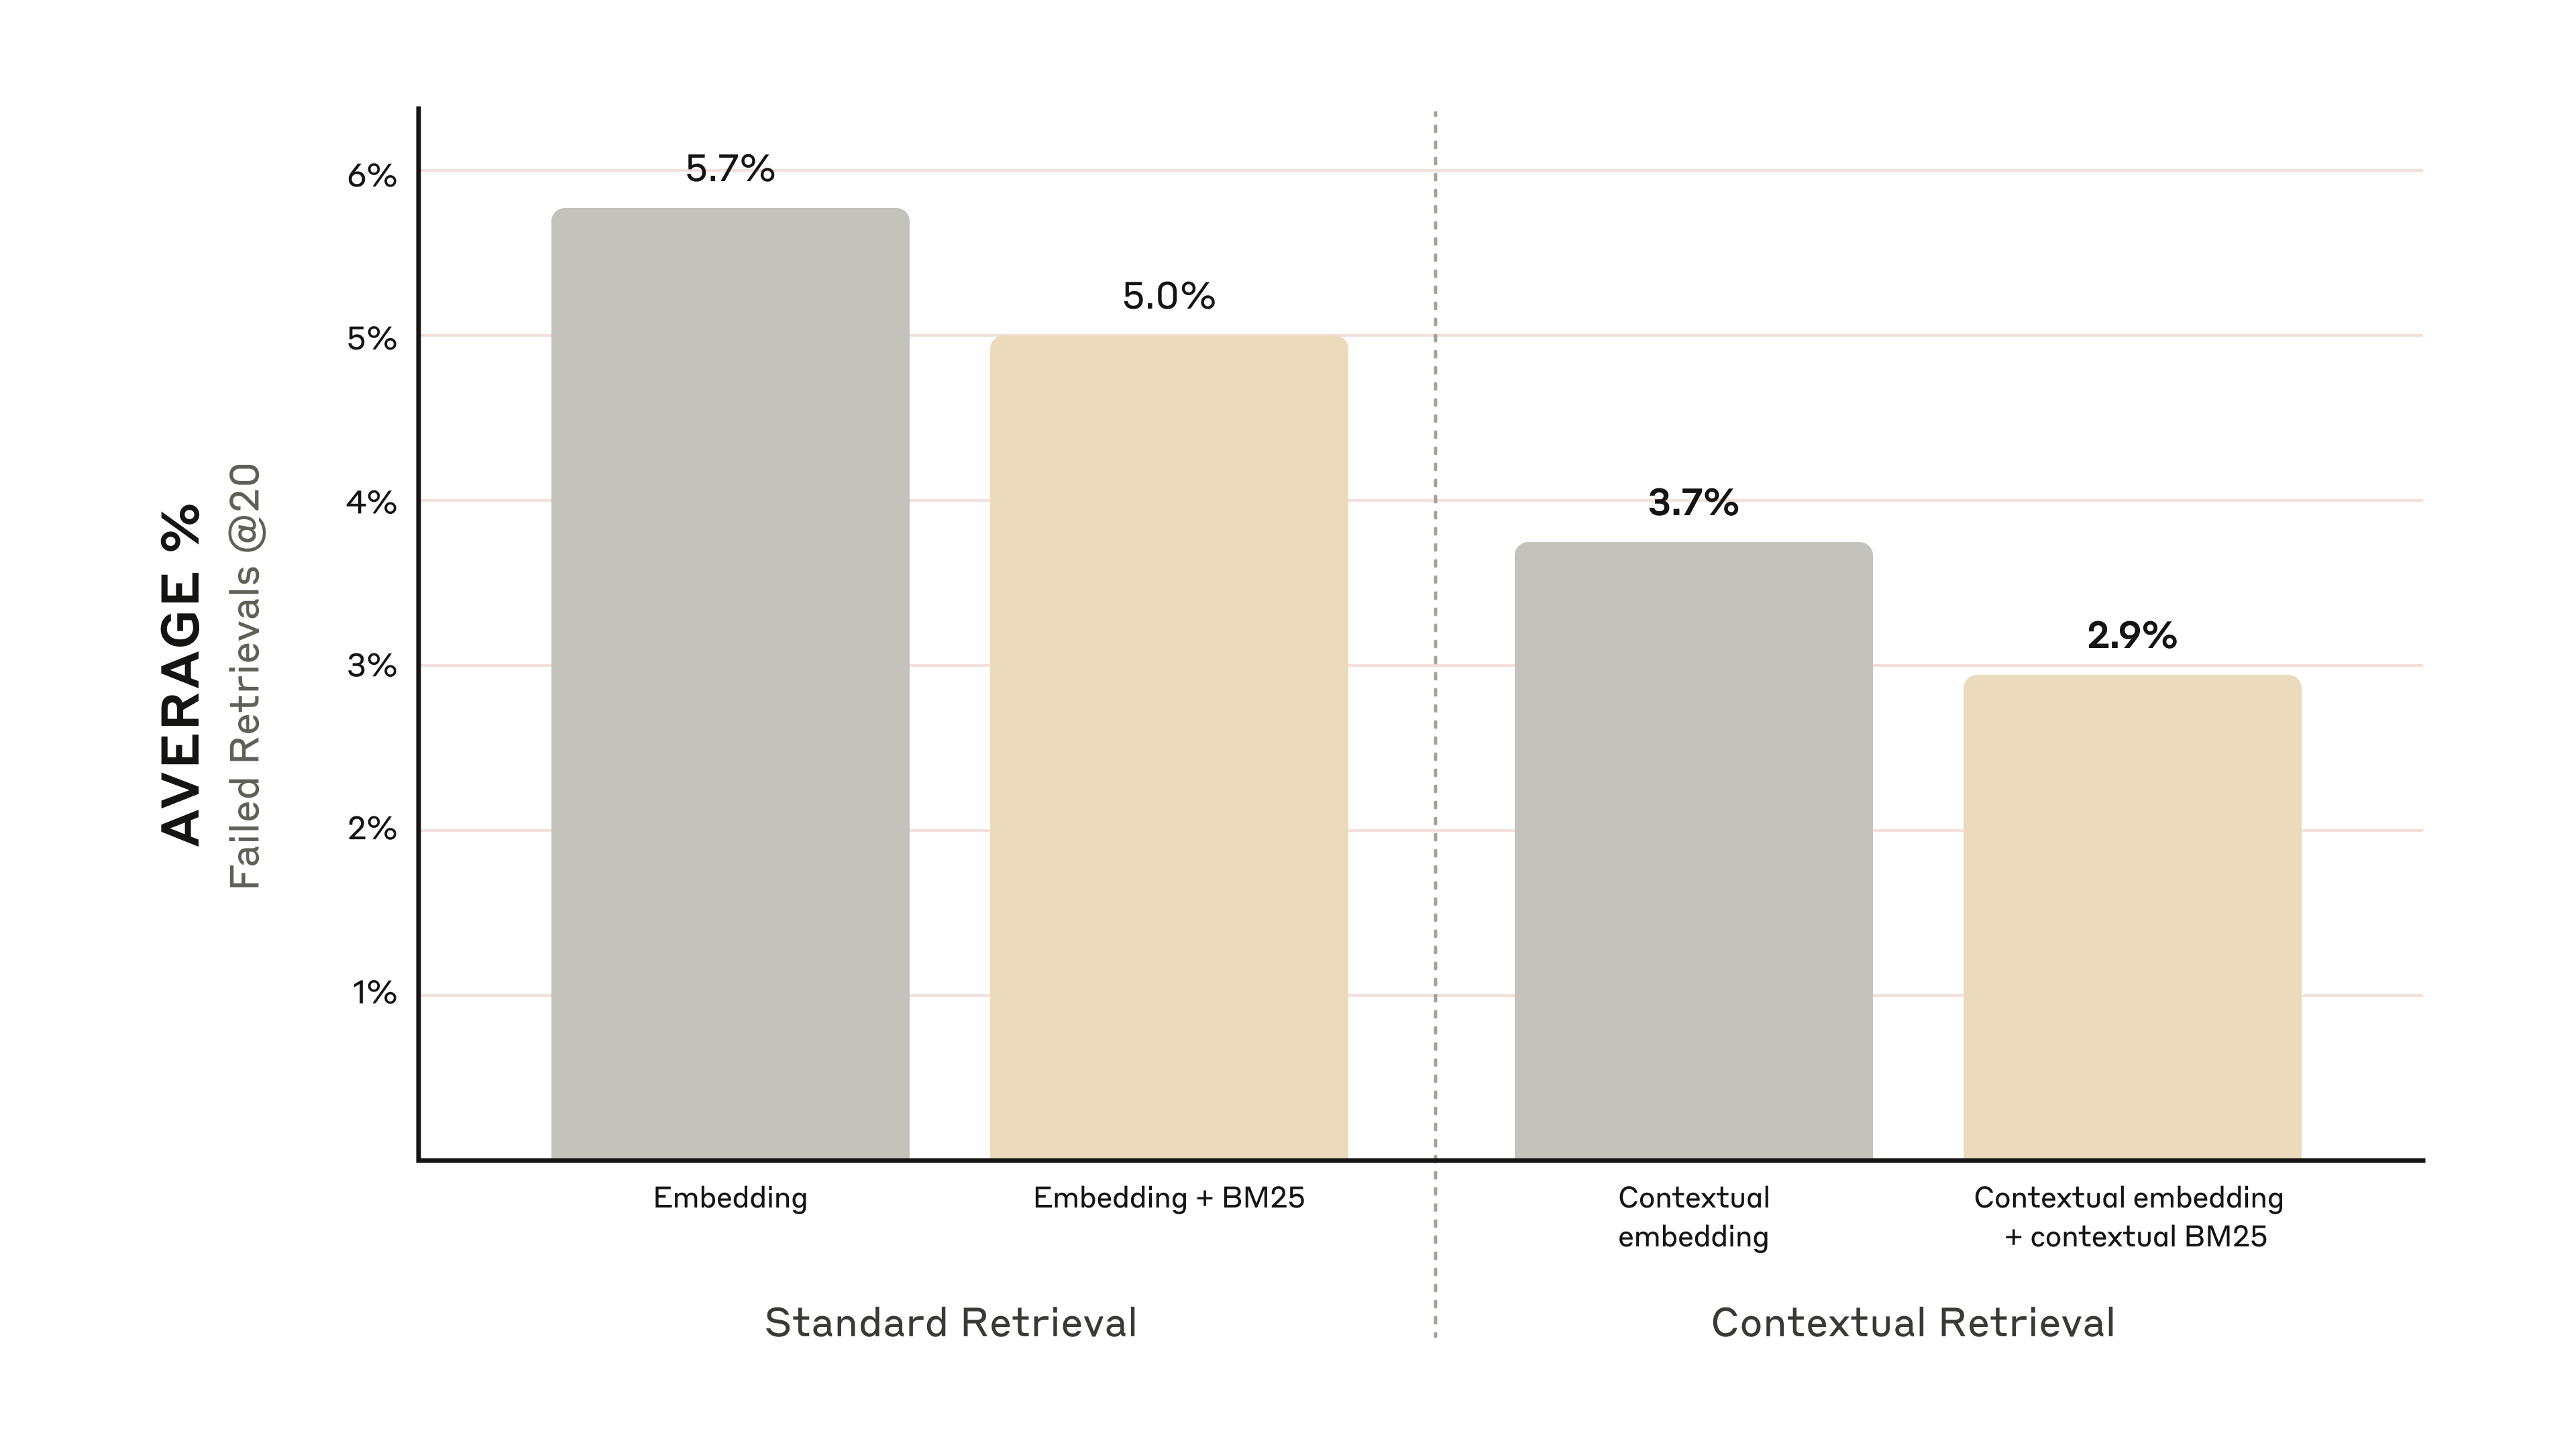
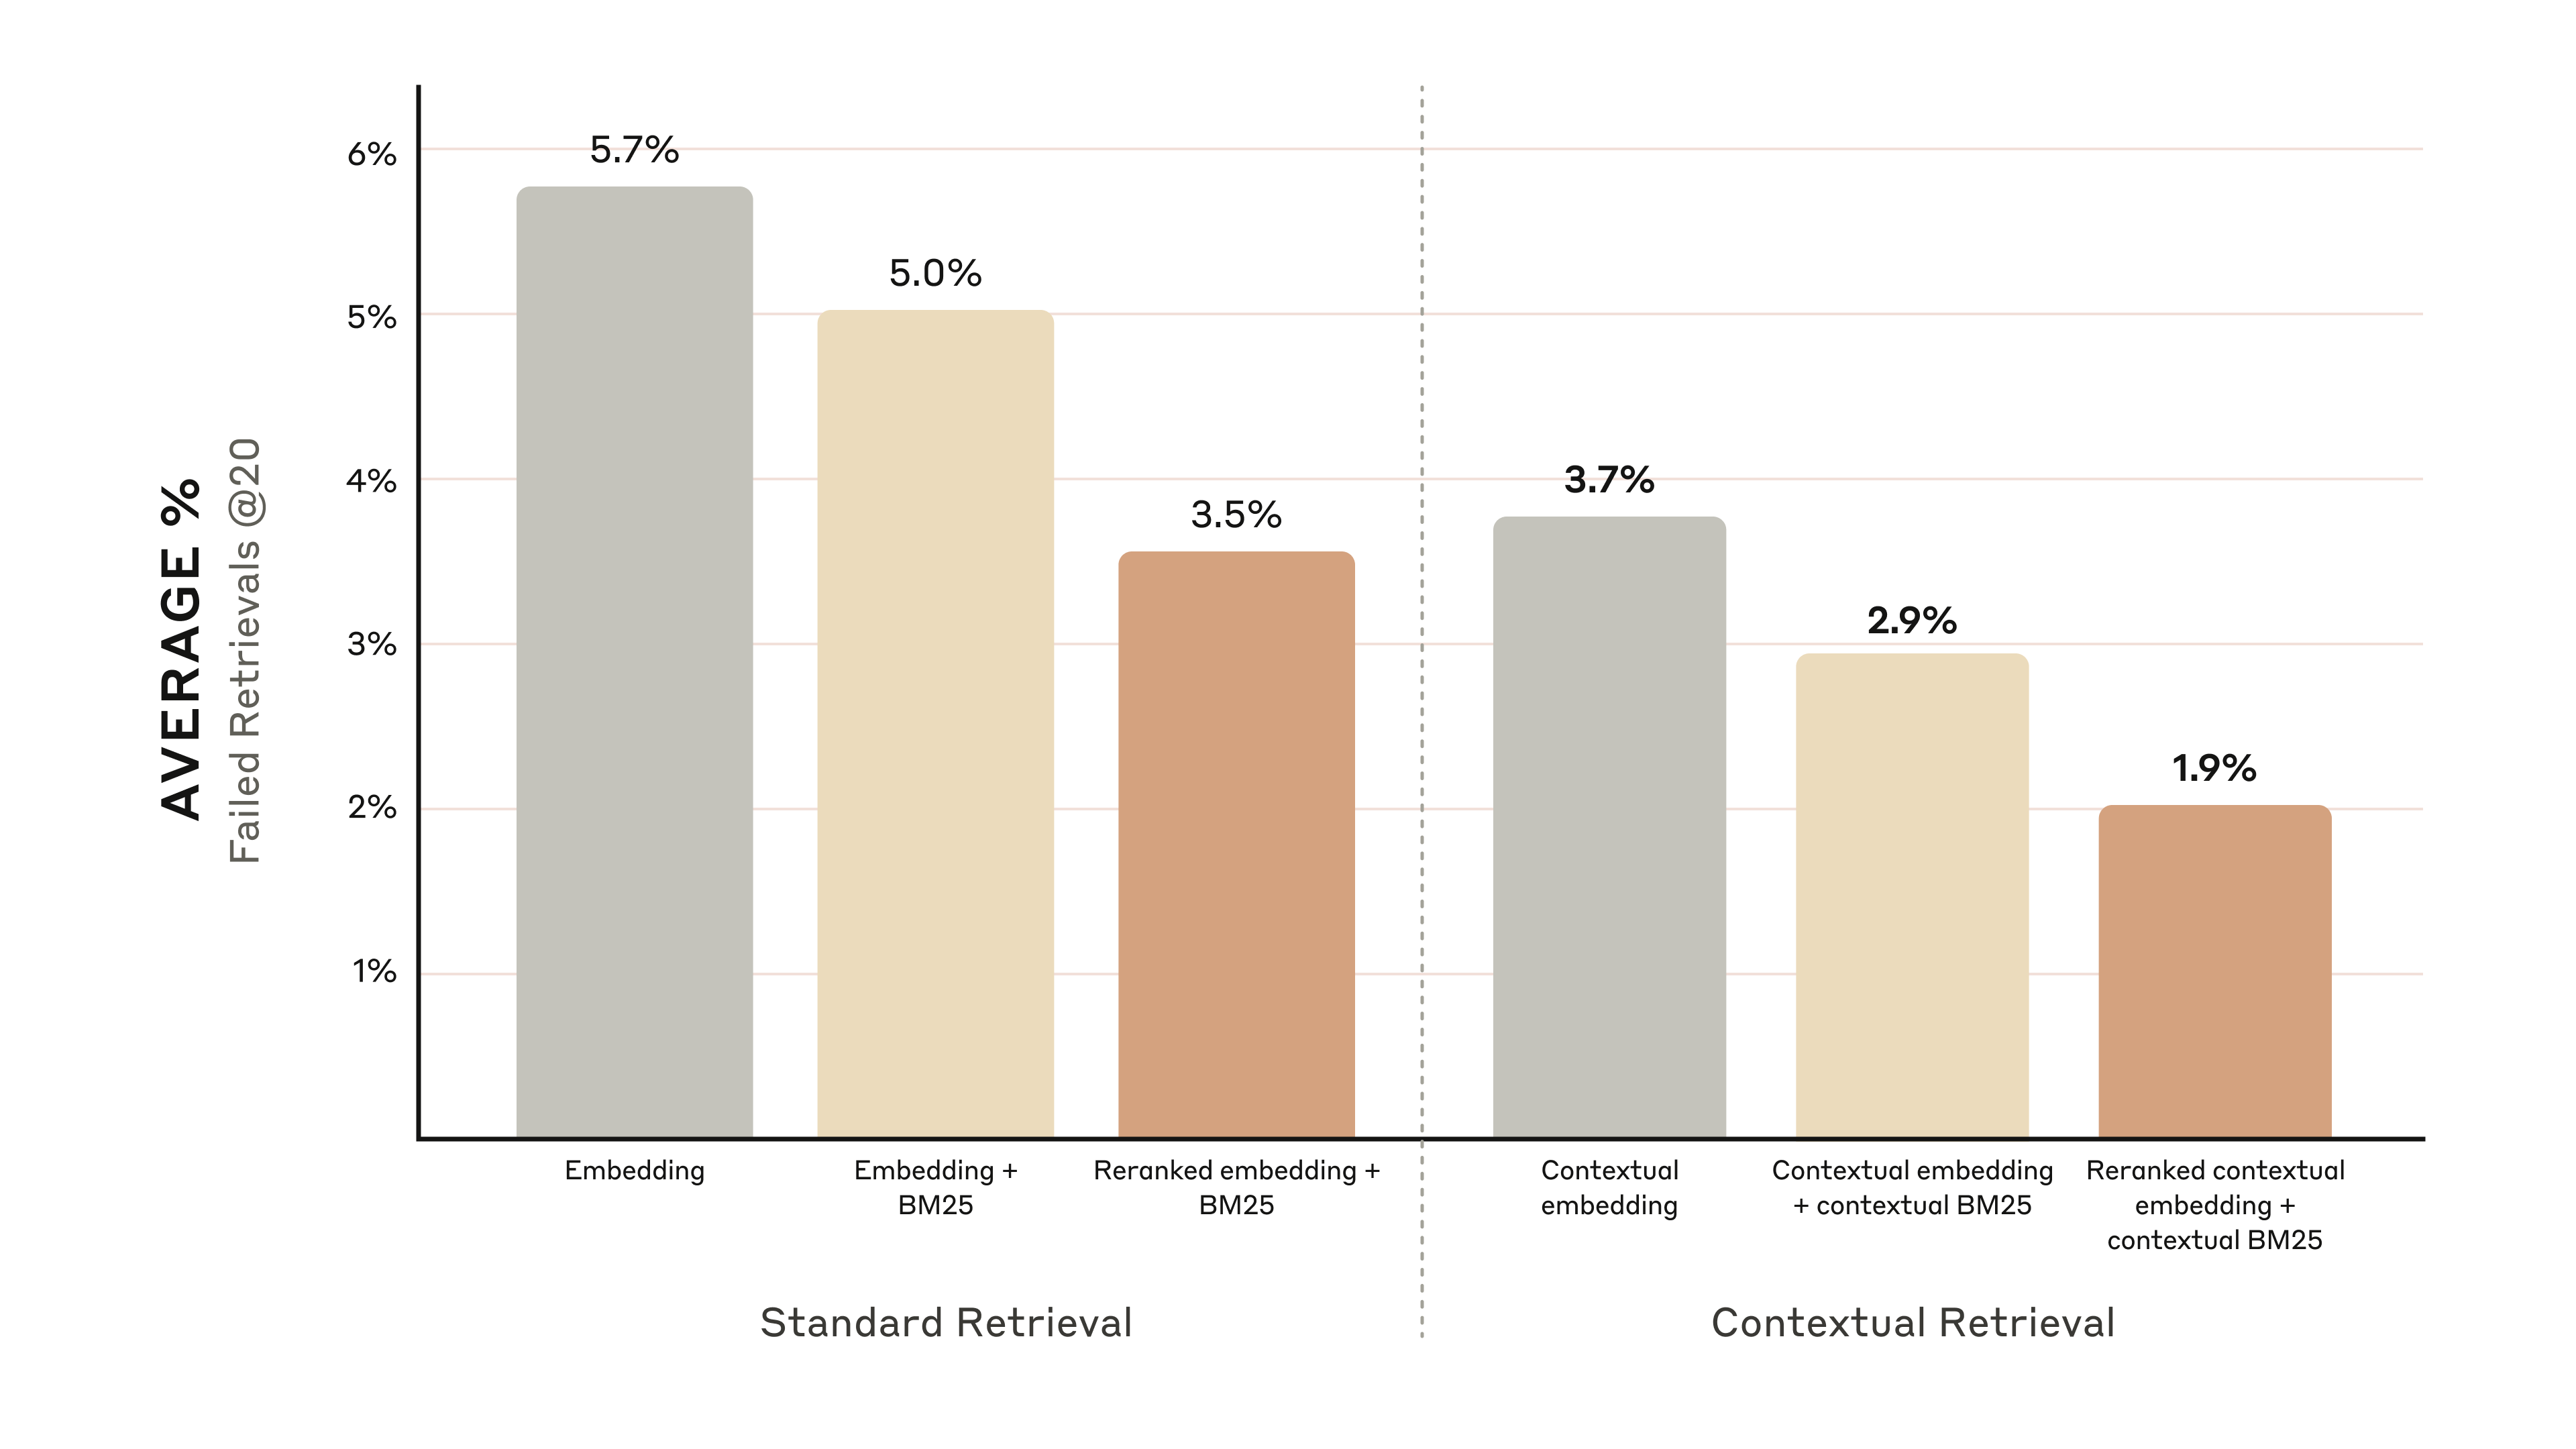
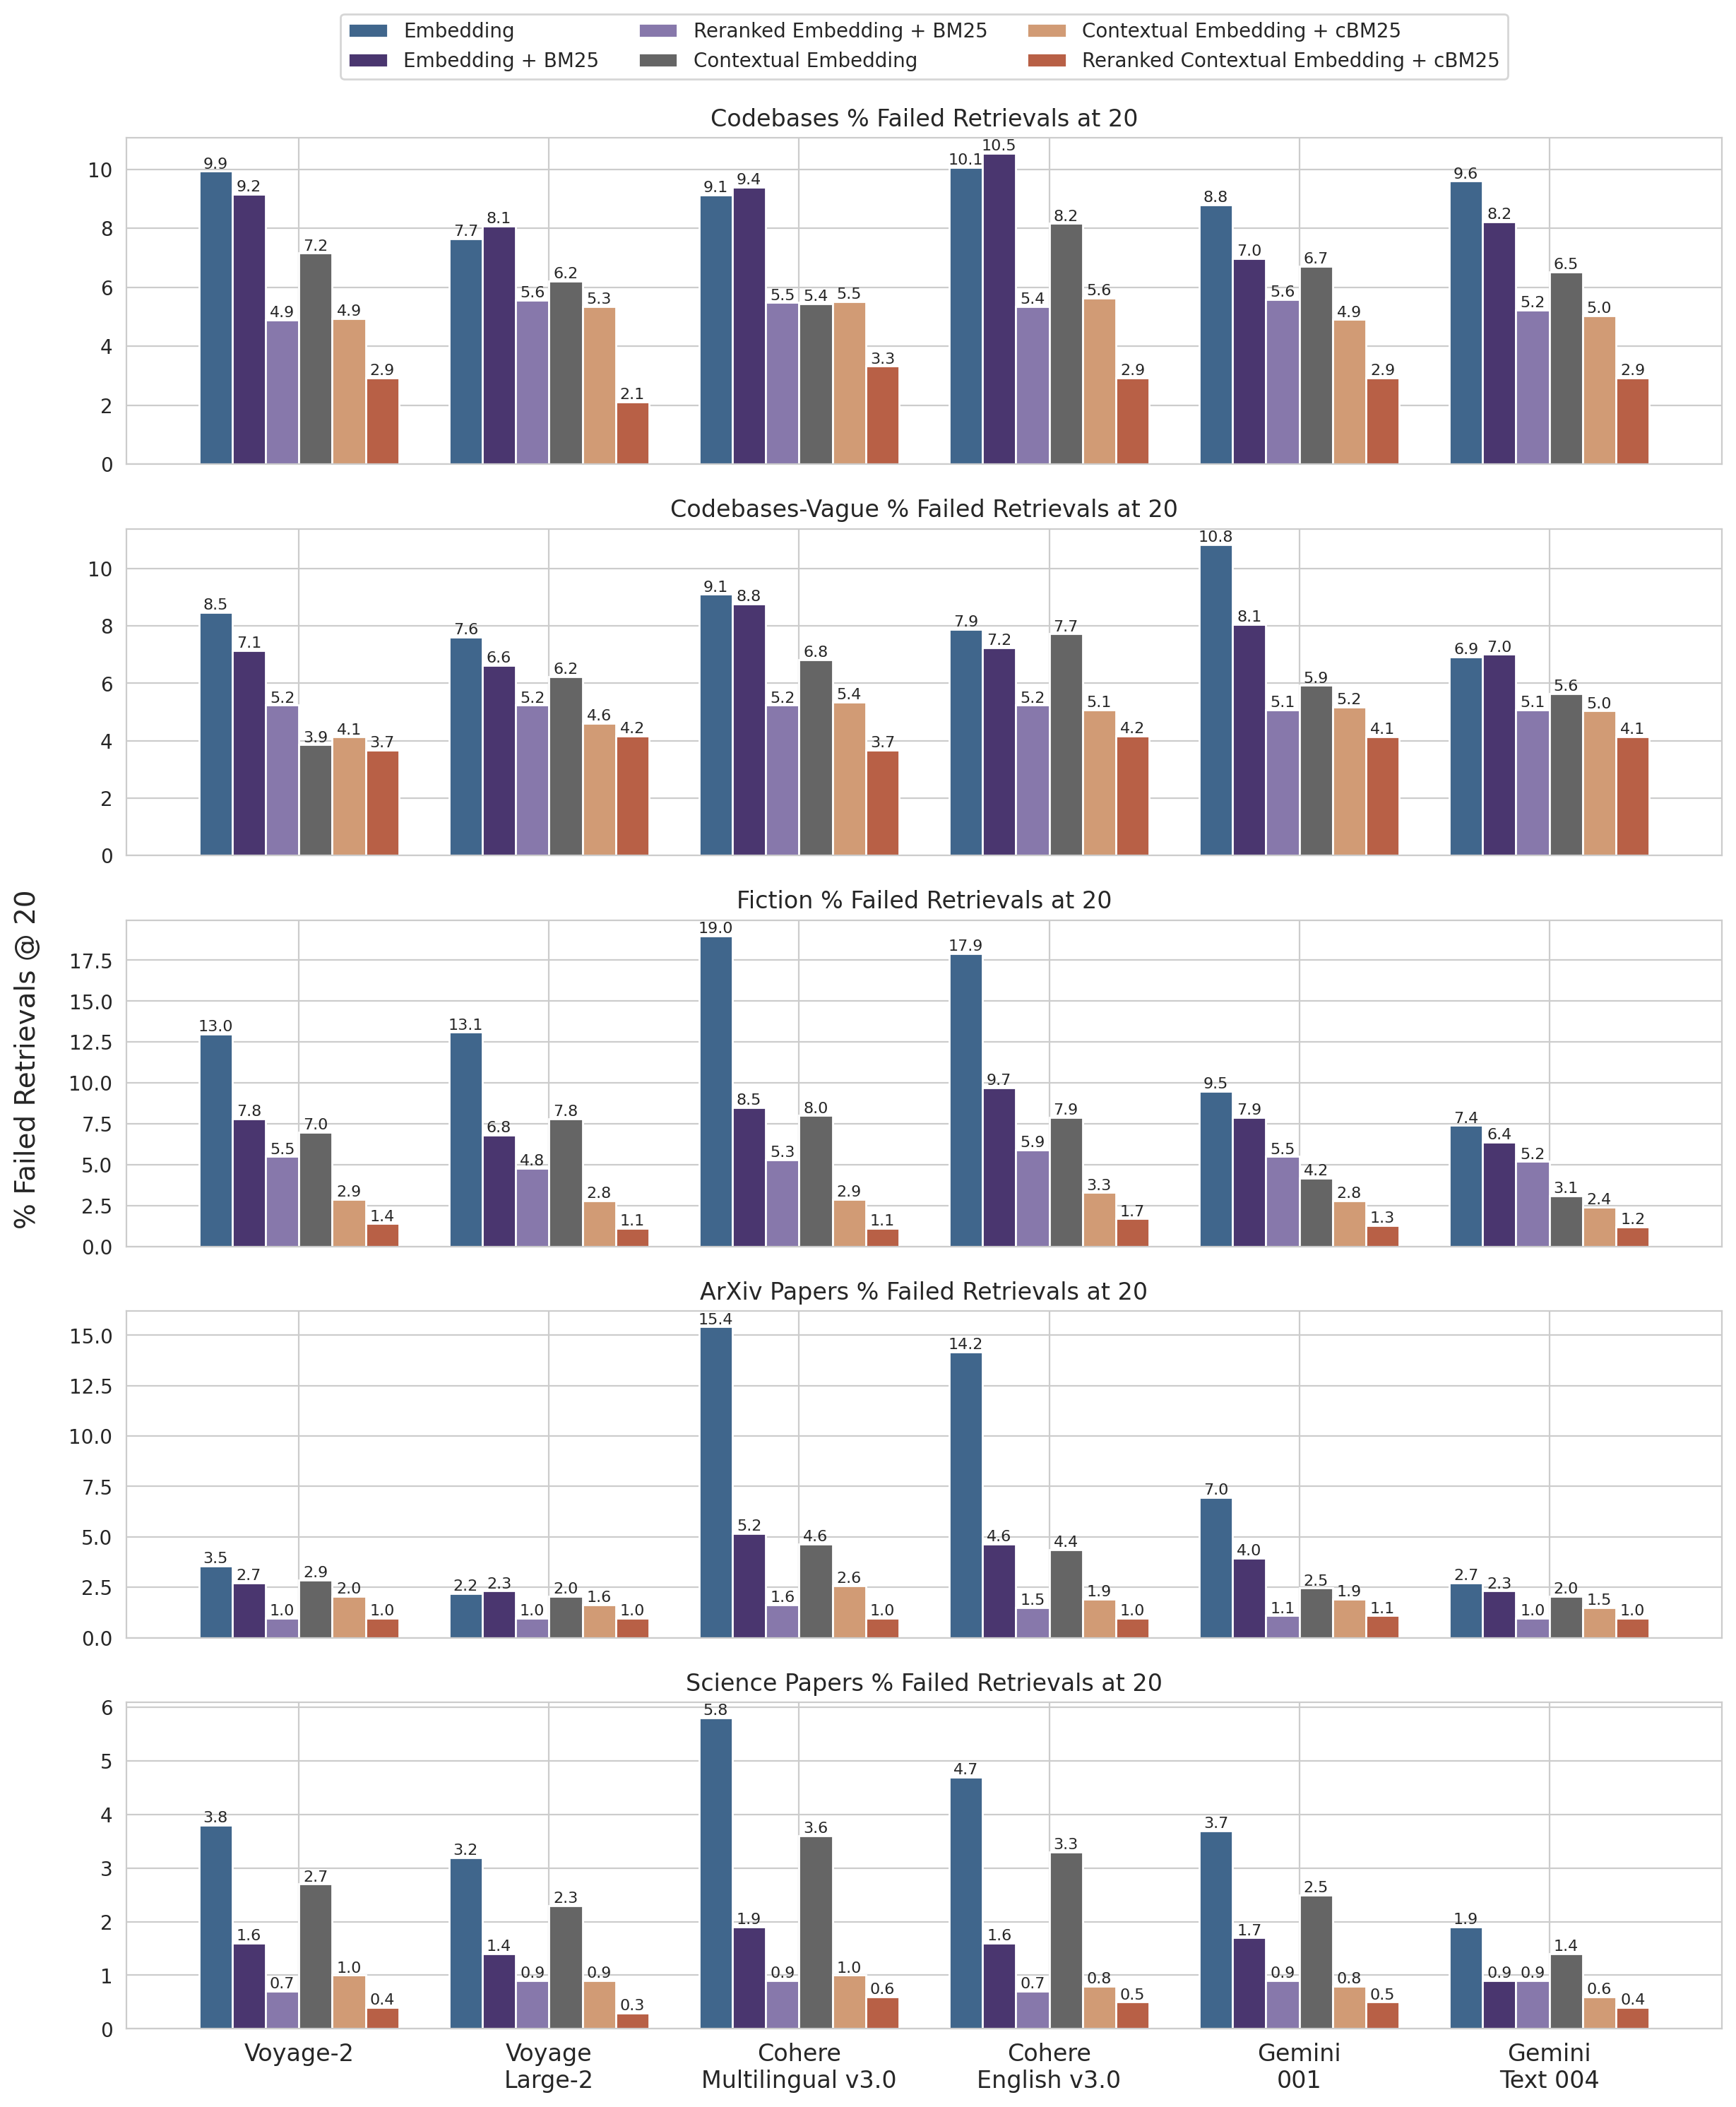
下图展示了在所有知识领域上的平均表现,采用表现最佳的嵌入配置(Gemini Text 004)并检索前 20 个文本块。我们使用 1 减去 recall@20 作为评估指标,它衡量的是在前 20 个文本块中未能被检索到的相关文档所占的百分比。完整结果见附录——对我们评估的每一种嵌入与数据源组合,加入上下文都提升了性能。
性能提升
我们的实验表明:
- 上下文嵌入将前 20 个文本块的检索失败率降低了 35%(5.7% → 3.7%)。
- 将上下文嵌入与上下文 BM25 结合,前 20 个文本块的检索失败率降低了 49%(5.7% → 2.9%)。
实现时的注意事项
实现上下文检索时,有几点需要牢记:
- 文本块边界:考虑如何把文档拆分成文本块。文本块大小、块边界和块重叠的选择,都会影响检索性能1。
- 嵌入模型:虽然上下文检索对我们测试的所有嵌入模型都有性能提升,但有些模型可能获益更多。我们发现 Gemini 和 Voyage 的嵌入特别有效。
- 自定义上下文生成提示词:我们提供的通用提示词效果不错,但针对你的具体领域或用例定制提示词,可能取得更好的结果(例如,加入一份关键术语表,这些术语可能只在知识库中的其他文档里有定义)。
- 文本块数量:向上下文窗口中加入更多文本块,能提高包含相关信息的机会。但信息过多也可能干扰模型,所以这有一个限度。我们尝试了提供 5、10 和 20 个文本块,发现其中使用 20 个效果最好(对比见附录),但仍值得针对你的用例做实验。
始终运行评测:把带上下文的文本块传给模型,并让它区分哪些是上下文、哪些是文本块本身,可能会改善回复的生成。
用重排序进一步提升性能
最后一步,我们可以把上下文检索与另一种技术结合,获得更多性能提升。在传统 RAG 中,AI 系统在知识库中搜索潜在相关的信息块。对于大型知识库,这一初始检索往往会返回大量文本块——有时多达数百个——其相关性和重要性参差不齐。
重排序(Reranking)是一种常用的过滤技术,用来确保只有最相关的文本块被传给模型。重排序能带来更好的回复,并降低成本和延迟,因为模型需要处理的信息更少。关键步骤如下:
- 执行初始检索,获取排名靠前、可能相关的文本块(我们使用前 150 个);
- 把前 N 个文本块连同用户的查询一起传给重排序模型;
- 使用重排序模型,根据每个文本块与提示词的相关性和重要性为其打分,然后选出前 K 个文本块(我们使用前 20 个);
- 把前 K 个文本块作为上下文传给模型,以生成最终结果。
性能提升
市面上有多种重排序模型。我们的测试使用的是 Cohere 重排序器。Voyage 也提供重排序器,不过我们没来得及测试。我们的实验表明,在各个不同领域中,加入重排序步骤都能进一步优化检索。
具体而言,我们发现经过重排序的上下文嵌入加上下文 BM25,将前 20 个文本块的检索失败率降低了 67%(5.7% → 1.9%)。
成本与延迟的考量
重排序有一个重要的考量,即它对延迟和成本的影响,在对大量文本块进行重排序时尤其如此。由于重排序在运行时增加了一个额外步骤,即使重排序器是并行为所有文本块打分,也不可避免地会增加少量延迟。重排序更多文本块以获得更好性能,与重排序更少文本块以降低延迟和成本之间,存在固有的权衡。我们建议针对你的具体用例尝试不同的设置,找到合适的平衡点。
结论
我们进行了大量测试,在各种不同类型的数据集上,比较了上述所有技术的不同组合(嵌入模型、是否使用 BM25、是否使用上下文检索、是否使用重排序器,以及检索的前 K 个结果总数)。以下是我们的发现总结:
- 嵌入加 BM25 优于单独使用嵌入;
- 在我们测试的模型中,Voyage 和 Gemini 的嵌入效果最好;
- 把前 20 个文本块传给模型,比只传前 10 个或前 5 个更有效;
- 为文本块添加上下文能大幅提升检索准确率;
- 重排序优于不重排序;
- 所有这些收益可以叠加:为了使性能提升最大化,我们可以将上下文嵌入(来自 Voyage 或 Gemini)与上下文 BM25 相结合,再加上重排序步骤,并把 20 个文本块加入提示词。
我们鼓励所有处理知识库的开发者使用我们的 cookbook 来试验这些方法,以解锁新的性能水平。
附录 I
下面按数据集、嵌入提供商、除嵌入外是否使用 BM25、是否使用上下文检索以及是否使用重排序,给出 Retrievals @ 20 的结果明细。
Retrievals @ 10 和 @ 5 的明细,以及各数据集的示例问题和答案,请参见附录 II。
致谢
研究与撰写:Daniel Ford。感谢 Orowa Sikder、Gautam Mittal 和 Kenneth Lien 提出的关键反馈,感谢 Samuel Flamini 实现 cookbook,感谢 Lauren Polansky 的项目协调,也感谢 Alex Albert、Susan Payne、Stuart Ritchie 和 Brad Abrams 对本文的塑造。