编码智能体已经开始大规模编写生产代码。Stripe 的智能体每周生成 1,300 多个 PR。Ramp 称其 30% 的已合并 PR 来自智能体。Spotify 报告每月有 650 多个智能体生成的 PR。Claude Code 和 Codex 这类工具在一次编码会话中会发起数百次 API 调用,每次调用都带着完整的对话历史。在这些工作流背后,是一套承受着巨大 KV 缓存压力的推理栈。

以 Claude Code 为例。第一次 API 调用把对话前缀写入 KV 缓存之后,之后每次发往同一个 worker 的调用都能命中 85-97% 的缓存。智能体团队(或称智能体集群)把这个数字推得更高:4 个 Opus 队友的整体缓存命中率达到 97.2%。11.7 倍的读写比意味着,系统每写入一个 token,就要从缓存中读取将近 12 次。这是一种一次写入、多次读取(write-once-read-many,WORM)的访问模式:系统提示词和不断增长的对话前缀只计算一次,之后每次调用都直接从缓存提供。要在所有 worker 上最大化缓存复用率,并让 KV 块保持热状态且可被路由到,这是智能体推理最核心的优化目标。
这些数字来自托管式 API 基础设施,前缀匹配、缓存放置和淘汰都由服务提供方掌控。对于在自有 GPU 上运行开源模型的团队,这些能力开箱即用是不存在的。我们一直在构建 Dynamo 来弥补这一差距。本文将介绍我们如何在三个层面上让 Dynamo 原生支持智能体:前端 API、路由器和 KV 缓存管理。
全文中,我们统一使用三个术语:
- Harness:驱动工作流的智能体框架(Claude Code、Codex、OpenClaw、OpenCode 等)
- Orchestrator:Dynamo 的路由、调度和缓存管理层
- Runtime:执行模型并管理 KV 缓存管理器的推理引擎(SGLang、vLLM、TRT-LLM)
第一层:前端
多协议支持
智能体 harness 越来越多地采用 v1/responses 和 v1/messages,而不是 v1/chat/completions,以便干净地处理交错思考与工具调用等新模式。这些 API 的关键差别在于结构。在 v1/chat/completions 中,消息内容是一个扁平字符串,工具调用则作为单独的字段附加上去。例如,请注意 GLM 和 MiniMax 在把各自的模型部署于 v1/chat/completions 端点之后,对交错思考的处理方式并不相同。v1/responses 和 v1/messages API 使用带类型的内容块,因此一个助手回合里可以把思考、工具调用和文本作为不同的对象。这对推理很重要,因为 orchestrator 可以看到块的边界,进行提示词优化,并针对不同类型的块应用不同的缓存和调度策略。Dynamo 通过统一的内部表示同时提供这三个端点,因此同一套部署就可以作为任意 harness 的推理后端。我们团队内部一直在运行 GLM-5 和 MiniMax2.5 的 Dynamo 部署,为我们的 Codex 和 Claude Code harness 提供支撑。这让我们能够把自己的后端实现与闭源推理做基准测试,目标是在缓存复用性能上达到同等水平。未来几周,我们将发布完整的文章,以及部署这两个模型的一些优化方案。
▶ https://github.com/user-attachments/assets/5fa8a224-44e8-4acb-943b-9b8af84815e6
视频 1. 用 Dynamo 部署 Claude 服务
▶ https://github.com/user-attachments/assets/8694b544-3fd1-4931-9fd0-7d9a3a2fb78f
视频 2. 用 Dynamo 部署 Codex 服务
我们还投入精力,为多种开源模型提供首日(day-0)的工具调用和推理解析支持。如果你发现某个模型尚不受支持,请提交 issue,或使用 tool-call-parser-generator skill,借助你偏好的 harness 来生成解析器。
智能体提示(Agent hints):Harness 与 Orchestrator 之间的接口
如今,推理服务器看到的只是匿名的、已分词的请求。但智能体 harness 掌握着基础设施永远看不到的全局上下文:哪些智能体正阻塞在工具调用上,哪些刚刚被创建,一个会话还剩多少轮,当前这次调用是快速查询还是长篇综合。使用编码智能体时,用户等待的是最终结果,而不是单个 token 流,因此 orchestrator 可以在多个智能体之间重新排序、调整请求优先级,而不影响最终用户体验。会话可以持续几分钟乃至数天,期间还有很长的工具调用停顿。这足以让我们以传统服务方式做不到的手段来优化推理调度。
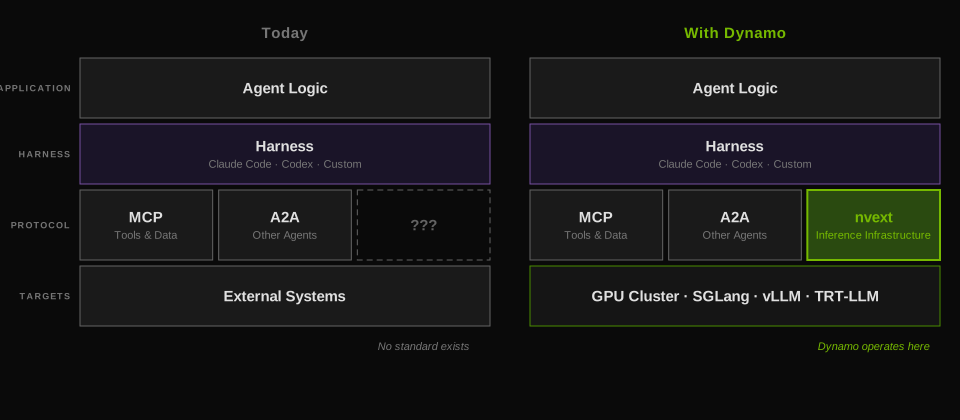
Dynamo 新增的智能体提示扩展正是为弥合这一差距而设计的。它允许任何 harness 在全部三个 API 端点上为请求附加结构化提示,让路由器和 runtime 获得做出智能体感知的调度与缓存决策所需的上下文。这是一个 v1 版 API,我们正与社区积极共同设计,也希望构建智能体 harness 的团队反馈哪些信号最有用。如果你有任何想法或反馈,欢迎联系我们。
{
  "model": "MiniMaxAI/MiniMax-M2.5",
  "messages": [...],
  "tools": [...],
  "nvext": {
    "agent_hints": {
      "osl": 256,
      "speculative_prefill": true,
      "priority": 10
    },
    "cache_control": {
      "type": "ephemeral",
      "ttl": "1h"
    }
  }
}
agent_hints 字段:
priority同时控制路由器和引擎两处的调度。在 Dynamo API 层面,数值越高表示“越重要”;Dynamo 会把它转换为路由器的队列顺序以及各后端特定的引擎优先级。osl(输出序列长度)是 harness 对该请求将生成多少 token 的估计。路由器据此判断某个 worker 会被占用多久,从而改进负载均衡。harness 可以通过跟踪每种工具调用类型的平均输出长度,逐步学到这个值。speculative_prefill通知 orchestrator,在完整请求就绪之前,就开始在可能的 worker 上缓存该请求的前缀。当 harness 知道某个工具调用即将返回,并希望提前预热缓存时,这很有用。
用过 Anthropic 提示词缓存 API 的人对 cache_control 字段会很熟悉。它告诉 orchestrator 在 worker 上把已计算的前缀固定(pin)住,保留指定的 TTL,使其在工具调用的间隙中不被淘汰。目前 ephemeral 是唯一支持的类型(以与 Anthropic 的 API 保持一致)。我们将在下文的缓存保留一节中讨论其工作原理。关于智能体提示的完整文档,请见此处。
第二层:路由器
编码智能体遵循一种顺序模式:长预填充、工具调用、扩展前缀,如此往复。多智能体 harness 则把工作分发给并行的子智能体,各自上下文较短且相互独立。默认的轮询(round-robin)路由对这两种模式都视而不见,它无法考虑缓存局部性、请求优先级或会话结构。Dynamo 的路由器通过三种机制弥补这一差距:KV 感知放置、优先级调度和可扩展的路由策略。
KV 感知放置
如果没有缓存感知路由,一次对话的第 2 轮落在与第 1 轮相同 worker 上的概率只有约 1/N。每一次未命中都意味着完整的前缀重新计算,这是一个显著的性能瓶颈,对终端用户来说成本极高。Dynamo 的路由器维护着一份全局索引,记录哪些 KV 缓存块存在于哪些 worker 上。Flash Indexer 一文介绍了把这个索引器做到 170M ops/s(行星级规模的 KV 路由)所经历的六次迭代。对每个请求,路由器都会查询该索引,得到各 worker 的重叠得分,并选择能使缓存未命中与当前解码负载的综合成本最小的 worker。这个成本函数是可调的,下文将展示团队如何在其之上构建自定义的智能体感知路由策略。
优先级调度
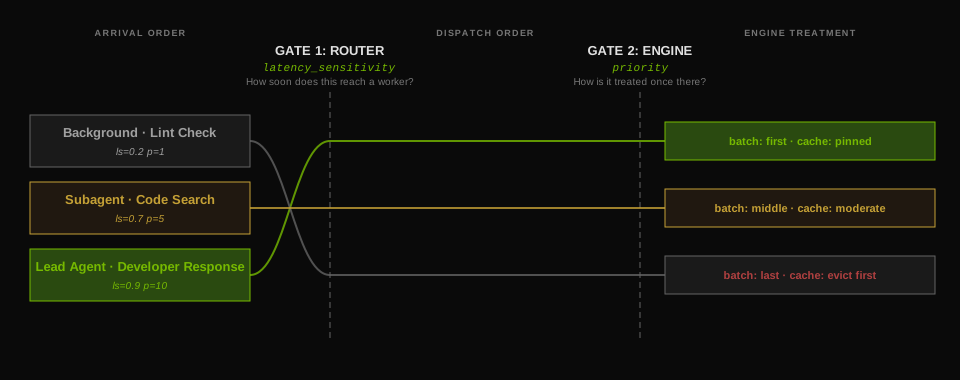
priority 是唯一面向用户的调度旋钮。在 Dynamo API 层面,数值越高表示“越重要”。Dynamo 在两个层面都使用这一个提示:
- 在路由器处,启用
--router-queue-threshold后,优先级较高的请求会被提前到队列更靠前的位置。 - 在引擎处,Dynamo 会对各后端特定的优先级极性进行归一化,并转发该请求,用于队列排序、抢占和 KV 缓存淘汰。
在路由器处,进入的请求会进入一个按有效到达时间排序的 BinaryHeap<QueueEntry>。更高的 priority 会让请求看起来像是更早到达,从而排在低优先级任务之前。只有当所有 worker 的负载都超过某个可配置的阈值时,请求才会进入队列;低于该阈值时,请求完全绕过队列,直接进入 worker 选择。当有容量释放出来(预填充完成或某个请求结束)时,队列会优先放出优先级最高的条目。
请求一旦被分发,SGLang、vLLM 和 TRT-LLM 对引擎优先级的解释可能各不相同,因此 Dynamo 会针对每种后端对面向引擎的数值做归一化。SGLang 等引擎还可以使用基于优先级的 radix 缓存淘汰,在内存压力下优先淘汰低优先级的块。
面向智能体工作负载的路由策略
一个拥有 200K 上下文窗口的研究型智能体,需要有足够空闲 KV 容量的 worker 来容纳它的完整状态。路由器默认的成本函数(重叠得分 + 解码负载)可以处理常见情形,但有特定领域工作负载的团队可以通过路由器的 Python 绑定来实现自定义路由策略。核心的 KvRouter 类提供用于查询路由决策的 best_worker()、用于检查各 worker 负载的 get_potential_loads(),以及一次调用完成路由加分发的 generate()。自定义路由器与默认组件注册在同一个服务网格上,并且可以按请求覆盖路由配置:
# Query per-worker load and overlap for custom routing logic
loads = await router.get_potential_loads(token_ids)
# Override routing config based on request properties
# Long contexts benefit from heavier overlap weighting
config = {"overlap_score_weight": 2.0} if len(token_ids) > 8192 else {}
worker_id, dp_rank, overlap = await router.best_worker(
    token_ids,
    request_id="req-123",
    update_indexer=True,
    router_config_override=config
)
# Or bypass the default selector entirely when the harness
# has its own worker selection logic (e.g., session affinity)
stream = await router.generate(
    token_ids, model=model, worker_id=chosen_worker
)
NeMo Agent Toolkit(NAT)团队使用这些 API 构建了一个自定义的在线学习型智能体路由器。他们的路由器从 nvext 注解中提取会话元数据,并将其输入到一个 Thompson Sampling 多臂老虎机式的成本函数中,学习在负载下哪些 worker 对哪些前缀模式表现最好。与 Dynamo 的默认路由相比,他们测得 p50 TTFT 降低到原来的 1/4,p50 每秒 token 数提升 1.5 倍。在中等内存压力下,为对延迟敏感的请求打上优先级标签,最多使 p50 TTFT 降低 63%。实现细节请参见 NAT Dynamo 集成示例。我们很快会将其作为 Dynamo 中的一种路由策略提供。
第三层:KV 缓存管理
智能体工作负载产生的块,其复用价值天差地别:系统提示词每一轮都会被复用,推理 token 则再也不会被用到;但默认的 LRU 淘汰对所有块一视同仁。一次 2 到 30 秒的工具调用停顿,就可能让智能体的整个前缀过期,在其恢复时被迫完整重算。缓存需要理解块的价值,支持跨 worker 共享,并遵循智能体的生命周期边界。
统一淘汰的问题
| 块类型 | 复用模式 | 价值 |
|---|---|---|
| 系统提示词 + 工具定义 | 每一轮 | 最高 |
| 对话历史 | 后续各轮,单调增长 | 高 |
| 思考/推理 token | 推理循环结束后通常不再被复用(占输出的相当大一部分) | 接近零 |
| 子智能体 KV | 用上几轮后智能体即终止,无需保留 | 接近零 |
LRU 只看最近使用情况。在高流量环境下,等待被调用工具完成(智能体等待外部 API 时的 2 到 30 秒)可能会让该智能体的块过期,等智能体恢复时,整个前缀都必须重新计算。要解决这个问题,我们需要给 orchestrator 提供相应的 API,来控制哪些块应当保留、保存在哪里,以及保留多久。
把 KV 缓存当作共享资源
如今,KV 缓存被视为每个 worker 上本地的、临时的资源。一个智能体约 32K token 的系统提示词和工具定义,会在每一个为其请求提供服务的 worker 上各自独立地计算一遍。当主智能体派生出 4 个子智能体,且各自的工具定义有重叠时,如果子智能体落在不同的 worker 上,这段共享前缀就会被重算 4 次。在对 Claude Code 团队会话的分析中,我们直接测量了这一点:队友的平均缓存命中率为 79.4%,而主智能体的 explore 子智能体为 91.3%(读写比分别为 5.0 倍和 11.7 倍),这一差距几乎完全来自每个队友首次调用时的冷启动写入。我们的目标是让高价值的 KV 缓存块对集群中的所有 worker 都可用。本质上就是在冷启动时写入一次,之后任何 worker 都可以随时读取。
SGLang 的 HiCache 和 Dynamo 的 KV Block Manager(KVBM)等方案正在朝着四层内存层级迈进:
块遵循写穿(write-through)路径:当某个 worker 计算出一段前缀的 KV 时,这些块会自动从 GPU 流向 CPU,再流向磁盘。每个块都会按序列哈希在全局注册表中去重。块一旦注册,就是不可变的,任何能访问该存储层的 worker 都可以寻址到它。
这直接解决了子智能体的冷启动问题。当主智能体计算出工具定义和系统提示词时,这些块会写穿到共享存储。当子智能体 1 在另一个 worker 上被创建时,路由器查询 Flash Indexer,在共享存储中找到这些块,worker 便通过 NIXL(RDMA 读取)加载它们,而不是从头重算。子智能体 2 同理。四次冗余的预填充计算变成了一次计算加三次加载。同样的机制也解决了解耦式预填充-解码(disaggregated prefill-decode)服务中的缓存一致性问题。在 disagg 模式下,预填充 worker 计算 KV,并通过 NIXL 把它传给解码 worker。解码 worker 生成 token,产生新的 KV 状态。到了下一轮,预填充 worker 既需要原始前缀,也需要第 1 轮生成的 token,但这些只存在于解码 worker 上。有了共享存储,解码 worker 就可以把新块写入公共层,任何预填充 worker 在下一轮都能取到它们。
多层存储解决了共享和持久化问题,但块仍然要等请求到达 worker 之后才会进入 GPU。智能体系统缺失的一环是预取:harness 可以利用历史时序数据预测智能体的某次工具调用何时可能返回,也就意味着它知道哪些块将在何时被需要。我们正在构建预取钩子,让 harness 能够发出“在下一个请求到来之前,把这些块从存储带到 GPU”的信号。结合(下文的)保留 API,harness 就获得了完整的生命周期控制:固定块以防被淘汰,设置优先级以控制淘汰顺序,并在块被需要之前主动预取。
选择性缓存保留
让块在全局可用解决了共享问题,但没有解决淘汰问题。SGLang 和 vLLM 都通过优先级堆支持基于优先级的淘汰:harness 为每个请求分配一个数值优先级,低优先级的块先被淘汰。TensorRT-LLM 则更进一步,提供了 TokenRangeRetentionConfig(由 Dynamo 团队成员@jthomson04 设计并实现),可以在单个请求内按区域进行控制。
一个请求可以携带零条或多条指令。没有指令的块沿用默认的 LRU 路径,开销为零。淘汰器变成一个双结构系统:一个用于未设优先级块的 LRU 空闲链表(O(1),保持不变),以及一个用于带注解块的优先级队列。harness 可以表达这样的意图:“系统提示词块最后淘汰(priority:100);对话上下文要撑过一次 30 秒的工具调用(duration:45s);解码 token 最先淘汰(priority:1)”,而引擎无需理解背后的原因。
Anthropic 的提示词缓存允许你在其基础设施上把前缀标记为可缓存。Dynamo 的 cache_control API 把同样的语义带到了自托管推理中。当请求包含 cache_control: { type: "ephemeral", ttl: "1h" } 时,路由器会在该 TTL 内把匹配的前缀节点固定在 worker 的 radix 树中,保护它们不被从 worker 的 L2 存储中淘汰。
下一步是把保留机制与分布式缓存连接起来。目前,保留指令只作用于单个 worker 的本地缓存。当某个块在 worker A 上被固定,而下一个请求被路由到 worker B 时,这个固定并不会随之跟过去。把保留语义扩展到 HiCache/KVBM 的共享存储层,意味着 harness 只需固定一次块,就能让它跨 worker 存活:优先级和 TTL 元数据会沿写穿路径随块一起传递,任何从共享存储加载该块的 worker 都会继承其保留策略。结合前文所述的预取钩子,harness 就能对整个内存层级实现端到端的生命周期控制。
智能体生命周期感知
设想一次典型的 Claude Code 会话。主智能体运行 20 多轮,积累起不断增长的对话前缀。途中它会派生出若干 explore 子智能体,每个运行 1 到 3 轮后即终止。它也可能派生出由 4 名专家组成的团队,并行处理不同的子任务,随后终止。到了中途,智能体触及上下文上限并对历史进行摘要,把约 175K token 压缩到约 40K。这些事件每一个都会产生临时性的 KV:永远不会再被引用的块。子智能体终止、上下文摘要和已闭合的推理循环,都会产生临时 KV,而它们与系统提示词这类高价值块占用的是同一份内存。推理模型会放大这一问题:<think>...</think> 块约占生成 token 的 40%,却在推理循环闭合的那一刻就变成临时的了。缺乏生命周期感知,缓存就会对所有这些块一视同仁。

上文的保留原语(优先级、TTL、token 范围)为我们提供了构建模块。缺少的是把它们与会话关联起来的能力。如果 harness 能把子智能体的请求标记为属于某个会话,并把该会话的 KV 标记为临时的,那么淘汰器就可以优先针对这些块,并完全跳过将它们写入共享存储。子智能体终止时,其会话的块会最先被回收。同样的机制也适用于思考 token:引擎可以在生成过程中检测 <think> 的边界,并在插入时把这些块标记为临时的,使它们跳过 L2 写回,并先于普通块被淘汰,而无需任何外部信号。这里的设计空间很大:由 harness 驱动的会话标记、引擎原生的语义检测,以及把二者结合的混合方案。我们正在积极探索多个方向,并预计正确答案会因工作负载和框架而异。
弥合差距
智能体推理中最大的优化空间,在于 harness 所知道的与基础设施所能看到的之间的差距。哪些智能体被阻塞,哪些即将恢复,哪些 KV 值得保留,哪些可以丢弃,所有这些上下文都存在于 harness 层,却从未跨越 API 边界。nvext.agent_hints 是我们弥合这一差距的第一步:一小组结构化信号,让 orchestrator 能够做出有依据的路由、调度和缓存管理决策,而不是把每个请求都当作匿名 token。这是一个 v1 版 API,我们仍在积极演进它。如果你正在构建智能体 harness、为智能体工作负载运行开源模型,或在思考缓存感知的推理,我们希望听到哪些信号对你的用例最重要。欢迎在 GitHub 上联系我们,或在 X 上 @ 我们:@0xishand、@KranenKyle、@flowpow123。