
今天,我们发布 Search Toolkit 公开预览版。Search Toolkit 是一个可组合的框架,用于为 AI 应用构建生产级搜索管道。我们打造它,是因为构建搜索基础设施的团队仍然在“管道胶水”上耗费过多工程时间。多数团队把摄取、检索和评估三类独立工具拼凑在一起,每个工具都有自己的接口,对数据也各有各的假设。Search Toolkit 把这三者纳入同一个框架,共用统一接口,让团队把时间花在提升搜索质量上,而不是维护各种集成。Search Toolkit 是开源的,可以在您的基础设施所在之处运行:云端、本地部署、边缘。
搜索基础设施依然比它应有的样子更难搞。
大多数构建检索系统的团队,花在拼装基础设施上的时间多于提升搜索质量的时间。摄取需要一套工具,检索需要另一套。评估即便有,也是用单独的框架外挂上去的,对数据形态另有一套假设。
团队反映,往往要经过数周的集成工作,才能对自己的数据跑通哪怕一次查询。而要衡量检索器是否返回了正确的结果,常常还需要另一套工具链。对于构建 RAG 工作流或内部知识系统的组织来说,这种开销在每一层都会成倍放大。
适用场景。
企业搜索。大多数组织并不是只有一个搜索问题,而是有十几个:内部 wiki、客服工单系统、文档库、文件存储、代码库。每个来源的结构不同、元数据不同,要建好索引所需的处理方式也不同。团队通常只能为每个来源单独构建一条摄取管道,各有各的解析逻辑、分块策略,以及对“文档”长什么样的假设。结果要么是一组彼此孤立、无法联合搜索的索引,要么是一个试图统一它们的脆弱的自定义层,而这一层本身又成了维护负担。Search Toolkit 在单一框架内为不同来源类型提供一致的处理和索引模式,团队新增数据源时无需每次都重建管道。
RAG 与检索质量。当 RAG 系统返回的结果不理想时,首先要问的是问题出在检索还是生成。实际上,大多数团队没有清晰的办法回答这个问题。他们调整提示词、调整分块策略、更换模型,却不知道检索器一开始是否找出了正确的上下文。即使有团队专注于检索,也往往缺乏工具,无法在自己的数据上、用自己的相关性判定来严谨地比较各种策略。另一种办法是为每次实验编写自定义的评估脚本。Search Toolkit 内置评估功能,可独立衡量检索器的表现,因此你可以把检索质量与生成质量区分开,并随着语料库的演变比较不同配置。
垂直领域检索。法律文件、病历、代码库、财务披露。现成的检索器是在通用文本上训练的,面对专业术语、文档结构以及与网页搜索不同的相关性标准,往往力不从心。需要领域调优检索的团队,最终常常要从零构建自定义检索基础设施,维护成本高昂,也难以评估。
智能体时代的搜索
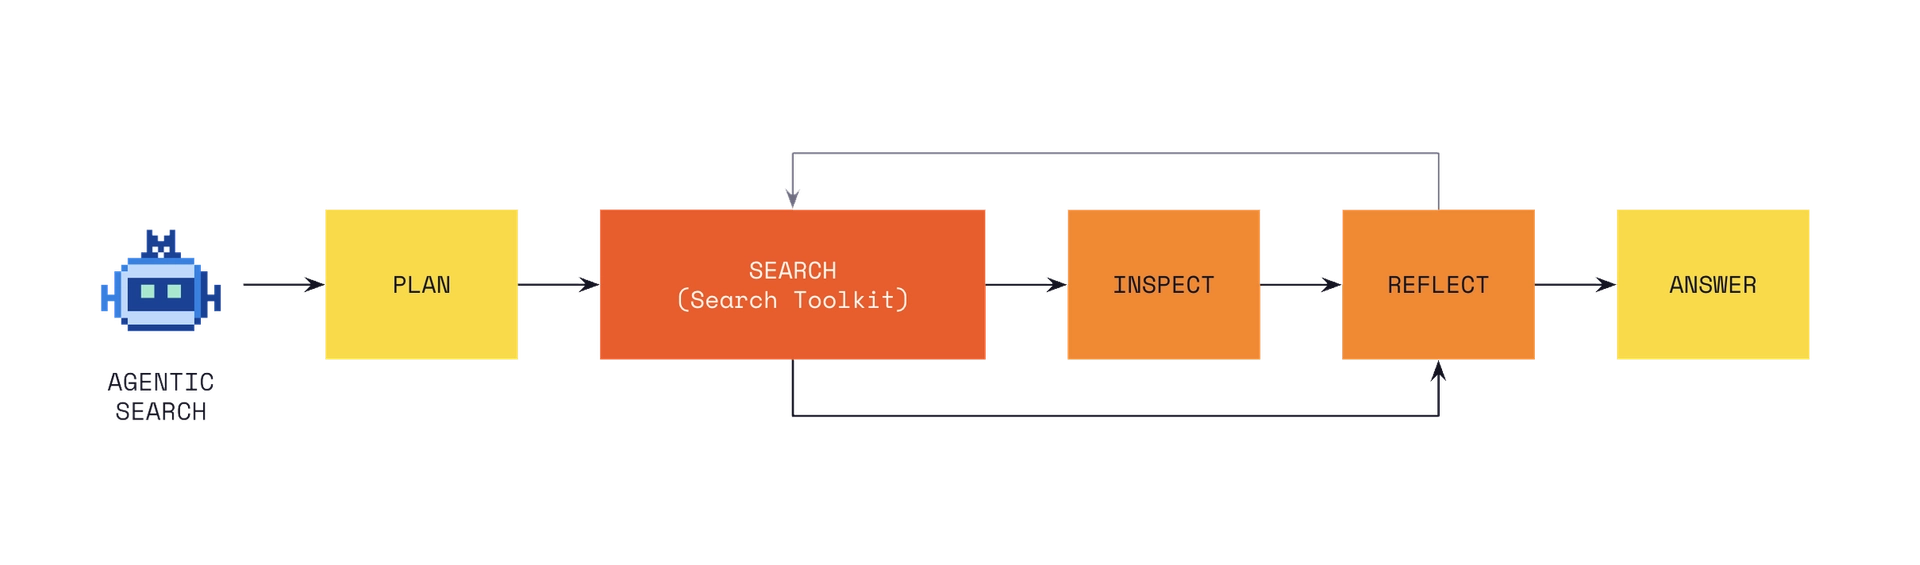
处理企业任务的智能体需要获取企业上下文。它们自主地、高频地做出检索决策,因此其底层搜索基础设施的质量会直接影响下游的每一步。在大型文档语料库中进行搜索时,智能体对索引执行语义搜索,从而以低延迟获得精确的结果。
智能体同样需要实时数据。借助Connectors,它们可以通过 MCP 集成直接从 CRM、代码仓库和生产力工具等源系统中拉取数据。需要在海量内容中搜索时,智能体可以查询已建立索引的语料库;需要最新状态时,则可以从源系统拉取实时数据。Search Toolkit 为你的智能体提供了一条高质量的索引搜索路径,可与实时检索配合调用。
内容概览。
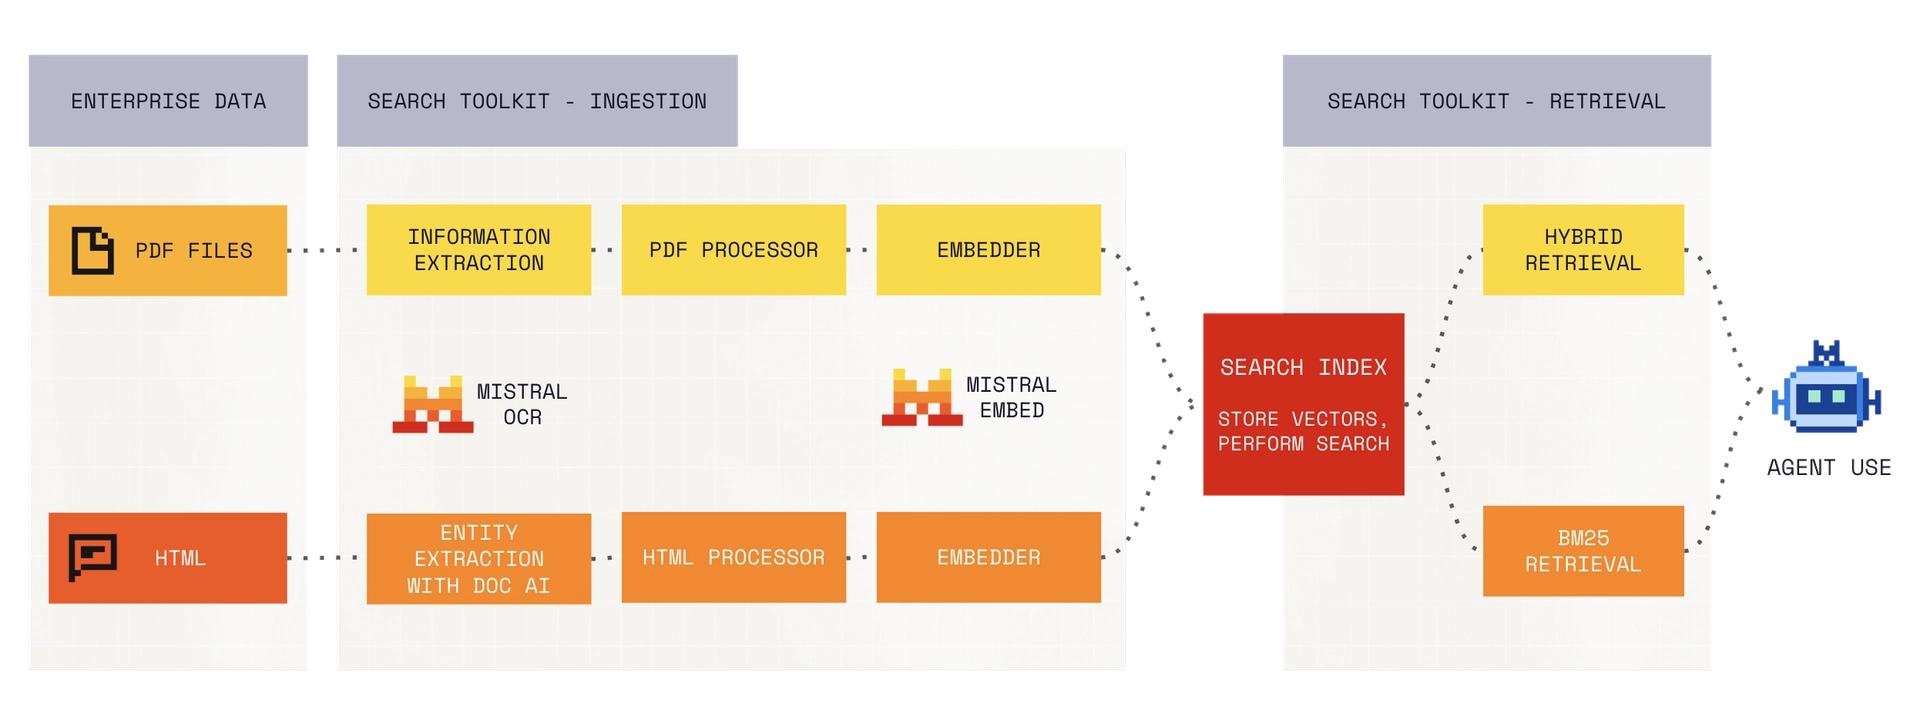
摄取。通过可配置的管道对来自多个来源的数据建立索引并进行处理。Search Toolkit 负责文档解析、分块和嵌入生成。自定义文档格式和预处理步骤可通过标准的适配器接口接入。
检索。Search Toolkit 自带 BM25 稀疏检索、基于嵌入的稠密检索,以及将两者结合的混合配置。每一种都可以根据你的数据和用例进行配置。
评估。用内置指标衡量搜索质量:召回率、精确率、MRR 和 NDCG。可以针对你自己的测试集运行评估,并排比较不同的检索器配置,跨版本追踪质量变化。
所有模块共用同一套配置接口。换掉索引器、替换检索器、加入评估器,管道的其余部分会自动适配。
Search Toolkit 面向企业的高级用例设计,并已在金融服务、制造业、公共部门以及传媒 & 娱乐等垂直行业经过实战检验。CMA CGM 将 Search Toolkit 与 Voxtral 结合使用,帮助记者识别假新闻。该管道处理来自三个不同数据源的音频,端到端在 15 秒内返回警报。
观看演示
▶ https://www.youtube.com/watch?v=Kj7Ewd64QTA
快速上手。
试用 Search Toolkit 最快的方式是使用我们的入门应用模板。
前提条件
安装 Docker。在生成的项目中还需要 uv。
创建新项目脚手架
uvx copier copy gh:mistralai/search-starter-app my-search-project
cd my-search-project
运行
# Start Vespa locally with Docker
make setup-vespa
# Index sample data
make ingest path=sample_data/hello.txt
# Run a query
make search query="hello world"
该模板包含:
- 预配置的 Vespa 索引
- 混合检索(BM25 + 向量)
- 示例数据和摄取管道
完整详情请参阅入门应用 README。
下一步
试过入门应用之后,可以继续深入:
- 调优你的摄取管道:针对特定文件类型配置解析器、分块策略、嵌入模型和提取器,以处理你的数据源。
- 管理 Vespa schema & 相关性:针对你的用例优化索引和排序配置。
- 打造你理想中的检索:利用 LLM 查询改写、重排序和混合检索等高级功能。
完整参考请参阅 Search Toolkit 文档。