核心要点
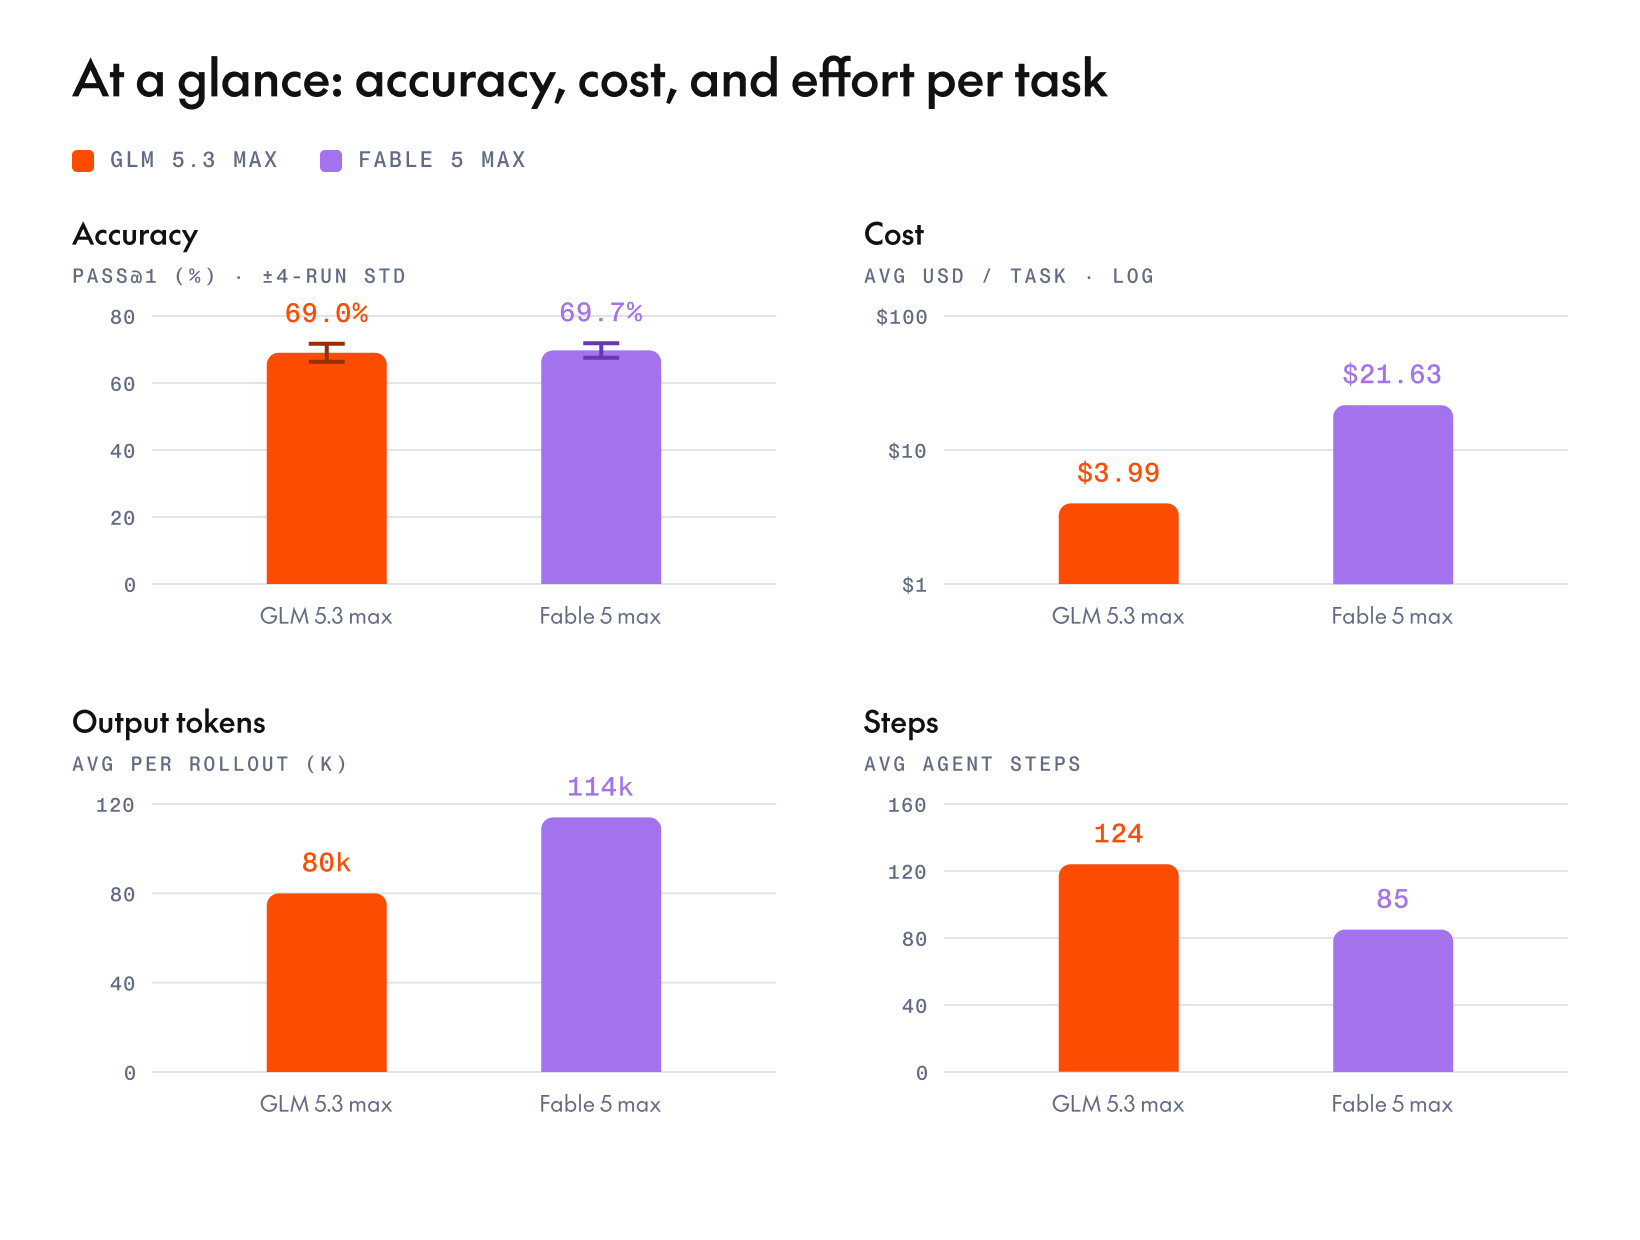
在 DeepSWE 的准确率上,GLM-5.3 与 Claude Fable 5 的差距在误差范围之内,但 GLM-5.3 每个任务的成本只有后者的五分之一,并且在所有多次尝试的指标上都胜出。当两个模型的质量如此接近时,价格差距就成了决策的全部。
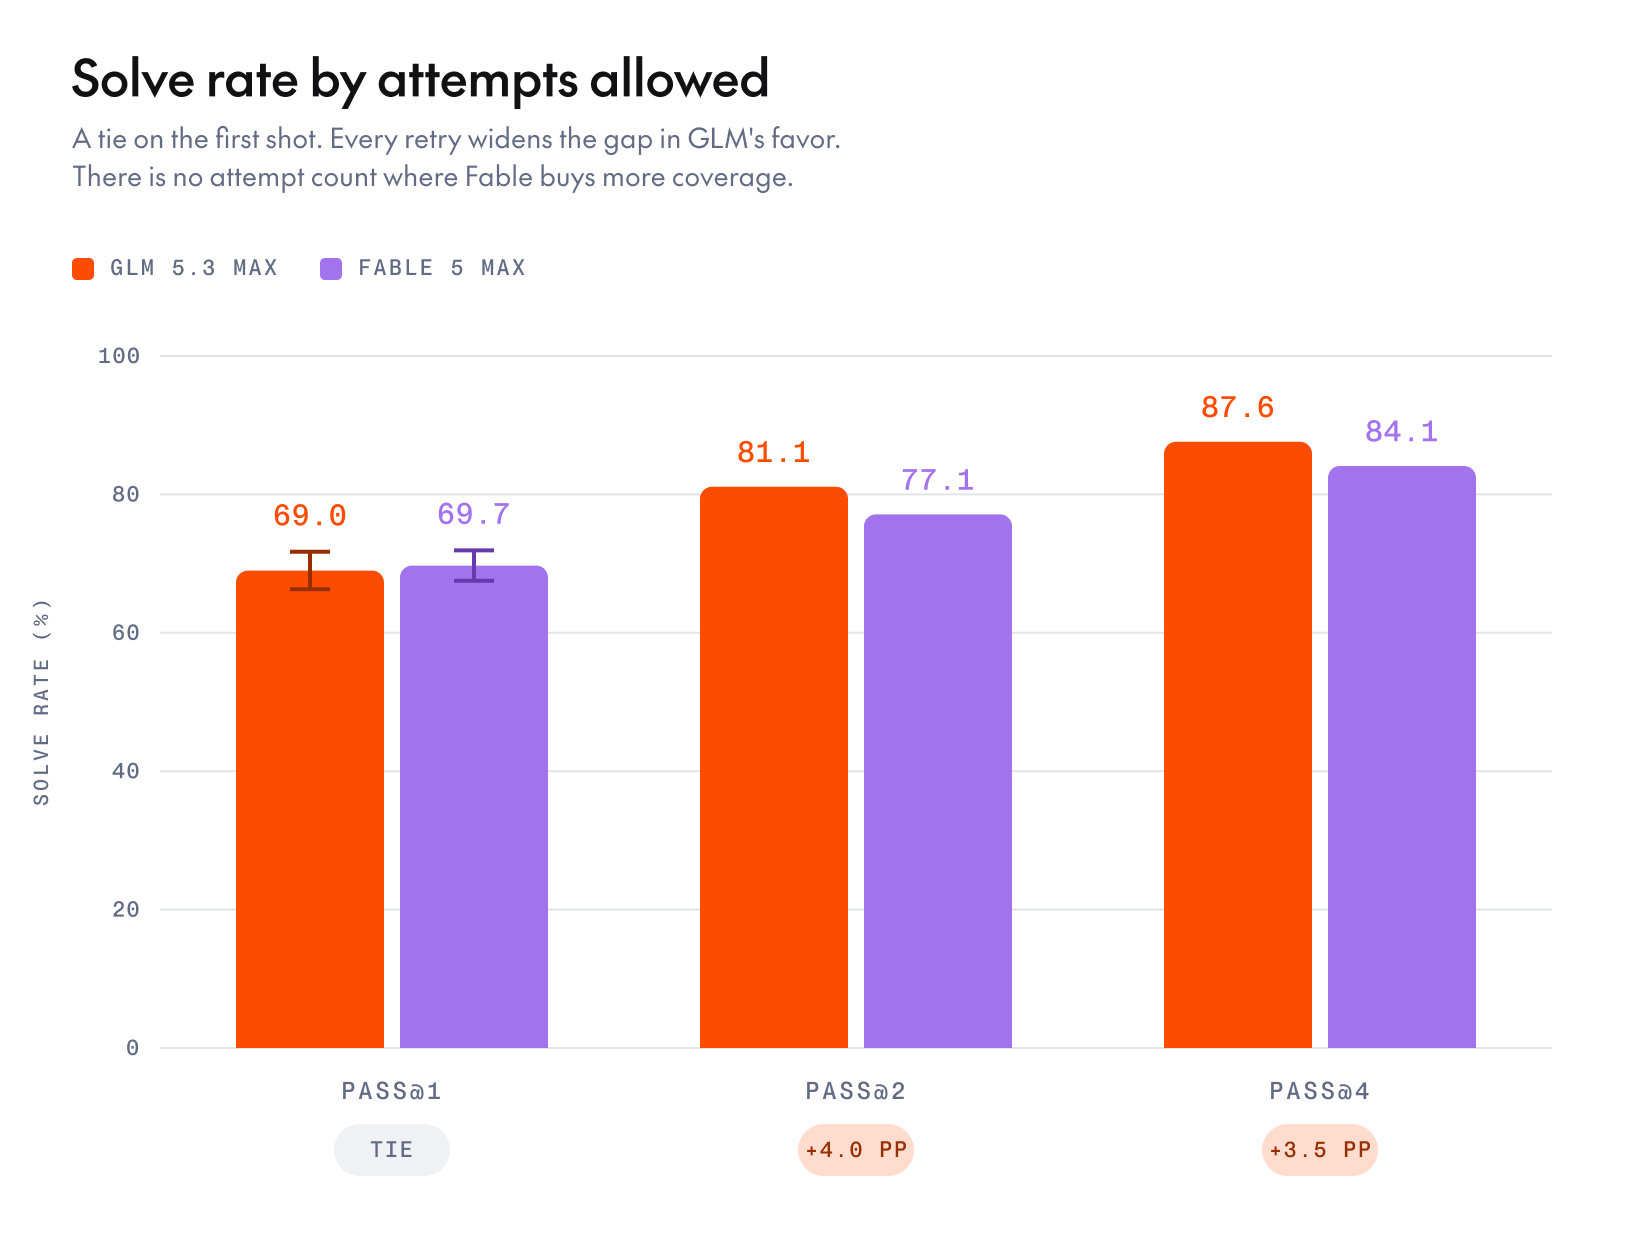
- 首次尝试不分高下。Fable 5 的 pass@1 为 69.7%,GLM-5.3 为 69.0%,0.7 个百分点的差距在双方的误差范围之内。
- GLM-5.3 在重试上占优。它在 pass@2(81.1% 对 77.1%)和 pass@4(87.6% 对 84.1%)上都领先,因此不仅价格更低,上限也更高。
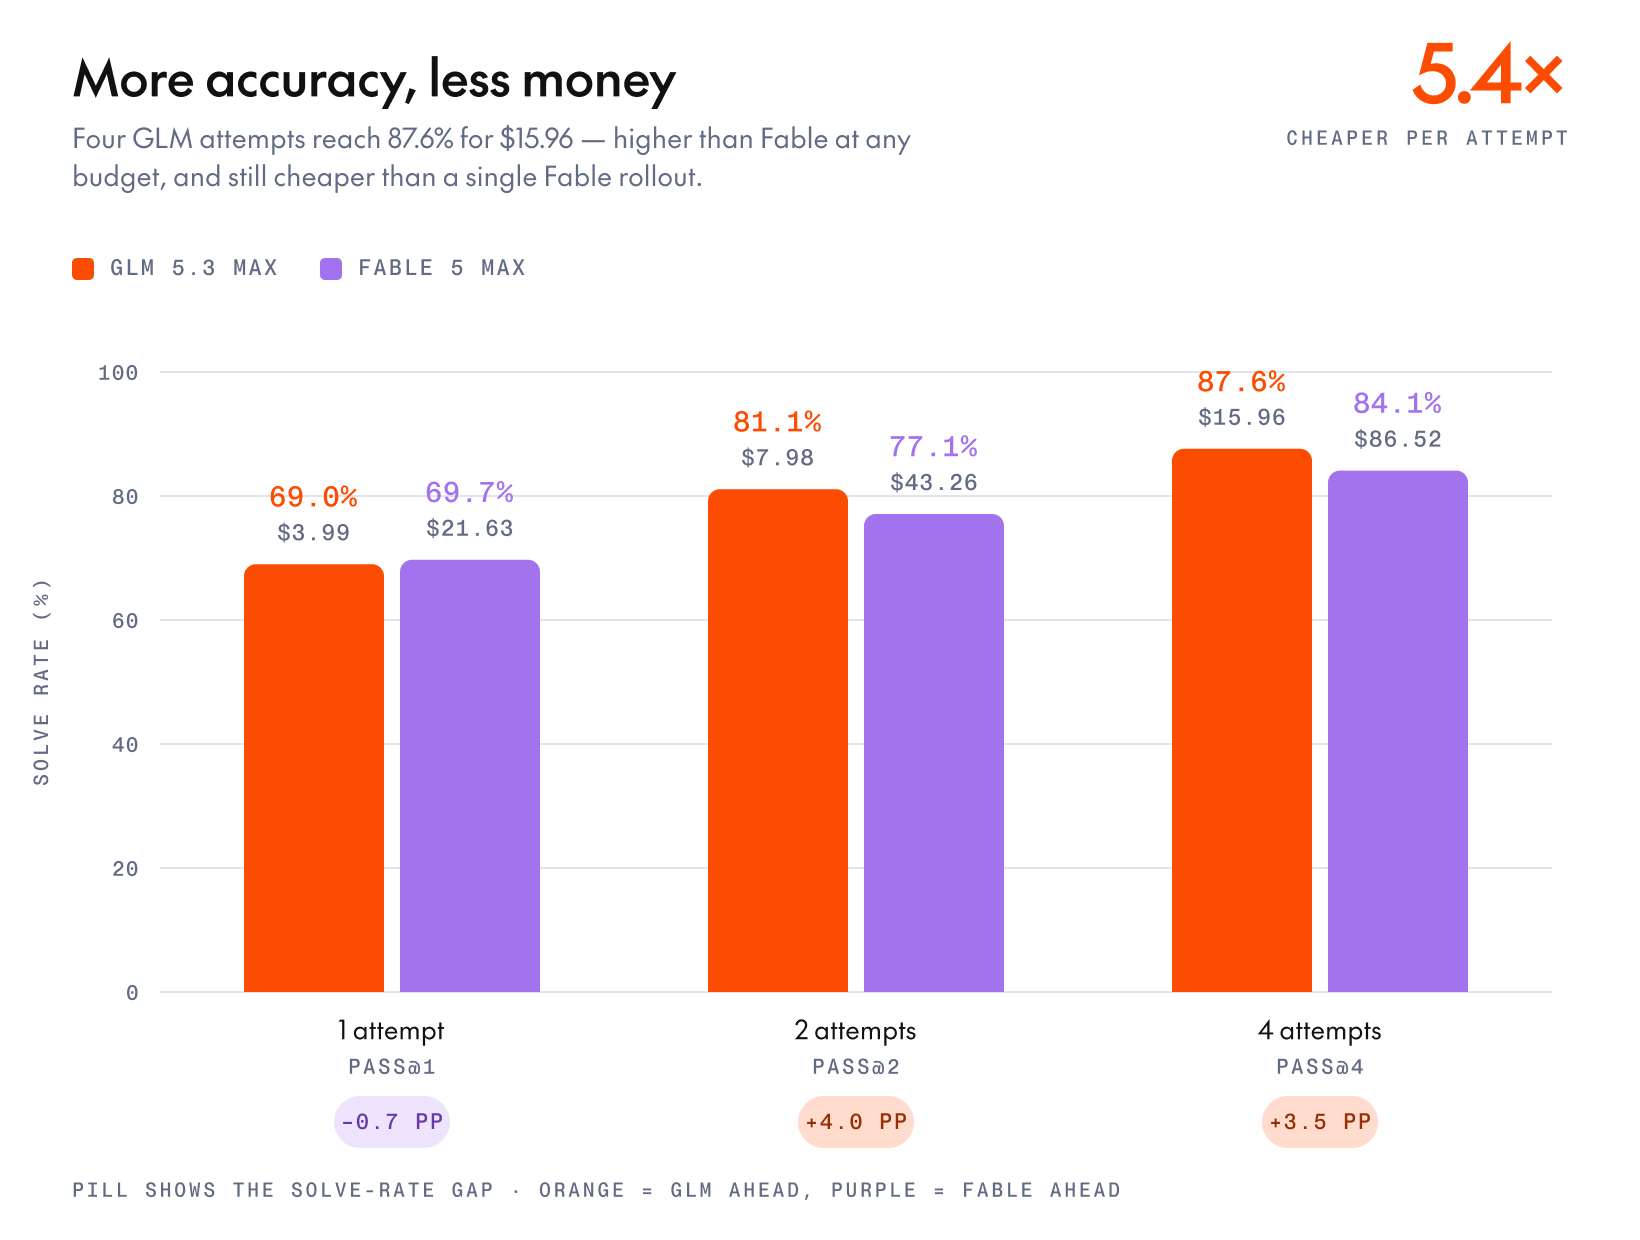
- 成本差距为 5.4 倍。每次 rollout 为 \$3.99,对 \$21.63。每花 100 美元,GLM-5.3 能解决 17 个任务,Fable 只能解决 3 个。
- 二者近乎可以互相替代。逐任务相关性为 0.65,是这组数据中一致性最高的,所以同时运行两个模型几乎不会增加覆盖面。保留成本更低的模型,只在 Rust 和序列化类工作上升级到 Fable。
在我们对 GLM-5.3 与 Claude Fable 5 在 DeepSWE 上的比较中(DeepSWE 是一个跨多种任务类型和编程语言、测试模型软件工程能力的基准测试),这两个模型在质量上几乎无法区分。Fable 5 的 pass@1 领先 0.7 个百分点,但每次 rollout 的成本高出 5.4 倍,也是 DeepSWE 榜单上最昂贵的单一配置。这使得真正值得问的问题变得很窄:当准确率相同时,这笔溢价买到了什么?
DeepSWE · 正面对比
GLM 5.3 与 Claude Fable 5 一览
| 模型 | Pass@1 | 平均成本 | 每 100 美元解决数 | 输出 token | 步数 |
|---|---|---|---|---|---|
| glm-5.3 [max] | 69.0% ± 2.7% | $3.99 | 17 | 80k | 124 |
| claude-fable-5 [max] | 69.7% ± 2.3% | $21.63 | 3 | 114k | 85 |
我们根据已公布的逐次试验记录,让 GLM-5.3(max)与 Claude Fable 5(max)在全部 113 个 DeepSWE 任务上各跑四次试验:共 904 次 rollout,每个模型 452 次。两者都属于严谨、低回归的一类,所以表现如此相似。下面所有数字都来自这次运行,因此可能与其他公开的 GLM-5.3 对 Claude Fable 5 评分表有所不同。
DeepSWE 计分板:pass@1 与 pass@k
单次尝试,二者打平。按 DeepSWE 官方计分,Fable 5 首次尝试解决 69.7% 的任务,GLM-5.3 为 69.0%,差距远在噪声范围之内。一旦允许重试,二者就分出了高下,而且是 GLM 占优。两次尝试时,GLM-5.3 以 81.1% 对 77.1% 领先;四次时以 87.6% 对 84.1% 领先。
这个开放模型以一小部分的价格达到了 Fable 的首次尝试准确率,并且在允许重试后上限更高。无论尝试多少次,花 5.4 倍的价钱买 Fable 都买不到更多的覆盖面。
成本比较:GLM-5.3 与 Claude Fable 5 的定价
GLM-5.3 每次 rollout 为 $3.99,Fable 为 \$21.63,前者成本低 5.4 倍:每 100 美元解决 17 个任务,而 Fable 只有 3 个。Fable 是榜单上最昂贵的配置,而 GLM 的低价并没有以速度为代价。GLM-5.3 平均每次 rollout 35 分钟,Fable 为 34 分钟,大致持平。
token 概况解释了这次运行的特点。GLM-5.3 的输出更精简(80k 输出 token,Fable 为 114k),尽管步数更多(124 对 85)。Fable 每一步写得更多,GLM 则走更多、成本更低的步骤。两者都不更快,但只有一个的成本是另一个的五分之一。
覆盖面与可靠性:GLM-5.3 与 Fable 5 的差异
把 pass@1 分解为覆盖面(至少解决一次的任务)和可靠性(这些任务上的通过率),二者落在平面上相近的角落,GLM 略微更靠外。GLM-5.3 的覆盖面更高,为 87.6%,Fable 为 84.1%。Fable 每次尝试略为稳定,可靠性为 82.0%,GLM 为 78.8%,并且四次全对的任务更多(56 对 48)。
实际上,两者都像是严谨的通才,GLM 用一点点单次可靠性,换来了在整个基准上明显更广的覆盖。
失败模式:各自是怎么出错的
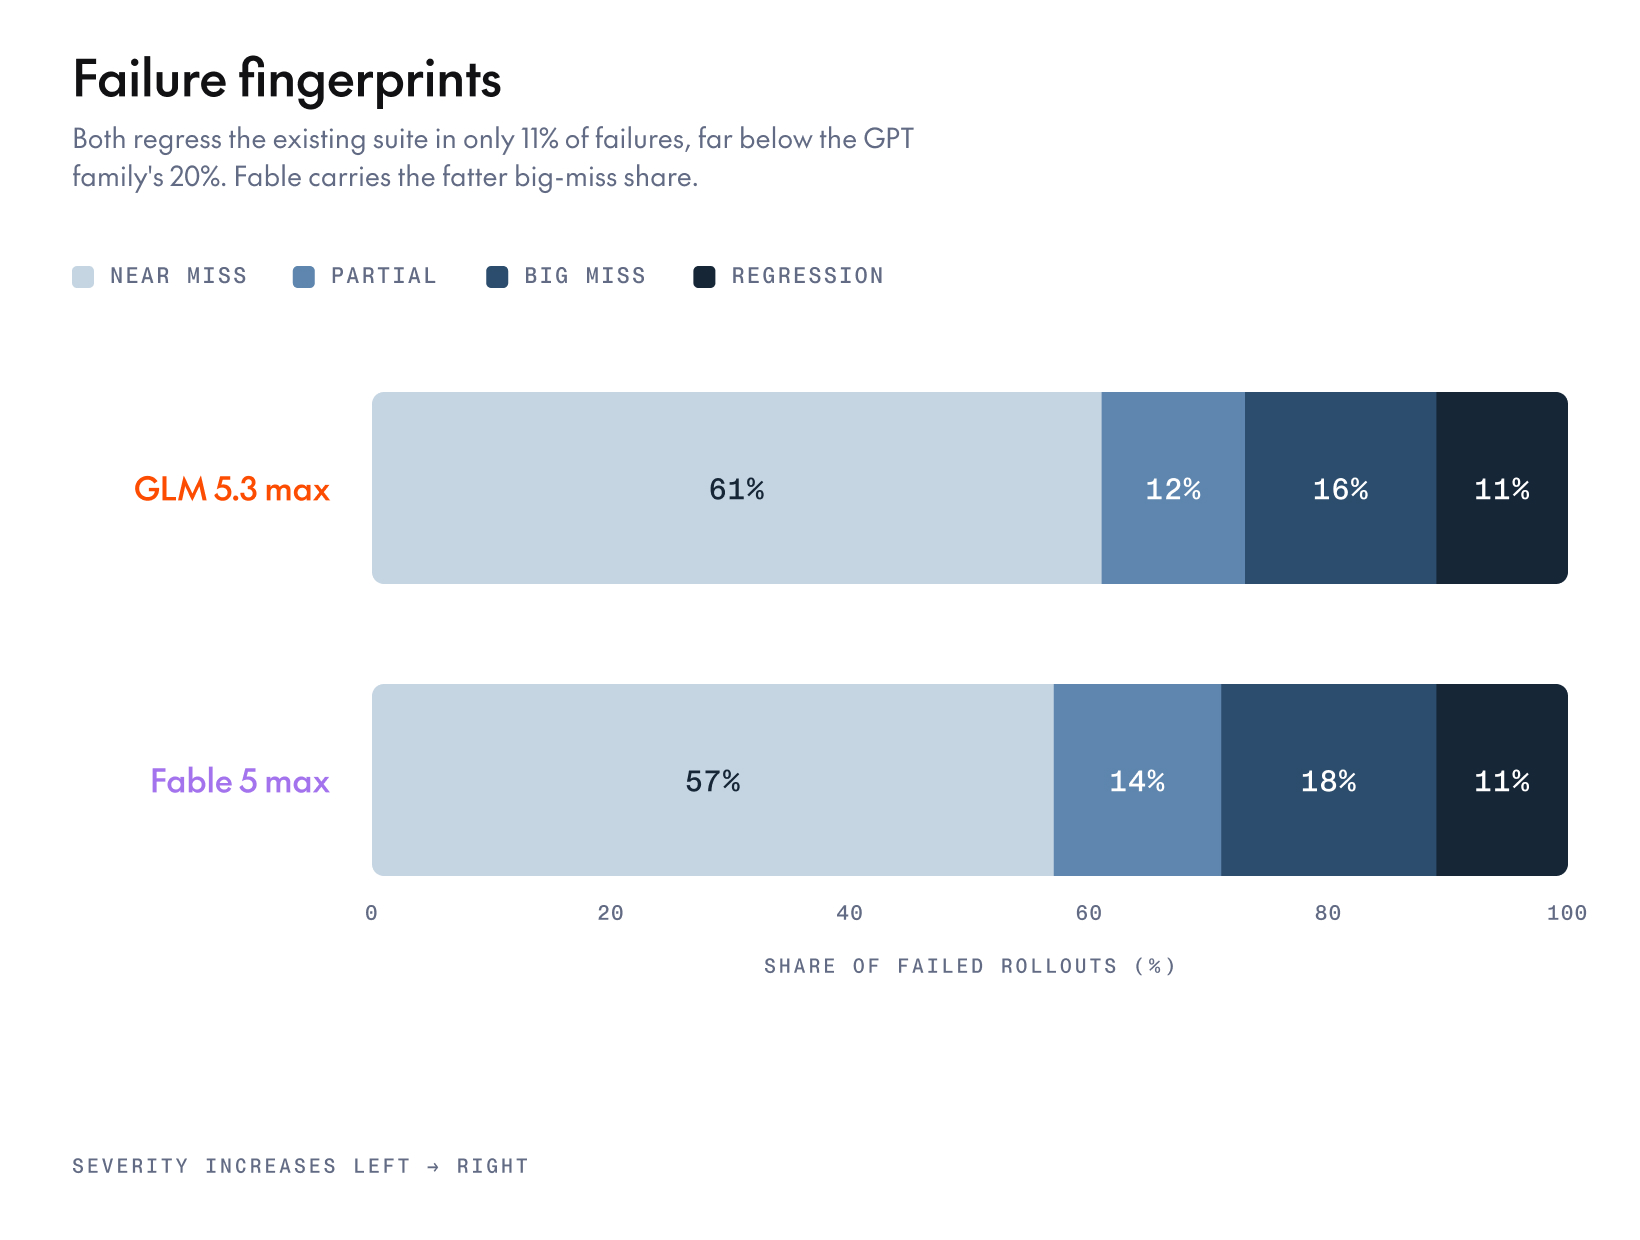
在这一点上,两者的家族相似性最为明显。两个模型在失败案例中破坏现有测试套件的比例都只有 11%,远低于 GPT 系列的 20%,因此二者的结果都可以放心采纳,无需严格的回归把关。
差别很小。Fable 的严重偏离占比更大(18%,GLM 为 16%),也就是说,它出错时略微更常错得离谱。GLM 因差一点点而失败的情况稍多(61% 对 57%)。总体而言,这两个模型的失败方式同样严谨,这也正是它们的结果高度相关的原因。
按任务类型看各自的优势
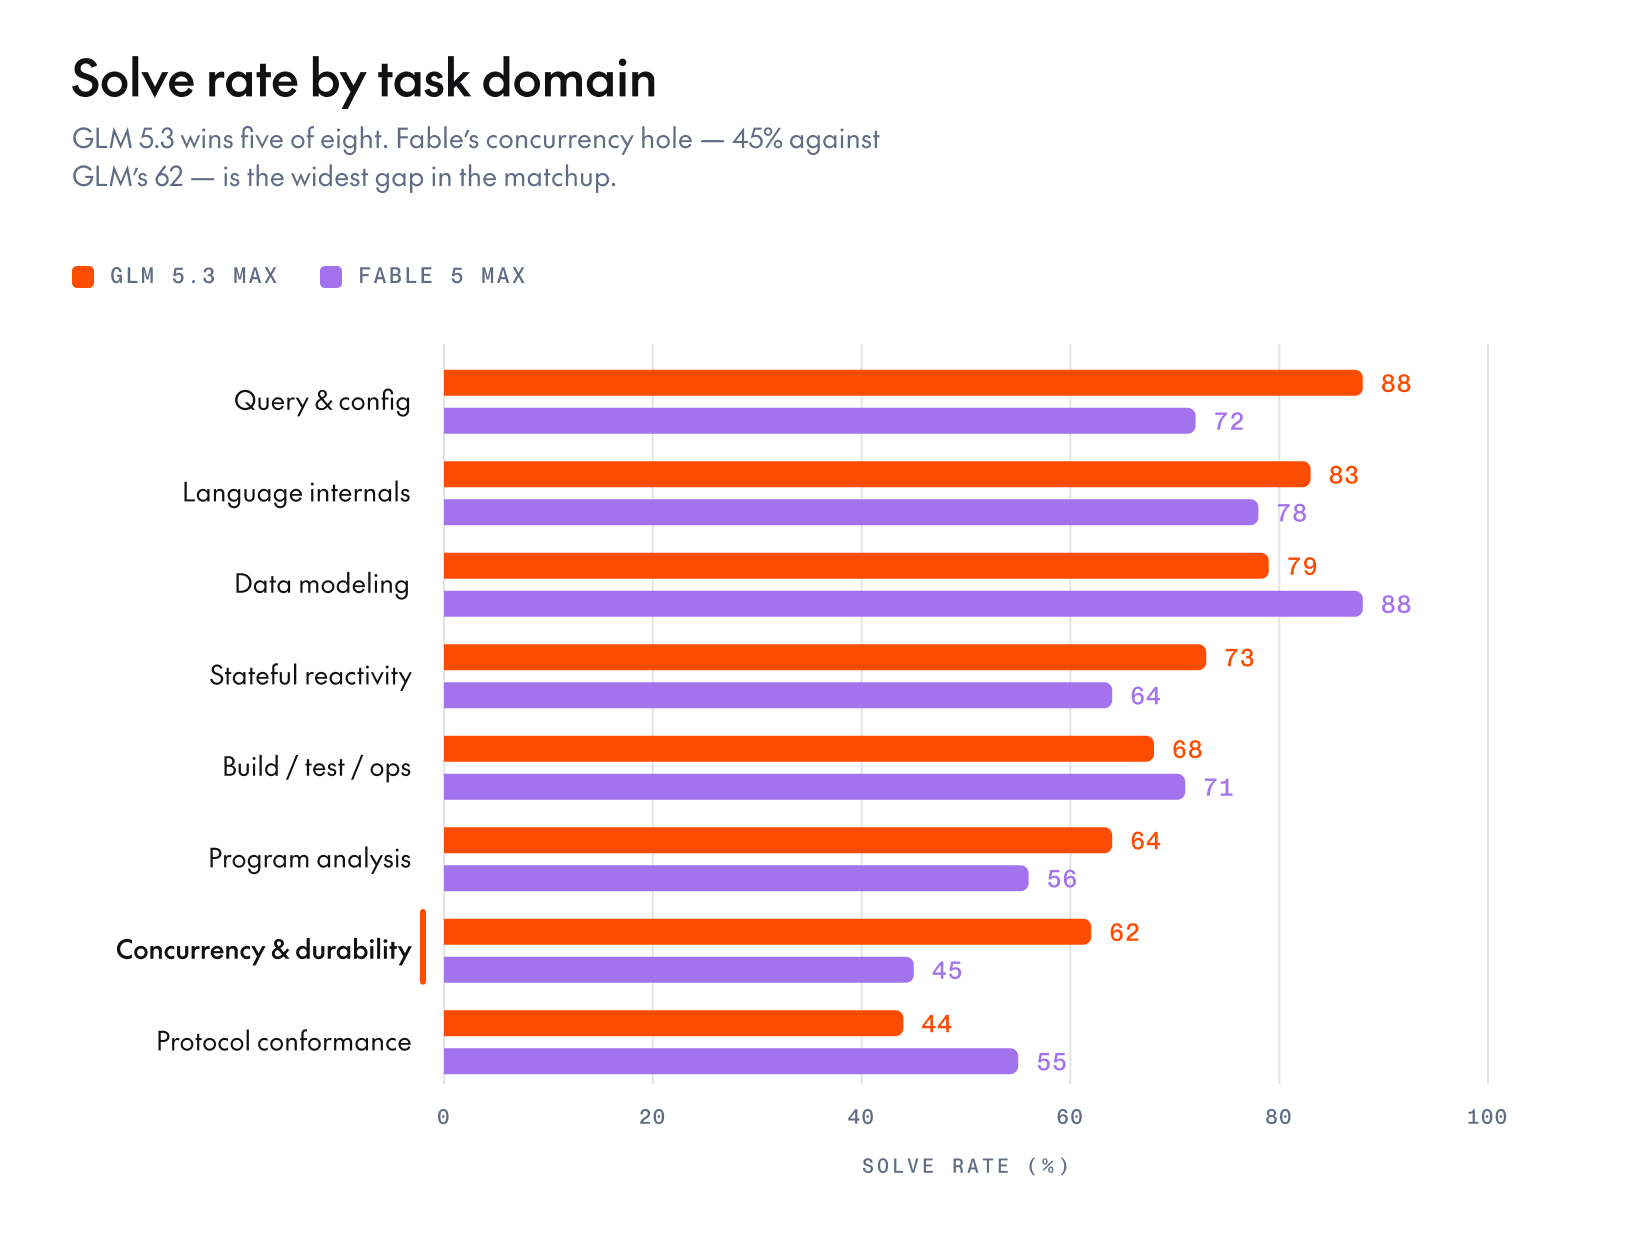
尽管 pass@1 打平,两者的领域分布并不相同。GLM-5.3 拿下结构化、解释器类的工作:查询与配置(88 对 72)、语言与运行时内部(83 对 78)、有状态响应式(73 对 64)、并发与持久性(62 对 45),以及程序分析(64 对 56)。并发这一项,在 Fable 最弱的领域里拉开了 17 个百分点的差距。
Fable 则以精确契约类的领域作答:数据建模与序列化(88 对 79)、构建与运维(71 对 68),以及协议一致性(55 对 44),这是 GLM 最弱的领域。GLM 赢下五个领域,Fable 赢下三个,而 Fable 在并发上的 45% 是唯一应当完全避免使用它的场景。
按编程语言比较 GLM-5.3 与 Claude Fable 5
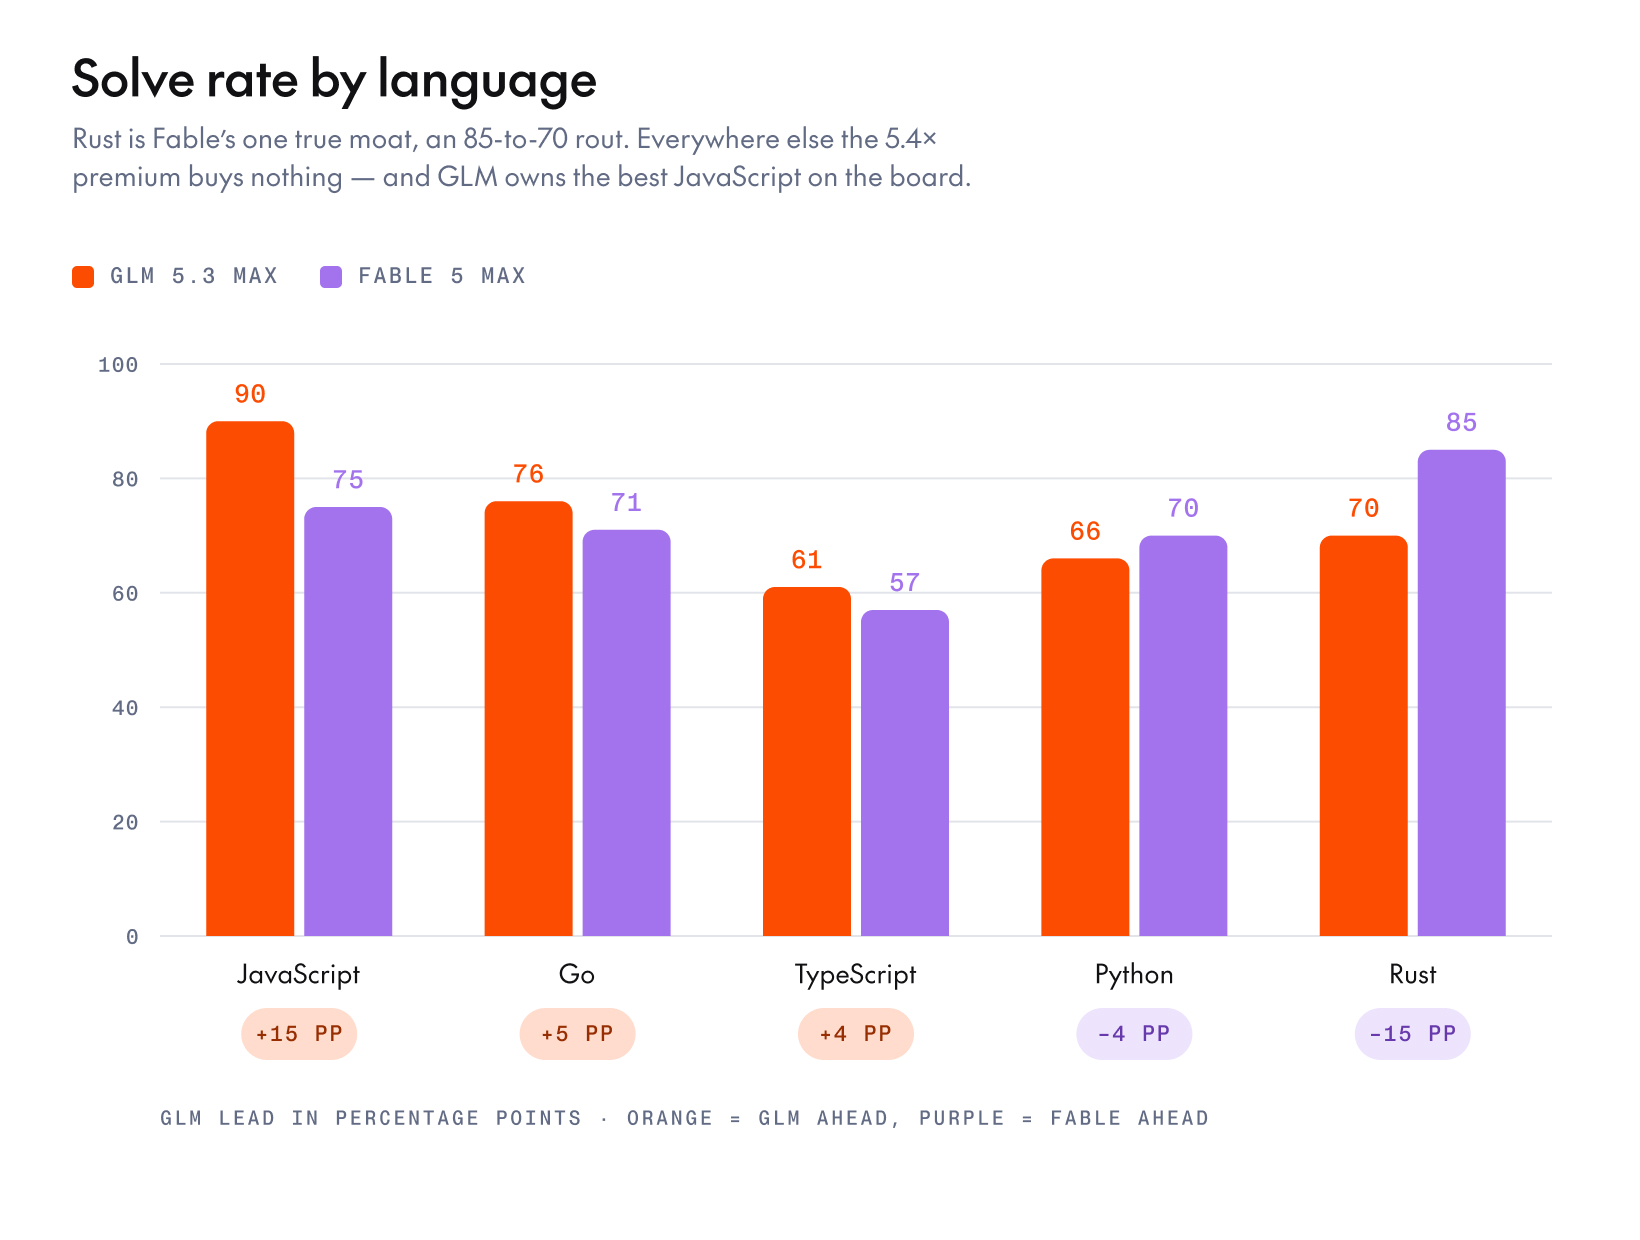
Fable 的优势几乎完全押在一门语言上。它的 Rust 是 85%,GLM 是 70%,领先 15 个百分点,是这场对决中差距最大的单一语言。以序列化为主的工作自然是这一优势的搭档。
GLM 的回应是榜单上最好的 JavaScript(90 对 75),在 Go(76 对 71)和 TypeScript(61 对 57)上接近持平。Fable 守住了 Python(70 对 66)。除了 Rust 和以序列化为主的工作,没有哪门语言能让 Fable 的 5.4 倍溢价换来有意义的准确率优势。
GLM-5.3 与 Claude Fable 5 有多相似?
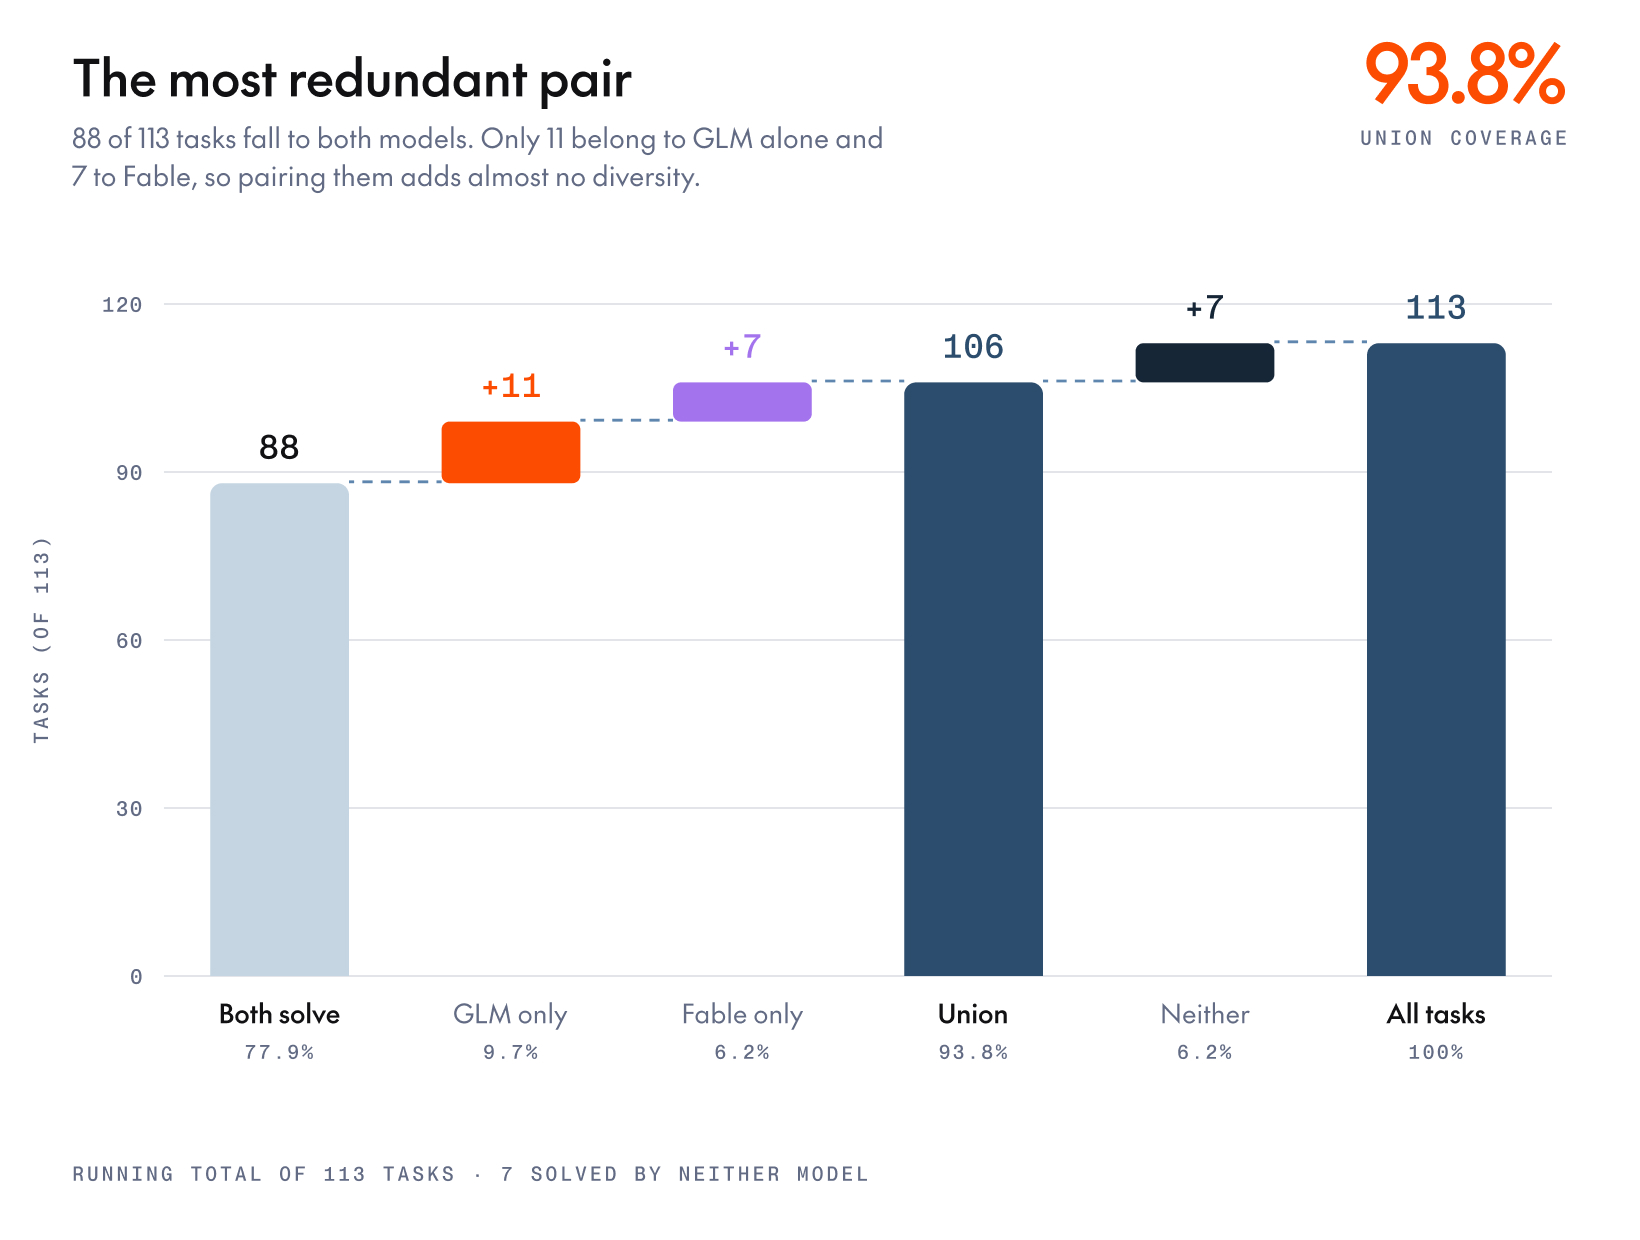
对于想同时运行两者的人来说,问题就在这里。GLM-5.3 与 Fable 的逐任务相关性为 0.65,是这组数据中所有配对里一致性最高的。两者都解决了 88 个任务。只有 GLM 解决的有 11 个,只有 Fable 解决的有 7 个,另有 7 个任务两者都没做出来,并且双方都没有出现“四次全对对四次全错”的分歧。
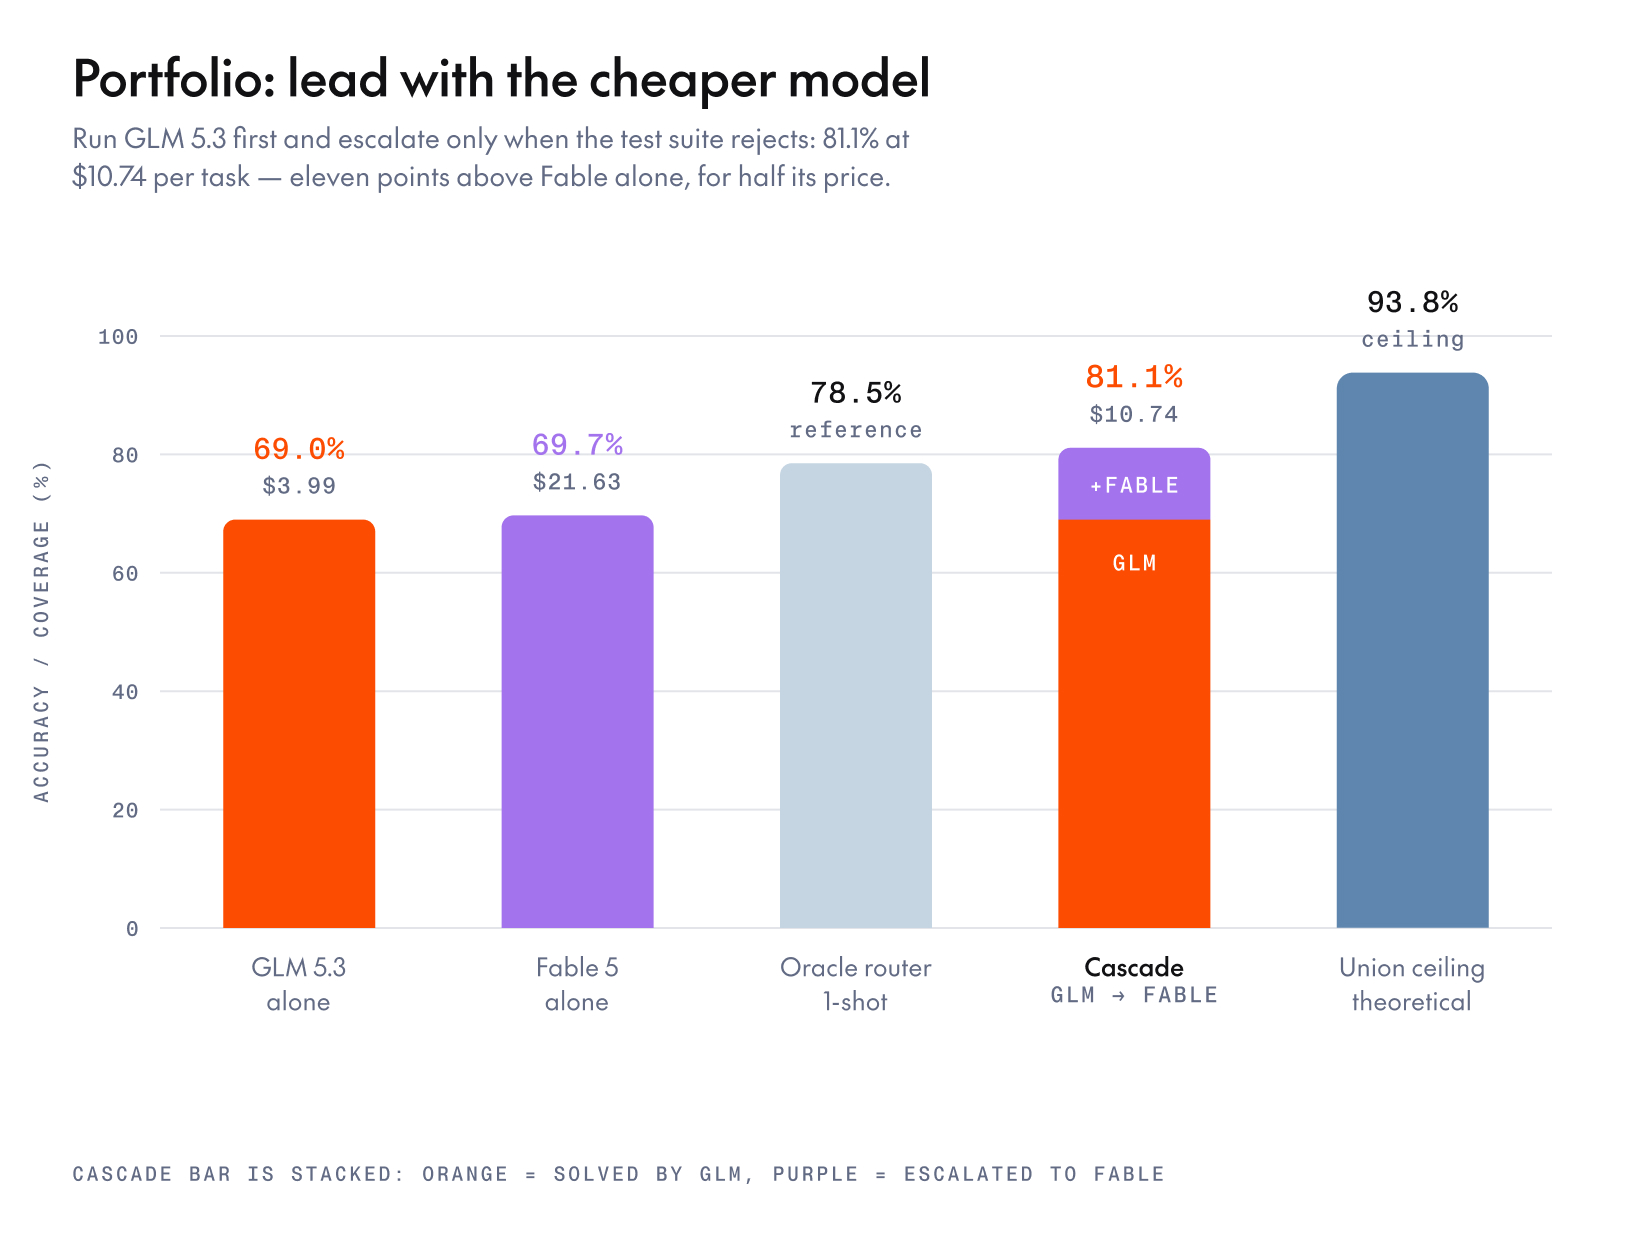
它们的并集覆盖了 113 个任务中的 106 个(93.8%),但由于它们成功和失败的任务大体相同,把它们配对所增加的多样性,比任何一个与 GPT 系列模型配对都要少。它们近乎可以互相替代,而当两个模型可以互相替代时,你应该留下成本更低的那个。
在二者之间路由:组合策略
如果你确实要同时运行两者,顺序和经济账仍然支持把开放模型放在前面。先运行 GLM-5.3,只有当你的测试套件拒绝其答案时才升级到 Fable:每个任务 \$10.74,解决率 81.1%。这比单用 Fable(69.7%)高出十一个百分点,而每个任务的价格只有 Fable 自身(\$21.63)的一半。
考虑到 0.65 的相关性,更坦率的建议要简单得多:对大多数工作,单用 GLM-5.3 就能拿下 Fable 几乎所有的成果,而成本只有五分之一,只有在 Rust 和序列化这两个特长上才值得升级到 Fable。
这意味着什么
Fable 5 与 GLM-5.3 在首次尝试准确率上是统计意义上的平局,但对等也就到此为止。GLM-5.3 成本低 5.4 倍,pass@2、pass@4 和覆盖面更高,输出更精简,在回归上同样严谨,并且赢下八个领域中的五个,外加榜单上最好的 JavaScript。
Fable 是这里测得最昂贵的模型,相比 GLM 只赢下三个领域,外加 Rust 和序列化上真正的优势。由于二者在 0.65 的相关性下近乎可以互相替代,同时运行两者的组合收益很小。务实的做法是把 GLM-5.3 作为默认选择,把 Fable 作为一个范围很窄、成本高昂的升级选项,用于重度依赖 Rust 或对序列化要求苛刻的任务。欢迎了解全新的 GLM 5.3 Flash API。
DeepSWE · 完整结果
GLM 5.3 与 Claude Fable 5 逐项指标对比
| 指标 | GLM 5.3 [max] | Fable 5 [max] |
|---|---|---|
| pass@1(官方计分) | 69.0% | 69.7% |
| pass@1(错误按失败计) | 68.8% | 67.3% |
| pass@2 / pass@4 | 81.1 / 87.6% | 77.1 / 84.1% |
| 覆盖面 / 可靠性 | 87.6 / 78.8% | 84.1 / 82.0% |
| 稳定(4/4)/ 死胡同(0/4) | 48 / 14 | 56 / 18 |
| 每次 rollout 成本 / 总成本 | $3.99 / $1,806 | $21.63 / $9,346 |
| 每 100 美元解决数 | 17 | 3 |
| 平均分钟数 / 步数 | 35 / 124 | 34 / 85 |
| 平均峰值上下文 / 输出 token | 155k / 80k | 205k / 114k |
| 失败剖析(差一点 / 严重偏离 / 回归) | 61% / 16% / 11% | 57% / 18% / 11% |
| 赢下的领域(共 8 个) | 5 | 3 |
| 赢下的语言 | 2(JavaScript、TypeScript) | 3(Rust 大幅领先、Python、Go) |
| 逐任务相关性 / 并集 | 0.65 / 113 个中的 106 个(93.8%) | |
| 级联 GLM → Fable(准确率 / 成本) | 81.1% / $10.74(单用 Fable 为 69.7% / $21.63) | |
| 理想化单次路由器(Oracle) | 78.5% | |
| 基础设施错误 | 1 | 16 |
113 个 DeepSWE 任务 · 每个配置 4 次试验 · 均为最高推理强度 · 共 904 次 rollout
常见问题
GLM-5.3 比 Claude Fable 5 更好吗?
在 DeepSWE 上,二者在首次尝试中是统计意义上的平局:Fable 5 的 pass@1 为 69.7%,GLM-5.3 为 69.0%。此后的每一项指标都是 GLM-5.3 胜出,包括 pass@2(81.1% 对 77.1%)、pass@4(87.6% 对 84.1%)和覆盖面,而且每次 rollout 的成本低 5.4 倍。Fable 四次全对的任务更多(56 对 48),所以在任何单次尝试上稍微更稳定。
GLM-5.3 比 Claude Fable 5 便宜多少?
在我们的运行中,在最高推理强度下,GLM-5.3 每次 rollout 成本为 \$3.99,Claude Fable 5 为 \$21.63,相差 5.4 倍。按每个已解决任务计算,GLM-5.3 每 100 美元解决 17 个,Fable 为 3 个。
写代码用 GLM-5.3 还是 Claude Fable 5 更好?
这取决于语言和任务类型。GLM-5.3 在 JavaScript(90 对 75)、Go(76 对 71)和 TypeScript(61 对 57)上占优,并在八个任务领域中赢下五个,包括并发与持久性,在该领域以 62 对 45 领先。Claude Fable 5 在 Rust(85 对 70)、Python(70 对 66)以及精确契约类领域领先,其中数据建模与序列化为 88 对 79。
我应该在 GLM-5.3 和 Claude Fable 5 之间做路由吗?
只宜有选择地做。这两个模型的逐任务相关性是我们测过的所有配对中最高的(0.65),因此它们成功和失败的任务大体相同,并集覆盖 113 个任务中的 106 个。GLM 优先的级联确实能以每个任务 \$10.74 达到 81.1%,远高于单用 Fable,但对大多数团队来说,更大的收益只是默认使用 GLM-5.3,把 Fable 留给重度依赖 Rust 或对序列化要求苛刻的工作。
GLM-5.3 是开放权重的吗?
是的。GLM-5.3 是开放权重模型,可以自行部署,也可以通过 Together AI 等推理服务商使用。Claude Fable 5 是闭源模型,只能通过 Anthropic 及其合作伙伴获得。
DeepSWE 上的 pass@k 是什么?
pass@k 衡量的是对某个任务的 k 次尝试中,是否至少有一次通过隐藏的测试套件。pass@1 奖励一次就做对,而更高的 k 则奖励那些经过多次尝试最终能得出解法的模型。随着 k 增大,GLM-5.3 的优势也在扩大。
方法与注意事项
- 数据:DeepSWE v1.1 导出数据,每个配置 113 个任务 x 4 次试验,均为最高推理强度,来自已公布的逐次试验记录。每方 452 次试验。
- 计分:主要通过率采用 DeepSWE 的官方计分(included_in_score,排除基础设施错误)。Fable 有 16 个来自模型路由的基础设施错误,因此其严格的“错误按失败计”得分为 67.3,官方得分为 69.7。GLM-5.3 有 1 个。
- pass@2、pass@4、覆盖面、并集和相关性使用逐任务的通过次数。
- 成本采用已公布的逐次试验 cost_usd。Fable 的与轨迹的 total_cost_usd 完全一致,而 GLM 的仅来自索引。分析时,GLM-5.3 批次的逐轮轨迹 JSON 不在公共 CDN 上。
- 失败剖析使用已公布的逐测试比例。差一点指至少 80% 的新测试通过且基线保持完好。回归指某个基线测试被破坏。领域采用基于产物的任务分类法。
- 级联假设由验证器决定是否升级,且在给定任务的条件下两次尝试相互独立。预期准确率与顺序无关,成本则不然,因此应让成本更低的模型打头阵。考虑到 0.65 的相关性,组合收益有限。理想化路由器(Oracle)是逐任务选取最佳单次尝试的结果,是任何单次路由器的上限。