摘要
Together Evaluations 现已支持 OpenAI、Anthropic 和 Google 的模型,可进行全面的基准测试。你可以并排比较任意模型,无论是开源的、微调的还是专有的,从而在质量、成本和性能上做出数据驱动的决策。
Together Evaluations:评估模型质量
现代 LLM 开发的特点,是在不断扩张的开源、专有和微调模型生态中,于质量、成本和性能之间做复杂的权衡。Together Evaluations 提供了一个统一的框架,让团队能够比较模型(开源的、微调的或专有的),并基于经验性的质量数据做出模型选型决策。
Together Evaluations 为 LLM 质量评估提供了一个结构化、可重复的框架,使团队能够:
- 并排比较模型:使用相同的方法和指标评估开源、微调和专有模型。
- 做出数据驱动的架构决策:判断提示词优化还是微调能为特定任务带来最佳回报。
- 长期跟踪质量改进:通过可复现的自动化评估监控模型质量的进展。
新增内容
今天,我们很高兴宣布支持闭源前沿模型(包括来自 OpenAI、Anthropic 和 Google 的模型),它们既可作为评审模型,也可作为目标模型,用于严格的跨模型基准测试。
我们新增了以下用户呼声很高的能力:
1. 支持专有模型提供商
Evaluations API 现已支持主流专有提供商的模型,包括:用户也可以指定任何与 OpenAI Chat Completions 兼容的 URL,来评估自托管的外部模型。
- OpenAI
openai/gpt-5openai/gpt-5.2
- Anthropic
anthropic/claude-sonnet-4-5anthropic/claude-haiku-4-5anthropic/claude-opus-4-5
- Google
google/gemini-2.5-progoogle/gemini-2.5-flash
2. 支持评估 Together 微调的模型
用户现在可以直接在 Evaluations API 中评估通过 Together AI 微调服务微调的模型,有两种部署选项:
3. 关于如何优化和评估开源模型的新配方
- 深度解析和 Cookbook,展示如何使用我们的平台微调出优于 GPT-5.2 的开源评审模型。在这个 notebook 中,我们演示了如何基于 RewardBench 2 偏好数据,用 DPO 微调开源 LLM 评审模型(GPT-OSS 120B、Qwen3 235B),使其作为评估器超越 GPT-5.2 的表现,准确率达到 62.63%,而 GPT-5.2 为 61.62%。它提供了使用 Together AI 的 Evaluation 和 Fine-tuning API 的端到端工作流,展示了开源模型如何以低 10 倍的成本和快 15 倍的速度击败闭源评审模型。
- 在这个 notebook 中,我们演示了如何将评估服务与流行的 GEPA 框架结合使用,无需手动提示词工程即可自动优化提示词。基于 CNN/DailyMail 数据集,GEPA 通过 LLM 引导的反思和一对一评估,迭代改进一个基线摘要提示词。这一过程将提示词的胜率从 50% 提升到 62.12%,展示了自动化提示词优化如何带来显著的质量提升。
分步指南
- 以 JSONL 或 CSV 格式上传数据
- 在
classify、score或compare中选择评估类型 - 通过以 Jinja2 格式向评审模型提供
system_template来描述你想评估的内容- 你可以使用如下 Jinja 模板,指定数据集中的参考答案:“Please use the reference answer: {{reference_answer_column_name}}”
- 配置要评估的模型:
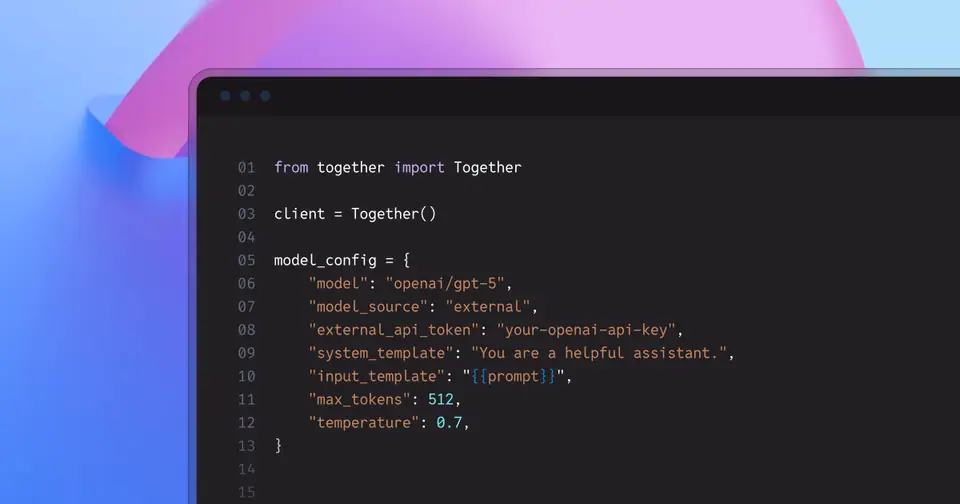
- 对于外部模型:设置 ‘model_source’=’external’ 并提供你的 API 密钥
- 对于微调模型:从你的 LoRA 无服务器部署或专用推理端点复制模型 ID。
- 定义你的
input_template,引用数据集中包含提示词的列。示例:“Answer the following: {{prompt_column}}”
- 获取结果!我们同时提供汇总的评估指标,以及包含评审模型完整反馈的结果文件。
你可以使用 UI、API 或 Python 客户端提交评估请求。完整文档见这里。
为了突出这些新能力,我们准备了一个动手实践的 notebook 和一篇深度解析,演示如何为你的具体任务选择最佳模型和优化策略。该演练涵盖多种方法,包括:
- 提示词优化
- 微调
- 针对专有模型的评估
你可以在这里找到相关材料: