Together Research 在 AI Native Conf 上发布了 FlashAttention-4、强化学习 API、ThunderAgent、ATLAS-2 等多项成果。
AI 原生云不只是一句定位。它是一个全栈 AI 云,由做出过 FlashAttention 和 ThunderKittens 等基础性 AI 成果的研究人员和工程师,专门为 AI 原生企业打造。发表这些研究的人,也正是运行 Cursor 和 Decagon 等客户所依赖的生产系统的人。这种近距离很难复制。当某项技术从我们的研究项目中诞生,我们可以迅速从研究走向生产,把这些技术交付出来,让客户立即受益。
今天,在首届 AI Native Conf 上,我们发布了七项研究和产品成果,涵盖三个方向:内核、强化学习和算法层面的推理优化。每一项都代表着我们从研究到生产的流水线上的一次重大进展,供客户使用。
内核
FlashAttention-4
FlashAttention 是当今许多大规模前沿语言模型在生产中使用的注意力引擎。由首席科学家 Tri Dao 领导的研究项目仍在不断突破注意力计算速度的极限。FlashAttention-4 将新算法与针对 NVIDIA Blackwell GPU 调优的内核协同设计相结合,消除了新出现的瓶颈,让张量核心(tensor core)保持忙碌。
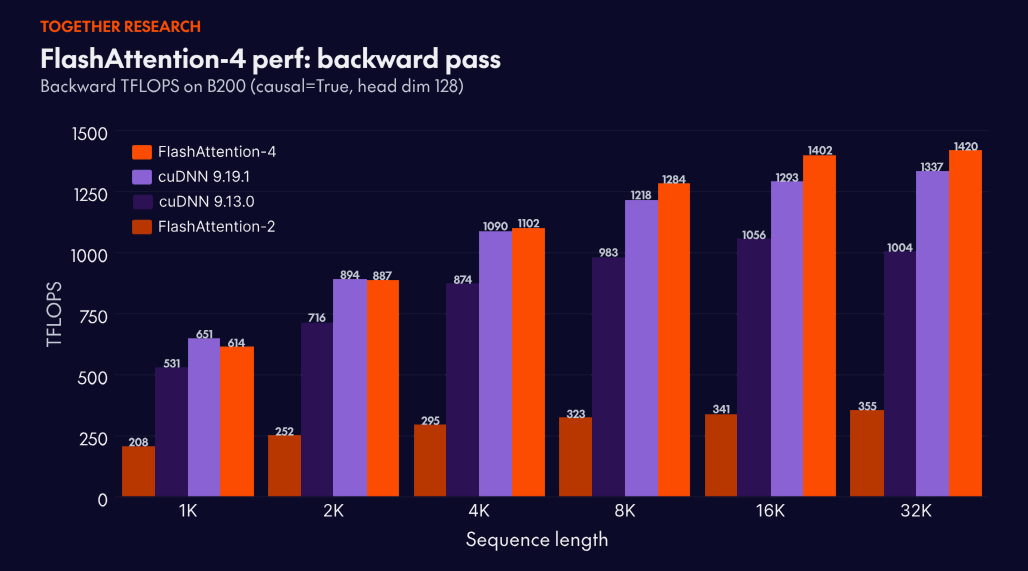
它比 Triton 快 2.7 倍,比 cuDNN 9.13 快 1.3 倍。对于视频理解、编码智能体和测试时计算扩展(test time compute scaling)等长上下文工作负载,这意味着在最新的 NVIDIA GPU 上,以更低的单 token 成本获得更智能的能力。
Together Megakernel
一家领先的实时语音智能体公司带着一个硬性约束来找 Together:生成前 64 个 token 的首字时间一旦超过约 100ms,对话体验就会被破坏。他们之前部署在 NVIDIA B200 GPU 上的方案是 281ms。对大多数工作负载来说已经很快,但对他们的场景还不够快。
Together 的内核团队与他们合作选定了模型架构,然后手工优化了一个 Megakernel 实现,它在单个内核中运行整个模型,目标是触及 NVIDIA H100 的 HBM 带宽上限。
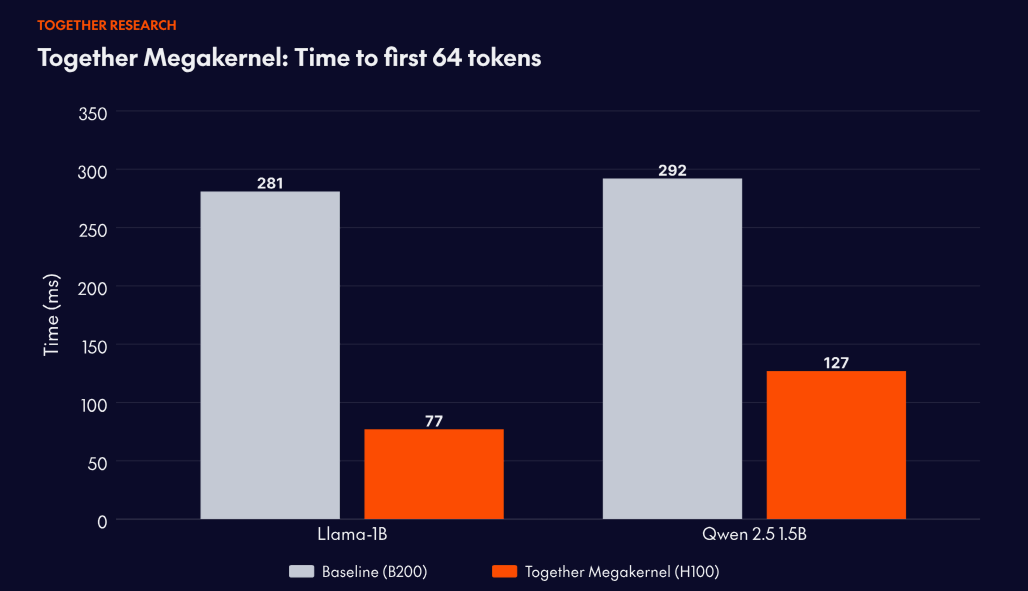
最终部署达到了 77ms,性能提升 3.6 倍,单位经济效益比之前的部署提高 7.2 倍。Together Megakernel 是开源研究的生产级实现,该研究最初由斯坦福的合作者共同开发。它与 FlashAttention 同出一脉的研究,是一种软硬件协同设计,缩小了理论可能与实际部署系统表现之间的差距。
together.compile
要产出 Together Megakernel 这样的成果,内核优化过去一直需要专家,也就是理解 GPU 线程块映射、内存带宽约束和硬件专属调优的工程师,其深度是大多数团队人手里没有的。together.compile 把其中大部分过程自动化了。
together.compile 是 ThunderKittens 的扩展,只需一次函数调用,就能在启动时生成优化后的内核栈,无需修改模型代码。应用于 Hedra 的 Omnia 视频模型时,together.compile 将生成 200 帧的速度提升了 25%。
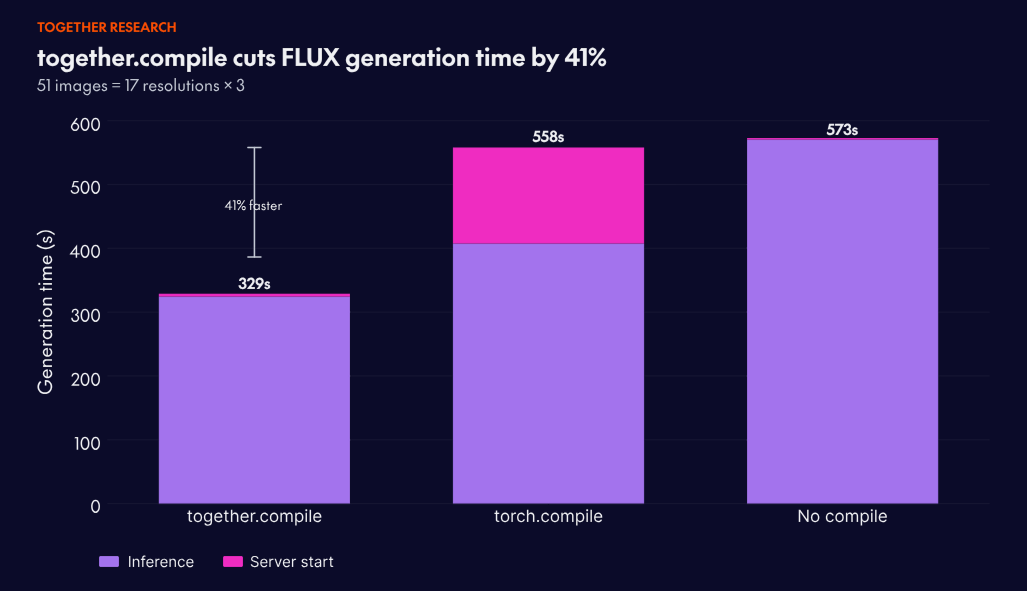
在生产环境的 Flux Kontext 基准测试中,服务器启动加上生成 17 种分辨率共 51 张图像,使用 together.compile 耗时 329 秒,而使用 torch.compile 为 558 秒,提升了 41%。启动时间也随之缩短,这对大规模运行自动扩缩容的图像和视频生成的团队很重要。
together.compile 即将登陆 Together Dedicated Container Inference。如果你想加入测试版,请联系我们。
强化学习
强化学习 API
Together 的强化学习 API 把 Together 的完整技术栈带入 RL 训练。支撑 Together 生产推理的内核、推理优化和研究进展,现在可以直接用于以 rollout 为主的工作负载,而这正是主导 RL 实际耗时的瓶颈。
这套 API 给团队的是控制权,而不是黑盒。推理和训练被作为相互独立、可配置的层暴露出来,由团队决定 rollout 配置、权重推送频率以及计算在哪里运行。Together 负责同步和调度,如何运行 RL 的决策仍由你来做。这种抽象层次让团队真正能优化自己的训练循环,而不是绕开别人对 RL 应该如何工作的假设。
超过 70% 的 RL 实际耗时花在 rollout,也就是推理上,而这正是 Together 研究项目可以直接发挥作用的地方。分布感知的推测解码(distribution-aware speculative decoding)和 ThunderAgent 都针对决定 rollout 速度的吞吐量和延迟特性,把每一项研究进展转化为更快的 RL 训练周期。
剩下的瓶颈是权重分发:在每个训练步骤之后,把更新后的权重送到推理节点。在数据中心内部,Together 能在几秒内把新权重推送到所有推理节点。在全球分布式规模下(节点跨区域、GPU 类型各不相同),同步可在一分钟内完成。
ThunderAgent
强化学习 API 处理的是基础设施层。ThunderAgent 解决的则是被训练和被服务的工作负载本身就是智能体式(agentic)时的问题,比如大规模运行的编码智能体、科学发现智能体和多步推理流水线。
现有推理系统把智能体工作流当作一系列相互独立、无状态的请求来处理。这会带来三个相互叠加的问题:
- KV 缓存抖动(工具调用打断执行时反复重算上下文)
- 跨节点内存失衡(一些 GPU 节点过载,另一些却闲置)
- 对工具生命周期无感知(Docker 沙箱和网络端口不断累积却得不到回收)
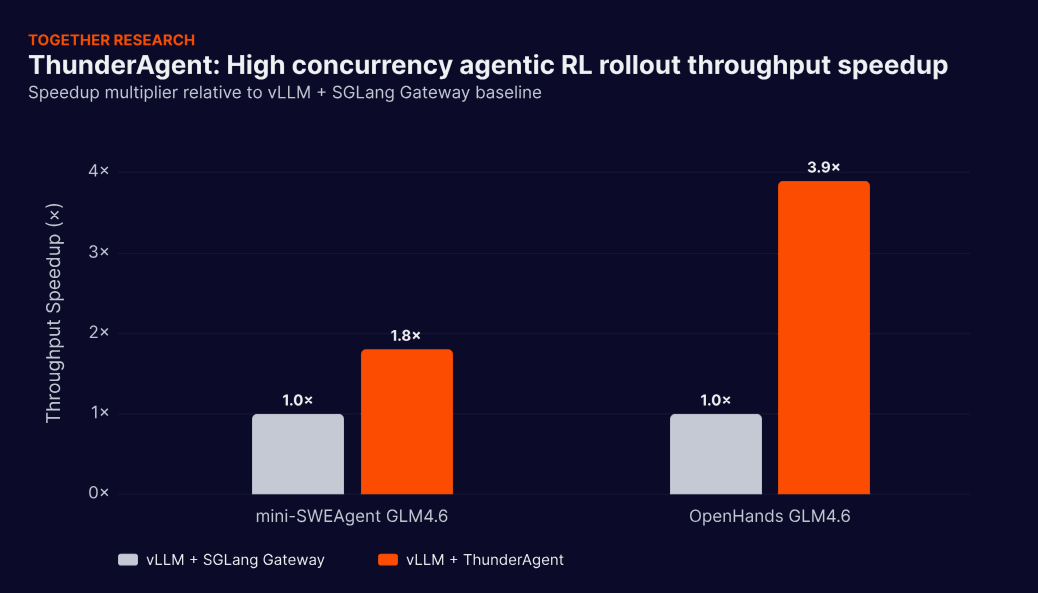
ThunderAgent 通过引入一种感知程序的抽象,把这三个问题一并解决:它将每个智能体工作流视为一等调度单元,并能看到完整的执行过程。结果是:智能体服务的吞吐量提升 1.5–3.6 倍,分布式 GPU 集群上的 RL rollout 提升 1.8–3.9 倍,磁盘内存占用相比之前最先进的系统节省 4.2 倍。ThunderAgent 今天开源,是未来构建高吞吐智能体训练的研究基础。
算法层面的推理优化
ATLAS-2
推测解码(speculative decoding)用一个小的草稿模型提出 token,再由较大的目标模型验证,是降低推理延迟最有效的技术之一。它目前的部署方式存在问题:推测器离线训练,作为固定产物发布,随着目标模型更新或流量模式变化而性能下降。重新训练需要数周的流水线工作和大量目标模型的激活值。
ATLAS-2 引入了在线训练飞轮,把被接受和被拒绝的 token 作为信号,利用线上流量持续更新推测器。新版本的推测器可以热切换到生产环境,服务不中断。
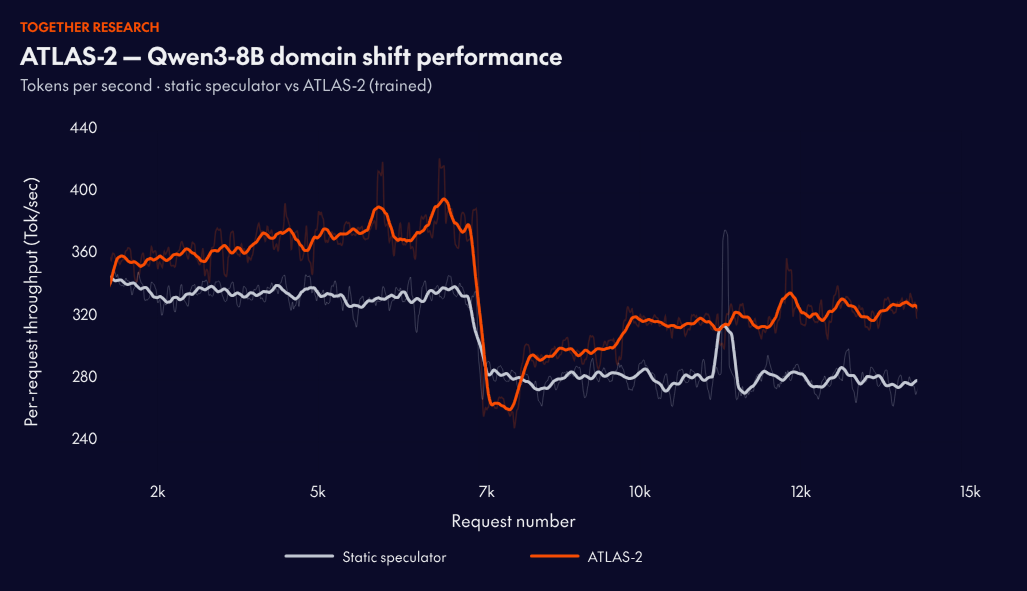
在已有静态推测器的成熟模型上,ATLAS-2 又带来 1.2 倍的性能提升。这个差距会不断累积:静态推测器只训练一次,随着流量分布变化,其接受率会衰减。ATLAS-2 持续自适应,因此性能会随分布变化而提升,而不是随之下降。
了解 Aurora,即 ATLAS-2 背后的开源框架。
缓存感知的预填充–解码分离(CPD)
长上下文推理的可持续吞吐量最高提升 40%。
标准的预填充–解码分离,把计算密集的预填充与对延迟敏感的解码分开。但所有预填充,无论热还是冷,仍在争抢同一份容量。在真实流量中,带有 100K+ 新上下文 token 的大型冷提示,会与上下文大多可复用的多轮请求排在一起。TTFT 变差,并不是因为热请求需要大量计算,而是因为它们被堵在了真正需要大量计算的请求后面。
CPD 在服务栈中增加了第三层。缓存感知路由器按缓存命中率对每个传入请求分类,并据此路由:
- 冷请求进入专用的预预填充(pre-prefill)节点,这些节点计算新上下文并填充分布式 KV 缓存
- 热请求进入预填充节点,通过 RDMA 获取 KV 块,而不是重新计算
- 解码节点保持隔离,专注于延迟。
三级 KV 缓存层次,即 GPU 显存、主机 DRAM 和通过 RDMA 连接的集群级分布式缓存,使被频繁访问的上下文随时间向 GPU 迁移。同一个 100K token 的上下文,首次请求需要数秒计算,预热之后只需几百毫秒即可提供服务。
在 NVIDIA B200 GPU 上,使用混合了热请求与冷请求的长上下文编码智能体工作负载进行评估,CPD 将可持续 QPS 比标准分离式设计提高了 35–40%。
下一步
以上每项发布都会有各自的深度解读。但它们有一条共同的主线,值得点明。
FA4 中的内核进展会直接指导未来的 Megakernel 实现。ThunderAgent 中的程序感知调度,决定了强化学习 API 如何处理智能体训练工作负载。ATLAS-2 的在线学习循环,则是我们思考任何应在线上流量下持续改进的系统的范本,而不仅限于推测解码器。我们交付的每一项成果,都会成为解决下一个问题的基础设施。
这就是“AI 原生”真正指代的飞轮。研究推动平台前进,平台吸引来的工作负载暴露出下一批难题,这些难题又驱动下一轮研究。这种复利是真实存在的,也正因如此,Together 上“可能做到的”与“实际可用的”之间的差距,往往比其他任何地方都小。纯基础设施公司只能部署业界已有的成果,纯研究实验室只能推进业界已知的边界。而研究在生产中运行、生产反哺研究,这种结合是我们从第一天起就在构建的,也是上述发布所代表的。
当今最苛刻的 AI 应用,需要能不断拓展可能性边界的基础设施。这就是我们在 Together 所构建的。
联系我们。