功耗是 AI 工厂(AI factories)的决定性约束。AI 工作负载需要一整套计算平台来承载,平台的每个组件都必须在工厂有限的功率预算内最大化产出。因此,衡量 AI 平台价值的终极指标是每瓦性能,而不是未经归一化的原始吞吐量。
NVIDIA Vera Rubin 平台旨在实现大规模高能效 AI。其核心是 NVIDIA Vera Rubin NVL72,无论是面向吞吐量优化的大批量,还是高交互层级的小批量,无论是开放模型还是闭源模型,它都能在最广泛的 AI 计算需求下提供出色的每瓦性能。
工厂级和机架级的电源管理创新,推动了 Vera Rubin 在这一重要指标上的表现。在工厂层面,NVIDIA DSX MaxLPS 软件会随工作负载需求的变化在机架之间调配功率,使运营方能够回收闲置功率,在同一场地功率上限内多部署最多 40% 的 GPU,并带来 高出 35% 的 token 吞吐量。
在每台 Vera Rubin NVL72 内部,机架级电容器配合基于荷电状态的智能功率平滑(Intelligent Power Smoothing)软件,吸收训练和推理工作负载的突发功率尖峰,因此工厂可以按持续需求而非最坏情况的峰值来规划。这意味着每兆瓦可部署更多算力。
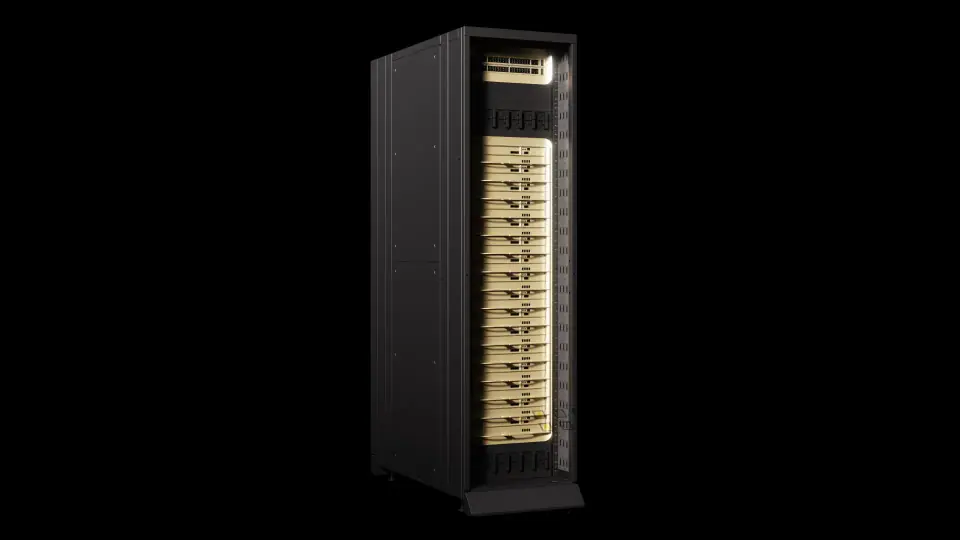
最高交互层级带来了独特的挑战。针对这一层级,平台加入了 NVIDIA Groq 3 LPX 作为低延迟加速器。本文介绍单个 LPX 机架内的创新,正是这些创新使其成为 Vera Rubin 平台中高能效的一环,其中包括它的确定性执行模型。
NVIDIA Groq 3 LPX 机架中有哪些能效技术?
Groq 3 LPX 的确定性执行模型让 LPU 编译器能够制定一份调度表,精确到时钟周期,规定每份数据何时移动到哪个具体的计算单元,以及该操作何时精确执行。这一模型覆盖机架内全部 256 颗 LPU 芯片,既能实现长上下文下的超快交互,也使得利用这种确定性的电源管理技术成为可能。
LPU 编译器生成工作负载执行调度表后,就能预测该调度表中每个周期的电流消耗。这又带来了两项互补的技术:
- 预先供电(Preemptive Power,PEP):在需求变化到来之前,提前让供电系统做好准备
- 时钟周期合成(Clock Period Synthesis,CPS):调整需求上升和下降的陡峭程度
PEP 和 CPS 共同作用,有助于缩小任何一组芯片都必须持续预留的“电压保护带”(voltage guardband,或称“电气安全裕量”),尽管这部分电压并不直接为 AI 工作负载供电。电压保护带缩小,意味着更大比例的宝贵功率可以用在工作负载上。

在恰当的时刻为 AI 工作负载供电,难点在哪里?
为了运行 AI 工作负载,芯片要执行一系列指令,从简单的数据重塑到复杂、耗电的矩阵乘法不等。几乎所有芯片都具备硬件特性,可在工作负载运行期间随资源可用情况在这些繁多的操作之间动态切换。这种灵活性意味着,计算密集型操作可能在任意时刻被调度执行。为芯片供电的系统必须被设计成能够应对这种情况。
驱动 AI 工作负载的矩阵乘法和向量乘法会在短时间内引起大量晶体管开关动作,使芯片的电流需求在纳秒量级上骤增。芯片从最近的可用来源获取这部分额外电流:紧邻芯片的电容器,即去耦电容(decoupling capacitors,简称 decap)。这些电容放电会使芯片电压下降。
芯片所在的电路板上确实有电压调节器,这是一种专用电路,职责是将芯片供电电压保持在设定目标值,但由于电感会阻碍其输出电流的快速上升,它无法瞬时响应。不过,电压调节器提供的电流最终会追上芯片的需求,使电压得以恢复。
这些暂时的电压下降,归根结底由 AI 工作负载电流需求的剧烈变化所驱动,被称为电压跌落(voltage droop)。其幅度取决于电流变化量,也取决于 di/dt,即电流的变化率。在其他条件相同的情况下,di/dt 越大,电压跌落越大;反之,同样的电流绝对变化量若在更长时间内完成,di/dt 就更小,跌落也更小。这些跌落通常不成问题。然而,所有芯片都有一个最低电压(Vmin),低于该电压芯片就无法正常工作,导致结果出错。

为降低这种最坏情况出现的可能性,芯片是带着电压保护带运行的,即提供足够的供电电压裕量,使芯片在瞬态和最坏情况下仍能获得所需的最低电压。大多数时候,为提供这份保护带所需的功率实际上是多余的。此外,功率与电压的平方成正比,因此持续多供 10% 的电压,就会多耗 21% 的功率。
NVIDIA Groq 3 LPX 的周期精确调度如何让电流需求变得可预测?
Groq 3 LPX 的确定性执行模型使得在工作负载开始之前,就能制定出 AI 工作负载将如何运行的调度表,其中既包括运算,也包括数据移动。单个 LPU 加速器只有相对少量的不同硬件单元,每种单元都能让最常见的操作可预测地快速执行:
- MXM,用于矩阵乘法
- VXM,用于向量运算
- SXM,用于转置和重塑
单个加速器还配有硬件,使这些计算单元精确同步到时钟周期。在内存方面,每颗芯片都有不分层级的片上 SRAM 存储体。在 LPX 系统层面,LPU 之间直接互连,不经过中间设备,使数据传输时间更可预测。
确定性把这些硬件单元联系在一起:单次计算、内存读取和芯片间通信每次运行所需的时钟周期数都相同。编译器可以利用这一点,规划数据何时需要在这些计算单元之间移动,使其恰好在需要的时间到达需要的位置。这份计算与数据移动的调度表还让编译器能够提前解决常见的资源冲突,例如两个硬件单元同时写入同一个存储体。

这份周期精确的调度表还能生成工作负载随时间变化的电流需求。编译器可以在时钟周期级别估算系统将消耗多少电流。

执行模型如何实现主动的电压与时钟控制?
周期精确的调度表及由此得到的电流需求曲线,使 Groq 3 LPX 能够减小电压跌落,并以更小的电压保护带运行。由于编译器精确到时钟周期地知道电流需求何时上升、何时下降,它就能提前让供电系统做好准备,并通过互补的 PEP 和 CPS 技术来调整需求中最剧烈的变化。
- PEP 是芯片命令供电网络(PDN,即向 LPU 供电的物理电子系统)改变其输出电压的机制。由于编译器知道电流会在哪个周期飙升,它可以足够提前地调度这条指令,使供电电压在需求到来之前就已开始变化。这样,去耦电容需要弥补的缺口更小,电流上升时芯片电压的下降也就没那么陡。
- CPS 让编译器可以调度工作负载中的单个时钟周期变短或变长。这种逐周期的调度之所以可行,全靠 Groq 3 LPX 的准同步(plesiosynchronous)时钟系统,它让芯片之间的时钟保持同步,也让芯片内部的计算单元保持同步。与 PEP 相比,它能对电流最剧烈的变化进行更精细的控制。具体来说,电流尖峰最高的那些时钟周期可以被拉长,从而降低 di/dt,即电流上升的速率。

PEP 和 CPS 共同为编译器提供了工具,可以调度电信号,甚至时钟周期的长度,从而减小电压跌落。在 Groq 3 LPX 系统上的内部测试表明,这种方法使电压降低了 >60%。据估计,这将使电气系统必须持续向 AI 工作负载提供的基准电压下降高个位数百分比。由于功率与电压的平方成正比,功耗的降幅百分比还会更高,而这一切都不会影响工作负载。

在高交互场景下提供更高的每瓦性能
与规格相近的非确定性系统相比,Groq 3 LPX 的确定性执行可将运行同一工作负载所需的功率降低,幅度可能达到低两位数百分比。在功率受限的 AI 工厂中,降低这部分开销,意味着固定功率预算中有更多可用于生成 token。
Groq 3 LPX 将这些由确定性支持的功率控制带入 NVIDIA Vera Rubin 平台,预计于 2026 年下半年推出。它们与工厂层面的 NVIDIA DSX MaxLPS 以及 Vera Rubin NVL72 机架内的智能功率平滑相辅相成。它们分别作用于平台的不同层级,但目标一致:让每兆瓦产出更多有用的 AI 推理。
在平台层面,对于 2T+ 参数的模型,在长上下文和高交互场景下,将 Groq 3 LPX 与 Vera Rubin NVL72 搭配使用,每兆瓦吞吐量比上一代 NVIDIA GB200 NVL72 最高提升 35 倍。对 AI 工厂而言,这意味着在这一严苛的运行点上,同样的功率预算可以服务多得多的 token。
致谢
这项工作得益于 Ashraf Essea、Kibibi Moseley、 Graham Steele、Suhas Somnath、Sarah McKenney、Farshad Ghodsian 和 Eduardo Alvarez 的专业知识与工程贡献。