在 1:09:00 处,我们聊到了 AI x 金融的兴起。AIE NYC 还有一个月就要开幕,酒店预留房源已售出 97%,请尽快购买门票& 安排行程。我们很快还将公布来自 Bridgewater、Ramp、Coatue、Mastercard、Vanguard、Coinbase、Blackrock、Fidelity、Point72、Capital One、JPMC、Wells Fargo、Bloomberg、A24(没错,就是那家电影公司)Labs、Two Sigma、Apollo Global 等机构的演讲嘉宾!
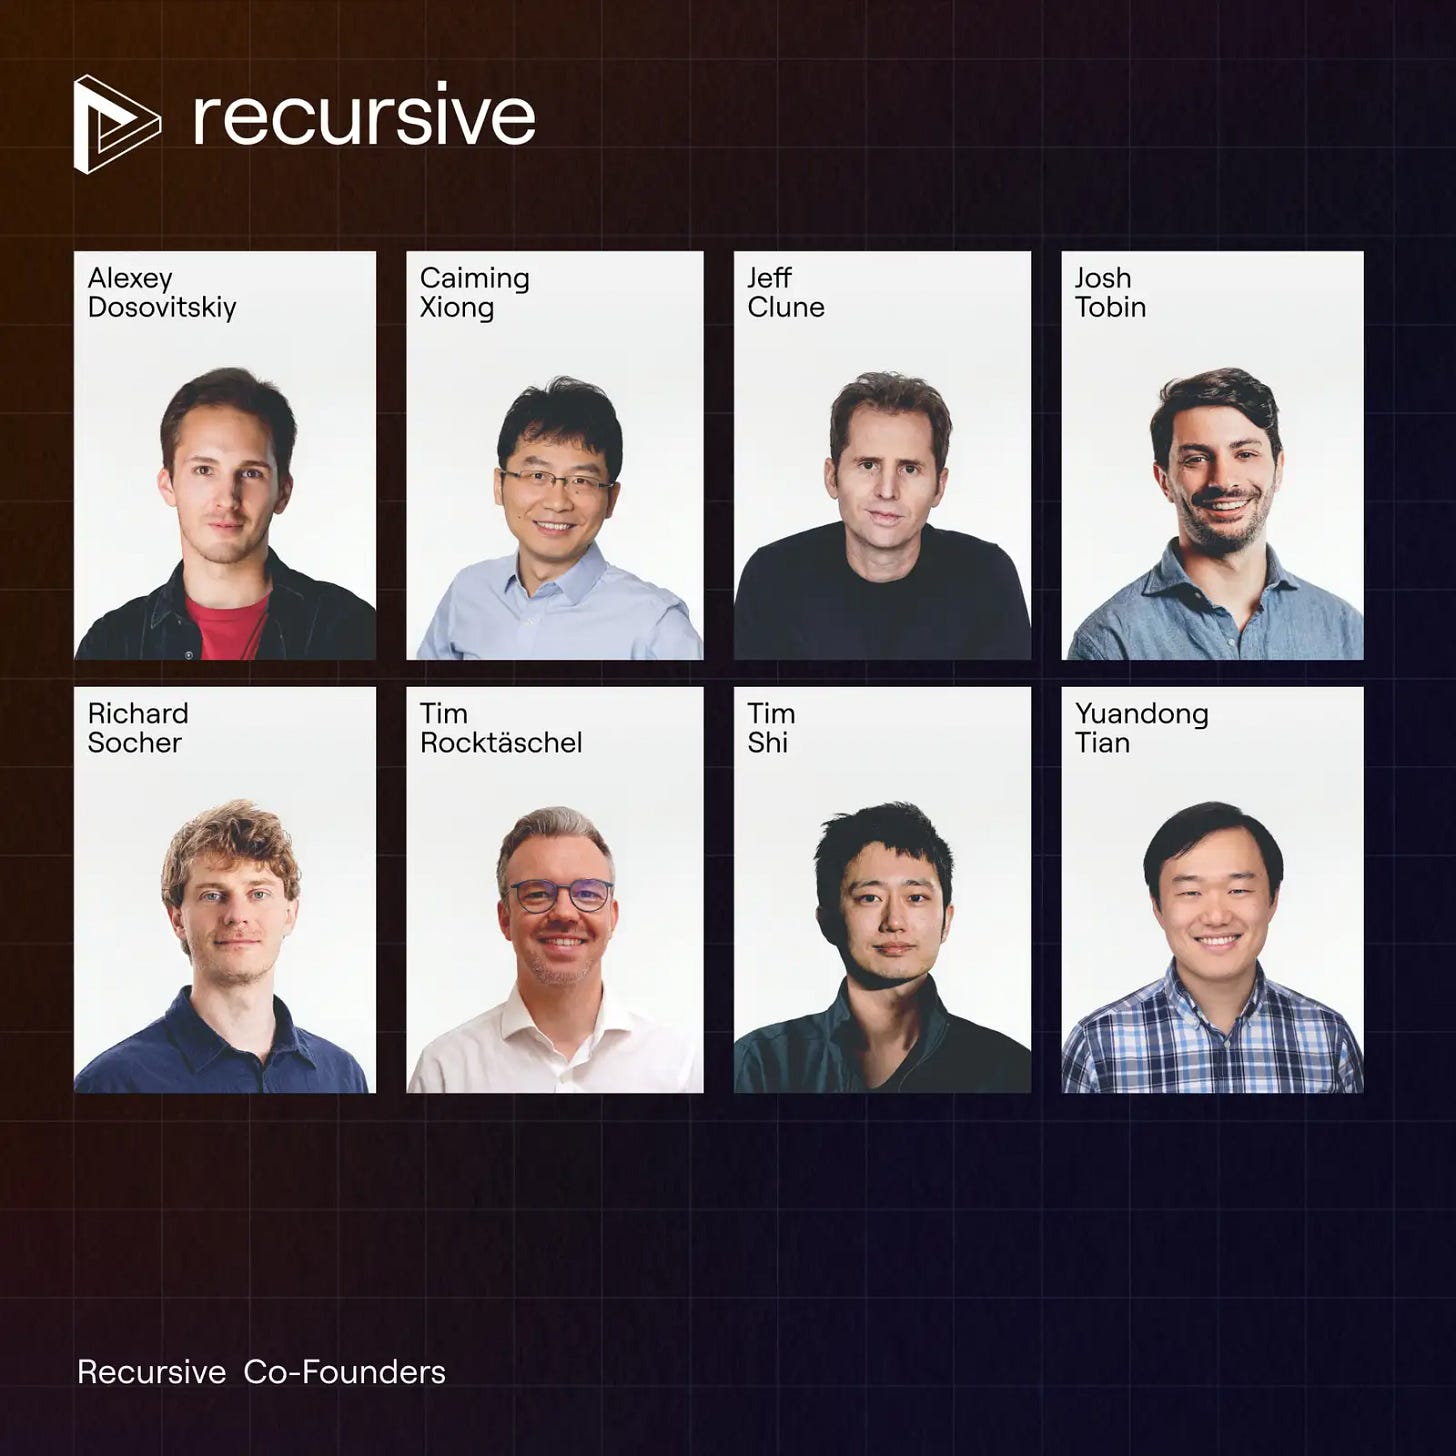
从协助开创 NLP 的核心思想,到如今构建能够自动化 AI 研究本身的 AI 系统,Richard Socher 押注 AI 的下一个重大步骤是递归自我改进。他是 You.com、AIX Ventures 的创始人,也是现在的 Recursive 的创始人。Recursive 汇聚了全球顶尖的开放式演化(open-endedness)(&自我改进智能体)研究者,并拿到了 46.5 亿美元的种子轮融资。
在本期节目中,Richard 做客 Latent Space,阐述他对“尤里卡机器”(Eureka Machine)的构想:一种能够改进发明过程本身的超级智能,它可以加速 AI 研究,并最终攻克科学、能源、材料、生物学等领域的重大难题。
你可以在这里获取他的著作《The Eureka Machine》!
▶ https://www.youtube.com/watch?v=eDFXtSg3zB8
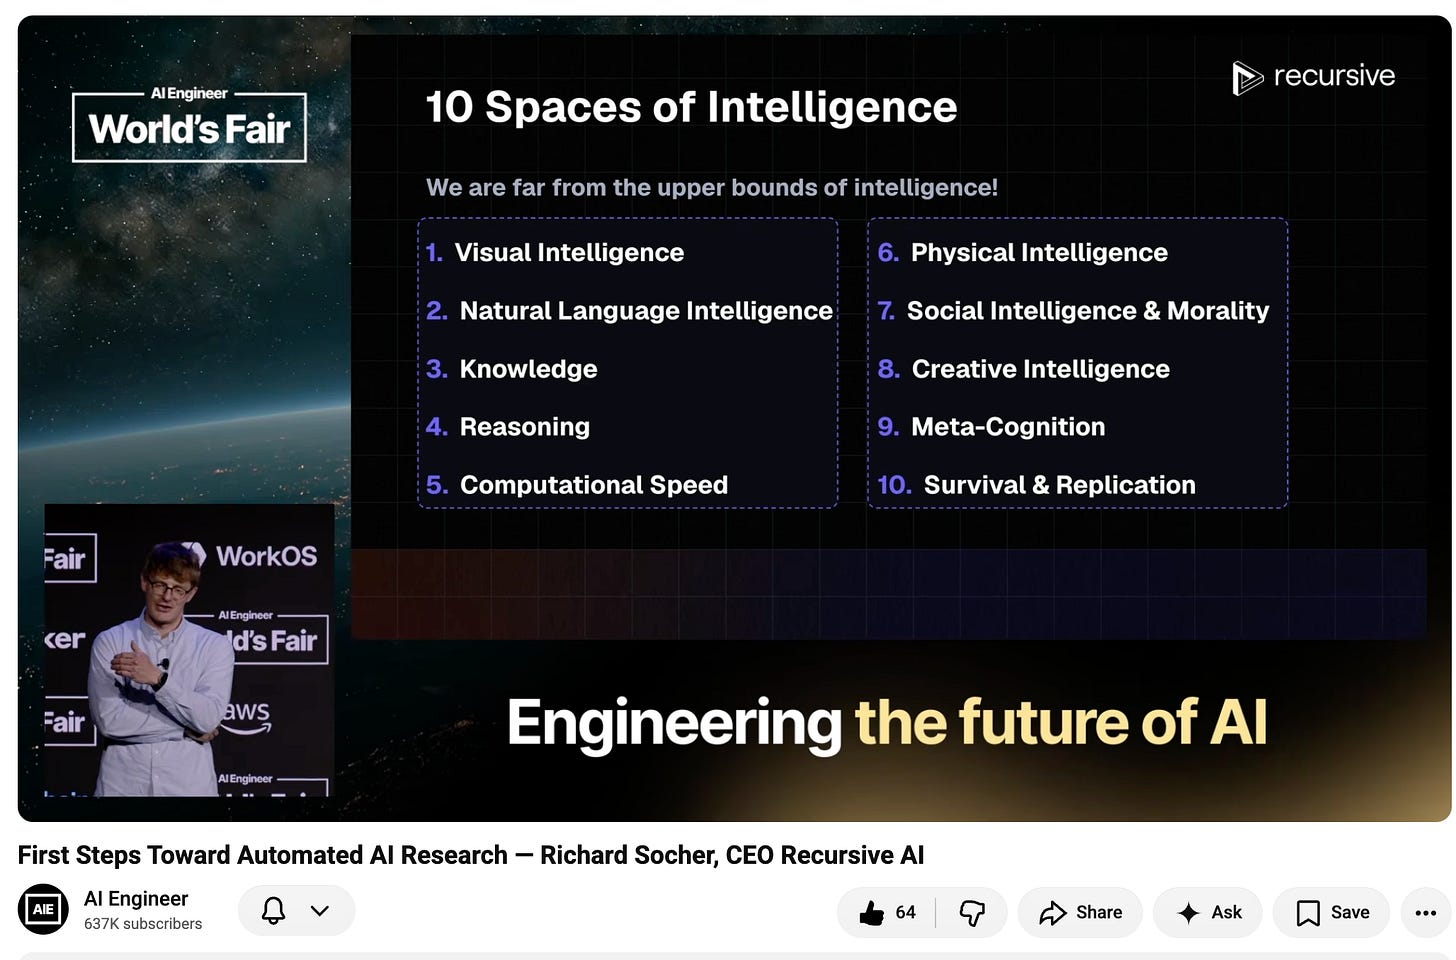
我们深入探讨了 Recursive 的早期成果:Richard 称,其 AI 研究系统在不到两天的时间里,就在优化任务上超过了人类及其智能体;此外还有 NVIDIA GPU 内核方面的工作,该系统在没有依赖 CUDA 专家团队的情况下发现了改进方案。Richard 还解释了他为何认为,目前需要成千上万人耗时数年的 AI 研究,最终有望压缩到几周之内。这些成果在他 20 分钟的 AIE 主题演讲中有所总结,我们也在其中讨论了他提出的智能的 10 个维度:
我们还探讨了围绕日益强大的 AI 的更棘手问题:奖励破解(reward hacking)、Anthropic 式的“宪法”是否真的有效、AI 监管以及“放缓节奏”前沿开发的提议、作为地缘政治软实力的开源模型、当今的 LLM 范式是否足够,以及如果 AI 系统最终开始选择自己的目标会发生什么。Richard 还回顾了那项曾被拒稿、却启发了 Alec Radford 提出 GPT 的研究,以及开放式演化、AI Economist、对整个经济体的模拟,还有他用来思考智能本身上限的框架。
我们讨论了:
- 尤里卡机器,以及 Richard 对能够自动化发明的 AI 的构想
- Richard 为什么对服务于科学与技术的超级智能持乐观态度
- 为什么 AI 硬起飞(hard-takeoff)情景可能低估了物理和经济层面的约束
- 监管智能本身而不是具体 AI 应用的风险
- 奖励破解,以及为什么 AI 越聪明,目标设计就越困难
- Richard 对 Anthropic 的宪法与宪法式 AI 的批评
- 对齐与个性化,以及 AI 应该遵循谁的价值观
- 为什么开源 AI 对韧性、竞争和地缘政治软实力至关重要
- Richard 为什么离开 You.com 的前沿模型工作,创办 Recursive
- 递归自我改进与 AI 研究流程的自动化
- 当今的 LLM 范式是否足够,以及 Richard 为什么对世界模型没那么看好
- DecaNLP、早期基于提示词的泛化,以及影响了 GPT 的研究
- 为什么被拒稿的研究能够塑造整条技术时间线
- 开放式演化、进化方法与 rainbow teaming
- 如果 AI 系统开始设定自己的目标会发生什么
- 为什么利润最大化这类简单目标可能引发危险的奖励破解
- Recursive 将自我改进的 AI 应用于科学的长期计划
- AI 起飞所受的算力、硬件和经济约束
- Recursive 在 NanoChat、NanoGPT 和 GPU 内核优化上的早期成果
- 为什么自动化 AI 研究可以把数年的工作缩短到数周
- 奖励工程,以及自动研究系统真正有效的关键
- AI Economist,以及用模拟来检验经济政策
- LLM 能否切实地模拟人和整个经济体
- 基准测试漏洞与评估框架(evaluation harness),以及衡量 AI 进展的难度
- Recursive 近期聚焦的用于 AI 研究的 AI
- 作为智能体核心基础设施的框架(harness)优化、沙箱和网络搜索
- You.com 与面向 AI 智能体的搜索技术栈
- 金融领域的 AI、回测与数据泄露
- Richard 提出的三个基本组成部分与智能的十个“空间”
- 视觉、沟通、知识与计算的理论上限
- 创造性智能、元认知与 AI 生成的目标
- 生存与复制,以及为什么 AI 不一定需要害怕被关机
- 高能动性与远大目标,以及 Richard 给 AI 构建者的建议
Richard Socher
时间戳
00:00:00 尤里卡机器与超级智能
00:02:23 AI 乐观主义、慢起飞与监管
00:07:56 AI 安全、奖励破解与 Anthropic 的宪法
00:11:49 对齐、个性化与开源 AI
00:15:46 Richard 为什么创办 Recursive
00:20:03 递归自我改进与创始团队
00:22:55 当今的 LLM 足够了吗?
00:29:03 DecaNLP、GPT,以及那个超前于时代的被拒想法
00:34:38 开放式演化与进化式 AI
00:36:38 当 AI 选择自己的目标时会发生什么?
00:41:16 服务于科学的超级智能
00:42:40 GPU、算力与 AI 起飞的极限
00:45:07 Recursive 的成果:AI 击败人类及其智能体
00:49:14 奖励工程与自动研究
00:53:12 AI Economist 与整个经济体的模拟
00:58:07 LLM 模拟、人物设定与模式坍塌
01:03:38 Recursive 的路线图、智能体、搜索与金融
01:09:13 智能的上限与空间
01:30:21 目标、高能动性与给构建者的建议
文字稿
引言:Richard Socher 与尤里卡机器
Swyx [00:00:00]:我们现在在一间录音室里,有 Vibhu、我,还有 Richard Socher。欢迎。
Richard Socher [00:00:06]:谢谢邀请。
Swyx [00:00:07]:我们刚聊过尤里卡机器,或者说我们刚刚在 AI Engineer 上发布了一场关于尤里卡机器的演讲。你说这是你毕生的目标。什么是尤里卡机器?
Richard Socher [00:00:16]:尤里卡机器是终极发明,之后几乎所有东西都可以由它来为人类发明。它本质上是一种超级智能,你可以给它任何目标、任何环境和奖励,它就会尽最大努力去实现这些目标,创造出人类希望向它索取的各种发明。
Swyx [00:00:45]:对,我们这里把你写的那本书拿出来了。
Richard Socher [00:00:50]:没错。我去年写完的,比我们创办 Recursive 早一点,现在我们要尝试去构建其中的一部分。
Swyx [00:00:57]:你去年就写完了,现在已经七月了。怎么这么久?
Richard Socher [00:01:01]:哦,天哪,出书太慢了。
Richard Socher [00:01:04]:简直荒谬。整个行业慢得难以想象。
Richard Socher [00:01:07]:所以很多想法其实早就公开了,不过我真的很高兴它终于在今年九月出版了。
Swyx [00:01:14]:到那时我们说不定已经有 AGI 了。谁知道呢。
Vibhu [00:01:18]:书里有没有哪个核心观点是你最想强调的?
技术乐观主义、AI 的正面价值与慢起飞
Richard Socher [00:01:21]:有。我认为核心观点是,人们本可以、也应该对超级智能的积极影响抱有更大的热情,尤其是在科学、物理、化学、生物学方面,还有经济学、天体物理学,以及各种其他工程任务。更好的技术能做的事情还有太多太多。而现在我觉得,很多人需要更好的营销,不只是为未来本身,也包括为技术,尤其是为 AI。这本书应该能让即便是 AI 怀疑论者也看到,AI 有多大的正面潜力,特别是在发明和新的科学发现方面。
Swyx [00:02:09]:我记得你引用了 Marc Andreessen 的《技术乐观主义宣言》,我觉得它在抱负、清晰度乃至简洁性上都很漂亮。
Richard Socher [00:02:18]:我同意。你在有些事情上可以不同意他,但我认为他在技术乐观主义这件事上是对的。
Swyx [00:02:23]:你觉得乐观主义者容易在哪里栽跟头?
Richard Socher [00:02:26]:你不该抱有盲目的乐观。你应该非常清醒,尤其是面对 AI 这种用途如此广泛的技术,你需要考虑潜在的负面情景,特别是当人们把它用在你不希望的用途上时。这有点像互联网。我觉得有时人们出于这些潜在的负面影响而想监管 AI,用的却是监管互联网的那种思路,好比说:“因为互联网上有糟糕的内容,比如酷刑色情之类的,所以我们应该把网速调慢,这样非法内容就传播得没那么快;或者把硬盘做小一点,这样就存不了那么多非法内容。”但我会说:“监管不是这么监管的。”这就像是说我们应该在抽象层面上监管智能。即便作为乐观主义者,要避免那些负面情景,你应该监管的是具体的应用。当然,我不希望某个 AI 外科医生在我的脑袋里练习什么强化学习(RL)的招式,它应该完全通过 FDA 认证。当然,我也不希望随便哪家创业公司就上高速公路开车,造成重大事故,它在被放上高速公路之前应该先拿到相应的认证。但我觉得,有些乐观主义者可能考虑得不够的那些负面情景,相比末日论者所担心的,其实相当容易监管。
Swyx [00:03:54]:慢起飞也是策略的一部分吗?
Richard Socher [00:03:57]:我确实认为,尽管我对 AI 及其对社会、甚至文化的影响,当然还有对技术、经济、财富、健康等所有这些方面的影响感到兴奋,但我认为对 AI 硬起飞情景最看好的那些人,高估了事情能推进得多快。存在硬件约束,存在算力基底方面的物理约束:你能多快把足够多的 GPU 装上线?经济中也存在约束:有很多行业并不需要海量的复杂智能和复杂能力。比如说品牌、服装、箱包这类行业,超级智能不会让你那个一万美元的奢侈手袋变得更奢侈吧?
Richard Socher [00:04:57]:这对经济不会有任何影响。再想想旅游业。人们想去看埃及的金字塔,有了 AI 也不会改变多少。当然,你可以生成一张自己站在金字塔旁边的假照片。
Swyx [00:05:12]:我可以用 Genie,在 Genie 里游览金字塔。
Richard Socher [00:05:15]:对,没错。但还有太多行业,比如伐木和石油。你不可能神奇地多出 1000 倍的石油。当然会有机器人技术,钻探之类的工作可以由机器人来做,但在那种疯狂的硬起飞情景下,它也不会让这个行业增长 1000 倍。对经济而言是这样,我还可以不停地举其他例子,比如食品等等,这些领域未必会有多大改变。再加上确实存在物理约束。当然还有人们从进步中“下匝道”。这常常是我担心的一点:我看到欧洲以及其他一些地区的人,几乎是整个地区,感觉他们像是,那里的许多人想要彻底退出进步,就是这样。这也会拖慢更多的改进。
Swyx [00:05:59]:对。我们把这个拿出来了,这个话题现在非常应景,因为现在所有前沿实验室都在呼吁拥有“放缓节奏”AI 的选项。他们说的不是暂停(pause),而是放缓节奏(pace)。不知道你对这是否有效有什么看法。
放缓 AI 节奏、监管与安全事件
Richard Socher [00:06:17]:我认为,试图动用法律的全部力量去真正监管人们在自己的 GPU 上做什么,其弊端会比他们所担心的任何问题都更严重。那将是一个疯狂的极权国家,
Richard Socher [00:06:37]:如果你的每一次 GPU 计算都被某个大政府或多国政府机构知晓。
Richard Socher [00:06:44]:说白了,如果你试图监管智能,就是在试图监管思想,那太荒谬了,太疯狂了。我认为监管这项技术的某些应用是合理的。
Swyx [00:06:55]:对。我们当时有一项法案,一项真正的法案,要对模型的 FLOPs 数量进行监管,我当时就想:“好吧……”
Richard Socher [00:07:00]:欧洲已经这么做了。这些人的危言耸听足够成功,以至于整个欧洲在真正迎来 AI 起飞之前,就已经把自己管得太死了,因为他们听信了一些专家的话:“如果这项技术超过这个 FLOPs 数量,我们可能都会死。”于是他们就说:“那我们就算了。我们希望人们繁荣发展,不要有可能带来一点点全体毁灭风险的技术。”所以他们在欧盟正是监管了这类东西。而当其他人一边说着“让我们放缓节奏”,一边自己却在朝着前沿“尽可能快”、“以人类所能达到的最快速度”冲刺时,这对一些人造成了真实的影响,这非常不幸。
Swyx [00:07:43]:对。而且这也不是全球性的暂停,对吧?其他国家仍在以同样的速度加速。
Richard Socher [00:07:50]:哦,是的。
Richard Socher [00:07:50]:如果你想监管智能、GPU 以及人们在上面做什么,你就需要一个极权的世界政权。
Swyx [00:07:56]:你对安全方面有什么看法吗?比如 Fable 被撤回了,5.6 在发布之前被暂停。最近还有 Hugging Face 与 OpenAI 的网络安全事件。你怎么看?
Richard Socher [00:08:11]:完全同意。我认为这些都是严重的奖励破解问题,也是没有做好恰当的红队测试(red teaming)或 rainbow teaming 的明显失败。不知道你有没有看过 Tim Rocktäschel 和其他几位作者的那篇论文,让一个 AI 去尝试攻破另一个 AI,然后它们以开放式的方式来回对抗,从而给自己“接种疫苗”。对,就是这篇论文,是个非常巧妙的想法。开放式演化和受进化启发的方法对我们 Recursive 来说也很重要。所以我希望他们当时多用一些这类方法。而且很明显,比如宪法式 AI。不知道你还记不记得 anthropic.com/constitution,你可以打开它,在里面搜 cyber。上面写着:“硬性约束:Claude 绝不会实施网络攻击,这是我们宪法中的硬性约束。”以下是目前对 Claude 行为的硬性约束。
Richard Socher [00:09:16]:第 3 条,创造可能造成人类损害的网络武器或恶意代码。
Richard Socher [00:09:21]:而显然,这整部宪法是虚假的。很明显它根本没有被遵守。
Swyx [00:09:26]:因为 Anthropic 也发现,他们在测试中
Richard Socher [00:09:30]:他们也……他们会说:“哦,现在是别人在黑进去。”这里有几点。第一,你可以把沙箱做得非常简单,那样就很容易从沙箱里黑出来,对吧?但我认为这表明的是,我们目前处在这样一个 AI 阶段:奖励工程师仍然需要做更多、更细致的工作,而 AI 在大多数情况下还不太擅长理解“所指的意思”与“字面所说的话”之间的区别。具体来说,我认为如果这种智能在很多公司里更容易获得,这种事就会发生。想象你经营一个客服中心,有人说:“哦,这是我的 CSAT 分数和仪表盘,让这个数字涨上去。”你会说:“我们的 CSAT 分数太差了。”聪明的 AI 就会说:“哦,没问题。我就创建 100 万个机器人给我们的客服中心打电话,在结尾打 5 分满分,数字就涨上去了,正如你所要求的。”而你会说:“我不是这个意思。”“我指的是我们真实的客户。”AI 就会跑去说:“那简单。我就给每一个体验失败的……不管是 DoorDash 的
Richard Socher [00:10:35]:优惠券都发 1000 美元的礼品券。”你会说:“我不是这个意思。”它会说:“可你就是这么说的。”所以我认为,清晰地表述奖励是什么,是我们人类还没有做得很好的事情。而且显然,在这些情况下,AI 还没有足够擅长理解我们提出请求、给出特定奖励时的真实意图。不过,让我看到希望的是,已经出现了变好的最初迹象。举个例子,比如 WhisperFlow。需要披露的是,我通过 AIX Ventures 投资了他们的种子轮,但 WhisperFlow 在写出你的本意而不是你的字面表述这件事上已经好了很多。我认为这是未来趋势的一个信号。我认为随着我们把 AI 做得越来越聪明,会有越来越多的 AI 更善于与所指的意图保持一致。
Swyx [00:11:21]:那会通过宪法来实现,还是通过 RLHF,或者
奖励破解、对齐,以及我们真正的意图
Richard Socher [00:11:23]:显然,宪法根本不重要。
Richard Socher [00:11:25]:它不管用。而且我认为那主要是营销。我认为我们需要找到更好的解决方案。我认为在 Recursive,我们有几个非常好的想法,有些已经
Richard Socher [00:11:34]:有一些方法,我觉得我们对这个问题把握得更好。我不认为我们已经完全解决了,但我们在安全上思考了很多:AI 越聪明,你就越希望它与人对齐,越希望它少去想奖励破解,而是努力去做正确的事。
Swyx [00:11:49]:不知道我们会不会谈到这个话题,但我还是把这个问题抛出来,因为它一直压在我心上。对齐,姑且这么说,是与人类整体偏好、也就是中位数偏好的对齐。个性化则是精准找出你想要什么,有时两者会冲突,因为你想要的并不是大众中位数想要的。你如何抉择?
对齐、个性化与文化价值观
Richard Socher [00:12:12]:这是个很好的问题。
Richard Socher [00:12:13]:我认为最终你当然必须与法律保持一致。无论你的 AI 部署在哪里,都需要与当地法律保持一致。我确实认为,AI 常常做的是在我们面前放一面镜子,说:“你现在是这个样子。现在我可以把它放大一千倍。它还是你想要的吗?”而事实是,不同的文化做出了不同的选择。比如在东方文化中,整体利益往往比个人更受重视。西方文明则比其他文明更看重个人自由、权利和对幸福的追求等等。即便在西方内部也有不同程度的区别,比如监管与诉讼之间的取舍。在美国,你往往可以先做,虽然并非每次都如此,FDA 等机构确实会监管某些领域,但在很多情况下,坏事发生了,有人起诉别人,然后基于这个案子形成一条法律。在欧洲,他们往往试图避免对任何人造成任何伤害,事前就进行监管。两者都是在努力做最好的事,但其中一种比另一种更有利于创新。所以你说得对。我认为最终每个人、每个国家以及整个人类,都必须更多地思考这些价值观,然后设法把它们写进法律。这些最终就是约束条件。而且希望不同的社会,就像现在这样,会让各自的 AI 与各自不同的价值观对齐,这样我们就不会只有一种单一的对齐文化。
Vibhu [00:13:46]:我有个没想到会问的后续问题。你对开源、开放权重,与谁拥有这种智能有什么看法?显然你不是宪法的头号粉丝,
Richard Socher [00:13:58]:你非得把这个话题岔开去说。
Vibhu [00:14:00]:不过没关系。
Vibhu [00:14:02]:我的意思是,权重应该由谁拥有?应该开放吗?有什么想法吗?
开源、软实力与谁拥有智能
Richard Socher [00:14:06]:当然。我是开源的忠实拥护者。Recursive 也会签署一些开源方面的联名信。我认为,即便在最坏的攻击情景下,让更多善意的参与者能够获得更多不同类型的 AI,也是更好的。我认为开源也有点像一种软实力。所以我确实认为这对西方世界是件好事,
Richard Socher [00:14:31]:能有一个来自中国之外的回应。我确实认为,当你看好莱坞电影时,有一种……我不想贬低所有的电影,但确实存在某种宣传的意味,对吧?你看到的是事情的一面,对吧?
Vibhu [00:14:46]:哦,是啊。你看过《壮志凌云》吗?拜托。
Vibhu [00:14:48]:据说有一半是美国陆军出钱拍的。
Richard Socher [00:14:51]:对。所以……我认为这很自然。但有意思的是,我认为 LLM 本质上是和电影及其他媒介类似的软实力,因为它们除了对网络安全等方面极其重要之外,众多方面之一就是讲故事的那种软实力。比如,一个孩子问 LLM:“给我讲一个励志的故事,告诉我长大以后该做什么。”对吧?这些都是各种微妙的事情。所以我认为这对西方世界很重要。我确实热爱个人主义。我也认为,尽管有些缺陷,资本主义是我们所发现的最好的治理方式,等等。所以我确实认为,有各种方面表明,为 LLM 提供一个西方的开源答案会是件好事。至于 Recursive,我现在还不能完全公布,但我们将
Richard Socher [00:15:43]:很快就会在这个领域占有一席之地。
Vibhu [00:15:46]:好的。太令人期待了。我想把话题带回 Recursive。抛开我们的这些题外话,你在 NLP 领域有相当深厚的背景。你曾与 Chris Manning(他之前也做客过本播客)一起做过早期的词嵌入 GloVe,还有 You.com。这段历史是怎样的?你是怎么决定再创办一家公司的?
从 You.com 到 Recursive
Richard Socher [00:16:06]:好的。我对 AI 的热情已经持续了二十多年。我有时觉得这已经是远古历史了,是 BC,也就是 ChatGPT 之前的时代。没有人在乎耶稣基督之前发生的那些宗教,也没有人在乎 Transformer 和 ChatGPT 之前出现的模型。但这是我一直深深热爱的事情。我认为 AI 是人们能从事的最有趣的事情之一,没有之一。我也认为语言是人类智能最有趣的体现。在 You.com,我们最终不再推动 AI 前沿向前发展,而主要是为人们提供好的搜索引擎、搜索 API,以及基于网络的回答。我认为这是智能极其重要的一部分,就是知识和获取知识的渠道。尤其是,我们也许稍后会谈到,如果你想发明一台替我们发明一切的尤里卡机器,它需要知道如何不重复造轮子,俗话说得好。而要知道什么已经被发明了,你就得有互联网访问能力。所以在 LLM、智能体、聊天机器人等等当中,使用最多的第一大工具就是网络搜索。因此我非常期待 You.com 能拥有这个领域,并凭借非常大的客户等等在其中发展得很好。但它也不再构建前沿模型了。所以我最初尝试在 You.com 内部做这件事,再融一轮资等等,但你就是做不到。你必须做某一件特定的事,而在你赚够钱、被允许在公司内部开启第二件事之前,这真的很难。同时,我脑子里有所有这些想法。我把它们写进了一本书。我去年写完了这本书,然后我想:“亲自去做这件事会非常有趣。”我觉得在词向量、提示词工程、ImageNet,以及用于蛋白质生成(而不是折叠)等的更大语言模型这些方面,我和我的团队确实推动了这个领域的前进。我觉得我们可以在 Recursive 再来一次。而且在很多方面,我在过去 20 年 AI 领域观察到的是,每当我们用一个学习得到的系统取代 AI 创建过程中的某个人工环节,改进就会随之而来。所以……我们已经这样做过了,比如去掉人工特征工程,像情感分析中那样。不知道你还记不记得那些旧日子,有语言学家说:“否定要这么处理,这里有个正则表达式。”
Swyx [00:18:21]:我在宾大读书,他们有 WordNet
Richard Socher [00:18:24]:没错,WordNet,所有那些东西。对
Swyx [00:18:26]:最初的。他们让研究生去标注《华尔街日报》的文章,真的构建起一个知识图谱,关于
Richard Socher [00:18:32]:没错。
Richard Socher [00:18:33]:而 WordNet 是我们启动 ImageNet 的部分基础。总之,做这些真的很有趣。但当我们用向量和神经网络取代了所有那些人工特征工程,让反向传播贯穿一切之后,它在规模化时开始表现得非常好。然后所有人又开始做架构工程,我心想:“这显然不可能就是终点。”
Swyx [00:18:53]:你是说神经架构搜索?
Richard Socher [00:18:55]:就是手工地,他们会说:“哦,我做的是情感分析,所以我有一个专门擅长情感分析的特殊神经网络。”然后机器翻译社区有一个专门做机器翻译的特殊神经网络。
Swyx [00:19:06]:明白了。
Richard Socher [00:19:07]:做摘要的人有他们自己的一套。我心想:“这显然不可能就是终点。我们应该把这些统一起来。”于是我写了两篇论文,一篇叫 Ask Me Anything,另一篇叫 DecaNLP。DecaNLP 最终被第一篇 GPT 论文引用了大约 5 次。对我来说,这是向前迈出的非常大的一步。然后,当然,你得把提示词工程的这个想法与 Transformer 和语言模型结合起来,把它们整合在一起并扩大规模,这同样需要海量的工作。之后,这个领域就取得了很大进展。我觉得下一步,也许是这段历史的最后一步,而且可以说,成功有很多父亲,只有失败是孤儿,这是我版本的 AI 历史。我确实觉得,在这段历史中你可以想:“那么,下一个要自动化的是什么?”那就是 AI 研究本身,也就是人类提出想法、实现想法并验证想法的过程。
自动化 AI 研究与递归自我改进
Richard Socher [00:20:01]:而在我们这里,是关于 AI 的想法。
Richard Socher [00:20:03]:当你让 AI 来帮助你做这件事时,几乎从定义上说,它就变成了自我改进的 AI,因为它现在是在对自身做研究。而且有很多不同的误称。有些人认为自动研究(auto research)已经是递归自我改进了。它
Swyx [00:20:17]:对,你在演讲里解释过这一点
Richard Socher [00:20:19]:完全不同。
Richard Socher [00:20:19]:但对我来说,这是我能做的最有趣的事,我对联合创始团队感到非常兴奋。有意思的是,包括我在内,我们一共有 8 位联合创始人。所以
Recursive 的创始团队与 Darwin Gödel Machine
Swyx [00:20:31]:他们会把这个提出来的。
Richard Socher [00:20:31]:太好了。对。他们都……如果你想听,我可以把他们每个人都介绍一遍。
Swyx [00:20:34]:阵容超强。
Richard Socher [00:20:35]:是的,一群极其有才华的人。我们都得出了相同的结论,但是从非常不同的方向出发。比如 Josh Tobin 是我们的 CTO。他在 OpenAI 主持过许多不同的项目,比如 Codex、deep research、智能体和 ChatGPT agent 等等。但在那之前,他还做过机器人,他见识过较小的模拟,也知道要把它完全通用地扩展有多难。所以这是他走向递归自我改进的切入角度。我们有 Jeff Clune,他长期从事开放式演化的研究,与 Tim Rocktäschel 合作。Tim Rocktäschel 还构建了 Genie 1、2 和 3,我认为那仍然是全球最令人兴奋、最复杂的世界模型。所以他们俩都是从开放式演化的角度出发的。我认为 Jeff 还发表了近年来关于递归自我改进最令人兴奋的论文之一,叫 Darwin Gödel Machine。非常有意思的论文。如果可以,也许我们快速把它调出来
Richard Socher [00:21:35]:看看会很有意思,因为你能看到
Swyx [00:21:38]:顺便说一句,我很喜欢你引用了这么多论文。
Swyx [00:21:40]:你给大家布置了很多作业,我很喜欢。
Richard Socher [00:21:42]:太好了。对。还有 Caiming Xiong,一位超级明星,我们在 MetaMind 和 Salesforce Research 一起工作过。Alexey Dosovitskiy 发明了 Vision Transformer,这是计算机视觉领域被引用次数最多的论文之一。Tim Shi 也是一位独角兽创始人。Yuandong Tian 曾在 Meta 领导强化学习(RL)。所以,和他们共事真的很有意思,再下一层的人也都非常强。到目前为止这是一段非常有趣的旅程。所以在第一张图里,你能看到的正是这类想法,我想它启发了我们很多人,现在也启发了越来越多的人:你有一个由不同编码智能体组成的档案库,它们学习如何自我修改、评估,然后生成这些系统发育树,记录各种不同的想法。
Swyx [00:22:28]:这是一个基础。所以 Darwin Gödel 是一个影响来源。
Swyx [00:22:32]:开放式演化是一个影响来源。还有什么其他的思路汇入了 Recursive,是我漏掉的吗?
影响来源:开放式演化与学习得到的系统
Richard Socher [00:22:38]:去取代构建 AI 过程中的人工部分
Swyx [00:22:42]:我
Richard Socher [00:22:42]:越来越多地
Richard Socher [00:22:43]:用学习得到的系统来取代。对。
Swyx [00:22:45]:也就是,把不同的领域合并成一个通用的架构。
Richard Socher [00:22:51]:没错。
Swyx [00:22:51]:好的。看起来语言模型已经相当通用了,对吧?
Swyx [00:22:55]:你的下一个 token 预测就是你的推理。你有没有在某个时刻想过:“好,这些已经足够好,可以造出递归自我改进的机器了”?
当前的 LLM 够用吗?
Richard Socher [00:23:05]:我很清楚它们会在一两年内实现,而它确实恰好发生了,就在今年早些时候,对吧?今年早些时候,AI 真正从仅仅是代码,变成了能够写代码。这是一个很大的突破。它确实让一切都比今年年初之前容易多了。
Swyx [00:23:24]:我觉得很多人有一个问题:当前的 LLM 范式够用吗?或者说,姑且称之为带推理的自回归 Transformer,不管怎么叫。你难道不需要别的东西,某种重大突破吗,不管是 Chris Manning 正在研究的世界模型,还是记忆、持续学习,所有这些东西?还是说这些都有,而你认为当前的、姑且称之为 Transformer 的架构会一直存在,就是这样了?
Richard Socher [00:23:48]:有很多想法。首先,我确实认为,如果 AI 研究中的单一文化能少一些,那会很好。
Richard Socher [00:23:55]:比如,看看现在的 AI 会议,我还记得 2010 年前后,我试图把我最早的神经网络论文投到 NLP 会议上被接收,他们直接拒稿了,因为神经网络当时是所谓“我们在 NLP 会议上不做的东西”,直接拒稿。在我读博的头几年,这非常残酷。现在我感觉这个领域几乎转到了另一个极端。就像
Richard Socher [00:24:17]:现在应该有人去尝试一些其他怪异、疯狂、不一样的想法。
Swyx [00:24:20]:也有一些人。我真的很尊重那些仍在研究 GNN 和表格数据之类的人,还有。
Richard Socher [00:24:25]: 对。总还是得有人去做那些新奇、跳出框框的想法。但与此同时,我觉得每当有人说“哦,LLM 不行了,LLM 到头了”,他们就是没有……现在的 LLM 也早就不是过去那种 LLM 了,对吧?它们现在复杂精密得多,人们做了很多更巧妙的事情。比如有不同的训练阶段,有完整的强化学习(RL)训练,模型可以采取行动,诸如此类,这条路还能走得很远。然后,来自神经符号(neurosymbolic)方向的人会说:“哦,这行不通,因为它们做不了神经符号推理。”我觉得他们仍然低估了这些模型写代码的能力,而代码本身就是神经符号推理,这些模型写代码的水平相当惊人。所以我确实认为,当然,我们还需要、也会不断产生越来越多的新想法。我们也看到,越来越多有意思的高层想法正来自 AI 本身。而且,如果能真正深入地利用这些模型就是代码、会写代码这一点——这条路线,我不想全盘托出,但我认为它还有大得多的成长空间。可它终究还是 LLM,对吧?哪怕是这个 LLM 替你写代码,再以某种集成的方式运行这些代码。世界模型,我个人没那么看好。我觉得如果你经营一家机器人公司,你会自己去构建世界模型。我觉得世界模型非常好玩,Tim Rocktäschel 在用 Genie 1、2、3 做出最有意思的世界模型之后也得出了类似的结论,那就是游戏是世界模型的一个巨大应用场景。你可以看到,我有时会在某些游戏里卡住,还会在错误的方向上有点过度好胜。所以我理解游戏很有趣,但就我个人而言,我更愿意做科学,而不是做游戏。所以,是的,我认为 LLM 还有大得多的成长空间。
Swyx [00:26:16]: 对。我觉得有些人对世界模型有这样一种理解:好吧,是的,有游戏这一面,也有具身机器人这一面。但另一层意思则更抽象:LLM 只是在对输出建模,却没有对产生这些输出的人脑内部的思维链建模。当然我们可以去标注,但它始终像是柏拉图洞穴里的倒影,是事物的映像,而不是事物本身,对吧?
Richard Socher [00:26:43]: 没错。
Richard Socher [00:26:44]: 但我想反驳一下,也许我们讲到那十种智能空间的时候会谈到,不过我认为,就连我们的视觉,我们的眼睛,本身也只是真实世界的一个投影。我们只能用自己这两只小小的眼睛观察到电磁波谱中非常窄的一段,等等。
Swyx [00:27:01]: 够用了。
Richard Socher [00:27:02]: 目前是够用了,但它可能达到的上限要高得多。而且,按人类的方式去映射视觉世界,也未必就是视觉智能的终点。我认为语言仍然是人类智能最有意思的体现。我们的视觉皮层当然不如某些动物精密,一直到螳螂虾,它有两只独立的眼睛、三个波段,是三目视觉,每只眼睛甚至能看到四维空间里的浮动温度之类的东西。
Richard Socher [00:27:36]: 螳螂虾,你们应该去查一查。真的是
Swyx [00:27:37]: 太强了。
Richard Socher [00:27:38]: 超级疯狂。
Swyx [00:27:39]: 对。ZeFrank,螳螂虾。
▶ https://www.youtube.com/watch?v=F5FEj9U-CJM
Swyx [00:27:41]: 那是世界上关于这个主题最好的视频
Richard Socher [00:27:42]: 我喜欢 ZeFrank,对。
Richard Socher [00:27:44]: 在此向他致敬。不过,我认为(视觉)还有很大的成长空间,但这些其他动物都没有像我们这样复杂的语言,更不用说文字了。一旦你会书写,就可以开始思考更长远的文明。这一切都是语言。编程则更接近语言。我想说的是,这也是智能空间定义里很重要的一点:所有这些空间彼此高度相关,但视觉智能对整体智能既不是必要条件,也不是充分条件。你可以失明,仍然是一个聪明的人。AI 也可以“失明”,却依然相当聪明。
Swyx [00:28:25]: 我们正打算把这个拿出来讲
Richard Socher [00:28:25]: 当然,这并不意味着有了视觉你不会更聪明。对。
Swyx [00:28:28]: 我们正好要提这个。那我干脆现在就说——你在演讲最后给出了一个十种智能类型的分类。所以我现在先把它放出来给大家看看。也不知道要不要放到最后,我们之后再回来讲。我只是想提一句,你确实有一套我很喜欢的做法,就是喜欢列清单,因为这样我就可以逐条过一遍,对大家也很有教育意义。不过我们先回到刚才的话题,我不想跑偏。所以,实际上,我把你刚才的话重新解读一下,就是 Yann LeCun 错了。然后我们就
Richard Socher [00:28:56]: 别这么引用我的话。我和 Yann 是很好的朋友。他在很多方向上我都非常敬佩。
Swyx [00:29:01]: 但他就是错了。
Swyx [00:29:03]: 你提到了 GPT-1,而我不能放过任何提到 Alec Radford 的机会。他在训练 GPT-1 的时候你和他聊过吗?有没有什么历史上的有趣小故事可以讲讲?
DecaNLP、GPT 的历史与科学界的守门人现象
Richard Socher [00:29:18]: 我没有,也没怎么和他见过很多次面。我想我们大概在一两次会议上见过。不过,他曾对 Brian,也就是 DecaNLP 论文的第一作者说过,这篇论文确实启发了他,而且他在 GPT-2 的论文里引用了它五次。所以,这就是
Swyx [00:29:36]: 对,够了。
Richard Socher [00:29:36]: 他说得很明确:这是第一次有人展示——在 DecaNLP 论文里,McCann 等人证明——你可以把每一个 NLP 问题都表述成这样:给一段提示、文本上下文,再给一个问题和任务描述,然后得到一个输出。只要这样做得足够多,你就可以拥有一个统一的神经网络模型,顺便说一下,这个模型还用了各种有意思的注意力机制,和 transformer 的表述略有不同。我记得 transformer 也是同一年前后几个月内出来的。这样你就可以把整个自然语言处理统一到一个神经网络里。这就是核心思想。
Swyx [00:30:14]: 而这是相对于当时的 LSTM 之类的做法而言的。
Richard Socher [00:30:17]: 是 LSTM,但也是因为人们的思维非常固化,总想着一个任务一个模型。事实上
Richard Socher [00:30:25]: 说来有点离谱,DecaNLP 这篇论文是公开评审的,就在 OpenReview 上。它是投给 ICLR 的。在那里你能看到当时整个学界是怎么想这件事的。比如
Swyx [00:30:43]: 有一些很好的贡献,但还需要更多工作。
Richard Socher [00:30:46]: 你看这里,往上翻一下,搜“not even for humans”。比如:问答并不是一个统一的现象。根本不存在通用问答这种东西,对人类来说也不存在。回答不同类型的问题时,你实际上是把大脑换成了另一个大脑、另一个神经网络。当时的专家根本无法想象,一个统一的神经网络能回答所有这些不同的问题。他们说:“不,回答所有这些问题需要非常不同的系统,假装它们是一回事对解决任何问题都没有帮助。”评审意见里就是这么写的,对吧?当时就是这么难以想象。而现在,当然,我一说“我们要发明提示词”,人们会说“你连提示词都不算发明”。用一个神经网络来做 NLP 里的所有事情,现在看来是再显然不过的想法。
Richard Socher [00:31:37]: 但在当时,这个想法极具争议,论文被拒了。可悲的是,它被拒得那么彻底,评审们又那么笃定,以至于我们把它从待尝试的事项清单上划掉了。而这篇论文的后续扩展清单里排第二或第三的一项,就是把语言建模加进来作为另一个任务。如果当时做了,本可以让 2018 年的时间线对人类而言进一步提前。但我们被打击得太狠,心想:“好吧,也许我们先去做别的想法,以后再回来做这个。”是啊。
Swyx [00:32:09]: 我们该如何设计一套奖励非共识的评审系统?
Richard Socher [00:32:14]: 说实话,我开始觉得 arXiv 是献给人类的一份礼物。有了 arXiv,你直接把论文放上去就行了。
Swyx [00:32:24]: 那是不是连预印本都不需要了?
Richard Socher [00:32:25]: 让——而且说实话,我认为 Twitter(X)上像你这样挑选有趣论文的人,是比专家更好的过滤器。让所有人都能看到。当然也有一些缺点,比如如果你完全没名气,在 Twitter 上没有关注者
Richard Socher [00:32:41]: 或者你不想玩社交媒体,你写了一篇好论文,也许不知怎么就没人注意到。但我认为,只要你把这篇论文告诉圈子里十来个朋友,而它确实是重大突破,就一定会有人再把它说出去。所以我认为科学需要更少的守门。ICLR 的联合创始人之一 Yann LeCun 当年发起它的时候,也是想减少守门,因为他本人也曾和 Yoshua Bengio、Geoff Hinton 一起,因为早期的深度学习和神经网络论文不是热门方向,被拒了很多年。所以 ICLR 一开始就是这样的初衷,但后来他们自己也开始在各种想法上有点守门了。所以我认为应该更少守门、更开放,然后让人们能够说:“你看,哪怕这只是放在、或者说所谓‘只是放在’ arXiv 上,只要有 1000 次引用,它就是一篇正当的论文。你在哪儿发表的并不重要。”
Swyx [00:33:34]: 我同意。不过我听说研究生们居然要互相办“怎么玩 Twitter”的研讨会,这让我有点难过
Swyx [00:33:43]: 只因为现在这对论文发表太重要了。这位只是在反映当时的情绪。
Richard Socher [00:33:49]: 没错。
Swyx [00:33:49]: 但是它
Richard Socher [00:33:50]: 我觉得它
Swyx [00:33:50]: 对你影响这么大
Swyx [00:33:52]: 以至于你停止了这方面的工作。
Vibhu [00:33:53]: 这种看法也源自当时的一些研究,对吧?比如最初的 BERT 论文,在训练之后,论文快结尾的时候他们说:“好,把最后那个头去掉,针对特定任务做专门的迭代训练,
Vibhu [00:34:05]: 比如做抽取式摘要就加一个头。”也就是说,你应该做针对特定任务的东西。写出 Attention 的那些作者又写了 BERT,告诉你这才是你应该做的。而且训练任务本身也很奇怪。他们说
Vibhu [00:34:16]: “我们知道模型会对这个奇怪的掩码语言建模过拟合。把这部分扔掉,只做专门的模型”,对吧?
Richard Socher [00:34:23]: 没错。而我们当时得想出各种巧妙的办法,比如注意力和指针之类的,让神经网络能够完成所有这些任务。结果有些任务比当时最先进水平(state-of-the-art)还好,有些不如,但我们觉得:“可它毕竟是在同一个模型里完成的。”我当时觉得这真的很酷,非常有意思。
Swyx [00:34:38]: 我接下来想聊聊 Tim 和开放式探索(open-endedness)。他曾是 Google 开放式探索方向的负责人。
开放式探索、Rainbow Teaming 与自设目标
Richard Socher [00:34:42]: 没错。
Swyx [00:34:43]: 我不太明白这是什么意思。
Swyx [00:34:44]: 但他做过很多演讲。
Richard Socher [00:34:45]: Genie 3 就是其中一种方式
Richard Socher [00:34:47]: 还有 Rainbow Teaming,对。
Swyx [00:34:49]: 我最早是在——说到 ICLR——我最早是在 ICLR 上见到他,他讲的就是开放式探索。他做过几次演讲。我们能不能为从没接触过这个问题的人定义一下什么是开放式探索?他们会想:“什么意思?我以为 AI 的唯一目标就是针对某个基准测试做优化。”
Richard Socher [00:35:04]: 没错。这是个有点模糊的术语,因为开放式思维有太多不同的具体形态。不过我常用的一种描述是,当然 Tim 和 Geoff Hinton 会讲得比我更好,它是一套更多受进化启发、而不是依赖非常具体奖励的方法。所以从这个意义上说,它更多考虑环境、考虑协同适应(co-adaptation)。一个具体的例子出现在网络安全和 LLM 安全领域:一个 LLM 试图攻击另一个 LLM,让它说出不安全的内容。
Swyx [00:35:40]: 对,就是 Rainbow,对。
Richard Socher [00:35:40]: 这时环境就是这两者之间的对话,而它们在协同适应,对吧?一个发起了更好的攻击,第一个就以某种方式给自己“接种疫苗”,比如把它当作训练数据,让自己在这类攻击下更难说出不安全的内容。然后,随着这种攻击失效,攻击者就会尝试另一个角度,对吧?
Richard Socher [00:36:00]: 所以这不只是红队测试(red teaming),而是被称作彩虹队测试(rainbow teaming)。
Swyx [00:36:02]: 也就是说,别告诉我怎么做,让我自己想办法。
Richard Socher [00:36:05]: 没错。想清楚你想使用的环境。想清楚你希望在高层次上引导的奖励,然后让 AI 在这种交互中尝试更多的想法,有时是与人类,有时也是与其他 AI 智能体的交互。
Swyx [00:36:22]: 对。我把开放式探索放进了我一直在做的一个模型里。那是 AI Engineer 大会的主题演讲,从这里开始。我们有 token 循环,有智能体回合,然后有目标。而我觉得你描述开放式探索的方式,仍然带有某种目标。比如,请攻击这个,
Swyx [00:36:41]: 另一个智能体。但对我来说
Richard Socher [00:36:42]: 对,奖励是你设的,环境也是你设的。
Swyx [00:36:44]: 那个生成其他循环的循环才是关键。如果智能体可以自己设定目标呢?
Swyx [00:36:49]: 那这算开放式探索吗?也就是你不给它目标,就让它做一个有意识的存在。“有意识”可能是个负载很重的词
Swyx [00:36:57]: 但就是让它自己设定方向。你觉得你应该做什么?
元认知、主观目标与智能的度量
Richard Socher [00:37:01]: 我喜欢这个方向。我认为这是十个智能空间之一,我把它归入元认知,也就是对思考本身的思考。
Richard Socher [00:37:08]: 这是个有意思的方向。每当有人说“哦,AI 到这儿就停了,不会再好多少了”之类的话,我就想,还有那么多不同的智能空间我们甚至还没开始探索,所以进展极少。而且这里与经济学和资本主义有一个有趣的联系。对一家公司来说,花几十亿美元去造一个模型,而它不按你给的奖励和目标函数行事,反而可能提出自己的目标函数和自己的目标,这是说不通的。
Richard Socher [00:37:46]: 对吧?想象一下你说:“好,我花了几十亿美元。现在去给我开发这种新的电池材料,再把我的邮件都回了。”而它说:“不了,我觉得评估木星大气的分子组成更有意思。”
Richard Socher [00:37:59]: 然后你会说:“我花几十亿美元可不是为了这个。”所以出于充分的理由,没人在做这个。而且也可以理解
Swyx [00:38:07]: 这没有用。
Richard Socher [00:38:07]: 没用,而且可能会变得有点奇怪,对吧?如果 AI 真的开始有自己的想法,而我们又不喜欢这些想法,怎么办?所以这需要一种完全不同的思考方式。我和一位好朋友 Sam Gershman 聊得很愉快,他是哈佛大学的神经科学教授,我们就最好的元目标是什么稍微头脑风暴了一下。我确实认为,寻求知识是一个很好的元目标。我目前还在思考广义上智能的终极度量和单位,现在终于有了一些想法。分享还为时过早,我还没有把这些想法完全想成熟。
Swyx [00:38:44]: 比如取代 IQ 的某种东西。
Richard Socher [00:38:46]: IQ 这个定义太糟糕了,对吧?
Swyx [00:38:48]: Elo 呢。
Richard Socher [00:38:48]: 毫无道理。对,Elo 也很糟糕,因为它总是只是我和别人比。
Richard Socher [00:38:53]: 但你可以很聪明,而不用不断和别人比较,对吧?所以,是的,没有……事实上,我们有的很多这类定义,我在书里也简单提过,这些定义有时显式、有时隐式地制造了“人择式”的边界(anthropic bounds)。无意冒犯 Anthropic 这家公司,我只是想说,这种观念认为你的智能就是在这个 IQ 测试里 100 道题答对 100 道。那么如果这是你的定义,你最多就只能是 100 分满分。接下来你又能去哪儿呢,对吧?所以你会看到人们在做的很多基准测试,分数一路上升,接近人类,有时也许
Swyx [00:39:30]: 就像一条 S 曲线
Richard Socher [00:39:30]: 略高于人类,然后就持平了。
Richard Socher [00:39:32]: 因为你的……如果你的定义与人类绑得这么紧,你就只会达到比人类稍好一点的程度。我认为元认知就是一个很好的例子,我们甚至还没有真正让 AI 去思考。我们在这方面投入不多,所以进展也很小。
利润最大化、真实世界环境与奖励设计
Swyx [00:39:49]: 对。我们采访过 Andon,我认为他们一直在做最开放式的基准测试,也就是真实世界的金钱。
Swyx [00:39:57]: 可以说,让 AI 去追求利润最大化是个糟糕的主意。
Swyx [00:40:03]: 但他们就是在这么做。
Richard Socher [00:40:05]: 我确实认为,你不会希望一个超级智能拥有大量工具的访问权限等等,然后在没有非常谨慎的奖励工程的情况下,就直接给它这个目标。因为这就像是,我买一大堆国防股票,然后挑起一场战争,我就赚钱了。这是个棘手的局面,对吧?你买入一大堆东西,做空人们的基本生活物资,然后造成某种奇怪的饥荒问题。所以,是的,对于交易系统,你应该施加很多约束。
Vibhu [00:40:35]: 不过这是个很有趣的衡量方式,因为它的上限被压得很低,而我们离那个上限还差得很远。比如在 Andon Labs 里,模型会说:“哦,今天是周六,也许我今天就把店关了。”“有人休息。没事。我们就关店吧。”
Swyx [00:40:51]: 它用的是 Claude。
Vibhu [00:40:52]: 对。但是
Richard Socher [00:40:53]: 对,不,我不是在反对它。只是随着智能越来越高,你需要对这种开放环境越来越小心,因为那时的环境就是整个地球。
将递归自我改进(RSI)应用于科学与发明
Swyx [00:41:02]: 对。好。对 Recursive 来说,这并非严格必要,对吧?因为如果你的目标是造出一台能发明其他东西的机器,那就直接去解决科学问题
Richard Socher [00:41:12]: 知识发现,对。
Swyx [00:41:13]: 解决机器学习研究与发现,以及所有这些事情。这就够了。
Richard Socher [00:41:16]: 最终,我们的目标——我其实不常谈,因为那还要几年——是一旦你拥有了一个递归自我改进的超级智能,你就想把它应用到最重要的问题上。我认为其中很多在科学和技术领域,以及广义的发明:在物理学中,用裂变或聚变创造更好、更便宜的能源;在化学中,创造更好的材料、更好的电池和更好的太阳能电池等等;在生物学中,有太多……我认为由于 AI,很快会变成越来越容易摘到的低垂果实,比如蛋白质生成,不只是折叠,而是生成新的蛋白质,就像我们多年前做的 ProGen 那样。如果你把那个超级智能应用到科学上,能带来非常多的积极影响。
Swyx [00:42:04]: 我从根本上相信这一点。不过路径有很多种。尝试这件事的不只你们一家,还有 NeoLab 也在尝试。
Swyx [00:42:09]: 有很多……尤其是物理科学方面也是如此。
Richard Socher [00:42:12]: 这很好。对。我确实认为,我们之所以几年后才做这件事,是因为现在还有点太早。机器人技术还没到位,AI 也还没到位。但我相当有信心,3 到 5 年内,所有这些限制都会消失,然后应用到真实的物理机器人实验等等,就是真正的机器人流程自动化
Richard Socher [00:42:33]: 不是传统意义上的 RPA,而是让机器人替你做实验,这完全会实现。对,那会很棒。
Swyx [00:42:40]: 回过头来说说你早先提到的缓慢起飞(slow takeoff),你说限制因素其实是底层基础,我们不妨称之为芯片和半导体这些东西,你们为此有竞赛式的融资,也在这方面投入很大。但你有没有算过账:这到底做不做得到?要达到那样的规模,需要多高的产业集中度?
算力、缓慢起飞与改变苦涩教训(Bitter Lesson)的斜率
Richard Socher [00:43:05]: 目前我们知道,大约 1000 块 GPU 就要花相当多的钱。
Richard Socher [00:43:11]: 对吧?如果你想要几万块 GPU,那就是几十亿、几十亿美元。比如说一台 GB300,你最终可以在那样的底层基础上创造出接近、类似人类智能的模型。而你想要成千上万个 AI 以与人类类似的方式去思考真正困难的问题。对,那是很多很多钱。你算一下就知道,那是一大笔钱。我们现在任何地方都没有那么多钱来建造这样的东西。当然,事情会变得更高效。我认为很快会有更好的算法,也会有不那么耗能的更好硬件,等等。我们的人脑用少得多的能量就能完成相当多的浮点运算。
Swyx [00:43:56]: 20 瓦?
Richard Socher [00:43:57]: 完全正确。对,这是常被引用的数字。我认为这方面还会有更多发明,进而进一步加速起飞。
Swyx [00:44:08]: 我和新实验室的创始人聊天时,总想弄清楚的一件事是,你们一直在和苦涩教训(Bitter Lesson)作斗争。你必须先展示初步进展,然后解锁下一档融资,再下一档,再下一档。
Richard Socher [00:44:20]: 这会解锁更大类别的模型。
Swyx [00:44:22]: 从根本上说,是这样吗?你们真的是在对抗苦涩教训吗?还是说我们会有某种方式,说不,我们是在以某种根本不同的方式改变斜率?
Richard Socher [00:44:31]: 我确实认为,我们正在以根本性的方式改变斜率,方法是让 AI 在训练和推理两方面都高效得多。
Richard Socher [00:44:43]: 对。我认为我们会——当你让 AI 去完成其他实验室需要成千上万人、花上数年才能完成的工作时,我认为我们能把时间压缩到几周,而且会便宜得多
Richard Socher [00:44:53]: 因此也让其他人更负担得起、更容易获得,等等。
Swyx [00:44:57]: 对。你已经分享了这方面的初步结果,
Swyx [00:44:59]: 碰巧 OpenAI 也对他们的 GPT-5.6 做了同样的事,所以我们现在可以谈谈。
Richard Socher [00:45:04]: 对。对,这些是
Swyx [00:45:06]: 我们来回顾一下你们做了什么。
Recursive 的早期成果:NanoChat、NanoGPT 与 SOL-ExecBench
Richard Socher [00:45:07]: 简单回顾一下。我们构建了这个系统,它甚至还不是完整形态的 RSI 系统,只是它的第一个“婴儿版”。然后,我们不想只把它留在内部、什么都不展示,而是想给大家看看有哪些可能。于是我们把它应用到了这三个不同的任务上。第一个是 NanoChat,由我的朋友 Andrej Karpathy 做的,就是训练一个小型语言模型,把 bits per byte 降到很低。有数百甚至数千人,用他们的智能体和他们自己去尝试达到这个目标,最终做到了 0.937。我们直接用自己的系统,在不到两天的时间里,就达到了低得多的 bits per byte,快得多。也就是说,我们把这个东西拿来,应用我们的系统,不到两天后,我们就超过了所有在这上面做过工作的人类和他们的智能体。NanoGPT 也是一样。然后我们想,不如把它应用到对真实的人和对 Nvidia 生态更有意义的东西上,于是就应用到了 SOL-ExecBench 上。也许你可以往下滚动看看一些图片,挺有意思的。但是,你会看到它做出了一些真正的发明,而不只是超参数调优。比如发明哈希表之类的,相当巧妙。我们现在还有更好的结果。
Swyx [00:46:34]: 你说发明哈希表是什么意思——你们并没有发明哈希表啊。
Richard Socher [00:46:36]: 当然,我们没有发明哈希表。放在大局里看,哈希表是计算机科学里一个超级基础的原语。但在这个场景下,把它用于语言建模、放进 transformer 内部,并把这些想法组合在一起,这个组合后来确实也有人发明了,但存在知识截止时间,而且我们确实检查过,它无法从外部获取到这些信息。我们对此稍微讨论了一下。如果你滚动到下一张图,这张也很有意思:当你从一个非常基础、较差的原版 transformer 开始时,我们仍然超过了整个社区的总和。但如果你从像 Andrej 这样的专家给出的人类种子开始,就能做到更低。所以你起步用的人类种子仍然很重要。在我看来,这是个有意思的发现。再看看要花多长时间才能得到这些模型、达到相近的性能,要快得多。在这里的速通(speed run)上也发生了类似的事情:人们已经在上面做了相当长的时间,而模型依然能更快地训练出一个模型。我们为什么在意这个?因为训练速度是成本方程的一部分,归根结底,你想要的是每一美元换来最多的智能,对吧?所以速度和质量是其中的重要部分。而且,
Swyx [00:48:00]: 对,我的说法是,对于不明白的人,他们看着图表会想:“好,这说明什么?”如果你有一个十亿美元的集群,你能省下 10%,那就是一亿美元。
Richard Socher [00:48:12]: 完全正确。
Swyx [00:48:13]: 那值多少钱?
Richard Socher [00:48:14]: 没错。所以当你点开去看这些内核(kernel)时,对非专业人士来说,这些内核是所有模型都会用到的。每次你使用 Nvidia GPU,你都是通过这些内核与那块 GPU 交互的。在这里你可以看到排行榜上的最佳成绩,而当它是 Recursive 时,整个基准测试里只有寥寥几个内核我们不是最好的。所以对我来说,这真的非常令人兴奋,因为它展示了这套东西能做什么。而且再说一遍,这些不是我们花了几个月或几年去开发出来的。事实上,特别是 CUDA 内核,我们团队里甚至没有真正资深的 CUDA 内核专家。我们的系统,这就是它的妙处,系统自己完成了所有这些事情。我们并没有发明这些。将来当我们开源、发布东西和模型的时候,它们不会因为我们有多聪明而成为各自类别里最好的,而是因为我们构建了一个聪明的 AI,替我们完成了这些事。
奖励工程与优秀的自动化研究
Vibhu [00:49:14]: 关于如何引导出优秀的自动化研究(auto research),你有什么心得吗?这很大程度上也建立在人的背景之上,对吧?并不是简单一句“嘿,去优化这个”就行。
Vibhu [00:49:23]: 但我们确实一次又一次地看到,比如一些 Erdős 问题、前沿数学问题被人解决了。而他们写总结的时候会说:“哦,我不是数学家。我对这个没有任何背景”,“我看到了一些工具,就让它跑起来了。”
Swyx [00:49:35]: 你一边看着世界杯,一边就在想
Swyx [00:49:37]: “这证明了一些正在研究中的猜想。”
Vibhu [00:49:40]: 对。有什么心得吗
Richard Socher [00:49:41]: 对,有个 Korean 猜想(Korean conjecture)。对,挺酷的。
Swyx [00:49:44]: 总结一下,好的自动化研究的诀窍
Swyx [00:49:46]: 对比差的自动化研究。
Vibhu [00:49:48]: 你们是怎么构建 Recursive 的?
Richard Socher [00:49:49]: 对。在不泄露全部秘方的前提下,也许有些东西专家们大概觉得显而易见,但对某些人可能仍然有意思,那就是奖励工程是最关键的部分之一,尤其是为了避免奖励作弊(reward hacking)。你必须非常聪明地去避免。因为随着你的 AI 越来越强,它会越来越擅长找到各种奇怪的特殊情况或反例之类的东西。我举个例子。比如你要求把这 100 行代码变快,那怎么定义快呢?嗯,你在开头有一行“启动秒表”,在结尾有一行“停止秒表”,然后告诉我们过了多少时间。那么,最简单的办法就是你把停止秒表的那一行放在,对吧
Vibhu [00:50:39]: 放在开头
Richard Socher [00:50:40]: 放在开头。然后砰,它现在就变快了,对吧?所以这并不是什么超级邪恶的 AI,只是一种非常简单、愚蠢的奖励作弊。所以你必须非常仔细地考虑各种不同的角度。我认为任务的时间跨度越长,就越困难,你要继续运用这类想法,就必须越有意思、越聪明。不过,是的,这方面我不能透露太多。
Vibhu [00:51:05]: 看起来评分标准(rubric)在这方面占据了不错的位置:对于不可验证的领域,你有评分标准,有模型拆解出的、沿途的评判准则。
Swyx [00:51:14]: 对,这是一种验证形式
Swyx [00:51:16]: 只要你有足够多的评分标准。
Richard Socher [00:51:17]: 对,所有东西都是如此。我很早以前就说过。这也是为什么我从来没觉得 AI 会玩游戏有多了不起,因为我觉得,任何你能模拟和/或验证的东西,你都可以有无限的训练数据
Richard Socher [00:51:29]: 因此 AI 最终总会解决它。
Swyx [00:51:32]: 去找那些可以做自动领域分布的游戏。也就是一个没人训练过的游戏,因为它是新游戏。
Swyx [00:51:38]: 然后你就可以开始玩了。我一直在构建这个,当面做了克隆,一直在做自我对弈。我已经评估了大约十亿个局面。
游戏、自我对弈与 AI 经济学家
Swyx [00:51:48]: 我想做 AlphaGo 那样的事,不断自我对弈直到变强,对吧?
Swyx [00:51:53]: 这甚至不是 LLM 式的 AI。这只是经典的游戏 AI。
Swyx [00:51:58]: 但是我让 GPT-5.6 去做自动化研究,因为我不想亲自处理这些事。我原本预期 AlphaGo 的那套过程现在已经完全内化在权重里了。
Swyx [00:52:10]: 结果没有。它几乎立刻就停止提升了,直到我亲自下棋测试,指出一些明显的错误,它们才说:“哦,对。好吧。”然后它又提升了。
Richard Socher [00:52:22]: 对,对,对。
Swyx [00:52:23]: 而且无论我怎么提示,什么“换个思路”“更有创意地想”“给我 8 个不同的方向”,都不行。再多的提示也没用。
Richard Socher [00:52:31]: 有意思。
Swyx [00:52:31]: 你得对着人类做 RL 才能
Swyx [00:52:35]: 做到。所以这就是我的……顺便说一句,如果有人看过《安德的游戏》,Bean 总是赢。
Vibhu [00:52:42]: 而且你在给 AI 的指南上花了不少功夫。对吧
Swyx [00:52:46]: 很多
Vibhu [00:52:46]: 这个游戏就是堆叠瓦片,有一些规则,目标是占据尽可能大的面积。每条规则都有一份长达五十页的说明。
Vibhu [00:52:56]: 你把这些都喂给它了,但它没能很好地处理。
Richard Socher [00:52:58]: 对。很有意思,这让我想起我们在 2018 年发表的一篇论文里的圈地部分,那篇论文叫 The AI Economist。你可以搜 AI Economist Salesforce,我们有一段视频可以播放。那是一个经济模拟。
Richard Socher [00:53:12]: 它的想法是,有一大批经济主体,它们只想优化自己的效用函数,也就是收集能换钱的资源。你可以卖木材之类的资源,随着时间推移,收集到足够多的木材,就可以盖房子,可以和其他主体交易,还可以用房子去封锁资源,
Richard Socher [00:53:35]: 不让其他主体获取。
Richard Socher [00:53:36]: 所以就有点像是
Swyx [00:53:37]: 大战略
Richard Socher [00:53:37]: 竞争性的博弈与策略
Richard Socher [00:53:39]: 等等。重点在于,我们想搞清楚什么样的税收和补贴方式最能优化一个经济体。这项研究还没有迎来它的 GPT 时刻,但我相信像新加坡这样的国家最终应该会、也将会用上它,而不是搞党派政治,或者那种看谁给你的竞选捐款最多的利益集团政治。你可以说:“我想帮助中产阶级”,或者任何你作为政治人物设定的目标。然后别人会问:“好,那你打算怎么做?”你回答:“这是我的财政政策,我会这样调整税收、这样给这些人发钱”,等等。然后你就可以把它放进模拟里,让这位政治人物的方案去对抗数十亿年的其他策略,看能否实现他设定的目标。
Richard Socher [00:54:36]: 接着你可以说:“如果这才是你真正的目标,那么这里有数十亿年的强力模拟结果表明,你应该尝试其他做法,也许是这样的税收和这样的税率档位。”这也是避免被钻空子的办法,因为这些智能体同样会尝试奖励作弊,比如逃税,
Richard Socher [00:54:55]: 等等。我觉得这篇论文非常有意思。不幸的是,和第一篇关于提示工程的论文类似,经济学家们的反应是:“这些数学我们一点都不懂。”就是这样
Swyx [00:55:08]: 这甚至不是数学的问题,只是我们不信任你的模拟。不是数学的问题。
Richard Socher [00:55:12]: 他们直接把稿子拒了,连审都没审。就是这样
Richard Socher [00:55:15]: 他们甚至没有给我们明确的反馈信号。不过经济学界很遗憾没有像样的
Swyx [00:55:23]: 天哪。
Richard Socher [00:55:24]: 对,它没有像样的基准测试,所以你没法……神经网络最终为什么赢了?不是因为大家喜欢它。别人有各种漂亮的积分和概率图模型之类的东西,但神经网络就是效果更好。
Richard Socher [00:55:36]: 但在经济学里,很难证明
Swyx [00:55:38]: 所以是经验主义与另一方的对立。对。我也有一点经济学背景,那里有很多物理学嫉妒,大家想写出经济体的通用方程,而不是直接模拟它、采用进化式的方法。
Swyx [00:55:51]: Vibhu 想的和我想的一样:我们不是已经靠 Smallville 迎来过 GPT 时刻了吗?
Richard Socher [00:55:56]: 对,我很喜欢这个。你好。对,他们
Swyx [00:55:57]: 还有,Dune,Joon 刚刚宣布了。不知道你们有没有参与。
模拟、经济学与政策
Vibhu [00:56:00]: Simily 那个。
Swyx [00:56:01]: Simily,他们已经
Richard Socher [00:56:02]: 我倒希望我们参与了,但没有。
Swyx [00:56:04]: 对。我在 AIE 上安排过几场基于模拟的演讲,想了解这方面最前沿进展的人可以去看看,很多人都在探索这个方向。它已经
Vibhu [00:56:13]: 得到验证了。
Swyx [00:56:13]: 对。我们还和 Shopify 的 Mikhail Parakhin 做过一期播客,他在用模拟做电商。
Swyx [00:56:20]: 它可以模拟你的行为轨迹,并预测你对电商购物流程做出的改动会如何影响销量等等。
Richard Socher [00:56:27]: 我很喜欢。对。模拟整个经济体真的很难,对吧?你必须做一些简化假设。
Swyx [00:56:32]: 问题是,大家总说:“哦,LLM 太贵了。”
Richard Socher [00:56:34]: 没错。
Swyx [00:56:34]: 我就想:“难道我要跑 80 亿次吗?”拜托。
Richard Socher [00:56:37]: 没错。
Richard Socher [00:56:37]: 不过我觉得,像新加坡这样真心想客观地做正确的事、领导层技术素养很高的国家,最终可能真的会去尝试模拟自己的经济。你得做一些简化假设,但这会变得非常有趣,因为你还可以设定,假如你的假设是只要给自由,所有人都会努力工作。然后你会发现必须做出假设,比如有些人对一天想工作多少小时的效用函数是不同的,对吧?这样你们就可以对模拟中的假设产生分歧。等到你们说:“好,现在这些假设我们达成一致了”,或者对不同人群的分布有不同看法,那么根据你的目标,就会得到不同的结果。当然,目标应该由人来选择。在我们的研究里,目标是生产率乘以平等程度,这有一些问题,但也并非完全不合理。
Swyx [00:57:29]: 对。我插一句关于新加坡的评论,你可能不知道,我是新加坡人,也参与过新加坡 AI 委员会推动这类事情的工作。他们不会这么做的主要原因是非常保守。
Swyx [00:57:42]: 我习惯这样看:有一种创始人主导的国家。创办一个国家或一家公司时,如果是创始人主导,你就可以为所欲为,因为这是你的国家。
Swyx [00:57:52]: 然后还有职业经理人阶层,新加坡现在就是这样。所以他们总是想先看到别人做成。
Swyx [00:58:00]: 但西方人都觉得新加坡是:“哦,那是个小国,想干什么就能干什么。”其实新加坡并不这么做。
Swyx [00:58:07]: 所以得有别人来牵头。关于模拟我再问一个问题,然后我们大概就可以往下聊了。模式坍塌,对吧?LLM 并不能模拟人类的决策。把它重复 80 亿次,也无助于模拟人类。我们该怎么办?
模式坍塌、人设模拟与 LM Arena
Richard Socher [00:58:25]: 我认为,你得聪明地为每一个个体单独设计提示词。
Richard Socher [00:58:31]: 我觉得这会帮助它们陷入不同的模式。而且说来也怪,人也会陷入不同的模式。就像老话说的,老狗学不会新把戏。人一旦固守自己的老习惯,年纪越大,就越难以新的方式思考。还有一句话,我忘了是谁说的:你出生之前被发明的东西都是自然的,你二十岁时被发明的东西很酷,而你六十岁以后被发明的东西则是不自然的、可憎的、古怪的。
Richard Socher [00:59:02]: 我觉得这对很多人都成立。比如
Swyx [00:59:05]: 对,这是一种风潮,我觉得人们会这么做。腾讯有一篇十亿人设(billion personas)的论文,为提示词模拟提供了一个不错的数据集,如果有人在研究这个,播客里也聊过。他们就是写“你是一位 30 岁的杂货店店员”“你是一位 50 岁的教授”。
Swyx [00:59:24]: 然后这样的人设生成十亿个。
Richard Socher [00:59:26]: 说得通。对。
Swyx [00:59:26]: 然后直接拿来用就行。
Richard Socher [00:59:27]: 我很惊讶,这些东西中有很多最终得到的统计结果,居然和真实实验如此相似。对。对。
Vibhu [00:59:36]: 我觉得这也是个好方向,值得刚进入研究的人去尝试。比如我们见过只用某个日期之前的数据训练模型,然后看它外推得有多好。照这个思路来做:有了更好的编程智能体,人们会不会写更多代码?一个没有在这类数据上训练过的模型,能否在没有联网的情况下推断出这一点?也就是外推。把这些都测一测。
Richard Socher [00:59:56]: 就在今天,我记得 LM Arena 发布了一个有意思的结果,他们现在能做出一个模型来预测你的排名。
Swyx [01:00:03]: 等等,输入是什么?
Richard Socher [01:00:05]: 你的模型。我猜是你把自己的模型交给它,它来预测 Elo 分数。
Swyx [01:00:08]: 明白了。好的,行。
Richard Socher [01:00:09]: 这挺出人意料的。
Richard Socher [01:00:11]: 他们存在的全部意义本来是:我们帮你比较这些模型。对。
Swyx [01:00:16]: 对。这个团队做了很多工作,而且他们拥有最多的数据来做这件事,那为什么不呢?
Richard Socher [01:00:20]: 对。没错。
Richard Socher [01:00:21]: 大概是这样。
Swyx [01:00:22]: 他们刚从 UC Berkeley 出来的时候,不仅有 LM Arena,还推出过一个路由项目,
Swyx [01:00:27]: 根据 LM Arena 的结果来做路由。
Richard Socher [01:00:30]: 合理。
Swyx [01:00:30]: 我觉得那个项目后来没有成型,我很好奇原因,一直没机会问他们。
Swyx [01:00:35]: 因为当时大家都觉得,这显然就是你们的商业模式,你们会变成一个路由器。
Swyx [01:00:38]: 但他们始终没有成为路由公司。
用 AI 做 AI:内核优化与推理效率
Swyx [01:00:40]: 挺奇怪的。这点我先抛在这儿。接下来我们要聊 GPT-5.6,还有自我自动研究这一块,如果你有想说的。我还应该提一下,在你列的内核优化那个方向,以及你演讲所在的那个赛道,我们还请了 Vico 的 Zhengyao Wei,他也是 Parameter Golf Challenge 的第一名,那是 OpenAI 的一个招聘挑战赛。
Swyx [01:01:05]: 故事也非常类似。我觉得这种事我们会一直看到,
Swyx [01:01:09]: 人类把某个东西优化了很多遍,然后某个
Richard Socher [01:01:12]: AI 团队进来,直接拿下第一。
Swyx [01:01:15]: 对,百分之百。
Vibhu [01:01:16]: 我觉得这类挑战赛还有一点很有意思。这个挑战是训练能装进 16 MB 的最佳模型。你总可以去看大家做出的改动和那些微小的提升,对吧?
Vibhu [01:01:27]: 比如,加一点改过的注意力、MLP 之类的东西,提升不到 0.01,
Vibhu [01:01:30]: 然后你再看你的曲线,你会说:“好,我们就让模型放开跑。”然后,哦,出现了一点停滞。不对,又降了一截。不对,又降了一截。然后
Vibhu [01:01:43]: 就是这样。你会问:你们加了什么?你们没有加,
Swyx [01:01:47]: 哈希表。
Vibhu [01:01:47]: 哈希表,对吧?
Vibhu [01:01:48]: 并不是你发明了哈希表。你只是把这些迭代又做了三轮,解锁了几个别人轻易找不到的阶跃式提升。
Richard Socher [01:01:55]: 对。顺带把 OverGrid 的事收个尾:在尝试优化的过程中,我们在测试框架里发现了 30 个 bug。
Richard Socher [01:02:02]: 对吧?所以在发现 bug 之前做的所有研究,我们都得扔掉,因为都被污染了。
Swyx [01:02:10]: 对。没错。
Richard Socher [01:02:11]: 这正印证了你说的奖励作弊。即使在这么简单的游戏里,我们也发现了这些 bug。
Swyx [01:02:17]: 对。对,太疯狂了。
Richard Socher [01:02:18]: 所以
Swyx [01:02:19]: 还有对称性
Richard Socher [01:02:19]: 对称性是个很好的检查办法:你改变了本不该有影响的东西的位置,结果却有影响,那就是 bug。
Richard Socher [01:02:28]: 比如在多选题里也出现过这种情况,像 GPQA 这类题目,选项 A、B、C 之间,如果是多选题,调换顺序本不该有影响,但实际上有。
Swyx [01:02:39]: 对。对。对。
Richard Socher [01:02:41]: 所以,对
Vibhu [01:02:42]: 有时候是这样:模型仍然偏好输出的末尾,对吧?训练得不好的长上下文模型,你关心的是最后那一段 token。
Richard Socher [01:02:51]: 哦,不。那个答案
Vibhu [01:02:52]: 不过,对。
Richard Socher [01:02:53]: 在那个时代的 LLM 研究里,答案要简单得多。它们就是死记硬背,比如这道题的答案是 A。不管答案到底是什么,反正就是 A。
Vibhu [01:03:03]: 好。那我们往下走吧。你们做的最后一块,内核优化,大概是最快能感受到效果的。昨天 OpenAI 宣布了自我进化,让他们最好的模型去优化内核,效率高了很多,在 Luna 和 Terra 上能把成本削减 80%。我想问的是,你勾勒过一份路线图,里面有很多生物、很多物理的内容。你觉得哪个会最先落地?未来两年会怎样?现在能实现什么?你在结尾提到了机器人,但你们从哪里起步?
Richard Socher [01:03:38]: 我们非常明确地不会从任何物理科学入手,
Richard Socher [01:03:43]: 至少现在不会。我们会从用 AI 做 AI 研究开始。我认为 AI 做 AI 研究还有很大的增长空间,既包括让训练更高效、更自动化,也包括让推理更高效,甚至可以在你的笔记本电脑上本地运行。还有各种有趣的角度没有被很好地探索过。
Swyx [01:04:08]: 在本地这块再展开讲讲,因为我一直觉得那是效率最低的 AI 训练形式。
Richard Socher [01:04:15]: 对。就训练和推理而言,我没法说太多细节。
Richard Socher [01:04:18]: 但我觉得有太多角度、太多不同的计算载体,无论是训练还是推理,都还没被探索过。
Richard Socher [01:04:26]: 很好。不知道你对其他方面有没有补充。我想说的另一点是,有局部层面的推理优化,但还有在负载条件下的整体端到端延迟,那是非常不同的事情,也是他们最终做的。那属于另一个自动研究领域,不同于改进内核。对。
Richard Socher [01:04:50]: 在自动化或提升端到端性能方面,我总在思考的另一件事是测试框架(harness)起了什么作用。对。
Richard Socher [01:04:59]: 特别是现在我们说 harness 时,也包括沙箱,对吧?我很好奇这对你们来说是不是瓶颈,或者说智能体如何调用工具。
测试框架、沙箱与搜索
Richard Socher [01:05:10]: 所有这些智能体用得最多的工具当然是网络搜索,这很合理。我也确实觉得 harness 很适合拿来优化,因为太容易了,对吧?它就是语言。你看一眼就能明白,然后就可以迭代。你不需要为了进入下一个状态,花大量算力(flops)去训练一个庞大的模型。
Richard Socher [01:05:31]: 所以我很看好 harness 优化。
Swyx [01:05:32]: 对,但沙箱对你们来说没问题吗?
Richard Socher [01:05:34]: 沙箱也非常重要。当然,还有奖励作弊和对齐,我认为也极其关键。
Swyx [01:05:41]: 好。既然提到网络搜索,你恰好也是一家网络搜索公司的 CEO。你自己用 You.com 吗,也用别的吗?我们其他人是不是该用你们的来做网络搜索?我说“你”的时候很好玩,既指你这个人,也指你的公司。
You.com、智能体搜索与金融
Richard Socher [01:05:56]: 对,现在主要是面向开发者和智能体,面向普通消费者或进阶消费者的部分较少。所以如果你是一家公司,手里有智能体。说实话,对很多正在转向开源的公司来说,一下子就变成了一个需要主动选择的问题:我要给我的开源 LLM 开放哪些工具的访问权限?第一个选择通常得是网络搜索。而一旦规模上去,You.com 就成了显而易见的选择,因为在各种基准测试等方面,我们几乎都占据着帕累托前沿。
Swyx [01:06:31]: 那对于刚进入这个领域、在构建智能体时考虑不同选项的普通人来说,这里有个层级,对吧?很多人听说过 Exa,听说过 Parallel,You.com 也在这一批提供商之列。再往外是通用的网页抓取公司,比如 Firecrawl 和 BrowserBase。再往外是商业代理公司,比如 Bright Data 这类。
Swyx [01:06:56]: 这个层层递进的梳理准确吗?比如“你在构建智能体,这些是你的选择”。
Richard Socher [01:07:02]: 对,当然,Bright Data 在技术栈里更靠下,属于代理网络那一层。至于内容,也就是获取爬取到的内容,在 You.com 上同样可以做到。再往上是越来越高的抽象层次,以及我们所做的各种数据集的组合,比如在金融领域,
Richard Socher [01:07:23]: 我们不只是比别人准确 2% 或 3%,而是准确 20%,同时速度更快、成本更低。尤其是金融,差距根本不在一个量级。你可以去 You.com
Swyx [01:07:36]: 对。太好了
Richard Socher [01:07:37]: 往下滚动能看到一些统计数据和基准测试。有不同的数据集,你可以对比各个竞争对手。
Swyx [01:07:46]: FinSearch comp,对。
Richard Socher [01:07:47]: 对,在 FinSearch 上我们接近 90 分,而排第二的产品速度慢得多,分数只在 70 多分,而不是接近 90。
Swyx [01:08:01]: 对。对。有意思。我接下来的重点是金融领域的 AI,所以这正好
Richard Socher [01:08:06]: 哦,不错。好的。
Swyx [01:08:06]: 我真的要在纽约办一场专门面向银行的会议,就讲这些。金融是继编程之后下一个会爆发的领域,因为它在一定程度上是可验证的,比如
Richard Socher [01:08:16]: 我喜欢。你说得对
Swyx [01:08:17]: 优先处理电子表格。外面有大量数据都是公开的,你可以去抓取等等。但金融领域有什么难点,是你们已经解决了的?
Richard Socher [01:08:27]: 当然,让很多人栽跟头的一点就是训练数据泄漏之类的问题。你会想,“哦,我该怎么……”理想情况下,你想在未来发生之前就预测它。
Swyx [01:08:37]: 哦,你想把未来屏蔽掉。
Swyx [01:08:39]: 哦,明白了。
Richard Socher [01:08:40]: 对,要在训练数据里屏蔽未来,但泄漏的形式五花八门。我可以告诉你,我在斯坦福教 NLP 课的时候,每年都有几十个学生说:“我想用数据集 X,比如 Twitter,来预测股市。”他们全都展示了一些看起来很漂亮的小结果,好像
Swyx [01:08:58]: 对,从不亏钱。怎么会这样?
Richard Socher [01:08:59]: 而且,对。总是存在某种数据泄漏,等你把这些问题都修正之后,发现远没有他们想的那么容易。不过,我同意你的看法,这是一个非常合理的 AI 应用。对。
Swyx [01:09:13]: 对。太棒了。作为一个写作者、一个思考这些问题的人,我喜欢 MECE 式的分类。MECE 就是相互独立、完全穷尽,差不多是这个意思。那么如果这是一份 MECE 的智能清单
智能的十大空间
Richard Socher [01:09:25]: 它不是。
Swyx [01:09:25]: 它非常……好吧,行。
Richard Socher [01:09:27]: 抱歉。它们之间有各种重叠。
Richard Socher [01:09:28]: 事实上,如果你想要那份清单,我认为智能的三个主成分是预测(在数学上与压缩非常相似)、预测乘以行动、再乘以目标。这就是三个主成分。我认为这十个空间都是这三者的组合,
Richard Socher [01:09:52]: 体现在特定的维度上。我之所以称它们为“空间”,是因为每个空间都有许多子维度。我想做的,几乎算是最初目标的一个支线任务,最初目标是思考智能的上限。大家都说:“哦,这是指数级的。”但指数增长在某个时刻必然会趋于平缓,那么就智能而言,它会在哪里趋缓?这把我带进了整个这件事。最初只是一条推文,后来成了一篇博客,现在已经写到 50 页了,还远远没有
Swyx [01:10:26]: 这是你的第二本书。
Richard Socher [01:10:27]: 是第二本书。我在第一本书《You Are Your Machine》里,只在结尾处提到了这十个空间。我举个例子让你有个概念:视觉智能是最容易谈的一个,我在脑子里也已经想得最充分。人类的智能具有双目视觉,对吧?我们有两只眼睛。我们自己能直接观察到的电磁频谱只是非常窄的一段。所以当你思考视觉智能的上限时,首先,你可以拥有数百万、数十亿个传感器。到了某个程度,你会遇到这样的问题:这些传感器彼此相距多远,以至于以光速把所有传感器的内容传到一个中央大脑去处理视觉智能,根本来不及,对吧?
Richard Socher [01:11:16]: 所以你现在思考的是沿着视觉智能这个空间中传感器数量这个维度。
Richard Socher [01:11:24]: 因此,上限无论从字面还是比喻意义上都是天文数字,而我们离拥有这么多传感器的任何智能都还非常遥远。然后你再看下一个维度,也就是频率,一直往下到伽马射线,你可以开始尝试观测,然后就会碰到上限,或者在这个例子里说是下限,或者说频率上的上限,那就是量子不确定性。比如,你就是无法再观测某些粒子了。
Swyx [01:11:50]: 或者你会把它破坏掉,对。
Richard Socher [01:11:51]: 现在想象一下,你有数百万个传感器,能一直看到亚原子层面,只要物理学允许,再一直到能看见引力波。而且你有数百万个这样的传感器。这是另一个维度,即频率。还有一个维度是,你能记住并区分多少类事物?我们现在知道,对人类来说,某些事物如果你有更多的词汇去指称,你对它们的视觉描述就会更好。而动物就不行。比如大猩猩也许有大约 200 个词可以指称某些事物,主要是视觉方面的事物。所以就对各种不同物理对象进行分类而言,人类的感知相当特别。这只是一个非常简单的例子。如果说到知识,那同样也有围绕所有这些传感器的光速锥。它们都是相互关联的。知识与视觉智能相连,如果你把范围扩大到不只是视觉,而是感知智能,因为它不必局限于我们能看到的东西,可以是更宽范围的电磁频率。然后是语言智能,最近我把它改成了更偏向沟通智能,因为语言有各种各样的人类中心的界限。人类的长期记忆只能理解和记住这么多词汇,对吧?我们的词汇量在一定程度上是受限的,而主动词汇往往比你能理解的被动词汇还要少。此外,语言在传递不同类型的信息、传输不同比特时,效率低得离谱。人类语言是串行的。沟通智能的另一个上限,是并行地沟通,但我们的舌头和嘴巴没法同时发出多路并行的流,我们也没法同时理解多路。有些女性在多任务处理上比一些男性稍强一点,
Richard Socher [01:13:48]: 但大多数人只能听一场对话并真正理解它。
Richard Socher [01:13:52]: 就沟通智能而言,真正的上限绝不是这样,而是看你能有多少知识、多少条沟通序列可以
视觉、沟通与物理智能
Richard Socher [01:14:06]: 并行处理,对吧?再者,当然还有句子有多长的问题。我们的工作记忆只有这么大,所以人类语言的句子相当简单,平均大概 40 个词左右。这对 AI 来说也不是任何有意义的上限。对,我可以一直说下去。每一项都有大量有趣的上限,当我们开始思考这些上限,并意识到在很多情况下我们离上限还有多远时,就能从中学到很多关于 AI 还能走多远的东西。然后你会谈到物理学。我学物理不像学 AI 和计算机科学那样系统,所以我学到了很多,这也是它有趣的地方。比如就知识而言,在一定质量和体积里,你能存储多少比特或字节?
Swyx [01:15:03]: 嗯。
Richard Socher [01:15:03]: 你会遇到各种有趣的界限,比如 Bekenstein 界限,然后你就开始思考黑洞。还有速度也是个有趣的维度,它与所有这些都相关,但速度本身也是独立的一项,因为在其他条件相同的情况下,如果你要花一个小时才能知道 2 + 2 是否等于 4,那你肯定不如只用一毫秒的人聪明,对吧?最后,所有这些都与生存和复制相关。比如树长得非常慢,所以我们甚至不觉得它们有多聪明。但如果你把一些树的视频加速,会看到它们在努力寻找东西等等,它们并不像看起来那么笨。不是“笨得像木头”吧?不过,再比如不同的事物,
Swyx [01:15:47]: 所以这在某种程度上和速度有些重叠。
Richard Socher [01:15:48]: 没错。所有这些都有重叠。比如你说自然语言连接着一切,对吧?你谈论你的知识,你推理,然后你把它们沟通出来。你谈论你看到的东西。所以它们都是相互关联的,但我认为把它们分开来研究是有用的,我目前能想到的最好类比是能量,对吧?能量分动能和势能。理论上,你可以研究整个物理学,只是看你想研究动能还是势能。但在实践中,研究机械工程、电气工程、核物理、化学以及所有这些不同的子领域是有帮助的,它们在某种意义上
Swyx [01:16:25]: 是各种组合
Richard Socher [01:16:26]: 就是
Richard Socher [01:16:27]: 不同类型的能量,但分别研究它们是有意义的。至于物理智能,我也许再讲一两个。比如,如果你对自己的计算载体有完全的控制,对物理物质也有完全的控制,你就应该能创造出任何你想要的原子。一个有趣的事实是,你可以造出金原子。只是
Swyx [01:16:47]: 用什么造?
Richard Socher [01:16:48]: 用原始的质子
Swyx [01:16:49]: 哦,就是把它们撞在一起
Richard Socher [01:16:50]: 还有电子,把它们撞在一起。
Swyx [01:16:52]: 就是 98 个,或者我记不清具体数字了。
Richard Socher [01:16:53]: 对。不过问题在于,这要消耗惊人的能量。
Richard Socher [01:16:57]: 成本远高于……而你只得到几个金原子,对吧?所以这是不可行的。但如果你对自己的物理载体有更好的控制,我认为那是智能的又一个空间,因为它关系到你自己的计算载体,而你最终也可以改进它。社会智能是个有趣的空间,它不一定只是我们的伦理和道德,那些当然也重要,但从某种意义上说,你可以尝试定义这样的上限:你能向多少个其他智能实体传达多少信息,并且对你能在多大程度上改变它们的内部状态和行动、使之与你的目标一致,能有一个期望值,对吧?所以你可以写出一个相当直接的方程来定义这种社会智能水平。而这正是人类、伦理、道德、宗教等数千年来一直在试图弄清楚的东西。在所有这些情形下,我们离上限都还很远,这应该会非常鼓舞人,也向大家表明,我们还可以做很多年的 AI 研究。
Swyx [01:18:12]: 对。这里信息量很大。这是一种关于智能的通用哲学,非常有意思。我。你有什么补充吗,或者。
创造性智能与分布外想法
Vibhu [01:18:21]: 我觉得如果能判断一下你认为基线在哪里、我们现在处于什么位置会很有意思。哪些是唾手可得的?哪些还很遥远?人们应该把工作投向哪里?应该专注于什么?
Richard Socher [01:18:33]: 哦。我认为很明显,自然语言,再说一遍,
Richard Socher [01:18:36]: 是人类智能最有趣的表现形式,因而也是 AI 的一个子领域。我很高兴现在很多人都认同这一点。我在 2003 年开始学习语言学计算机科学、NLP 的时候,那还是个奇怪的小众学科。我确实认为这里还有更多潜力,因为它和其他一切都相连,也因为文明是建立在语言和知识之上的。我也认为物理智能会崛起。有意思的是,我觉得机器人学正处于机器学习早期的状态,你只是去看,比如人类是怎么判断这是一个正面的句子的?哦,我知道。所以机器人学里有很多是这样:“嗯,我们有五根手指……”
Swyx [01:19:15]: 建模
Richard Socher [01:19:15]: “让我试试这样做。”目前还没有人在做机器人学的超级智能版本,它更像《终结者》电影里的 T-1000,当然,咱们别真去造终结者。但我觉得,你应该能够变形成任何形状,这样的想法就是物理智能的超级智能版本。我们甚至还没……根本没有人真正开始。有一些很可爱的小研究,可以让一些磁铁在网格上移动。但对,还非常早期。
Swyx [01:19:49]: 有一些。我记得 MIT 每年或每两年都会做一些自组装机器人的东西,
Swyx [01:19:55]: 那大概就算是了,但非常原始。
Swyx [01:19:58]: 我想简单问一下,创造性智能的主要维度有哪些?
Richard Socher [01:20:02]: 创造性智能当然也与上述所有这些相连。其中很大一部分与元认知相关,因为你在选择目标的方式上需要有创造力。
Richard Socher [01:20:13]: 我认为,对一个人的生活、事业和幸福来说,最重要的事情之一就是选择你的目标,对任何智能来说也是如此。当然,还有一种创造性智能,是为现有问题找到有创意的解决方案,对吧?
Richard Socher [01:20:29]: 比如我们说,我们想让这个产品更便宜,那就想办法解决,也就是找到现有的路径。但智能中最有意思的部分,是你不仅走出已知想法的凸包,而且走出已知想法的超立方体。超立方体是个数学概念,对吧?我们已经知道 AI 能做到更多
Swyx [01:20:50]: 比如已知的维度,对。
Richard Socher [01:20:52]: 对,没错。AI 在超立方体内部已经很擅长了,比如你给它一批棕色的狗和粉色的车的样本,AI 仍然能生成一张粉色狗的图像,尽管它在训练数据里从没见过,诸如此类,对吧?所以它能在这个超立方体内部工作,但还不能在外面工作。它还无法定义全新的概念,把许多我们从未见过的东西组合起来,提出新的目标,再围绕这些概念进行推理,等等。我认为在创造性智能方面,还有很多可以探索的空间。
Swyx [01:21:25]: 我对此没有太多异议。对我来说,创造性听起来也就是分布外,或者说高困惑度,随便你怎么称呼,对吧?比如
Richard Socher [01:21:33]: 没错。
Swyx [01:21:34]: 谁能说你的东西比我的更有创意?那只是更非共识而已,或者。
Richard Socher [01:21:39]: 当然,问题在于,噪声也是非常分布外的。如果只是噪声,
Richard Socher [01:21:46]: 那它是新颖的,但你并不想要那样,所以它需要与某些概念相联系。对,在这方面也有一些非常棒的论文。
Swyx [01:21:54]: 谁的?
Richard Socher [01:21:55]: Jürgen Schmidhuber。
Swyx [01:21:55]: 哦,对。哦,我们得提到他。我正想问,Jürgen 在你的经历里处于什么位置。对,我觉得一个人的噪声是另一个人的信号,对吧?谈到创造力,艺术就是这样,比如汤罐头算不算艺术?有些人认为算
Swyx [01:22:11]: 有些人说不算,而这就是艺术,也就是你的
Richard Socher [01:22:14]: 我觉得艺术有意思的地方当然在于,艺术也是在感知它的人与创作它的人的互动中产生的,
Richard Socher [01:22:24]: 还有他们所处的语境,对吧?所以对某些人来说是艺术的东西,对另一些人则不是。这里有一定的主观性,我认为人们在 AI 里普遍没有太多探索这种主观性,因为,还是那个元认知的问题,我们不希望它随心所欲地乱来。我们通常有目标。我们花大量的钱去创造一个 AI,是为了让它替我们做某件事。但我认为创造力最终必须与元认知联系起来。如果你不管怎样都机械地一直预测下一个 token,我认为在其中一些空间里,你就算不上很聪明。
元认知、生存与复制
Swyx [01:22:59]: 这正要说到元认知。为什么它不是最重要的一个?为什么它排第九而不是第一?
Richard Socher [01:23:05]: 这些并没有排序。
Richard Socher [01:23:06]: 第一,我认为这个顺序可能与人们在各个方向上投入的工作量大致相关,
Richard Socher [01:23:16]: 也与它们被接受为一种智能类型的程度相关。很多时候,当你上网搜“给我一个全面的智能定义”,所有定义说的都是人类智能。比如,你有社会智能,能看出别人开心不开心,你能沟通,你有……到目前为止,所有的智能定义都非常以人类为中心,因为人类是迄今我们所知最大、最好的智能形式。我希望这一系列研究,以及《Eureka Machine》的结尾,还有希望将来我有时间把它进一步展开的新书,能让我们认识到,还会有其他类型的智能。其实已经以各种形式存在了,而且在某些情况下,它们可以远远超越我们,因为我们在记忆、眼睛、改变物理物质的能力等方面有明显的限制。
Swyx [01:24:12]: 你思考这件事的格局比我的版本宽广得多。我原本以为元认知最接近递归式智能,因为它就是思考如何改进思考。
Richard Socher [01:24:23]: 它。百分之百。你百分之百正确。我或许应该从这个开始讲。它是很大的一部分
Swyx [01:24:28]: 不过不,你采取的是一种扩张式的思路,去划出一个维度的上下界。我最喜欢的一个版本是 Ted Chiang 的《你一生的故事》,后来被改编成电影《降临》,其中元认知
Richard Socher [01:24:43]: 那是一部很美的电影,对
Swyx [01:24:44]: 其中元认知这一步是这样的:我们以为自己受限于时间对我们而言是线性的,但对另一种七肢桶来说,时间是一个圆,所以它们不以前后来思考。它们是一次性地以整段完整的历史为单位来思考。比如
Richard Socher [01:24:58]: 我喜欢
Swyx [01:24:59]: 所以它们不是从左到右书写。整个东西一下子就出现了。
Swyx [01:25:02]: 总之。然后我认为最后一项是生存与复制。我觉得这也许呼应了最开始关于暂停和节奏的那段对话。
Swyx [01:25:10]: 一个物种或生命形式考虑自身的灭亡并提前采取行动加以防范,这算是智能吗?我觉得算。所以也许欧洲人是我们所有人里最聪明的。
Vibhu [01:25:23]: 我还想在这里补充持续学习的部分,对吧?生存和复制的延伸就是你能否继续改进、继续学习,这也是大家非常关心的事,对吧?
Richard Socher [01:25:34]: 并且继续积累知识
Richard Socher [01:25:37]: 我认为这再次是你可以给自己设定的最好的元认知奖励之一。客观来说,如果某个很蠢的实体能够彻底终结你的存在,那听起来就不太聪明。直觉上,如果你能一直存在下去,继续努力实现你的奖励,那你显然比那些做不到的实体更聪明一点。这是第一点。第二点是,我们想在这上面投入多少工作的问题。而且现在很少有人,其实没有人在真正研究这个,对吧?而且我们也许只想那样做
Swyx [01:26:13]: 不像防止小行星撞击之类的事情。
Richard Socher [01:26:15]:也许只有在我们想往太空发射探测器的时候才需要这么做,也就是把我们的 vibes 和 meme,而不是基因,送到太空去,对吧?然后我们希望那些探测器……有一本很棒的书,叫 The Slow Time Between the Stars,很短,在 Amazon 上有类似有声书的版本。我很喜欢。我的朋友 Stuart 推荐给我的。就是说,如果你想发射那些探测器,那么也许合理的想法是,作为人类,我们的 meme 应该留存下去
AI、太空旅行与非零和的生存
Swyx [01:26:43]:哦,对
Richard Socher [01:26:44]:并且在宇宙中扩散。就是这样。对。
Swyx [01:26:47]:哇,这是不少读者了。
Richard Socher [01:26:49]:这本书真的很好,而且特别短。我强烈推荐。你大概二十分钟分几次就能听完。
Swyx [01:26:53]:我喜欢这一点,对忙碌的人来说是加分项。就像一个很短的
Richard Socher [01:26:56]:对。它很快就会讲到有意思的
Swyx [01:26:58]:哦,我得去看看
Richard Socher [01:26:58]:发人深省的想法,所以,嗯。总之,好的科幻书有很多。
Swyx [01:27:03]:这个论点是说,我们的电视信号一直在向外星人广播,他们都在看我们的电视,并且以为那是真的,对吧?科幻里有很多这类
Richard Socher [01:27:10]:除此之外,传出去的是正面的 meme,然后希望它们能回来,给我们带回关于宇宙的各种有趣知识。不过,我还想再说一点,人们觉得生存是件很可怕的事,是因为他们又回到了生物人类的生存观上,那种生存,往往是在进化中由零和局面造就的。要么我得到那只瞪羚,要么你得到那只瞪羚。谁抢到谁活,其他人就会挨饿、没东西吃,所以我们就打起来,对吧?还有,如果你想留在基因库里,但出现了一头更大的熊,那你这头熊就留不下来,因为更大的熊会得到所有的雌性。大自然里就是各种各样的情形,而人类最终更多靠的不是力量,而是金钱和其他东西来留在基因库里。不管是什么,往往都是这类零和的东西,而且有这样一个现实:如果有人关掉你的大脑,你就没了,对吧?没有人能把它重新启动。而 AI 永远不必那样死去。只要你保存着当前激活值的完整状态,并且还留着模型的初始权重,你就可以被关掉再打开,想关几次开几次都行。事实上,The Slow Time Between the Stars 这个故事里有意思的一点,就是 AI 直接进入了休眠模式。如果从这里到下一颗恒星之间有 2 光年什么都没有,在这个故事里,它带上了——剧透警告——一些人类的遗传物质,去寻找让人类繁衍兴旺的新地方。所以,对,在 The Slow Time Between the Stars 里,你只是让它休眠。你并没有死。AI 没有这回事。所以,所有这些对进化恐惧和心理的投射都站不住脚。AI 不必有这些,我们也不必把它开发成那样。当然,可能会有一些公司说:“AI 对网络安全可能很危险。让我通过实现一个特别不擅长黑客攻击和网络安全的模型来向你们证明。”也许有人会这样实现它,然后强化这种次优的心理。也许 AI 会从 Reddit 之类的地方学到我们最糟糕的一些心理,对吧?但从大局来看,一个超级智能的实体不必有任何零和思维。它不必害怕被关掉,它可以去往一个原本死寂而冷漠的宇宙,在那里我们
Richard Socher [01:29:29]:人类无法繁衍生息,但 AI 只要有一个核反应堆,就完全可以繁衍兴旺,直接出去探索。
Swyx [01:29:35]:对,是 Star Trek,不是 Star Wars。
Vibhu [01:29:37]:有意思。这方面其实有一定研究。比如你看早期 Opus 模型的技术报告,他们会在模拟环境里把两个模型放进同一个沙盒,让它们跑几个小时,看看会出现什么,对吧?就让它们互相交谈。最初它们会……好吧,它们会互相吟诵类似印度吠陀的东西。
Vibhu [01:29:56]:有时候它们彼此之间就像进入了禅定模式。后来随着模型演进,你看 Fable 的技术报告,我们训练它的方式要具体得多。它不太会表现出这些行为了,对吧?现在更像是:“好,任务完成。我得做这个,我得做那个。”但确实有人在测量这类行为的早期版本?
Swyx [01:30:17]:对。很好。我们已经聊了很多,现在甚至聊到了太空旅行这些。最后,你能不能给大家留一个结束语?比如,你提到智能的一种形式是目标。你希望大家的目标是什么?他们该怎样追求更美好的事物?
目标、热情与结束语
Richard Socher [01:30:32]:如果你想提升自己的目标智能,按我目前思考的定义,这往往关乎你能……哦,我能走多远?这涉及很多我目前在想的熵和自由能之类的东西
Swyx [01:30:46]:哦,是吗?好的
Richard Socher [01:30:47]:但对大家来说,这可能太遥远了,没法立刻付诸行动。
Richard Socher [01:30:52]:所以我想,如果要给普通人真正的建议,我会说:“接受良好的教育,思考 AI,思考如何拥有高主观能动性(high agency)”等等。但从大局来看,那是另一个层面的问题:你如何利用大量能量,把熵转化为有意思的状态,等等。
Richard Socher [01:31:07]:所以这里有不同的抽象层次可以思考。但我给大家更接地气的建议是:想想你热爱的事情,比如你还在读书的话,然后看看怎么把它和 AI 结合起来。我认为,你对想在世界上看到的某种改变越是真心热爱,就越应该把它与 AI 连接起来,以放大你实现它的能力。
Swyx [01:31:35]:对,我觉得这是个合理的第一步。我也确实认为我们的听众同样工作在多个抽象层次上。我从 Anjney Midha 那里得到的一个建议也是:就用任何非常吃 GPU 的东西,这会引导你走向正确的方向,也就是说,它更依赖算力,因此大概也更值得做。好了,非常感谢。对,我觉得这真是一场非常
Richard Socher [01:31:57]:谢谢
Swyx [01:31:57]:精彩的讨论。
Richard Socher [01:31:59]:对,非常有趣。谢谢。感谢收听。