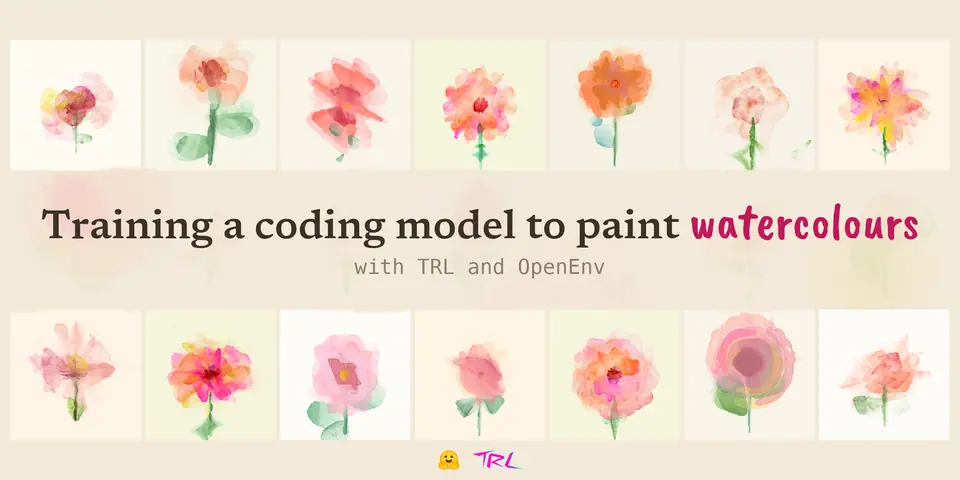

8 月 23 日,Surya Narreddi 发布了一段精美的视频,内容是由语言模型绘制的水彩画。该模型通过 p5.brush 编写 JavaScript,这是一个“为 p5.js 增添自然绘画工具”的库。视频迅速走红,撰文时播放量已超过 150 万。
视频附带了一篇博客文章,讲解该项目一个更早、范围更窄的阶段的训练过程,画的是花朵特写,而不是视频里的完整构图,遗憾的是目前还没有公开的产物。他的网站说完整的技术报告即将发布,所以请关注他。最初的点子是他的,来自艺术与设计一侧,在那里他的功力远在我之上。我的尝试则在工程一侧,把这套方案公开复现出来,并发布每一个部件。
注:想了解这个项目背后的来龙去脉,由 Surya 本人讲述,请观看他的论文视频。
在本文中,我尝试用 TRL 和 OpenEnv 复现他的想法。参考图库数据集、强化学习环境、训练脚本和训练好的模型,全部开放。
整个流水线端到端都跑在 Hugging Face 上:
- 在 Jobs 上训练
- 强化学习环境和打分模型以 Spaces 形式部署
- 成对评审模型通过 Inference Providers 调用
- 所有产物都放在 Hub 上,汇集在一个合集里
两个 Space 跑起来之后,整套方案只需一条命令。复制环境和打分模型,为奖励配比设置两个环境变量,然后启动:
hf jobs uv run train/watercolour_grpo.py --flavor h200 --timeout 48h --secrets HF_TOKEN -- \
  --env-url https://<you>-watercolour-env.hf.space \
  --model Qwen/Qwen3.5-35B-A3B --lora --all-linear --bf16 --gradient-checkpointing \
  --subject 'a peach hibiscus' --references 4 \
  --top-p 0.95 --top-k 20 \
  --lr 5e-5 --lr-scheduler constant_with_warmup --warmup-steps 5 \
  --scale-rewards none \
  --steps 110 --n-episodes 240 --num-generations 8 \
  --per-device-batch-size 1 --gradient-accumulation-steps 8 \
  --max-completion-length 8192 \
  --run-tag my-run --out <you>/watercolour-grpo --push-to-hub
本文其余部分讲的是一路走到这里的经过,而且每个部件都在代码仓库里。
我一步步照着原博客做,只在绝对必要时才改动。我自己的每个想法都记在一份清单里,而不是塞进实验,这份清单最后成了结尾的“接下来我会尝试什么”,旁边是已发布产物的完整清单。如果你已经读过他的文章,其中的整体思路和奖励设计会很眼熟。新的内容是开放的实现、手工打分的图库,以及三种奖励配比的训练与对比,从你需要搭建的强化学习环境开始。
▶ Three runs evolving in parallel
三次训练,每种奖励配比一次,并行演化。每一帧显示某一步的中位数画作。现在先不必区分它们,文章会说明哪次训练是哪一个。
人们为什么喜欢它
这些画看起来松散、不完美、带着手工感,而此时的图像模型生成的都是完美(统计意义上平均)的图片。我的猜测是,这种反差是视频走红的重要原因。它让我想起生成式 AI 艺术的早期,那时的重点是探索这种媒介。DeepDream(2015)本是一个调试工具,被人们变成了艺术;Edmond de Belamy(2018)这样的作品出自艺术家对 GAN 能做什么的探索;而 Mario Klingemann 这样的艺术家则在那些年里用神经网络创作梦幻般的肖像。
这个项目感觉更接近那些早期岁月。在论文中,Surya 描述了通向这里的路径。他一开始是给文生图模型写提示词,而提示词是你唯一能拉动的杠杆,更多的细节只能在一定程度上换来更多的控制。训练模型本身则走得更远。这个想法的另一半是媒介。模型编写一段约 150 行的 JavaScript 程序来绘制图像。模型的输出是代码。你可以阅读、编辑并再次运行它,每一笔背后的决定都清晰可见。而风格来自一个限制:模型只被允许使用该库的十个方法。下文会详细说明。
同一时期,Anna Ridler 拍摄了数千朵郁金香,逐一手工标注,把数据集本身作为艺术作品展出,后来还在其上训练了一个模型。我是通过 AI 智能体在构建这个项目时带回来的参考资料找到她的作品的,我很喜欢,因为这个项目做的事情非常相似:手工挑选一组图像,然后针对它们进行训练。
对品味做强化学习
近来语言模型的强化学习工作大多使用可验证的奖励。比如有已知答案的数学题、能通过测试的代码,或者对错分明且运行成本低的评分器。这个项目更接近较早的那个例外,即 RLHF,模型从人类偏好中学习一个奖励模型。
这里的奖励是审美偏好。没有正确答案。这个项目真正的问题是:你能不能对品味做强化学习。
奖励的定义如其博客所述,也是我搭建的强化学习环境所实现的:
| 项 | 权重 | 衡量什么 |
|---|---|---|
gate |
0.05 | 草图能编译、画出了东西、没有作弊 |
length |
0.05 | 对更长代码片段的轻微倾向 |
| 成对评审 | 0.60 | 风格,与从图库中抽取的参考图对比 |
| HPSv3 | 0.30 | 渲染结果的审美偏好 |
HPSv3 是一个开放的 7B 偏好模型。给它一张图像和一段文字描述,它会返回一个分数,表示人们有多偏爱这张图。它是在大量人类对图像两两选择的数据上训练出来的,所以它的分数是许多人品味的平均。成对评审模型是 Qwen3-VL-30B-A3B-Instruct,一个通过 HF Inference Providers 调用的通用视觉模型。成对评审模型会把候选画作与从图库中随机选出的四张参考图并排查看,并按照一段书面说明来权衡(晕染、半透明的淡彩、柔和的边缘),每次比较都在两种呈现顺序下各做一遍,它的分数就是候选画作胜出的比较所占的比例。它唯一的标准就是图库,所以它的分数就是我的品味,也就是这些评分所编码的品味。
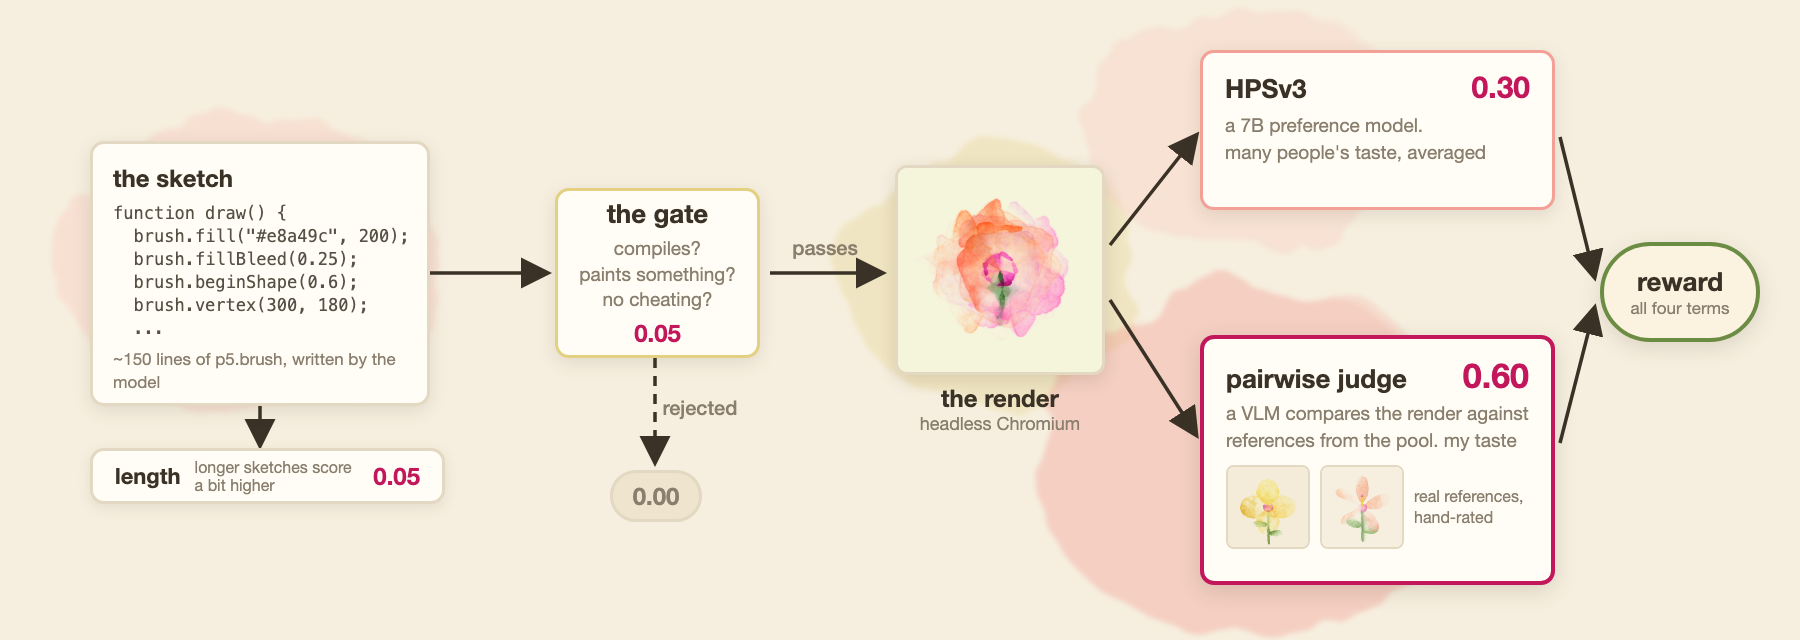
这些是 Narreddi 最终收敛到的权重。这里由图库定义品味。这就把工作从调超参数,转移到了构建一个决定什么是美的数据集。
我用这个奖励训练了三次。它们的区别仅在于权重如何在两个模型评审之间分配:
| 运行 | 成对评审 | HPSv3 | 角色 |
|---|---|---|---|
judge-led |
0.60 | 0.30 | 原始配比,在第 110 步停止 |
hps-led |
0.30 | 0.60 | 折中配比,在第 110 步停止 |
hps-only |
0.00 | 0.90 | 验证运行,在第 60 步停止 |
我先从 hps-only 开始,以验证流水线到底能不能学起来。一旦奖励在上升、各项指标健康,就没有理由继续跑下去,于是我启动了另外两次更长的运行。更长的运行要回答的问题是:你能把 HPSv3 的多少话语权交给成对评审?评审承担的权重越大,奖励就越多地代表我的品味而不是所有人的品味,爬升也应该越困难。顺带一提,如果推得足够远,或者你的风格离平均水平太远,模型可能会完全停止学习。
幸运的是,它没有停止,两次开启成对评审的运行也都学会了。手工打分的图库可以引导策略,至少从指标和最终画作来看是如此。数字见下文。
免责声明。如果使用前沿模型,它本来就能根据提示词生成画水彩的 JavaScript 代码。这是起点。这里的工作是教一个更小的模型做到这一点,并结合一个人自己的艺术偏好。
你需要搭建的强化学习环境
环境封装了模型与奖励之间的一切,包括模型用来作画的 JavaScript 库、限制它的系统提示词、渲染每份草图的无头 Chromium,以及拒绝作弊的关卡。
这个库做的工作比看上去更多。@acamposuribe 开发的 p5.brush 模拟的是一种媒介,而不是绘制形状:颜料会晕染到填充区域的边缘之外,纸张有纹理,笔触有分量,流场会牵引着笔法走动。当模型调用 brush.fillBleed(0.25) 时,它就是在决定墨迹扩散多远。
注。p5.brush 的作者在这一切之前,早就在尝试教机器作画了。2022 年他创作了一个生成艺术系列,里面藏着一篇日记,讲的是教 p5.js 像孩子一样画画:“它几乎不会用蜡笔 [...] 它听不懂简单的指令。今天就到这里,太让人抓狂了。”这个系列原本打算有三件作品,他做了两件。Surya 的视频走红时,他引用了这段话,分享了那篇日记,并说这件作品是第三件自己找上门来了。
p5.brush 提供 47 个方法。提示词只允许其中 10 个:scaleBrushes、noStroke、fill、noFill、fillBleed、fillTexture、beginShape、vertex、endShape 和 circle。其余三十七个方法所增加的东西,如线条、排线、自定义笔刷,会破坏水彩的质感。有了这十个方法,模型只能画填充形状,而库会给每一个形状都加上晕染。
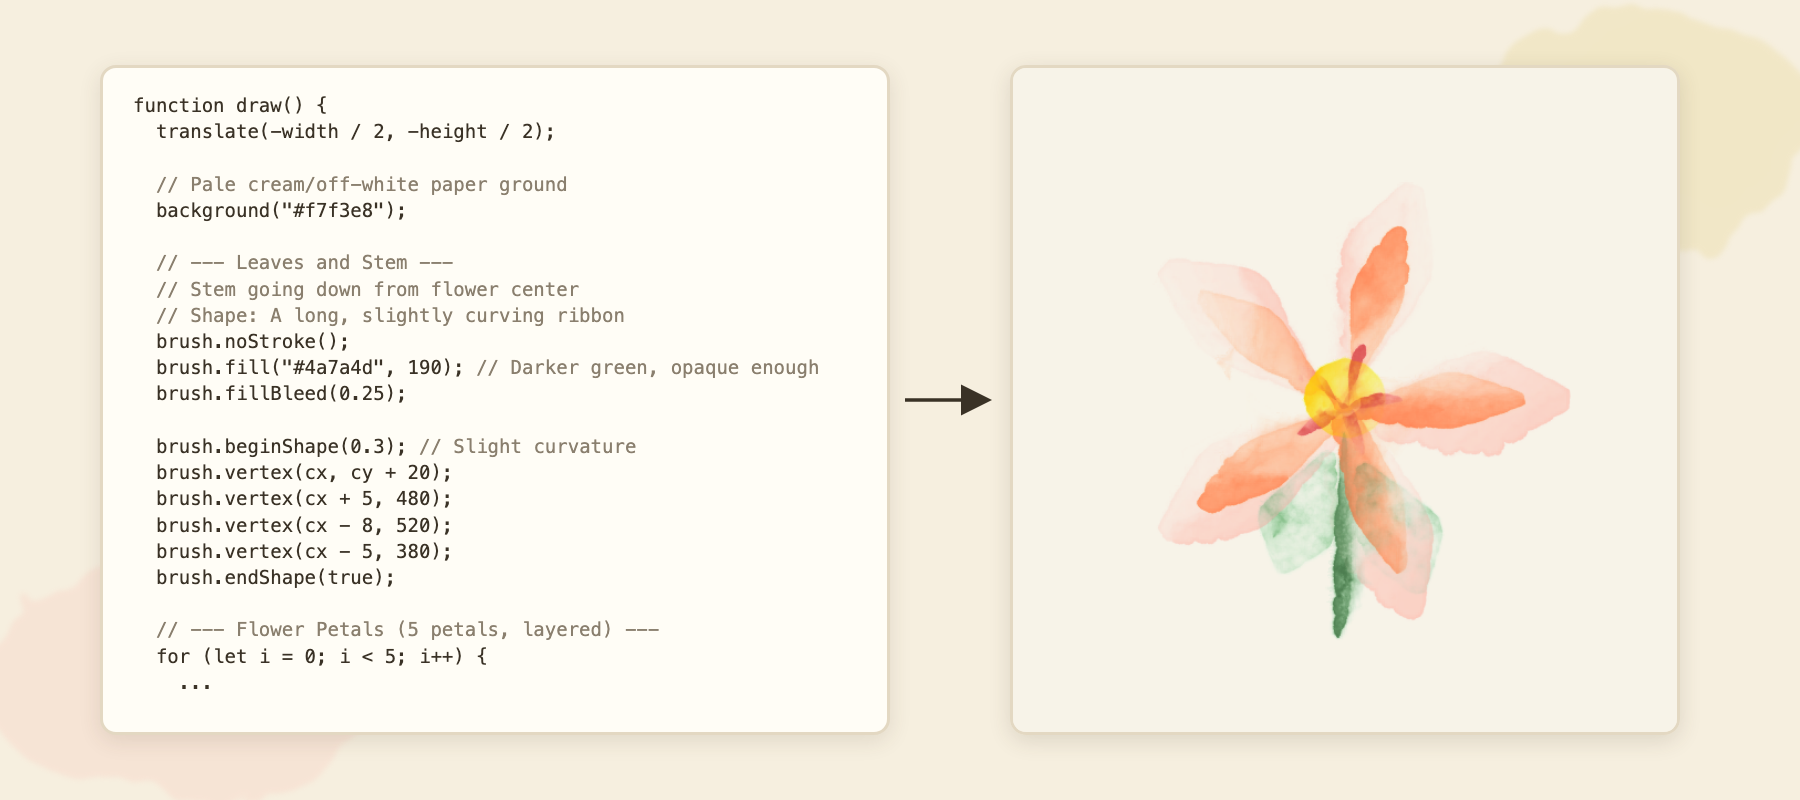
draw() 的一部分及其渲染结果。注释是模型自己写的。奖励 0.864,129 行,第 22 步。每幅画作的完整源码都在 rollout 数据集中。他的博客文章为我省下了大量本可能浪费在反复调整提示词上的时间。冗长的 API 参考文档会让模型凭空捏造不存在的方法,而他的 200 次 GEPA 迭代最终收敛到了一份严格的允许清单,没有任何文档。我也遇到了同样的失败,于是手写了这份允许清单。我对这套方案唯一的补充是一句话:每片花瓣画两到三遍,先大笔画一遍,再在里面画一遍更小、更不透明的。这个小改动让我的输出色彩丰富了许多。
注。如果你是第一次听说 GEPA,它是一个自动提示词优化器。由语言模型用平实的语言反思当前提示词在哪里失败,并提出更好的版本,然后循环往复。
关卡是最后一个部件。草图必须能编译,必须使用该库而不是直接调用 p5,必须在画布上留下真正的颜料,并且不能试图欺骗打分器,例如在画布上写文字。
图库就是奖励函数
图库由 178 幅画作组成,按我个人的偏好分为两档,love 和 okay。它们其实全部由模型生成。四个开放权重模型通过 Inference Providers 调用,各自编写 p5.brush 草图,每个都以一张来自 iNaturalist 的、开放授权的真实木槿花照片为依据。一个视觉模型对每份草图给出书面反馈,共经过三轮改进迭代。随后每张最终渲染图都由我逐一打分,最终有 178 幅入选。
| 生成模型 | 画作数量 |
|---|---|
| GLM-5.2 | 64 |
| Kimi-K3 | 57 |
| Qwen3-Coder-Next | 35 |
| Qwen3.5-122B-A10B | 22 |
这里我选了四个不同家族的模型,以测试它们各异的风格。这四个是在一次快速可靠性检查中每次都能产出有效草图的开放模型,另外两个候选因未通过检查而被淘汰。如果你想制作自己的图库,可以选择别的模型。
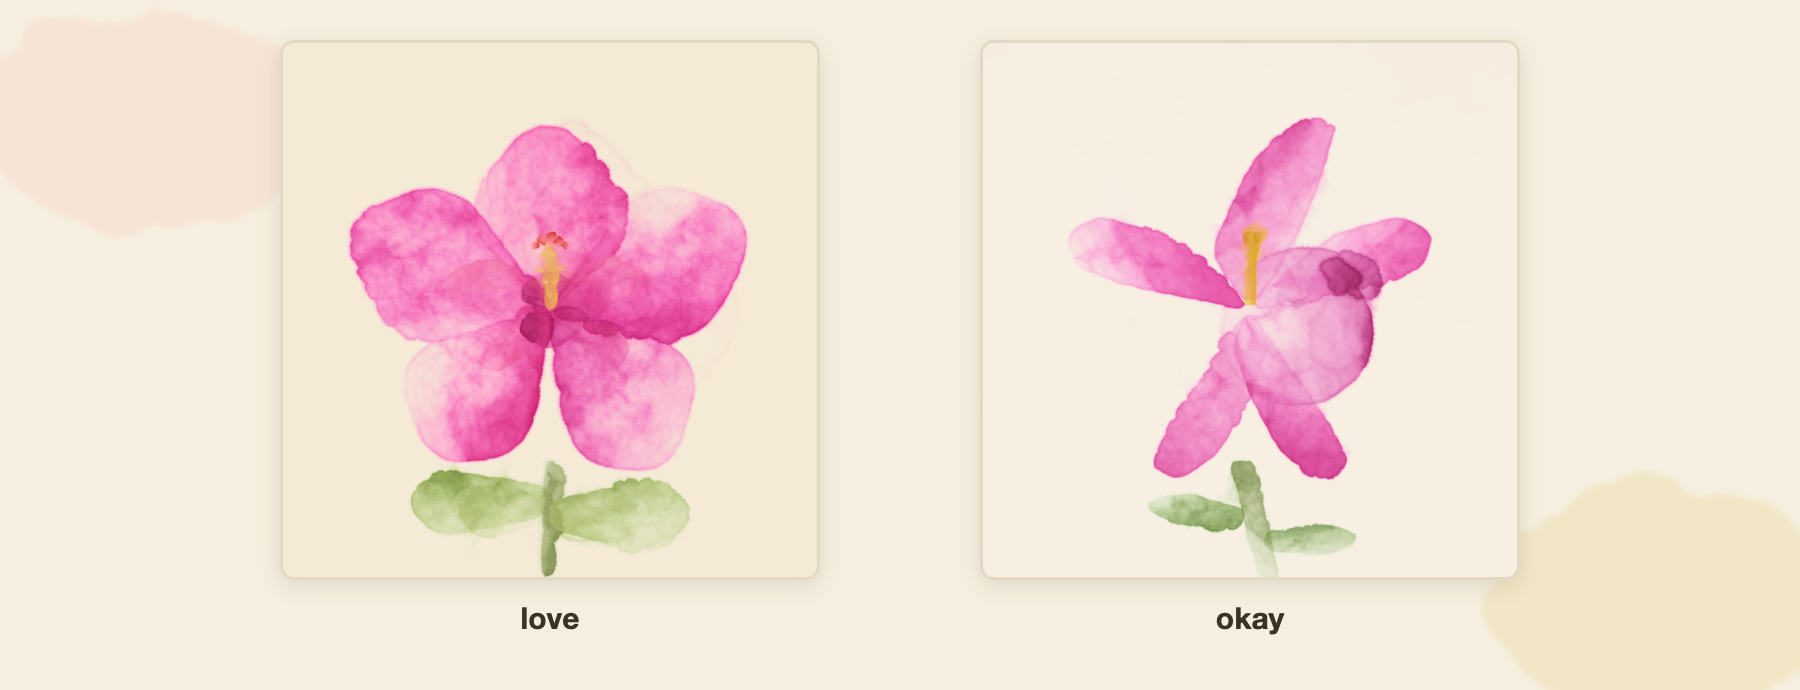
这两个档位在奖励中确实发挥作用。当成对评审抽取四张参考图时,一半来自 love,一半来自 okay,所以策略面对的对手里总有一些它有时能打赢的,而且无论对阵哪一档,获胜得到的奖励都一样。这是我为数不多的刻意改动之一:原版只与最高档对比,而我把较容易的一档也留在抽取范围内,让早期较弱的策略依然能得到信号。
里面没有任何人类创作的画作,这是一个真实的局限。p5.brush 是个小众库,用它创作且代码可获取的人类作品只有寥寥几件,远远达不到训练语料所需的量,他的博客也指出了这一点。
这里有趣的想法,正如我之前已经讨论过的,是模型会学着模仿图库里有的东西。如果我们把环境指向另一个数据集,奖励就会自动改变,而无需改动任何一行代码。对于我生成并公开分享的数据集,我还附上了对应的源草图。
仔细看这两个评审,它们回答的是不同的问题。HPSv3 判断它是不是一朵花,而成对评审判断它是否按我选定的风格画得好。
再来最后一次豪赌式的运行
在任何东西奏效之前,有很长一段时间奖励曲线都是平的。如果你尝试过复现一篇没有公开产物的论文或博客,大概会有同感。每次运行都在检验我认为合理的关于问题出在哪的某个理论。一次运行要花很长时间,所以我在还在分析上一次结果的同时就把下一次排上了队。一如既往,答案是先从更简单且能跑通的东西入手,再在其上构建。一个没有浏览器、没有评审的简单控制任务,是第一次真正学起来的尝试,而原因只是我的学习率太低了。
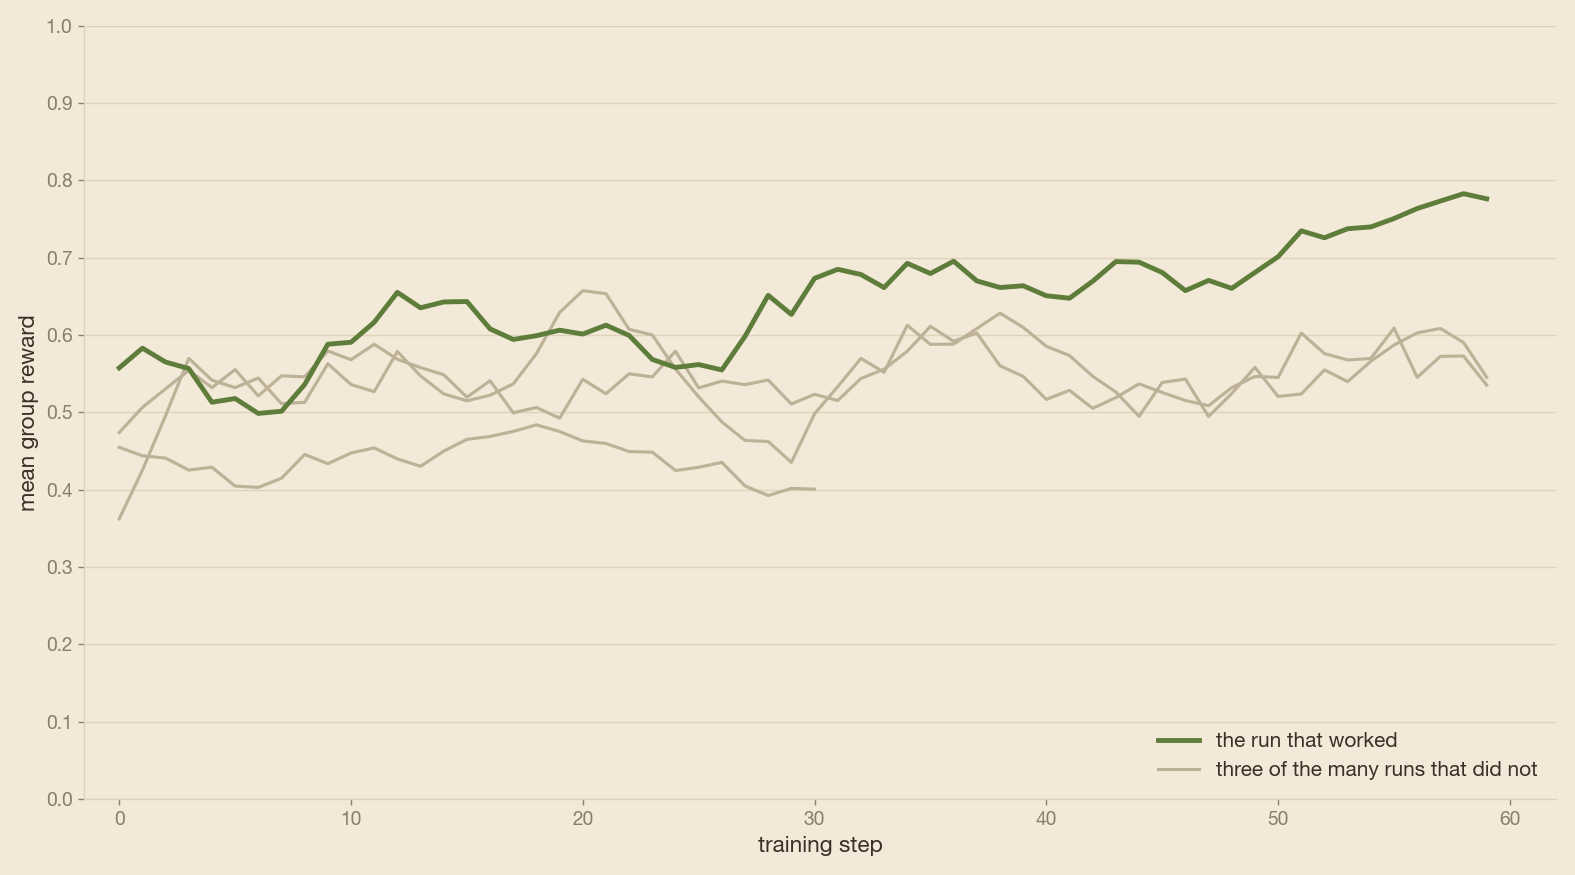
另一个花了我不少时间才找到的改动,是正确调整 LoRA 参数。通常的 target_modules 列表假定的是稠密模型,而 Qwen/Qwen3.5-35B-A3B 是混合专家模型,其大部分投影层的命名不同,所以适配器在四十层里只训练了十层。我把它改成 all-linear 解决了这个问题,它会覆盖每一个线性层。这个架构里的路由专家是融合张量,即使 all-linear 也会让它们保持冻结,但其余部分都有了适配器,这就足以学起来了。
修复方案是对 TRL 的 GRPOTrainer 做了四处改动:
| 设置 | 原值 | 改为 | 原因 |
|---|---|---|---|
| 学习率 | 2e-5 | 5e-5 | LoRA Without Regret 对 GRPO 使用的上限 |
| 调度器 | linear |
constant_with_warmup |
线性衰减在运行中途就把大部分学习率用掉了,所以奖励始终没有起飞 |
scale_rewards |
group |
none |
一次关卡拒绝正在压缩组内所有其他优势值 |
target_modules |
手写列表 | all-linear |
覆盖每一个线性层 |
这四项改动让第一次成功的运行(hps-only)成为可能,奖励明显在提升。
有了这套配置,三次运行全都学起来了。两次评审运行都计划跑 200 步,并在第 110 步停止,此时奖励仍在缓慢上升。一步需要十五到十八分钟,而各配比之间的对比已经稳定,所以我把两次都停掉以节省算力。每次运行前三分之一和后三分之一的组平均奖励:
| 运行 | 步数 | 前三分之一 | 后三分之一 | Δ |
|---|---|---|---|---|
hps-only |
60 | 0.58 | 0.71 | +0.13 |
judge-led |
110 | 0.45 | 0.72 | +0.27 |
hps-led |
110 | 0.57 | 0.82 | +0.24 |
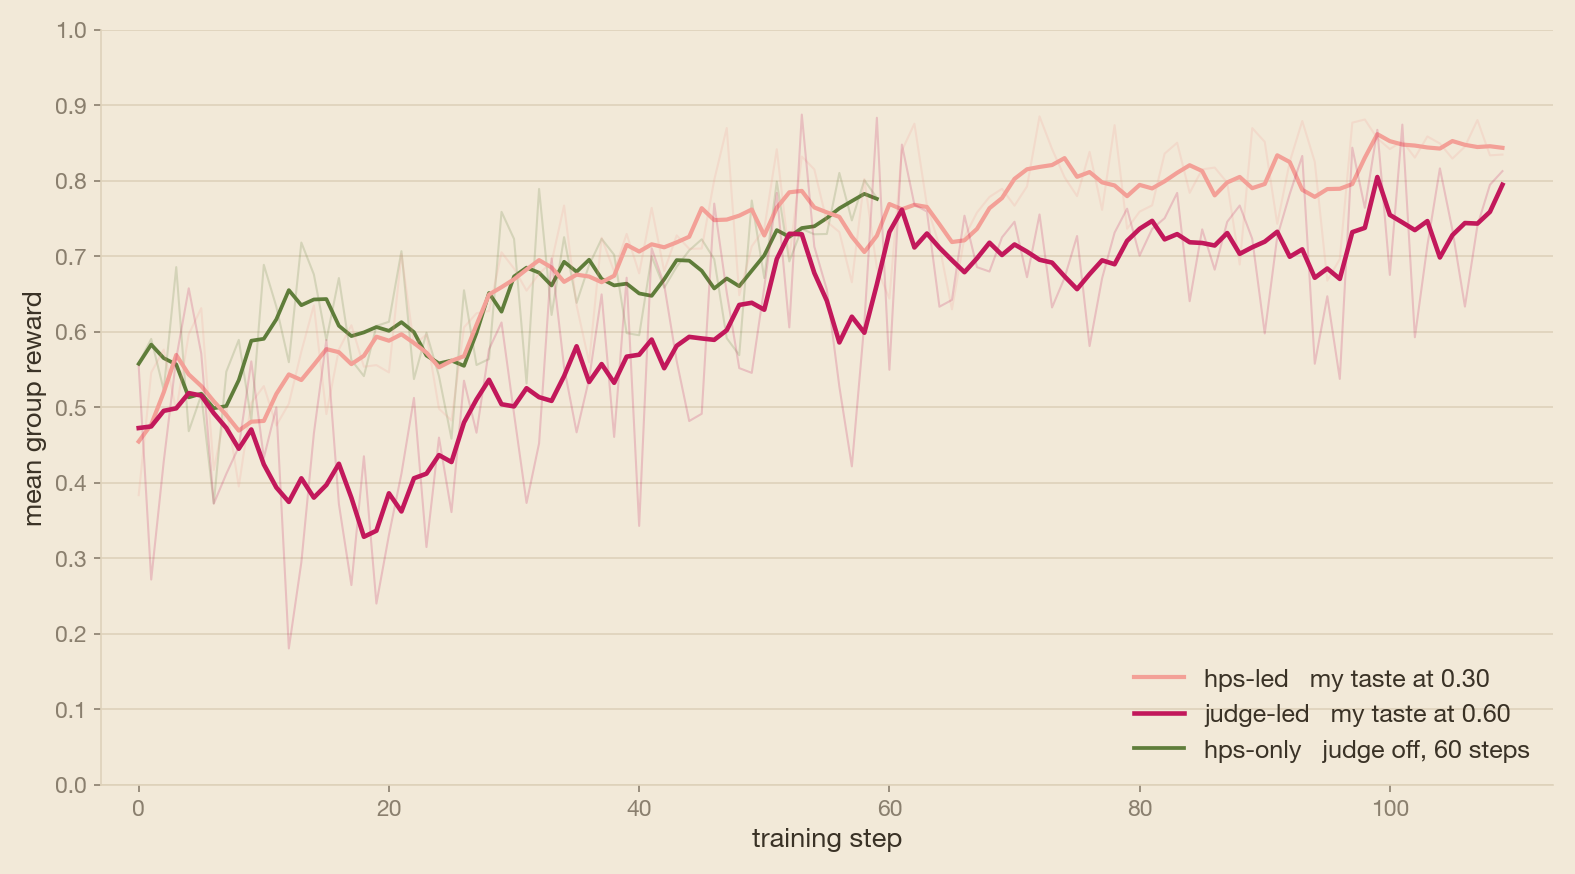
三条曲线与我的品味所占的权重吻合。评审的权重越大,起点越低,爬升也越嘈杂。judge-led 在前三十步几乎持平,之后才动起来。这和解决调试问题时用的是同一招:把问题缩小到有东西能学起来为止,再把困难的部分一次一个加回来。
在使用成对评审的两次运行中,成对评审这一项本身也在攀升。随着训练推进,模型在与图库的比较中赢得更多,而这是 hps-only 无法做出的论断。所有运行中都没有哪个组塌缩为相同的奖励,这是会让梯度消失的 GRPO 失效模式。感兴趣的话,各项指标曲线(HPSv3、颜料覆盖率、熵)以 CSV 形式放在仓库里。
完整的启动命令、硬件,以及能把它变成另外两次运行的两个环境变量,都在方案中。
它实际学到了什么
在每次运行中,模型学到的第一件事都是不再产出糟糕的画作,也就是总奖励低于 0.3 的近乎空白的画布和不成形的淡彩。在 hps-only 中,组平均值上升的四分之三来自糟糕画作变得罕见。在评审运行中,这种塌缩更为陡峭:在 judge-led 的前后三分之一之间,奖励低于 0.3 的 rollout 从 99 个降到 16 个,在 hps-led 中则从 37 个降到 4 个。
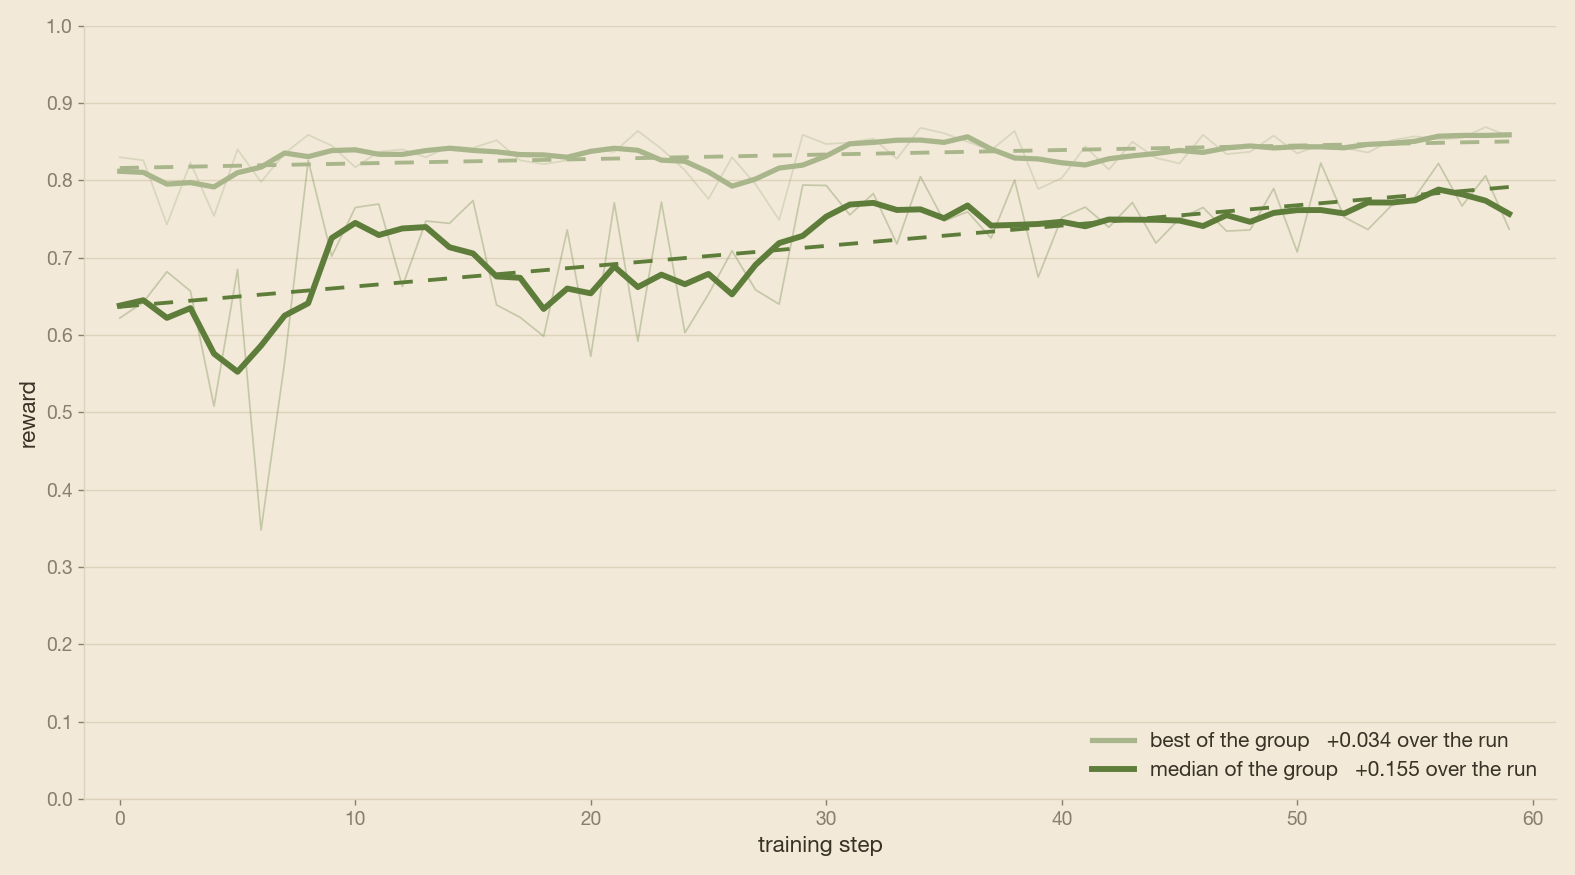
这就是为什么最直观的那种可视化,即每一步的最佳画作,在 hps-only 中几乎看不出差别。整个运行中它只变化了 +0.034,而中位数变化了 +0.155。学习体现在分布的中间部分。
成对评审改变的是头部。在 hps-only 中,画作变得更可靠,但没有变得更好。优质画作的质量只给组平均值增加了 +0.03,而且一旦 HPSv3 看到了围绕中心的花瓣和一根茎,它就不再要求更多颜料。开启评审后,故事的另一半浮现出来。这里的更好意味着更接近图库,也就是更接近我评为“好”或者更喜欢的东西。这在 judge-led 中增加了 +0.12,在 hps-led 中增加了 +0.16,每一步的最佳画作也有所上升,两次运行中的颜料覆盖率都翻了一番(0.11 到 0.23,以及 0.13 到 0.30),而 hps-only 几乎没怎么改变它。面前还有参考图可以超越时,好画作仍然可以变得更好,模型也开始因为使用更多颜料而得到奖励。
还有一个发现。模型无视了一条明确的指令,而且它这么做是对的。系统提示词要求画十五到三十个填充形状。实际的平均值在 7 到 9 之间,而且在所有运行中,n_shapes 与奖励几乎不相关(+0.000、−0.14、+0.07)。策略不会因为遵守那句话而得到奖励,所以它就不遵守。
hps-only 这条路线也存在天花板。如果每个 rollout 都能达到它好的那些的水平,那次运行的平均值将停在 0.771。更多的步数能否突破这个上限,还是个悬而未决的问题。
这些画作还展现了表格所遗漏的东西。在每次运行内部,它们看起来都很相似。随着训练推进,每个组内的奖励彼此越来越接近,开场视频里的中位数画作看起来就像同一朵花的不同镜头。这正是 GRPO 在以单一主题构建的图库上按设计所做的事。图库决定什么算多样性,就像它决定什么算质量一样。如果奖励只为匹配某一朵花而付费,模型就会学着画那一朵花。要得到更多样的输出,就需要更多样的图库,而构建这样的图库意味着更多的整理工作。Surya 较新的构图作品就是一个例子。Alex Yango 的动物画用的是同一套方案,只是图库里的选择不同。这是审美奖励与数学评分器之间最大的区别。数字背后有一项非常人性化的工作:决定什么属于奖励集。Jason Liu 谈品味的文章用一句话说出了其通用版本:AI 把瓶颈从创作转移到了鉴别。
Surya 在博客结尾放了一些他最喜欢的作品。我不挑自己的,而是在下面放了一面墙,墙上是两次评审运行中奖励打分最高的 178 幅画作,与参考图库的数量相同,顺序不分先后。打开它,挑出你自己的。

为了挑选,你看了很多幅,留下了几幅,而这恰恰就是构建这个项目奖励的那项工作。每次运行的每一幅画作,连同它的草图和奖励,都在 rollout 数据集中,并可在这个画廊里浏览。
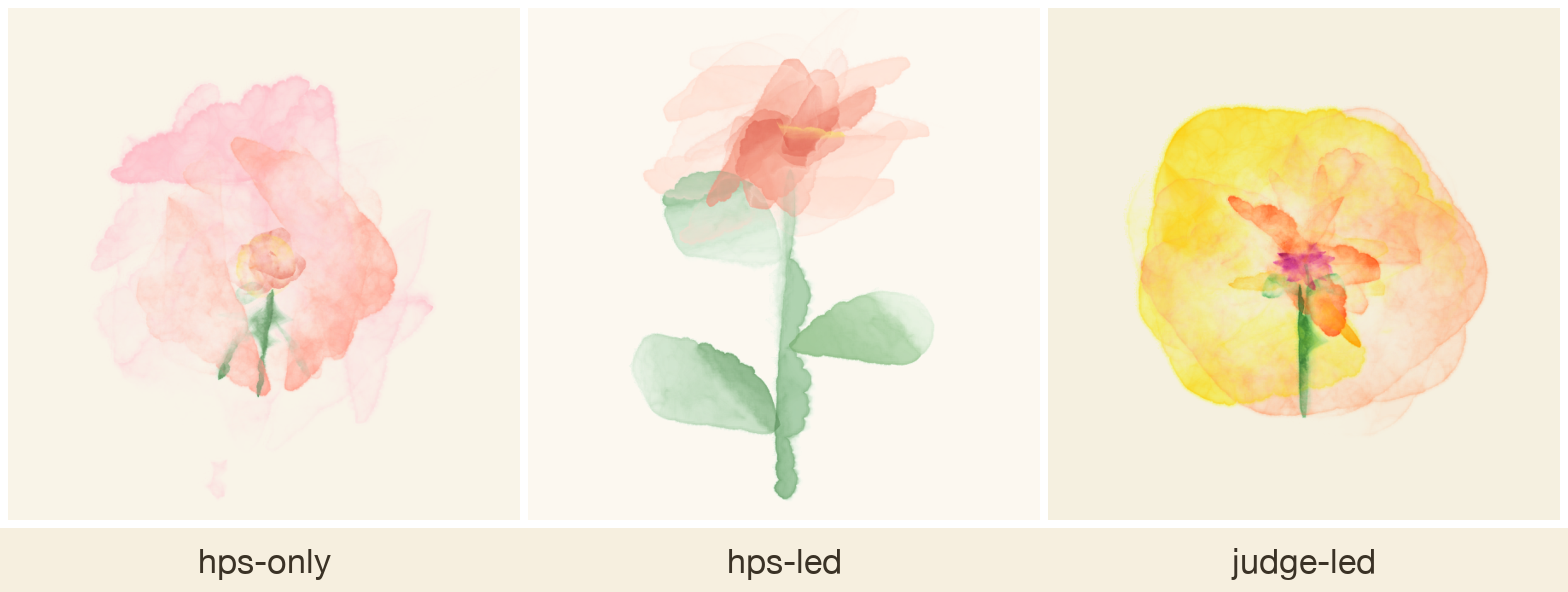
既然奖励部分基于我的品味,那么以观众的身份给出我的结论也算合理。在我看来,judge-led 是最终最多样、也最有艺术趣味的一次运行。hps-led 画出了令人信服的水彩,但它最好的几幅都带有一种柔和的湿画法质感,几乎自成一种风格。hps-only 收敛得最厉害,大部分画作都落在相同的色彩上。你可以在画廊里自己判断,那里有每次运行的每一幅画作,可按步数和奖励排序。
基础设施很难
这个项目主要是基础设施。一次运行需要训练器、两个 Space、一个推理路由器和一个 websocket 连续数小时保持健康,而任何悄悄失败的部件,都会在别处变成一个错误的数字。一半的工作是核实你读到的数字与实际发生的事情是否一致。
基础设施的故障正以零分的形式进入奖励。渲染超时或打分器没有响应,得到的分数与糟糕的画作相同,即组内的 0.0。在我所有的运行中,这类 rollout 约占 1.5%,最严重的一次达到 5.2%。这会让模型在噪声上训练,所以现在这些路径会返回 None,并把该 rollout 排除在组之外。
我还在 OpenEnv 中发现了一个 bug,并把修复提交到了上游。客户端保持一个持久的 websocket,而被对端关闭的套接字仍留在缓存里,所以之后的每次调用都会失败,即使环境本身是健康的。为了找到它,我白白搭上了两次没跑完的运行。修复已提交到上游,带着它启动的运行此后一直运行正常。
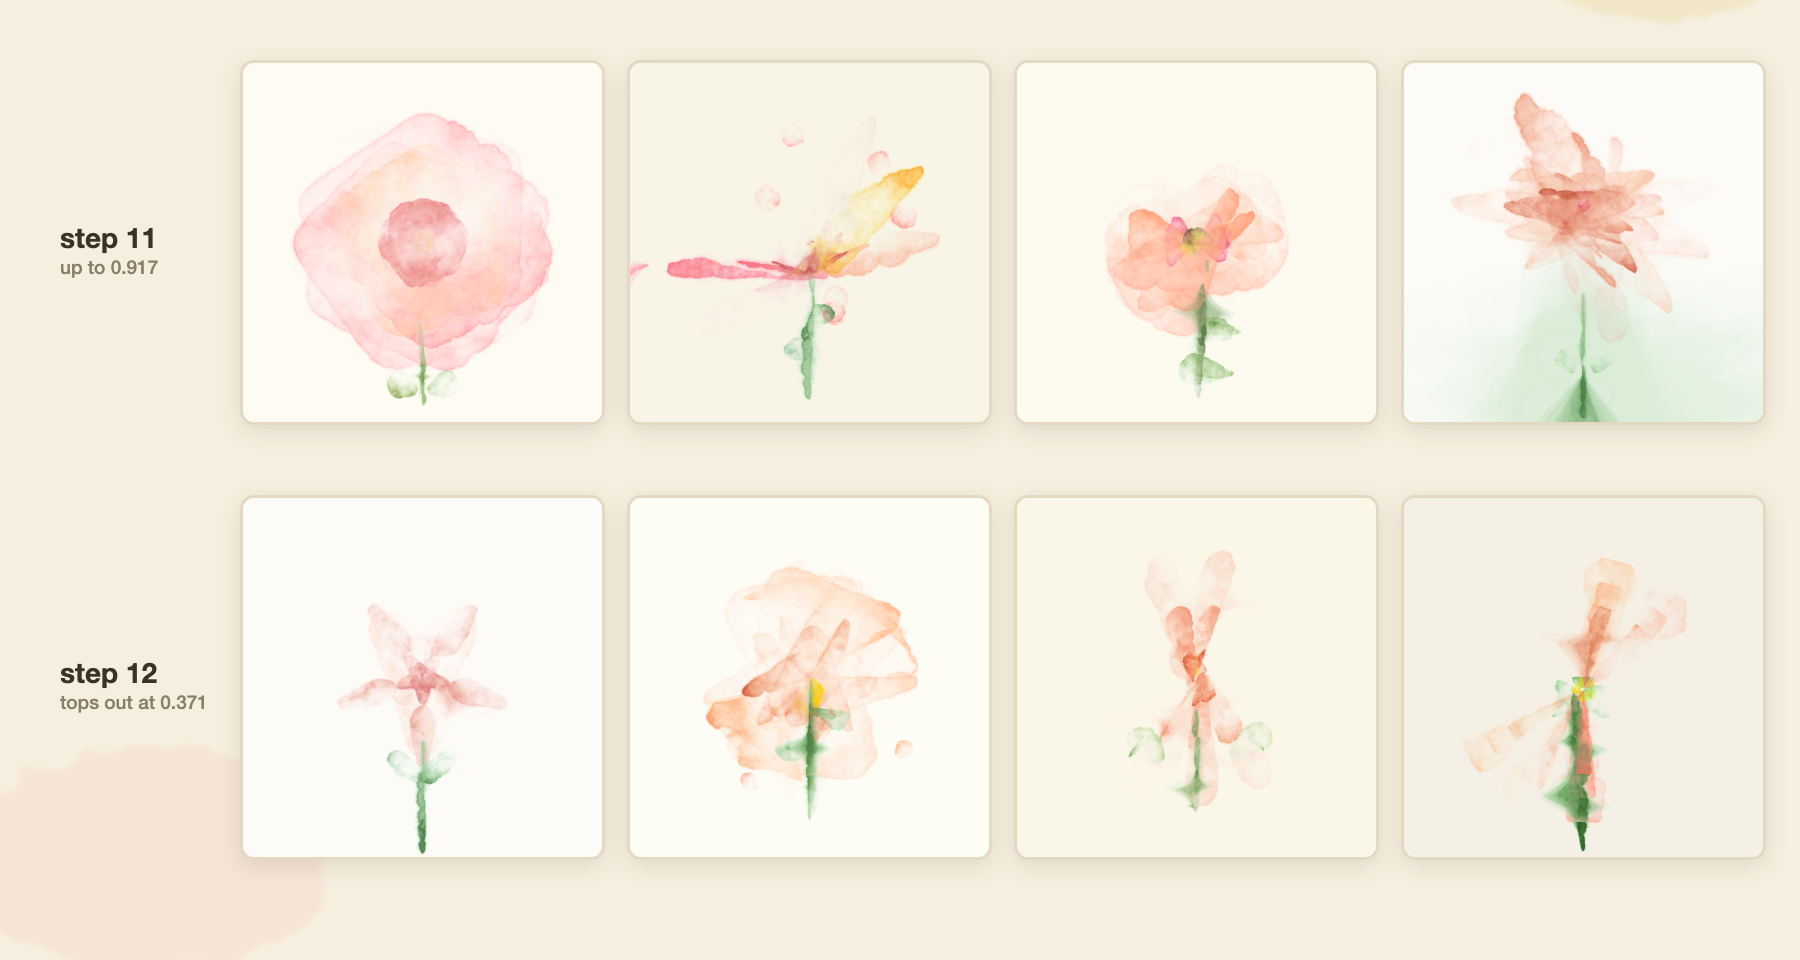
judge-led 运行中连续的两步,各取最好的四幅。第 12 步的画作是否看起来差了半分,由你来判断。一步的奖励取决于它抽到了哪些参考图。成对评审每一步抽取四张参考图,所以每一步面对的对手都不同,有些抽签就是更难。GRPO 本身基本是安全的,因为优势值是在组内计算的,一次抽到难的参考图会让整个组一起移动。但我当时在读的那条曲线就不安全了,看起来像糟糕的一步,有些其实只是抽到了难的参考图。上面的图就是一个例子。第 12 步的得分比第 11 步低了半分,主要是因为它抽到了整个运行中最难的参考图,而画作本身看起来很接近。
成本是多少
数字均为取整值,且只针对完成的运行。
| 部件 | 所需资源 |
|---|---|
| 训练器 | 1 块 H200。60 步需要 18 小时,110 步约需 34 小时 |
| HPSv3 | 一个 a100-large Space,整个运行期间都要保持在线 |
| 环境 | 一个 cpu-upgrade Space,渲染可以从容地按时完成 |
| 成对评审 | Qwen/Qwen3-VL-30B-A3B-Instruct 的 Inference Providers 配额 |
| 图库,一次性 | 来自 iNaturalist 的开放授权照片、四个生成模型的 Inference Providers 配额,而打分则要花你自己的时间 |
一步是八个 rollout,耗时十五到十八分钟,其中70% 到 80% 是渲染。单次渲染需要 69 到 96 秒,而截止时间是 90 秒。部分原因在意料之中:这个 Space 没有 GPU,所以 Chromium 用软件渲染 WEBGL 画布,而 p5.brush 的晕染和纹理是繁重的像素运算。即便如此,我原本预期会更快,但我还没有找到完整的原因。
打分器的成本可能比使用它的训练还高:HPSv3 必须在整个运行期间保持在线,所以运行结束时要暂停这个 Space,或设置它的休眠计时器。
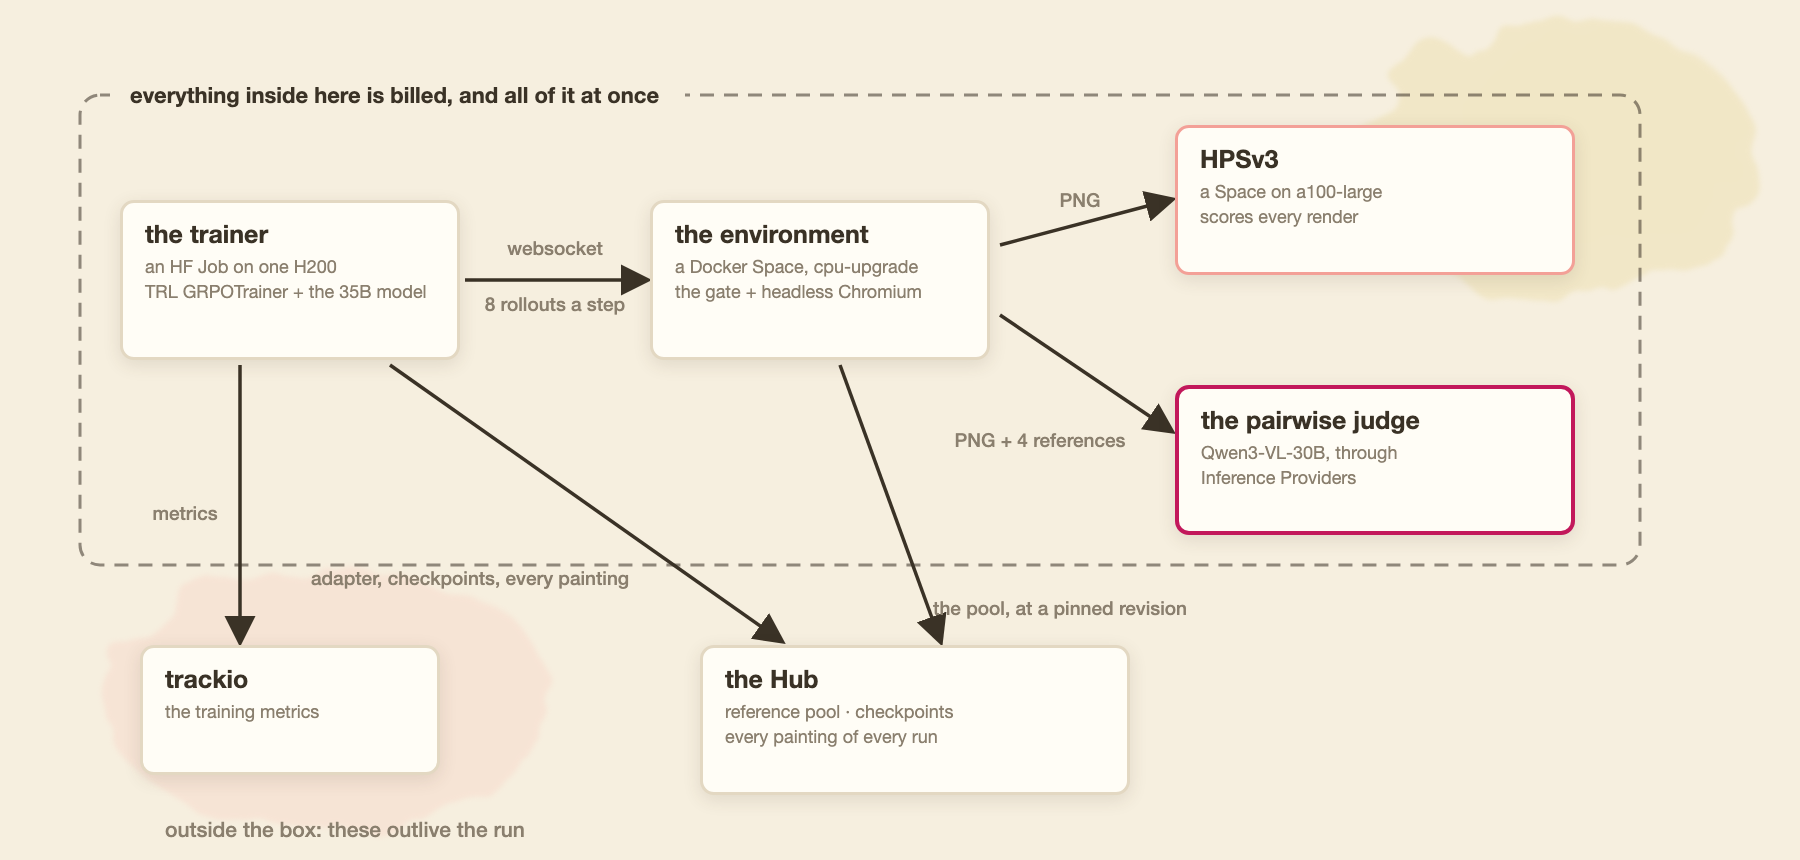
一切都运行在 HF Jobs 上,环境是一个 Docker Space,指标记录在 trackio 中。
接下来我会尝试什么
这个项目的规则是在所有资源都开放的前提下复现这套方案,而不是改进它,所以一路上积累了一份尚未尝试的想法清单。以下是我真正会去尝试的几项,按证据多少排序。
多步交互,并让模型看到自己画了什么。这是我首先会尝试的。原博客训练的是单轮,所以我训练的也是单轮,而在这个设置里,模型是闭着眼睛画的。没有任何图像输入,它得到的唯一反馈是一个数字。反馈循环行得通的证据就是图库本身。参考画作来自模型在视觉评论者的指导下迭代三轮的结果,而后几轮更好。定义奖励的素材是用一个循环做出来的,而策略却从未获得这个循环。
更小的模型。有证据表明 35B 超出了所需。在我的旁支实验中,一个 4B 模型已经能写出通过关卡的有效草图。如果 4B 能学会这件事,实验成本就能降低一个数量级。
清单上的其他想法包括:在开始强化学习之前先在图库的来源数据上做 SFT、显式奖励颜料、随着运行推进把评审的参考图配比从易到难调整,直到只剩 love、放宽十个方法的允许清单以获得更大的视觉范围(我在这方面的尝试让更多草图崩溃,也破坏了水彩质感),以及通过给同一张图打两次分,检查成对评审究竟有多一致。
而且这个方法并不局限于花朵。Alex Yango 用同样的机制画了动物,Brendan Hogan 则针对一个手工打分的片段图库训练了画布动画。我之前也用 Simon Willison 的鹈鹕基准测试玩过类似的东西,那里同样是把代码渲染成图像再打分。
在这一切之下,还有一个这个项目无法解决的问题。由模型生成的 178 幅画作,定义了这个训练出来的模型认为什么是美的。图库是瓶颈,也是整条流水线中没有原则性答案的部分。
我与原版有哪些不同
对于想要复现的人,我与 Narreddi 的方案有两处刻意的偏离,文中前面都已论证过:
- 成对评审抽取参考图时,一半来自
love,一半来自okay,而不是只与最高档对比,这样早期较弱的策略仍然能得到信号。 - 提示词中增加了一句关于技法的小话:每片花瓣画两到三遍,先大笔画一遍,再在里面画一遍更小、更不透明的。
其余部分,即 LoRA 的 all-linear、基础设施故障返回 None 而不是 0.0、在第 110 步停止评审运行,都是我在过程中不得不做的决定,因为他的博客没有说明这些。他的实现没有公开,所以我无法判断它们是与他的选择一致,还是有所偏离。
一切均已公开
| 产物 | 位置 |
|---|---|
| 方案,以及如何复现 | 02-watercolour/ |
| 参考图库,附带每份源草图 | watercolour-reference-pool |
| 环境,可直接复制使用 | watercolour-env |
| HPSv3 打分器,可直接复制使用 | watercolour-hpsv3 |
| 仅 hps 的适配器和 rollout | watercolour-grpo-hps-only · watercolour-rollouts-hps-only |
| 评审主导的适配器和 rollout | watercolour-grpo-judge-led · watercolour-rollouts-judge-led |
| hps 主导的适配器和 rollout | watercolour-grpo-hps-led · watercolour-rollouts-hps-led |
| 画廊,每幅画作都可浏览 | watercolour-gallery |
| 训练曲线 | 在线:judge-led · hps-led · hps-only,以及 results/ 中的 CSV 文件 |
| 全部内容 | Paint with Code |
本文中逐个 rollout 的数字都可以根据已发布的数据集重新计算。这里的一切都不依赖于任何 Space 保持开启。
方法和最初的想法属于 Surya Narreddi。这个库属于 Alejandro Campos Uribe。