AI 改变了各类组织的运作方式,带来了前所未有的生产力和创新水平。然而,围绕数据隐私、主权以及如何在数据使用期间(即推理以及与 AI 模型交互期间)保护数据的担忧,可能会阻碍 AI 的采用。NVIDIA 机密计算(Confidential Computing,CC)正是为智能体 AI 时代而设计的安全且高性能的方案,可让任何模型安全地扩展。
CC 能够在主动推理期间保护企业数据、专有模型权重以及模型本身。在本文中,我们将概述 CC,并通过基准测试表明,其推理性能与未启用 CC 安全功能的方案几乎相同(最高可达 98%)。
数据、代码和模型的完整性
CC 提供了一个横跨芯片、互连和系统软件的安全层。其工作原理如下:

硬件信任根
NVIDIA Blackwell GPU(包括 NVIDIA RTX PRO 6000、HGX B200 和 HGX B300)在硬件中内置了 CC。HGX B200 和 HGX B300 GPU 借助 NVIDIA NVLink 加密,支持跨多块 GPU(最多 8 块)的机密计算。在芯片层面,GPU 持有一把私有签名密钥,该密钥在制造时熔断写入,永远不会暴露给软件、固件或主机系统。这把密钥是整个证明链的基础。
证明:先验证,再执行
机密工作负载在获得任何机密信息之前,都要先经过远程证明。NVIDIA 远程证明服务(NVIDIA Remote Attestation Service,NRAS)会对照已知良好的参考完整性清单(reference integrity manifest,RIM),验证一个签名的证据包,其中包含 GPU 的硬件报告以及 CPU TEE 度量值(AMD SEV-SNP 或 Intel TDX)。
一旦机密虚拟机(Confidential VM,CVM)处于经过验证、未被修改的状态,模型解密密钥等机密信息就可以部署到 CVM 中。证明握手通常只是一次性的启动事件。工作负载运行起来之后,证明不会给单个推理请求增加延迟。
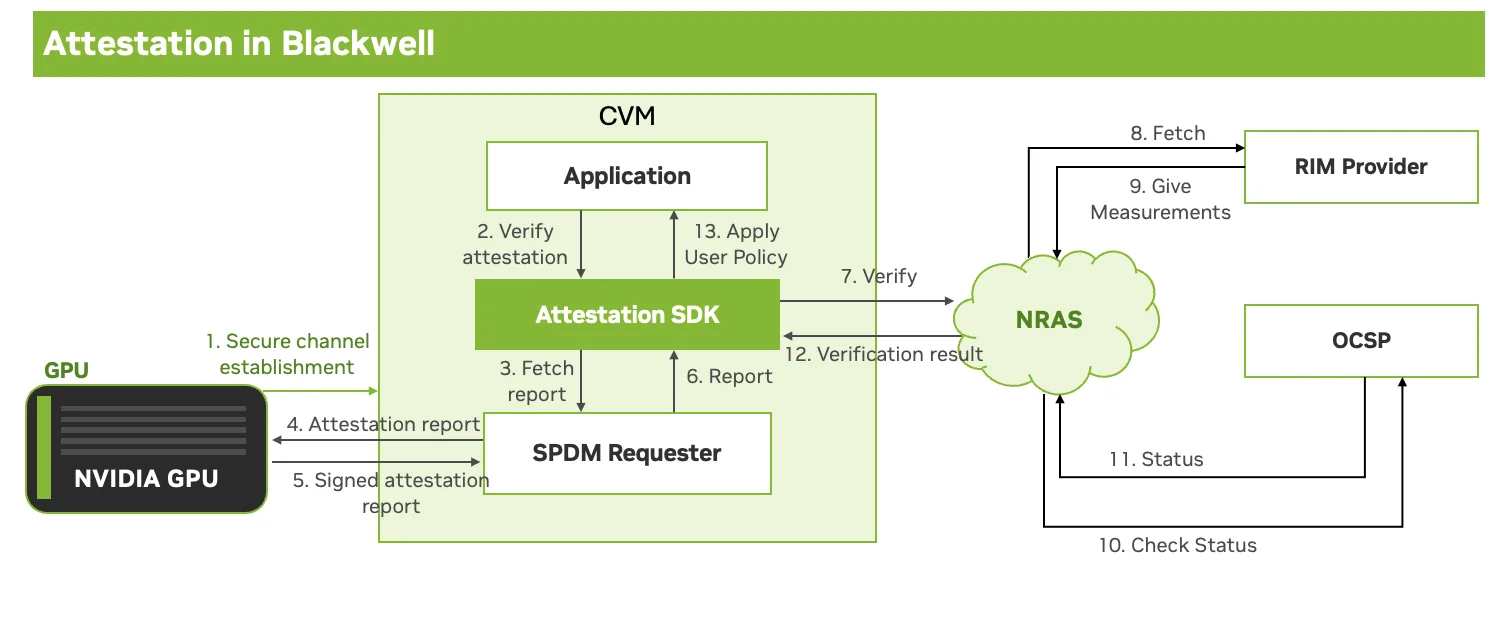
图 2. 证明服务远程验证可信执行环境的身份、配置和完整性,并签发密码学证明
在机密计算中优化 AI 推理性能
在 Blackwell GPU 上,CC 对 AI 推理性能的影响可能来自两个方面:
- 安全工作提交延迟:对推理而言,安全工作提交延迟往往是更大的因素。由于加密和内核启动带来的额外开销,较小的工作单元受影响更大。增加每次 GPU 工作启动所执行的工作量,可以降低安全启动开销的影响。
- 主机到设备(CPU 到 GPU)带宽下降:如果工作负载严重依赖向 GPU 传输输入,性能将取决于让 GPU 充分利用所需的带宽,是否超过 CC 模式下可用的加密传输带宽。
有多项创新可优化 CC 下的推理性能,包括:
- CC 安全的自动调优器计时:FlashInfer 在 CC 模式下用 GPU 全局计时器寄存器取代事件计时器,使自动调优器能够准确比较候选内核,并为每种形状选出最快的实现。
- 异步 D2H 拷贝工作线程:SGLang 将每一步的 token 回读移出调度器的关键路径。这有助于恢复计算与拷贝的重叠,因为 CC 否则会使 cudaMemcpyAsync 期间的许多主机到设备、设备到主机拷贝实际上变成同步操作。
- 分段 CUDA graph 支持:SGLang 为预填充和混合批次增加了 CUDA graph 重放,降低了在 CC 模式下被放大的内核启动开销。
NVIDIA 将继续与推理框架的上游社区合作,确保这些框架的性能得到优化。
我们在多个关键指标上测量了 CC 的推理性能。以下是测试设置和测量结果的详细信息。
基准测试结果
在测试的所有工作负载配置中,启用 CC 模式在稳态推理期间产生的吞吐量和每输出 token 时间开销都很小。
下表汇总了 Blackwell Ultra(HGX B300)上运行 Qwen/Qwen3.5-397B-A17B-FP8 模型时,CC 在吞吐量、TTFT 和 TPOT 方面的开销
机密计算的相对性能
| 并发数 | ISL/OSL = 1024 / 1024 | ISL/OSL = 8192 / 1024 | ||
|---|---|---|---|---|
| 每 GPU 吞吐量(tok/s) | TPOT 中位数(ms) | 每 GPU 吞吐量(tok/s) | TPOT 中位数(ms) | |
| 相对关闭状态的 Δ% | 相对关闭状态的 Δ% | 相对关闭状态的 Δ% | 相对关闭状态的 Δ% | |
| 4 | -2.0% | -1.6% | -3.5% | -3.6% |
| 8 | -2.6% | -2.4% | -2.8% | -2.9% |
| 16 | -5.3% | -4.9% | -2.8% | -3.0% |
| 32 | -6.3% | -7.8% | -1.0% | -0.9% |
| 64 | -6.2% | -6.8% | -2.3% | -2.4% |
| 128 | -7.5% | -8.1% | -3.5% | -3.5% |
| 256 | -4.6% | -4.1% | -3.6% | -3.7% |
测试设置
基准测试:FP8 精度的 Qwen 3.5 397B-A17B 模型
环境:带 GPU 直通的虚拟机
基线:关闭机密计算
实验组:开启机密计算
所有其他变量保持不变。
硬件配置
搭载 Blackwell Ultra 的 HGX B300。
软件栈
表 2. 测试设置的软件配置
| 组件 | 版本 / 详情 |
|---|---|
| 平台 | Intel TDX |
| 主机操作系统 | Ubuntu 25.10 |
| 主机内核 | 6.17.0-20-generic |
| 客户机操作系统 | Ubuntu 24.04.4 LTS |
| 客户机内核 | 6.8.0-124-generic |
| 客户机 vCPU | 256 |
| 客户机 NUMA | 2 个节点 |
| NVIDIA 驱动 | 595.71.05 |
| VBIOS | FW 1.4.x [97.10.64.00.0C] |
| GPU 功耗上限 | 1100.00 |
| CUDA | 13.2 |
| SGlang | docker.io/lmsysorg/sglang:v0.5.12-cu130PR:28251(SGLang)和 3638(FlashInfer) |
| NCCL | v2.28.9-1 |
| OpenSSL | 3.6.0 |
| 编排 | Docker 容器 + NVIDIA Container Toolkit |
注意:请按照这份文档中描述的 CPU 功耗和 vCPU 绑定配置操作。
工作负载参数
每种配置都在一系列条件下进行了测试,这些条件代表真实的企业推理工作负载:
输入/输出 token 长度:8192/1024、1024/1024
批大小:4、8、16、32、64、128 和 256 个并发请求。
推理框架(模式):SGLang(Server)
基线:不带 –enable-symm-mem
采集的指标
每 GPU 输出吞吐量(tokens/sec/gpu)
首个 token 时间(TTFT)中位数——从请求提交到生成第一个 token 的延迟,单位 ms
每输出 token 时间(TPOT)中位数——稳态流式输出中每个 token 的生成延迟,单位 ms
未来方向
借助 CC 实现的硬件级安全,在保护敏感 AI 工作负载的同时,保留了生产级 AI 工作负载所需的性能。
CC 以极小的性能开销,为生产推理工作负载提供了更强的安全基础。在我们基于 SGLang 上 Qwen 3.5 的评估中,我们在一系列并发级别、输入序列长度和输出序列长度上都观察到了这一点,证明企业可以在不牺牲性能的前提下,保护其 AI 工作负载和数据,并满足合规要求。
通过访问下方资源,与 NVIDIA 及我们的合作伙伴一起,在 Blackwell 上用 CC 保护你的 AI 工作负载。
资源
NVIDIA 机密计算文档
NVIDIA Blackwell 架构白皮书
NVIDIA GPU Operator 和 Container Toolkit
NVIDIA 远程证明服务(NRAS)
NIST SP 800-207 零信任架构
HIPAA 安全规则(HHS)
GDPR 第 32 条——处理的安全性