今天,我们很高兴宣布 Cloudflare AI Search 的几项开发者体验改进,让搜索方案开箱即用、易于管理。以前,你需要把 Cloudflare 的各个基础组件(Workers AI、AI Gateway、Vectorize、R2、Browser Run)拼接起来,现在 AI Search 可以自动完成这些工作,而且做得更好。我们的目标是给你的智能体配上它们自己的搜索引擎,让它们能轻松找到数据,从而为自己和它们服务的人提供更好的答案。
我们还为 AI Search 的客户提前预览了定价,方便你了解它如何随规模扩展。我们设计的定价模型可预测、可扩展:使用默认模型时,嵌入(embedding)和重排序(reranking)都是免费的,因此无需操心预估 token 数量。
现在,在 AI Search 中,用户可以:
- 为你的智能体索引一组数据:让结构化和非结构化数据都能方便地供智能体使用,范围从单个文件到你拥有的网站。(目前它必须是你 Cloudflare 账户下的一个 zone,不过更多的所有权验证方式即将推出。)
- 网站无需再提供 sitemap:以前,AI Search 要求网站必须有 sitemap 才能使用网站集成。现在你可以选择“Discover”解析选项,把没有 sitemap 的网站添加为数据源。
- 获得一个可跨命名空间搜索的统一公开端点:在命名空间上启用公开 URL 后,你会得到
/search和/mcp端点,可以无需认证地同时搜索多个实例或网站,方便你轻松分享给客户。 - 在公开端点上使用你自己的自定义域名:你现在可以在公开 URL 之上添加自己的域名,从而为你的
/search和/mcp端点打上自己的品牌(例如search.example.com/mcp)。你也可以加上 Cloudflare Access,创建私有的搜索实例。 - 通过 AI Search 插件,为基于 EmDash 构建的站点添加语义搜索:如果你的站点运行在我们的开源 CMS EmDash 上,AI Search 插件可以为你的内容增加语义搜索。
- 预览 AI Search 的新定价模型:我们希望定价可预测并能随你一同扩展,因此把嵌入和重排序的成本包含在内:使用 Workers AI 目录中的特定模型时,它们是免费的。
最后,我们还会分享 AI Search 在我们自家平台上的使用示例,包括 Cloudflare.com、我们的开发者文档、EmDash、Cloudflare Dev Stack MCP,甚至你正在阅读的这篇博客文章(试试 cmd+K)。
AI Search 实战:驱动全新的 Cloudflare Dev Stack MCP
我们使用 AI Search 的方式之一,是在全新的 Cloudflare Dev Stack MCP 中,你现在就可以在我们的 AI Playground 里试用。它为编码智能体提供来自整个 Cloudflare 开发者生态系统的最新、带引用的文档,让它们基于最新的功能和修复来构建,而不是依赖过时的训练数据。
下面是我们用 AI Search 现有功能构建它的过程:
1. 为每个来源建立索引
我们为每个 Cloudflare 自有的来源各创建了一个 AI Search 实例:Docs、Blog、API Docs、Community、Astro、Vite、Vitest、Hono、Replicate、OpenNext。(它们都归 Cloudflare 所有。)
它们涵盖不同的领域,但由于网站数据归 Cloudflare 所有,AI Search 可以把它们视为同一组数据,并以相同的方式全部摄取。只要把 AI Search 指向一个或一组站点,它就会处理爬取、摄取、嵌入和检索。创建实例只需一条命令;对于没有 sitemap 的站点,加上 --parse-type discover,就能通过跟踪链接来发现页面(由 Browser Run 的 /crawl 提供支持):
npx wrangler ai-search create cloudflare-community \
  --namespace dev-stack \
  --source https://community.cloudflare.com \
  --type web-crawler \
  --parse-type discover
2. 把多个实例合并成一个搜索
接下来是有趣的部分:用一次查询在全部 10 个实例中得出答案。有两种方式。
方案 A:在 Worker 中实现(我们为 Cloudflare Stack MCP 采用的做法)
我们把命名空间绑定到一个 Worker 上,创建了一个远程 MCP 服务器,并对全部 10 个实例发起一次多实例调用。我们选择这条路径,是因为我们正在把技术栈搜索加入 Cloudflare 的 MCP 服务器,使其作为一个工具,与智能体已经连接的 Cloudflare 工具一起提供。
绑定配置,位于 wrangler.jsonc:
{
  "ai_search_namespaces": [
    { "binding": "AI_SEARCH", "namespace": "cloudflare-stack" }
  ]
}
然后,一个工具只需一次调用,就会分发到你指定的各个实例:
// One tool, one call that searches every surface in the namespace at once.
context.registerTool(
  'search_dev_stack',
  {
    description: 'Search current docs across the Cloudflare stack.',
    inputSchema: z.object({ query: z.string() }),
  },
  async ({ query }) => {
    const res = await context.env.AI_SEARCH.search({
      query,
      ai_search_options: {
        instance_ids: ['developers-cloudflare-com', 'astro', /* ...every surface */],
        retrieval: { max_num_results: 10 },
        reranking: { enabled: true },
      },
    })
    // res.chunks come back cited and tagged with the instance they came from.
    return { content: [{ type: 'text', text: format(res.chunks) }] }
  }
)
方案 B:开启公开端点(无需代码)
如果你根本不想写 Worker,就在命名空间上启用公开 URL。你会立刻得到 /search 和 /mcp 端点,可以查询每一个实例,无需认证,也无需部署任何东西。
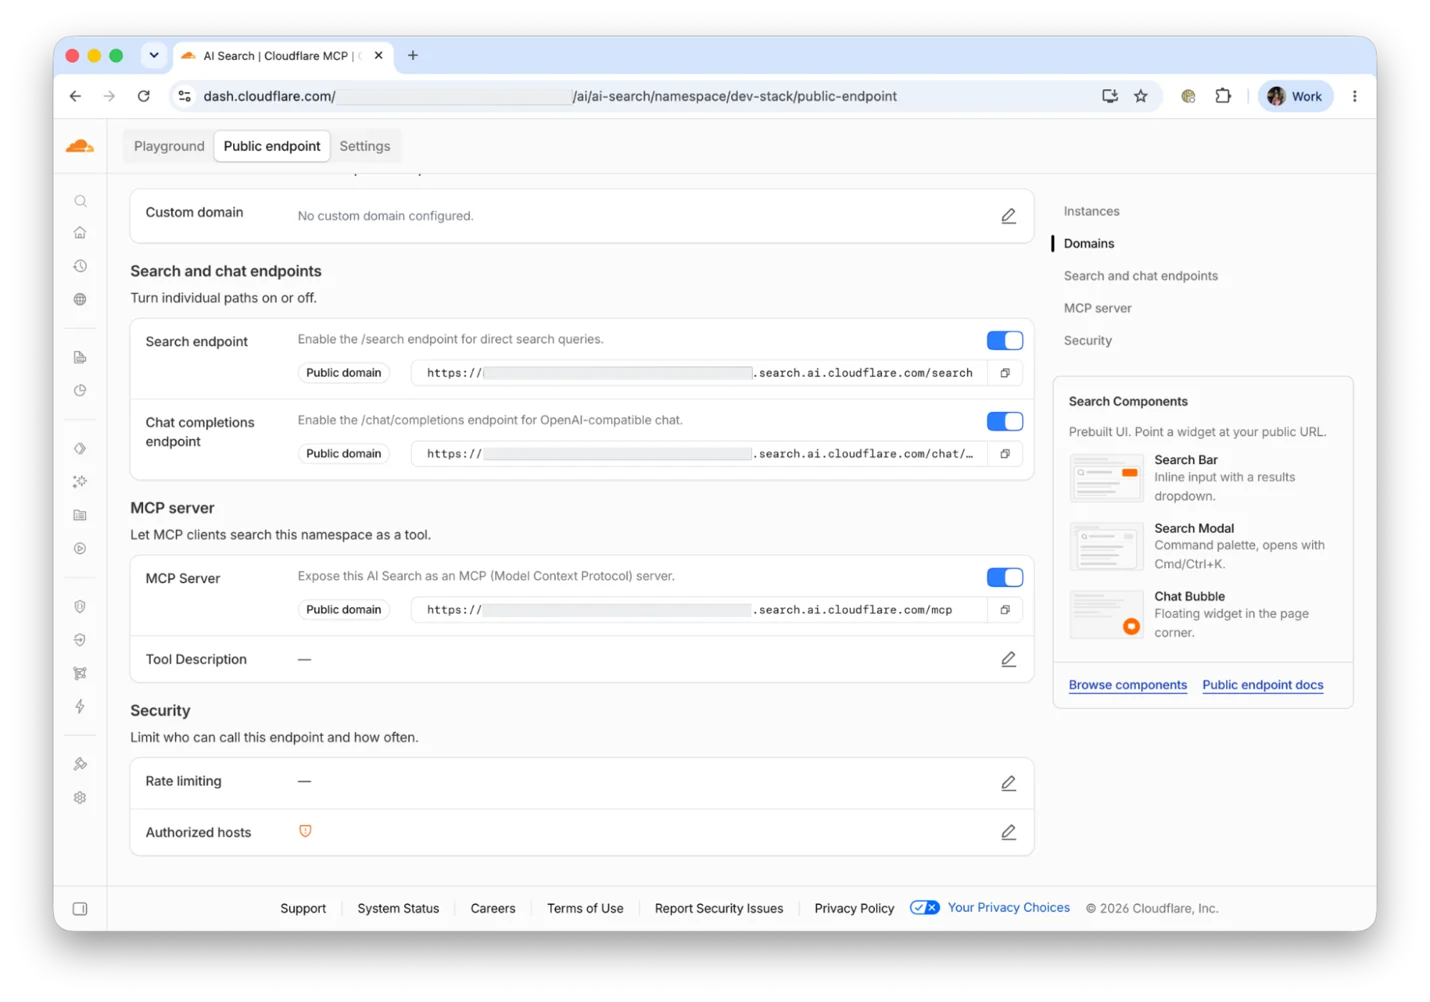
如果你像我们一样,要把搜索集成进已有的应用或 MCP 服务器,就选 Worker。如果只想一键获得一个可分享的搜索端点,就选公开端点。
3. 加上品牌并锁定访问
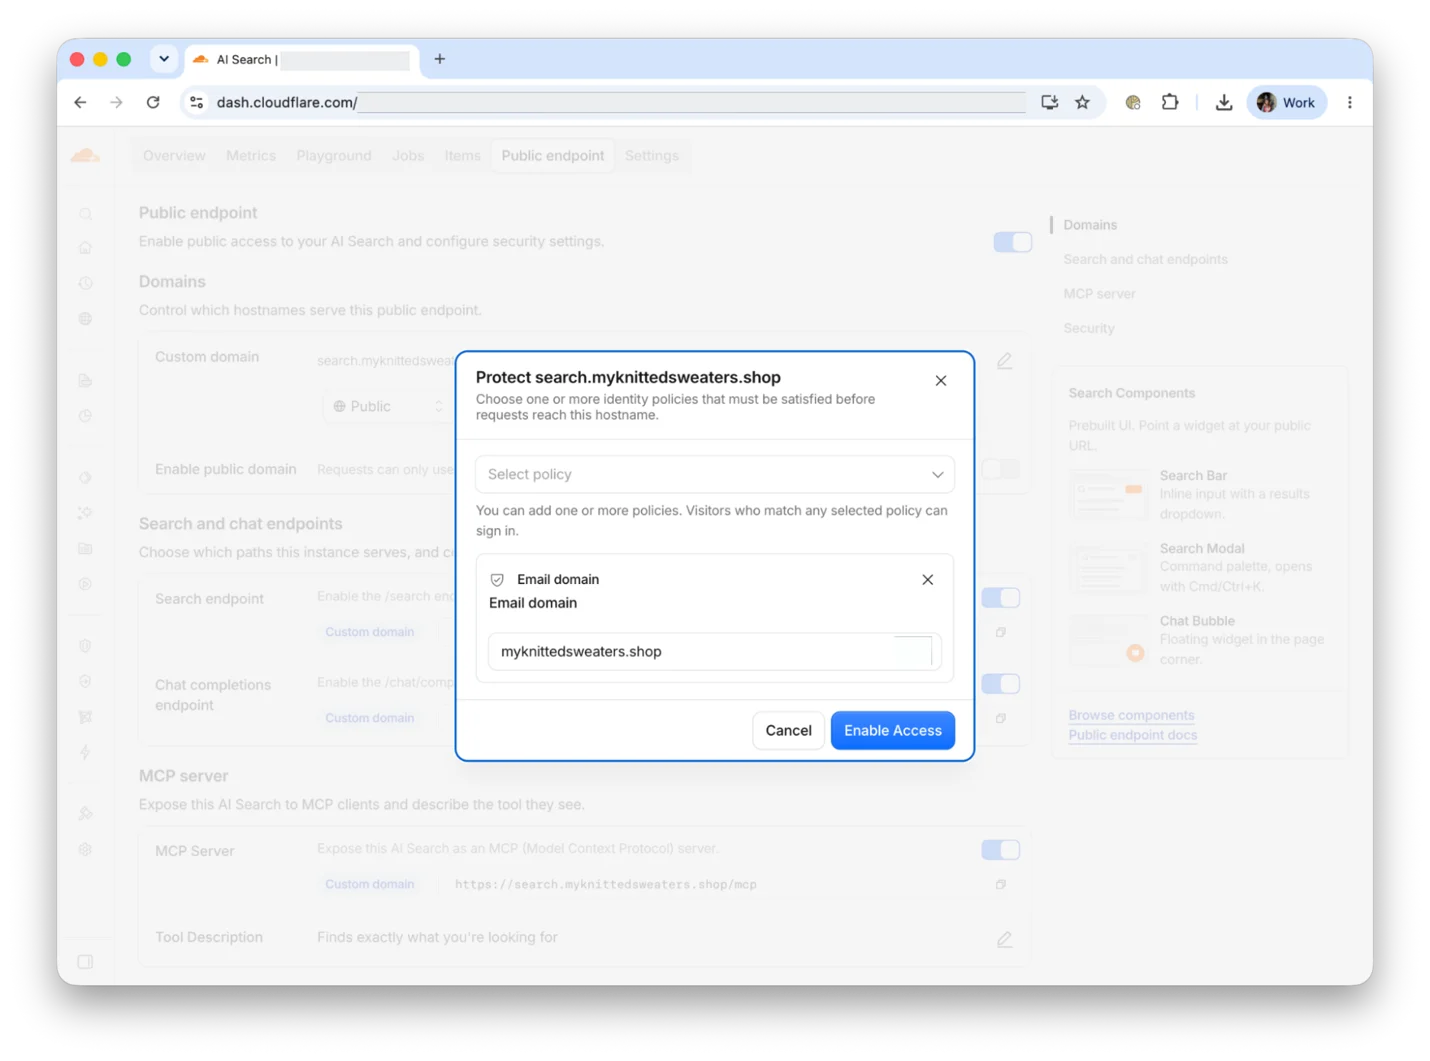
公开端点自带一个默认的公开 URL,但你可以在其上使用自己的自定义域名,为端点打上品牌(例如 search.example.com/mcp)。
如果搜索应当是私有的,就在该域名前加上 Cloudflare Access。这样端点就需要登录,只有获得授权的人(或智能体)才能查询。
亲自试试:使用 Dev Stack MCP
借助 Cloudflare Dev Stack MCP 服务器,你可以询问任何工具,或描述你想构建的应用,然后得到关于如何在 Cloudflare 技术栈上以最佳方式构建它的最新、带引用的回答。
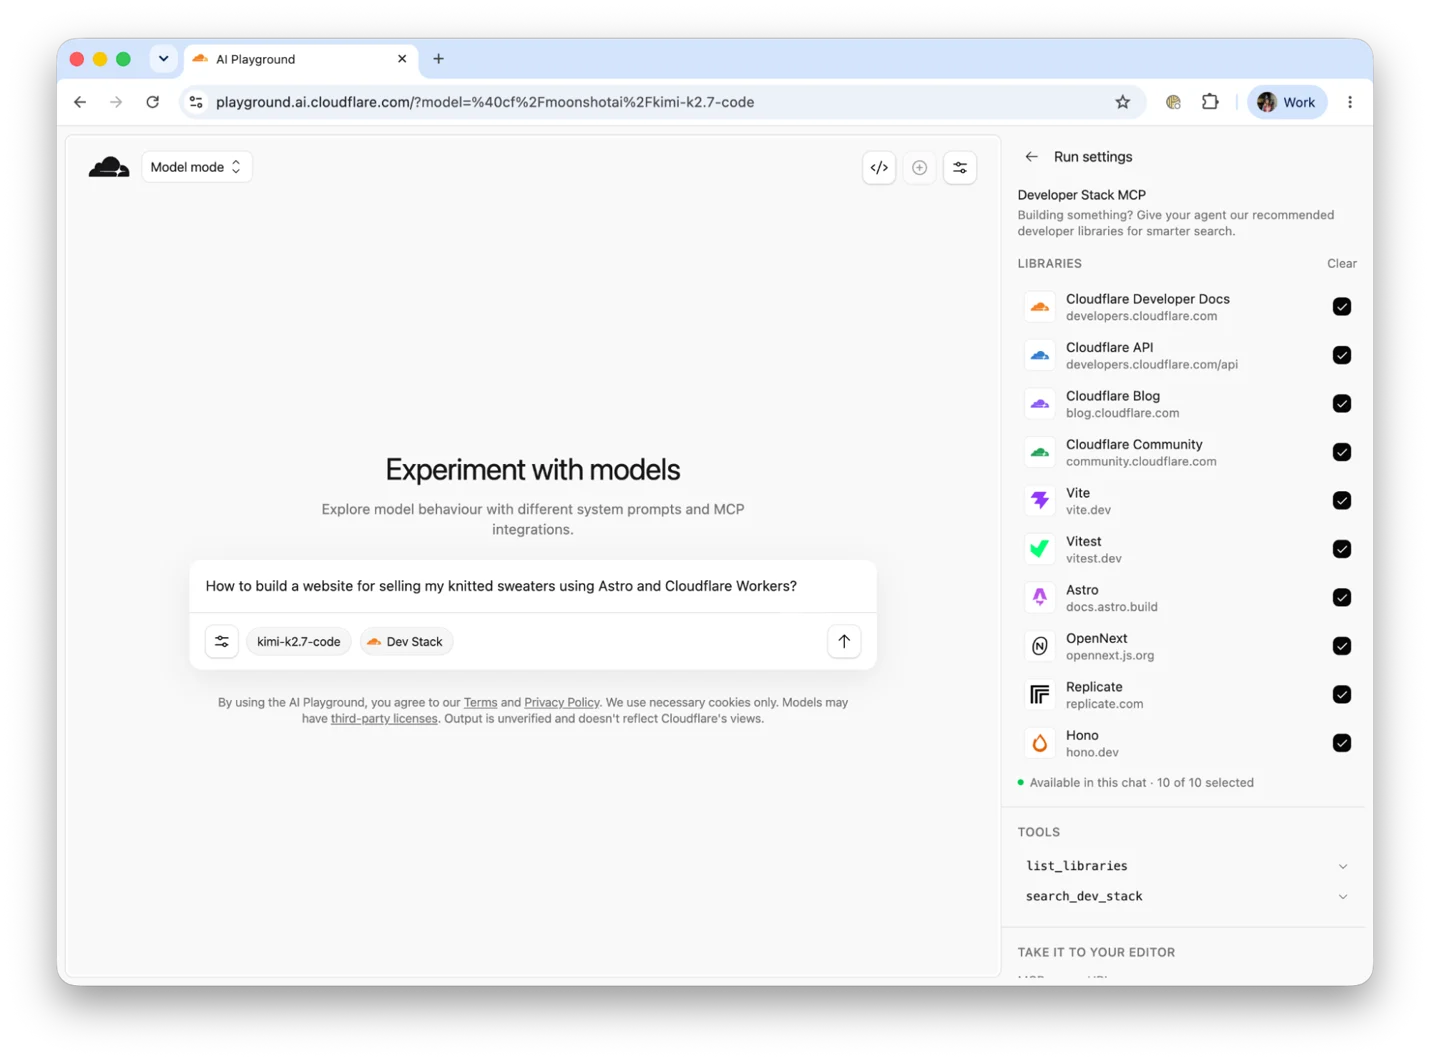
AI Playground 值得一试,但真正的妙处在于把 MCP 接入你的编码智能体,让技术栈的最新文档只需一次工具调用即可获得。这取代了通常的退路(网页搜索,再抓取整页内容),后者既慢、又耗 token,还常常落到错误或过时的来源上。要在你选用的智能体中使用,只需把 Dev Stack MCP 的 URL 填入你的 MCP 配置。例如:
{
  "mcpServers": {
    "dev-stack": { "url": "https://stack.mcp.cloudflare.com/mcp" }
  }
}
驱动我们的博客、开发者文档和 Cloudflare.com 的搜索
我们使用 AI Search 的方式,与客户使用它的方式相同:Cloudflare 博客的搜索早已运行在它之上,今天开发者文档和 Cloudflare.com 也加入了进来。所有这些都使用混合搜索,在一次查询中同时进行语义和关键词搜索,因此既能处理开放式的“这是做什么的”之类的问题,也能精确查找名称或关键词。我们最近用我们新的开源 CMS EmDash 重建了博客,而我们新的
EmDash AI Search 集成正是现在驱动该搜索的组件。你也可以把它添加到自己的 EmDash 站点,开箱即得对你的内容的同样搜索。
AI Search 遵守所有机器人政策
AI Search 在后台由 Browser Run /crawl 提供支持,但更进一步,它以自己专属的机器人身份来表明自己:Cloudflare-AI-Search。与 Browser Run 一样,它遵循 robots.txt,使用不可更改的公开 user agent 表明身份,并会遵守站点设置的任何机器人管控措施。
预览定价:可预测的定价
AI Search 在测试期间目前免费,尚未启用计费;在开始计费之前,我们会提前很久给你发送邮件通知。在我们迈向正式发布(GA)的过程中,以下是摄取、存储和查询,以及嵌入和重排序的定价预览(预览价格在开始计费前可能会有变动):
| 预览使用价格 | 每月免费额度(所有 Workers 套餐) | |
|---|---|---|
| 摄取 | ||
| 基础摄取 | $0.75 / 1M tokens | 5M tokens † |
| 图像处理(附加项) | +$0.50 / 1M tokens | 5M tokens † |
| 存储 | ||
| 已存储数据 | $2.00 / GB-月 | 10 GB |
| 查询 | ||
| 语义(混合搜索和向量搜索) | $0.75 / 1k 次查询 | 2,000 次查询 ‡ |
| 全文 | $0.10 / 1k 次查询 | 2,000 次查询 ‡ |
| 嵌入与重排序 | ||
| 摄取与查询 | 使用特定的 Workers AI 模型时免费;第三方模型另行计费 | 不适用 |
† 每月共用一个 5M 摄取 token 的额度池,涵盖当前支持的任何文件类型(例如文本、图像)。‡ 每月共用一个 2,000 次查询的额度池,两种查询类型共享。
我们的目标是提供你能预测的定价,首先从你的搜索所依赖的模型做起。嵌入把你的文本转换成搜索用来匹配的向量,重排序则对结果重新排序,让最相关的排在前面。使用 AI Search 默认设置或 Workers AI 目录中的特定模型时,两者都是免费的,因此索引和每次搜索背后的模型不是你需要操心的成本。答案生成和查询改写是可选步骤,运行在你选择的模型上,按 Workers AI 用量计费,你也可以对任意模型/提供商使用 AI Gateway 额度。
预览定价下的账单示例
下面是 Workers Paid 套餐下的一份月度账单示例:为一个包含 20,000 份文档(约 2000 万 token 的文本)外加 1,000 张图像(假设每张约 1,000 token)的数据源创建一个新的 AI Search 实例,每月 30,000 次语义查询,使用默认的 AI Search 嵌入和重排序模型。摄取时按约 10% 的重叠进行分块,下面表现为 × 1.1:
| 项目 | 用量 | 价格 | 本月 |
|---|---|---|---|
| 基础摄取 | (20M token 文本 + 1M token 图像)× 1.1 - 5M 免费 = 18.1M tokens | $0.75 / 1M tokens | $13.58 |
| 图像附加项 | 1M token 图像 × 1.1 = 1.1M tokens | $0.50 / 1M tokens | $0.55 |
| 存储 | 约 1.2 GB(在 10 GB 免费额度内) | $2 / GB-月 | $0 |
| 查询(语义) | 30,000 - 2,000 免费 = 28K | $0.75 / 1k | $21.00 |
| 嵌入(Workers AI) | 用量已包含在所选 Workers AI 模型中 | $0 | $0 |
| 重排序(Workers AI) | 用量已包含在所选 Workers AI 模型中 | $0 | $0 |
| 总计 | ~$35 |
图像计入基础摄取,同时还会产生图像附加项费用。存储按每份文档约 10 KB、每张图像 1 MB 估算。索引主要是一次性成本,因此之后的月份主要是查询费用,接近 $21。
立即开始
AI Search 现已可以启用和使用。把它指向你的站点,开启同时支持语义和关键词匹配的混合搜索,你就有了一个属于自己数据的搜索引擎,随时供你的智能体使用。一条命令即可创建:
npx wrangler ai-search create my-search \
  --namespace my-namespace \
  --source https://my-website.com \
  --type web-crawler \
  --hybrid-search
之后,你可以查询它,通过 /mcp 把它接入智能体,或者在公开的 /search 端点上设置自定义域名,与你的用户分享。更多信息请查阅 AI Search 文档。