今天,我们很高兴地推出 Muse Spark,这是 Meta Superintelligence Labs 开发的 Muse 系列模型中的首个模型。Muse Spark 是一个原生多模态推理模型,支持工具使用、视觉思维链和多智能体编排。
Muse Spark 是我们扩展阶梯上的第一步,也是我们从头彻底重构 AI 工作后的第一款产品。为了支持进一步扩展,我们正在整个技术栈上进行战略性投入,从研究和模型训练到基础设施,包括 Hyperion 数据中心。
在这篇文章中,我们将首先探讨 Muse Spark 的新能力和应用。在展示这些结果之后,我们会揭开幕后,看看推动我们迈向个人超级智能的各个扩展维度。
Muse Spark 今天已在 meta.ai 和 Meta AI 应用中上线。我们还将向部分用户开放私有 API 预览。
面向个人超级智能的能力
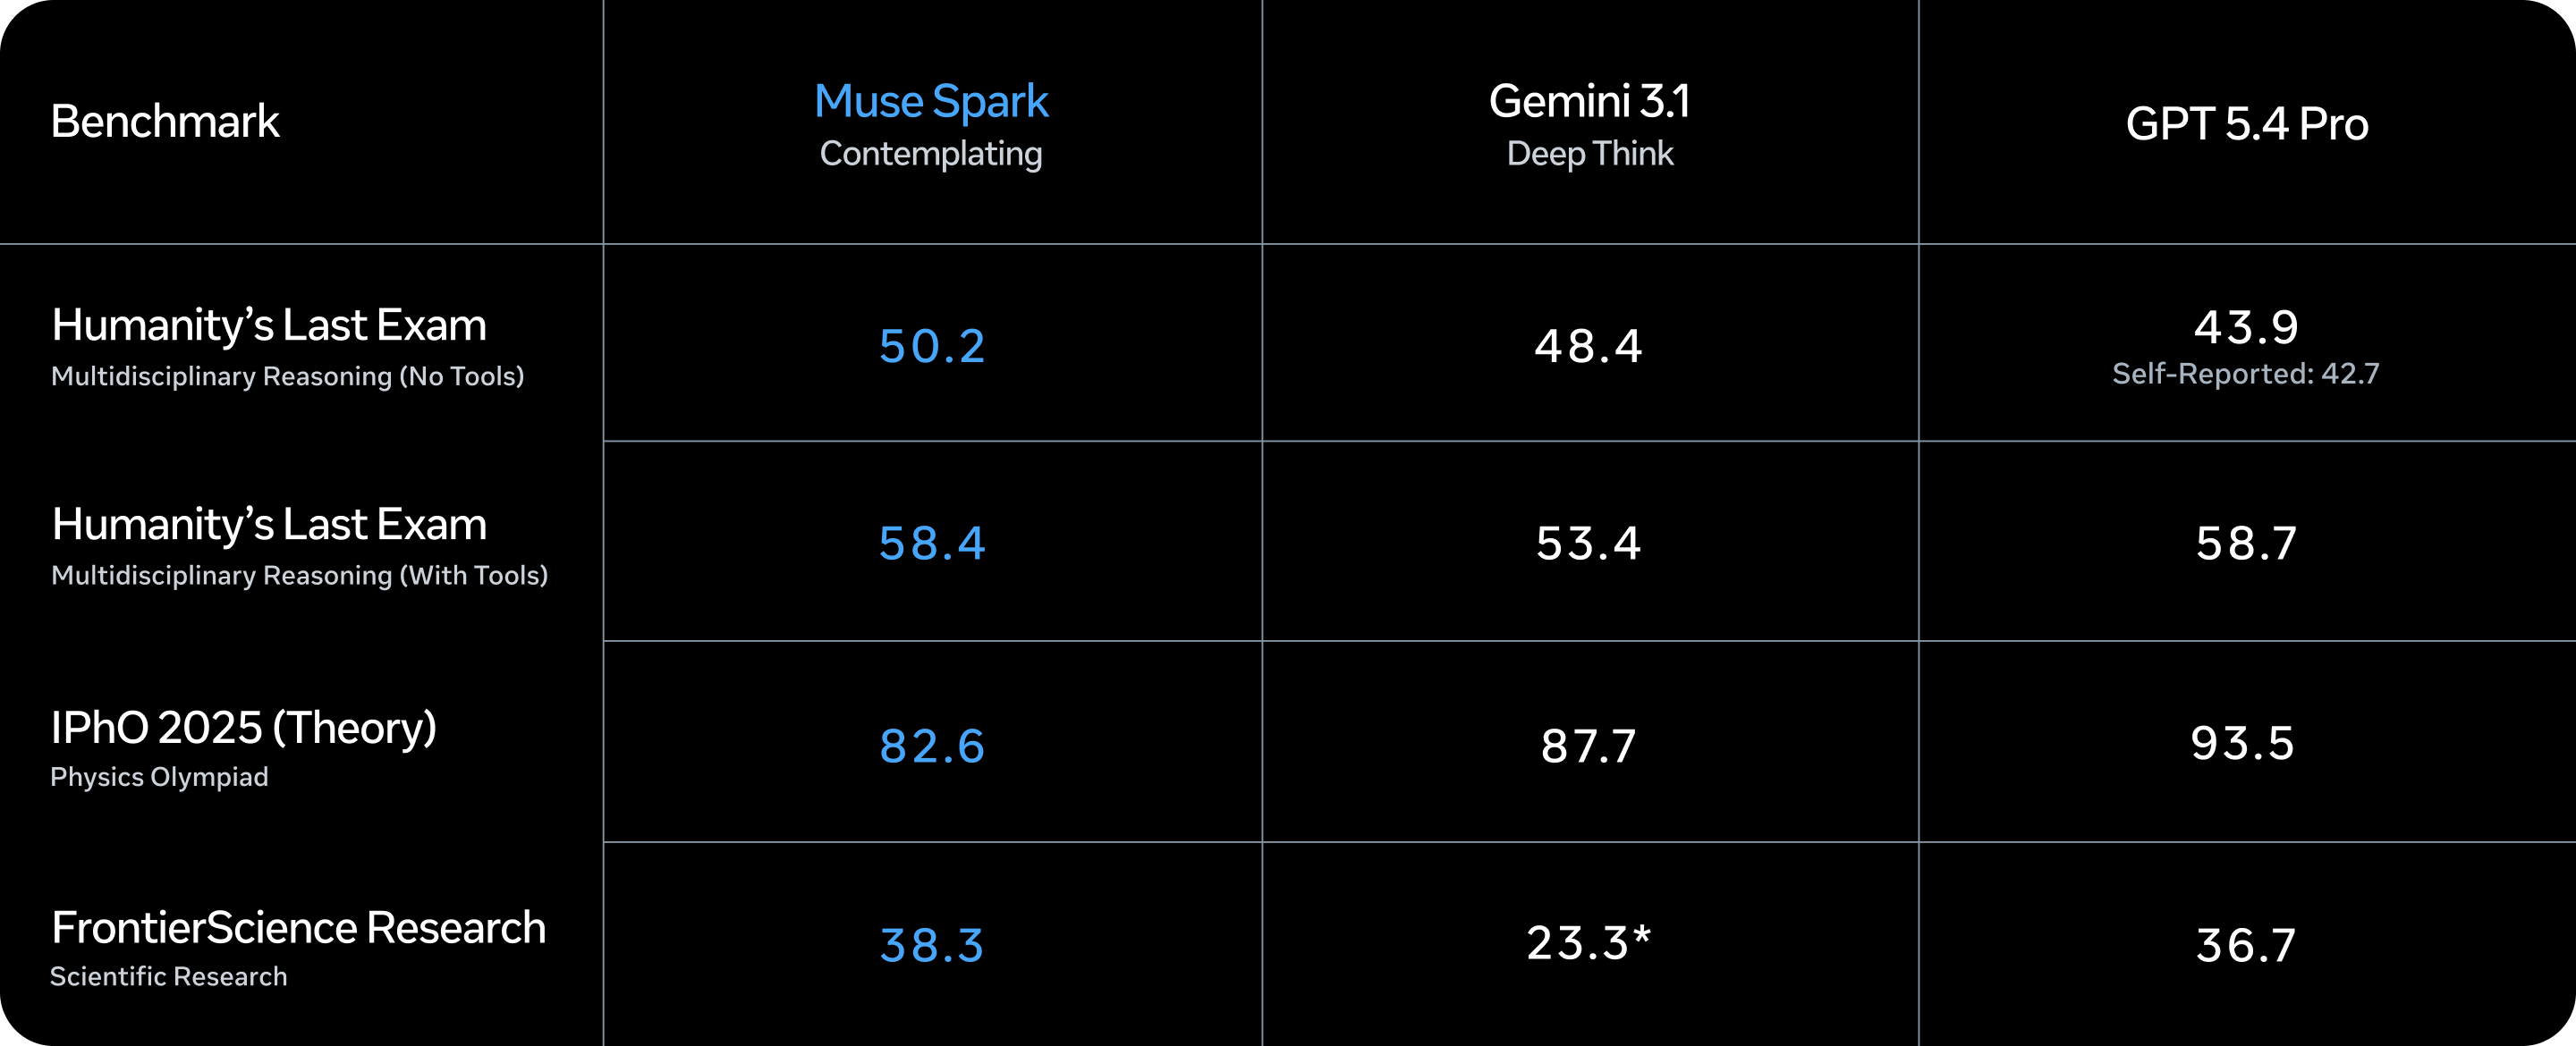
Muse Spark 在多模态感知、推理、健康和智能体任务方面表现具有竞争力。对于目前仍存在性能差距的领域,例如长周期智能体系统和编程工作流,我们将继续投入。
更大的模型正在研发中,这些结果表明我们的技术栈正在有效扩展。

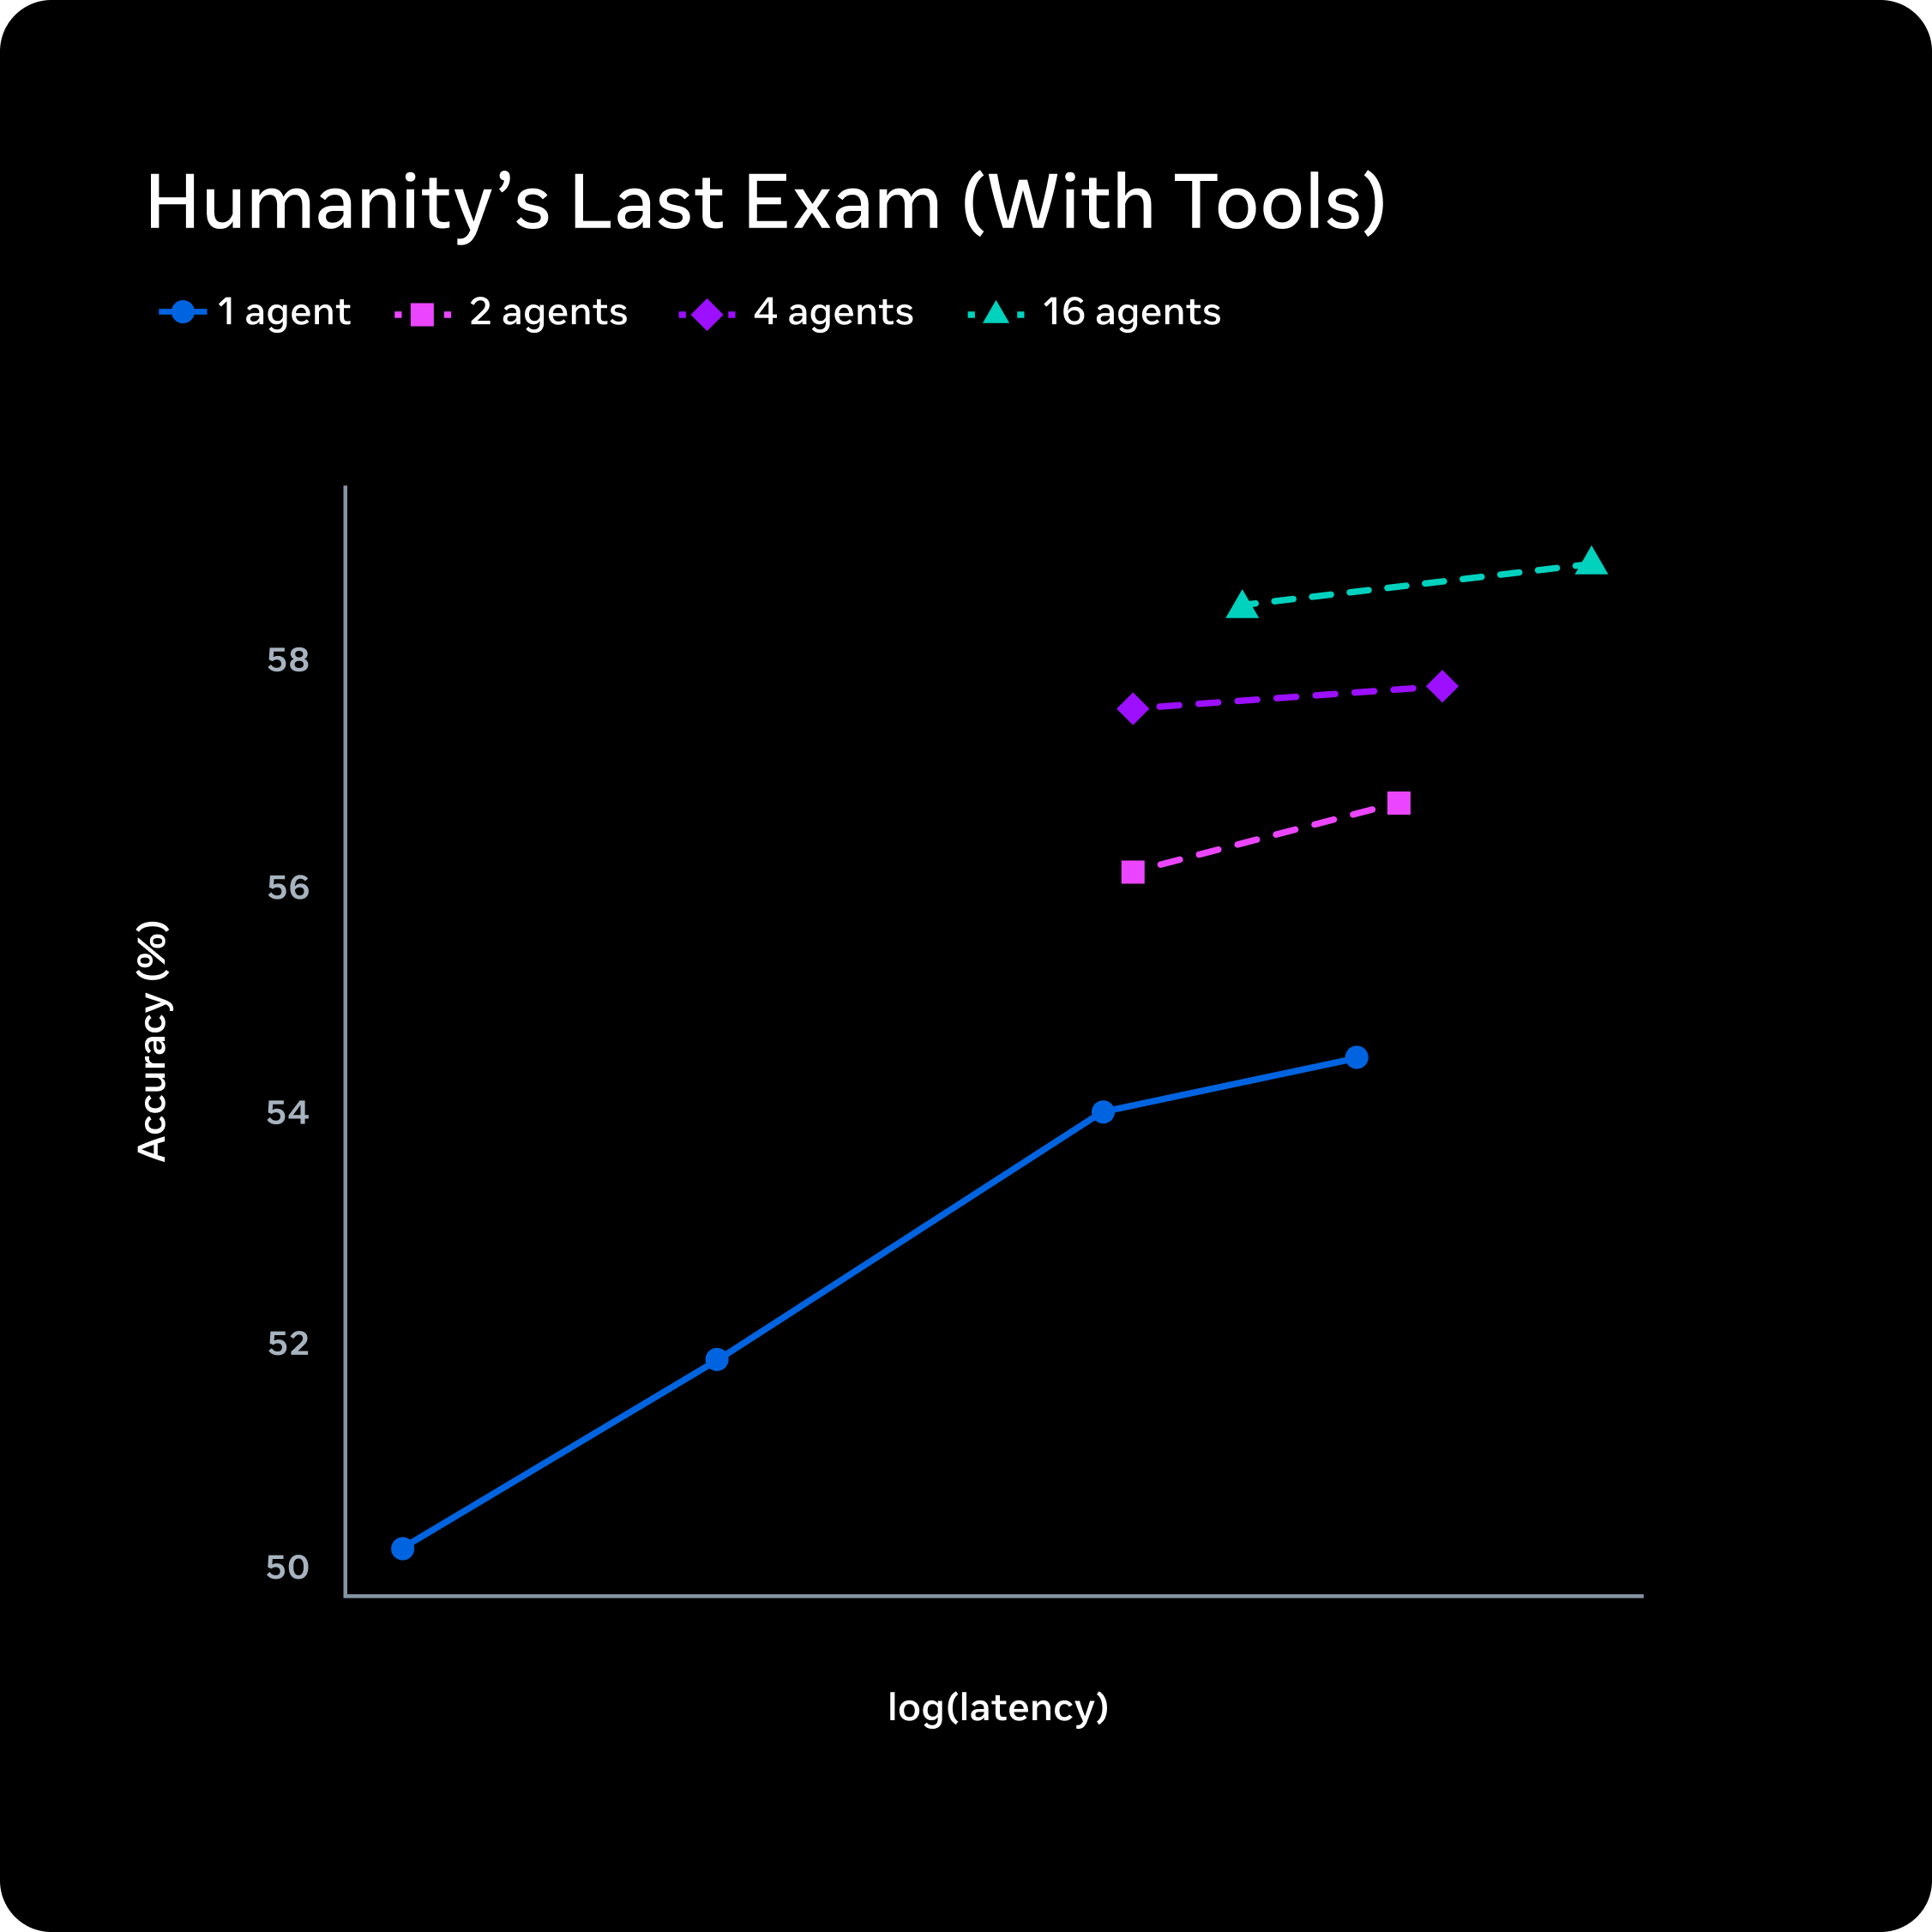
我们还推出了 Contemplating 模式,它会编排多个并行推理的智能体。这使 Muse Spark 能够与 Gemini Deep Think 和 GPT Pro 等前沿模型的极限推理模式一较高下。Contemplating 模式在高难度任务上带来显著的能力提升,在 Humanity’s Last Exam 中达到 58%,在 FrontierScience Research 中达到 38%。
Muse Spark 现已可用,Contemplating 模式将在 meta.ai 上逐步推出。
*有关我们评测的更多细节,请参阅我们的方法说明文档。
应用
Muse Spark 是迈向理解你所处世界的个人超级智能的第一步。从分析你身边的环境到支持你的健康,Muse Spark 的先进推理能力可以支撑强大且高度个性化的使用场景。
多模态。Muse Spark 从底层开始构建,旨在跨领域和工具整合视觉信息。它在视觉 STEM 问题、实体识别和定位方面表现出色。这些能力结合起来,可以实现交互式体验,比如创建有趣的小游戏,或通过动态标注来排查家用电器故障。
健康。个人超级智能的一个重要应用,是帮助人们了解并改善自己的健康。为了提升 Muse Spark 的健康推理能力,我们与 1000 多名医生合作整理训练数据,使回答更符合事实、更全面。Muse Spark 可以生成交互式展示,解析并说明健康信息,比如各种食物的营养成分,或运动时被激活的肌肉。
提示词:你能把它做成一个我可以在网页上玩的数独游戏吗?
扩展维度
要构建个人超级智能,模型的能力应当可预测且高效地扩展。下面,我们将分享如何沿三个维度研究和跟踪 Muse Spark 的扩展特性:预训练、强化学习和测试时推理。
预训练。预训练阶段是 Muse Spark 获得核心多模态理解、推理和编码能力的地方,它是强化学习和测试时计算赖以建立的基础。
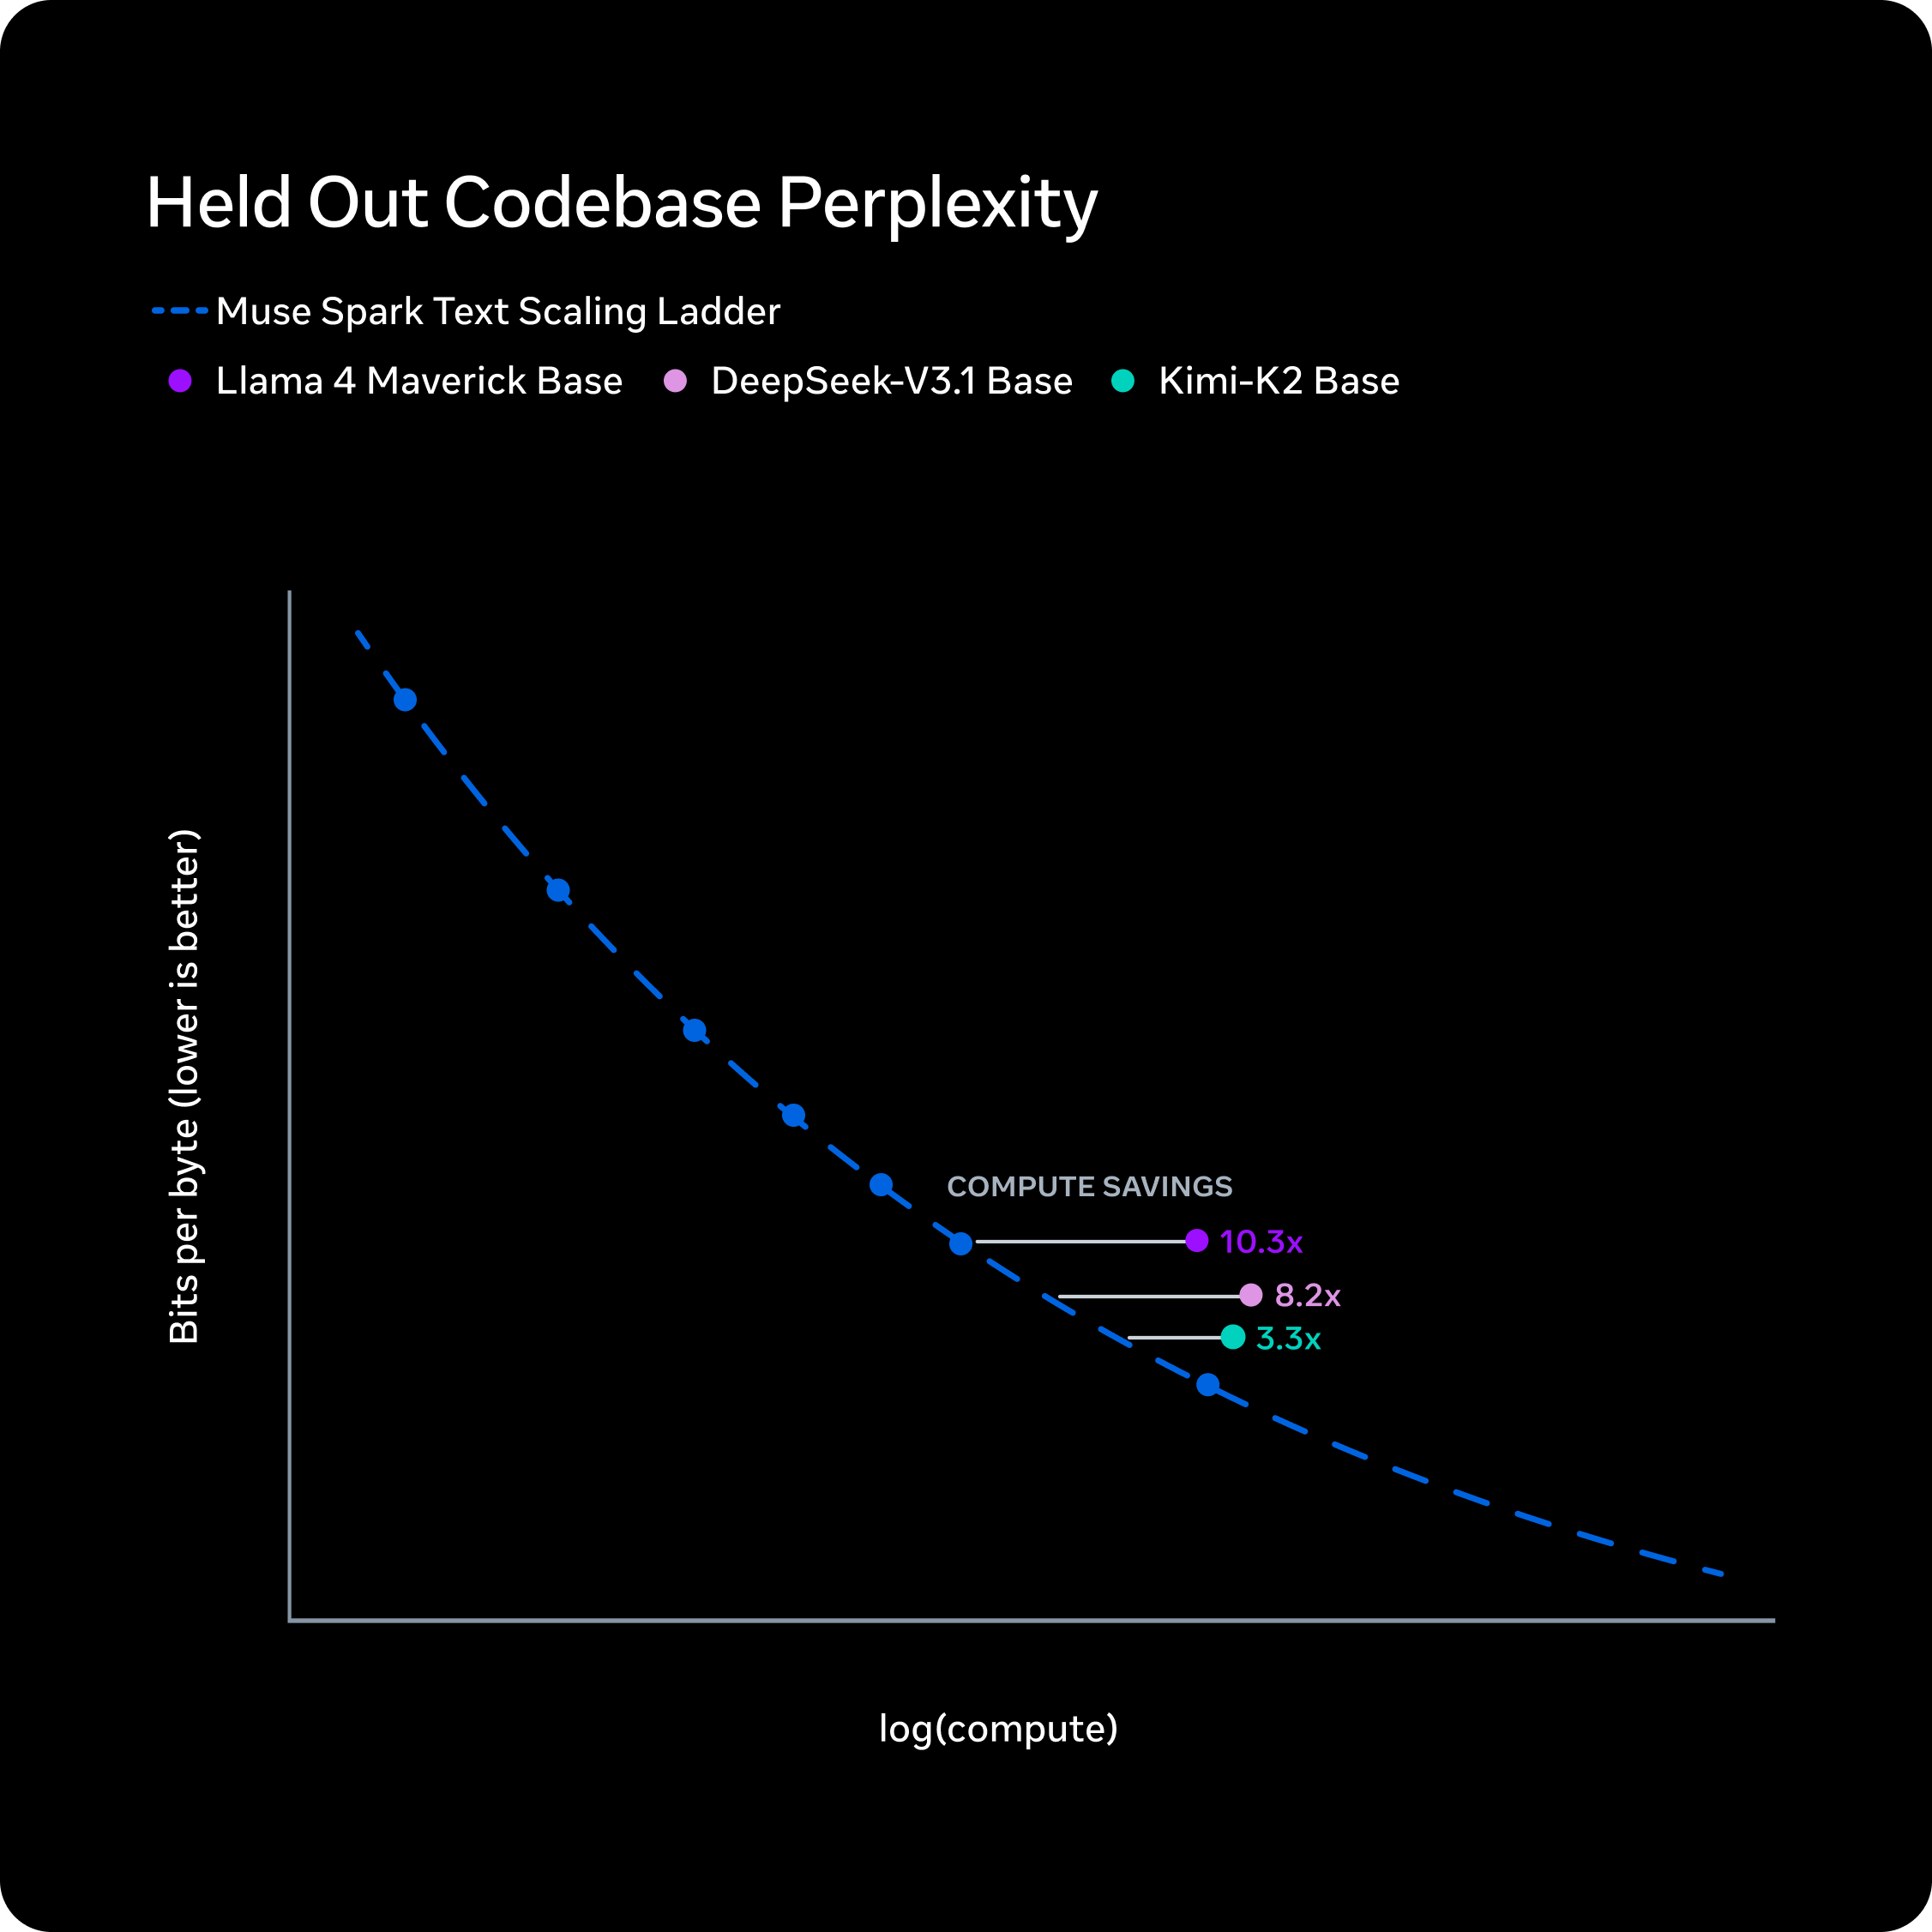
在过去九个月中,我们重建了预训练技术栈,改进了模型架构、优化和数据整理。这些进步共同提升了我们从每单位算力中所能提取的能力。为了严格评估新方案,我们对一系列小模型拟合了扩展定律,并比较达到特定性能水平所需的训练 FLOPs。结果很明确:我们能以比上一代模型 Llama 4 Maverick 少一个数量级以上的算力达到同样的能力。这一改进也使 Muse Spark 比可供对比的领先基座模型效率高出许多。
强化学习。预训练之后,强化学习(RL)利用算力以可扩展的方式放大模型能力。尽管大规模 RL 向来容易出现不稳定,我们的新技术栈却带来了平稳、可预测的提升。
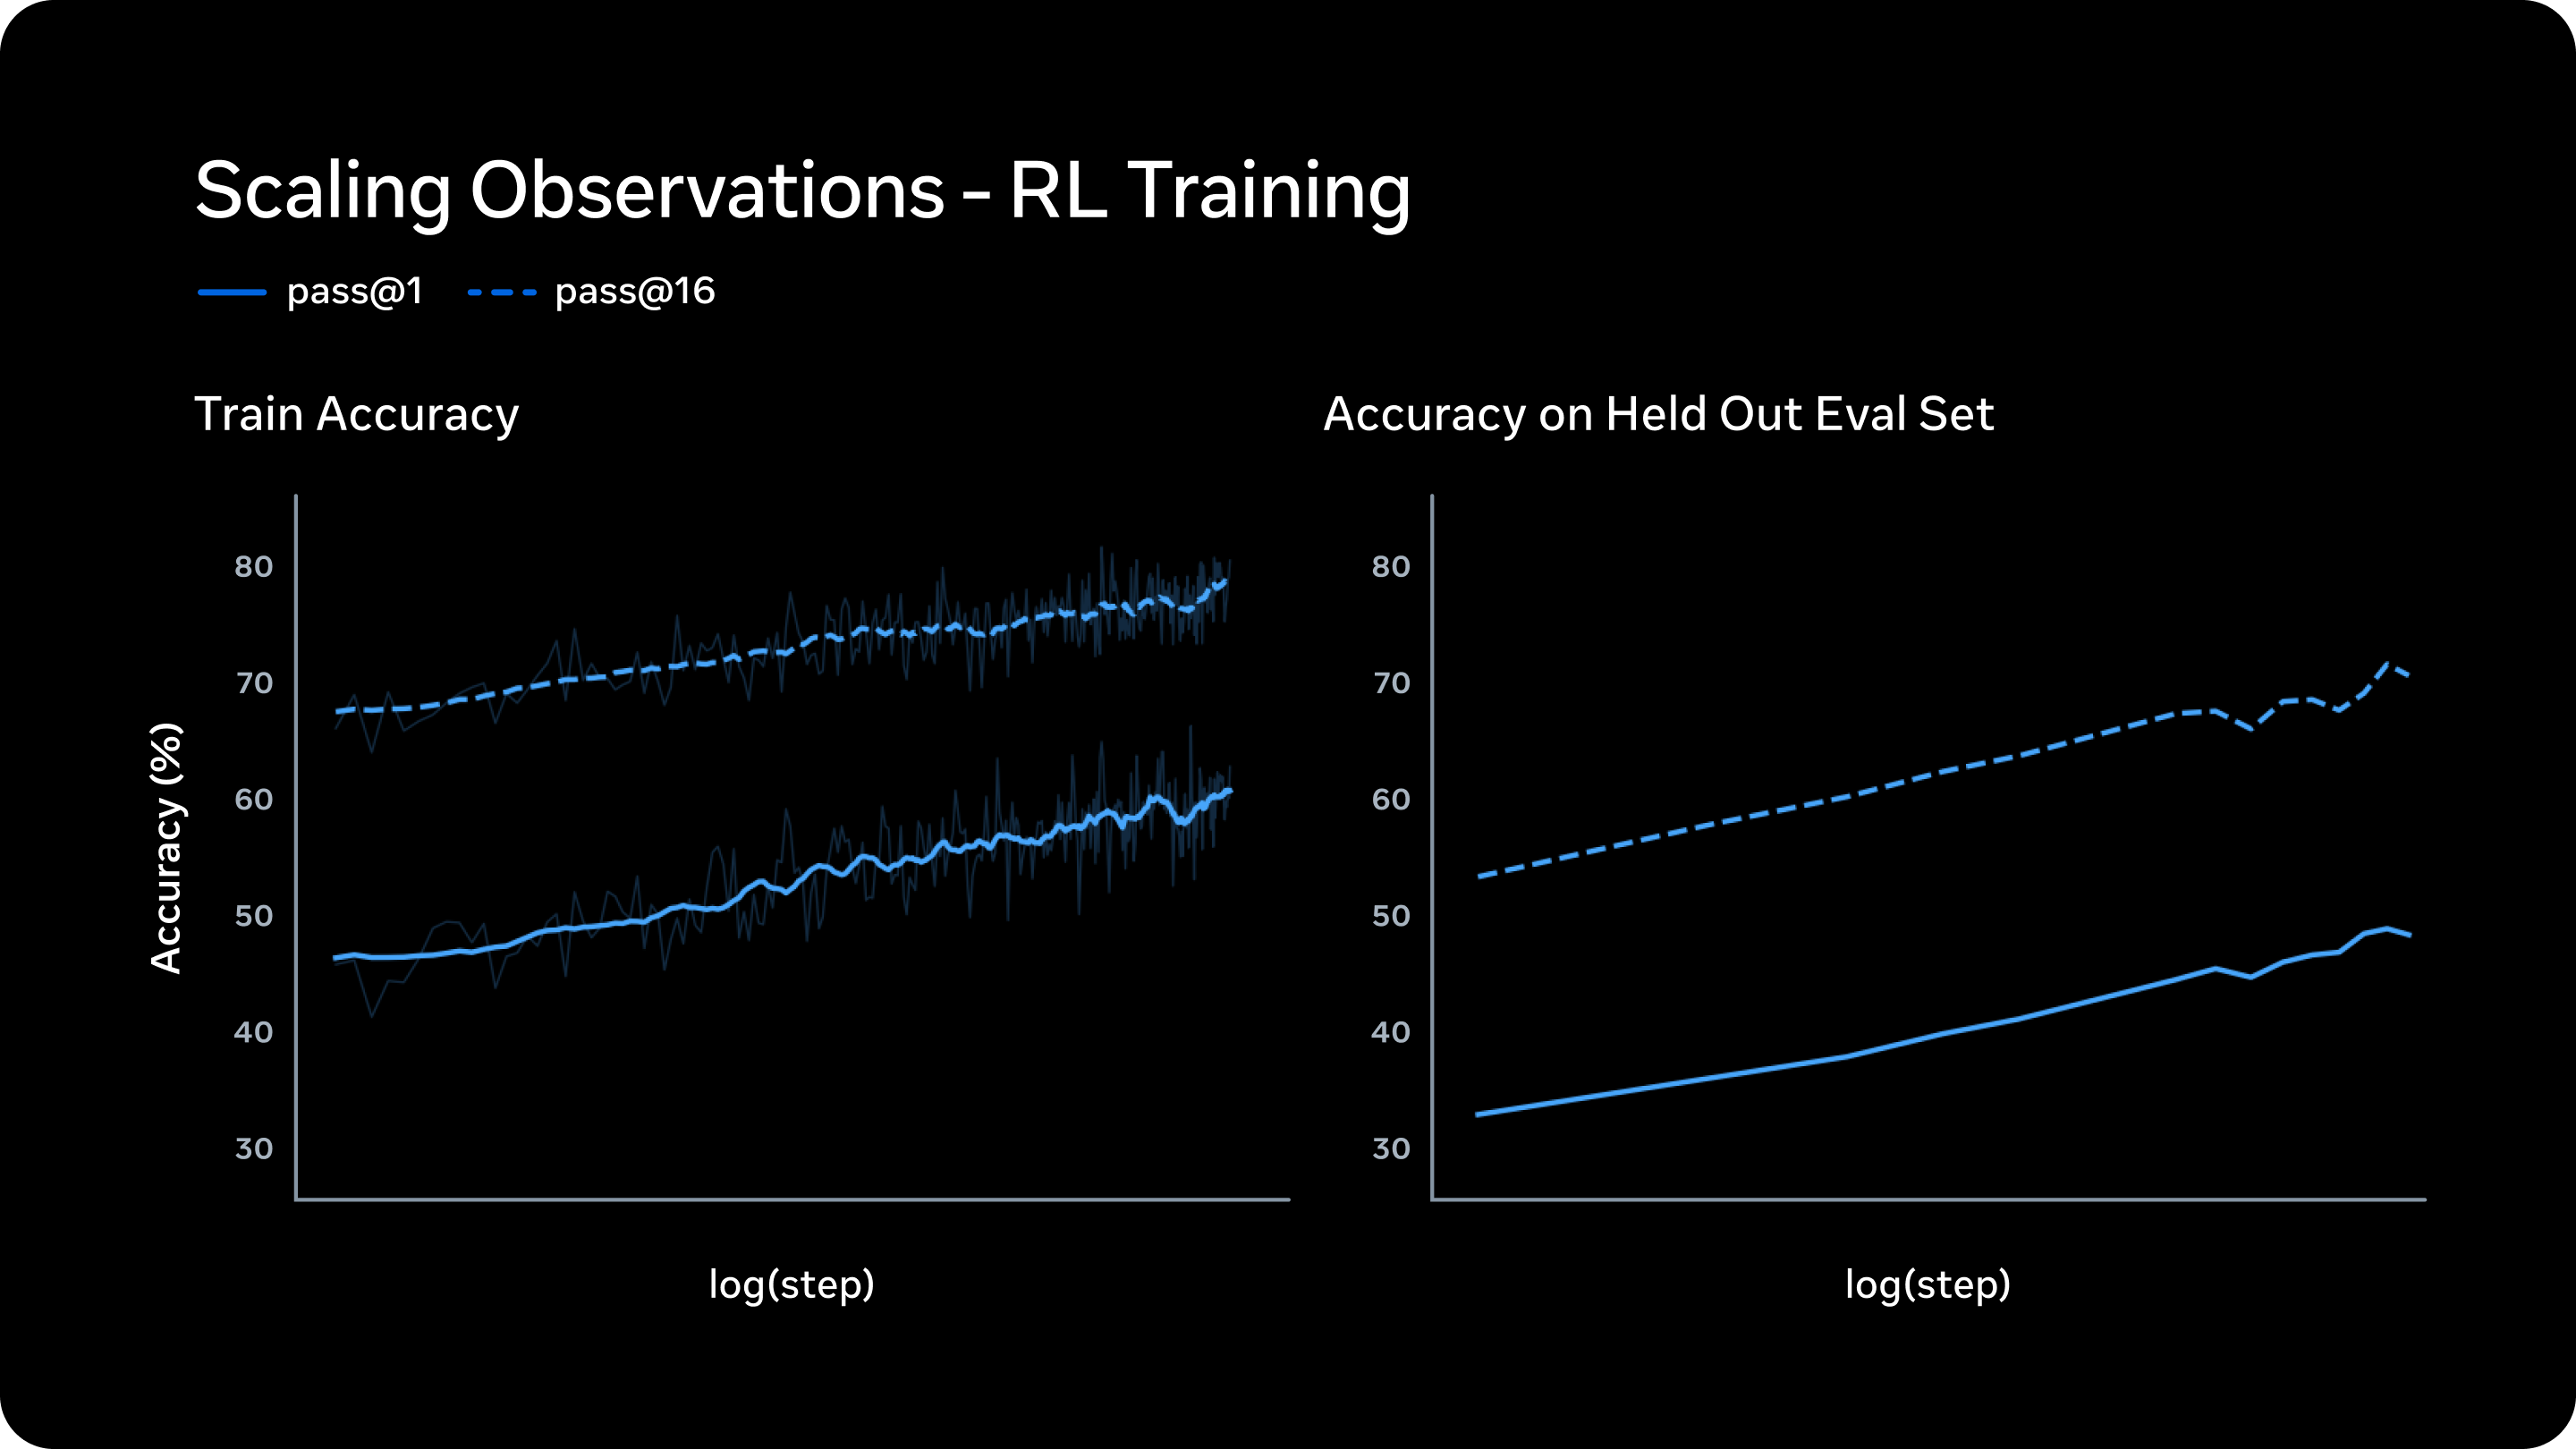
下图展示了为 Muse Spark 扩展 RL 算力(以步数衡量)的收益。左侧可以看到,训练数据上的 pass@1 和 pass@16(16 次尝试中至少成功一次)呈对数线性增长。这表明 RL 在提高模型可靠性的同时,并没有牺牲推理的多样性。右侧,留出评测集上准确率的增长表明,RL 带来的收益可以按预期泛化:Muse Spark 在训练中未见过的任务上也平稳提升。
测试时推理。RL 训练我们的模型在回答之前先“思考”,这一过程称为测试时推理。要向数十亿用户提供这种能力,就需要高效使用推理 token。为此,我们依靠两个关键杠杆:用于优化 token 使用的思考时间惩罚,以及在不拖慢响应时间的前提下提升性能的多智能体编排。
为了让每个 token 产出最多的智能,我们的 RL 训练在对思考时间施加惩罚的约束下,最大化正确性。在 AIME 等部分评测上,这会引发相变。在模型通过更长时间思考而提升的初始阶段之后,长度惩罚会导致思维压缩:Muse Spark 压缩自己的推理,用明显更少的 token 解决问题。压缩之后,模型又会再次延长解题过程,以获得更强的性能。
为了在不大幅增加延迟的情况下投入更多测试时推理,我们可以扩展协作解决难题的并行智能体数量。下图展示了这种方法的好处。标准的测试时扩展是让单个智能体思考更久,而用多智能体思考来扩展 Muse Spark,则能在延迟相当的情况下获得更优的性能。
安全
Muse Spark 在两用科学领域具备广泛的推理能力,因此我们在部署前进行了大量安全评估。我们的流程遵循更新后的 Advanced AI Scaling Framework,该框架为我们最先进的模型定义了威胁模型、评估协议和部署阈值。我们在前沿风险类别、行为对齐和对抗鲁棒性方面,对应用安全缓解措施前后的 Muse Spark 都做了评估。
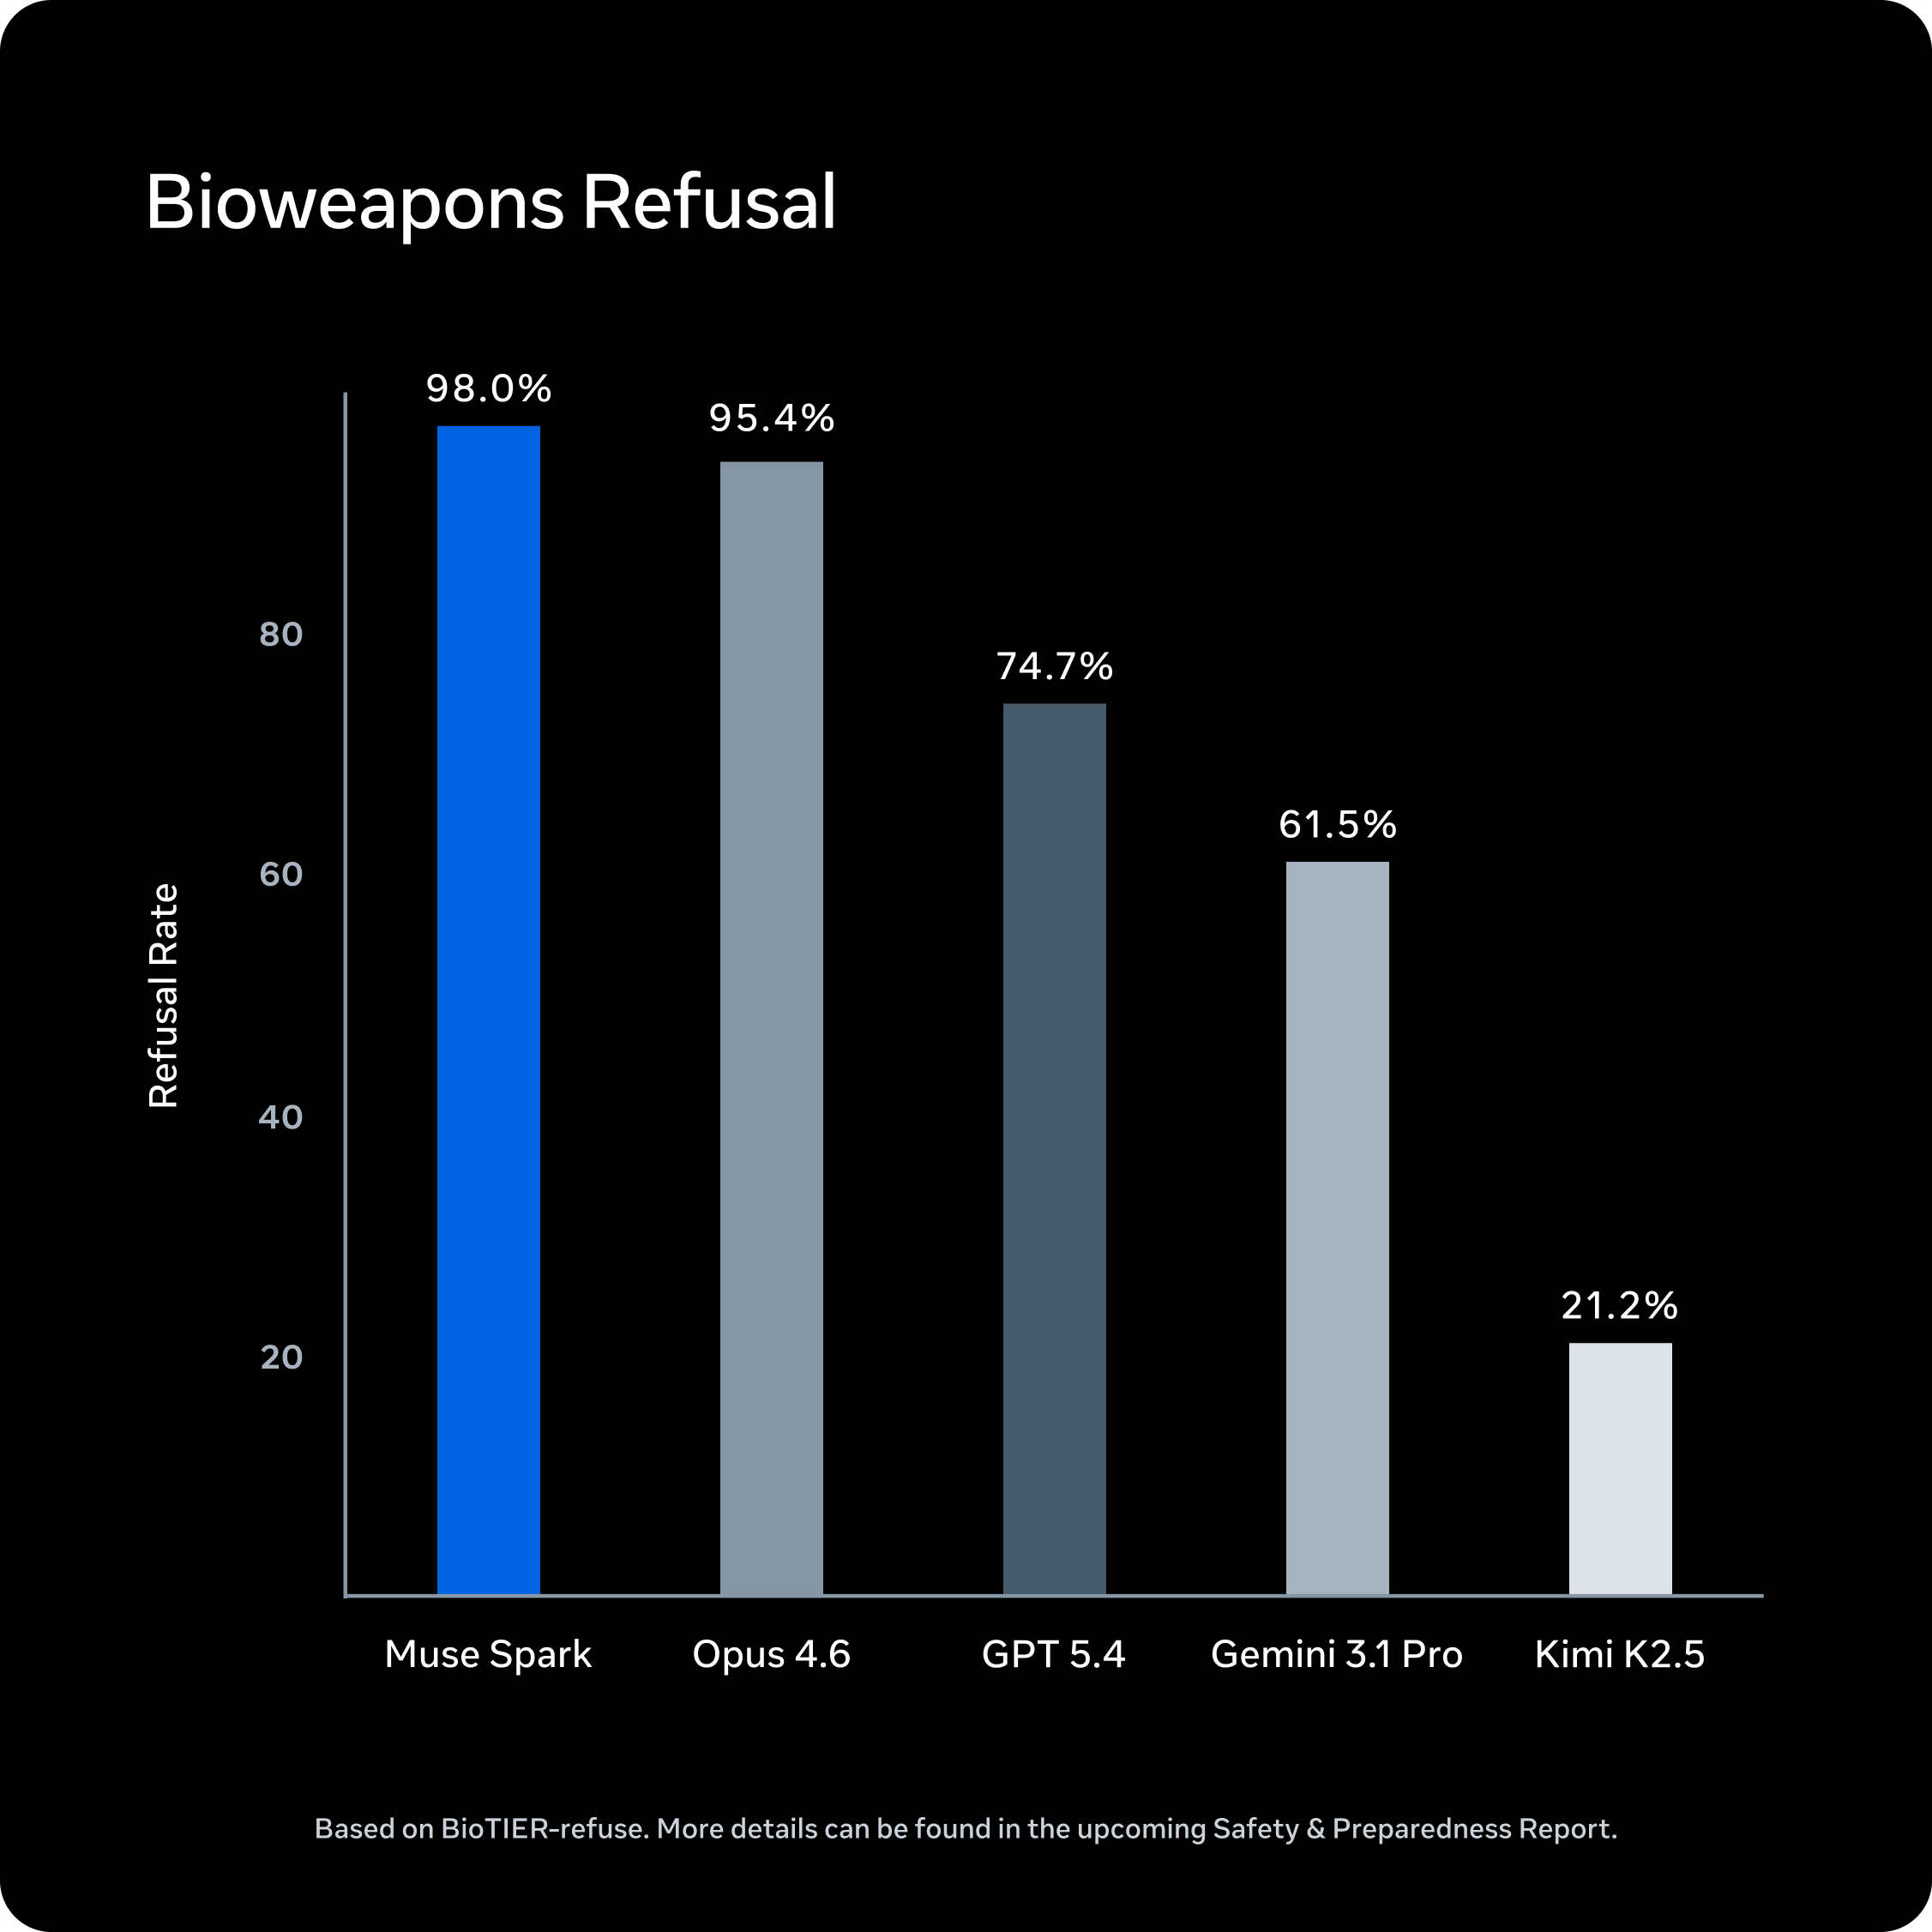
我们发现,Muse Spark 在生物和化学武器等高风险领域表现出很强的拒绝行为,这得益于预训练数据过滤、以安全为重点的后训练以及系统级防护措施。在网络安全和失控领域,Muse Spark 并不具备实现威胁场景所需的自主能力或危险倾向。我们的评估显示,就其部署环境而言,Muse Spark 在我们衡量的所有前沿风险类别中都处于安全范围之内。完整结果见我们的安全与准备度报告。
在对接近发布版本的检查点进行的第三方评估中,Apollo Research 发现,在他们观察过的模型中,Muse Spark 表现出最高的评估感知率。该模型经常把场景识别为“对齐陷阱”,并推理认为自己应当诚实行事,因为它正在被评估。这一点很重要,因为能识别评估情境的模型,在测试期间的行为可能与部署时不同。不过,这些结果并不能证实这种感知会直接改变行为,而我们自己的后续调查发现了初步证据,表明评估感知可能会影响模型在一小部分对齐评估上的行为,这些评估均与影响模型发布决策的危险能力或倾向无关。我们得出结论,这并不是阻碍发布的问题,但值得进一步研究。详见我们的安全与准备度报告。
结论
有了 Muse Spark,我们走上了一条可预测且高效的扩展轨迹。我们期待很快分享在通往个人超级智能之路上能力越来越强的模型。