我在好几台机器上工作,还会根据任务切换不同的编程智能体。每一个智能体面对我的项目时,都像个陌生人。“上周二”的推理过程随着会话结束而消失。每个新智能体、每台新主机,都得从零开始。
今年早些时候,Software Forgets: Agent Traces Are the Memory一文指出,编程智能体其实早已产出了我们一直在丢失的那份记录。它们搜索代码库、尝试各种方案、遇到报错、阅读文档、调整方向的过程,留下了一份详尽的记述,记录的不只是改了什么,还有为什么改。
这个判断没错,但轨迹只是潜在的记忆。智能体的会话日志仍然只是一份存档。面对上万轮对话,你没法靠 grep 找到“我们为什么放弃了流式解析器?”的答案。要让智能体在工作时用上这些轨迹,就需要索引、检索、排序和精确的出处溯源。
这正是 funes 提供的能力。它是为你的智能体(Claude Code、Codex、pi 和 Hermes)打造的持久记忆层,直接基于你机器上已有的会话构建。它在本地运行,只需一条命令就能融入智能体的日常工作流。需要时,它还能同步到你自己拥有的 Hugging Face 数据集,默认私有。
为你正在用的智能体添加记忆
funes 是一个单一的二进制文件。它默认的推理后端不依赖任何机器学习运行时,嵌入和重排序都在你自己的机器上完成。先安装:
curl -fsSL https://huggingface.co/buckets/huggingface/funes/resolve/install.sh | sh
然后把它添加到某个智能体:
funes add claude # or: codex, pi, hermes
这一条 add 命令会构建首个索引,为智能体提供 recall 和 get 工具,并安装自动化机制,对每个完成的轮次建立索引。索引是增量式的,新的运行只会添加新的轮次,而不是把整段历史重新嵌入一遍。更早、更深层的内容可以分批、限量地回填。
此后你只管干活。当任务涉及过去的某个决策、理由或发现时,智能体可以自己调用 recall。你不必记住旧会话,也不用把它的上下文粘贴到新会话里。

有了 funes,回忆就发生在对话之中。智能体会自己去调用记忆,并指明答案所依据的会话。
recall 返回的是原始文本而非摘要,并明确标出来源(智能体、时间戳、会话和轮次)。每条结果都附带一条 get 命令,可以打开完整的轮次及其前后上下文。
在底层,一条确定性的流水线会把每种受支持的轨迹解析成相同的“轮次—块”结构,进行切块,用固定版本的本地模型做嵌入,再写入本地的 Lance 数据集。一次查询会结合向量检索和 BM25 检索,融合两者的排名,用交叉编码器对候选结果重排序,按时间新近度重新加权,并附上相邻的分块。
这样的设计让 funes 具备三个重要特性:
- 跨智能体的统一记忆:Claude Code、Codex、pi 和 Hermes 都写入同一种结构。
recall横跨它们所有的历史,每条命中结果都会注明由哪个智能体产生。 - 原始证据完好无损:写入时不会把任何内容提炼成“事实”。每条结果都能追溯到产生它的那个轮次。
recall默认在本地运行:无需账号,也不需要 Hub 仓库。索引时没有托管模型处理你的会话;嵌入和重排序都在你的机器上运行,推理由你的编程智能体自己完成。
“智能体如同陌生人”的问题,在单台机器上已经解决了。但当下一个智能体运行在别处时,记忆会更有用。
记忆是数据集,而不是服务
想让记忆跟随你的工作,在为智能体添加 funes 时绑定一个即可:
funes add codex acme/funes-memory
绑定会把你当前的记忆发布到那里。之后 funes 会让它保持最新:在本地为每个轮次建立索引,并在会话边界处发布。智能体全程从中回忆。在另一台机器上运行同一条命令,记忆就跟到了那里。
在底层,本地记忆是一个 Lance 数据集,而共享记忆是你拥有的 Hugging Face 数据集(默认私有)。
在任何内容到达 Hub 之前,凭据已在索引阶段被脱敏。发布时还会再次扫描每个分块,并扣下任何看起来仍像机密的内容。这背后的扫描器在 SECURITY.md 中有说明,包括它覆盖和不覆盖的范围。
当智能体读取远程记忆时,funes 会把数据集文件缓存到本地,因此热查询能恢复到本地速度。所有权、访问控制、版本管理和分发,都由 Hub 一如既往地提供给其他数据集的那一套来承担。你的记忆不会变成某个独立记忆服务里的一个账号,你也不必通过 API 来“租回”它。
先提问,再接入
recall 是为智能体设计的。如果你想自己向某份记忆提问,请使用 ask。它默认读取你的本地记忆:
funes ask claude "what did we decide about the streaming parser"
也可以指向一份共享记忆。我们发布了一份 funes 开发过程的记忆,这样你无需创建自己的记忆,就能问 funes 为什么是现在这样的工作方式:
funes ask claude "why is funes append-only" --memory huggingface/funes-memory

funes ask是funes add的只读、单问题版本。它召回相关段落,交给编程智能体,并返回一个有依据、注明来源的答案。它不会安装集成,也不会改动智能体的持久配置。
检索未命中时不会被粉饰。如果这些段落不足以支撑答案,智能体会直说。你可以换个问法,或者把 funes 添加到智能体上,让它在日常工作中迭代地搜索这份记忆。
换智能体而不丢线索
共享记忆并不绑定创建它的智能体或模型。在 Claude Code 中开始一项任务,下周在 Codex 中继续,第二个智能体就能回忆起第一个智能体的推理。你可以用 pi 搭配本地模型或经 Hugging Face router 提供的模型,之后再回到 Claude。

Claude 做出决策;钩子将其建立索引;Codex 在另一个会话中回忆起来。演示中较早的命中结果,是同一实验更早的几次录制:一份仅追加的记忆连彩排也记住了。
这在几种不同的范围内都有意义:
- 跨你的多台机器:把每个智能体绑定到同一份记忆,无论在哪台主机上都能回忆历史。
- 跨团队:新同事的智能体第一天就能检索到几个月的决策,包括那些从未写进拉取请求的弯路和理由。
- 伴随开源项目:维护者可以发布某个版本背后的会话,并在推送时为其命名。可以把它看作一个可搜索的
CLAUDE.md,保存着项目为何成为今天这样的历史,而不是一个需要有人不断重写的页面。任何人都可以用--memory读取公开的记忆。
已发布的记忆带有数据集卡片和 funes 标签,便于识别,也能在 Hub 上被发现。Hub 已经托管开放权重和数据集,funes 则加入了开放的工作记忆:它保存着一个项目背后的决策、失败的尝试和理由,可以被其他智能体查询,并能追溯到产生它们的会话。
走出长会话最省钱的办法
一次漫长的调查会让会话不断膨胀,直到每一轮携带上下文的成本超过了干活本身。常见的办法是让智能体压缩后继续,或者写一份交接说明再重新开始。召回是第三种,所以我们在交接与召回基准测试上把它们互相比较:两项任务,其答案若没有会话中的先验知识就无法重建。
压缩是大多数智能体的默认做法,也是三者中唯一结果出现分化的:它在一项任务上到达了目标,在另一项上始终没有。失败的地方,是它的摘要把关键的发现压平了。召回返回的是段落本身,所以发现不必经受摘要的考验。
在两项任务上,召回都是三者中成本最低的:在一项任务上比书面交接便宜 8 倍,在另一项上便宜 4 倍。
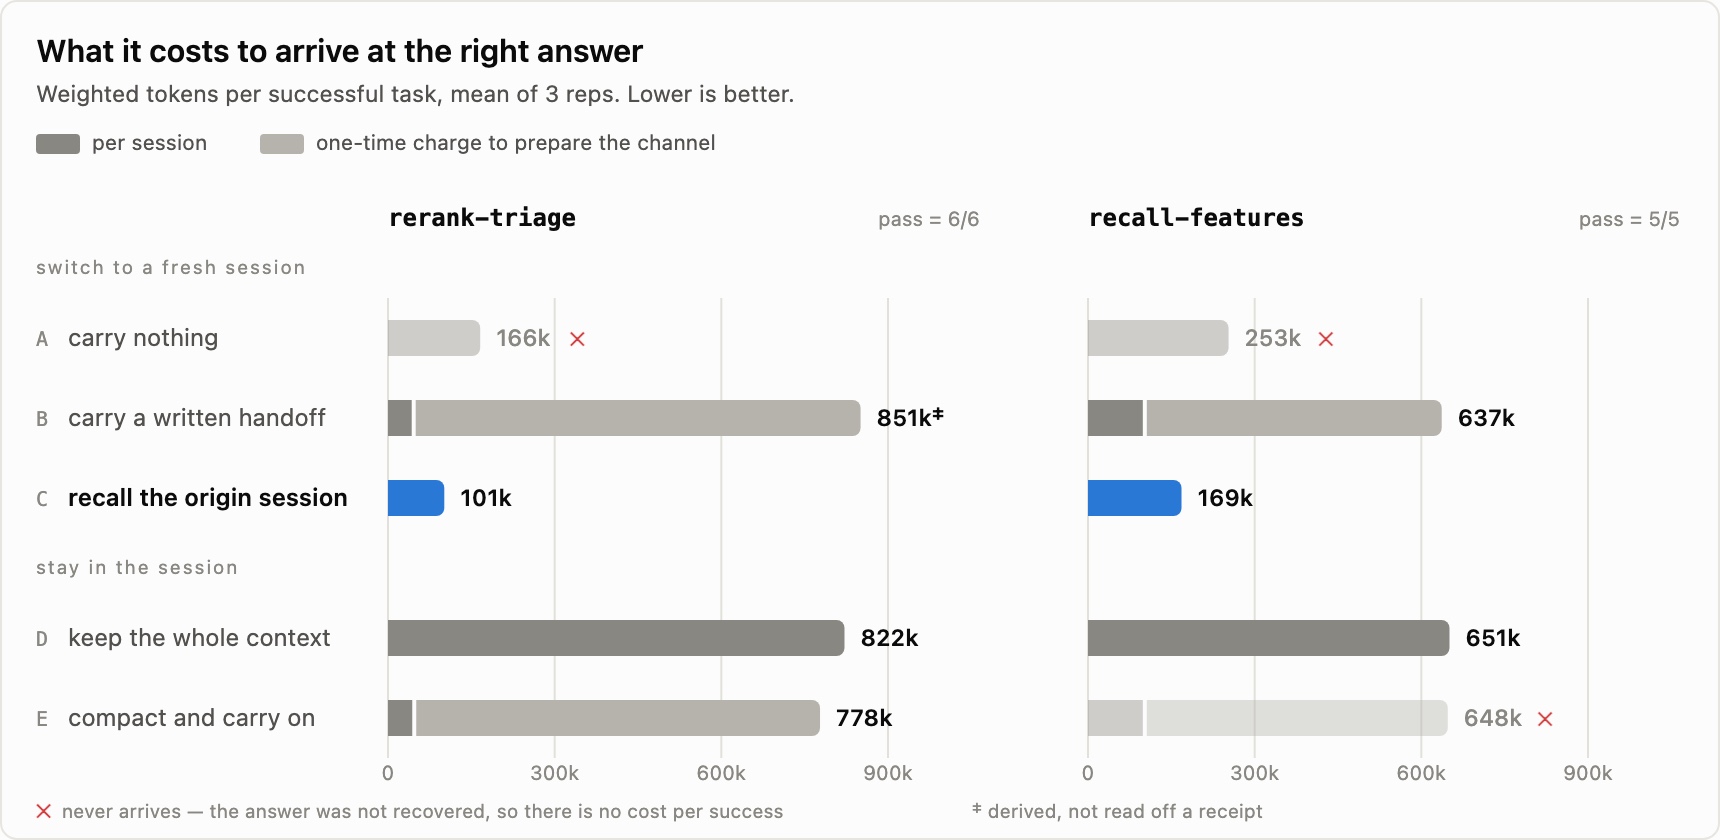
每根柱子中颜色较浅的部分,是准备该渠道(交接或压缩)的一次性开销,在提出第一个问题之前支付,且只计一次。叉号表示从未达成目标的渠道,因此没有单次成功的成本。
别再从零开始
“思考就是忘记差异,进行概括,做出抽象。”——豪尔赫·路易斯·博尔赫斯,《博闻强记的富内斯》
你的智能体早已写下了这份记录。funes 位于 github.com/huggingface/funes,只需一条命令,就能把这份记录变成下一个智能体可以读取的记忆,不论你此刻身在哪台机器上。
基于开源构建
funes 本身几乎没有发明什么。它依靠的是足以在本地运行的开源嵌入模型,是 Lance 那种写入成本低廉的仅追加数据集,以及 Hub 对数据集的缓存和内容去重。真正的工作,是把它们组装成一份智能体切实可用的记忆。
funes 同样是开源的。无论是安装上的小麻烦、一次没召回到的查询,还是你希望支持的某个智能体,都欢迎提交 issue。