今年早些时候,我打开 Linear,发现我们的 CTO Tuomas 给我指派了一个问题,标题是“CI 成本很高”。他还顺带希望我把 CI 跑得更快。
智能体让代码的交付速度成倍提升,但对这些改动的验证却没能跟上同样的节奏。每个 PR 仍然要走一遍 CI,所以随着开发提速,CI 就成了瓶颈:基础设施成本被推高,开发者和智能体也要等更久才能拿到反馈。
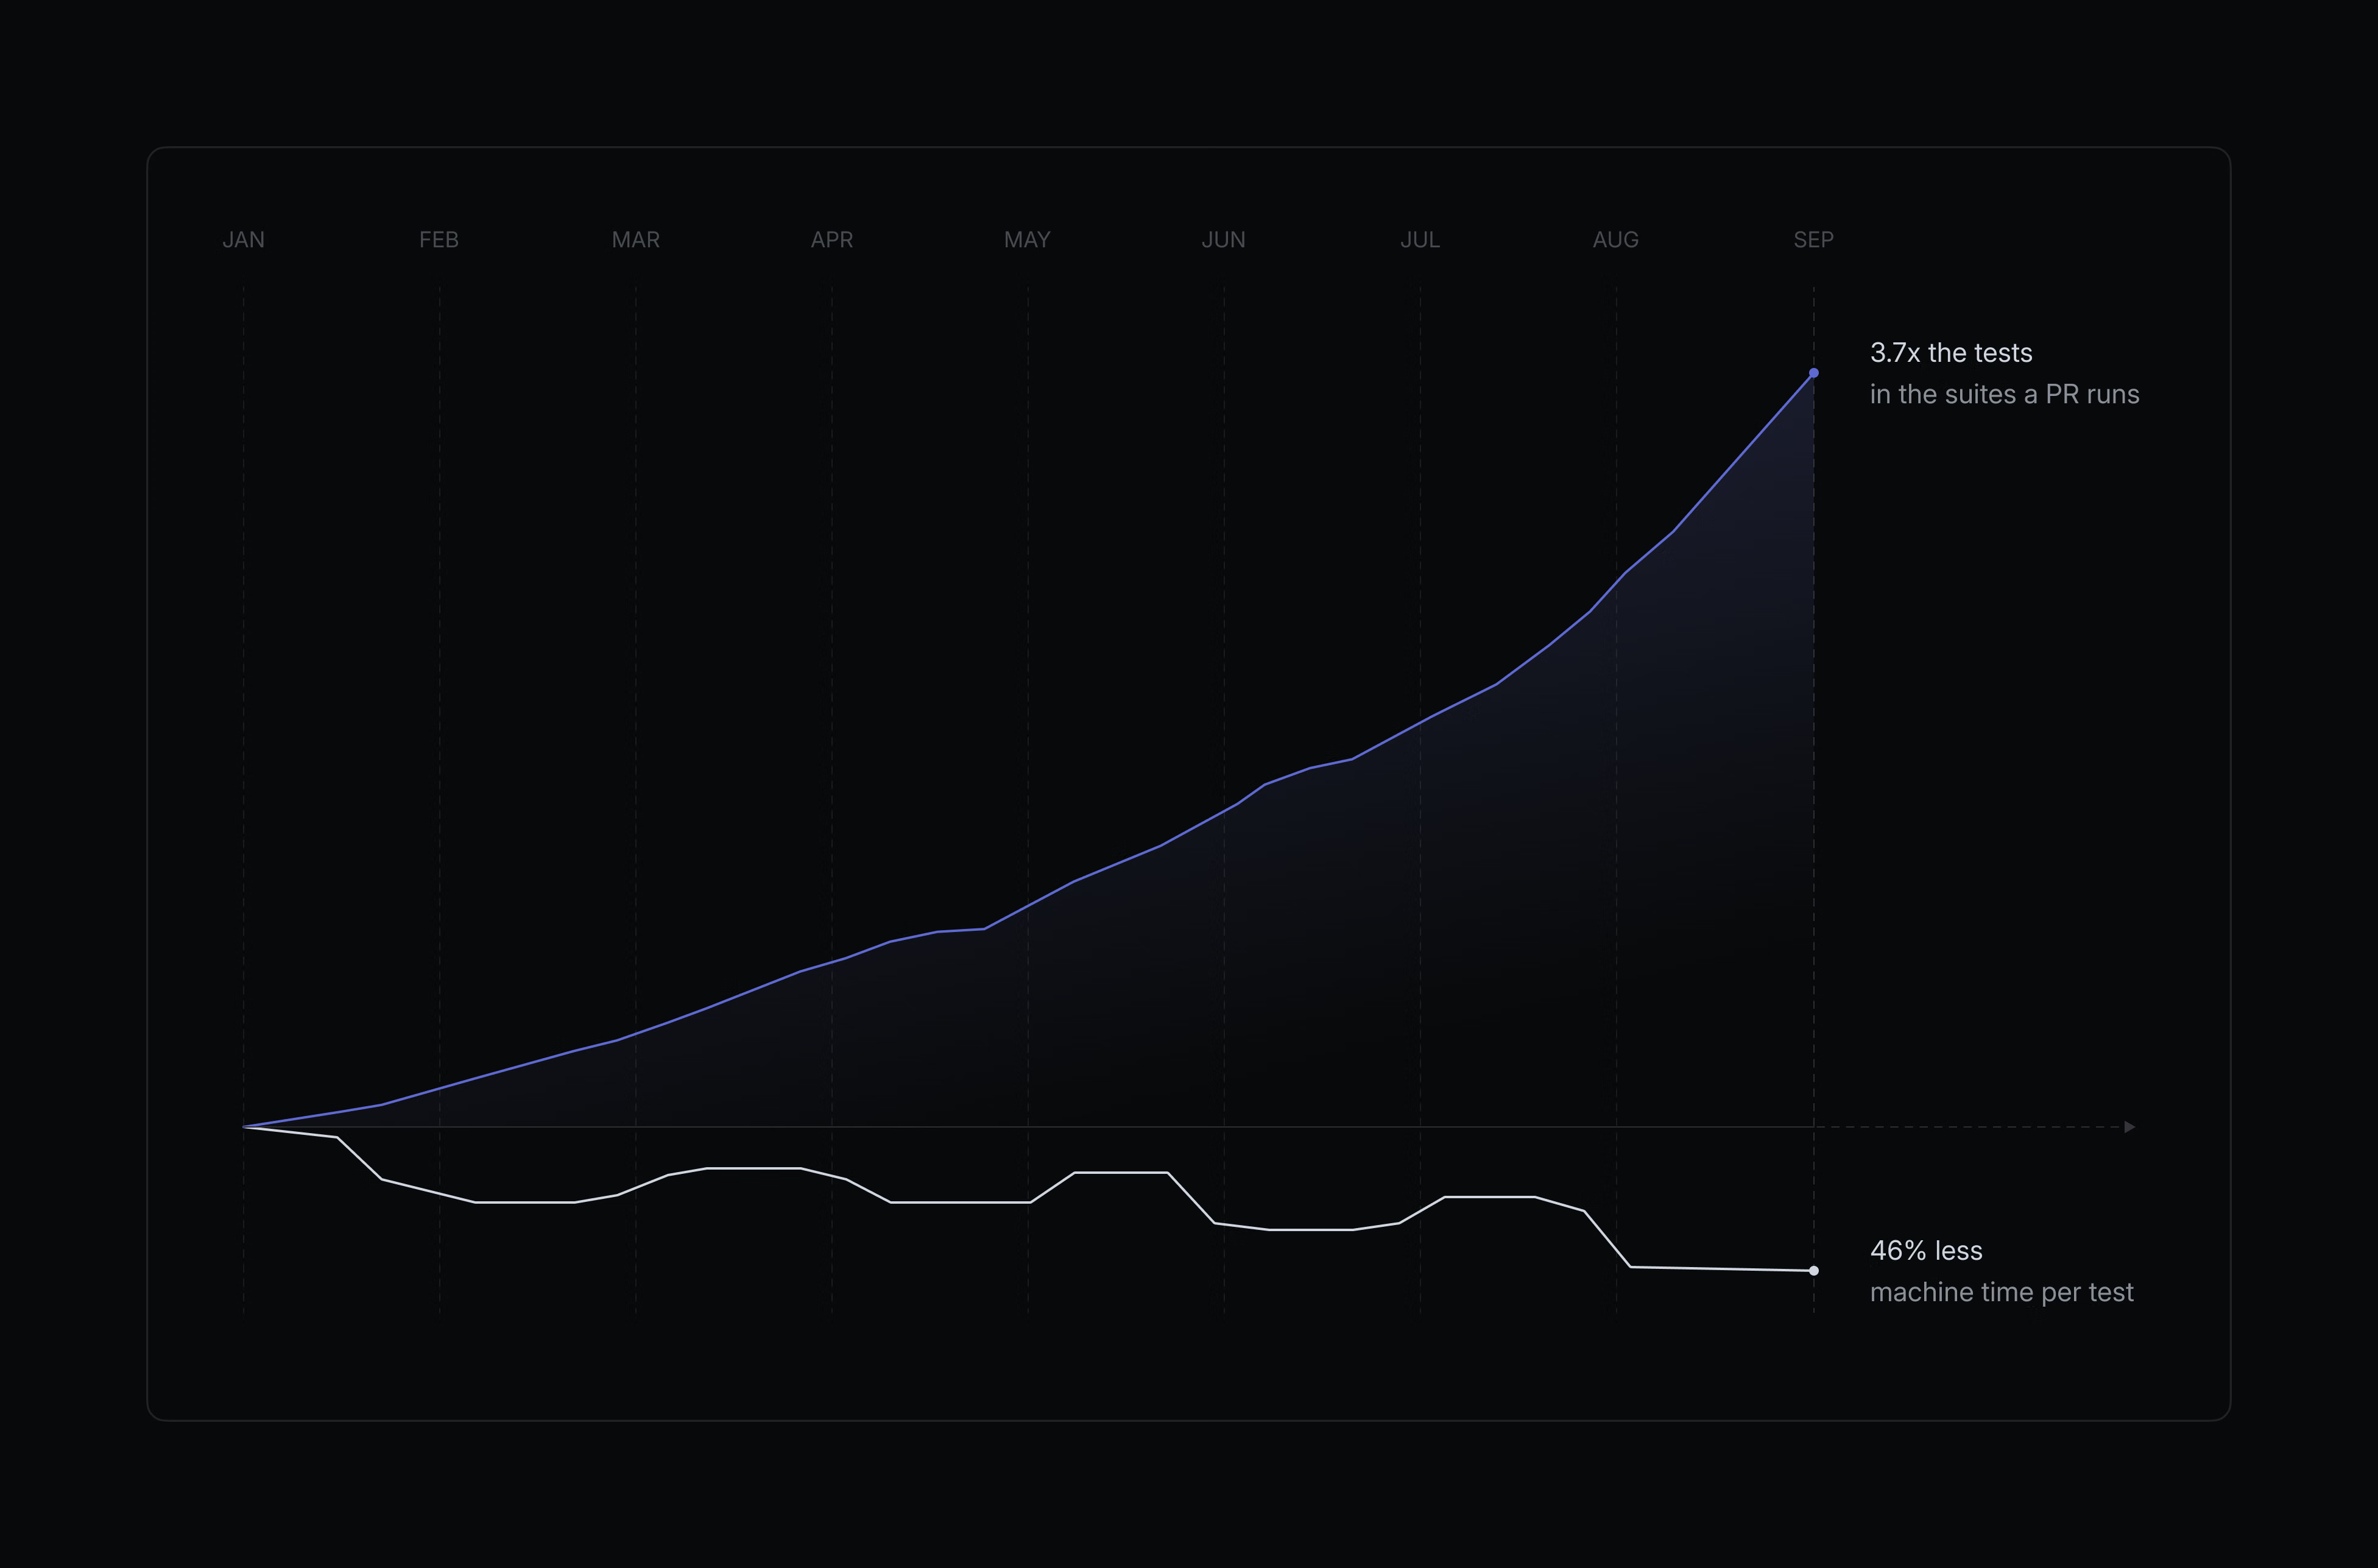
为了让 Linear 的 CI 性能更好,我们优化了两个指标:PR 在 CI 上等待的时间,以及它消耗的运行器(runner)时间。尽管从年初至今我们的测试套件规模几乎翻了两番,我们仍把 PR 的等待时间从 6 分钟以上降到了刚过 5 分钟,同时让每个测试消耗的运行器时间大约减半。

总体而言,我们从四个方面改进了 CI:
- 升级基础设施和工具链
- 优化卡在其他工作前面的任务
- 减少重复的环境准备
- 让测试执行更高效
Linear 的代码库以 TypeScript 为主,但其中许多优化适用于各种语言和工具链。
升级基础设施和工具链
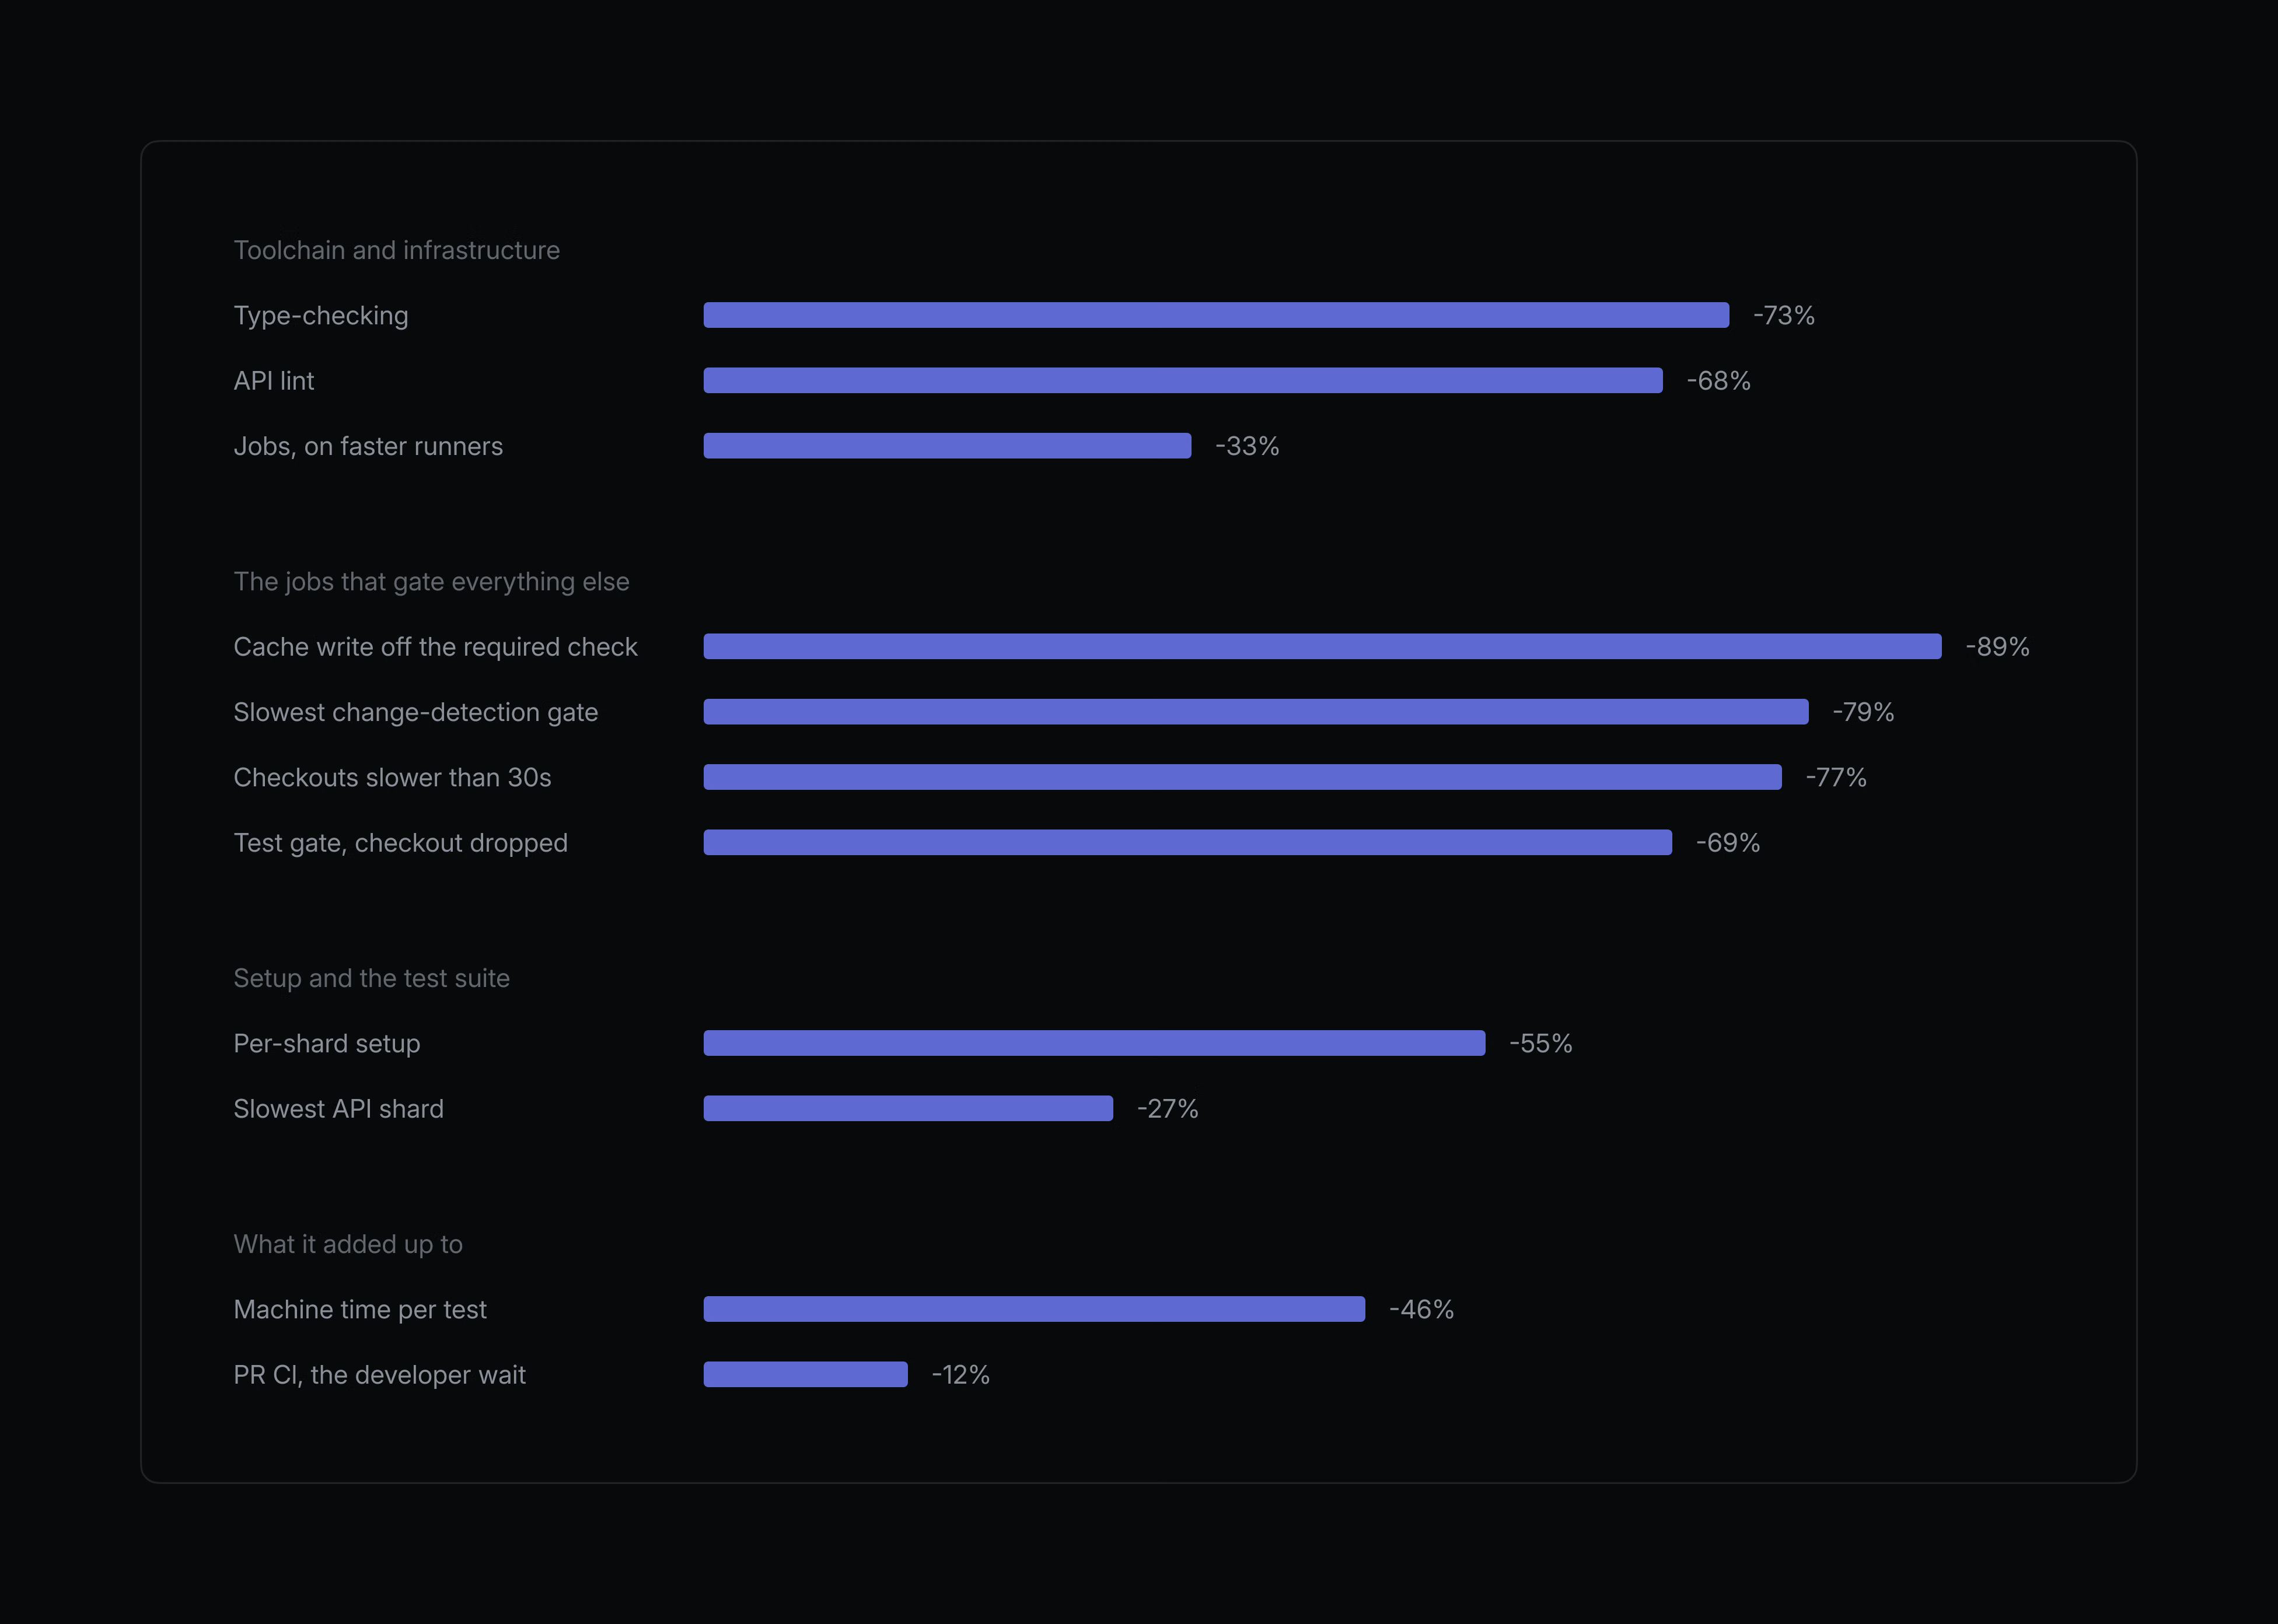
我们最早的一些收益几乎无需优化 CI 本身。我们把工作负载从 GitHub Actions 迁到了第三方运行器,后者拥有更快的 CPU、更高性能的存储和更好的缓存基础设施,同一条流水线因此跑在了更快的机器上。在切换前后各两天的同口径对比中,任务平均快了 34%,其中 tsc 等部分工作负载缩短了 52%。
另外,工具链的现代化也带来了回报。切换到原生 TypeScript 编译器 tsgo 之后,tsc 检查的每周中位耗时缩短了 73%,幅度大到类型检查不再是瓶颈。
不依赖类型检查器的 Lint
Lint 是另一个早期目标。我们有少量自定义 lint 规则依赖 TypeScript 的类型信息,用来强制执行某项限制或应用自动修复。这意味着每次运行 lint,都必须先构建完整的类型图,才能评估这些规则,使 lint 成为我们内存消耗最大的 CI 任务之一。
我们把这些规则改写为基于抽象语法树(AST)的静态分析,在没有类型信息的情况下识别类函数结构和守卫(guard)模式。这样 ESLint 就可以完全去掉对 TypeScript 的依赖,API 的 lint 时间缩短了 68%,整个仓库的 lint 时间缩短了 55%,内存占用也大幅下降。
去掉对类型信息的依赖,也让我们后来迁移到 Oxlint 容易得多,因为只依赖语法的规则很容易移植。Oxlint 本身也减少了 lint 所消耗的 CI 运行器分钟数。
优化卡在其他工作前面的任务
在底层基础设施和各项检查都变快之后,我们把视野拉远,把 CI 当作一个系统来审视。这让我们注意到了排在所有其他任务之前的那些小任务。每次运行都先要检查 PR 改动了哪些路径,以及对于相同的输入,这些测试是否已经通过。我们在任务级别用这些检查做门控,这样被跳过的工作就永远不会占用运行器,但这也让它们直接落在了关键路径上。八个 API 测试分片在这些检查完成之前都无法启动,所以哪怕是很小的延迟也会被不成比例地放大。
每个任务只拉取它需要的内容
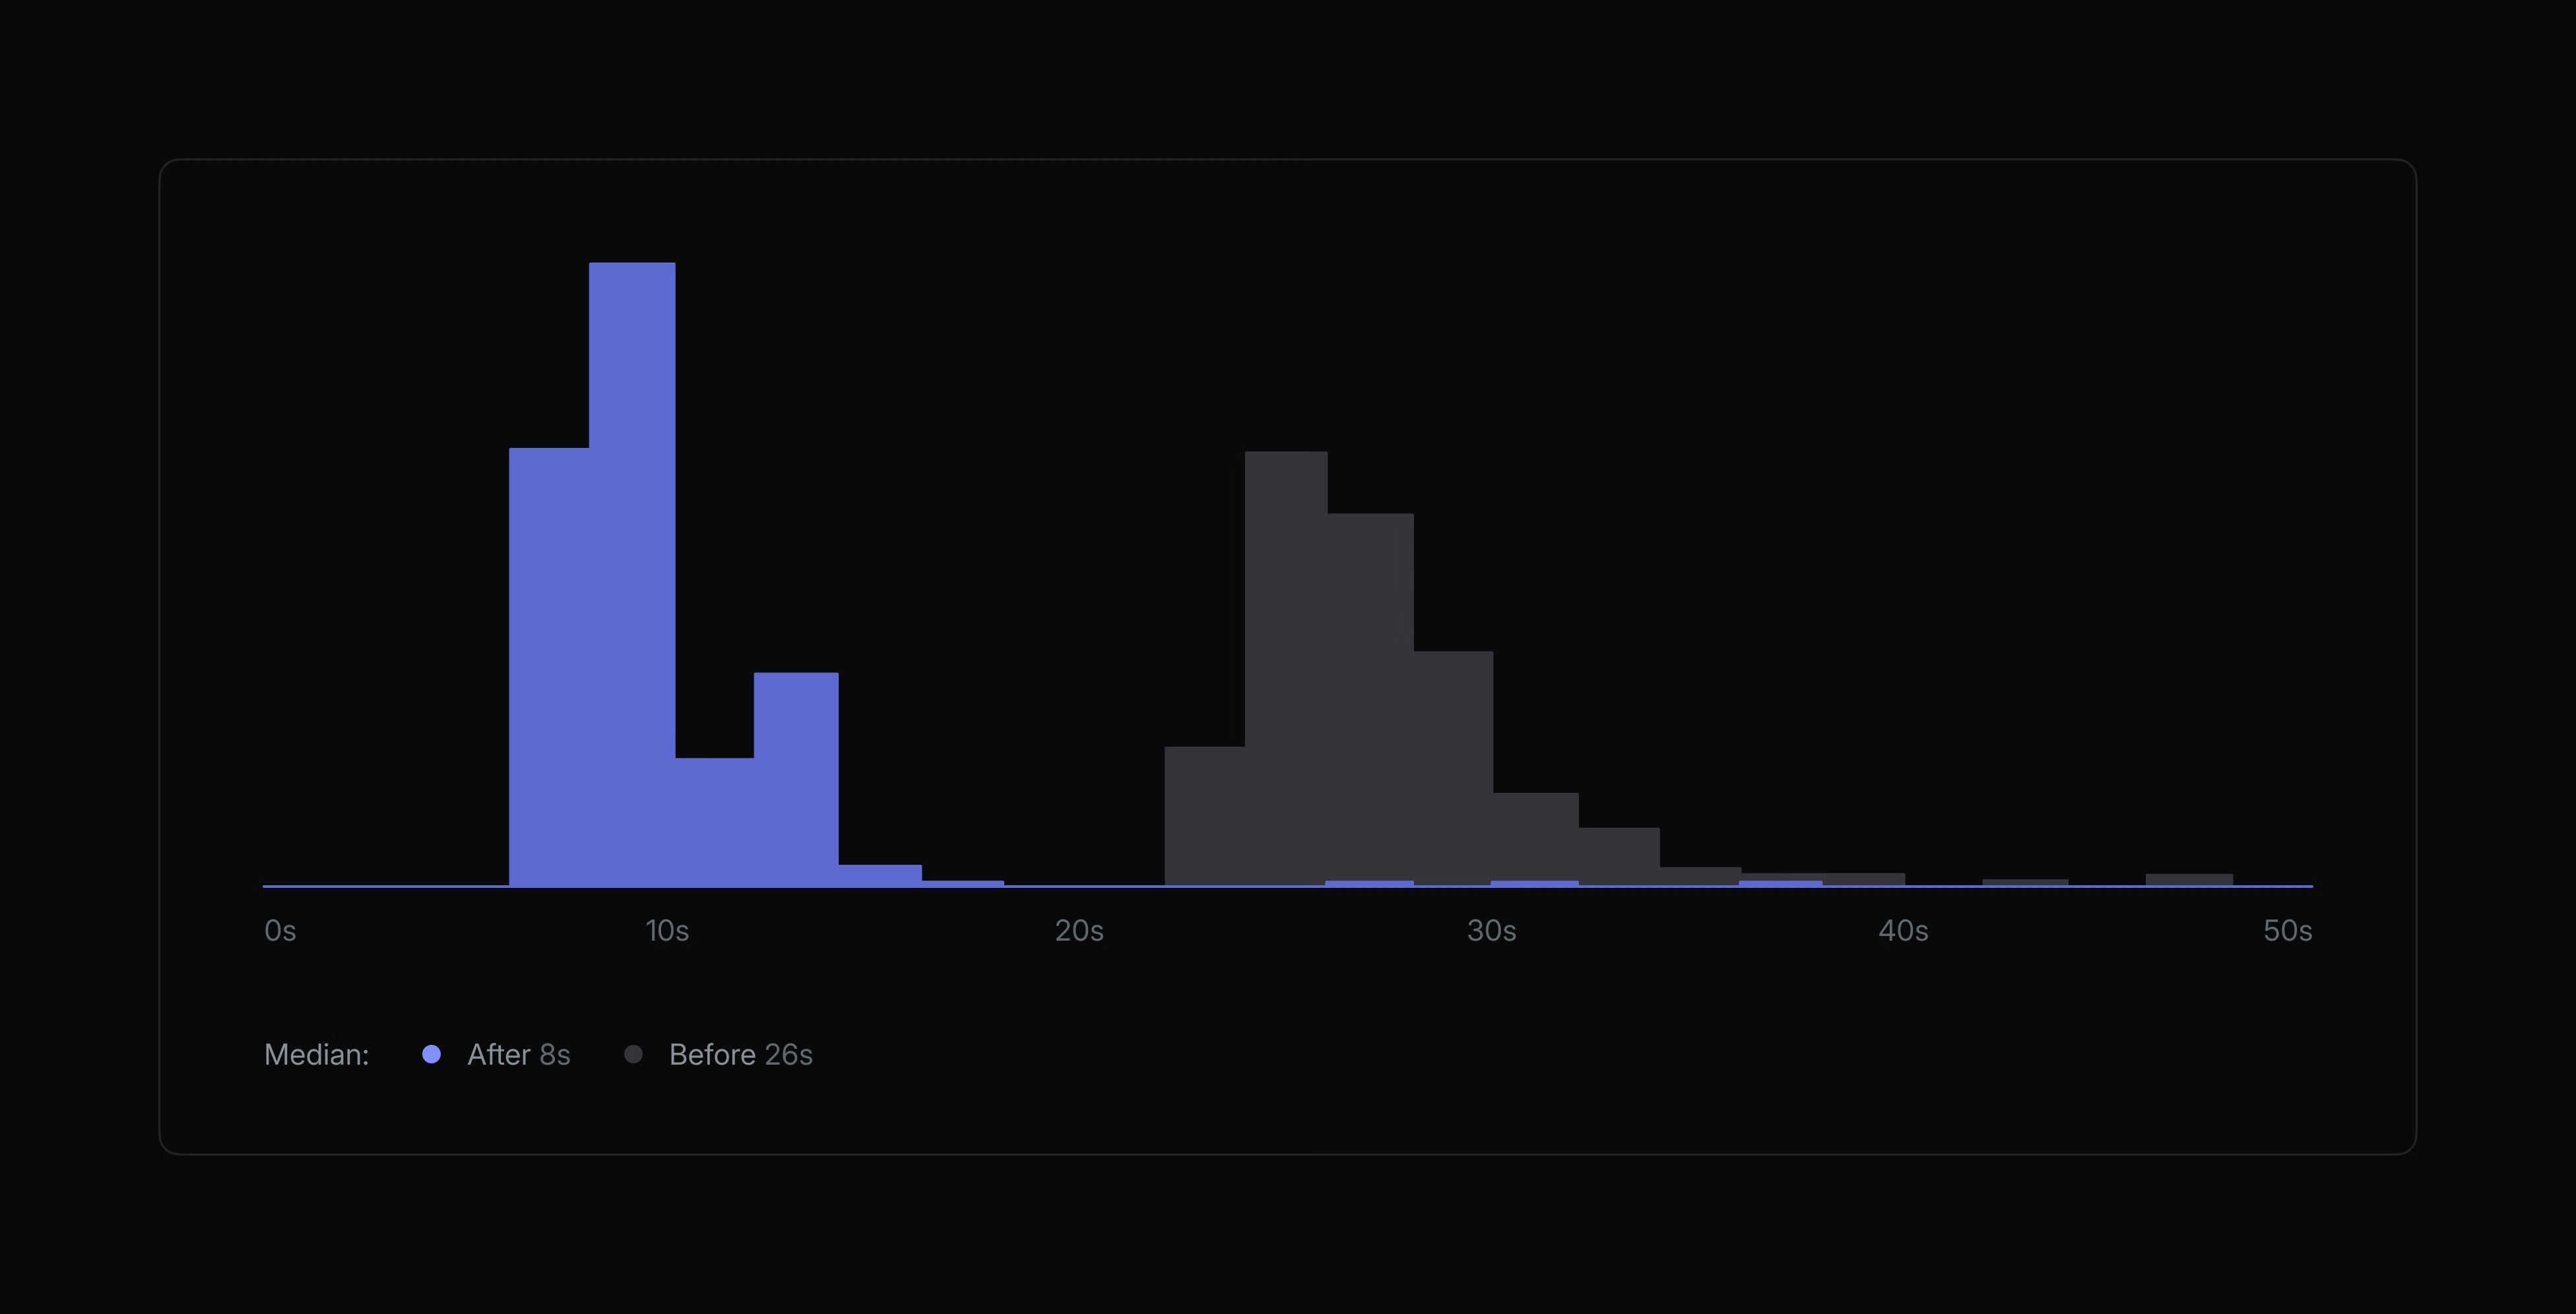
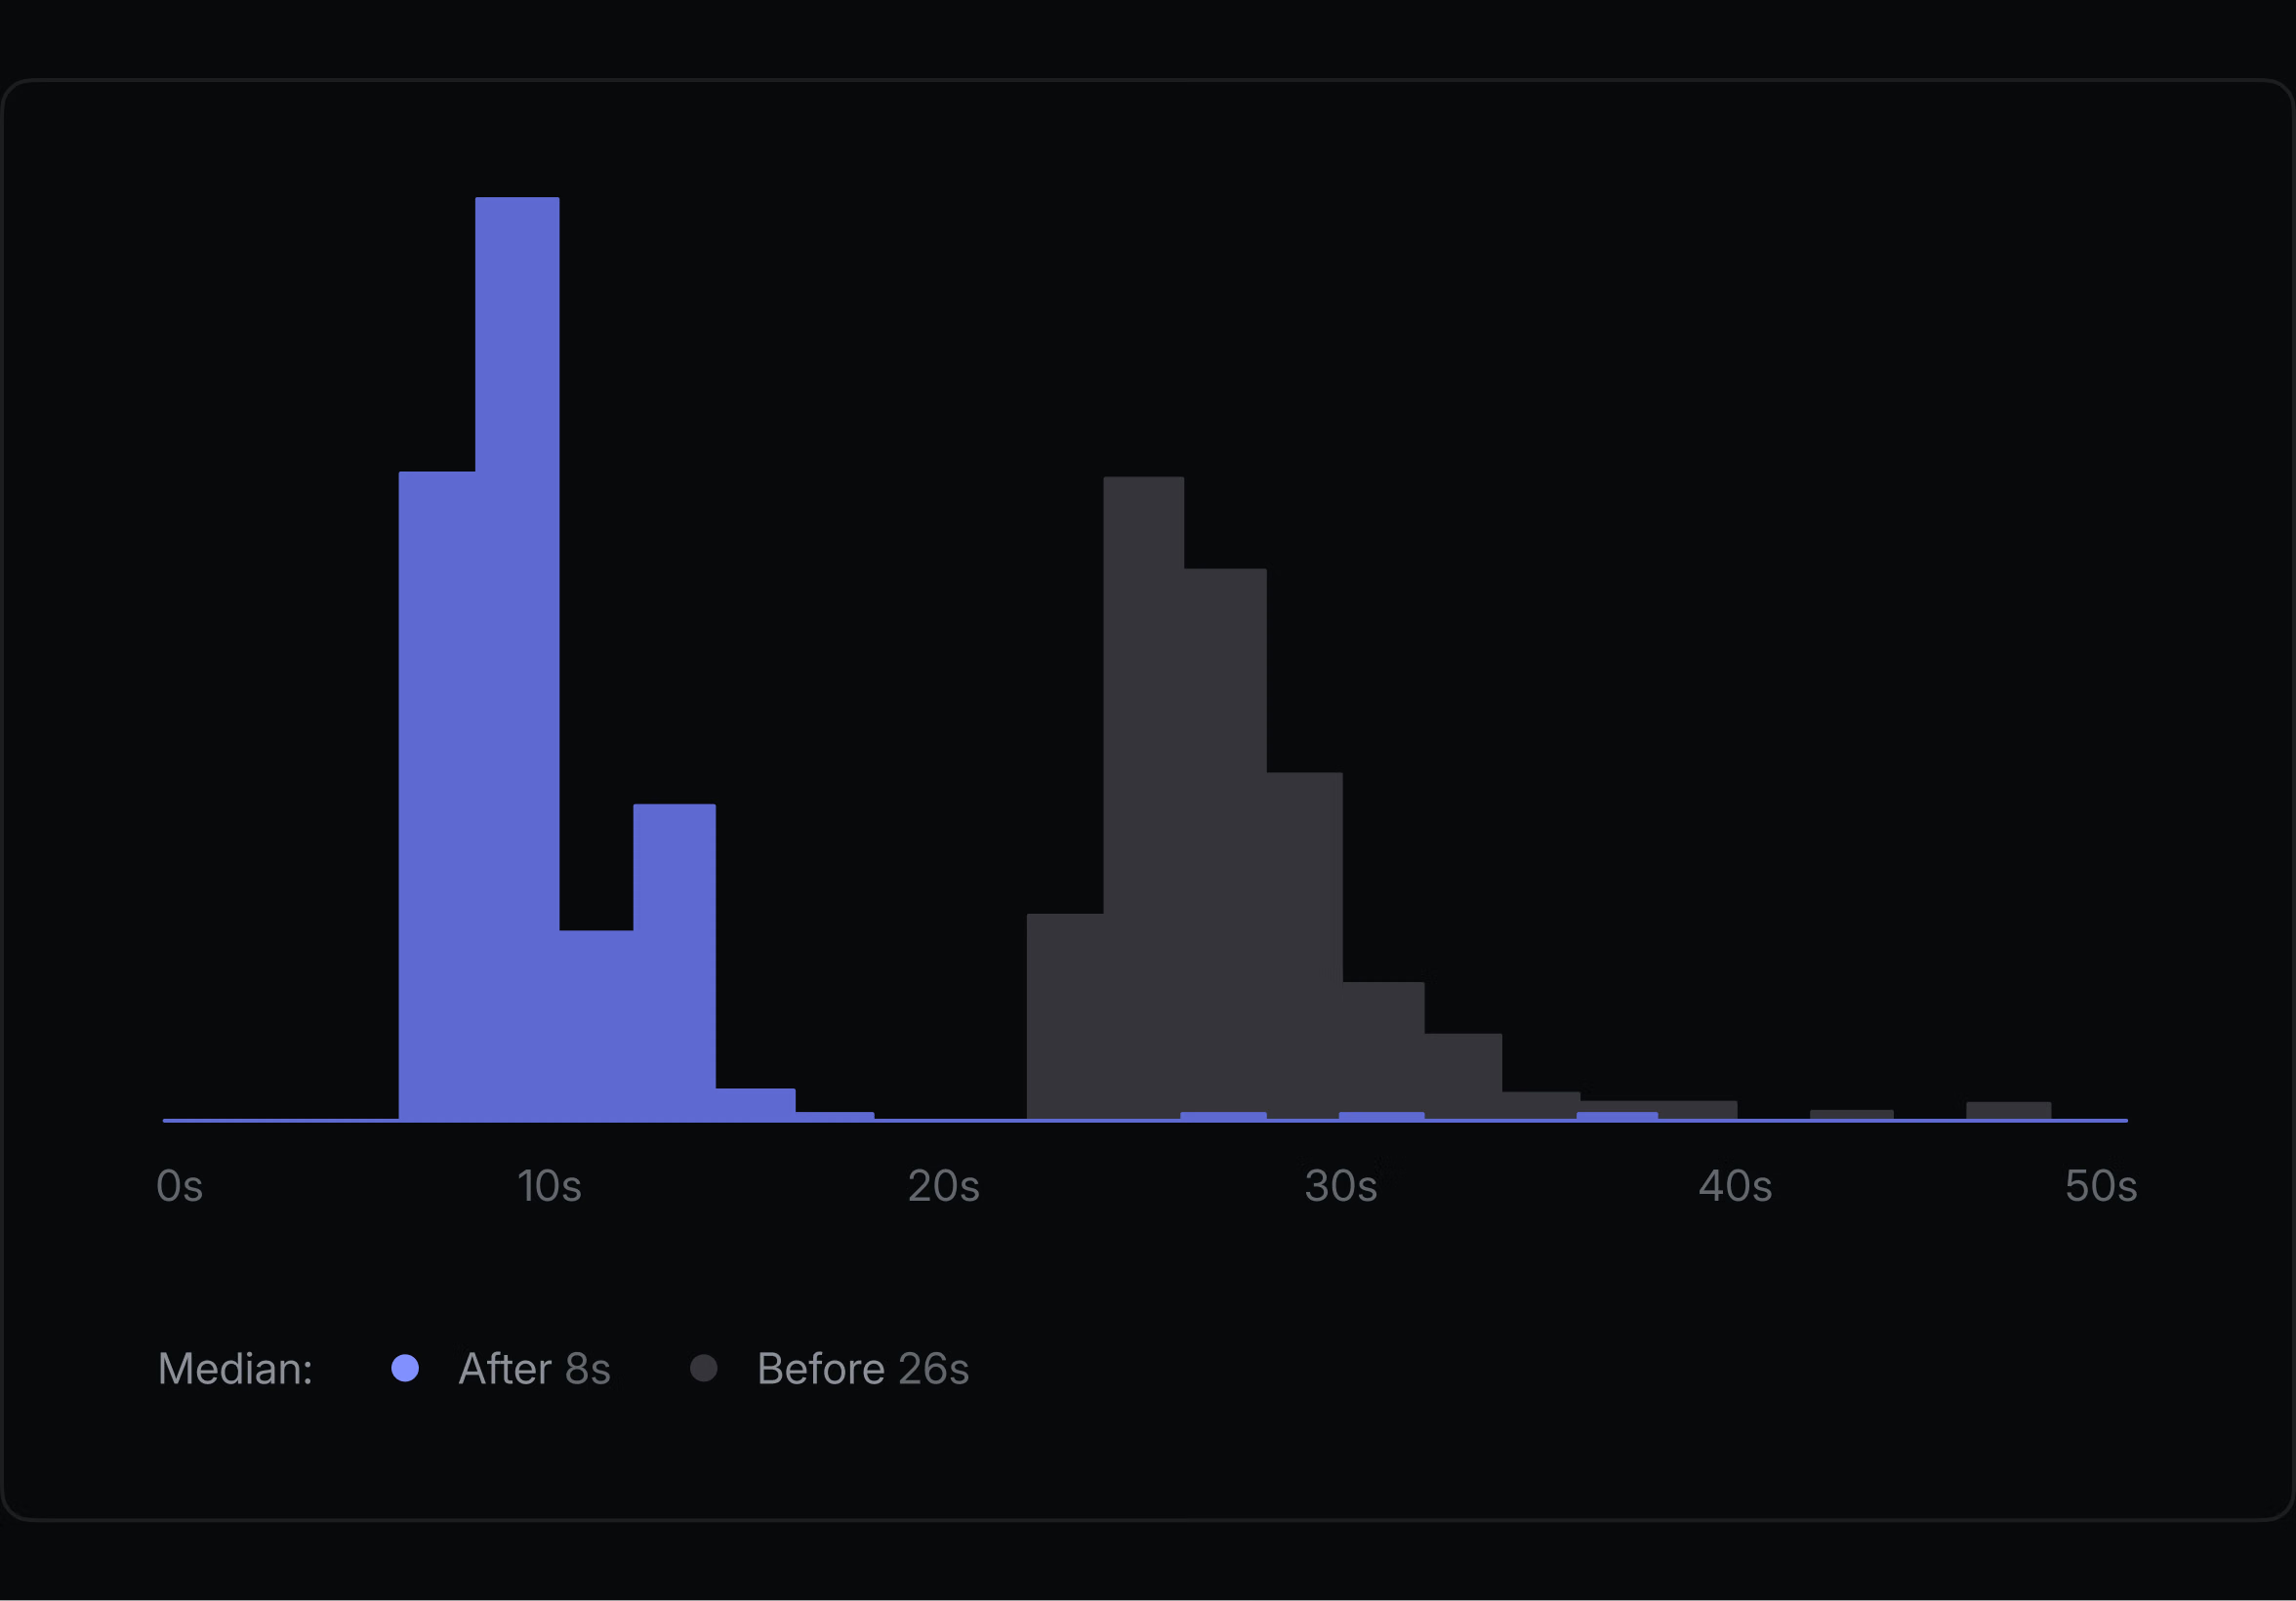
我们的多个工作流都以一个变更检测任务开头,由它决定接下来运行什么。例如,它会检查某次 diff 是否包含数据库迁移,并输出一个信号,用来调度相关的数据库 CI 检查。这些任务原本会检出完整的工作树,而实际上它们只需要其中很小的一部分。我们限制了拉取深度,使其中最慢的一个门控从 94 秒降到 20 秒;对于根本不需要工作树的任务,我们彻底去掉了 checkout,这些任务的耗时从 27 秒降到 7 秒。对于提交推送和合并队列事件,由于确实需要对路径做 diff,我们发现使用稀疏、无 blob 且历史有限的检出就足够了,又节省了 11 秒左右。
让 checkout 更有韧性
更换底层运行器基础设施之后,我们注意到任务中的 checkout(使用 actions/checkout)耗时变长,有时还会卡住。由于第三方运行器位于 GitHub 的网络之外,它们要靠直连 IP 链路来访问 GitHub。服务商把卡顿追溯到这条链路上的间歇性劣化。我们的多个工作流都以 checkout 开头,因此一次卡住的拉取就可能拖慢整个 CI 运行。
为了应对网络的不稳定,我们用自己编写的复合 action 取代了 actions/checkout:它带退避地重试,并设置 GIT_HTTP_LOW_SPEED_LIMIT 和 GIT_HTTP_LOW_SPEED_TIME,使卡住的连接在大约 30 秒后中止,而不是一直挂着;它还使用了 checkout 缓存,把一个持久的 git 镜像保存在粘性磁盘(sticky disk)上。结果是,关键路径上的任务因等待 checkout 完成而空转的情况大大减少。
尽量减少关键路径上的内容
并非关键路径上的每个任务都必须待在那里。我们过去在合并前的最后一项检查中写入缓存标记,这意味着一个 PR 即使测试已经通过,也可能在合并队列里继续等着。我们把这次写入挪到了一个在测试分片完成后运行、但不对任何事情做门控的任务中,使每个 API PR 和每次合并队列入队的合并路径都缩短了 42 秒。
这些改动合在一起,使缓存未命中时 API PR 的必需检查缩短了大约一分钟,同时也减少了运行器的启动次数。
减少重复的环境准备
接下来,我们转向每个任务都要重复支付的准备成本,比如启动运行器、安装包、准备构建依赖。这些开销意味着,一个只做几秒有效工作的任务,最终可能消耗整整几分钟的基础设施时间。为了解决这个问题,我们采取了几个步骤:
把共享依赖预装进 CI 镜像
我们的每个 API 测试分片,每次运行都要花 7 到 8 秒用 apt 安装同一个 Postgres 客户端。我们把它放进一个包含 Node 和该客户端的小型 CI 基础镜像,这样每个分片启动时环境就已经准备好了。后来我们发现,在准备阶段下载所需的原生构建头文件偶尔会卡住,于是又把这些头文件加进了镜像,缩短了长尾。
每个任务只安装它需要的依赖
Linear 的代码库是一个以 pnpm workspace 管理的 monorepo。我们的 API 测试工作流会安装整个 workspace,而实际上它只需要 API 包及其依赖。把安装范围限制在 API 包之后,pnpm install 的耗时从 44 到 73 秒降到 16 到 18 秒。我们对与 API 相邻的任务也采用了同样的做法,这些任务原本各自安装整个仓库,并上传一个后续运行几乎从不命中的依赖缓存。
重建更快时就不要缓存
我们还测试了缓存 node_modules,发现重建反而更快。缓存键依赖于一个频繁变化的锁文件,而且即使缓存命中,恢复也要大约 28 秒,相比之下,带过滤的安装只需约 7.5 秒。缓存增加了保存时间和不确定性,却没有带来任何明显的好处。
这三项改动合在一起,使每个分片的准备时间缩短了约 44%,从 110 到 140 秒降到 67 到 73 秒。
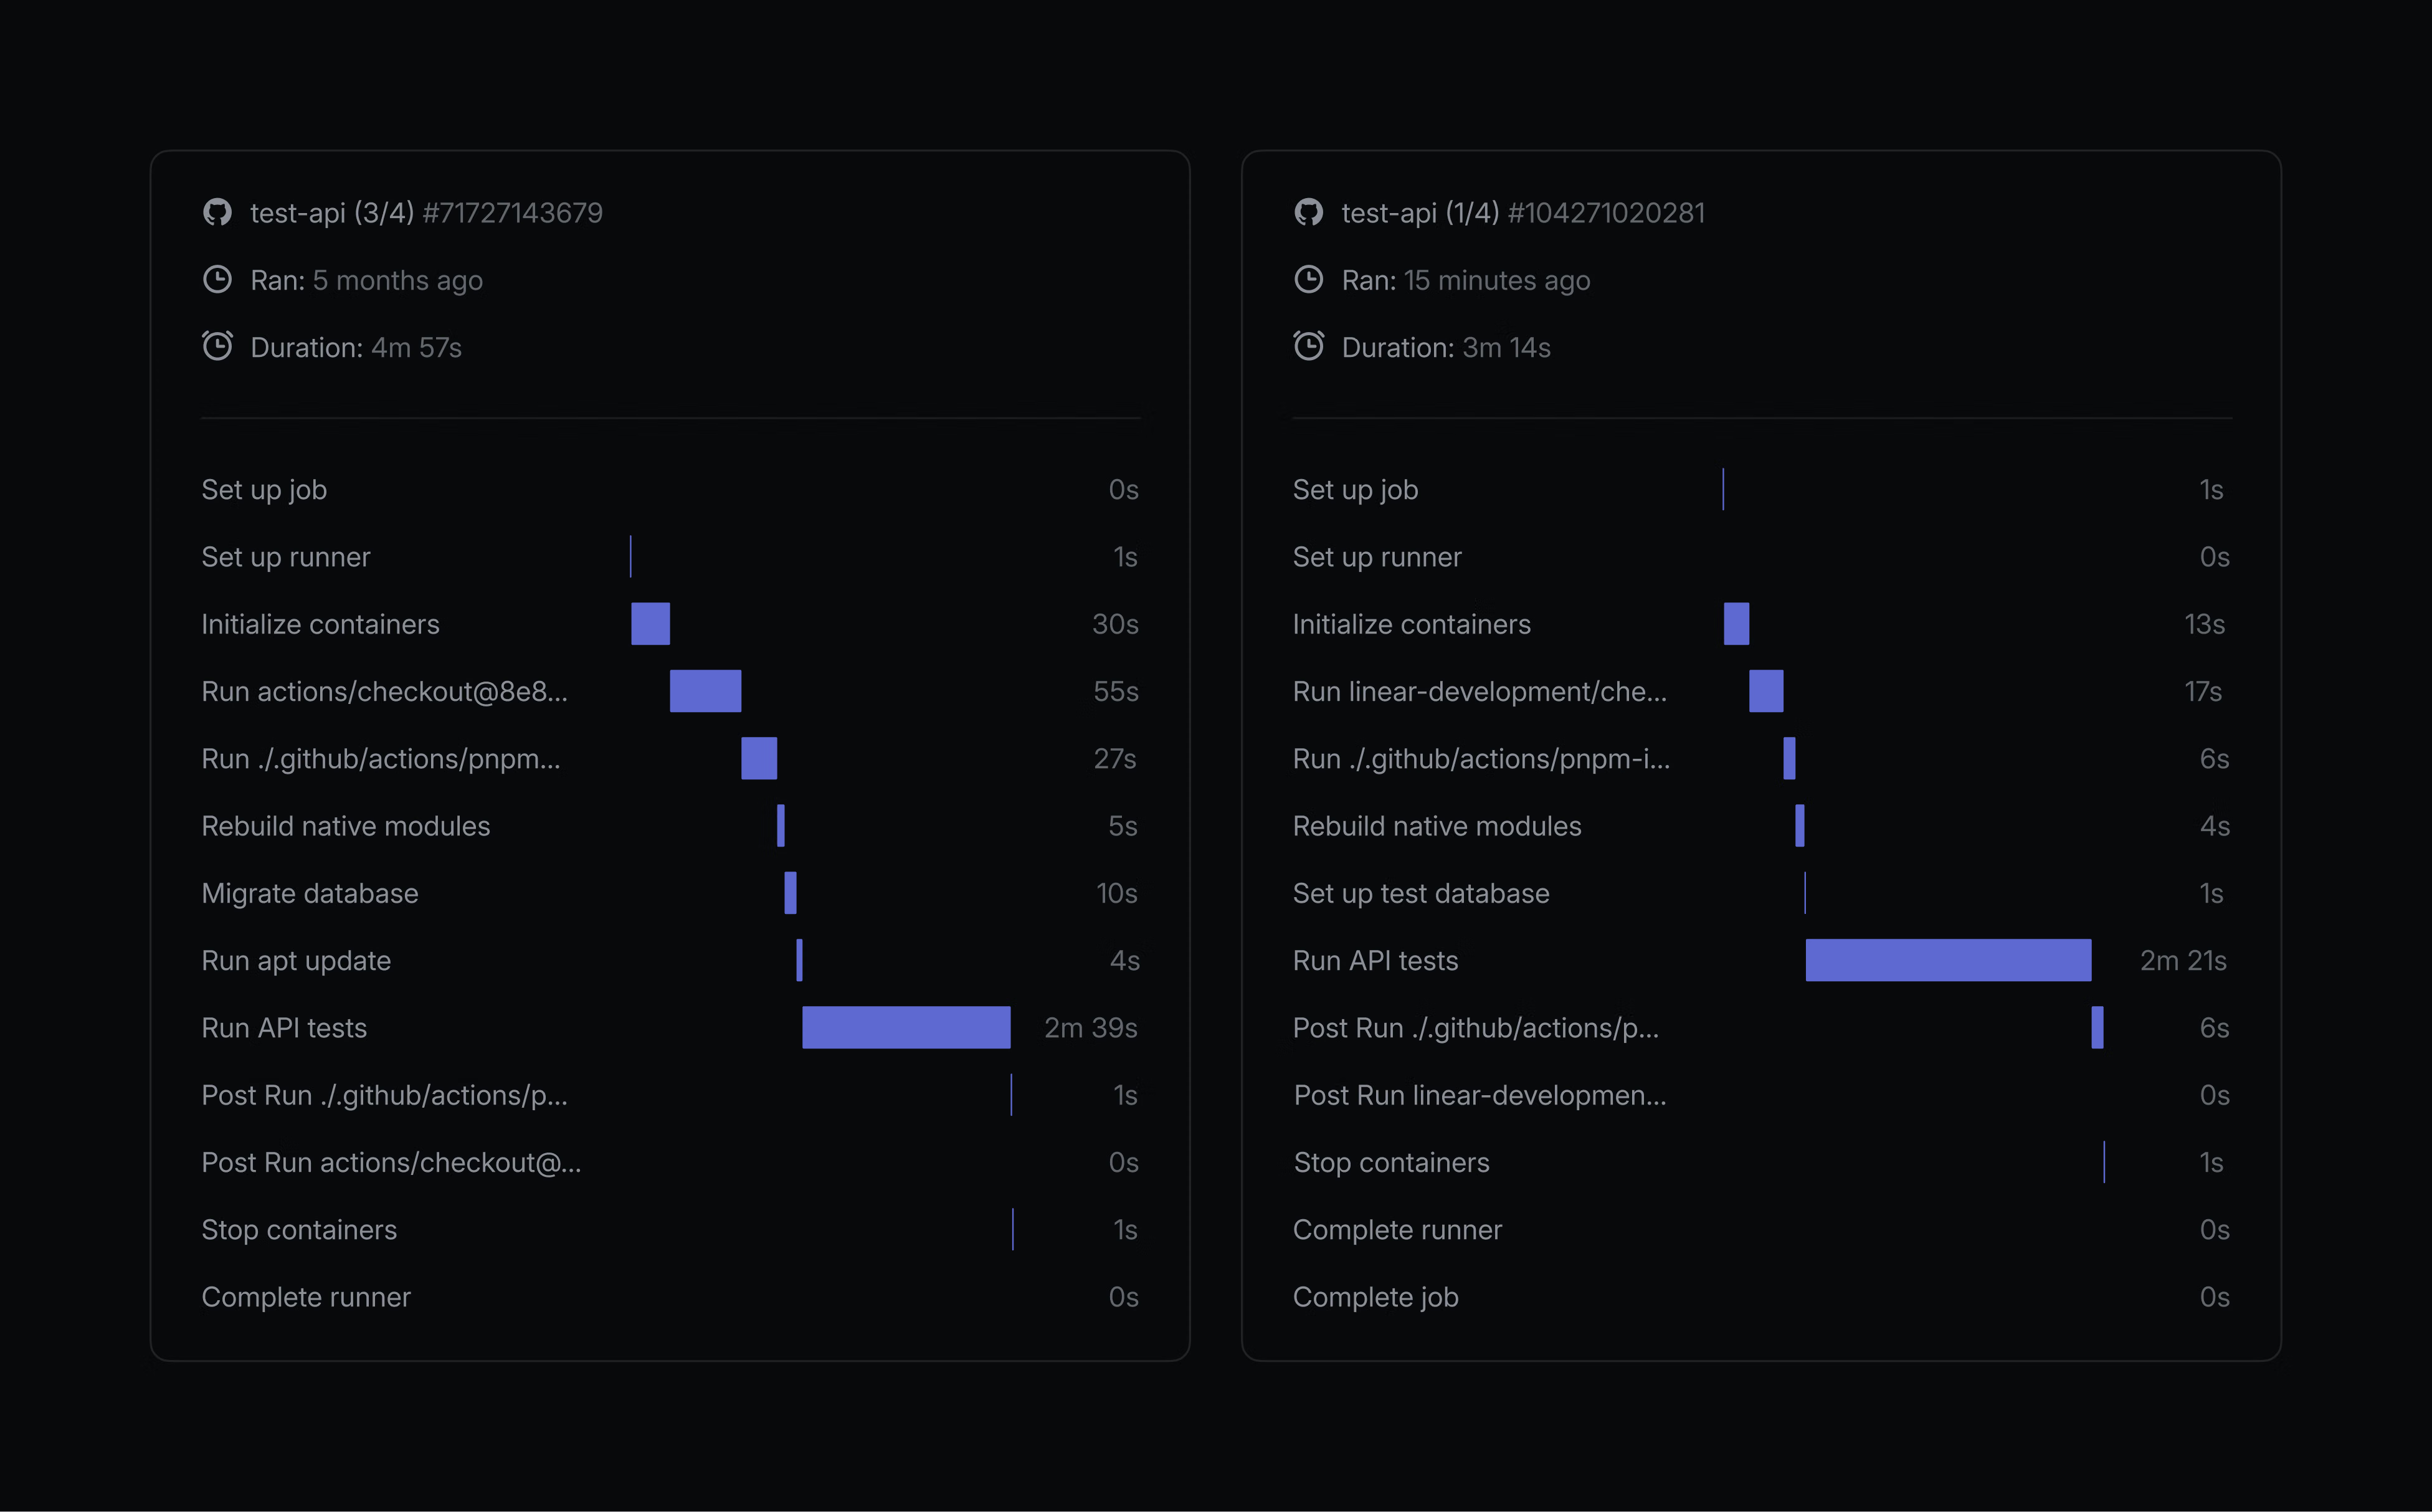
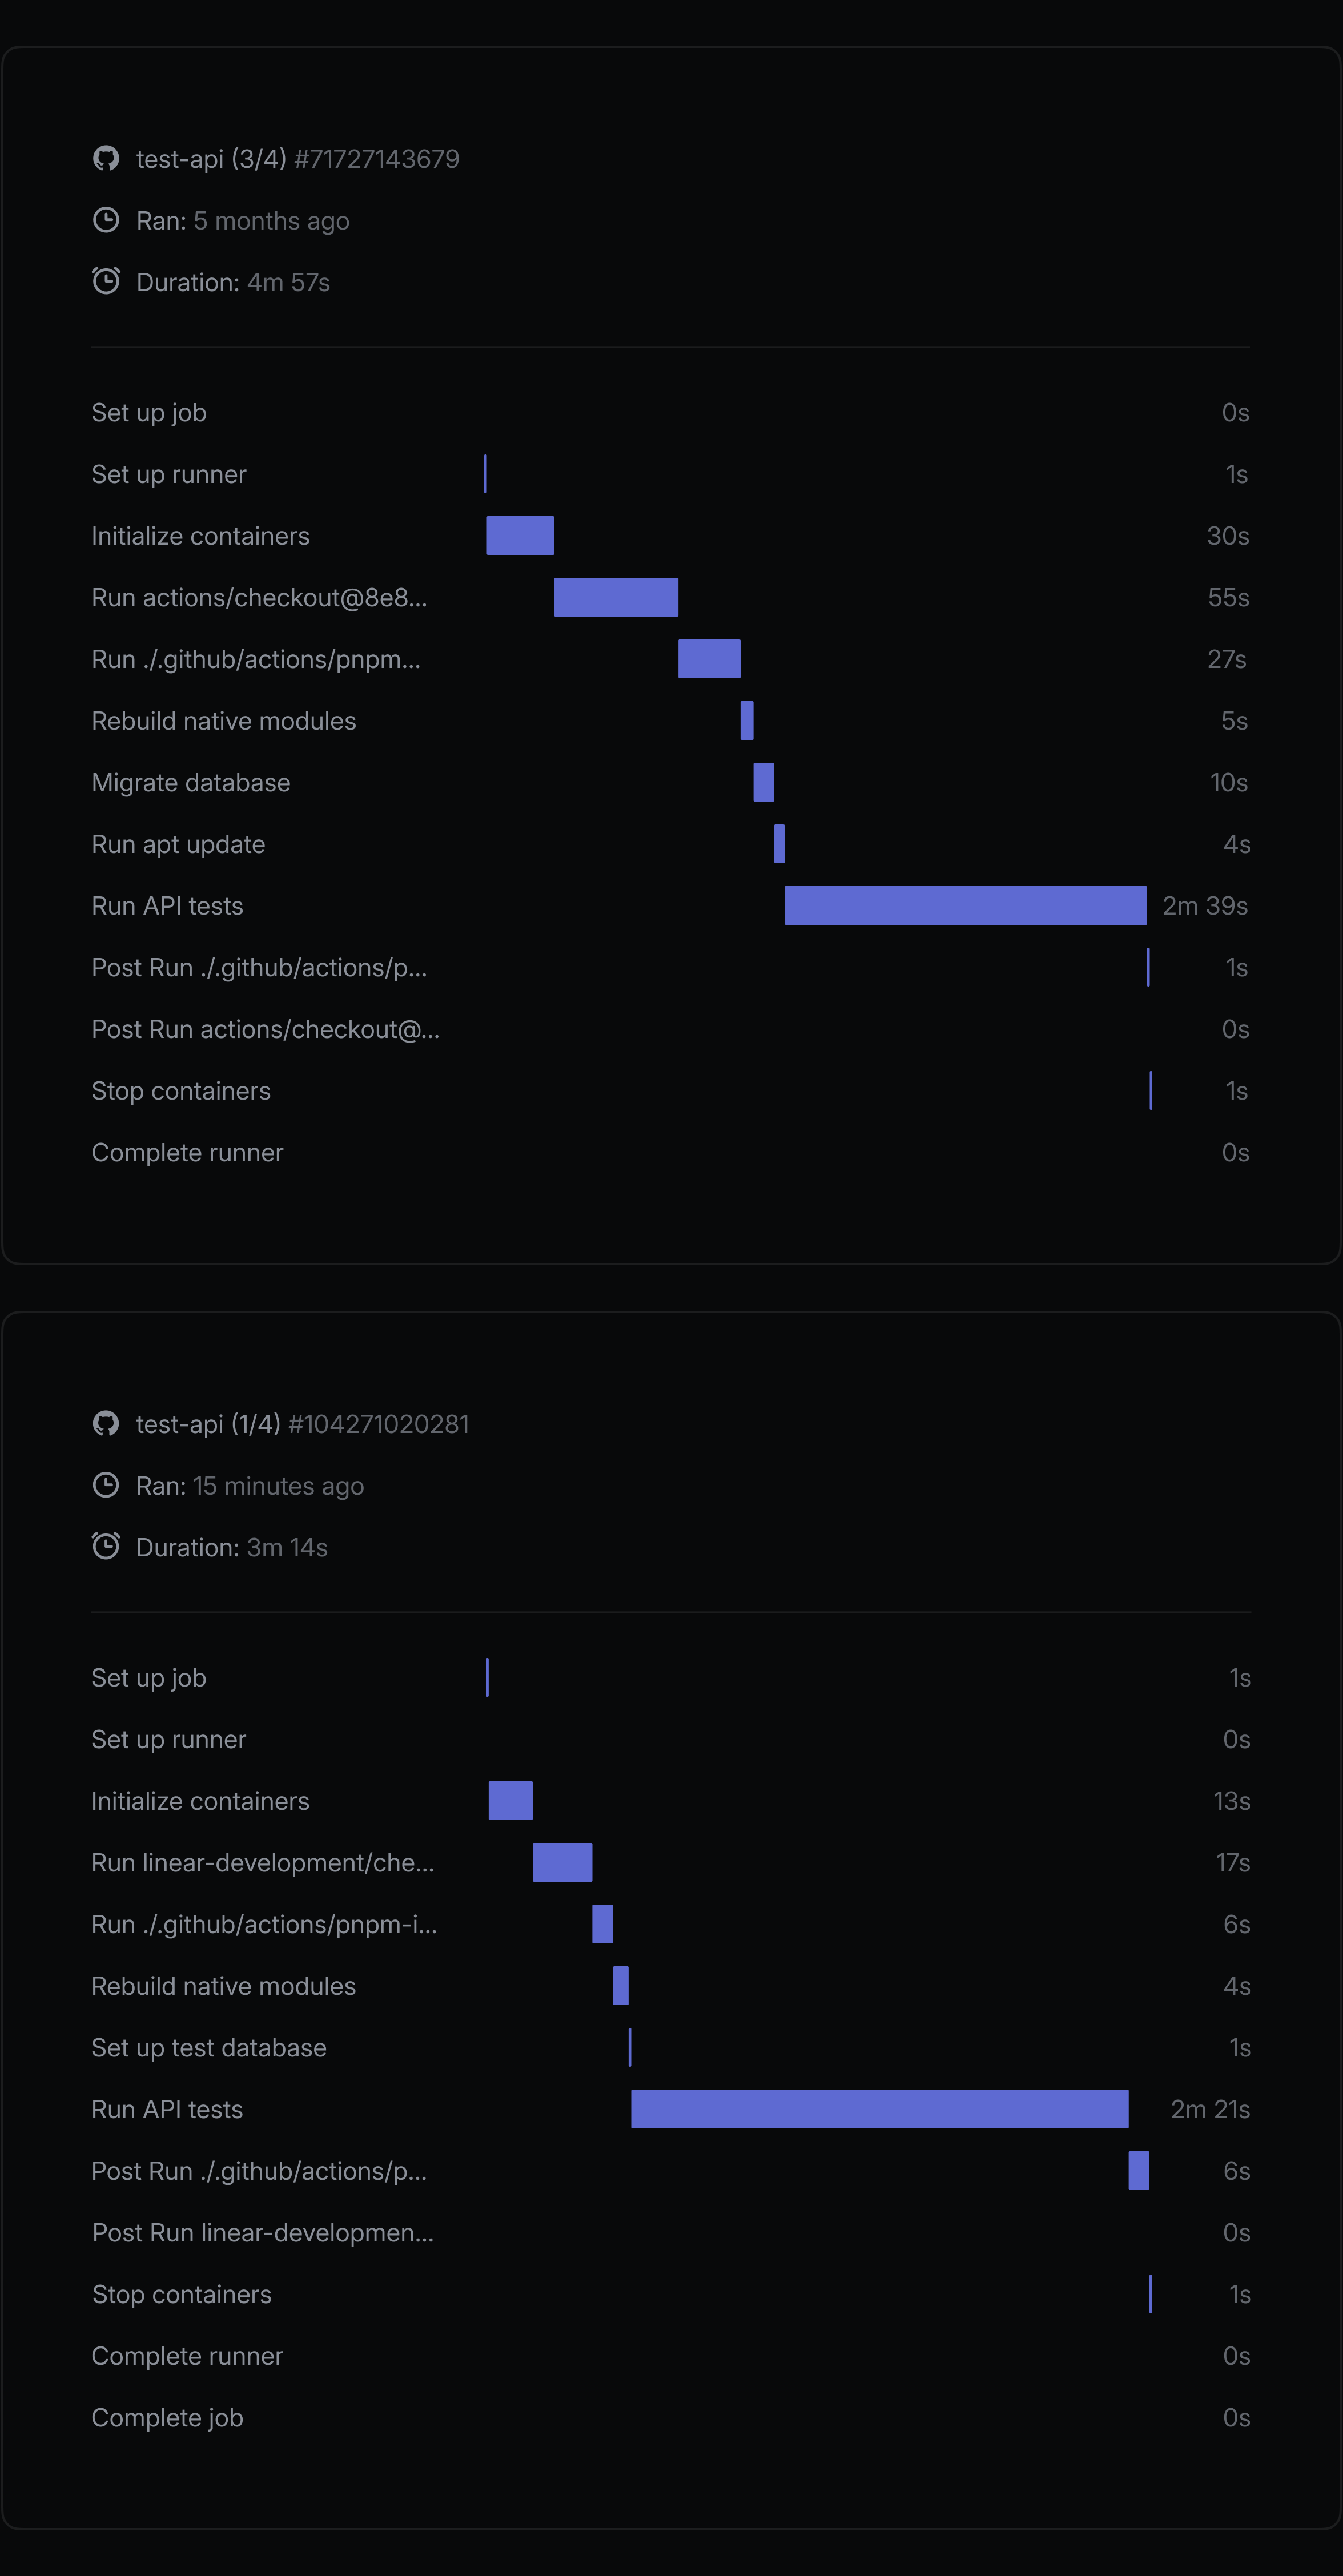
除此之外,还有其他形式的重复准备工作,是我们可以彻底避免的。
避免重放没有变化的准备步骤
有些准备工作只需要在其输入发生变化时才重复执行。例如,我们的 API 容器每次运行都会重放完整的数据库迁移历史,即使该 PR 并没有改动 schema。针对这类情况,我们改为加载一份生成好的 schema 快照和引导(bootstrap)文件,使每个容器的数据库准备时间从大约 12 秒降到 1 到 2 秒。
把短检查合并到更少的任务中
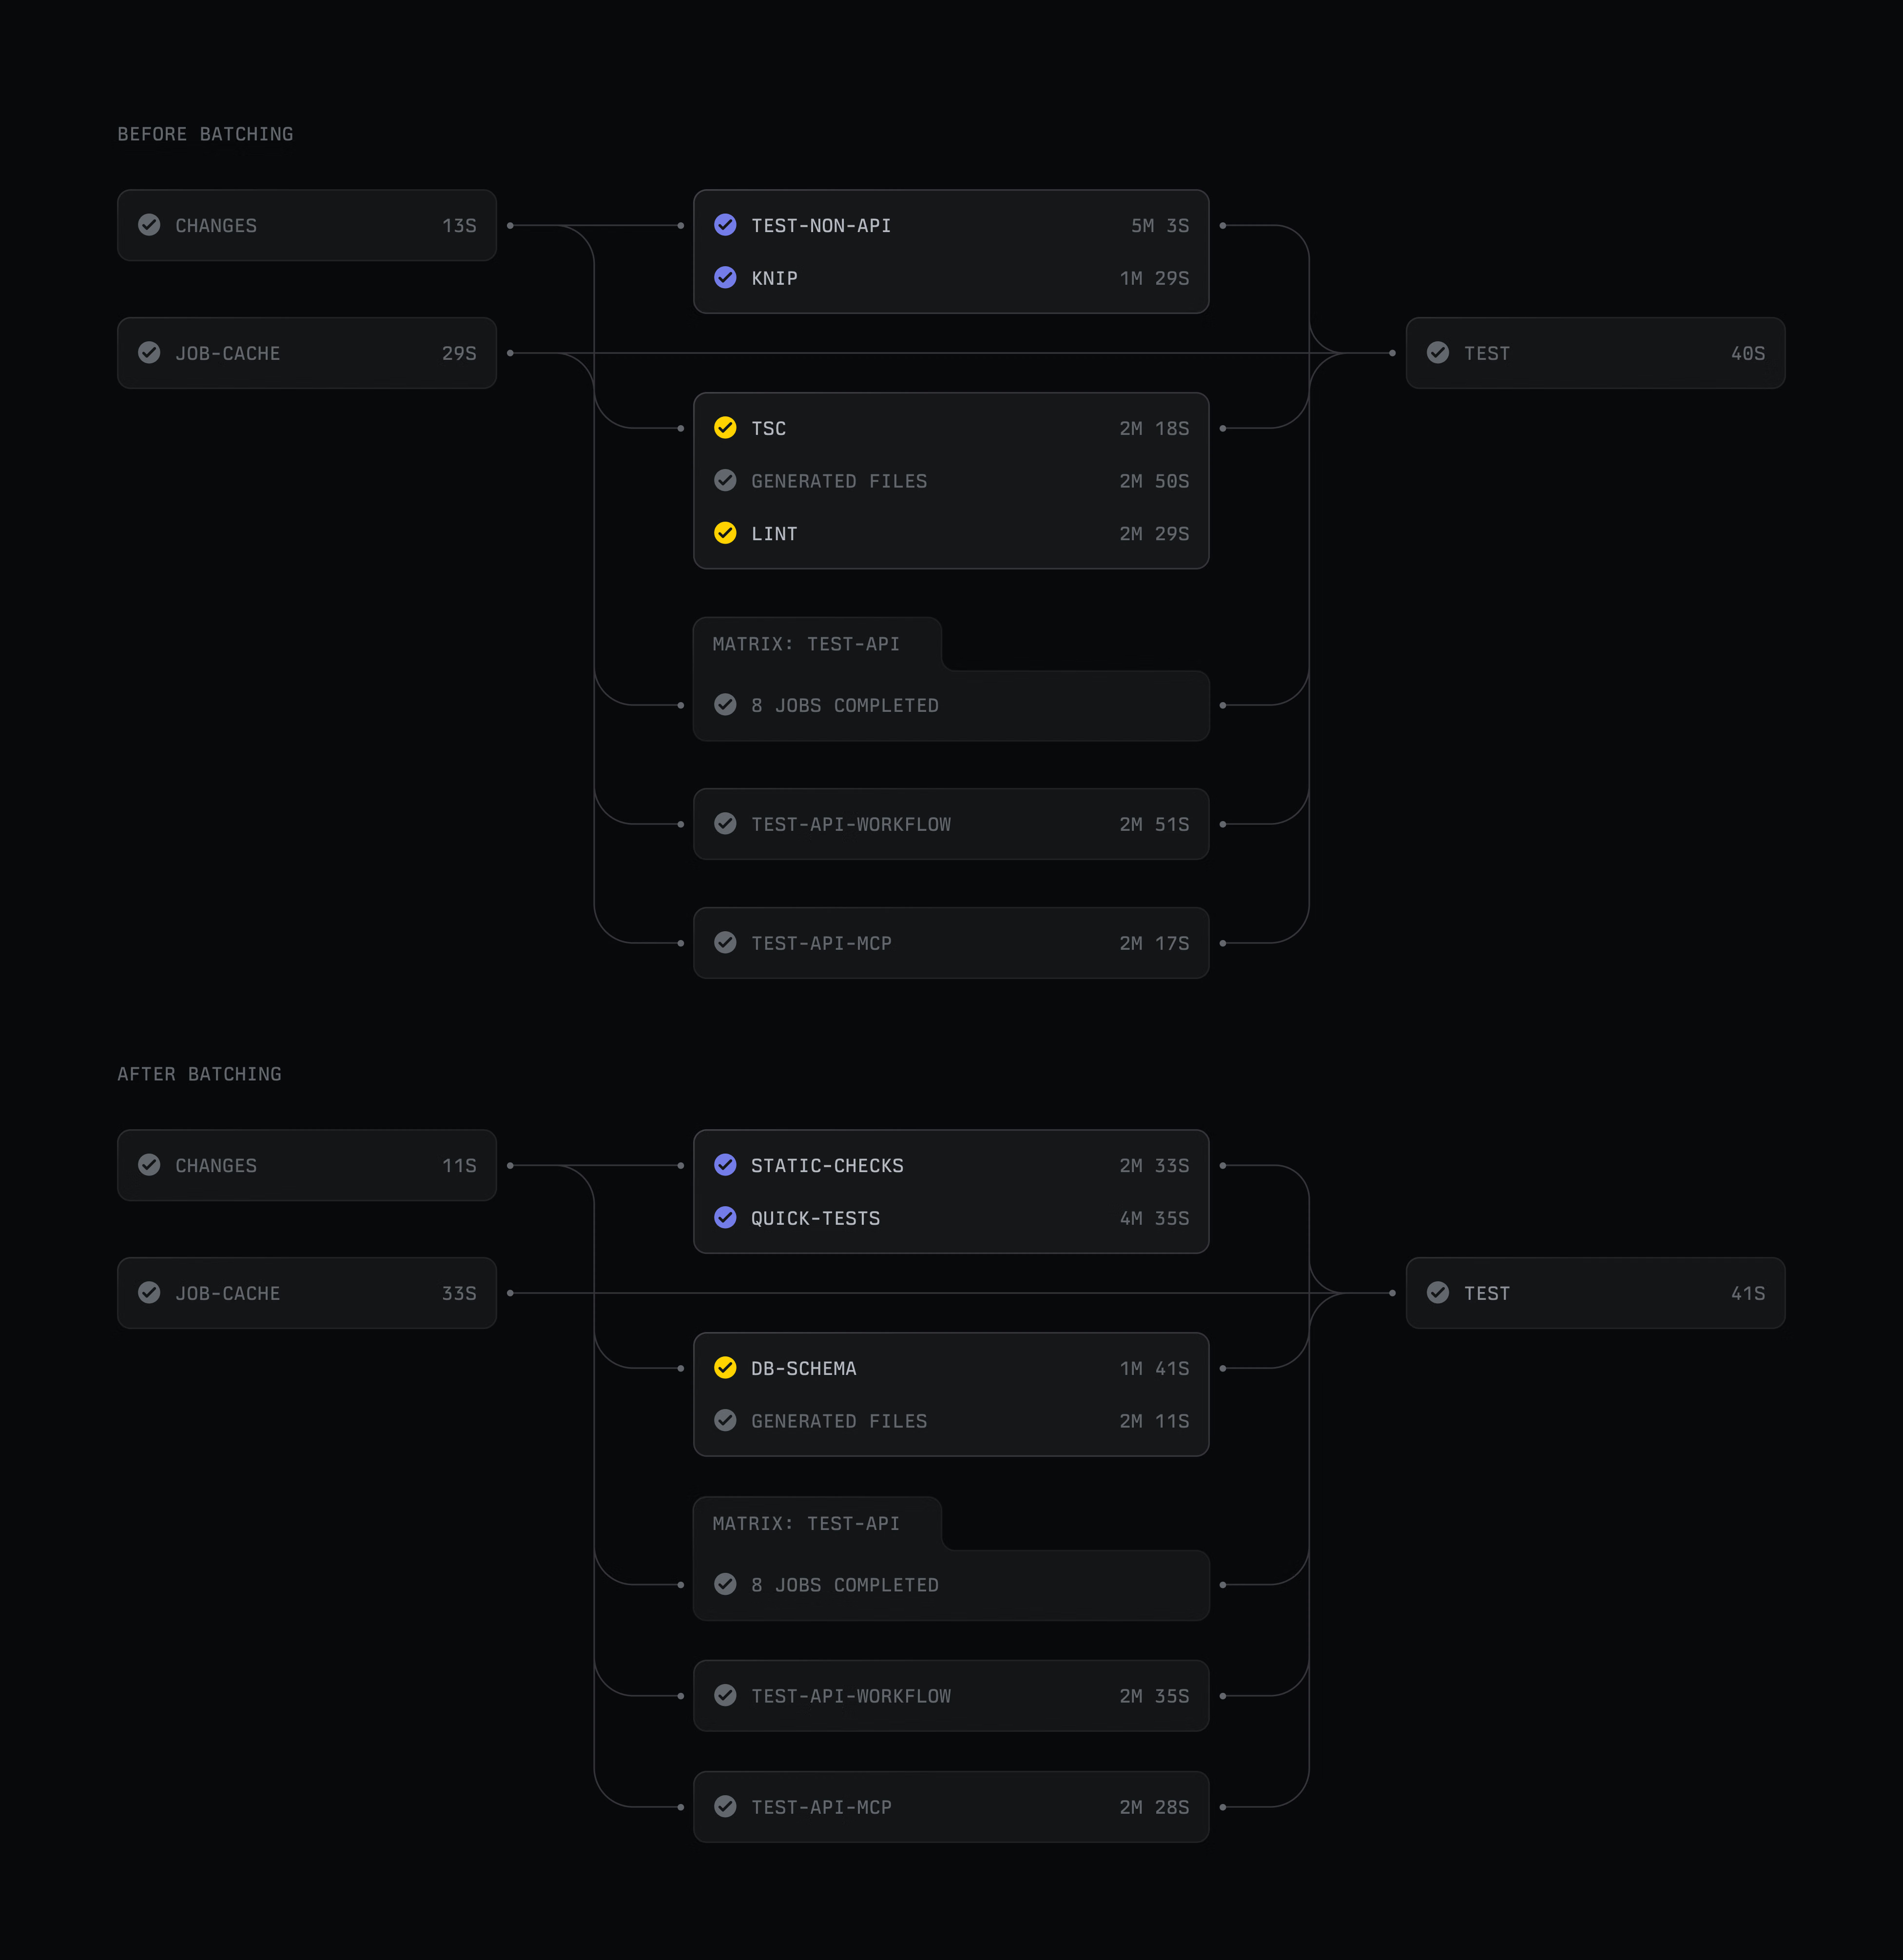
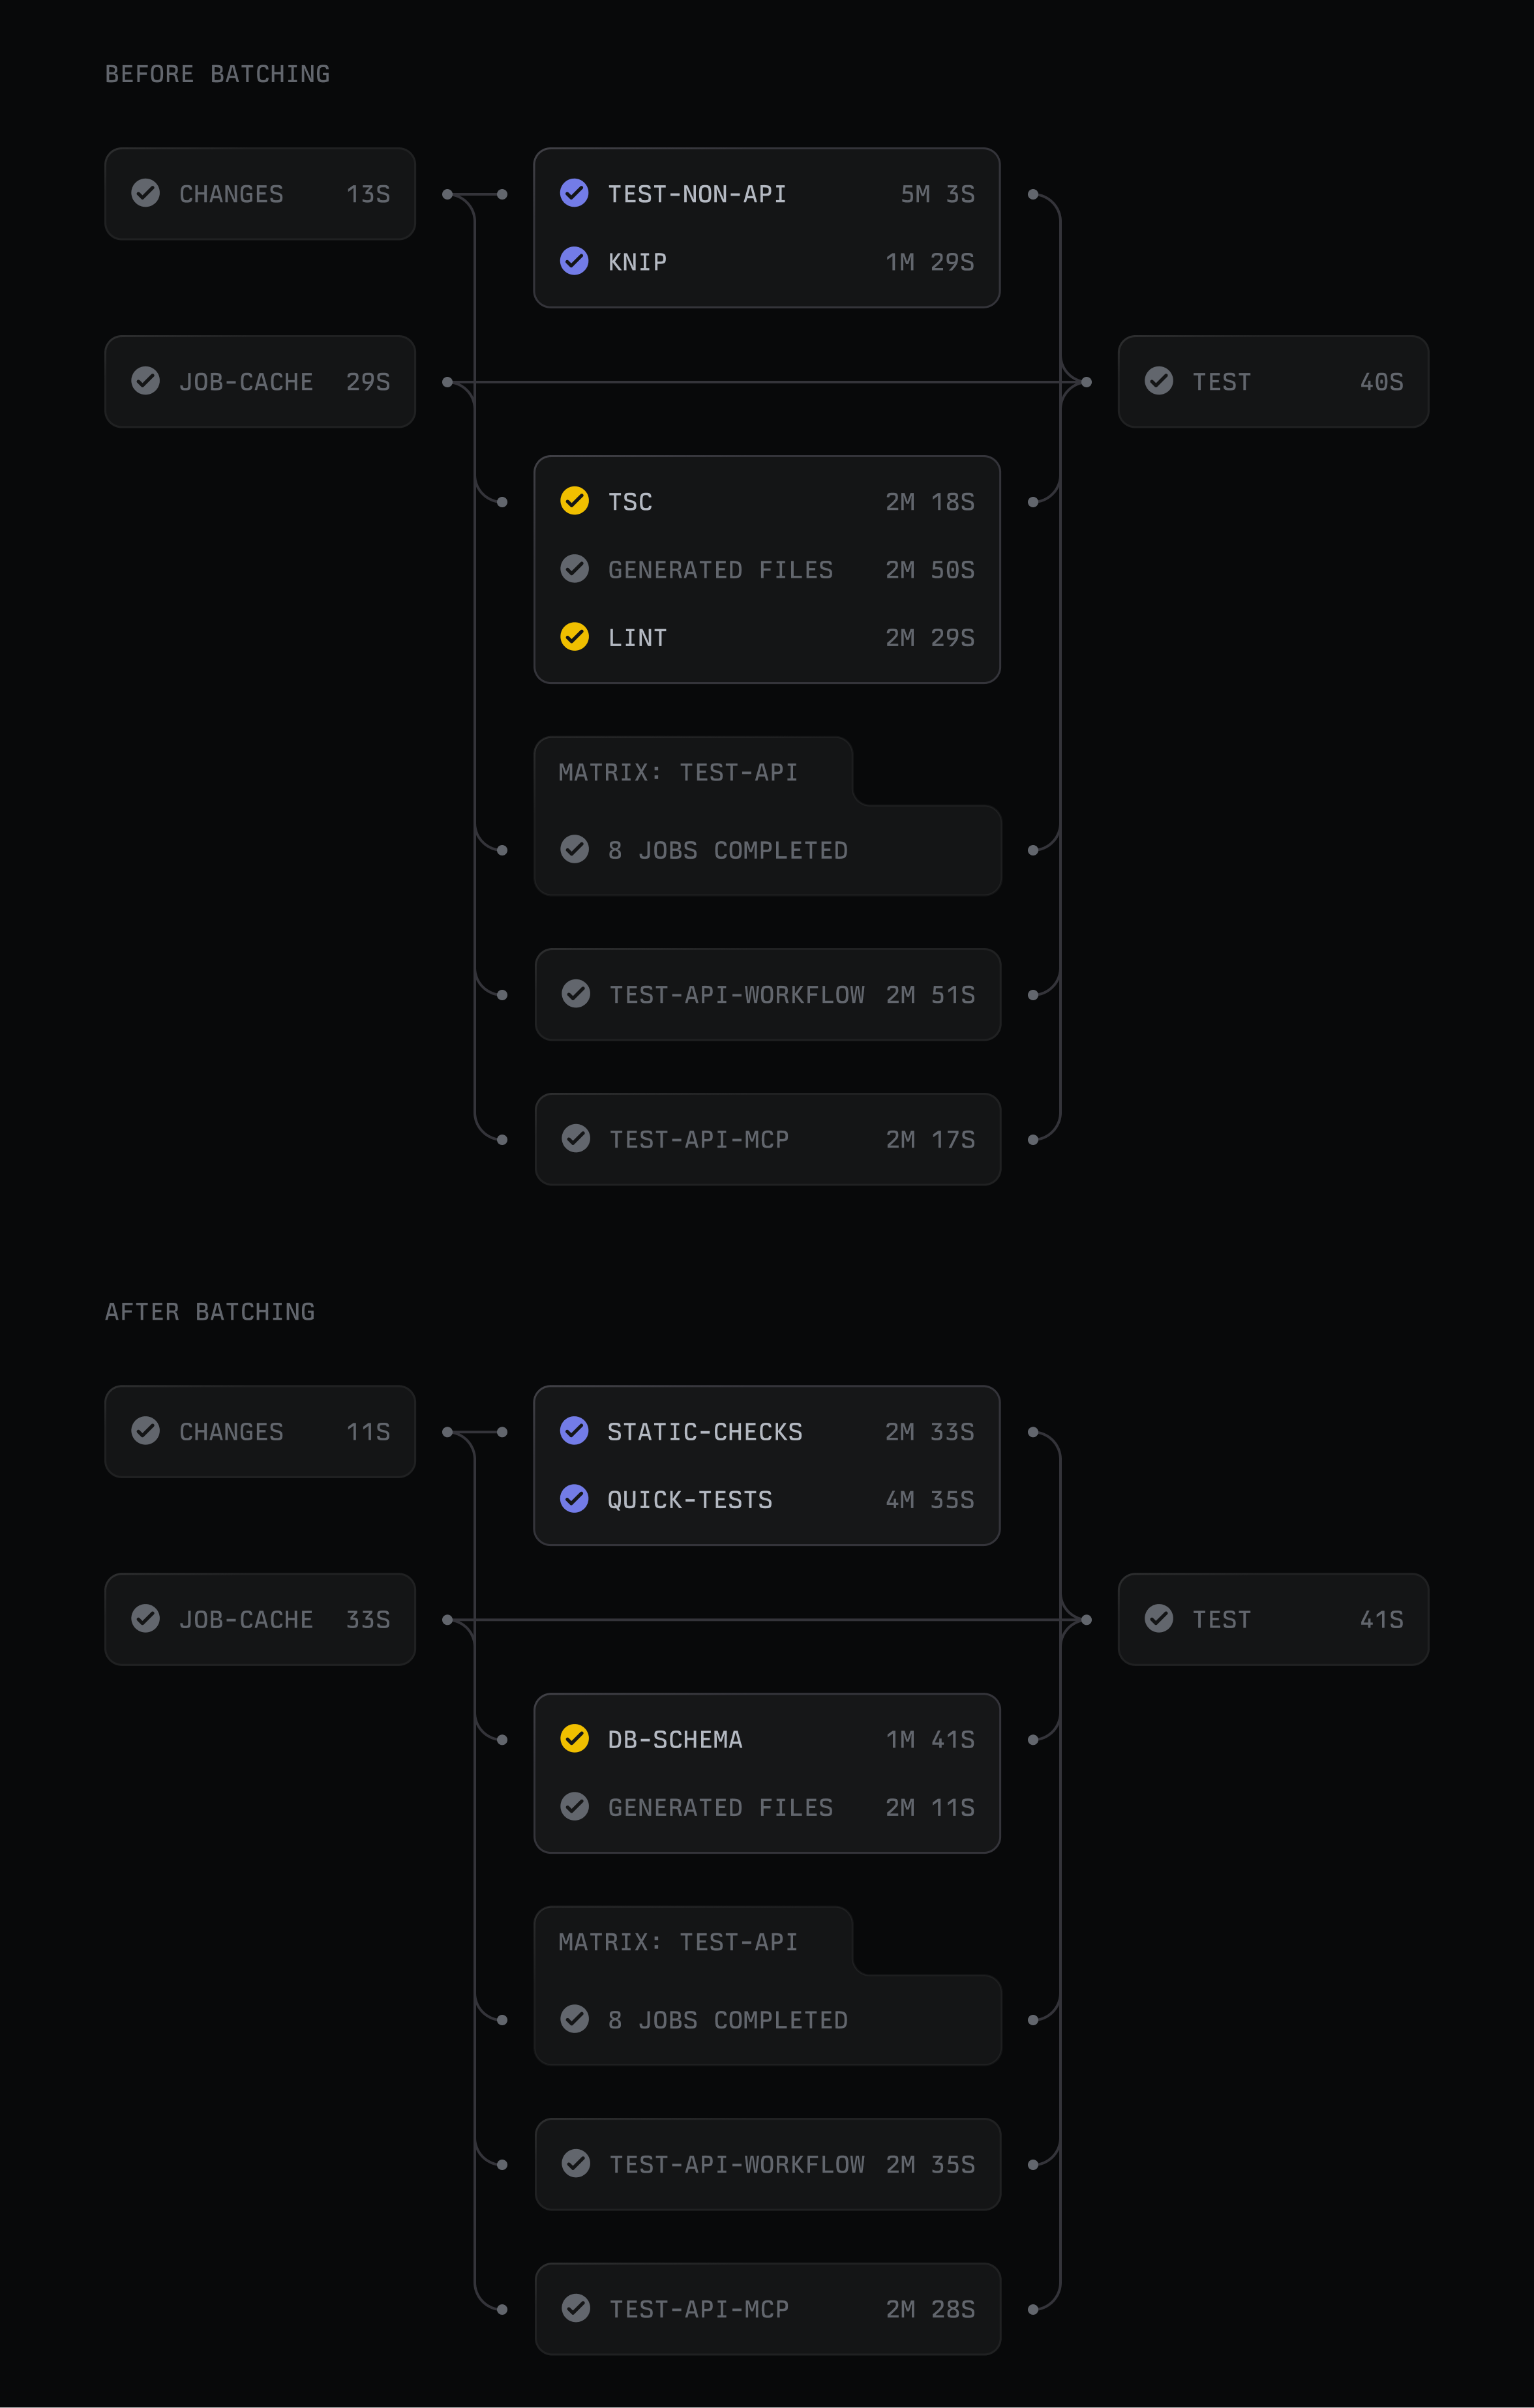
有七项相互独立的检查,各自都要启动一个运行器、检出仓库、安装依赖,然后才做几秒钟的有效工作。我们把它们合并成两个任务,并在任务内部并发运行这七项工作。这样,同样的准备开销被支付的次数从七次降到了两次。按 6 月的用量计算,这一改动每月节省约 87,000 个运行器分钟,相当于我们 CI 总用量的 11.8%。
让测试执行更高效
随着每个测试分片的固定成本降下来,我们就有余力更积极地并行化 API 测试套件。它是我们工作流中最大、也是执行最频繁的部分之一,因此这里的改进对合并时间的影响格外大。
按测试运行器的视角来均衡负载
我们用于 TypeScript 测试套件的测试运行器 Vitest,是按文件而不是按单个测试的耗时来分配工作的。这意味着少数几个特别大的测试文件可能会主导一个分片,实际上拖住整个套件的完成时间,即使其他分片早就跑完了。
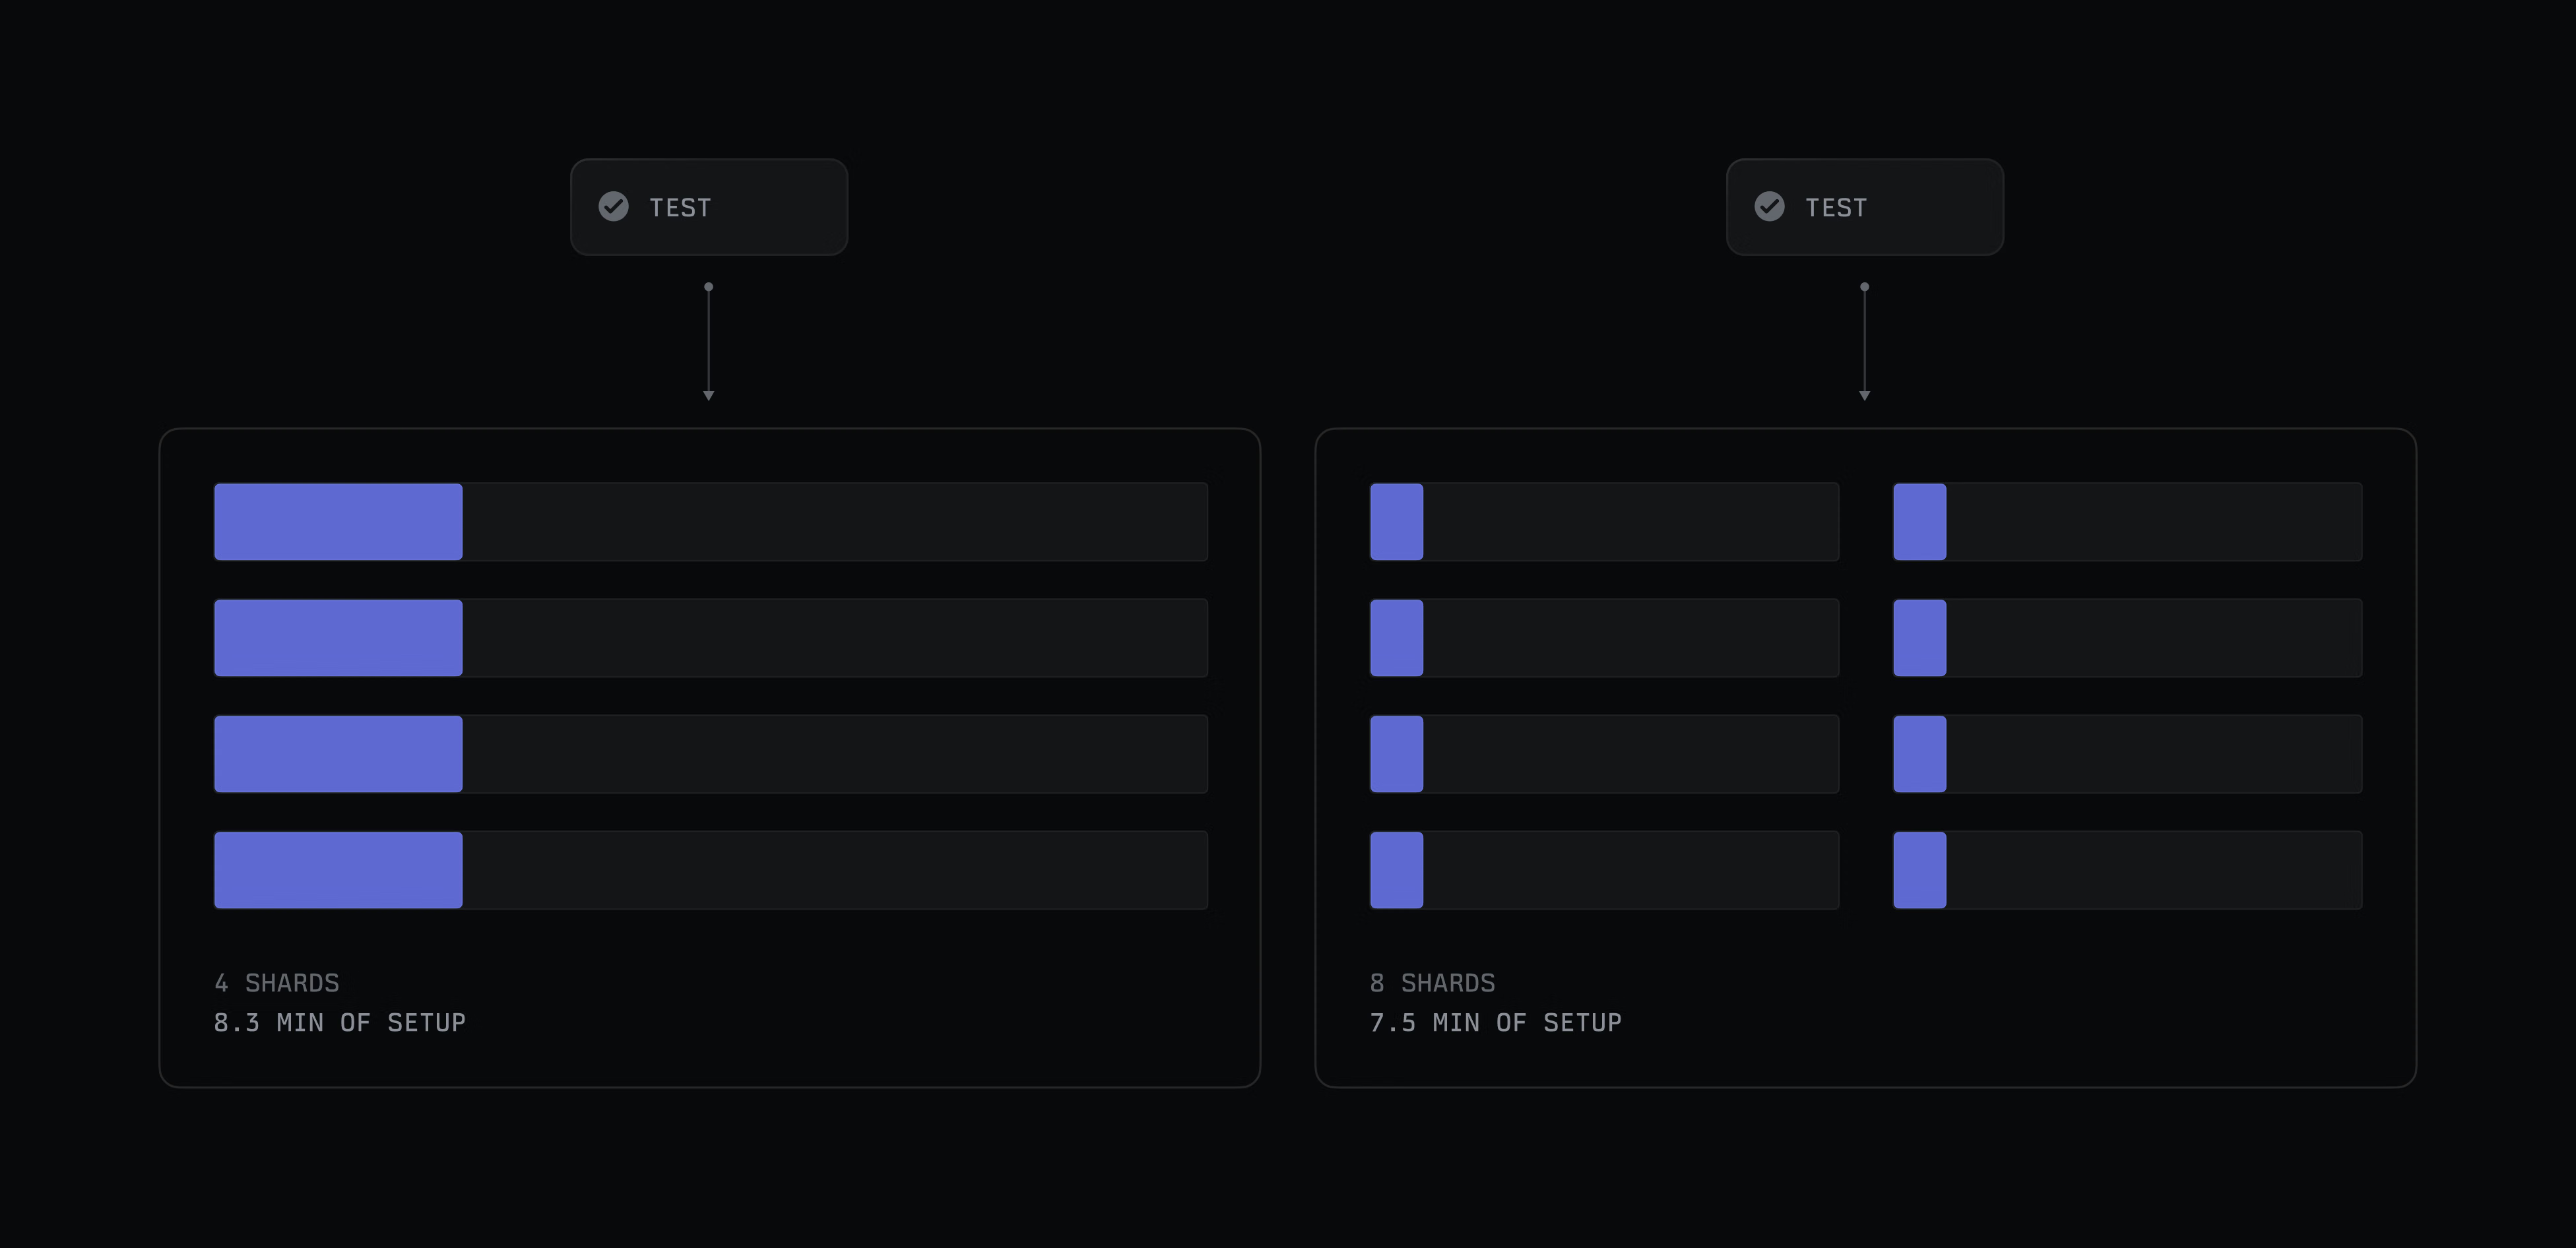
我们在保持测试结构不变的前提下,把这些大文件拆成更小、更聚焦的文件,然后评估了不同的分片和运行器配置。今年早些时候我们已经从三个分片增加到四个;在我们最初的基准测试中,增加到八个使关键任务大约快了 19%,成本也低了 19%。改动一周后,最慢的分片从 5.25 分钟降到了 4.33 分钟。
Vitest 通常会隔离每个测试文件,对我们来说,这意味着要在每个测试分片中重建实体(entity)、GraphQL 和装饰器(decorator)图。我们引入了一个需主动选择加入(opt-in)的 vitest project,配置为 isolate: false,让安全的文件在每个 worker 内共享一个模块注册表。
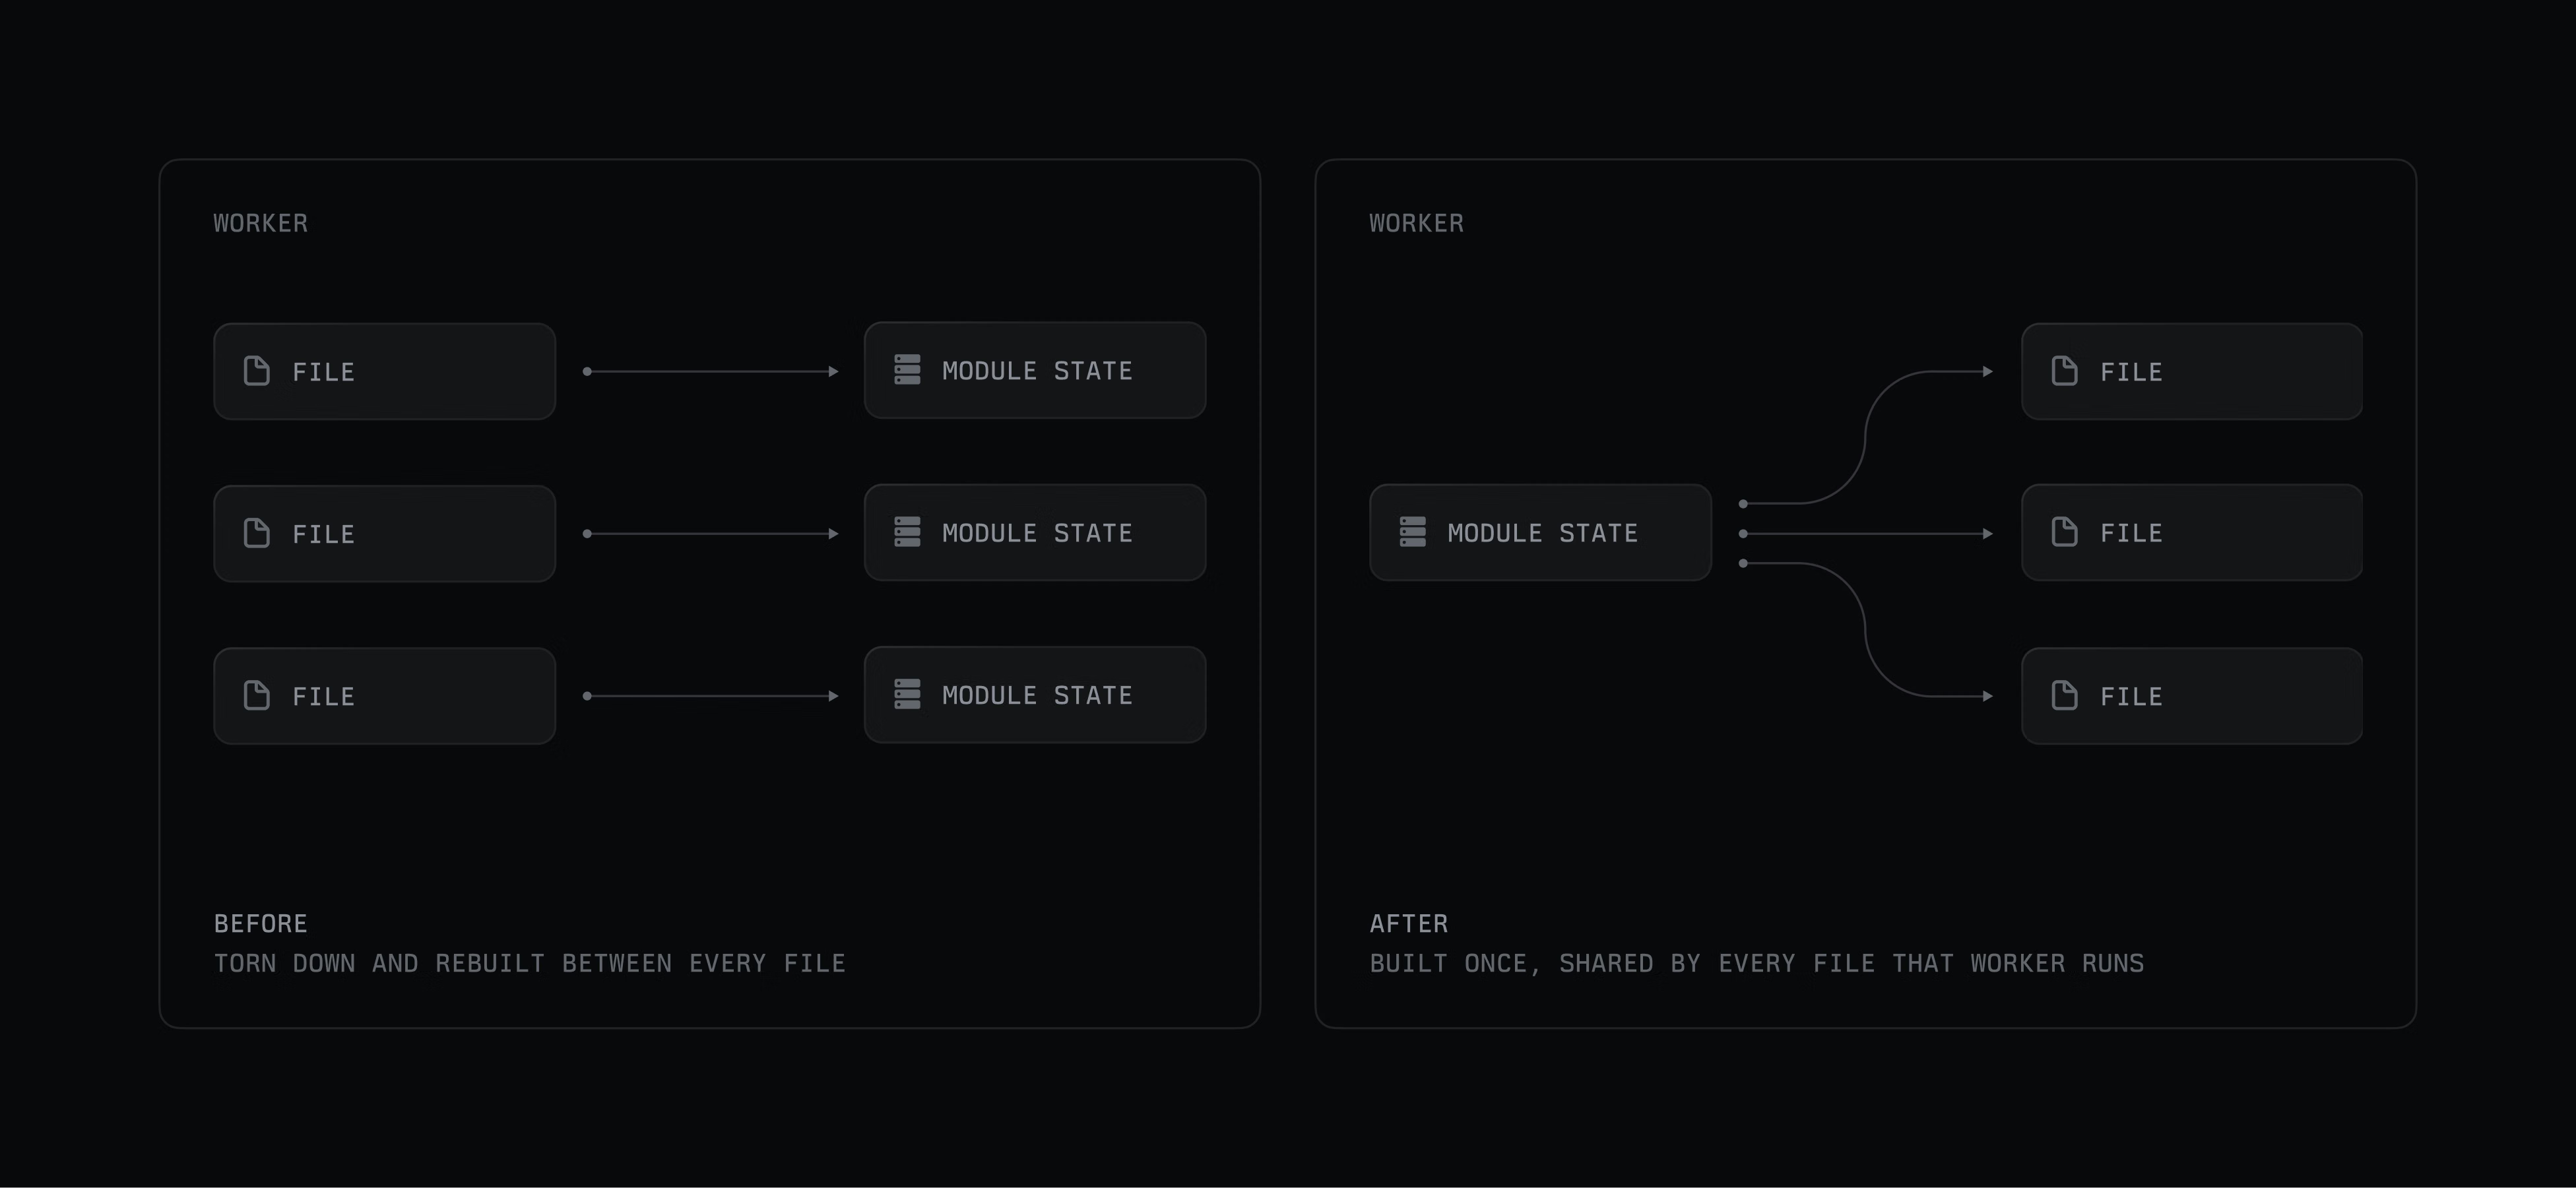
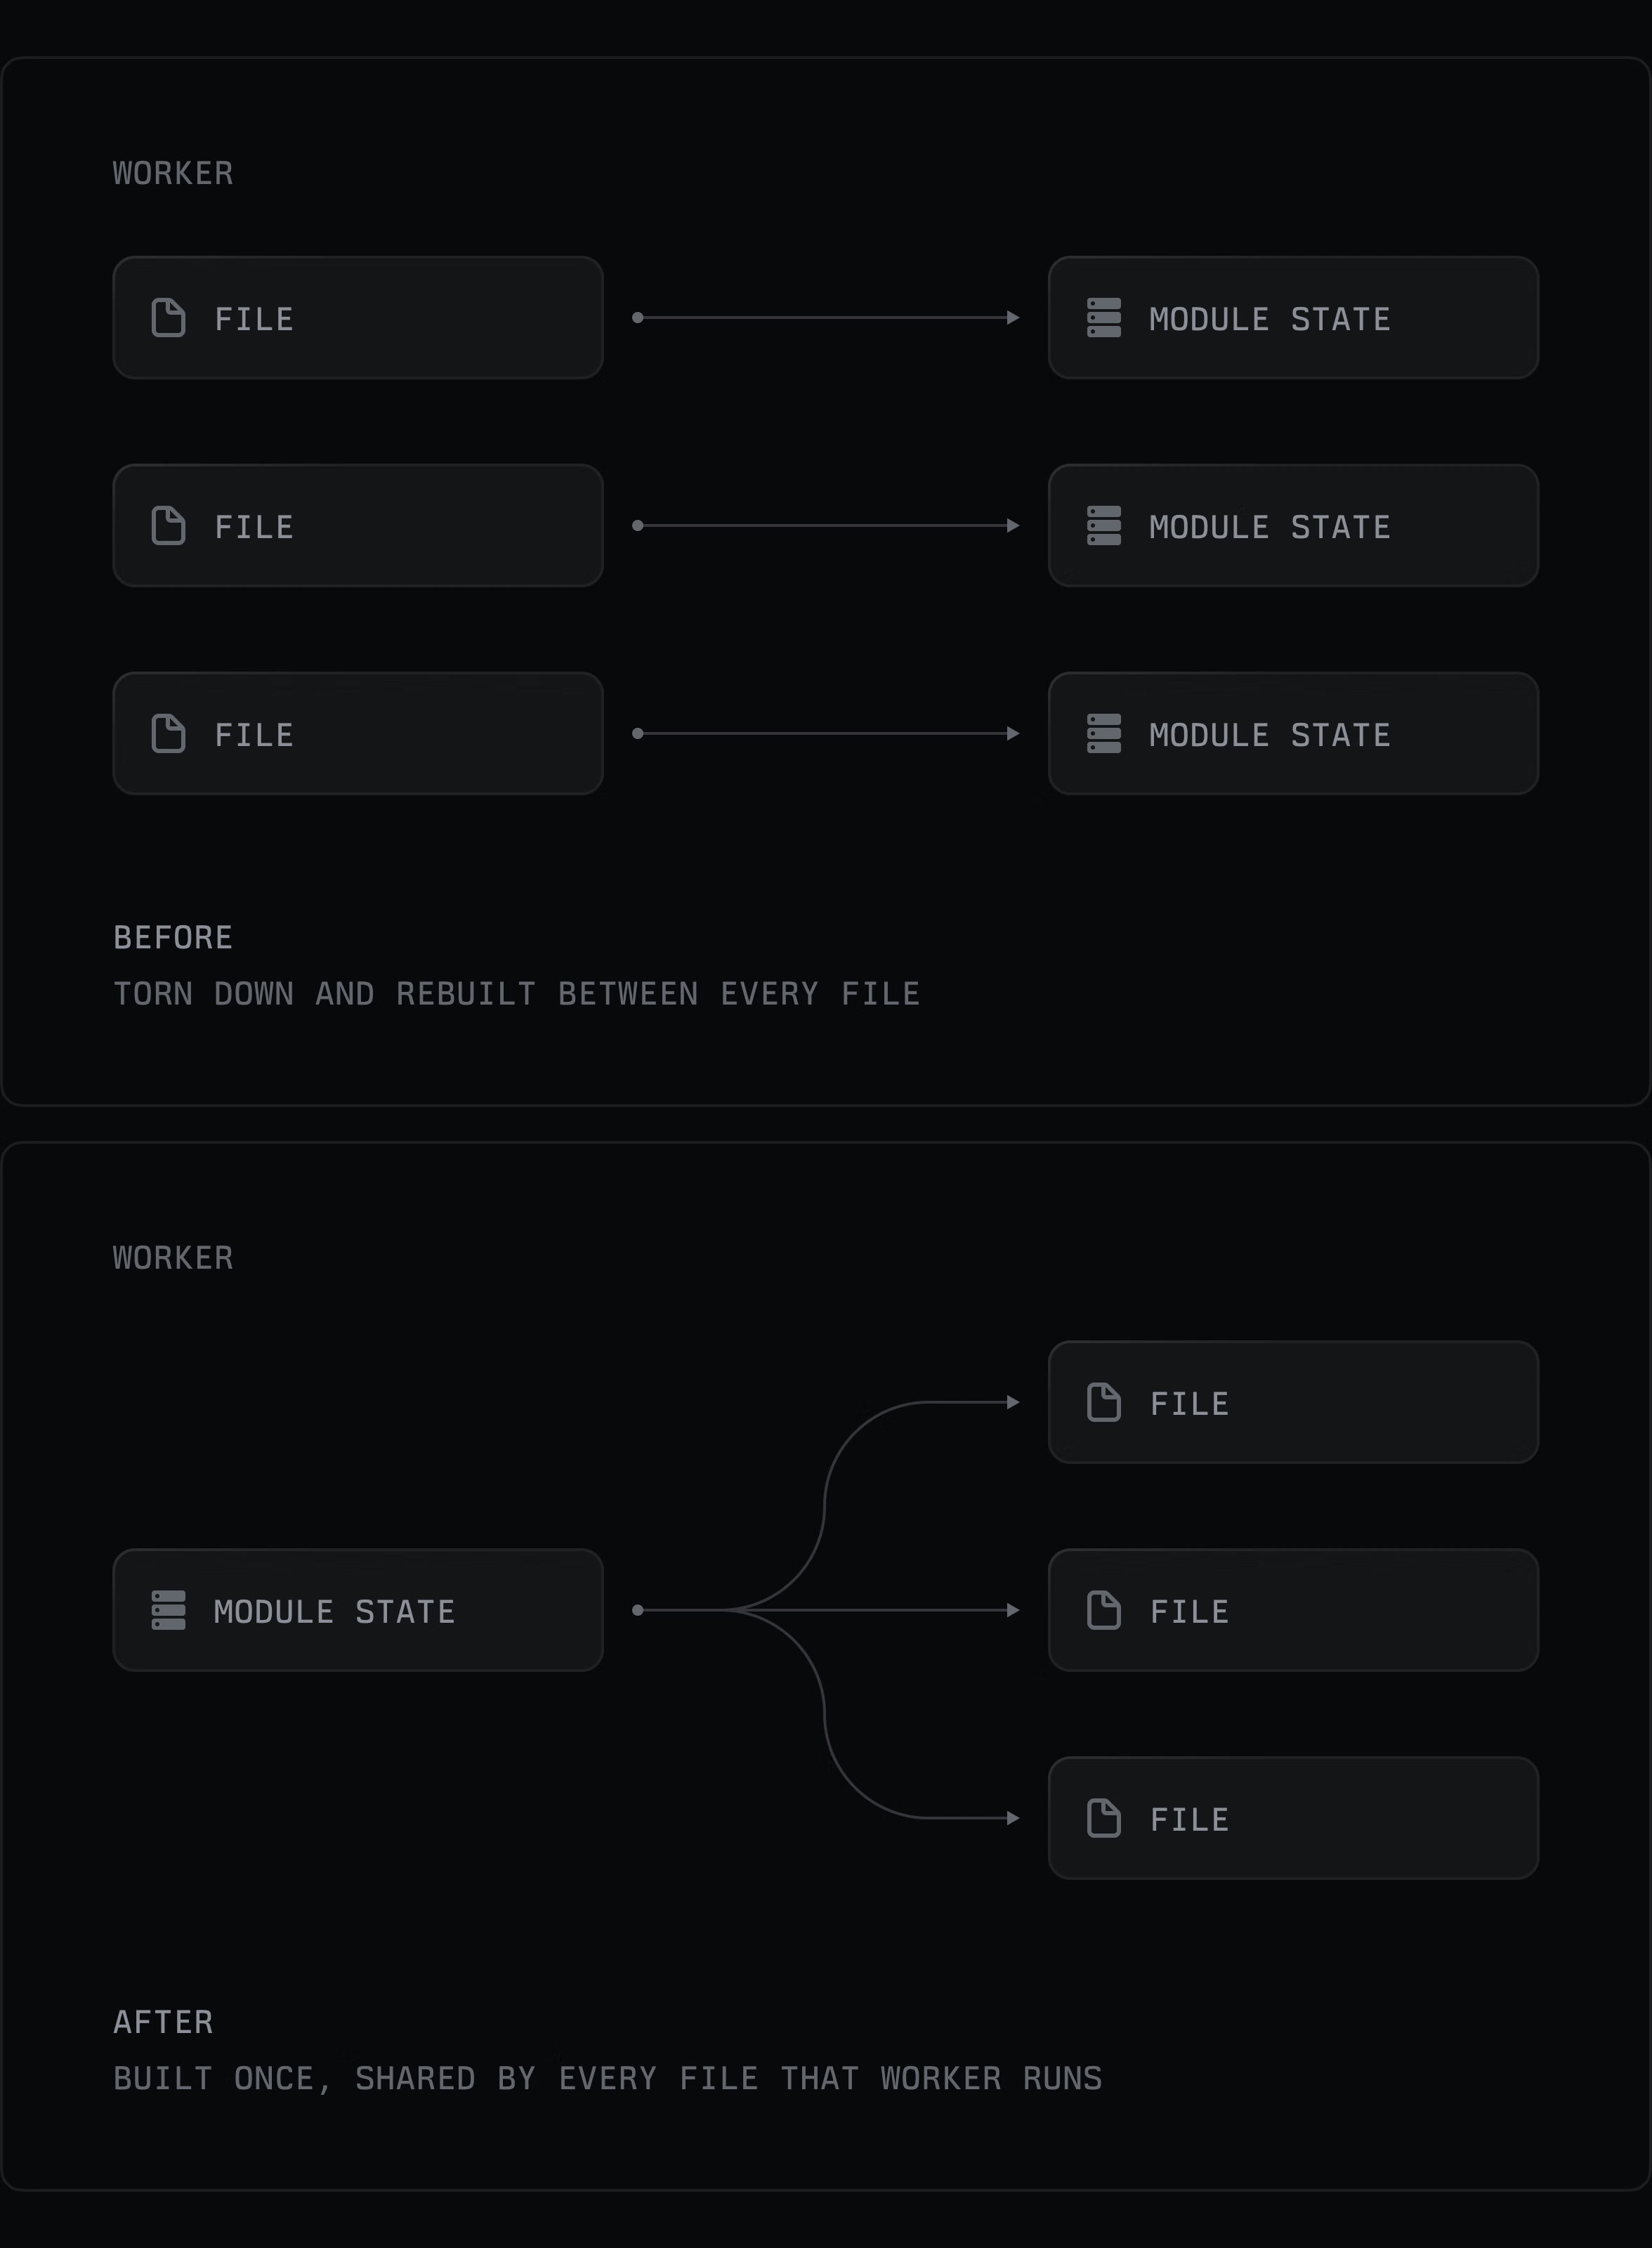
这是我们单项最大的性能改进,按我们的规模,每月大约能节省 17% 的成本。最慢的分片从大约 300 到 379 秒降到约 195 秒,而每次运行中 API 分片的运行器总时间从约 32.8 分钟降到 22 分钟。
这也是正确性风险最高的一项优化。我们通过在每个文件上添加 opt-in 注释,把适用资格明确化,并为共享状态补上了必要的清理(teardown)。有少数文件以我们无法安全理清的方式使用了假计时器或共享状态,所以我们把它们留在了隔离的 project 中。而且由于现在我们大部分测试都由智能体编写,我们也更新了相应的智能体技能(skill),让它们把这种性能上的 opt-in 考虑在内,这样生成的测试默认就会遵循同样的约束。
分片数量受准备开销的限制
只有当每个分片的固定成本很低时,继续增加分片才划算,因为分片数翻倍,工作流花在准备上的时间也会翻倍。我们前面提到的那些准备优化,正是让八个分片变得可行的原因。按每个分片 110 到 140 秒计算,八个分片仅准备工作就要消耗 15 到 19 分钟的运行器时间,比测试本身还多。现在准备时间约为 40 秒,所以八个分片花在准备上的总时间比之前四个分片还少,而测试的并行度却翻了一倍。

在整个系统中不断叠加的改进
如果我们今年早些时候没有刻意去改进 CI,今天的测试套件大约要跑 11 分钟,接近开发者现在等待时间的两倍。而这项工作并没有到此为止。显然,我们的代码库还会继续增长,目前我们每周大约新增 2,000 个测试。随着这种增长,让 CI 保持快速将是一项持续的工作,其中很大一部分是把我们在这个过程中学到的东西应用到新的瓶颈上。