摘要
- AI 原生云(AI Native Cloud)Together AI 发布了一整套用于构建实时语音智能体的能力:将 STT、LLM 和 TTS 共置于同一朵云上,消除跨厂商的网络跳转,使端到端流水线延迟低于 500ms
- Cartesia Sonic-3(TTS)和 Deepgram(STT)现已原生托管在 Together 基础设施上,进一步丰富了共置技术栈上的模型选择
- 一套 API、一个计费入口、一个部署入口,并为企业部署提供零数据留存、SOC 2 Type II、HIPAA 和专属数据驻留
想直接和助手对话,而不是读这篇博客?拨打 (847) 851-4323,向我们的助手询问模型、价格,或如何部署语音智能体。然后试着在它说到一半时打断它。这个演示专为实时轮流对话而设计,响应速度足以带来对话般的体验。这样的体验很难在碎片化的语音技术栈上实现,而这正是 Together AI 要在生产规模上交付的。
今天,AI 原生云 Together AI 推出了一整套能力,这是业界首个在共置的 STT、LLM 和 TTS 基础设施上构建实时语音智能体的统一方案。Together 把整个语音技术栈放在同一朵云上,从而降低延迟、简化部署并提升可靠性。我们还通过与 Cartesia(TTS)和 Deepgram(STT)这两家业界领先语音模型厂商的原生集成,为开发者提供了更多选择。
生产环境的语音系统通常迫使团队在速度、模型选择和运维稳定性之间取舍。Together 的统一方案正是为了消除这种取舍:面向实时对话的低延迟基础设施、覆盖整个语音技术栈的灵活模型支持,以及安全、可投入生产的平台,让团队从评估走到部署,无需在不同厂商之间反复重建。
架构:统一模块化方案与多厂商拼接方案的对比
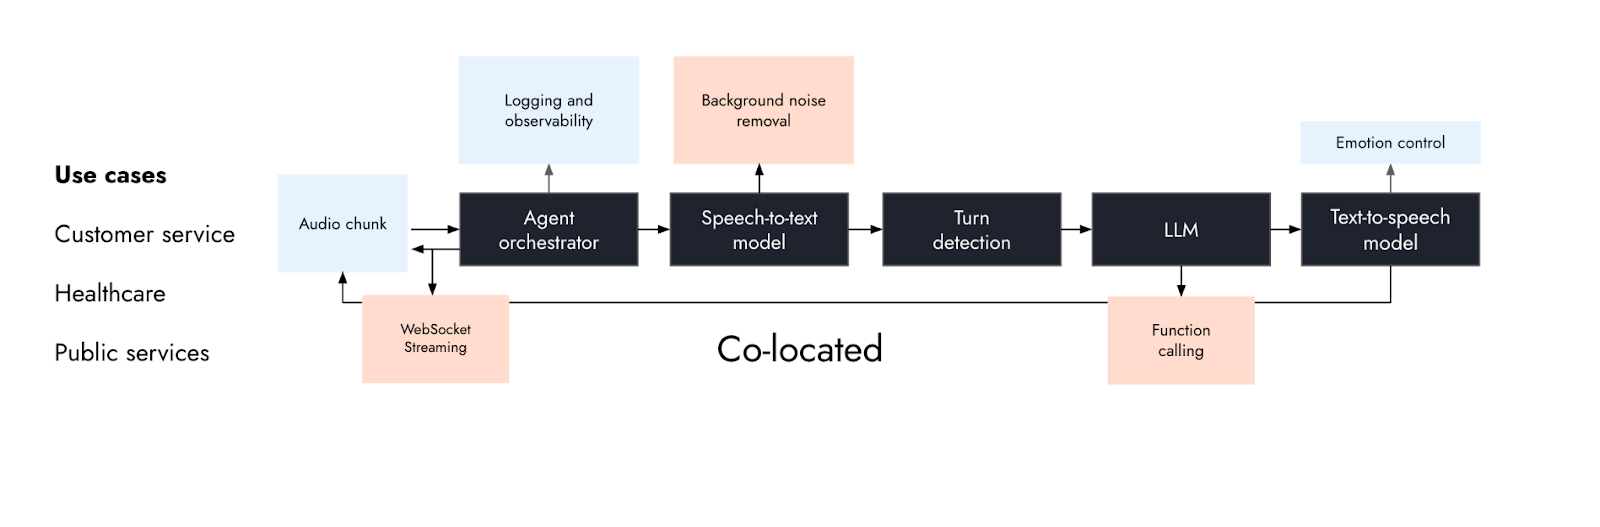
你刚才拨打的演示之所以能保持实时,是因为这些环节的交接都发生在同一个 Together AI 集群内部,并由能让往返延迟对来电者保持较低的区域提供服务。每个组件(STT、LLM 和 TTS)都运行在带有预热容量的专用端点上,从用户说话结束到第一个音频 token,端到端延迟低于 500ms。
跨多个厂商搭建语音流水线,通常意味着音频和文本要经由公共互联网,在彼此独立的 STT、LLM 和 TTS 系统之间来回传递。每次交接都会增加延迟、加大运维复杂度,也让技术栈在生产环境中更难管理。Together AI 的统一模块化架构旨在消除这些额外开销:把 STT、LLM 和 TTS 共置于同一集群,并从靠近终端用户的区域提供服务。
这种架构的重要性体现在三个方面:
- 速度:当 STT、LLM 和 TTS 在多个云厂商之间交接音频和文本时,语音智能体往往会变慢。这些跨厂商的网络跳转在流水线的每个阶段都增加延迟,让实时对话更难维持。Together 让这些交接走本地数据中心网络,而不是公共互联网,从而实现低于 500 毫秒的端到端延迟,满足自然轮流对话所需的响应速度。
- 灵活性:模型的灵活性需要有选择余地。Together 在一个地方托管了用于转录、推理和合成的领先语音模型,让团队有速度也有控制力,可以为每个用例配置所需的技术栈。而且与不透明的端到端语音模型(speech-to-speech)不同,Together 的模块化设计保留了对中间转录文本和响应文本的访问,团队可以在数据流转过程中检查、修改和路由数据,作为自己应用逻辑的一部分。
- 可靠性:生产环境要求可靠。Together 的零信任架构专为敏感语音数据而设计,其精简的端到端管理体验也省去了把多个厂商的零散方案拼凑在一起的复杂性。在同一平台上运行完整流水线,团队只需一套 API、一层认证、一个计费入口和统一的指标,既降低运维负担和延迟,也让生产环境中的成本更可预测。
对于企业部署,该平台可满足严格要求,包括零数据留存、SOC 2 Type II、HIPAA 以及专属数据驻留选项。
一个平台上的模型选择
团队常常为了速度、富有表现力的合成或声音克隆而拼凑不同的厂商,让自己的基础设施变成脆弱的多厂商拼盘。Together AI 用一个与模型无关的单一平台取代了这种做法。开发者可以配置所需的 STT、LLM 和 TTS 组合,并在无需重建集成的情况下更换模型。
在同一个平台上,团队可以让音频和文本流经 Whisper Large v3、Minimax Speech 2.6 Turbo、Rime Arcana、Kokoro 以及 Together 完整的 LLM 目录等模型。完整的受支持模型目录请见我们的 STT 和 TTS 文档。
为了扩充模型库,我们推出了对 Deepgram(STT)和 Cartesia(TTS)的原生集成。将这些模型直接托管在 Together AI 上,意味着团队既能获得业界领先的转录和合成能力,又能让每一次交接都安全地保留在共置技术栈内部。
Cartesia 为平台带来了 Sonic-3 和 Sonic-2,提供专为语音智能体和生产部署打造的、富有表现力的超低延迟 TTS。
“在 Cartesia,我们致力于突破实时、富有表现力的语音 AI 的极限。通过与 Together AI 合作,我们很高兴能把这项技术带给更多构建下一代语音应用的开发者。” - Arjun Desai,Cartesia 联合创始人
Deepgram 为平台带来了 Nova-3、Nova-3 Multilingual(STT)、Flux(对话式 STT)和 Aura-2(TTS),覆盖从实时转录到企业级语音合成的全部需求。
“语音智能体的成败取决于延迟,而厂商之间的每一次网络跳转都是体验可能崩坏的地方。通过把 Deepgram 的 STT 原生托管在 Together AI 的基础设施上,我们让开发者无需取舍就能获得生产级转录:快速、准确,并且与流水线的其余部分共置。” - Abe Pursell,Deepgram 合作伙伴副总裁
生产环境中的语音智能体:Decagon
Decagon 在这套技术栈上以生产方式运行礼宾式语音智能体。他们的智能体大规模处理复杂的企业客户支持工作流,例如解决账单咨询、管理账户变更和执行技术排障。在这类场景中,转录准确率、低延迟和基础设施正常运行时间,对维持自然的客户体验至关重要。在 Together AI 上运行流水线,提供了流畅对话所需的严格延迟上限,同时 Decagon 仍能掌控中间转录文本和响应文本。
开始使用
→ 拨打演示电话 - (847) 851-4323
→ 阅读演示指南
→ 阅读 TTS 文档
→ 阅读 STT 文档
→ 了解更多