新功能一览
- 工具调用微调:基于 OpenAI 兼容的 schema,提供端到端的微调与推理,确保智能体可靠地执行结构化操作。
- 推理微调:专门支持在推理轨迹中的“思考”token 上训练模型,让模型学会复杂的逻辑。
- 视觉语言模型微调:原生支持视觉训练,使视觉语言模型能够对齐复杂的、特定领域的视觉数据。
- 大模型支持:在我们高度优化、简单易用的服务上,训练参数量最高达 1T 的最新模型。
随着 AI 团队从单轮提示走向更高级的多轮工作流,可靠性问题总是出现在几个可预见的地方:工具调用与 schema 不符,推理能力在长时间交互中退化,模型漏掉特定领域的视觉信号。解决这些问题通常需要后训练,但相关工作流往往零散、迭代缓慢,也难以规划。
今天,AI 原生云 Together AI 扩展了 Together Fine-Tuning,原生支持工具调用、推理和视觉语言模型(VLM)微调。为支撑前沿规模的后训练,我们还升级了训练栈,能更高效地处理 100B+ 参数的模型,吞吐量最高提升 6 倍。此外,我们现在支持在最大 100GB 的数据集上进行微调。最后,我们在训练前提供任务成本预估,在训练过程中提供预计完成时间(ETA),帮助团队更好地规划实验。
“Together AI 之于微调和推理,就像 Vercel 之于基于大语言模型的应用——它移除了基础设施层,让我们能专注于自己的产品。我们通过简单的 API 调用来微调并部署面向客户的专属模型。这让我们现有的团队从每周迭代变成每天迭代,成本降低 2–3 倍,准确率从 77% 提升到 87%。” — Lamara De Brouwer,XY.AI Labs 联合创始人 & CTO
工具调用微调
工具调用是许多现代智能体应用场景的关键。然而,开箱即用的模型在工具调用上常常表现不佳:编造参数、选错函数,或无法遵循多步骤的调用顺序。在工具调用工作流中,哪怕是很小的不一致,也可能引发下游的连锁故障。
我们的微调服务现在提供一套端到端的方案,覆盖从微调到推理的全过程,实现可靠、生产级的工具调用。训练数据中可以使用 OpenAI 兼容的 schema 来包含工具调用。函数定义在顶层的 tools 数组中,服务会校验每一条 tool_calls 是否都对应一个已声明的工具,从而在训练开始前确保数据结构正确。
在推理阶段,我们大幅提升了工具调用的可靠性,确保工具调用微调的收益能转化为生产环境中的表现。增强的解析与校验提高了各类真实场景下的正确率,背后依托的是我们从社区贡献和内部研究中整理出的推理工具调用数据集。
来自 Qwen、Moonshot AI 和 Z.AI 的模型均支持工具调用微调。请参阅工具调用文档开始使用。若想查看工具调用功能的代码示例,请看我们的 cookbook。
推理微调
推理模型在给出最终答案之前,会先生成中间的思考轨迹,从而实现逐步推理。然而,各模型的推理格式并不统一,这给推理微调过程带来了额外的复杂性。
Together Fine-tuning 现在支持直接在思考轨迹上微调,做法是在 assistant 消息中使用 reasoning 或 reasoning_content 字段。这样你可以在保持轨迹结构化、可复现的同时,让模型学习特定领域的推理模式。与工具调用一样,我们也改进了推理的推理(inference)环节,确保微调得到的能力能转化为可靠的下游表现。
来自 Qwen 和 Z.AI 的模型支持推理微调。支持的模型及详细信息请参见我们的文档页面。若想查看推理微调的端到端代码演示,请看看我们的 cookbook
视觉语言模型微调
许多 AI 工作流需要模型能够理解图像输入。对于医学影像、电商等特定领域的任务,视觉语言模型(VLM)可能需要学习新的视觉模式才能发挥作用。
Together Fine-tuning 服务现在支持视觉语言模型的微调。视觉训练数据通过消息内容数组以内联方式提供,图像采用 base64 编码。微调任务支持混合数据集,即同一次运行中既可以包含图文样本,也可以包含纯文本样本。
默认情况下,我们会冻结视觉编码器,只更新语言层。设置 train_vision=true 即可启用联合训练,同时更新视觉编码器和语言层。
来自 Qwen、Google 和 Meta 的模型支持 VLM 微调。支持的模型列表和使用细节请参见视觉语言文档。你也可以查看我们的 cookbook,了解视觉语言微调。
大模型微调
随着开源模型规模的增长和上下文窗口的扩大,底层训练基础设施也必须跟上。万亿参数的模型无法放进单个节点,因此需要在多台机器之间精细地管理通信和内存。在持续数小时的训练中,哪怕一次硬件故障也可能导致进度丢失,而要实现所有优化和容错保障,往往需要大量投入。
Together Fine-Tuning 现在支持微调最新的开放权重模型。你只需提交训练任务,所有必要的优化由我们在底层完成。新增支持微调的模型包括:
- Qwen 3.5-397B-A17B
- Qwen 3.5-122B-A10B
- Qwen 3.5-35B-A3B
- Qwen 3.5-35B-A3B-Base
- Kimi K2.5
- Kimi K2(Instruct、Thinking)
- GLM-4.7
- GLM-4.6
完整的支持模型列表及其上下文长度,请查看我们的文档。
训练加速
本次更新中,我们继续聚焦训练栈中收益最高的优化机会。具体来说,我们针对的是混合专家(mixture-of-experts)架构,因为过去一年中最强的模型发布绝大多数都采用了这种架构。为加速其训练,我们集成了 SonicMoE 的一个变体——一种感知 I/O 和 tile 的优化内核,能让内存操作与计算重叠进行。在我们的训练工作负载中使用这些内核后,训练期间的激活内存占用明显降低,计算浪费也降到最低。
我们还引入了用于损失计算的自定义 CUDA 内核,并消除了训练循环中几处造成不必要停顿的 GPU 到 CPU 同步点,显著提升了整条流水线的效率。
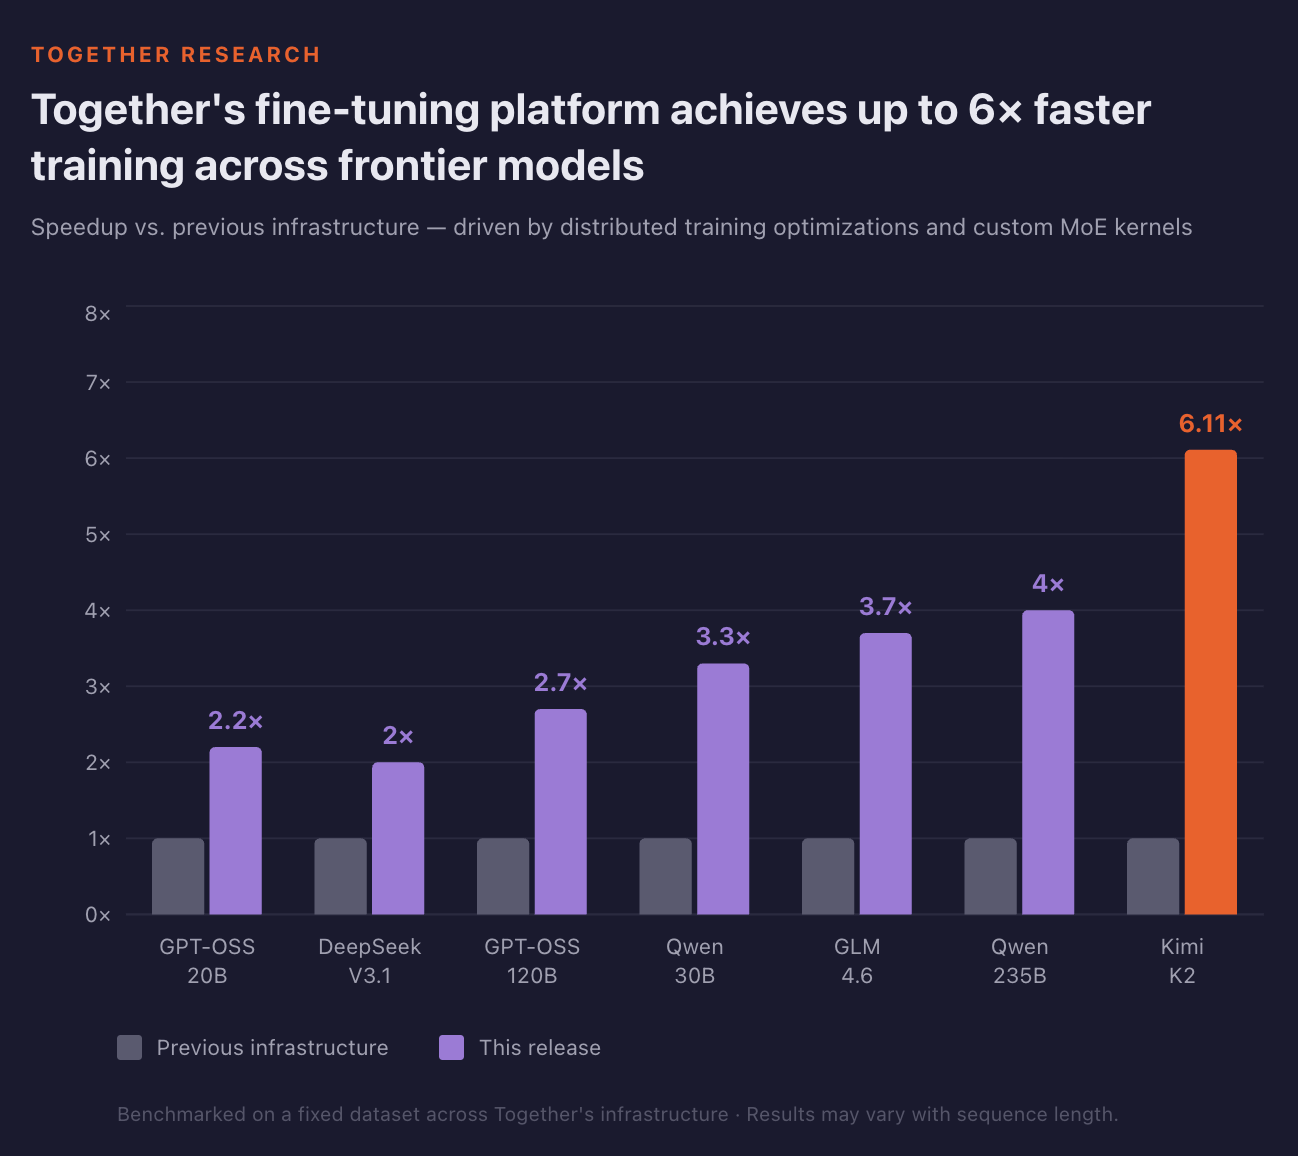
因此,每个模型的吞吐量至少提升了 2 倍,Kimi-K2 等更大的模型提升超过 6 倍。训练更快,意味着每天能做更多实验,也意味着更短的投产时间。
价格与时间预估
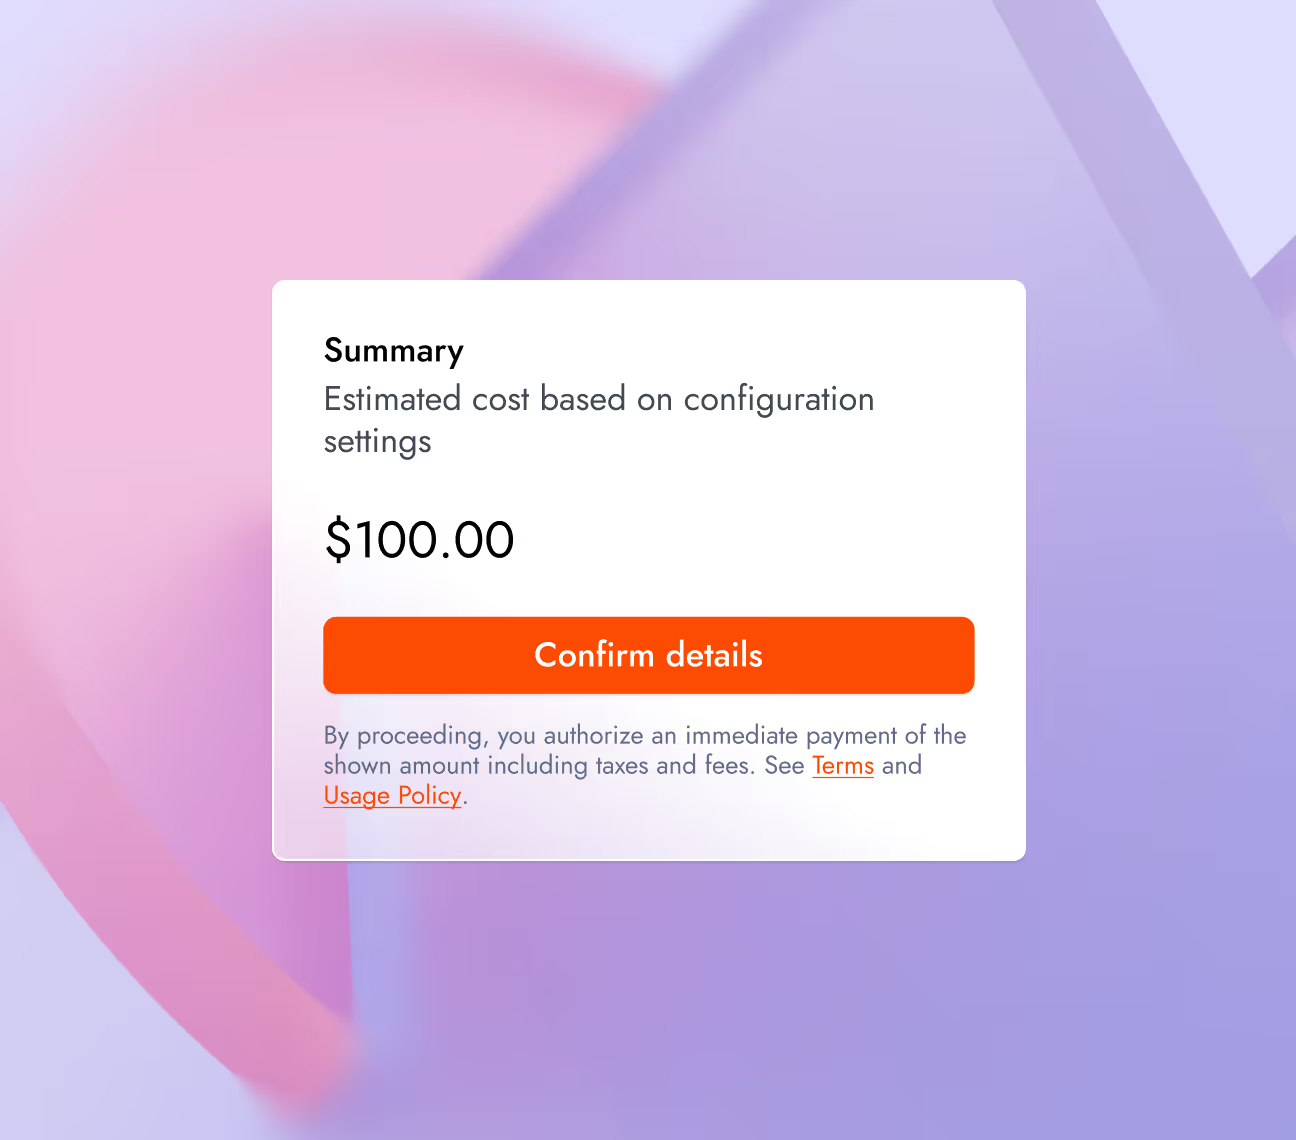
现在,无论从 UI 还是 CLI 执行任务,Together Fine-tuning 都会在任务运行前预估训练成本。价格透明可避免预算上的意外。
成本预估:在启动前查看任务的预估价格,在费用产生之前了解训练成本。
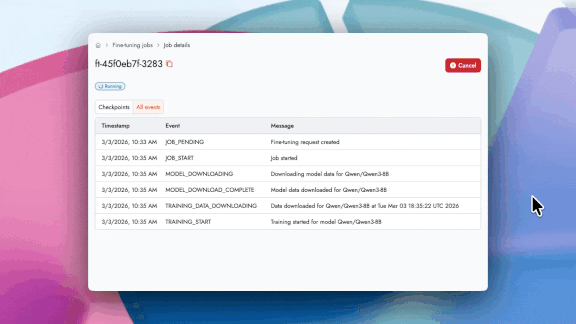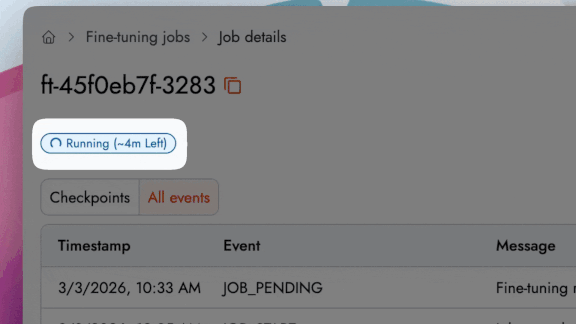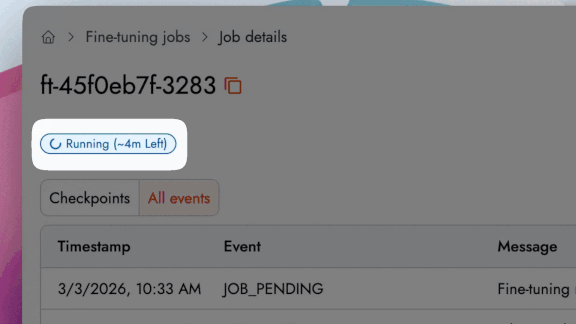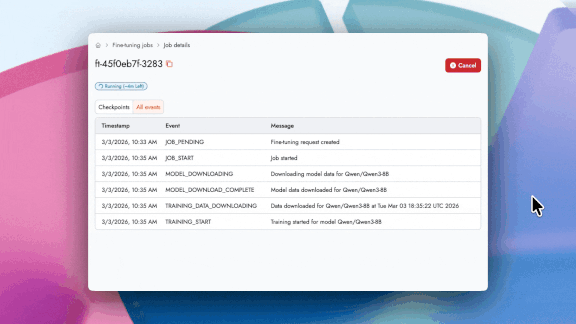
时间预估:通过实时进度条跟踪任务进展,预计完成时间会随任务运行动态更新。
开始使用
→ Cookbook 链接:
→ 阅读微调文档