摘要
发布(rollout)会分阶段、设置关卡,把线上流量从当前模型迁移到新的检查点。健康检查总是在流量移动之前运行;对于金丝雀发布,你还可以添加在每一步之后运行的指标关卡(比如 p95 延迟或错误率)。如果某个关卡被触发,发布会停在金丝雀流量占比上,此时你可以取消它,并反向运行一次发布。下面我们真实跑了一次:Qwen2.5-7B → Qwen3.5-9B 的金丝雀发布,其关卡在 10% 流量时发现了 137% 的 p95 劣化;我们取消并反向执行,期间所有线上请求均被正常处理,没有失败。
更换模型是常见做法
如果你在生产环境中运行模型,就已经知道需要换入新的检查点或新的模型系列:开源模型生态发展很快,候选模型在评测中往往表现出色,或者承诺更高的吞吐量。你希望它平稳地面向所有用户,并且在表现不佳时能够回滚。常见的做法都要求做出取舍:
- 硬切换:把端点指向新模型,所有用户同时暴露其中。如果 p95 翻倍,你只能从仪表盘上发现,更糟的是从客户那里得知,然后在压力下回滚到一个冷启动的旧模型上。
- 自建分阶段切换:再部署一套,加一个脚本,一边盯着 Grafana 一边逐步调整流量百分比,还要记得在把流量切回之前先把旧部署扩容回来。
这两种做法都把人放在回路中作为安全机制。发布功能把这套机制移进了平台:你只需描述源、目标、步骤,以及“健康”的含义,平台就会在每个阶段按这份计划执行。
发布是如何工作的
一次发布会在同一端点上的两个部署之间迁移流量:源(今天正在提供服务的)和目标(你希望明天提供服务的)。你可以从三种策略中选择一种:
- 金丝雀:流量按你定义的分阶段百分比迁移(例如 10% → 50% → 100%;默认阶梯为 5% → 25% → 50% → 100%),每步之间有等待期和可选的指标检查。
- 蓝绿:一次带关卡的 0% → 100% 切换。可以把它看作单步的金丝雀。
- 滚动:原地逐个副本替换,保持总容量不变。最适合容量受限的场景,尤其是不需要流量爬升的同模型配置变更。
下面是每个金丝雀步骤内部发生的事情:
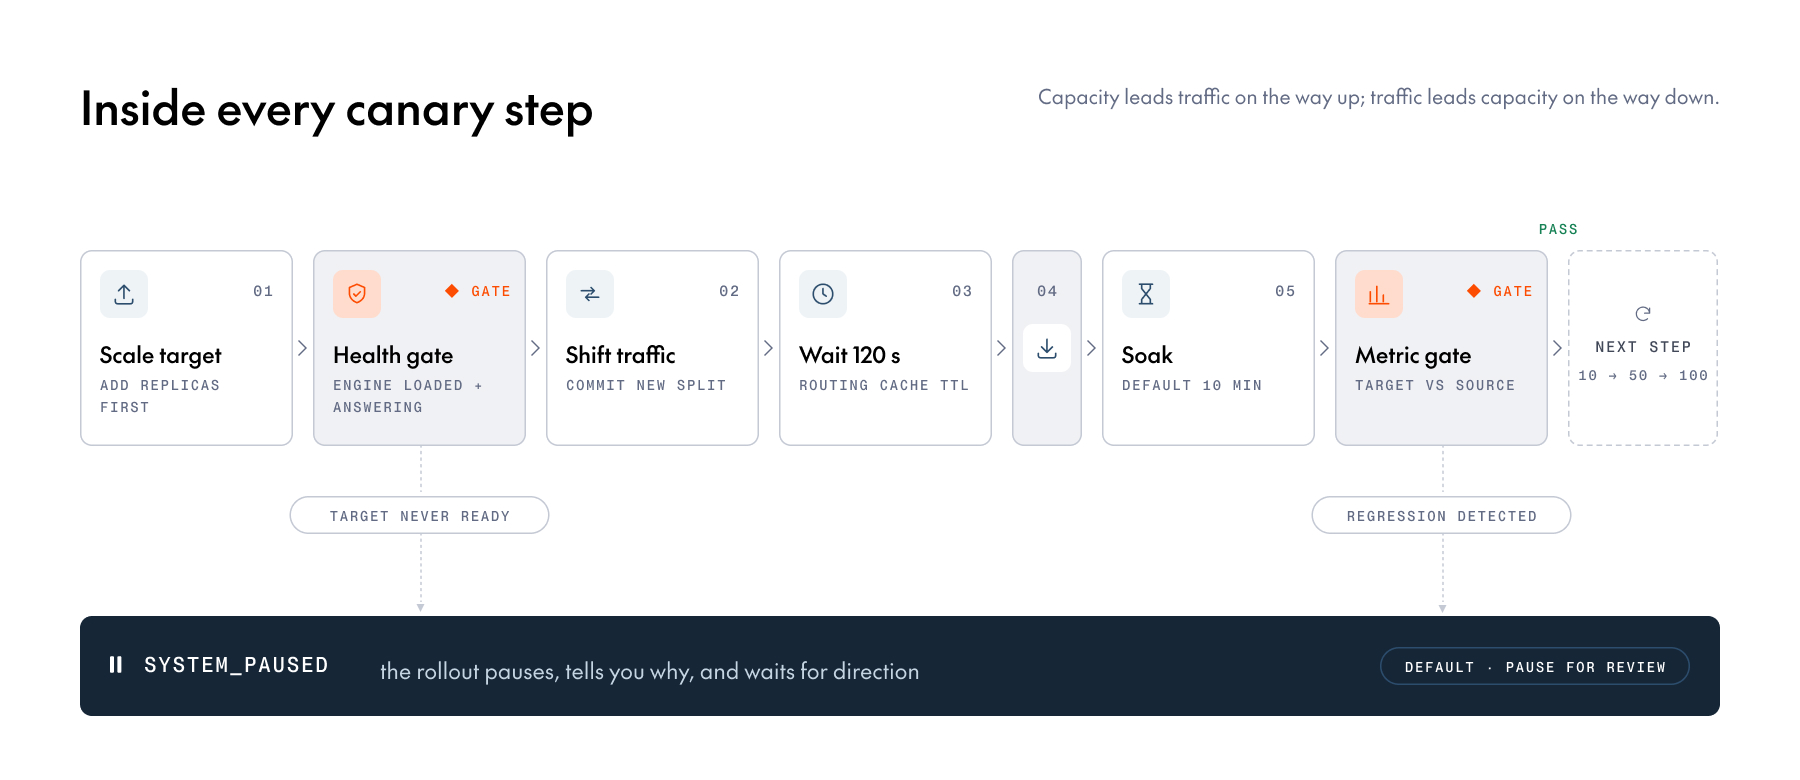
我们刻意选择了这个顺序,每一项都能防止一类事故:
- 目标在任何流量迁移之前先扩容。新部署没有容量,就不会有请求被重定向:发布会先停住。
- 健康关卡在流量切换之前运行。流量只会到达引擎已加载并能响应的副本,而不仅仅是已启动的副本。
- 在切换与排空之间有一段传播等待。路由缓存在任何源容量被移除之前完成收敛。
- 源在流量迁移之后才排空。扩容时容量先于流量,缩容时流量先于容量。
- 等待期和指标关卡先于该步骤被记录为完成。出现劣化的步骤绝不会被标记为通过。
无论通过 API 还是控制台,发布创建后都处于 PENDING 状态,在你明确启动之前不会做任何事(CLI 的 rollout 命令会一步完成创建和启动)。这种分两步的创建/启动是有意为之:你可以先创建发布,审阅它(或让同事审阅),等你真正盯着的时候再启动。
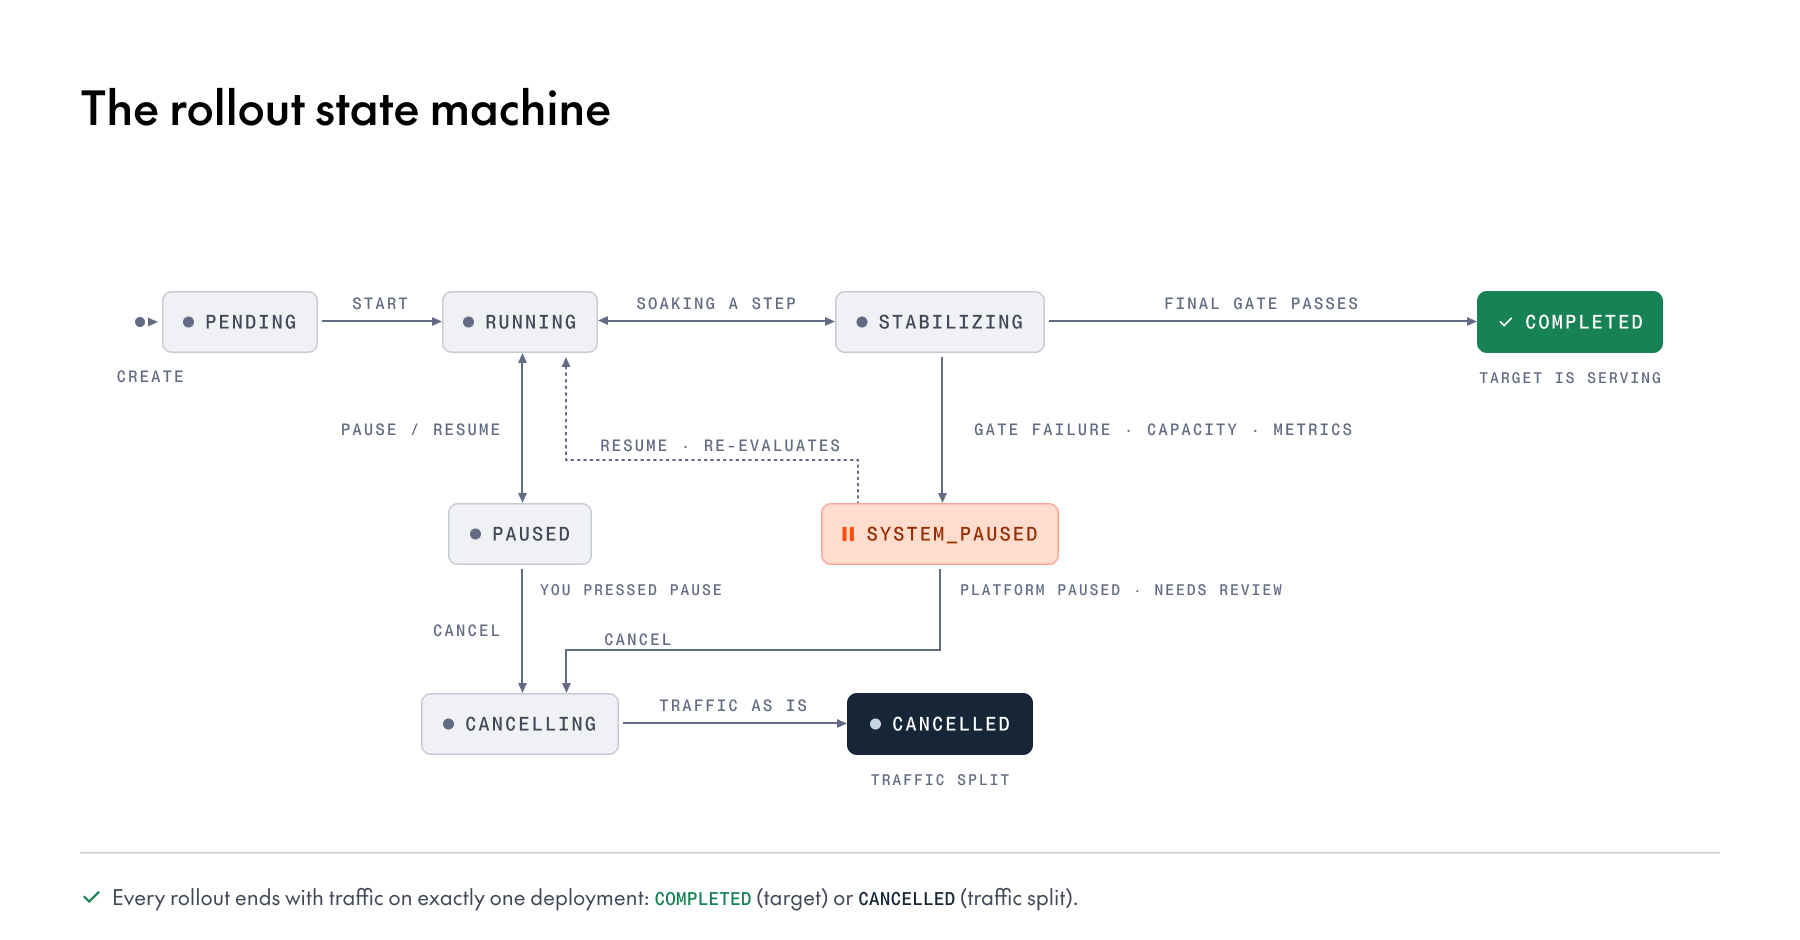
上图中有两个状态值得说明:
PAUSED表示你按下了暂停。发布会精确停留在当前位置,并从同一步骤继续。SYSTEM_PAUSED表示平台发现了问题,例如指标关卡失败、容量不足或缺少指标,于是停下来等待人工批准。它会暂停、通知你并等待;是否取消始终由你决定。
不存在让流量悬而未决的 FAILED 终态:发布要么以 COMPLETED 结束(目标提供服务),要么以 CANCELED 结束(流量划分冻结在原处,你可以反向运行发布以回退)。
一个步骤的剖析
下面拆解单个金丝雀步骤中发生的事情,数据来自本文末尾的那次运行(Qwen2.5-7B → Qwen3.5-9B,各使用一张 H100)。
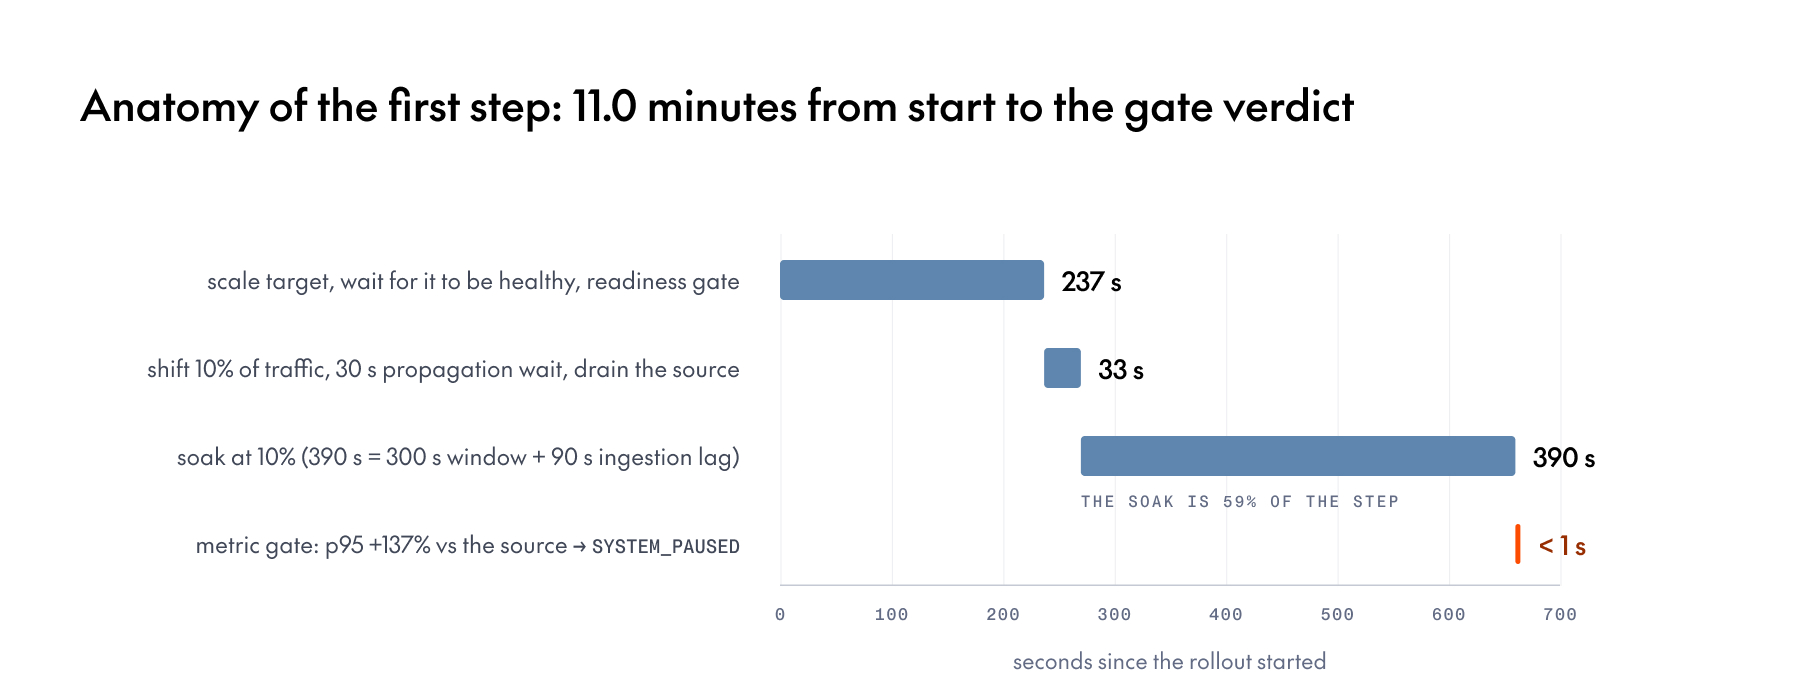
传播等待可防止过期的全局路由缓存把请求发送到正在缩减的源。等待期会延长到指标窗口加上摄取延迟。冷启动主导了第一步;后续步骤只是给已经在提供服务且已预热的目标增加副本。
策略选择一览
三种策略运行在同一个引擎和同样的健康关卡之上;区别在于流量如何迁移、重叠期需要多少额外容量,以及是否有供指标关卡使用的等待窗口。
| 金丝雀 | 蓝绿 | 滚动 | |
|---|---|---|---|
| 流量模式 | 按你选择的占比逐步推进(默认 5% → 25% → 50% → 100%),每步保持一个等待窗口 | 一次切换,0% → 100%,在目标健康之后进行 | 逐个副本替换,流量跟随副本比例 |
| 额外容量 | 接近源的规模;目标在源排空对应份额的前一步先增长 | 两个部署都保持满规模,直到源排空 | 每一步为源的副本数;步骤中途多一个副本 |
| 典型时长 | 一次冷启动,加上每步一次等待(带指标关卡时每步至少 390 秒) | 一次冷启动加 30 秒传播;几分钟 | 每个副本一次冷启动;大型部署上最慢 |
| 指标关卡 | 有,每步之后 | 无(没有等待窗口) | 无 |
| 如何回退 | 取消会冻结当前占比,然后反向运行发布 | 反向运行发布;--final-source-replicas 1 让旧模型保持预热,以便立即切回 |
反向运行发布 |
| 最适合 | 在拿下 100% 流量之前,先在线上流量上做测量 | 最快的切换,适合能短暂承受双倍容量的情况 | 在 GPU 占用不变的前提下更换同一模型的引擎或配置 |
创建发布
下面是一个三步金丝雀,从提供当前模型的部署切换到提供候选模型的部署,并带有延迟劣化关卡。CLI 随 together Python 包中的 tg 一起发布(2.34.0 或更新版本)。你需要传入目标部署;当恰好有一个部署在接收流量时,源会被自动推断,否则请传入 --source:
# 1. Create AND start the rollout in one command.
#    Intervals and windows are seconds with an "s" suffix ("600s", not "10m").
tg beta endpoints rollout $TARGET_DEPLOYMENT_ID \
  --source $SOURCE_DEPLOYMENT_ID \
  --canary \
  --steps 10,50,100 \
  --interval 600s \
  --metric router_latency --metric-stat p95 \
  --metric-max-regression 10 --metric-direction higher-is-worse \
  --metric-window 300s

# 2. Watch it move: pass the rollout ID printed under "Active Rollout",
#    or the endpoint ID for the endpoint summary
tg beta endpoints get $ROLLOUT_ID
tg beta endpoints get $ENDPOINT_ID

# 3. Control it: pass the endpoint ID plus exactly one control flag
tg beta endpoints rollout $ENDPOINT_ID --pause --reason "holding for review"
tg beta endpoints rollout $ENDPOINT_ID --resume
tg beta endpoints rollout $ENDPOINT_ID --promote
tg beta endpoints rollout $ENDPOINT_ID --cancel --reason "latency regression on target"
发布完成时,源会排空到零副本并停止(--final-source-replicas 默认为 0),目标落地时以源的副本数作为其下限(--final-target-replicas)。CLI 每次发布只附加一个指标关卡;若要设置多条规则,请使用控制台或 API。
通过 REST API 的做法相同,其中创建和启动是两个独立的调用,并且一次发布可以带有多条指标规则:
# 1. Create the rollout. It comes back in state PENDING; save its "id" (rol_...) as $ROLLOUT_ID.
curl -s -X POST \
  "https://api.together.ai/v2/projects/$PROJECT_ID/endpoints/$ENDPOINT_ID/rollouts" \
  -H "Authorization: Bearer $TOGETHER_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "sourceDeploymentId": "'$SOURCE_DEPLOYMENT_ID'",
    "targetDeploymentId": "'$TARGET_DEPLOYMENT_ID'",
    "canary": {
      "steps": [{"traffic": 10}, {"traffic": 50}, {"traffic": 100}],
      "stepInterval": "600s"
    },
    "metrics": [{
      "name": "router_latency",
      "stat": "METRIC_STAT_TYPE_PERCENTILE",
      "percentile": 95,
      "regressionCheck": {
        "direction": "REGRESSION_DIRECTION_HIGHER_IS_WORSE",
        "maxRegressionPercent": 10
      },
      "window": "300s"
    }]
  }'

# 2. Start it:   POST .../rollouts/$ROLLOUT_ID/start   -d '{}'
# 3. Watch it:   GET  .../rollouts/$ROLLOUT_ID
API 在几点上很严格:percentile 是整数(95,而不是 "p95"),枚举值带完整前缀(METRIC_STAT_TYPE_*、REGRESSION_DIRECTION_*、THRESHOLD_OPERATOR_*),时长是类似 "600s" 的 protobuf 字符串,而目录之外的指标名会被拒绝,并返回列出支持名称的 400 错误。排空源是默认行为,所以无需为此传任何参数。
劣化检查可以这样理解:在每个关卡,将目标在过去 5 分钟内的 p95 路由器延迟(在路由器处测得的每请求耗时,单位为毫秒)与源的进行比较。如果目标差出 10% 以上,就不继续推进。
Python SDK
用 together 包(2.34.0 或更新版本)在 Python 中完成同样的发布。这里的字段名是 snake_case,传输时是 camelCase;SDK 会自动转换。
from together import Together

client = Together()  # reads TOGETHER_API_KEY

rollout = client.beta.endpoints.rollouts.create(
    endpoint_id=ENDPOINT_ID,
    project_id=PROJECT_ID,
    source_deployment_id=SOURCE_DEPLOYMENT_ID,
    target_deployment_id=TARGET_DEPLOYMENT_ID,
    canary={"steps": [{"traffic": 10}, {"traffic": 50}, {"traffic": 100}], "step_interval": "600s"},
    metrics=[{
        "name": "router_latency", "stat": "METRIC_STAT_TYPE_PERCENTILE", "percentile": 95,
        "regression_check": {"direction": "REGRESSION_DIRECTION_HIGHER_IS_WORSE", "max_regression_percent": 10},
        "window": "300s",
    }],
)  # state: PENDING

client.beta.endpoints.rollouts.start(rollout.id, project_id=PROJECT_ID, endpoint_id=ENDPOINT_ID)

# later: .retrieve / .pause / .resume / .promote / .cancel take the same (id, project_id, endpoint_id)
控制发布
每个发布都接受同样的四种控制操作。一个端点最多只有一个活跃发布,所以 CLI 接收端点 ID,你很少需要发布 ID。每个控制操作一旦被接受就会返回;请轮询 tg beta endpoints get(或 GET 端点),直到发布达到你预期的状态。发布处于活跃状态期间(包括暂停期间),端点的流量划分被锁定,其源和目标不能被停止或删除。
暂停
发布进入 PAUSING,让正在进行的步骤操作完成,然后保持在当前的流量划分和副本数,状态为 PAUSED。两个部署都继续提供服务。暂停可以持续数天;平台绝不会自动恢复由运维人员发起的暂停。
CLI
tg beta endpoints rollout $ENDPOINT_ID --pause --reason "holding for review"
REST
POST …/rollouts/$ROLLOUT_ID/pause
{"reason": "holding for review"}
恢复
从同一步骤继续,对 PAUSED 和 SYSTEM_PAUSED 均适用。如果某个关卡被触发,它会基于最新数据重新评估;该步骤不会被跳过。
CLI
tg beta endpoints rollout $ENDPOINT_ID --resume
REST
POST …/rollouts/$ROLLOUT_ID/resume
{}
提升(Promote)
跳过剩余的金丝雀步骤,完整执行最后的 100% 步骤:目标扩容到落地规模,流量切换,执行传播等待和浸泡观察(soak),然后源排空。被跳过的步骤会记录为 SKIPPED。并非瞬间完成:在一次步骤间隔为 10 分钟的测试运行中,在第 0 步执行提升,仍然完整经历了最后一步的整个浸泡观察。
CLI
tg beta endpoints rollout $ENDPOINT_ID --promote
REST
POST …/rollouts/$ROLLOUT_ID/promote
{}
取消
把当前流量划分冻结为端点的常驻权重,并以 CANCELED 结束发布。不会缩容任何东西;两个部署继续服务各自冻结的份额,直到你修改划分或运行反向发布。在 0% 时被取消的目标会继续运行但没有流量;如果不再需要,请将其缩容到零或删除。
CLI
tg beta endpoints rollout $ENDPOINT_ID --cancel --reason "latency regression on target"
REST
POST …/rollouts/$ROLLOUT_ID/cancel
{"reason": "latency regression on target"}
反向发布
没有“回滚”这个动词。要把流量移回去,无论是在取消之后还是完成之后,都需要创建一个源与目标互换的新发布,然后启动它。任何策略都可以,同样的关卡也适用。取消之后,默认的金丝雀阶梯会跳过新目标已经通过的步骤,默认的最终副本数是这对部署副本数之和。
CLI
tg beta endpoints rollout $OLD_SOURCE_ID --source $OLD_TARGET_ID --canary
REST
POST …/rollouts        (with the two IDs swapped)
POST …/rollouts/$NEW_ROLLOUT_ID/start
对已结束的发布(COMPLETED 或 CANCELED)的控制操作会被拒绝。可以用 tg beta endpoints rm $ROLLOUT_ID 从历史中删除已结束或从未启动的发布;删除记录不会改变它留下的流量划分。
底层机制:配置关卡
指标关卡
指标关卡是金丝雀的功能:蓝绿和滚动仍会运行健康关卡,但分阶段的指标比较需要金丝雀的步骤结构才有意义。关卡基于由三项路由器侧指标组成的封闭目录进行评估,源和目标的测量方式完全相同(其他任何指标名都会在创建时被拒绝):
router_error_rate:路由器 5xx 响应数除以全部推理响应数,以 0-1 的比值表示(0.02 即 2%)router_latency:在路由器处测得的每请求耗时,单位为毫秒。它呈双峰分布(中位数尝试通常是快速拒绝),因此应基于p95或更高分位数设置关卡,而不是平均值inflight_requests:每个就绪副本上的并发请求数,在窗口内取平均(阈值应按每个副本而非整个集群来设定)
每条规则使用两种检查之一:
regressionCheck(相对):“目标的劣化幅度不得超过源的 N%。”这是延迟的合理默认选项,因为它能自我校准:你不需要知道自己绝对的 p95 是多少,只需要新模型不会使其变差。设置direction,让平台知道哪个方向更好/更差。thresholdCheck(绝对):“目标必须满足operator, value”(例如错误率< 0.01)。当你有硬性的 SLO,或者源本身可能不健康、相对比较会“放水”时,就用这种。
两种配方可覆盖大多数服务:
// Latency-sensitive service: don't ship anything meaningfully slower
{
  "name": "router_latency",
  "stat": "METRIC_STAT_TYPE_PERCENTILE",
  "percentile": 95,
  "regressionCheck": {
    "direction": "REGRESSION_DIRECTION_HIGHER_IS_WORSE",
    "maxRegressionPercent": 10
  },
  "window": "300s"
},
// Error-budget shop: hard ceiling regardless of what the source is doing
{
  "name": "router_error_rate",
  "stat": "METRIC_STAT_TYPE_AVG",
  "thresholdCheck": {
    "operator": "THRESHOLD_OPERATOR_LT",
    "value": 0.01
  },
  "window": "300s"
}
时间窗口
有三个时长相互作用,所以要把它们都放在心上:
window(默认 5m):关卡比较指标时回看多久。stepInterval(默认 3m):每一步在其流量水平上等待多久才运行关卡。- 指标摄取延迟(约 90 秒):从请求被处理到其数据点可被查询之间的时间。
你必须至少等待 window + ingestion lag 的时长,这样关卡的整个回看区间才会落在当前步骤的稳态内。如果等待时间短于窗口,关卡比较的指标就会有一部分描述的是上一个流量划分。平台会为你强制保证这一点:如果你请求的等待期对于你的窗口太短,它会自动加长。不过,设计时仍然最好把这一点考虑进去:5 分钟的窗口需要 6.5 分钟的等待期。在默认 5 分钟窗口下,平台会把默认的 3 分钟间隔延长到 390 秒(6 分 30 秒);如果你设置自己的 stepInterval,请至少设为 window + 90s。
出现劣化时会发生什么
默认情况下,被触发的关卡会路由到 SYSTEM_PAUSED,这意味着系统会暂停以供审阅。发布保持在当前划分上(影响范围就是你设定的金丝雀百分比),由你来决定:恢复(关卡重新评估)、提升或取消。
不存在自动中止:已确认的劣化总是让发布停下来等人处理,因为把流量移回去本身也是一次变更,应该有人盯着。可恢复的原因则不同,例如容量不足或指标管道出现缺口:平台会每 15 分钟重试一次,最长持续 3 小时,之后才让发布保持暂停等你处理。平台还会防范误报:在因劣化而暂停之前,系统会在约 90 秒内重新查询多次,确认看到的不是摄取延迟或瞬时波动;无法获得可信数据的关卡会以 METRICS_UNAVAILABLE 暂停,而不是被算作劣化。
平台保证什么
三种策略都运行在同一个步骤引擎上,因此以下各条对金丝雀、蓝绿和滚动同样成立。
1. 容量绝不向下取整。目标副本数向上取整,源的排空向下取整,因此同规模替换时副本数永远不会少于起始值。滚动在步骤中途多加一个副本;蓝绿会短暂地让两个部署都保持满规模。你的自动扩缩器在计划之上额外增加的副本会被保留。
2. 流量绝不会落到尚未就绪的容量上。每一步都按同一顺序执行:扩容目标、检查健康、切换流量、等待 30 秒让路由收敛、排空源、等待、评估关卡、记录该步骤。在等待期间出现劣化的步骤绝不会被记录为通过。
3. 每一侧始终拥有其份额所需的副本。只有当目标有足够的就绪副本承载新的份额时才会移动流量,源也绝不会被排空到低于其剩余份额。如果某个副本挂掉导致当前划分无法继续承载,发布会保持在它能承载的最大划分上,并以 UNDER_SERVED 暂停。
4. 发布只抬高下限,不与你的自动扩缩器对抗。每一步只写入各部署的最小副本数,不动其他任何东西,只有一个例外:目标的最大值会被提升一次,使其能承载整个端点,并保持在提升后的值。源的最大值在排空过程中随其份额缩小。如果你把最大值调到低于该步骤所需,发布会以 POLICY_INFEASIBLE 暂停,而不是覆盖你的设置。
5. 关卡总会给出结论。当目标处于源的百分比预算之内时,劣化检查通过。没有源数据时通过;在“越高越差”的指标上,源为零而目标非零则失败;其他任何源为零的情况均通过。阈值检查忽略源,直接将目标与你设定的值比较。
6. 关卡只读取当前步骤的流量,而且只读取足够的量。等待期至少为指标窗口加上约 90 秒的摄取延迟,所以 300 秒的窗口意味着 390 秒的等待。p95 要求窗口内有 20 个请求,p99 要求 100 个;少于这个数,发布会以 METRICS_UNAVAILABLE 暂停。错误率和在途请求数只需要一个请求。
边界情况
1. 如果目标没有 GPU 容量怎么办?
发布会在动任何东西之前,先对整个过程做可行性检查,并在每次扩容时再次检查。容量不足会让发布以 CAPACITY_EXHAUSTED 类别暂停在 SYSTEM_PAUSED。此时没有任何东西被移动,你的源也未受影响。恢复会重新检查容量,如果已经腾出就继续。容量问题通常是暂时的,所以暂停好过失败。
2. 可以无限期暂停吗?
可以。暂停不是一个被占用的连接,而是一等公民状态。发布被设计为能够经受多天的暂停,并精确地从中断处恢复。
当平台暂停一个发布时,status.condition 会携带一个带类型的失败类别,以及一段人类可读的 message。这些类别包括:
| 类别 | 含义 | 你应该 |
|---|---|---|
METRIC_REGRESSION |
关卡在真实数据上被触发 | 检查该步骤的指标读数;如果问题出在目标,就取消并反向运行发布;如果原因来自外部,就恢复 |
METRICS_UNAVAILABLE |
关卡无法获得可信数据 | 检查指标名称/窗口;恢复会重新评估 |
CAPACITY_EXHAUSTED |
下一步所需的 GPU 不足 | 等待或腾出容量,然后恢复 |
UNDER_SERVED |
某一侧的就绪容量低于当前划分所需 | 恢复容量(会自动重试);如果暂停持续,则恢复 |
POLICY_INFEASIBLE |
自动扩缩限制无法满足该计划 | 提高目标的最大副本数,然后恢复 |
文档列出了其余类别以及各自的处理方法:发布故障排查。
真实发布演示
亲眼看过一次实际运行之后,上面的一切会更让人信服,所以这里给出在当前平台(2026 年 9 月)上的一次运行。我们把一个线上端点从 Qwen2.5-7B-Instruct 升级到 Qwen3.5-9B,两者各占一张 H100,同时全程有稳定的每秒 5 个聊天补全请求流经该端点,并且记录了每一个响应码。新模型是我们想要的;发布要回答的问题是,它是否符合旧模型设定的延迟预算。我们给它设了 25% 的 p95 预算。
准备。7B 已经在提供服务。我们把 9B 作为同一端点上的第二个部署添加进来,没有流量,也没有副本;需要时由发布来启动它。
# $MODEL_ID is Qwen/Qwen3.5-9B-FP8. --config is optional when the model has exactly one serving config.
tg beta endpoints deploy $MODEL_ID --endpoint $ENDPOINT_ID --config $CONFIG_ID \
  --min-replicas 0 --max-replicas 0 --traffic-weight 0
启动。一条命令即可创建并启动金丝雀:10% → 50% → 100%,并带有一个关卡,在每一步之后用 5 分钟的窗口比较目标与源的 p95 路由器延迟。
tg beta endpoints rollout $TARGET_DEPLOYMENT_ID --source $SOURCE_DEPLOYMENT_ID \
  --canary --steps 10,50,100 \
  --metric router_latency --metric-stat p95 \
  --metric-max-regression 25 --metric-direction higher-is-worse \
  --metric-window 300s
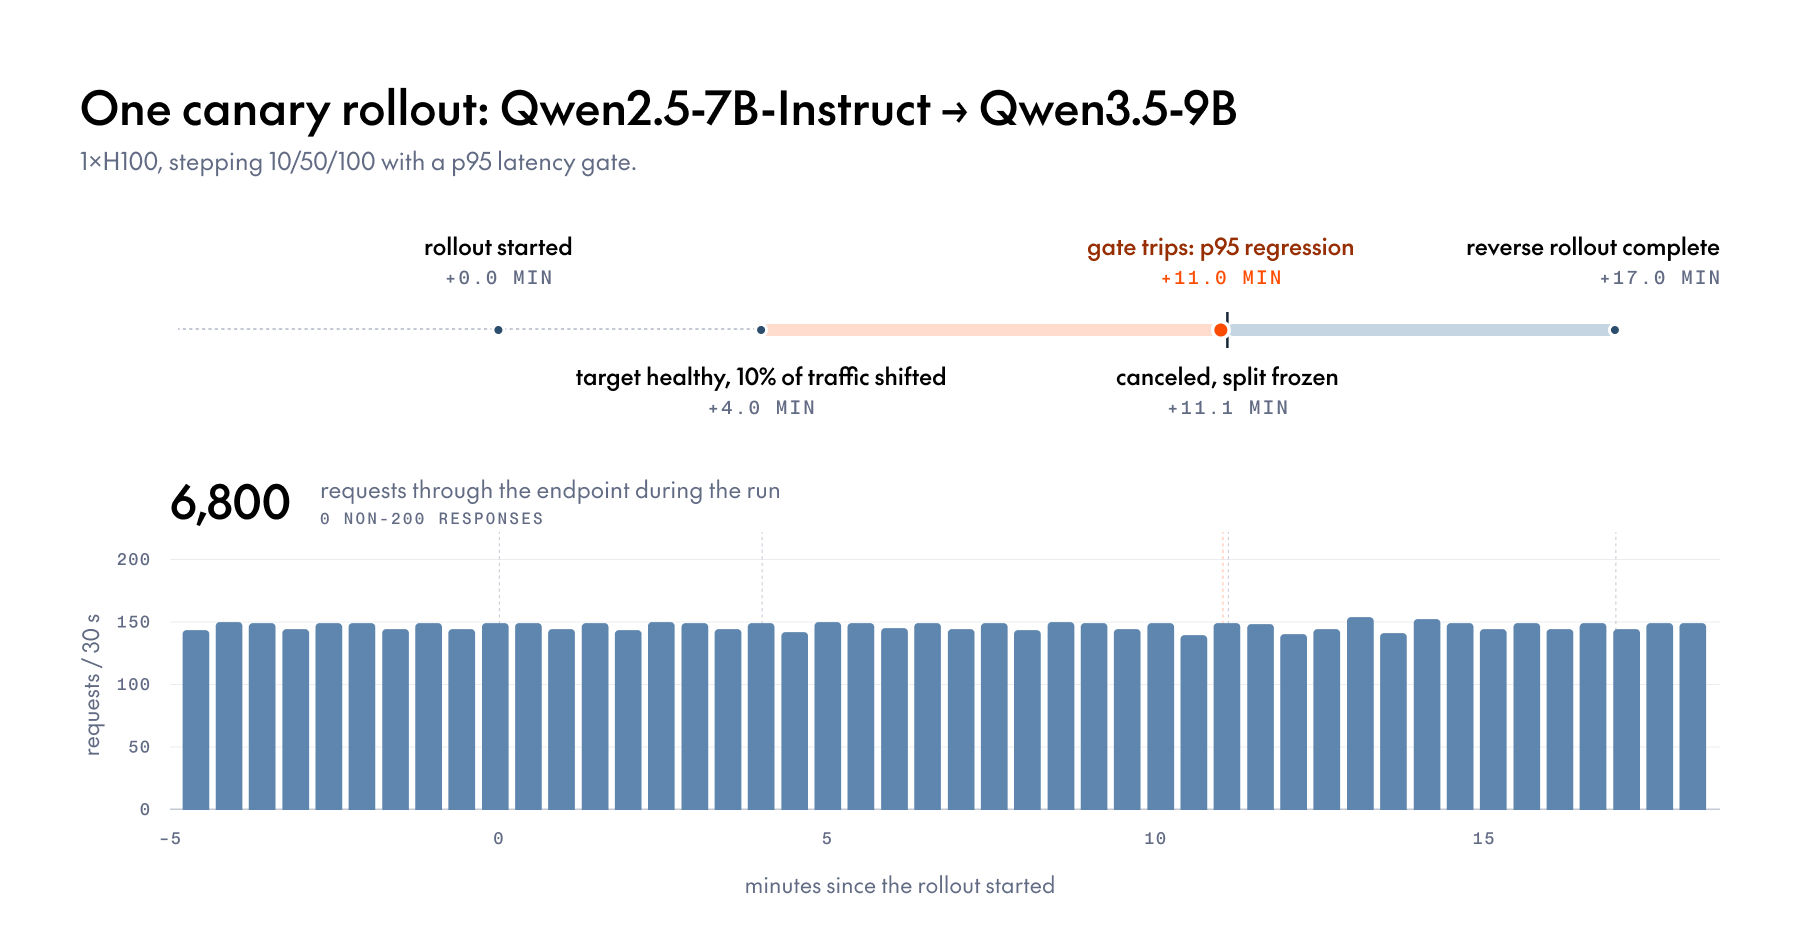
按时间线看发生了什么(自发布开始起算的时间):
- +3:57 9B 完成冷启动,通过健康检查,10% 的请求开始落到它上面。发布等待 30 秒让路由收敛,排空 7B 中对应的份额,然后进入浸泡观察。我们把步骤间隔保留为默认值,因此平台将其延长到 390 秒,以覆盖 300 秒的窗口加上摄取延迟。
- +11:00 关卡完成评估并被触发。9B 的 p95 路由器延迟为 1,740 ms,而 7B 为 734 ms,相对 25% 的预算出现了 137% 的劣化。发布进入
SYSTEM_PAUSED,目标上仍有 10% 的流量,没有任何东西被拆除。这是tg beta endpoints get $ROLLOUT_ID --json返回的内容(数值单位为毫秒):
"state": "ROLLOUT_STATE_SYSTEM_PAUSED",
"currentTrafficPercent": 10,
"pauseInfo": {
  "reason": "metrics-regression: regression check router_latency failed: target=1740.38 vs source=734.20, regression=137.05% exceeds max=25.00% (direction=REGRESSION_DIRECTION_HIGHER_IS_WORSE)",
  "pausedAt": "2026-09-16T20:50:45Z"
},
"status": {
  "condition": {
    "category": "ROLLOUT_FAILURE_CATEGORY_METRIC_REGRESSION",
    "atStep": 0,
    "metrics": [
	    {
		    "name": "router_latency",
		    "stat": "METRIC_STAT_TYPE_PERCENTILE",
		    "percentile": 95,
		    "check": "METRIC_CHECK_TYPE_REGRESSION",
		    "sourceValue": 734.20,
		    "targetValue": 1740.38,
		    "maxRegressionPercent": 25,
		    "direction": "REGRESSION_DIRECTION_HIGHER_IS_WORSE",
		    "verdict": "METRIC_VERDICT_BREACHED"
	    }
    ]
  }
}
决策。这次劣化是真实的,不是瞬时波动:9B 是推理模型,在相同的 max_tokens 下,每个请求生成的内容更多。这是一个产品层面的决策,而不是靠恢复就能越过的问题,所以我们选择取消并退回。
tg beta endpoints rollout $ENDPOINT_ID --cancel --reason "p95 latency regression on the Qwen3.5 target"
# split frozen at 90% / 10%; both deployments keep serving

tg beta endpoints rollout $SOURCE_DEPLOYMENT_ID --source $TARGET_DEPLOYMENT_ID --blue-green
# the 7B takes 100% back, the 9B drains to zero
- +11:09
CANCELED。命令发出后 0.2 秒内,流量划分就冻结在了 90/10。 - +17:00 反向发布完成,距其启动 5 分 49 秒:100% 的流量回到 7B,9B 排空到零并停止。这段时间的大部分花在第二个 7B 副本的冷启动上,因为取消之后,默认的最终副本数是这对部署副本数之和。
探针在整个运行过程中的结论,包括流量迁移、暂停、取消和反向发布:6,800 个请求,0 个非 200 响应。
审计轨迹。上面的每一步都记录在端点的事件流中,可按发布 ID 过滤:
tg beta endpoints events $ENDPOINT_ID --subject-id $ROLLOUT_ID --json
20:39:45  rollout.created           canary rollout created: dep_src → dep_tgt, 3 step(s) to 100%
20:39:45  rollout.started           rollout started: step 1 of 3 targets 10% traffic
20:43:42  rollout.traffic_shifted   0% → 10%   target traffic: 0% → 10%
20:50:45  rollout.system_paused     paused automatically at step 1 of 3: a metric check failed
20:50:54  rollout.canceled          cancel requested; traffic will be frozen at the current split
20:50:54  rollout.canceled_complete canceled: traffic frozen at 90%/10% (source/target)
7 月份的一次早期运行刻意设置了一个不可能满足的阈值关卡,得到了同样的结果:在 10% 流量时被触发,恢复期间 1,198 个探针请求零错误。
自己试试吧!
1. 一个端点上的两个部署。把你当前的部署保留为源,再把候选模型作为零流量的目标添加进来。pip install -U together(2.34.0 或更新版本)提供 tg CLI:
# A stopped, zero-traffic target; the rollout restarts it when it scales it up.
# Add --config cr_... to pin a specific config revision.
tg beta endpoints deploy $MODEL --endpoint $ENDPOINT_ID \
  --min-replicas 0 --max-replicas 0 --traffic-weight 0
2. 创建并启动金丝雀,使用默认阶梯(5% → 25% → 50% → 100%)和一个 router_latency 劣化关卡:
tg beta endpoints rollout $TARGET_DEPLOYMENT_ID --canary \
  --metric router_latency --metric-stat p95 \
  --metric-max-regression 10 --metric-direction higher-is-worse
3. 观察它,用 tg beta endpoints get $ENDPOINT_ID(或控制台中端点的 Rollouts 标签页)查看它逐步推进。用 tg beta endpoints rollout $ENDPOINT_ID --pause | --promote | --cancel 暂停、提升或取消它。
全程中,端点 URL 和你的客户端保持不变;变化的只是它们背后的模型。
📚 文档:启动发布 · 用指标为发布设置关卡 · CLI 参考 · API 参考:创建发布