过去六年里,Cloudflare 的 Wrangler CLI 发布了多个主要版本,每个版本至少都对命令、配置或开发者与平台的交互方式做了一些关键性变更。与任何积极维护的开源项目一样,我们保留了旧版本的文档。v1 文档带有弃用横幅、noindex 元标签,以及指向当前文档的 canonical 标签。所有的建议性信号都在表达同一个意思:这些内容已经过时,请到别处查看。但 AI 训练爬虫并不会可靠地遵守这些信号。
我们在 developers.cloudflare.com 上使用 AI Crawl Control,因此知道属于 AI Crawler 类别的机器人在过去 30 天里访问了 480 万次,而且它们抓取已弃用内容的频率与抓取当前内容的频率相当。这些建议性信号没有产生任何可测量的影响。这种影响是累积的,因为 AI 智能体并不总是实时获取内容,而是依赖训练好的模型。当爬虫摄取了已弃用的文档,智能体继承的就是过时的基础。
今天,我们推出 Redirects for AI Training,让你可以强制已验证的 AI 训练爬虫被重定向到最新的内容。在所有付费的 Cloudflare 套餐上,只需一个开关,你现有的 canonical 标签就会自动变成面向已验证 AI 训练爬虫的 HTTP 301 重定向。
而且,由于状态码归根结底是网络向爬虫传达策略的方式,Radar 的 AI Insights 页面现在新增了响应状态码分析,展示 AI 爬虫在 Cloudflare 全部流量中收到的各类状态码,包括成功(2xx)、重定向(3xx)、客户端错误(4xx)和服务器错误(5xx),以此呈现当下网络如何回应 AI 爬虫。
AI 训练爬虫如今面临死胡同
对搜索引擎而言,noindex 是一套丰富的信号系统,但页面上并没有等效的内联指令可以表达“不要用它来训练”。让已弃用的页面带着警告横幅继续在线,对人类读者也许有效,他们会读到提示然后转往别处;但 AI 训练爬虫会摄取全文,很可能把横幅当作又一个普通段落,即使警告已经可见,也依然成千上万次地回来抓取。
屏蔽又会带来自己的问题:它造成了一片空白,没有给出爬虫应该转而学习什么的任何信号。robots.txt 只能提供有限的保护,而且随着自动化流量的增长,按爬虫、按路径、按内容更新逐一维护指令,需要大量的人工维护。爬虫需要的是明确的指引:“当前的内容在这里。”
<link rel="canonical"> 标签是 RFC 6596 中定义的一种 HTML 元素,用来告诉搜索引擎和自动化系统哪个 URL 代表页面的权威版本。65-69% 的网页上已经有这个标签,EmDash、WordPress 和 Contentful 等平台也会自动生成它。这套基础设施声明了你内容的当前版本是什么,而 Redirects for AI Training 负责强制执行。
工作原理
Redirects for AI Training 依据两项输入:Cloudflare 的 cf.verified_bot_category 字段,以及你 HTML 中已有的 <link rel="canonical"> 标签。AI Crawler 类别涵盖为训练 AI 模型而抓取的机器人,包括 GPTBot、ClaudeBot 和 Bytespider,它不同于涵盖 AI 智能体的 AI Assistant 和 AI Search 类别。
当来自已验证 AI Crawler 的请求到达时,Cloudflare 会读取响应的 HTML。如果存在非自引用的 canonical 标签,Cloudflare 会在返回响应之前,向该 canonical URL 发出 301 Moved Permanently。人类流量、搜索索引以及其他自动化流量不受影响。
下面是 GPTBot 请求某个已弃用路径时的交互过程:
GET /durable-objects/api/legacy-kv-storage-api/

Host: developers.cloudflare.com

User-Agent: Mozilla/5.0 (compatible; GPTBot/1.1; +https://openai.com/gptbot)
HTTP/1.1 301 Moved Permanently

Location: https://developers.cloudflare.com/durable-objects/api/sqlite-storage-api/
它不做什么
它不会追溯修正已被摄取的训练数据,也不覆盖 AI Crawler 机器人类别之外的未验证爬虫。访问已弃用页面的人类和 AI 智能体不会被重定向。我们还在设计上排除了跨源 canonical(即指向不同域名上首选 URL 的标签),因为它们常用于域名整合,而非内容新鲜度。为避免循环,自引用的 canonical(页面上指向其自身 URL 的标签)同样不会触发重定向。
为什么不直接用重定向规则?
Single Redirect Rules 可以按 user-agent 字符串针对 AI 爬虫,如果站点只有少数几个已知的已弃用路径,这样做是可行的。但它无法扩展:每新增一个已弃用路径都要修改规则,user-agent 必须手动跟踪,而且还会占用本可用于活动 URL 或域名迁移的套餐限额。重定向规则还相当于手动重新编码 canonical 标签已经声明的内容,并且会随着内容变化而失去同步。
我们在自家文档站点上的发现
我们自己的经历表明,这个问题是真实存在的。我们在 developers.cloudflare.com 上运行 AI Crawl Control,使用的正是所有 Cloudflare 客户都能用的同一个仪表板。2026 年 3 月,旧版 Workers 文档被 OpenAI 抓取了约 46,000 次,被 Anthropic 抓取了 3,600 次,被 Meta 抓取了 1,700 次。
对已弃用页面的这些抓取,也许就是 2026 年 4 月我们向一款领先的 AI 助手提问“如何使用 Wrangler CLI 写入 KV 值?”时,它给出过时答案的原因:“你可以通过 Wrangler CLI 使用 kv:key put 命令写入 Cloudflare KV。”
实际上,正确的语法(截至 2026 年 4 月)是 wrangler kv key put;冒号语法(kv:key put)已在 Wrangler 3.60.0 中弃用。我们的文档带有内联的弃用提示,但训练流水线如何解读这些提示尚不清楚。
于是,我们在 developers.cloudflare.com 上启用了 Redirects for AI Training,并衡量了效果。在最初的七天里,AI 训练爬虫对带有非自引用 canonical 标签的页面发起的请求,100% 都被重定向,没有获得已弃用的内容。
我们预期,把爬虫重定向到当前内容,最终会改善 AI 生成的关于旧版工具的回答。鉴于训练流水线的封闭性以及重新抓取时间的不确定性,这是一个我们将持续验证的假设。但在访问当下,爬虫拿到的内容已经立即得到了改善。
如何启用
如果你的站点有 canonical 标签,现在就可以针对已验证的 AI 训练爬虫,强制执行你现有的内容层级。爬虫的识别由 Cloudflare 的已验证机器人分类自动处理。
在仪表板中:在任意域名下,依次进入 AI Crawl Control > Quick Actions > Redirects for AI training > 打开开关。
如需通过 Configuration Rules 和 Cloudflare for SaaS 按路径进行控制,请参阅完整文档。
网络如何回应 AI 爬虫
Redirects for AI Training 把一个状态码 301 Moved Permanently 变成了执行内容策略的机制。但 301 只是源站与爬虫之间更广泛对话中的一个信号。200 OK 表示内容已提供。403 Forbidden 表示访问被阻止。402 Payment Required 则告诉客户端它需要付费才能访问。综合来看,AI 爬虫流量中状态码的分布,揭示了整个网络在规模上究竟是如何回应爬虫的。
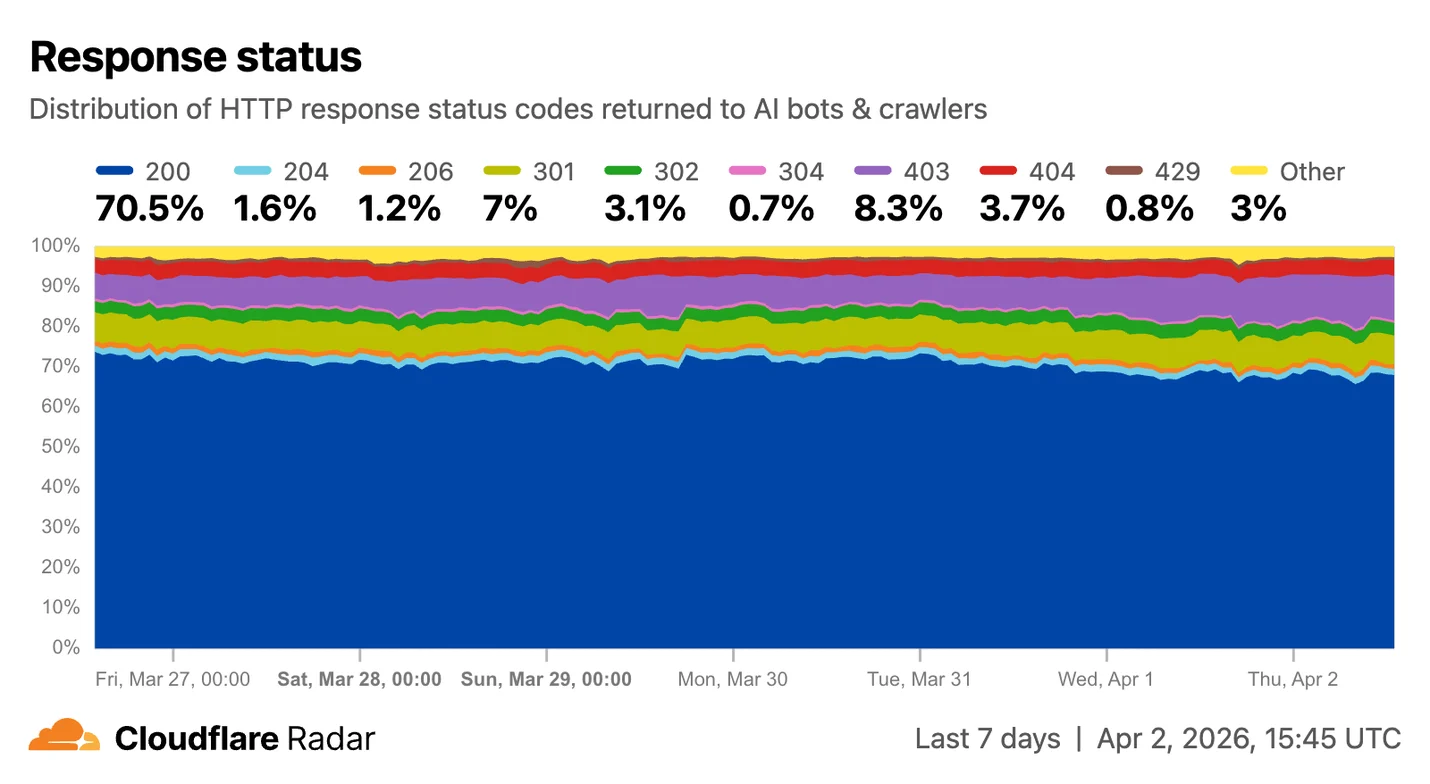
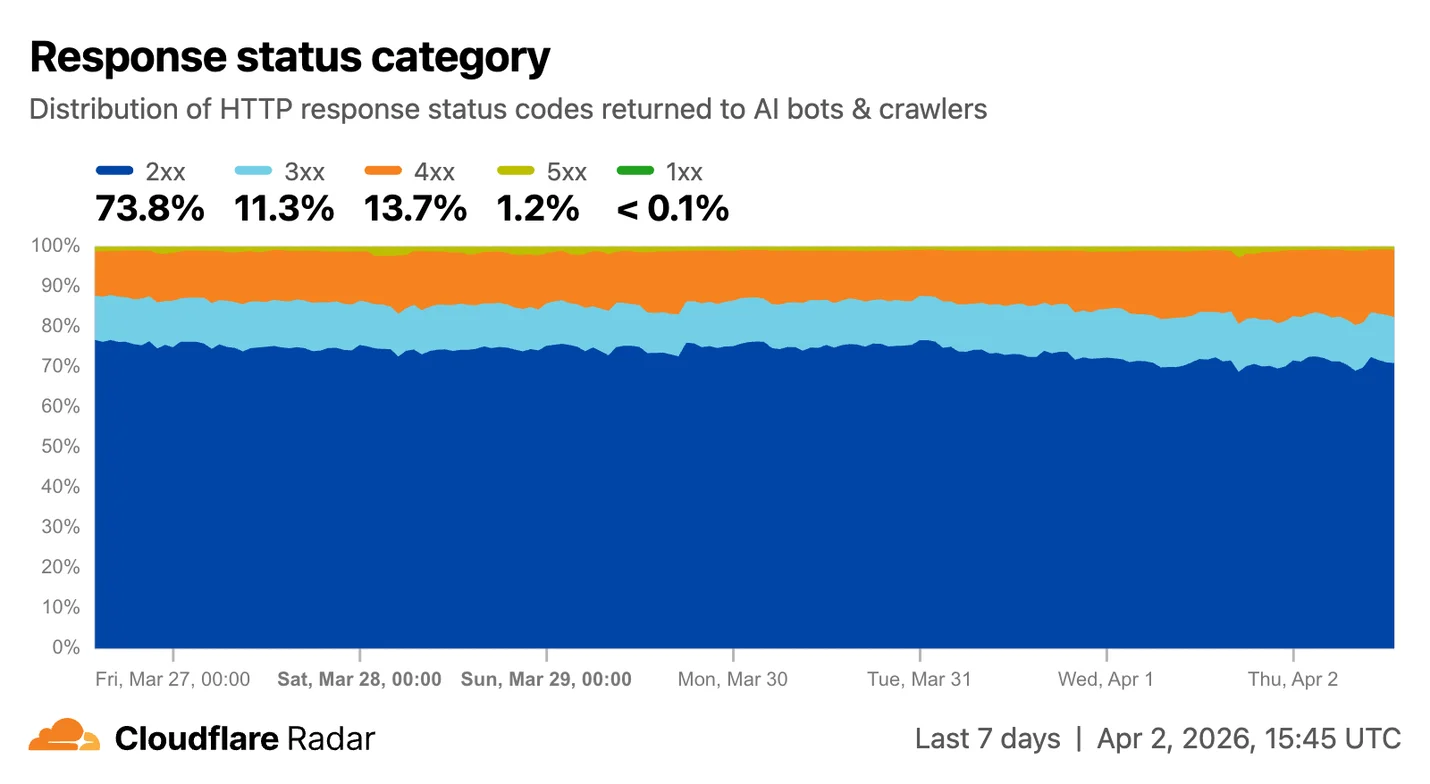
Radar 的 AI Insights 页面现在包含一张响应状态码分析图表,展示 AI 爬虫流量中排名靠前的响应状态码或响应状态码分组的分布(可通过下拉菜单选择)。数据可以按行业集合筛选;抓取目的筛选器也可以在 Data Explorer 中应用。经过筛选的分析可以让你了解不同类型的爬虫行为是否有差异,或者请求模式和分布是否因行业而异。
在下方的总体示例中可以看到,在图表所涵盖的时间段内,略高于 70% 的请求被成功处理(200),10.1% 的请求被重定向(301、302)到另一个 URL,3.7% 请求的是未找到的文件(404)。有 8.3% 的请求被阻止访问内容,收到的响应状态码为 403。按分组来看,近 74% 的请求收到了成功响应(2xx),13.7% 收到了客户端错误响应(4xx),11.3% 收到了重定向消息(3xx),1.2% 收到了服务器错误响应(5xx)。
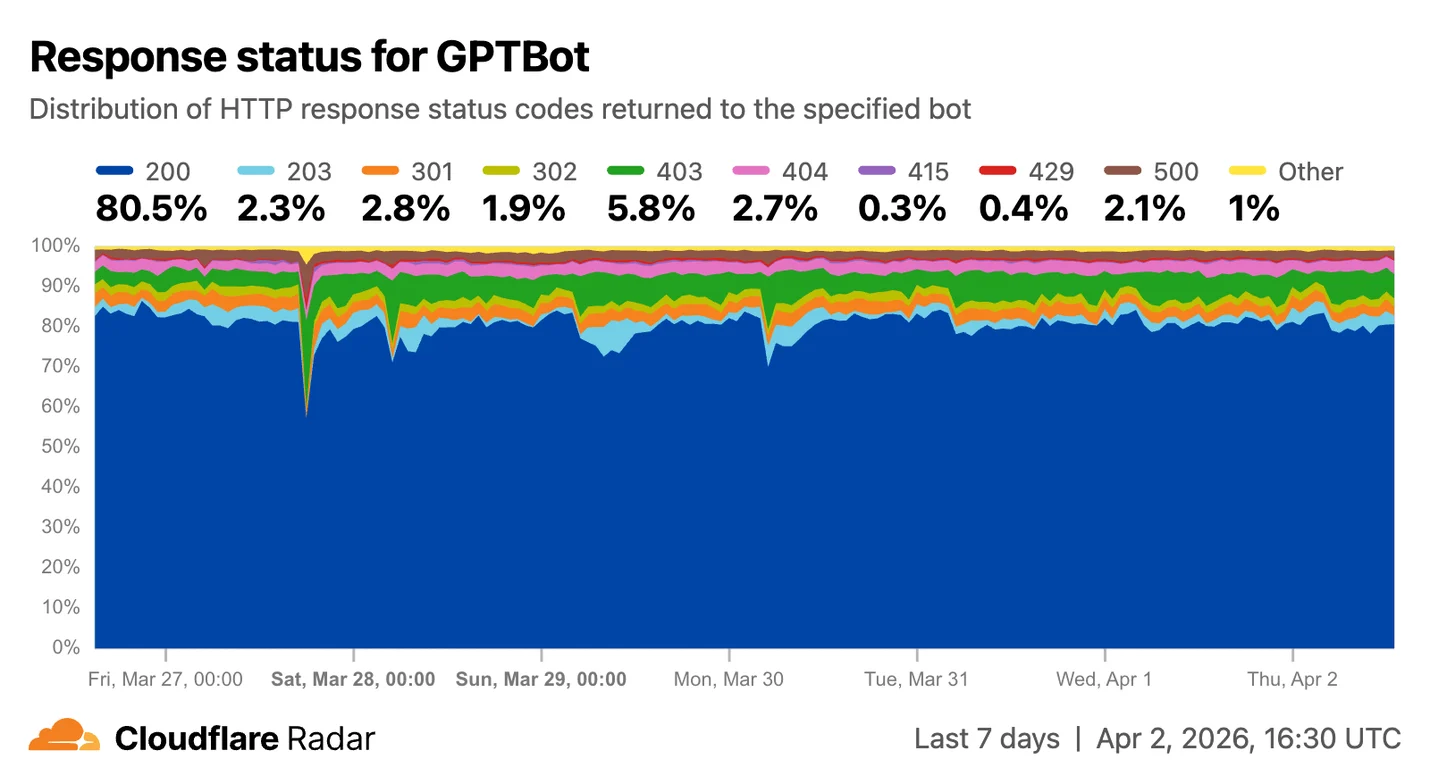
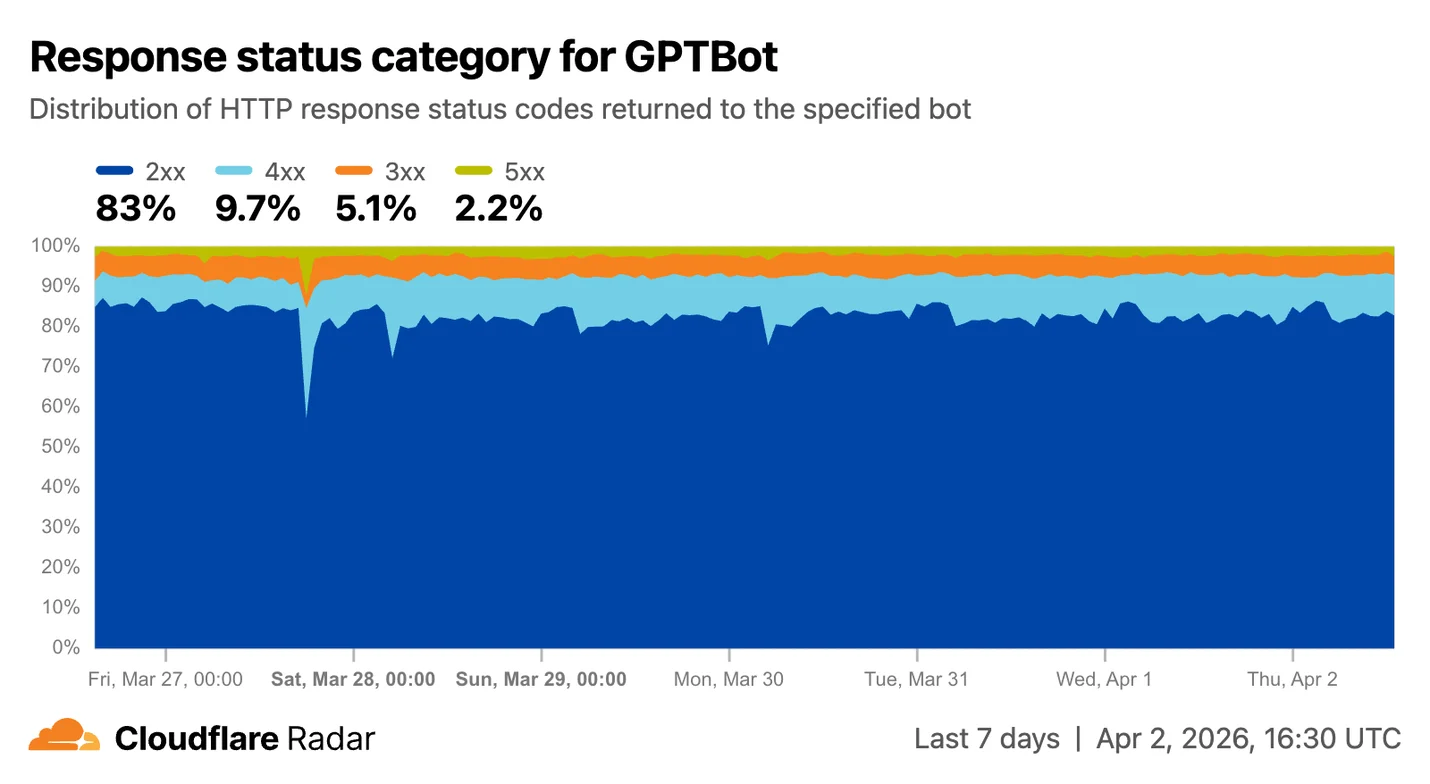
这项分析也已添加到各个机器人的页面上,以便了解爬虫在这方面的行为。在下方的 GPTBot 示例中可以看到,在图表所涵盖的时间段内,略高于 80% 的请求被成功处理(200),4.7% 的请求被重定向(301、302)到另一个 URL,仅有 2.7% 请求的是未找到的文件(404)。近 6% 被阻止,Cloudflare 返回的响应状态码为 403。按分组来看,83% 的请求收到了成功响应(2xx),近 10% 收到了客户端错误响应(4xx),5.1% 收到了重定向消息(3xx),其余 2.2% 收到了服务器错误响应(5xx)。
如上所述,Radar 的 Data Explorer 允许用户通过应用更多筛选条件进一步深入数据。例如,我们可以查看哪些爬虫请求了最多不存在的内容(返回 404 响应状态码),以及这些请求流量随时间的变化趋势;或者查看哪些行业向训练爬虫发出了最多的重定向(3xx)响应状态码,以及这一活动随时间的变化趋势。
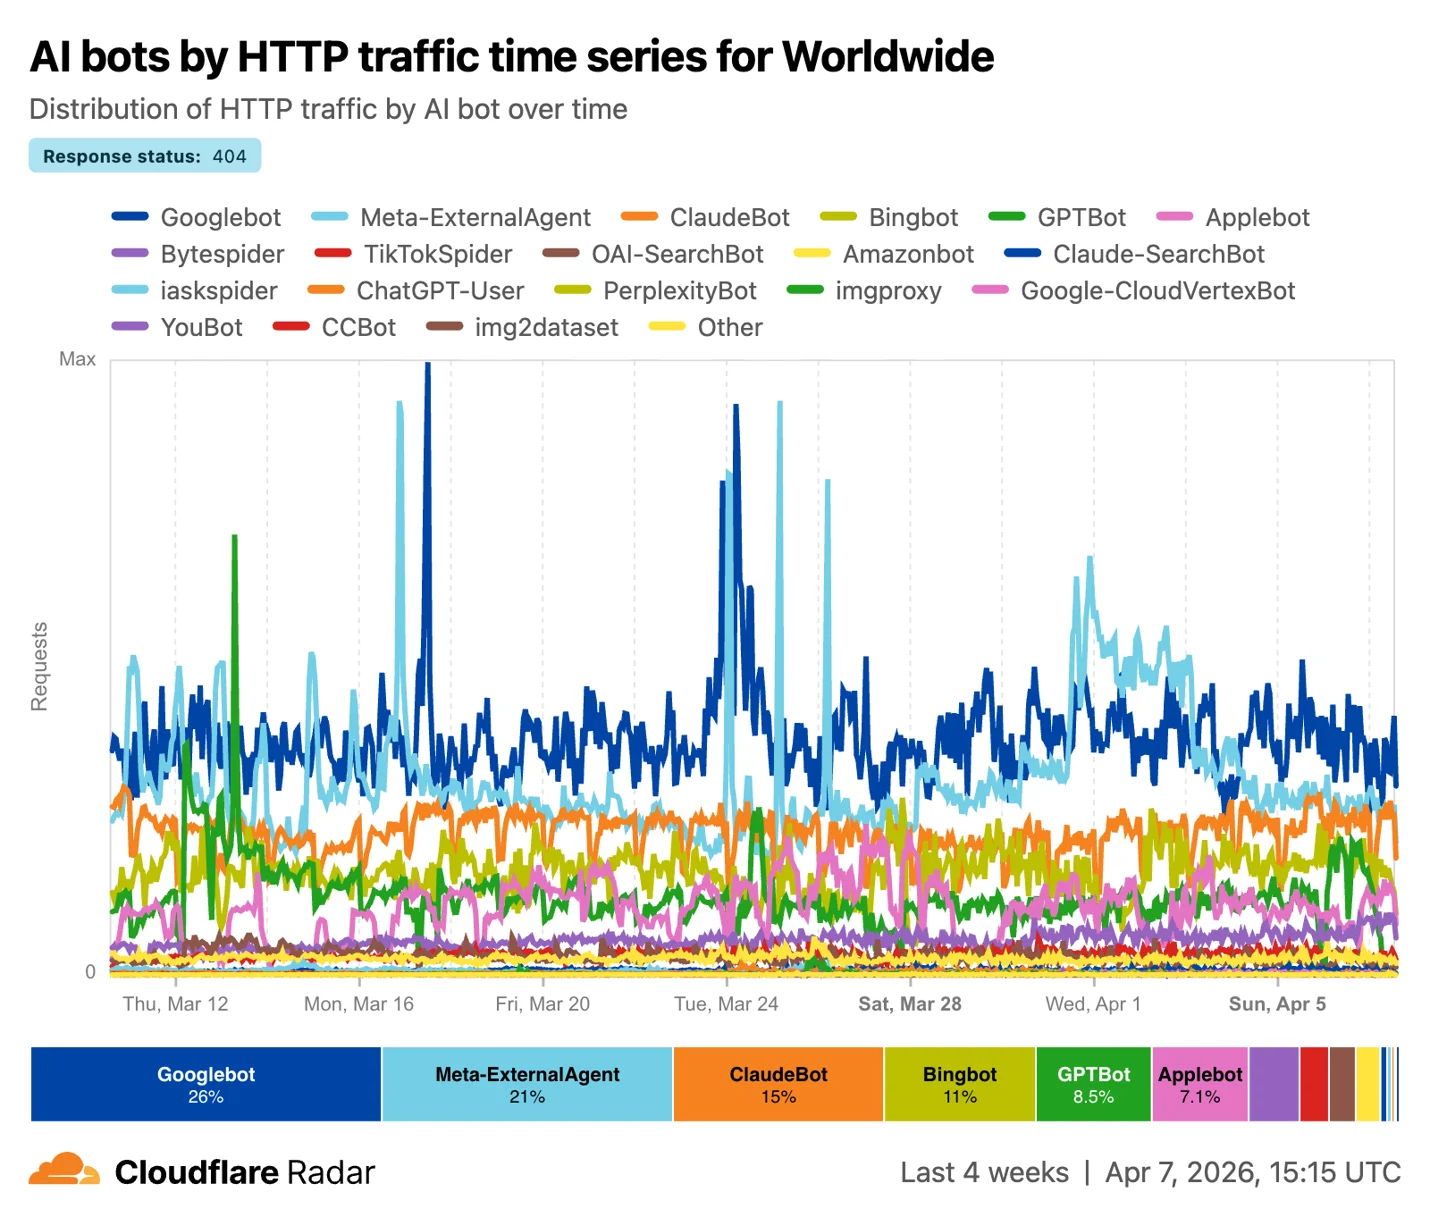
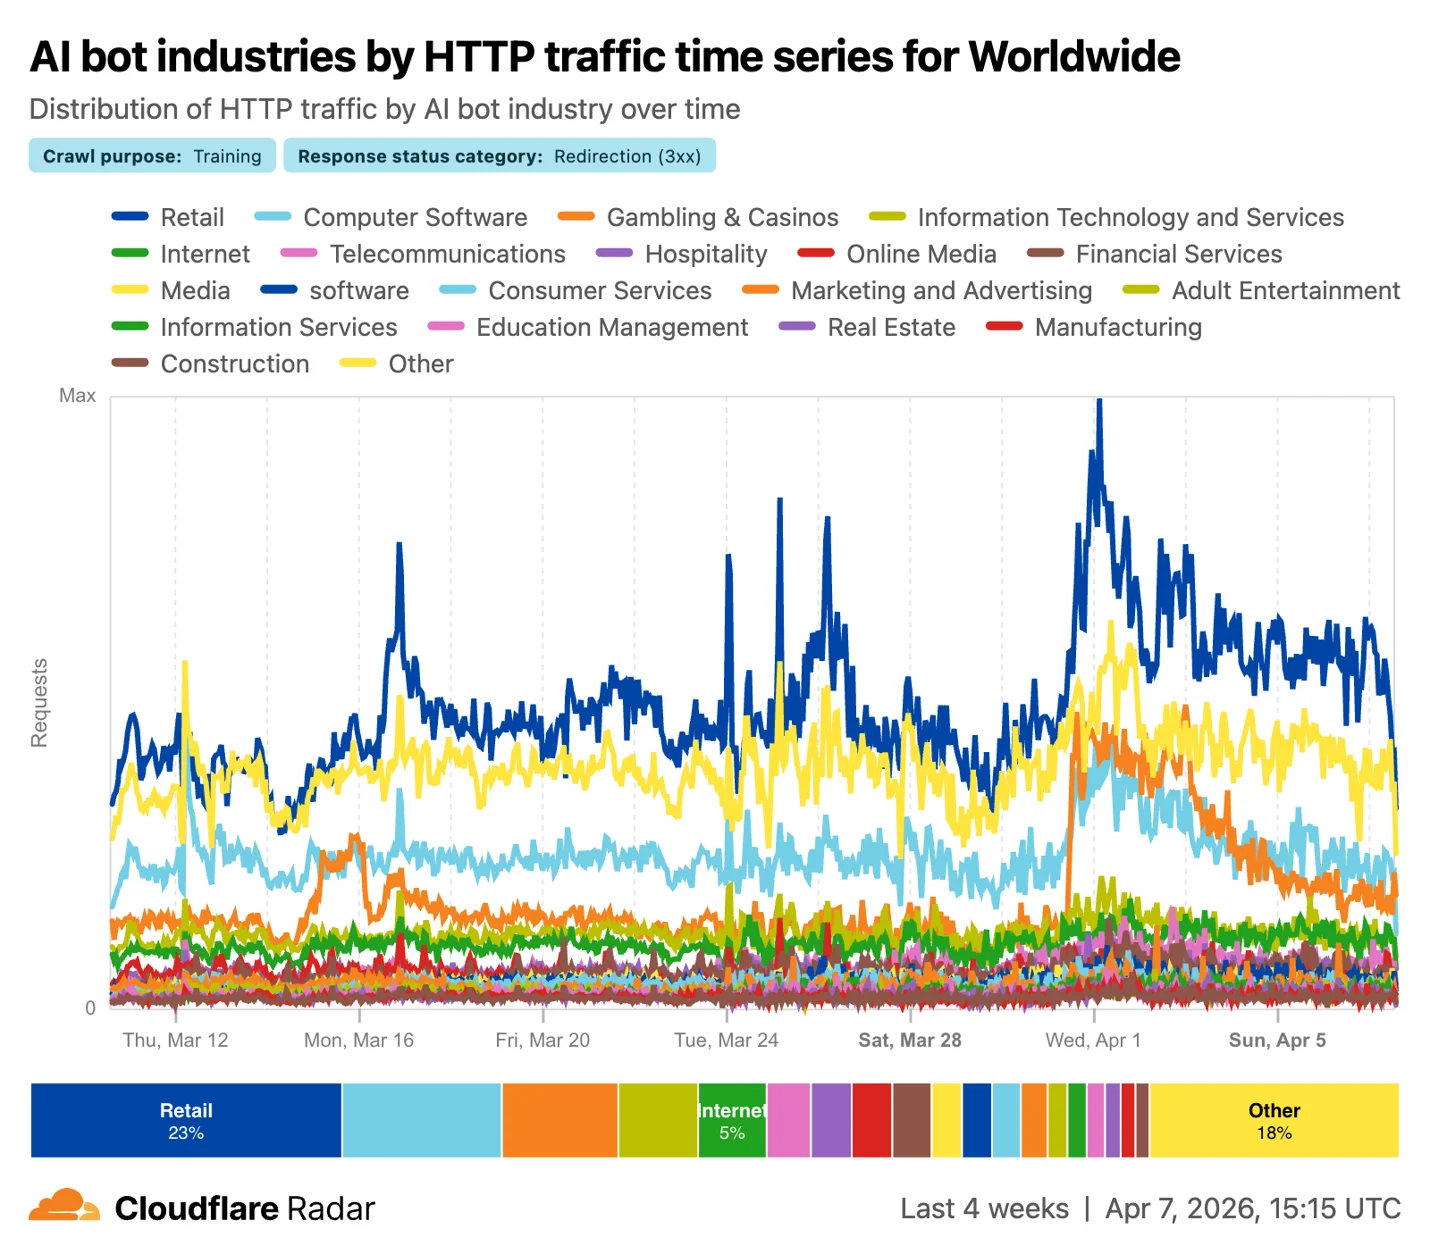
响应状态码数据,无论是汇总数据还是按机器人划分的数据,也都可以通过 Cloudflare Radar API 获取。
Redirects for AI Training 让你能够塑造爬虫从你的源站获得的内容;Radar 的状态码分析则让你看到网络上的其他站点是如何做的。在 AI Crawl Control > Overview > Quick Actions 中启用 Redirects for AI Training,今天就开始在你的站点上用强制生效的结果取代建议性信号。
有问题,或想分享你的发现?欢迎加入 Cloudflare Community 的讨论,或在 Discord 上找到我们。