联邦学习(Federated Learning,FL)项目通常从简单的配置起步:一台服务器、几个客户端,每个站点各有一个数据集。随着项目规模扩大,挑战就从运行算法转向了运维共享基础设施。GPU 必须在作业需要时分配,多项研究必须相互隔离,每个参与组织也必须保留对自己的数据、密钥和算力策略的控制权。
当各组织依赖不同的环境时,这种运维复杂度还会进一步增加。一个站点可能使用 Docker 主机,另一个运行 Kubernetes 集群,而某个研究中心则用 Slurm 调度其 GPU 工作负载。要求每个参与方都采用相同的基础设施,会让平台标准化变成协作的前提条件。
NVIDIA FLARE 通过把持久运行的联邦与执行每个作业的进程分离开来,应对这一挑战。
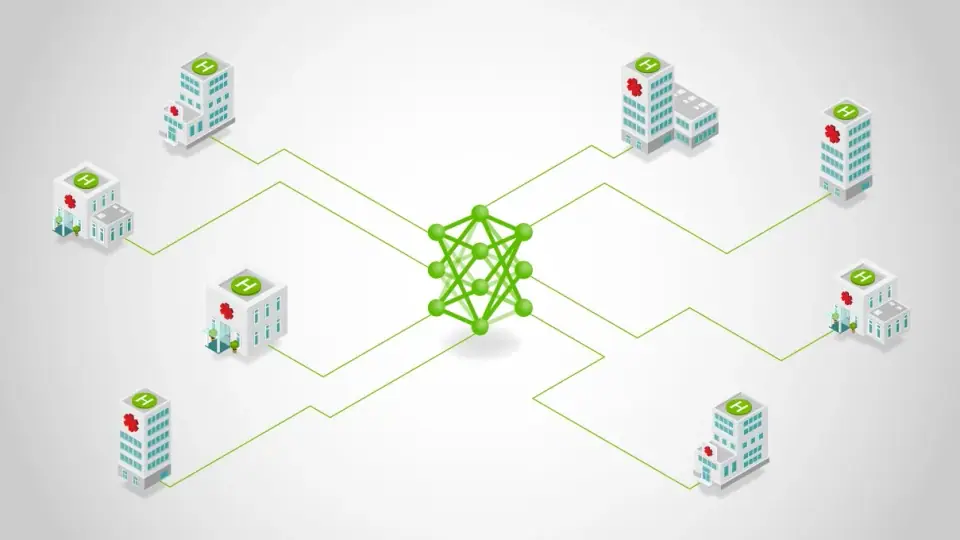
FLARE 的双层架构将持久的联邦服务与作业执行分离,使同一联邦中的每个站点都可以选用适合自身基础设施的执行后端——例如一个站点用 Docker,另一个用 Kubernetes,第三个用 Slurm。每个站点都在本地掌控算力分配,以及每项研究所使用的数据集、镜像、密钥和调度策略
NVIDIA FLARE 2.8 提供 Docker 和 Kubernetes 部署支持。FLARE 2.9 增加了 Slurm 支持。
将联邦协调与作业执行分离
一个 FLARE 部署包含两个运行层。长期运行的服务器和客户端父进程负责维护联邦、验证连接并协调工作。独立的服务器和客户端作业工作进程(job worker)则负责执行提交的 FL 作业。
这种分离实现了资源感知的执行。父进程可以持续可用,而不必占用训练所需的 GPU。当数据科学家提交作业时,每个父进程会通过其配置的执行平台启动一个工作进程。工作进程接收作业、使用所请求的资源、返回结果,并在工作完成后退出。
作业将资源需求与平台细节分开描述。一个作业可以请求 GPU、整数个可调度的 CPU 单元以及主机内存。每个站点的启动器(launcher)会把这些需求与本地研究配置结合起来,并将其转换为 Docker 容器、Kubernetes Pod 或 Slurm 分配。
这些层次共同作用,使联邦服务保持可用,同时在每个站点按需创建作业工作进程及其资源。

使用 Docker、Kubernetes 和 Slurm 部署作业工作进程
NVIDIA FLARE 与标准的部署和调度系统集成。站点运维人员选择与本地环境匹配的运行时,并对其策略负责。
表 1. NVIDIA FLARE 部署运行时对比
| 运行时 | 典型环境 | 动态执行单元 | 资源管理方 |
|---|---|---|---|
| Docker | 工作站或单主机站点 | 作业容器 | Docker 主机 |
| Kubernetes | 云端或本地集群 | 作业 Pod | Kubernetes 调度器 |
| Slurm | HPC 或共享 GPU 集群 | 批处理分配 | Slurm 调度器 |
Docker:在单台主机上进行容器化执行
Docker 是工作站、实验室服务器、边缘系统或其他单主机环境的实用选择。持久运行的 FLARE 服务器或客户端运行在基于父镜像构建的父容器中。对于每个提交的作业,FLARE 会动态启动一个基于作业镜像构建的独立作业容器。
父镜像包含 FLARE 运行时以及启动容器所需的组件。独立的作业镜像则可以包含训练框架、模型代码和应用依赖。站点可以通过 NVIDIA Container Toolkit 将所请求的 GPU 暴露给作业容器,并使用 Docker 设置来满足共享内存、挂载、网络及其他主机特定的需求。
将父镜像与作业镜像分离也使更新更容易。基础设施所有者可以保持父环境稳定,而研究人员可以独立更新其训练环境,但须遵守站点的镜像和代码审批策略。
Kubernetes:动态调度的作业 Pod
在 Kubernetes 中,Helm chart 将每个持久运行的 FLARE 服务器或客户端安装为一个父 Pod。对于每个提交的作业,父进程会创建一个独立的服务器或客户端作业 Pod。Kubernetes 调度器会根据该 Pod 的 CPU、内存、GPU、存储和放置要求来安排其位置。
这种方式将 FLARE 作业与人们熟悉的 Kubernetes 能力联系起来。站点可以使用命名空间、服务账号、Secret、持久卷、节点选择器、容忍度(toleration)和准入策略。例如,一项研究可以通过 Pod 模板选择 H100 节点,而另一项研究使用不同的节点池。
平台运维人员为其集群配置存储类、镜像仓库凭据、网络策略、GPU 启用和基于角色的访问控制(RBAC)。FLARE 利用这些服务来启动和监控作业 Pod。
Slurm:调度 GPU 与多节点分配
许多大学、研究中心和企业计算环境使用 Slurm 来共享 GPU 集群。FLARE 的 Slurm 启动器会把每个服务器或客户端作业工作进程作为批处理作业提交。Slurm 负责选择计算节点,并强制执行所请求的 GPU、CPU、内存、分区、账户、服务质量(QoS)和时间限制。
作业可以请求单个节点或多个节点。FLARE 提交分配请求、监控其状态、传递完成或失败的结果,并在需要时取消分配。该启动器支持裸机执行(无沙箱)、Pyxis/Enroot 容器和 Apptainer 容器。
Slurm 仍然是资源的管理方。其账户、关联(association)、分区、QoS 规则、cgroup、文件系统权限和设备控制决定了一次分配可以使用什么。这保留了集群管理员已经用于非联邦工作负载的运维模式。
NVIDIA FLARE 提供参与方身份验证、安全通信和授权,而每个站点的执行平台则强制执行本地的资源和工作负载策略。站点运维人员负责配置主机和集群安全、获批镜像、密钥和访问控制,并为其所选的运行时验证工作负载隔离。
用研究(study)隔离不同的研究项目
共享基础设施带来了另一个问题:多个团队如何运行 FL 研究,而不混淆各自的用户、作业或数据?
FLARE 的研究(study)在同一个部署内提供了逻辑上的多租户边界。每项研究定义其参与的客户端站点,以及可以为该研究打开会话的管理员用户。感知研究的操作会把作业可见性、客户端状态、提交目标和部署映射限制在当前活动的研究范围内。
研究的边界在每个参与站点上延续。站点自有的 local/study_runtime.yaml 文件将一项研究映射到它在本地可以使用的资源。根据运行时的不同,该配置可以定义:
- 数据集挂载
- 环境变量
- 由 Secret 支持的环境变量和文件挂载
- 站点批准的默认作业镜像
- Kubernetes Pod 模板
- Docker 运行时设置
- Slurm 沙箱、分区、账户和 QoS 策略
数据科学家通过打开限定在某项研究范围内的会话来选择研究,从该会话提交的作业会继承研究上下文。作业不能任意选择本地数据集路径,也不能提供密钥值。FLARE 服务器在作业到达站点之前会验证研究成员资格,而站点运维人员控制着从该研究到本地资源的映射。
下面这个精简的 Kubernetes 示例,将一项病理学研究映射到站点自有的数据卷和数据库凭据。该配置中包含的是对 Secret 的引用,而不是 Secret 的值。
format_version: 2

studies:
  pathology:
    container:
      image: registry.example.com/pathology-trainer:1.0
    datasets:
      slides:
        source: pathology-data-pvc
        mode: ro
    secret_env:
      DB_USER: {source: pathology-db, key: username}
      DB_PASSWORD: {source: pathology-db, key: password}
当从病理学研究范围的会话提交的作业到达该站点时,Kubernetes 启动器会选择匹配的 studies.pathology 条目。启动器使用该研究的镜像作为本地默认镜像,并将 pathology-data-pvc 卷以只读方式挂载到作业容器内的 /data/pathology/slides。挂载路径由研究名称和数据集名称派生而来,形如 /data/<study>/<dataset>。
secret_env 条目会变成 Pod 规范中的 Kubernetes secretKeyRef 引用。Kubernetes 在启动 Pod 时,会从 pathology-db Secret 中注入 username 和 password 的值。这样凭据值保留在站点的密钥存储中,同时又为该研究的工作进程提供了所需的环境。

研究适用于共享同一个 FLARE 服务器和公钥基础设施(PKI),但需要在实验之间进行逻辑隔离的组织。如果组织需要独立的 PKI、基础设施管理员或故障影响范围,则应使用各自独立的 FLARE 部署。
将异构联邦整合在一起
在上文图 1 所示的联邦中,一项病理学研究连接了两家医院和大学,使用 GPU 工作进程以及各站点获批的镜像数据集。一项结局(outcomes)研究则只包含两家医院,使用 CPU 工作进程分析结构化的临床数据。
两项研究共享联邦的持久服务。研究成员资格决定哪些站点参与,而每个站点的研究配置则为其工作进程提供数据集、镜像、密钥和调度设置。研究人员从相应的研究会话提交作业,本地启动器会应用这些设置。
提交作业
FLARE 2.9 支持在作业的 meta.json 中通过 resource_spec 声明可移植的 GPU、CPU 和主机内存需求。可移植的键为 num_of_gpus、num_of_cpus 和 memory。CPU 值表示整数个可调度的 CPU 单元,内存使用以 Mi、Gi 或 Ti 为单位的正整数数量。
@default 条目将同一个资源配置应用于每个目标站点,包括服务器。指定名称的客户端或服务器条目只需提供有差异的值。在这个示例中,两家医院都继承 1 块 GPU、4 个 CPU 单元和 64 GiB 内存。大学覆盖了 GPU 数量,而服务器将 GPU 数量覆盖为零。两者都继承相同的 CPU 和内存需求。
{
  "resource_spec": {
    "@default": {
      "num_of_gpus": 1,
      "num_of_cpus": 4,
      "memory": "64Gi"
    },
    "server": {"num_of_gpus": 0},
    "university": {"num_of_gpus": 8}
  }
}
每个启动器都会把解析后的值转换为原生设置。Docker 将 4 个 CPU 单元转换为 nano_cpus=4000000000,将 64 GiB 转换为以字节为单位的 mem_limit,并应用 GPU 设备请求。Kubernetes 设置对应的 CPU 和内存 request 与 limit,并添加 GPU 请求。Slurm 则生成 --cpus-per-task=4、--mem=65536M 以及相应的 GPU --gres 值。
数据科学家打开限定在某项研究范围内的会话,向 FLARE 服务器提交一次作业,服务器会把它部署到该研究的各个参与方。在每个站点,已配置的启动器应用该研究的本地运行时默认值并创建工作进程。FLARE 负责协调联邦工作流并报告作业状态,而 Docker、Kubernetes 和 Slurm 管理本地资源。
对于特定后端的拓扑和策略,例如 Slurm 节点布局或特定运行时的镜像,请使用 launcher_spec。研究运行时配置则提供每个站点在镜像、数据集、密钥和执行策略方面获批的本地默认值。
这带来了什么
联邦学习基础设施不必在所有参与方之间保持统一。FLARE 将持久的联邦服务与动态启动的作业工作进程分离,使每个站点都可以使用 Docker、Kubernetes 或 Slurm。研究则增加了限定范围的成员资格,以及由站点自有的、针对数据、密钥、镜像和调度策略的映射。
这些能力共同使一个联邦能够横跨本地系统和云端,而无需强迫每个组织使用同一平台。站点可以在作业需要时分配 GPU 和其他资源,继续使用其既有的运维管控,并在独立治理的数据上运行多项研究。异构基础设施成为联邦设计的一部分,而不再是扩展的障碍。
要开始使用,请浏览 NVIDIA FLARE 文档和 NVIDIA FLARE GitHub 仓库。