摘要
分布感知推测解码(Distribution-aware speculative decoding,DAS)是一个全新的框架,可显著缓解强化学习后训练中的展开(rollout)瓶颈——在不改动模型输出的前提下,带来高达 50% 的加速。
展开阶段的瓶颈
强化学习已成为现代大语言模型后训练的基石。DeepSeek-R1 等模型的推理能力正是得益于强化学习微调。但随着模型越来越大,一个关键瓶颈浮现出来:展开阶段。
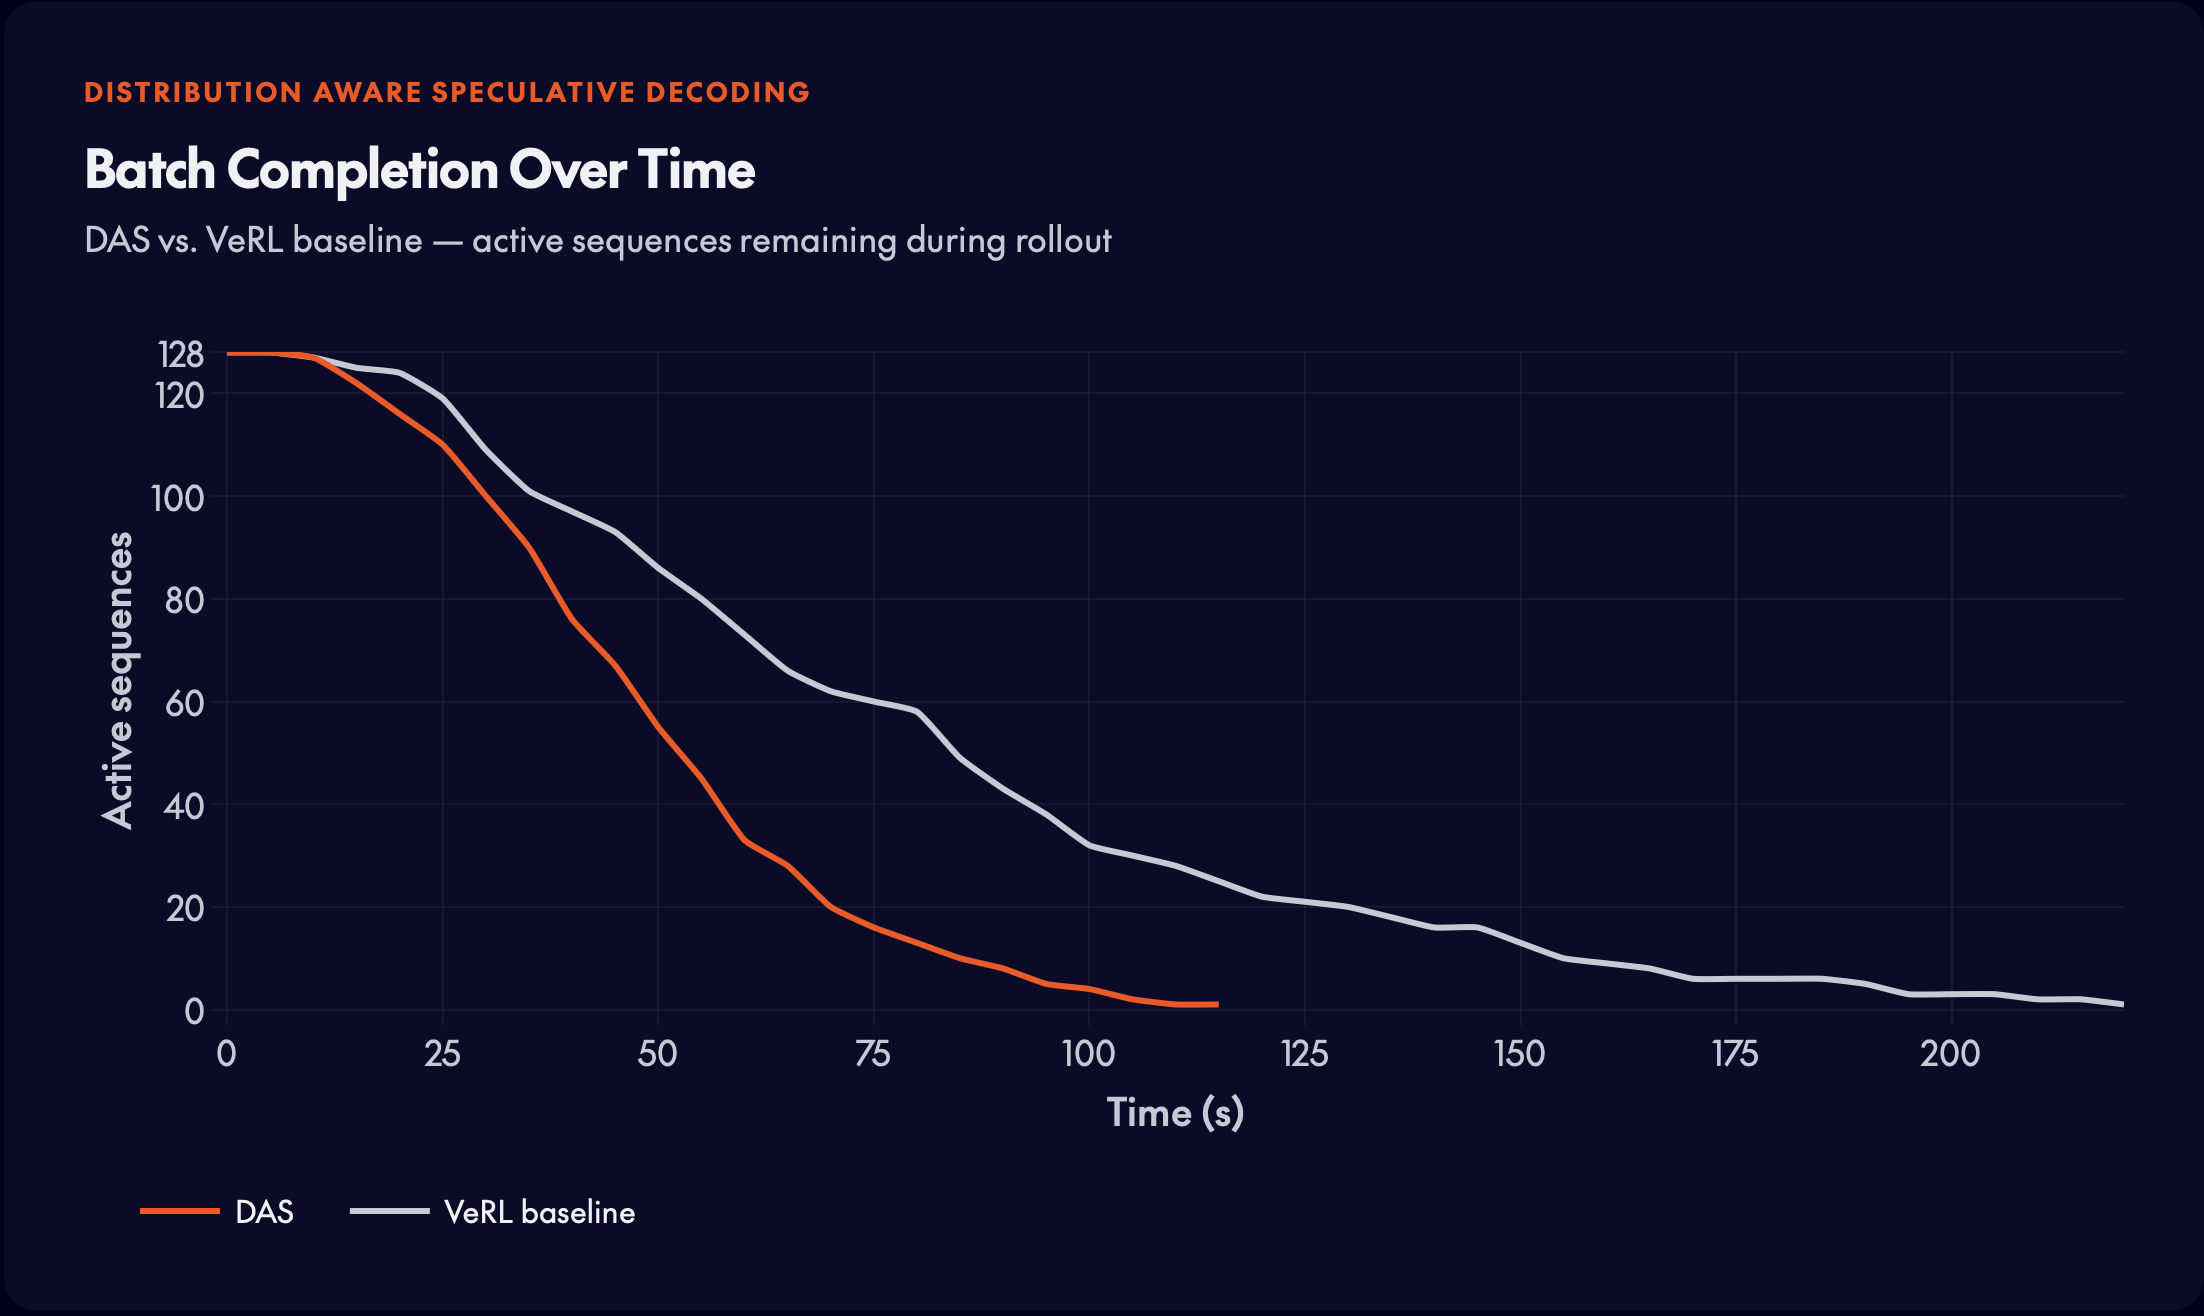
在强化学习训练中,模型必须为一个批次中的每个提示词生成完整的回复,下一个训练步骤才能开始。最慢的那次生成决定了整个步骤的耗时——这是一个典型的长尾问题。
占总训练时间 70% 的时间消耗在展开阶段——超过了反向传播和参数更新的成本总和。
- 同步屏障:所有展开必须全部完成,训练才能继续。一次缓慢的生成就会阻塞整个批次。
- 长度不断增长:现代推理模型生成的思维链越来越长,放大了长尾效应。
- GPU 空闲时间:当落后者还在运行时,其他 GPU 处于空闲状态——每次训练运行都白白浪费数千美元的算力。
关键洞察
强化学习后训练中的展开阶段具有三个结构性特征,使其区别于标准的大语言模型服务负载。这些特征决定了 DAS 的核心设计选择。
- 长尾展开导致 GPU 利用不足:强化学习的展开服从长尾分布:大多数生成很快完成,而少数生成会产生极长的轨迹。由于训练步骤必须等待所有展开完成,这些长序列就成了决定步骤延迟的落后者。随着较短的请求提前完成,GPU 变得空闲,造成严重的硬件利用不足。
- 历史轨迹信号:与推理服务(请求各不相同)不同,强化学习训练会在多个 epoch 中反复遍历相同的提示词——由此产生了丰富的历史生成记录,可供利用。
- 模型权重不断演化:模型在每次优化器步骤之后都会改变。在较早检查点上训练的静态草稿模型很快就会与当前策略失配。
DAS 框架
这些特征各自对应一项设计要求:
- 一个无需重新训练就能保持最新的草稿器
- 一个能化解落后者问题的调度器,以及
- 一个能利用强化学习特有的提示词复用的系统。
DAS 通过两个紧密集成的组件来解决这三点。第一个是自适应后缀树草稿器,它能加速生成,并能在漫长的训练周期中平滑扩展。第二个是长度感知的调度策略,它通过 GPU 间的负载均衡和 GPU 内的推测预算分配来减少展开阶段的落后者。
自适应后缀树草稿器
为什么选择后缀树?
随着策略在强化学习训练过程中不断演化,静态草稿器很快就会过时。因此,DAS 使用基于近期展开构建的免训练草稿器,使其无需任何梯度更新就能持续适应不断变化的策略。
工作原理
DAS 基于近期轨迹的滑动窗口构建后缀树。在解码时,它会在当前上下文与已索引的历史之间寻找前缀匹配。随后,候选的下一个 token 会按其在匹配子树中的出现频率打分,得分最高的 token 被选为推测草稿。
为什么它适合强化学习展开
草稿序列由目标模型并行验证,新验证通过的 token 会立即插回树中,使草稿器始终与最新的策略保持同步。由于强化学习展开中往往存在大量的轨迹复用,这种非参数化设计可以有效利用重复出现的前缀,而无需单独的神经网络草稿器。
可扩展性
后缀树在展开之前构建,并在每个训练步骤之后释放,因此内存不会随着漫长的训练周期而累积。树的构建和清理按问题并行进行,并与 actor 更新重叠执行,使 actor 更新延迟的波动低于 5%,并把开销移出了关键路径。
长度感知调度
GPU 间均衡
DAS 会把长请求交错分布到各个 rank 上。这样可避免长生成集中在某一个 worker 上,并减少展开阶段的落后者。
对长请求的早期推测
DAS 对长请求从展开一开始就应用推测解码。展开延迟由少数撑到后期的长落后者主导,此时解码变成小批量且强烈受限于内存。提前为这些请求投入额外的算力是值得的——它避免了后期昂贵的模型前向计算,并缩短了展开的尾部。
GPU 内预算分配
在每块 GPU 内部,请求会根据历史展开统计数据被动态划分为长、中、短三类。长请求获得激进的推测解码预算,中等请求使用适中的预算,而短请求则完全跳过推测——避免在推测无法减少模型前向次数的地方浪费算力。这一分类策略会在运行时动态更新。
这个设计简单到几段话就能说清楚。真正验证它的是实验结果。
实验结果
DAS 在两个强化学习后训练任务上进行了评估——数学推理和代码生成。在这两种情况下,关键指标都是在奖励质量不下降的前提下缩短展开时间。
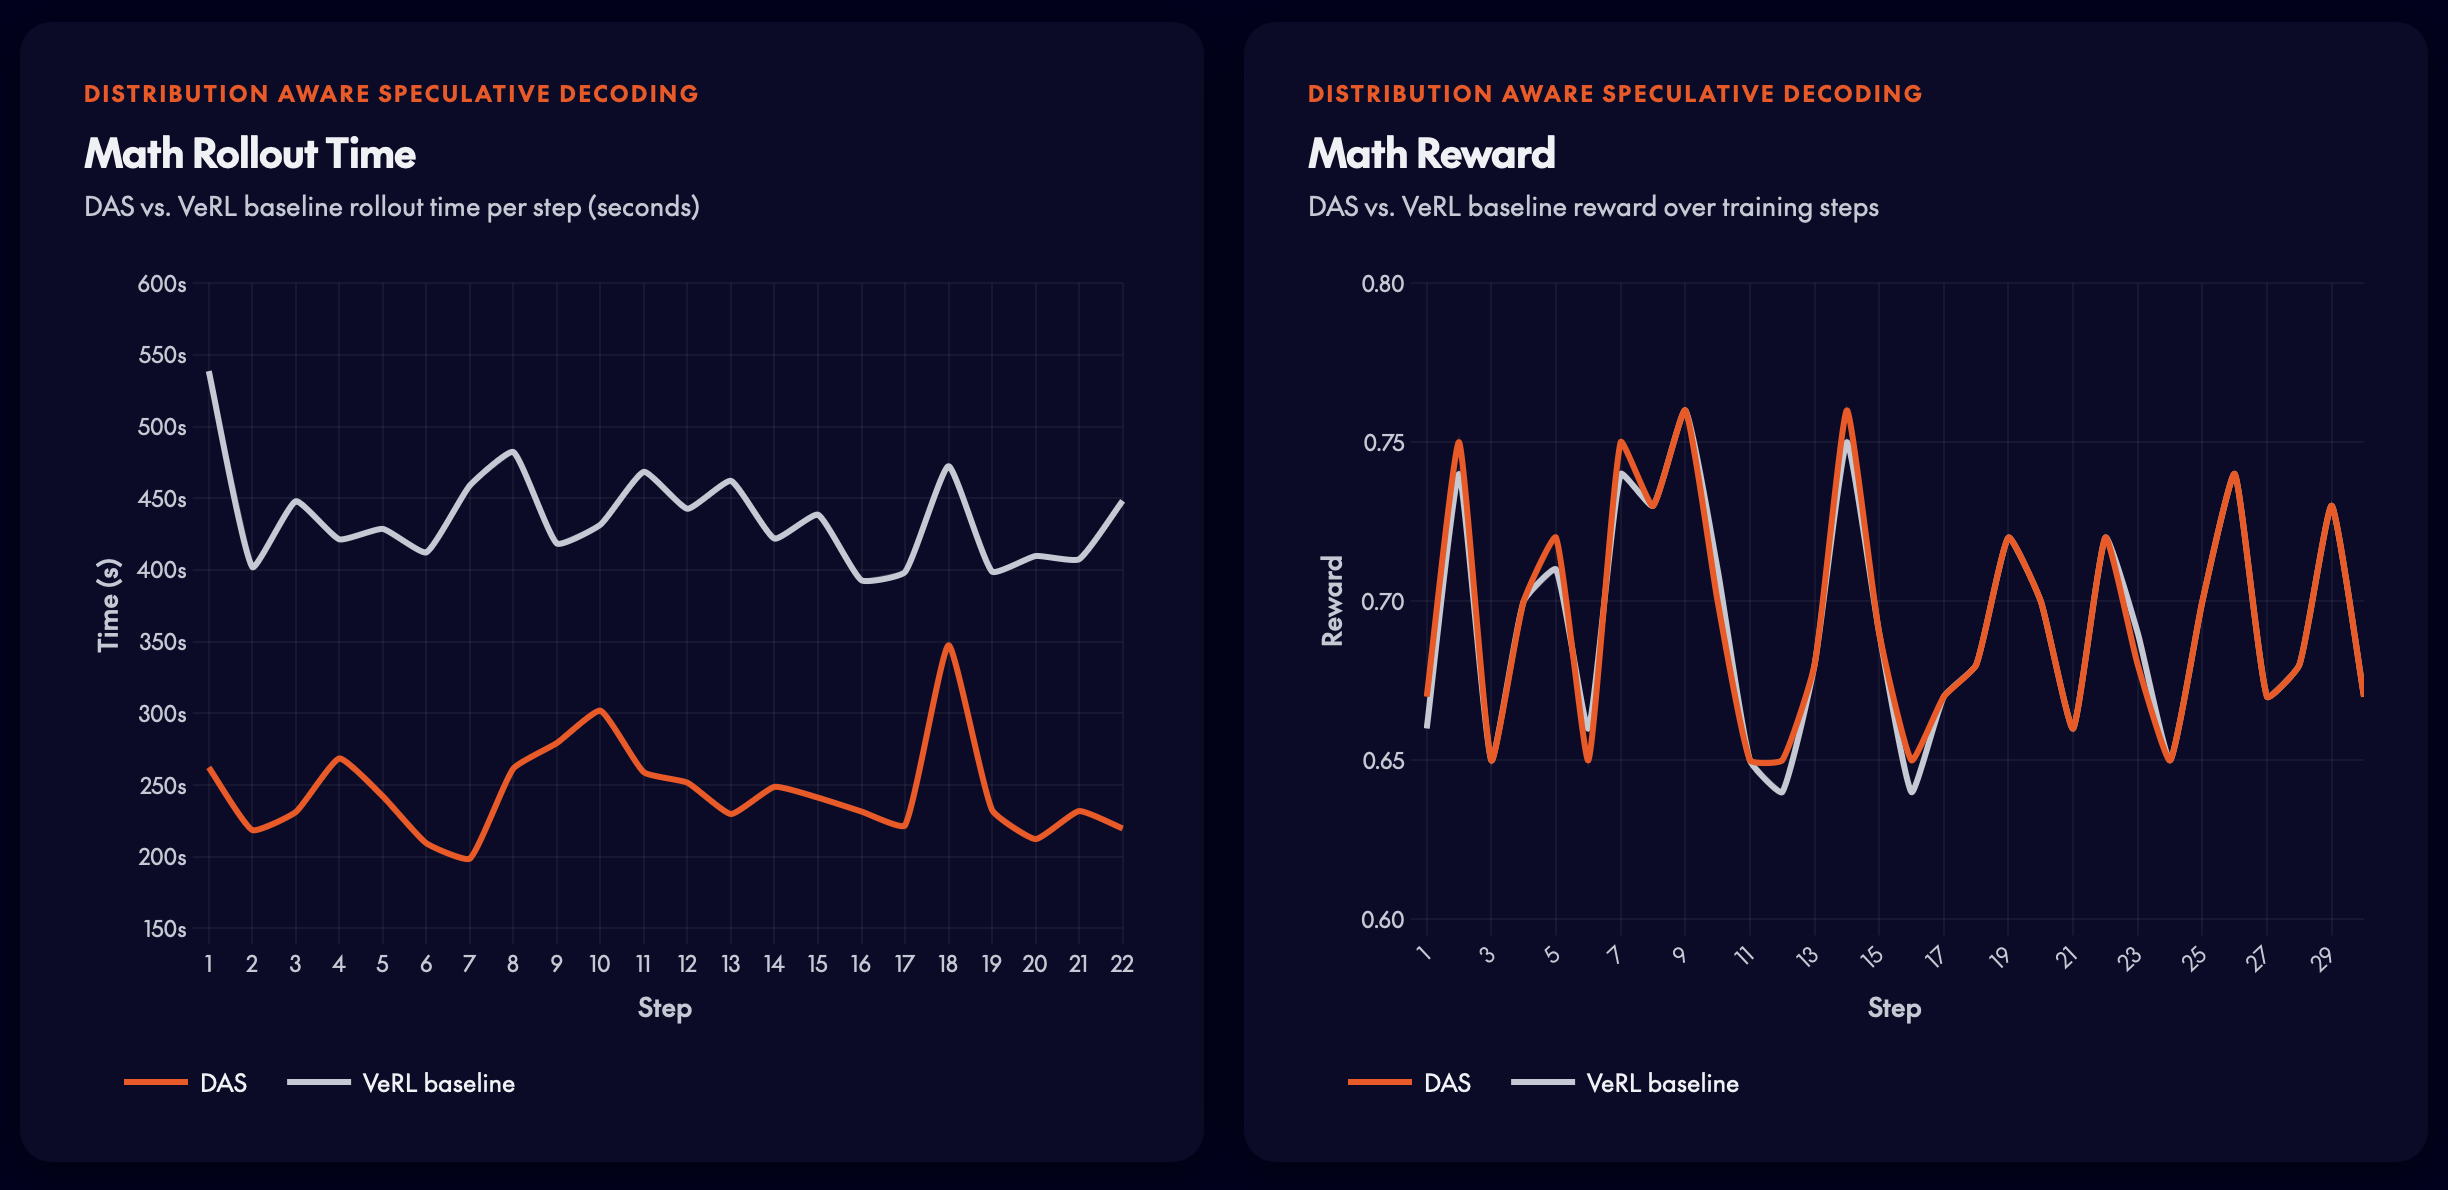
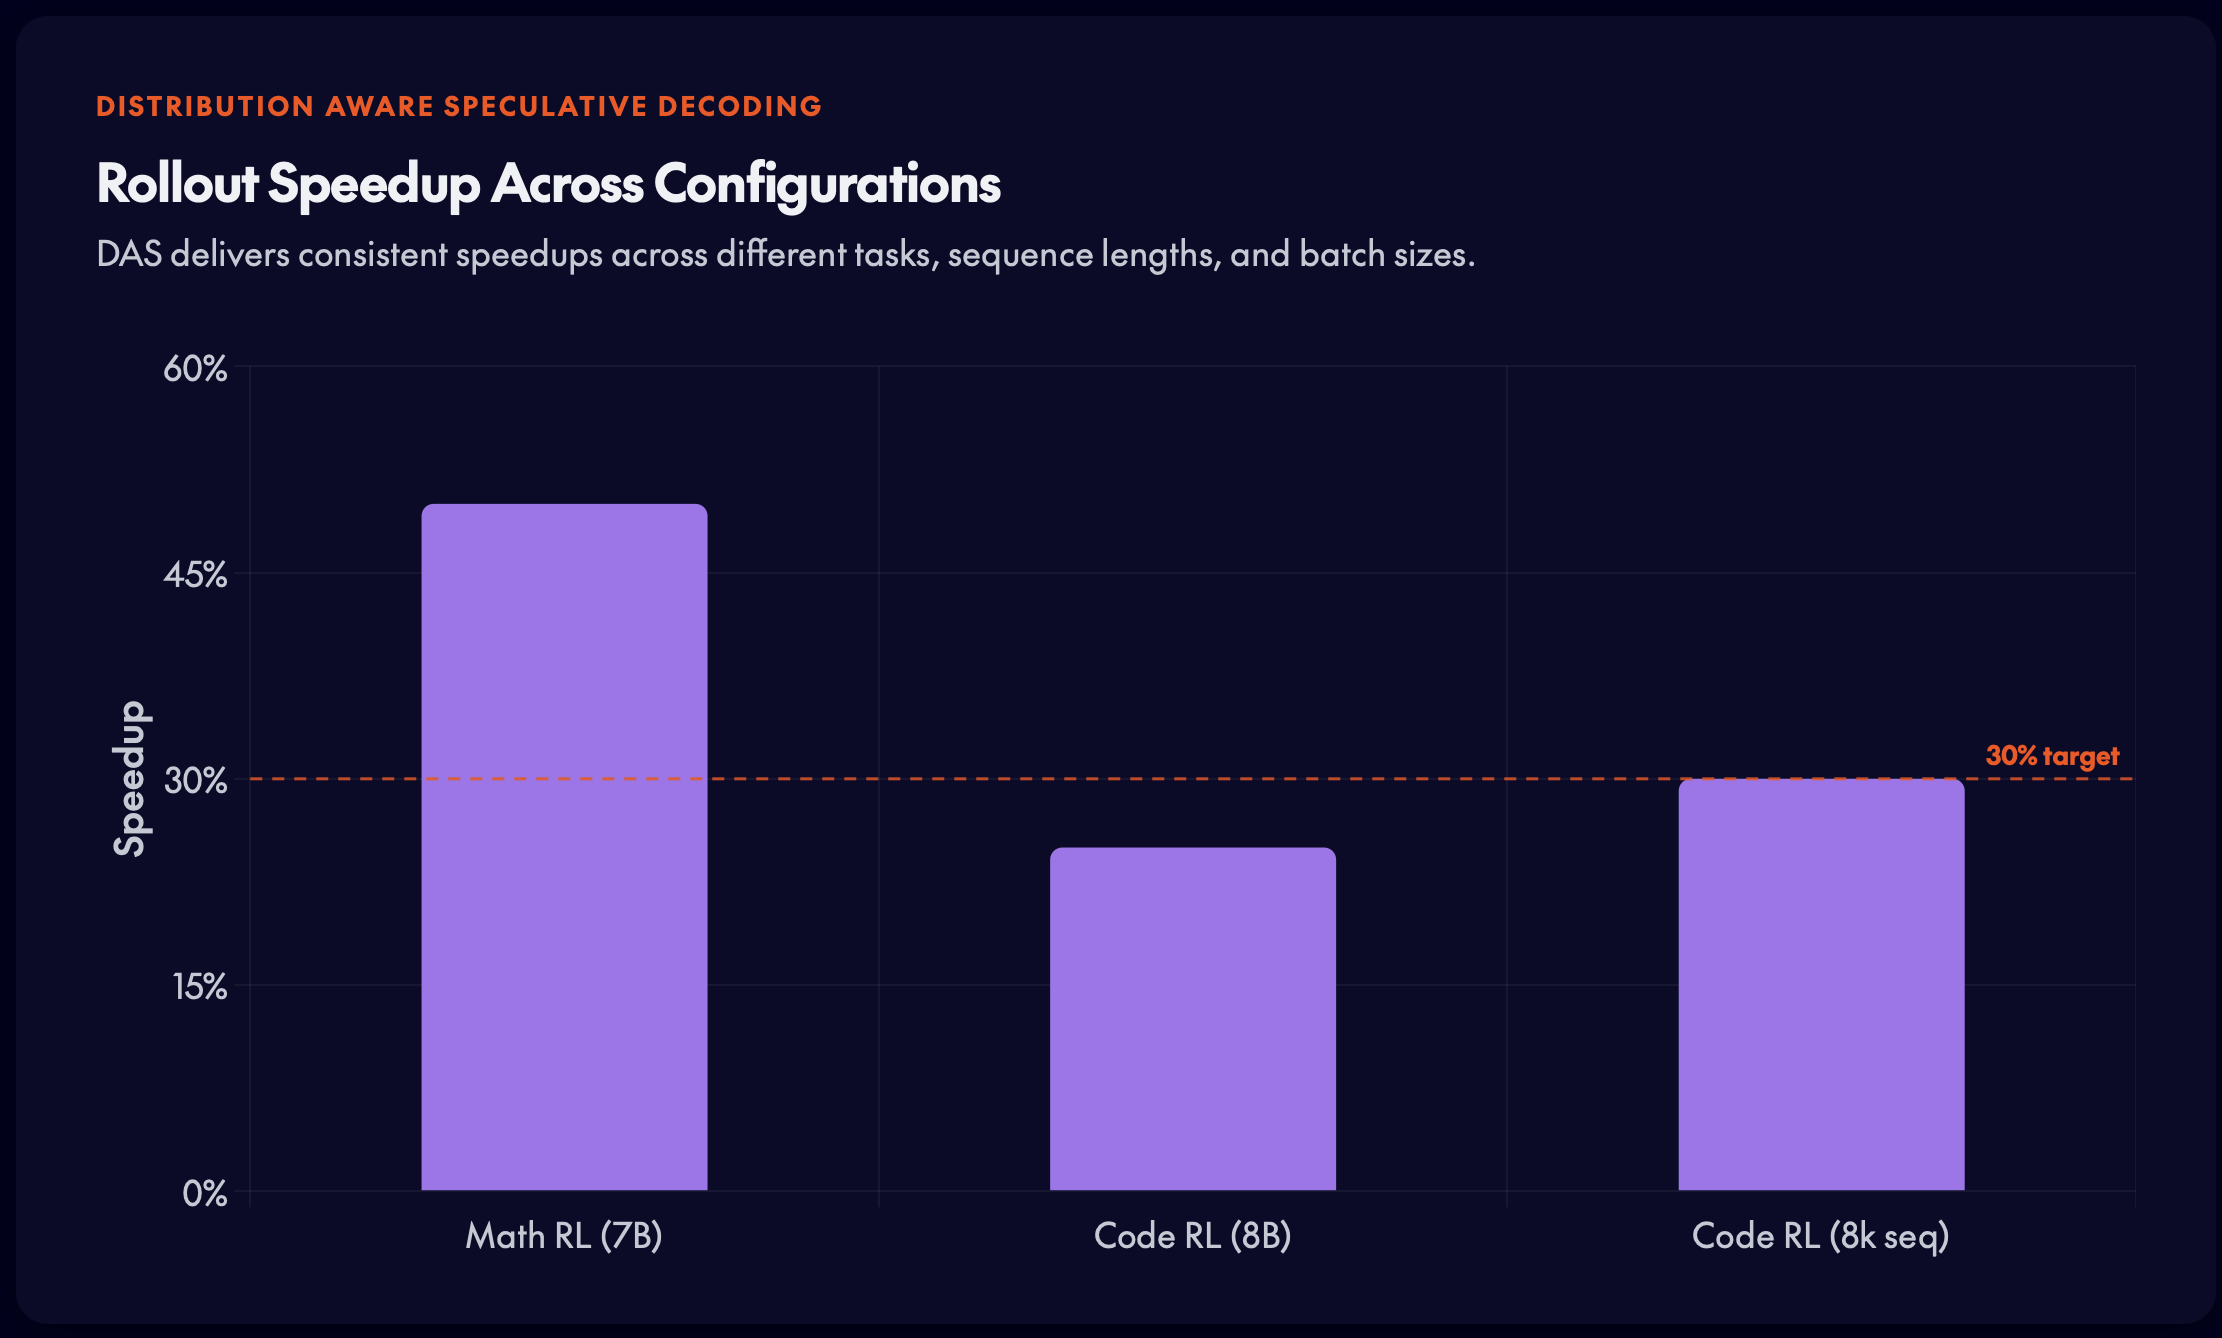
数学强化学习——DeepSeek-R1-Distill-Qwen-7B
DSR-sub 数据集(1,209 个样本)。DAS 实现了超过 50% 的展开时间缩减,同时与基线奖励曲线完全吻合。
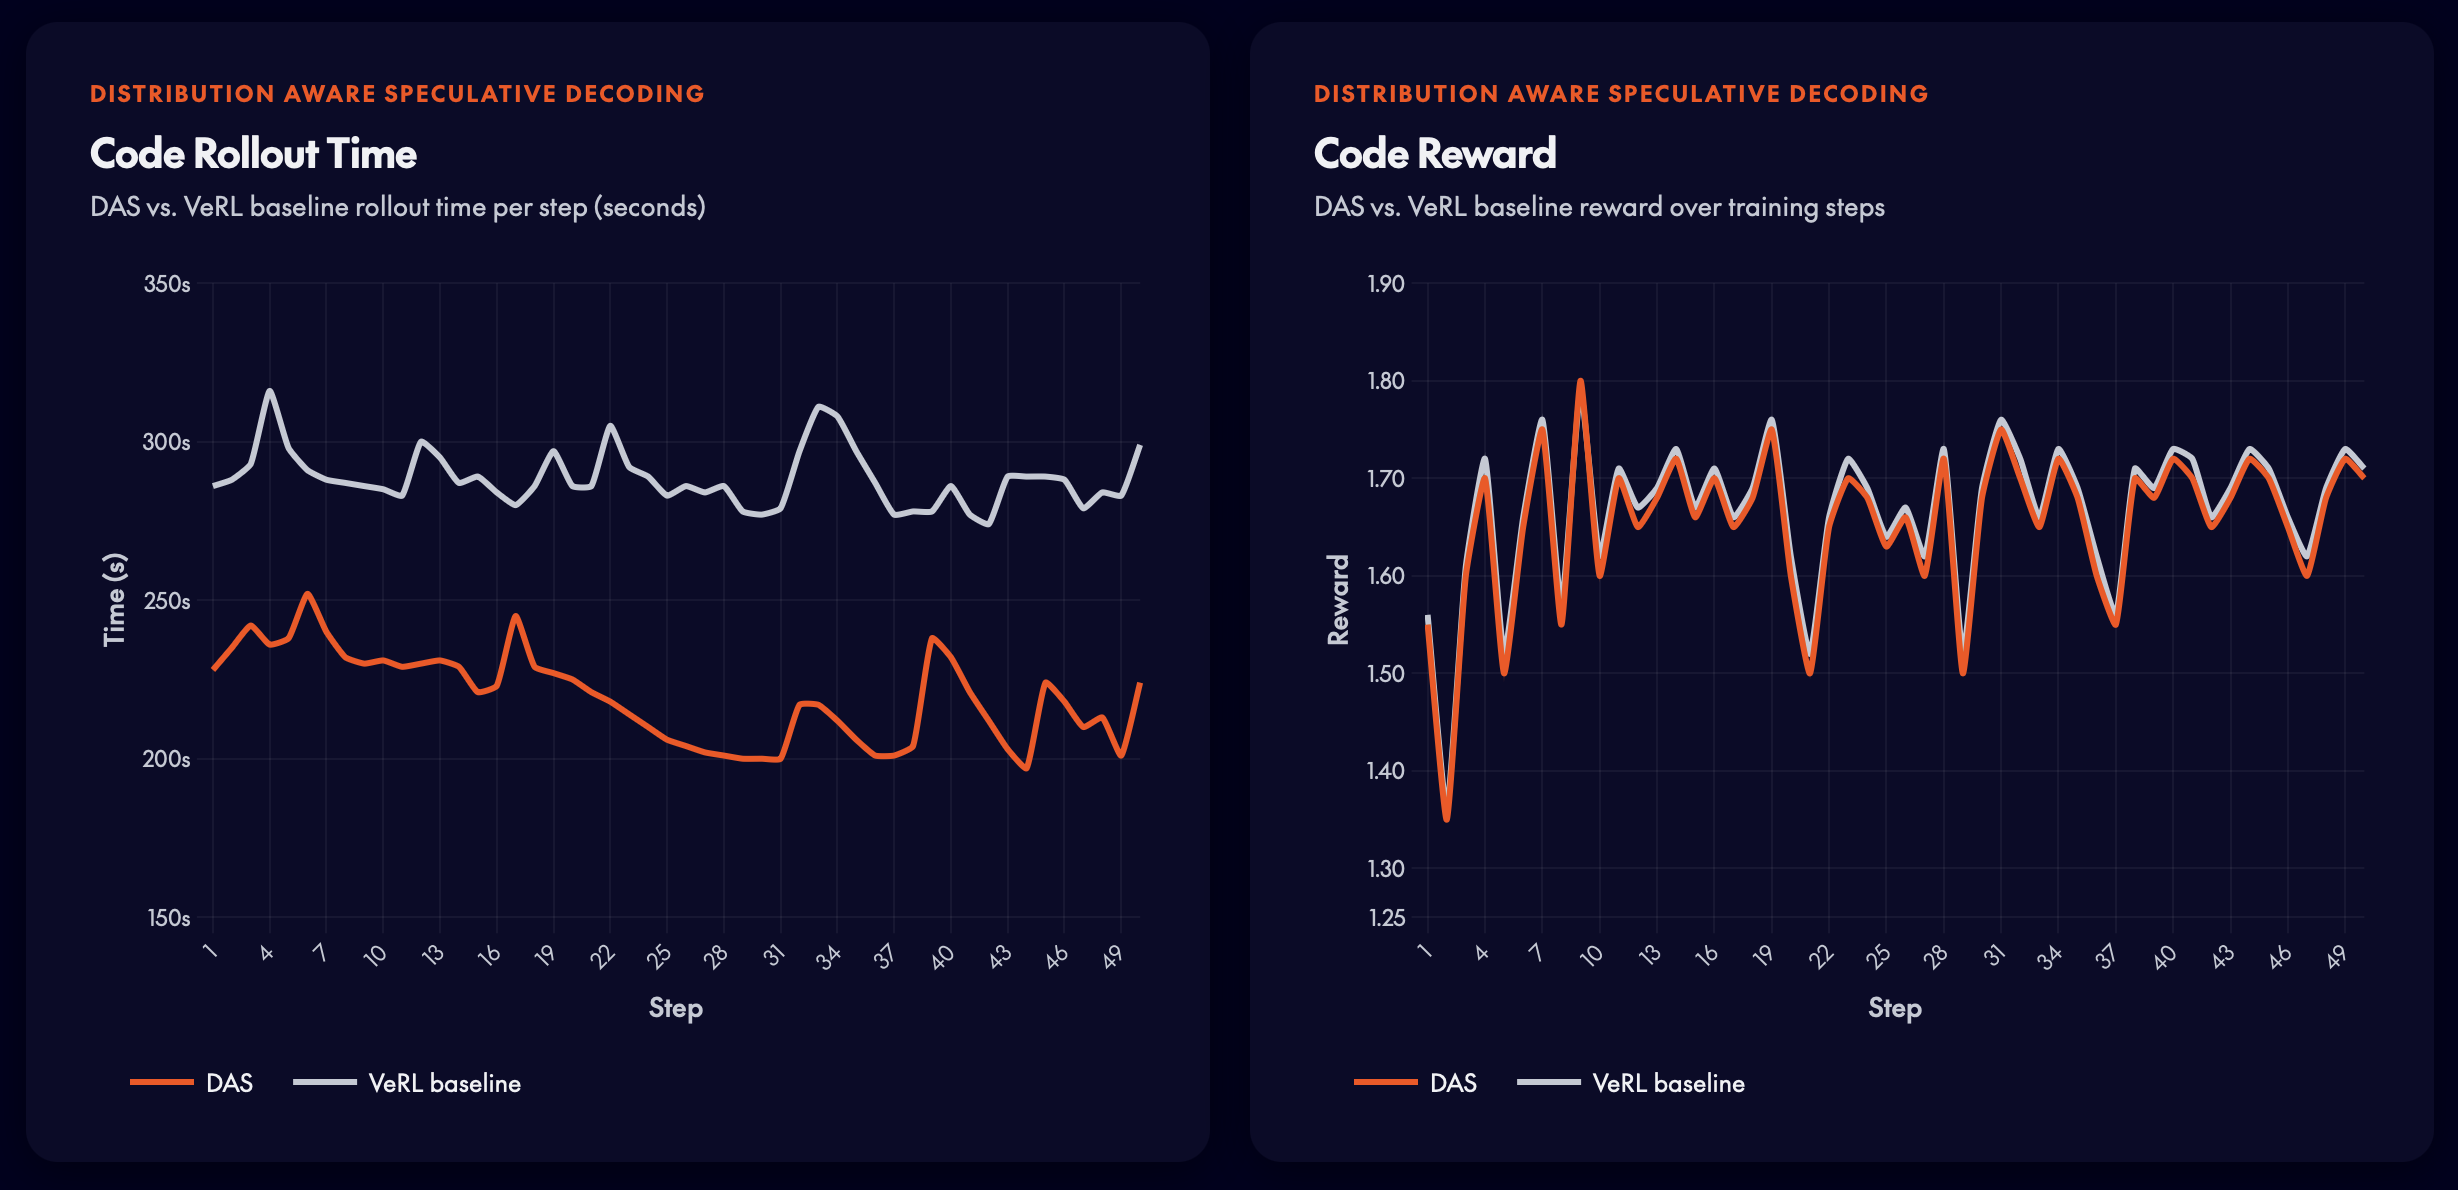
代码强化学习——Qwen3-8B
基于单元测试的奖励信号。DAS 实现了约 25% 的展开时间缩减,同时保持了奖励质量。
为什么这很重要
DAS 同时具备三个难得兼得的特性:
- 无损加速:DAS 保持输出分布不变——输出与标准解码完全一致,训练曲线也完全一致。
- 在各种配置下都稳健:在不同序列长度(8k–16k)和批大小(16–32)下,加速效果都能保持。
- 零成本适配:后缀树草稿器根据展开历史自我演化。无需梯度更新,无需维护。
随着 AI 社区推动用强化学习在日益复杂的任务上训练越来越大的模型,展开瓶颈只会愈发严重。对于大规模运行强化学习后训练的从业者来说,DAS 提供了一条极具吸引力的路径,可将算力成本最多削减 50%,而模型质量不受影响——在资源受限的大规模 AI 训练世界里,这是难得的双赢。
阅读论文了解更多。