摘要
Dedicated Container Inference(专用容器推理)让团队可以部署自定义的生成式媒体模型(如视频生成、数字人合成和图像处理),并获得无需自己搭建的生产级编排能力。你只需带上自己的 Docker 容器,自动扩缩容、排队、流量隔离和监控都由 Together 负责。对于已经在 Together GPU Cloud 上训练模型的团队,从训练到上线无需传输任何制品。Creatify 和 Hedra 等客户已实现 1.4 到 2.6 倍的推理加速,这既得益于平台架构,也来自 Together 研究团队亲手参与的优化。
自创立以来,Together 一直为大规模 LLM 推理提供支持。我们对这个领域有深入的理解,并打造了针对无状态请求、基于 token 的延迟和高度优化的服务路径的产品。
Dedicated Container Inference 则是为另一类工作负载打造的。
在过去一年里,我们与将自定义的非 LLM 模型部署到生产环境的团队紧密合作。这些模型远不止“文本进、文本出”的 API:视频生成流水线、数字人合成、大规模图像处理,以及带有真实业务约束的自定义音频/媒体模型。
这些团队始终需要的,不只是 GPU 或容器。他们需要一种方式,在生产环境中运行自定义推理代码,而不必自己搭建任务编排层。自动扩缩容、排队、流量隔离、重试和监控都很重要,但没有人想在内部重新实现这一整套。
Dedicated Container Inference 就是我们对这一空白的回应,它为 AI 原生云带来了面向自定义模型的生产级编排。
你提供容器和推理逻辑,我们负责部署、自动扩缩容、排队以及任务级别的监控,这一切都专为 GPU 密集型工作负载而构建。
它有什么不同?
大多数推理平台围绕单一抽象来优化,要么是无状态端点,要么是大型批处理任务。这在你同时面对实时流量、批量流量、客户分级和突发需求高峰之前都没问题。
Dedicated Container Inference 围绕你的容器的任务编排来构建,从而实现:
- 多个独立队列,而不是单一的 FIFO 流
- 由策略驱动的流量控制,而不是按请求设置优先级
- 批量、实时和不可信流量之间相互隔离
- 高峰期行为可预测,且无需过度预配
不过,差异不只体现在推理阶段。Together 是端到端的“训练到推理”平台。在 Together GPU Cloud 上训练的模型,可以直接部署为专用容器,无需任何制品传输或额外工作。
对于构建自定义模型的团队,这种紧密的闭环降低了运维开销,让从训练到生产的过程更顺畅,也不会引入新的故障模式。
架构一览
Dedicated Container Inference 构建在基于容器的部署框架之上,其中任务和队列是一等公民。我们不会强行把推理塞进单一的请求-响应形态,而是把你的容器视为执行单元,并管理它周围的一切。
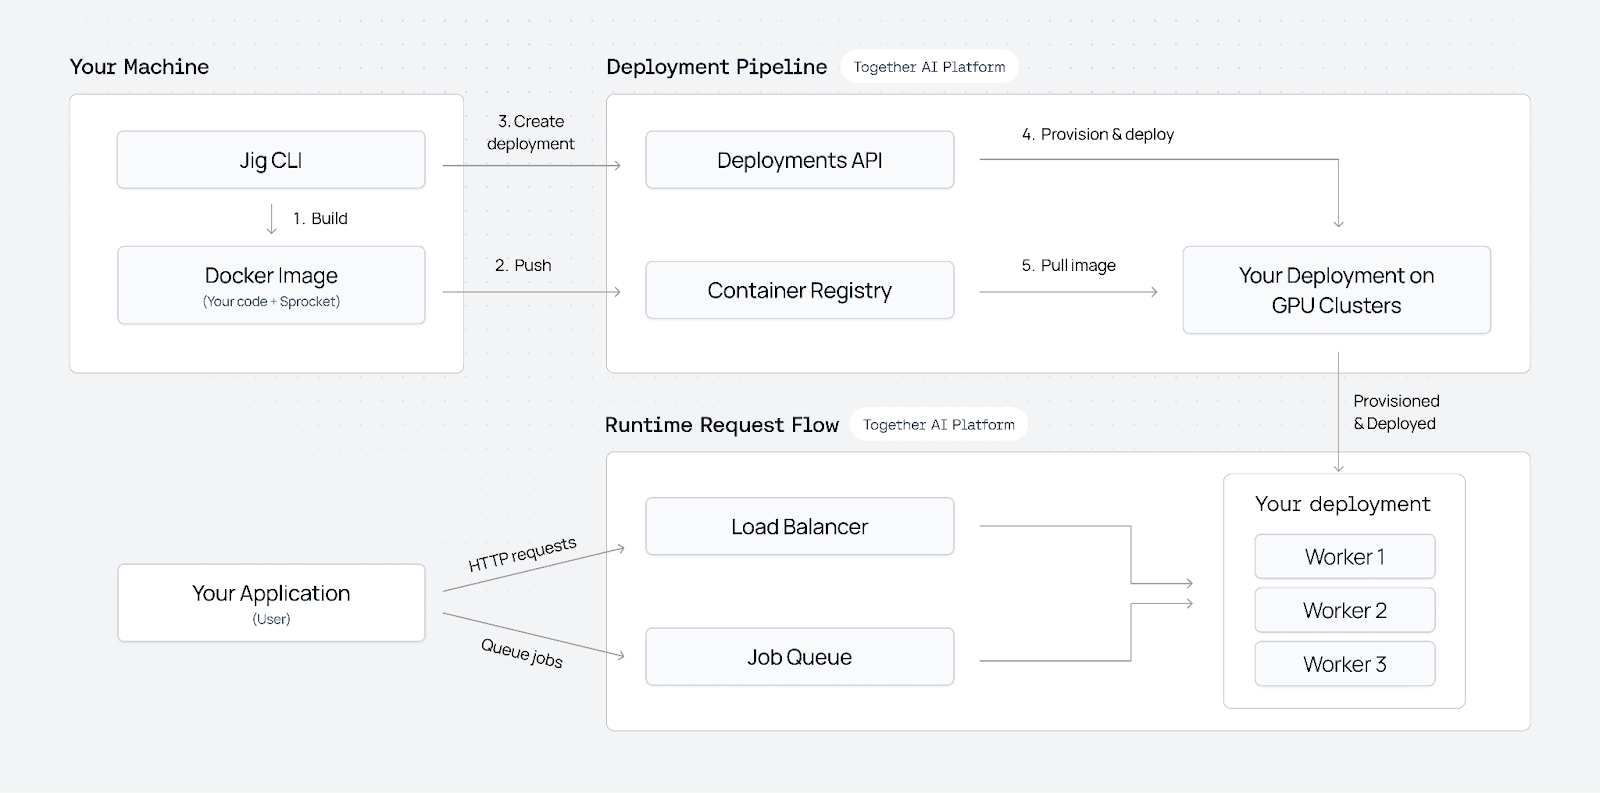
概括来说:
你把模型打包成 Docker 容器容器包含你的运行时、依赖项和推理代码。推理如何运行、使用哪些库,都由你决定。
我们在 GPU 基础设施上部署并管理该容器Together 负责预配 GPU、启动副本、处理网络、健康检查和监控。你无需直接管理集群或节点。对于需要多块 GPU 的大模型,我们通过 torchrun 内置支持分布式推理。
用卷挂载存放模型权重每次更新权重都重新构建一个 50GB 的容器,既慢又贵。使用卷挂载,你只需上传一次权重,并在部署时挂载即可。
推理以任务形式运行请求会进入队列,由从你的部署中拉起的 worker 执行。这支持长时间运行的任务、批处理工作负载和混合流量模式。
由队列深度或你选择的指标驱动自动扩缩容可根据利用率、队列长度、加权队列优先级、视频时长等任务特征,或目标等待时间,来扩缩容量。
流量策略是显式的你可以定义多个队列,并按客户等级、用例或 SLA 控制优先级。批处理工作负载不会干扰实时请求,付费用户在高峰期也能得到保护。
内置可观测性指标、日志和任务状态开箱即用,方便你监控运行状态。
提升生产工作负载的性能
对于生成式媒体工作负载,推理速度上的小幅提升,很快就会累积成成本和延迟上的大幅收益。
借助 Dedicated Container Inference,团队可以受益于我们的研究流水线,从自动内核优化,到针对具体工作负载的性能改进而进行的亲手剖析与调优。
“基础设施成本可能在 AI 公司扩张时拖垮它。Together 的 Dedicated Container Inference 为我们解决了两个关键问题:在不过度预配的情况下应对不可预测的爆款流量,并把我们本已颇具竞争力的模型性能再提升一个台阶。
他们的研究团队实现了显著的无损加速,直接改善了我们的单位经济效益,而且没有牺牲质量。他们不只是提供 GPU,还与我们合作,让我们的大规模推理更高效。这种技术层面的合作,加上生产级的基础设施,让我们可以专注于打造产品,而不是管理集群。”
— Ledell Wu,Creatify 联合创始人 & 首席研究科学家
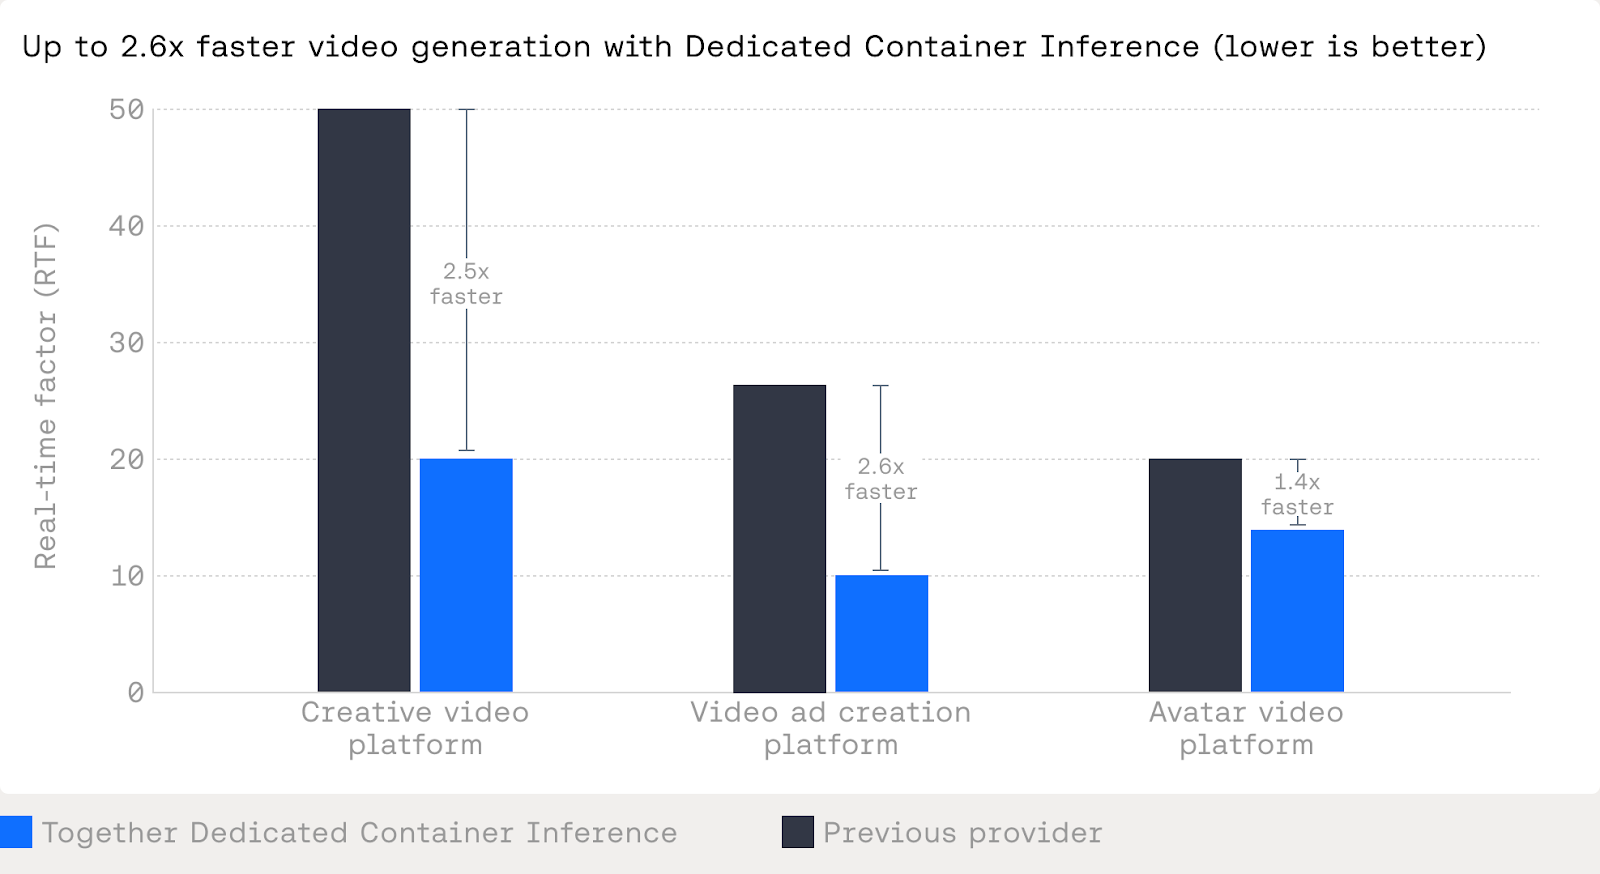
在各个生产部署中,我们看到了:
- 视频生成模型的实时因子大幅下降,从每秒输出需要数十秒,降到了低两位数
- 通过更好的批处理、调度和多 GPU 执行,数字人和视频合成模型获得了显著加速
- 端到端的改进,让原本不具经济性的模型成为可行的生产服务
这些收益来自平台能力与亲手优化工作的结合。最终带来更低的延迟、更低的每秒输出成本,以及负载下更可预测的扩缩容行为。
“Together AI 的研究人员与我们合作,优化了我们模型的推理性能。正是这种亲手参与的工作,让我们的模型明显变快了。
他们的基础设施轻松消化了爆款流量。在大幅流量激增期间,Dedicated Container Inference 能够无缝扩容,同时保持性能。
而且因为我们是在 Together 的 Accelerated Compute 上训练的,部署到生产环境毫无阻力。一个平台,零制品传输,没有部署烦恼。”
— Terrence Wang,Hedra 创始机器学习工程师
开始使用
如果你正在部署自定义模型,并且需要生产级的编排,Dedicated Container Inference 正是为这种场景设计的。你对容器和推理逻辑保有完全控制权,部署、扩缩容、排队和监控则由我们来管理。