摘要
在生产环境的编码智能体工作负载上,Together Inference Engine 在相同硬件下的 TPS 比次优的开源引擎高 31%,并在饱和状态下保持 2 倍的 TTFT 优势。这些收益来自全栈优化:ThunderMLA、自定义内核重写,以及基于真实流量的端到端性能剖析。
大多数推理基准测试衡量的是单个用户访问专用端点的情形。数字很好看,但对于推断生产环境的表现毫无用处。
在生产环境中,你要同时处理几十甚至上百个并发请求。它们争抢同一份 KV cache、同一份内存带宽、同一批 GPU 周期。重要的是系统在负载下每位用户的体验会怎样。
我们构建这个基准测试,就是要针对编码智能体回答这个问题。这类工作负载对推理的压力很大:输入长、并发高,而且不能容忍负载下的延迟劣化。
这是第一版,我们会随着构建进展持续更新。
编码智能体工作负载是什么样的
编码智能体的请求携带大量上下文:正在编辑的文件、周边代码、对话历史、检索到的代码片段。输入很长。输出有实质内容但有界,生成的是一个函数,而不是一篇文章。
更难的挑战是并发。许多用户同时访问端点,这些请求之间的相互作用是单用户基准测试永远无法捕捉的。随着流量增加,KV cache 逐渐填满,调度压力上升,单用户吞吐量下降,首词元时间(TTFT)攀升。到了某个临界点,系统就不再可用。不同引擎抵达这个临界点时的流量水平差别很大。
我们设计了一个高流量基准测试来做压力测试,其依据是我们在大规模服务生产环境编码智能体流量时看到的请求分布。提示词长度从约 45k 到 200k 个 token 不等,模拟真实编码会话的增长,生成长度平均约 450 个 token。关键指标是 TPM(每分钟输入 token 数)、每用户 TPS(每秒 token 数)和 p50 TTFT。
推理必须做对什么
对编码智能体而言,TTFT 决定了工具用起来是快还是坏。开发者提交请求后,在第一个 token 到达之前什么也看不到。从提交到开始流式输出之间的这段间隔,决定了信任的得失。输出速度也重要,但属于次要:一旦 token 开始流出,即便生成速率一般,体验也会很流畅。
第二个约束是长上下文下的并发。编码智能体的请求不仅长,而且同时到来。几十位开发者同时访问同一个端点,每个请求携带 80k 以上 token 的上下文,由此产生的 KV cache 压力是单用户基准测试永远看不到的。缓存填满后,调度器的回旋余地越来越小,预填充延迟攀升,TTFT 恶化。在足够高的流量下,系统在正式失效之前就已经失去了可用性。
第三个约束是输出形态。生成的是一个函数,而不是一篇文章。生成长度有界,平均约 450 个 token,这意味着饱和状态下的吞吐量表现与摘要或文档生成类工作负载不同。系统承受的不是持续的解码压力,而是持续的预填充压力,外加频繁的短促解码。针对长时间解码优化的引擎,在这里未必能赢。
TTFT 敏感性、并发长上下文负载,以及预填充为主的输出形态,这三个约束正是这个基准测试要施压的对象。
方法
硬件:每个引擎使用 4 块 NVIDIA B200(SGLang 使用 8 块 B200,见下方说明)。
工作负载:长提示词、高并发、真实的会话更替。提示词长度从约 45k 到 200k 个 token 不等,模拟真实编码会话的增长。生成长度平均 450 个 token(p50:293,p99:2,230)。难度随流量增加:QPS 越高,提示词越长、KV cache 越大,预填充压力越大,需要维护的上下文越多,会话更替增加也会带来更多 KV cache 抖动。
EAGLE 推测解码:3 个草稿 token。接受率(约 70%)是从逼真的合成提示词数据中自然得出的,并非人为设定。
引擎配置:TensorRT-LLM 针对该工作负载调优得很好,是一个强基线。SGLang 在可能的范围内按其对齐配置;我们没有做穷尽式调优实验,因此可能还有少量改进空间。所有引擎均按低延迟配置。这与吞吐量优化的配置不同,后者会增大解码最大批大小,并采用预填充-解码分离,以牺牲输出 TPS 换取更高的输入 TPM。
我们优化了什么
我们的性能提升来自把推理当作全栈问题来对待:端到端做性能剖析,找出开销最大的操作,再逐个消除。
ThunderMLA。Kimi K2.5 使用 DeepSeek 的多头潜在注意力(Multi-head Latent Attention,MLA)架构。标准实现每个解码步骤要启动两次独立的内核。我们的 ThunderMLA 属于 ThunderKittens 内核库,它把这两次启动融合成一个单一的巨型内核(megakernel),消除了启动开销以及两者之间的尾部效应。在有代表性的解码工作负载上,ThunderMLA 比 DeepSeek 自家的 FlashMLA 快 20% 到 35%。
除了 ThunderMLA,我们还对整个栈做了性能剖析,包括驱动行为、内存布局和内核执行,并消除了找到的每一个瓶颈。有些只需修改配置,有些则需要从零编写内核。在这一工作负载上,我们编写的内核表现优于 TensorRT-LLM 的开源同类实现。
下面看看这些优化在负载下转化为整个系统的表现。
结果
我们在启用 EAGLE 推测解码的 Kimi K2.5 上,将 Together Inference Engine 与两个基线进行了对比:
- TensorRT-LLM:4 块 NVIDIA B200 GPU
- SGLang:8 块 NVIDIA B200 GPU
关于 SGLang 的说明:在 SGLang 上以 TP4 运行带 EAGLE 的 Kimi K2.5 时发生了内存不足,在这个模型上 SGLang 的 EAGLE 实现比 TensorRT-LLM 需要更多内存。我们改用 TP8(8 块 GPU)来运行。TensorRT-LLM 和 Together Inference Engine 则运行在 4 块 GPU 上。
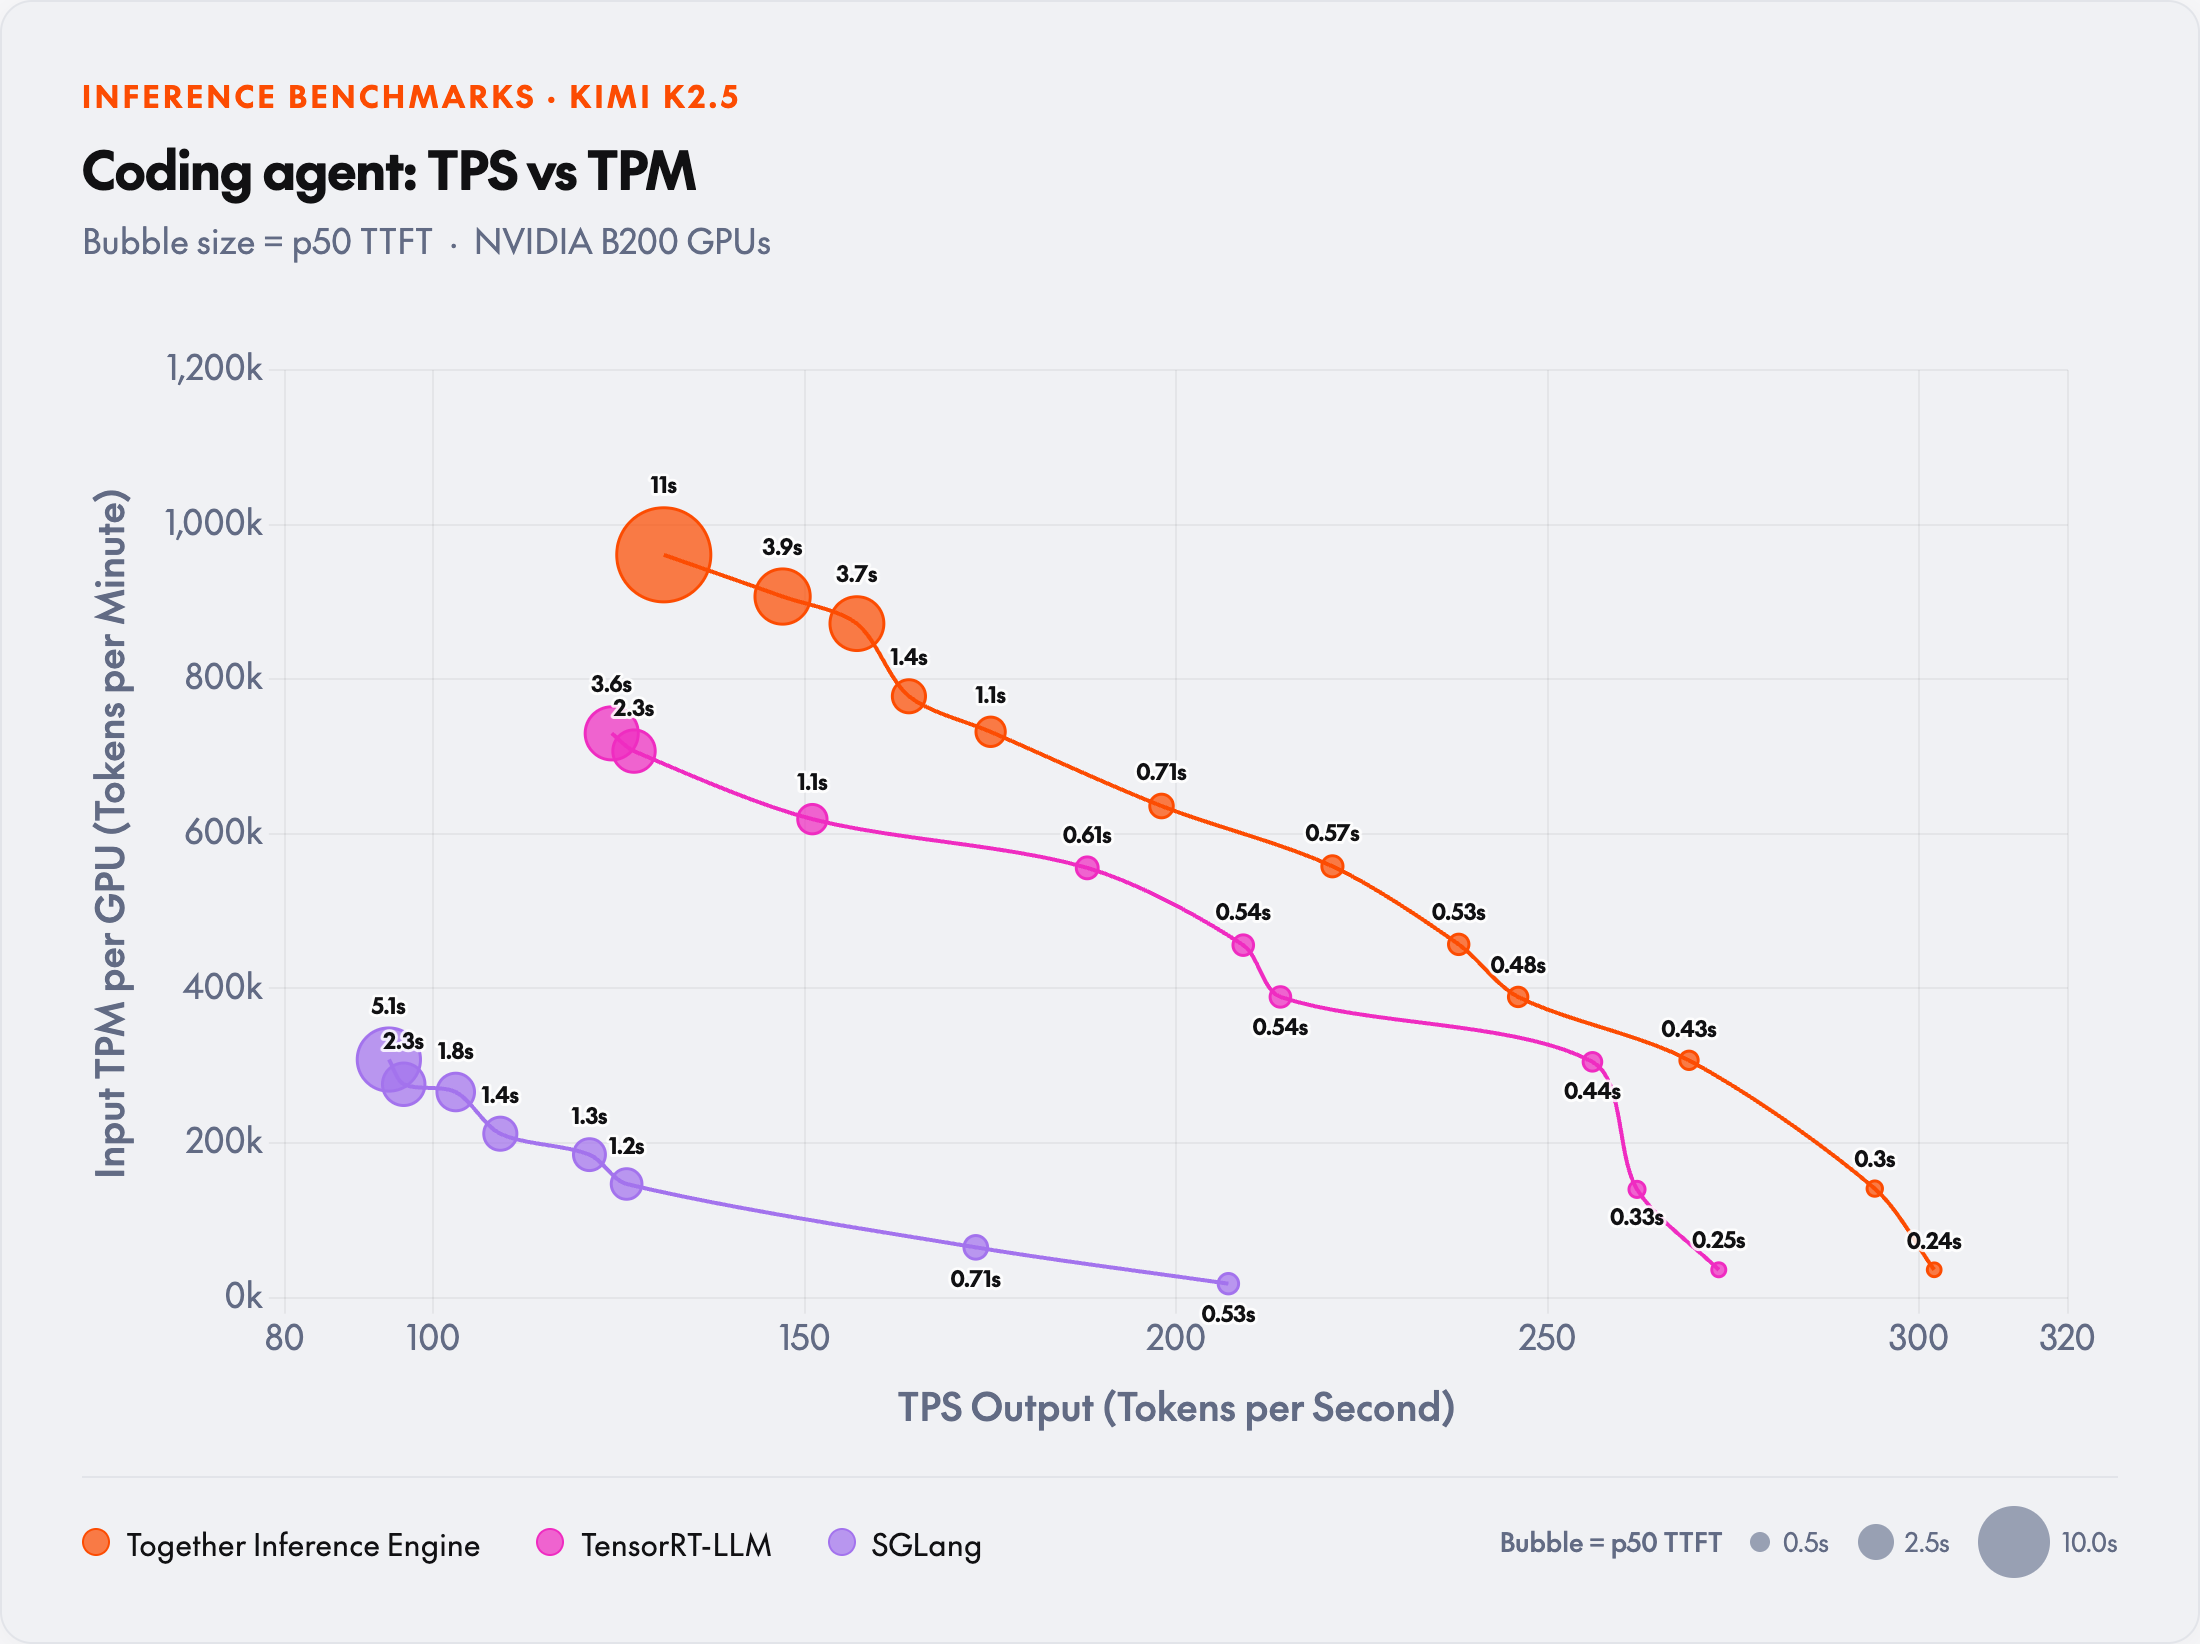
在每块 GPU 625 TPM(总计 2.5M TPM)时,Together Inference Engine 的 TPS 比 TensorRT-LLM 高 31%,并且是唯一仍保持 TTFT 低于 1 秒的引擎。
The 劣化曲线
曲线的形状比任何单个数据点都更重要。每个推理引擎最终都会饱和:KV cache 填满,调度压力上升,TTFT 攀升。引擎之间的差别在于这件事何时发生,以及发展得有多快。
在 2.5M TPM 时,每个引擎都已超出其舒适区间:
| 引擎 | GPU 数量 | p50 TTFT |
|---|---|---|
| Together IE | 4 | 0.71 秒 |
| TensorRT-LLM | 4 | 1.1 秒 |
| SGLang | 8 | 5.1 秒 |
在 2.5M TPM 下测得。
在所有引擎都在劣化的流量水平下,Together IE 的 TTFT 比 TensorRT-LLM 好 2 倍,比 SGLang 好 3 倍。系统拥有更多余量:在其他引擎已无法正常工作的负载下仍然可用。
成本与质量
本文中的性能基准测试是在 Kimi K2.5 上进行的。Kimi K2.6 现已在 Together 上线,在编码基准测试上全面追平或超过 Claude Opus 4.6。
| 基准测试 | Kimi K2.6 | Kimi K2.7 Code | GPT-5.5 | Claude Opus 4.8 |
|---|---|---|---|---|
| 编码 | ||||
| Kimi Code Bench v2 | 50.9 | 62.0 | 69.0 | 67.4 |
| Program Bench | 48.3 | 53.6 | 69.1 | 63.8 |
| MLS Bench Lite | 26.7 | 35.1 | 35.5 | 42.8 |
| 智能体 | ||||
| Kimi Claw 24/7 Bench | 42.9 | 46.9 | 52.8 | 50.4 |
| MCP Atlas | 69.4 | 76.0 | 79.4 | 81.3 |
| MCP Mark Verified | 72.8 | 81.1 | 92.9 | 76.4 |
在这样的质量水平下,成本差异非常显著。以该工作负载上的典型请求为例,约 80k 到 100k 输入 token、约 450 输出 token:
| 模型 | 单次请求成本 |
|---|---|
| Together 上的 Kimi K2.7 Code | $0.029 |
| Claude Opus 4.8 | $0.097 |
每次请求便宜 70%。一个 150 人的工程团队以 7.5M TPM 每天运行编码智能体 5 小时(每年 250 个工作日),与 Claude Opus 4.8 相比,每年可节省约 $421K 的推理成本。
这是第一版
这些结果反映的是 Together Inference Engine 当前在该工作负载、该硬件配置下的水平。我们发布它们,是因为我们认为基准测试应当有意义:基于真实的工作负载形态,方法透明,并坦诚说明系统在哪里开始出问题。
每次更新都是增量式的。目标是留下一份持续的记录,说明在一个你能够推理的工作负载上,优化究竟能带来什么。下一版发布时,我们会明确展示改变了什么,以及数字为何变化。
如果你正在大规模运行编码智能体,想了解这对你的工作负载意味着什么,请联系我们。