- Together AI 是 MiniMax M3 的首选云合作伙伴。待该开放权重模型公开发布后,Together AI 将把它作为开发者端点托管上线。
- 我们的推理团队和内核团队取得了多项关键工程突破,实现了对 M3 的高效服务,包括 KV-Block-Major 稀疏注意力内核、面向 MSA 的全新分页注意力集成、高度优化的索引打分内核,以及基于 Rust 的多模态预处理网关等关键优化,使不同并发水平下的吞吐量提升了 81%–125%。
- 在生产环境中大规模服务 MiniMax M3,印证了 Together AI 是首选推理平台:对于那些在棘手的系统问题上不断突破前沿、而这些问题又决定着实际部署能否落地的模型,它都能胜任。
MiniMax 发布了其最新的最先进模型 M3,Together AI 很高兴成为其首选云合作伙伴,帮助 MiniMax 在生产环境中大规模、高效地服务 M3。在 MiniMax M3 于未来几天内作为开放权重模型发布之后,Together AI 也将直接把该模型作为端点提供给开发者。支撑这一规模的,是我们推理团队和内核团队的出色工作:他们推动了深层的性能优化,并为这个不断突破前沿的模型确保了生产级的可靠性——1M token 上下文窗口、原生多模态,以及一种需要扎实工程投入才能高效服务的架构。在这篇文章中,我们将介绍这一切是如何实现的。祝贺 MiniMax 团队发布里程碑式的模型,并期待他们持续创新。
MiniMax M3 是一个集大成的模型,融合了最先进的编码能力、对智能体工作流的支持,以及原生多模态推理。在这些能力之上,它还被设计为支持 1M 上下文,同时服务成本非常经济。这使它非常适合真实场景中的任务:长文档、代码库、工具调用、图像和迭代推理常常同时出现,且上下文负担很重。与上一代相比,服务 M3 带来了更多挑战,因为新能力要求在更多维度上进行优化,包括稀疏注意力计算、更大的 KV cache 管理、多模态处理等。
架构 / 特性
M3 中最新颖的架构变化是 MiniMax Sparse Attention(MSA),其设计目的是解决 MiniMax M2.7 中出现的注意力计算瓶颈。它的块稀疏注意力机制限制了每个查询可以关注的 token 数量上限,从而降低了长上下文处理的成本,使大幅更长的上下文窗口变得切实可行。这使预填充阶段的速度提升超过 9 倍,解码阶段的速度提升超过 15 倍。
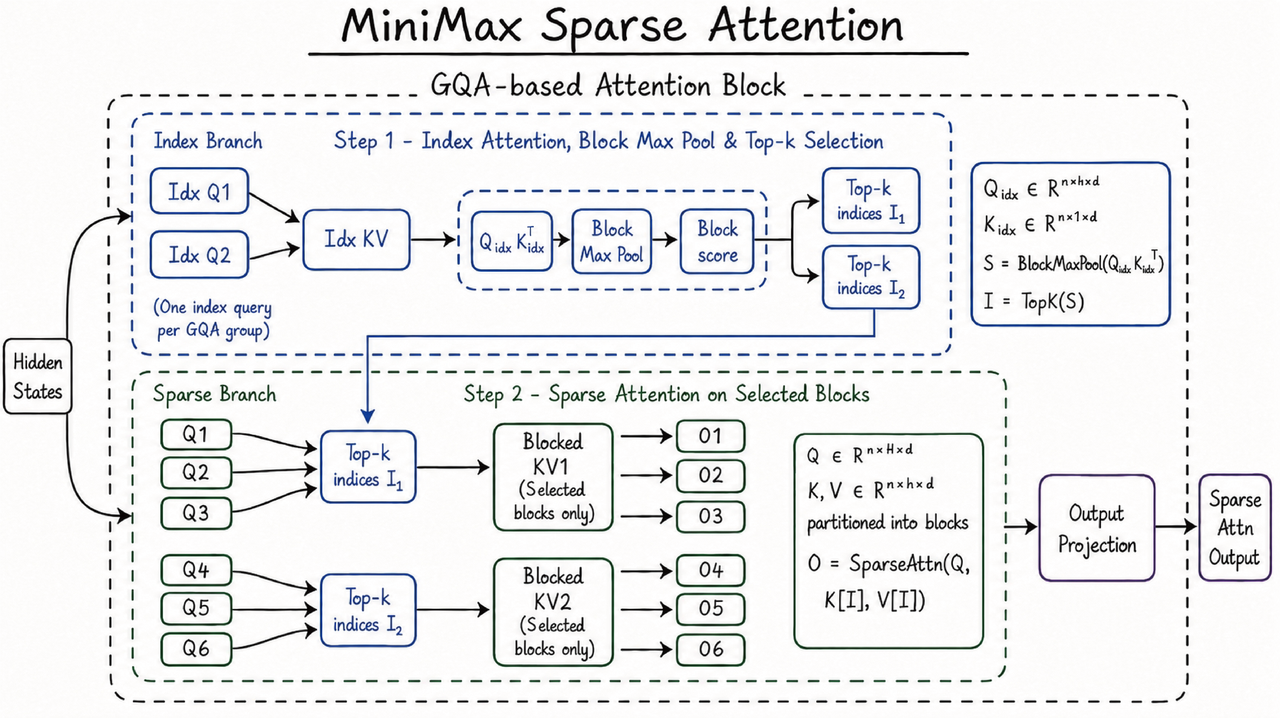
本质上,MSA 的计算由两部分组成:先做分数计算,为每个 KV 组确定最相关的 K 个块;然后在查询 token 与这些块之间做稠密注意力。这一设计在 KV 组维度上保留了表达能力,同时仍然限制了每个查询 token 所关注的 KV token 数量上限。注意力计算本身不再随上下文长度呈 N^2 增长,因此非常适合长上下文负载。
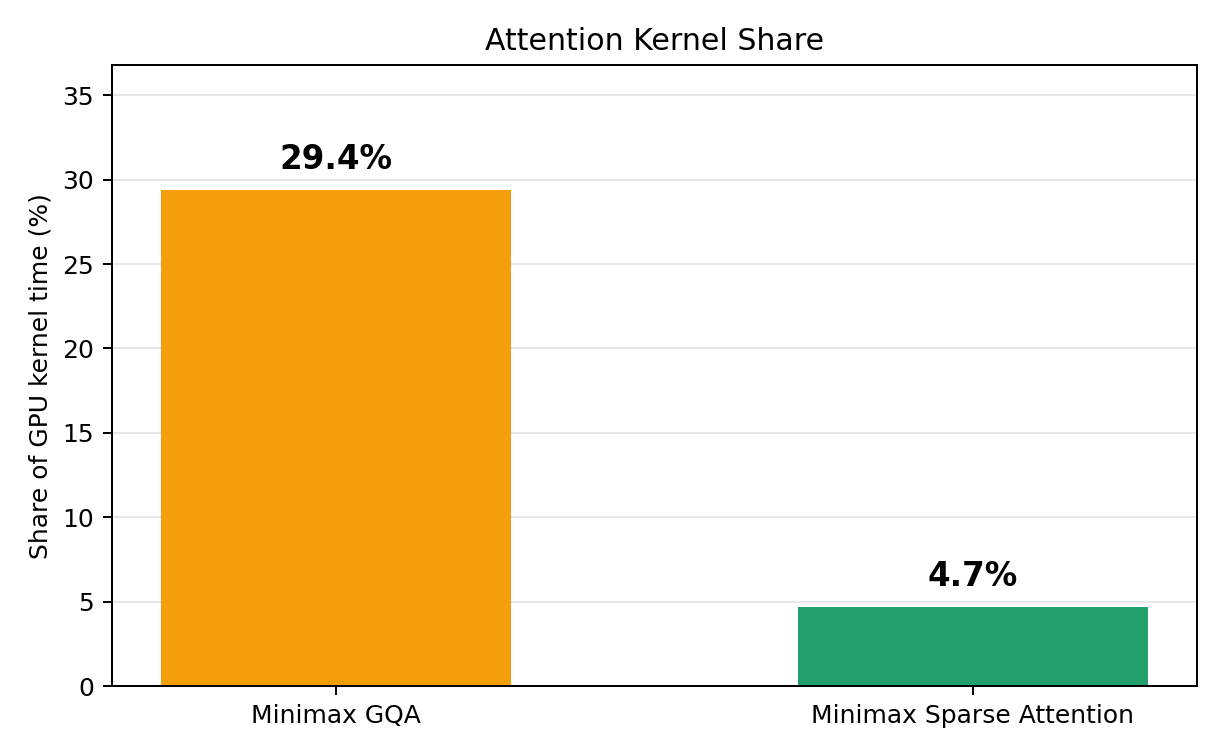
我们在 B200 上、并发数为 8 的情况下,针对智能体式的流量形态(60k 前缀缓存)测量了内核执行时间的分解。MSA 显著降低了每次迭代中实际注意力计算所占的墙钟时间比例。
除了注意力架构的变化之外,M3 还提供了多模态支持,包含视觉组件以及新的图像和视频预处理功能。
面对这些根本性的变化,Together AI 与 MiniMax 的工程团队紧密合作,应对新出现的挑战。主要挑战包括:
- 尽管 MiniMax 稀疏注意力的计算本身非常高效,但从工程角度看,支持 1M 上下文长度依然充满挑战。
- 视频和图像处理天然比文本分词复杂得多。
优化
KV-Block-Major 稀疏注意力
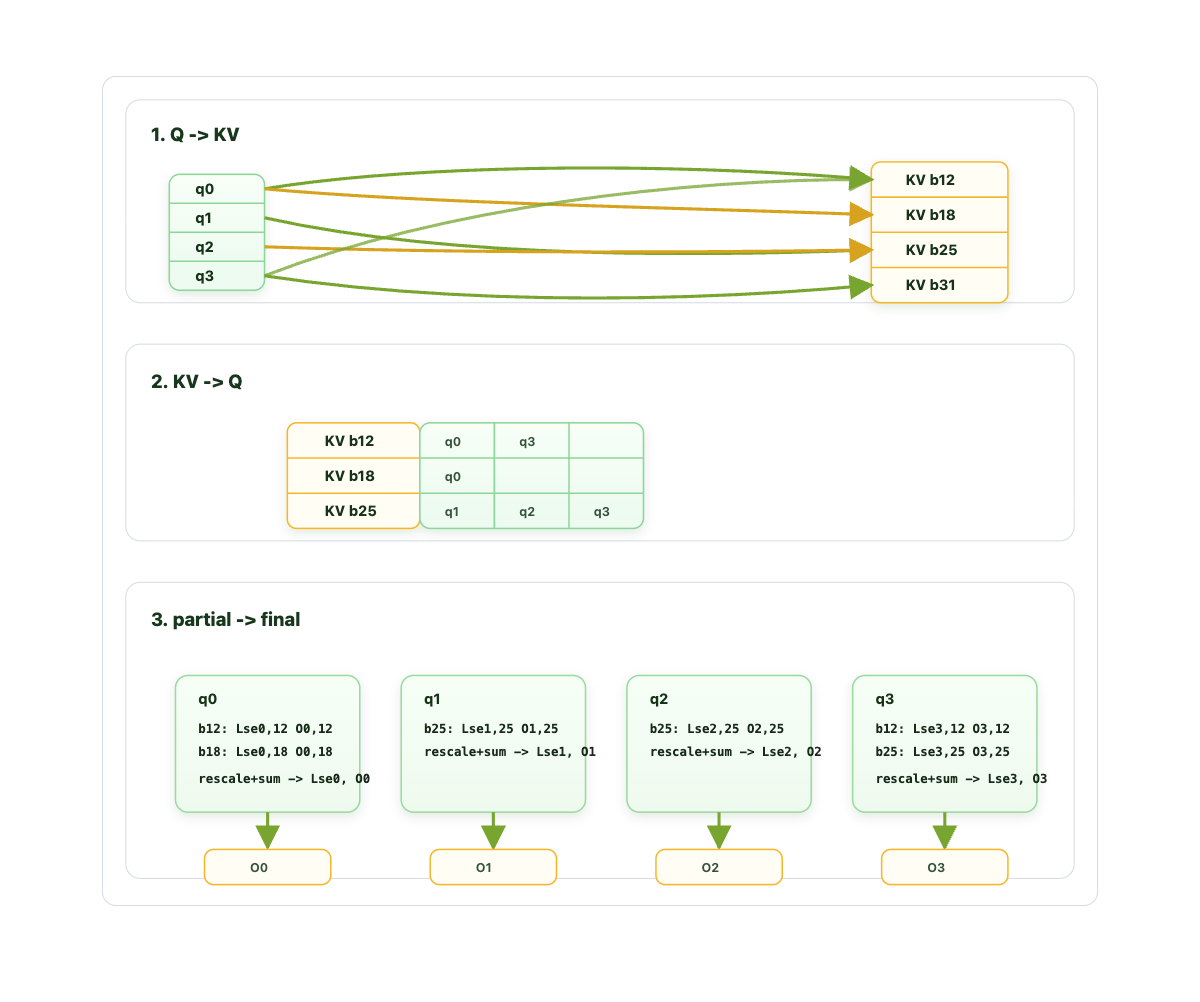
在预填充阶段,对于长上下文输入,注意力计算仍可能是一个重要因素,因为对每个 token,我们都需要计算 Selected Block * KV Head Group * Tokens。块稀疏注意力的特性使多个查询可以关注同一批键值块。因此,如果我们逐个查询去与键值块计算注意力,就会在 GPU 上重复地把 KV 从 HBM 搬运到 SRAM。改为在外层循环遍历键值组、在内层循环计算查询 token 之间的注意力,KV cache 只需搬运一次,从而获得更高的算术强度。
为此,我们需要把 {q, kv block} 的映射重组为 {kv block, q},并重新实现注意力内核。由于我们只针对该 kv 块计算部分输出 O,因此需要一个基于 Log-Sum-Exp 的最终“归约”步骤,对输出 O 进行重新缩放并求和。过程如下:
将 MSA 与分页注意力集成
在现代推理引擎中,分页注意力常被用来管理请求的 KV cache 上下文。大多数高度优化的注意力内核都只支持一组固定的页大小。阻碍我们使用这些内核的障碍在于:不同 KV 组所选中的块各不相同。
在 Together AI,我们提出了一种将 MiniMax Sparse Attention 集成进引擎的新方法。在解码时,我们先根据所选中的块构建页表,把 KV 组维度展平到 batch 维度中,并利用 KV cache 张量的步幅视图(strided view),为注意力内核提供检索 KV 页所需的指针。诀窍在于步幅:页地址按 D 递增以选定虚拟页的起点,而 token 则按 Hkv * D 递增。这样就把一个物理张量解交错为按头划分的页,于是每一个展平后的行都可以使用不同的页表。
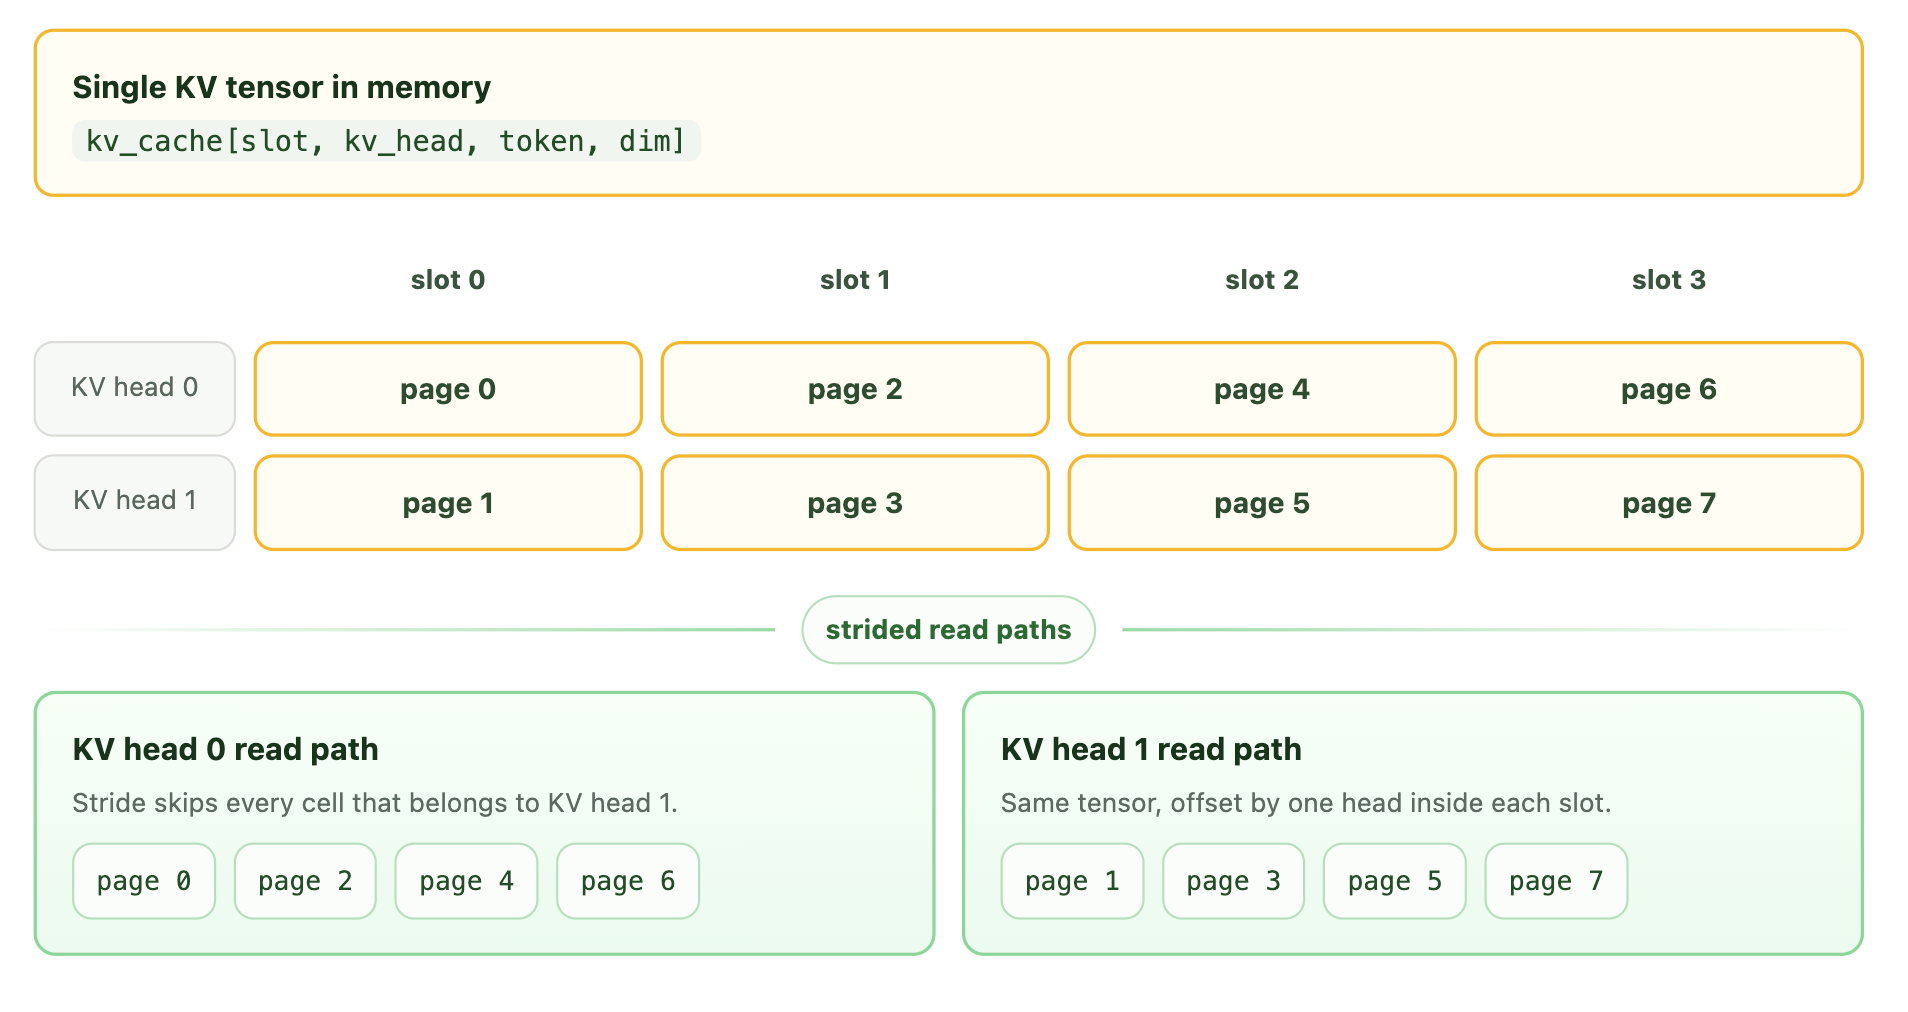
这一设计让我们可以直接使用现有的、支持 GQA 的注意力内核,而不必从零重写一个支持稀疏注意力的新内核。由于每个查询所选中的块数量有限,查找块到页映射的内核开销非常低。该设计使解码吞吐量提升了 5%。
解码阶段索引打分内核优化
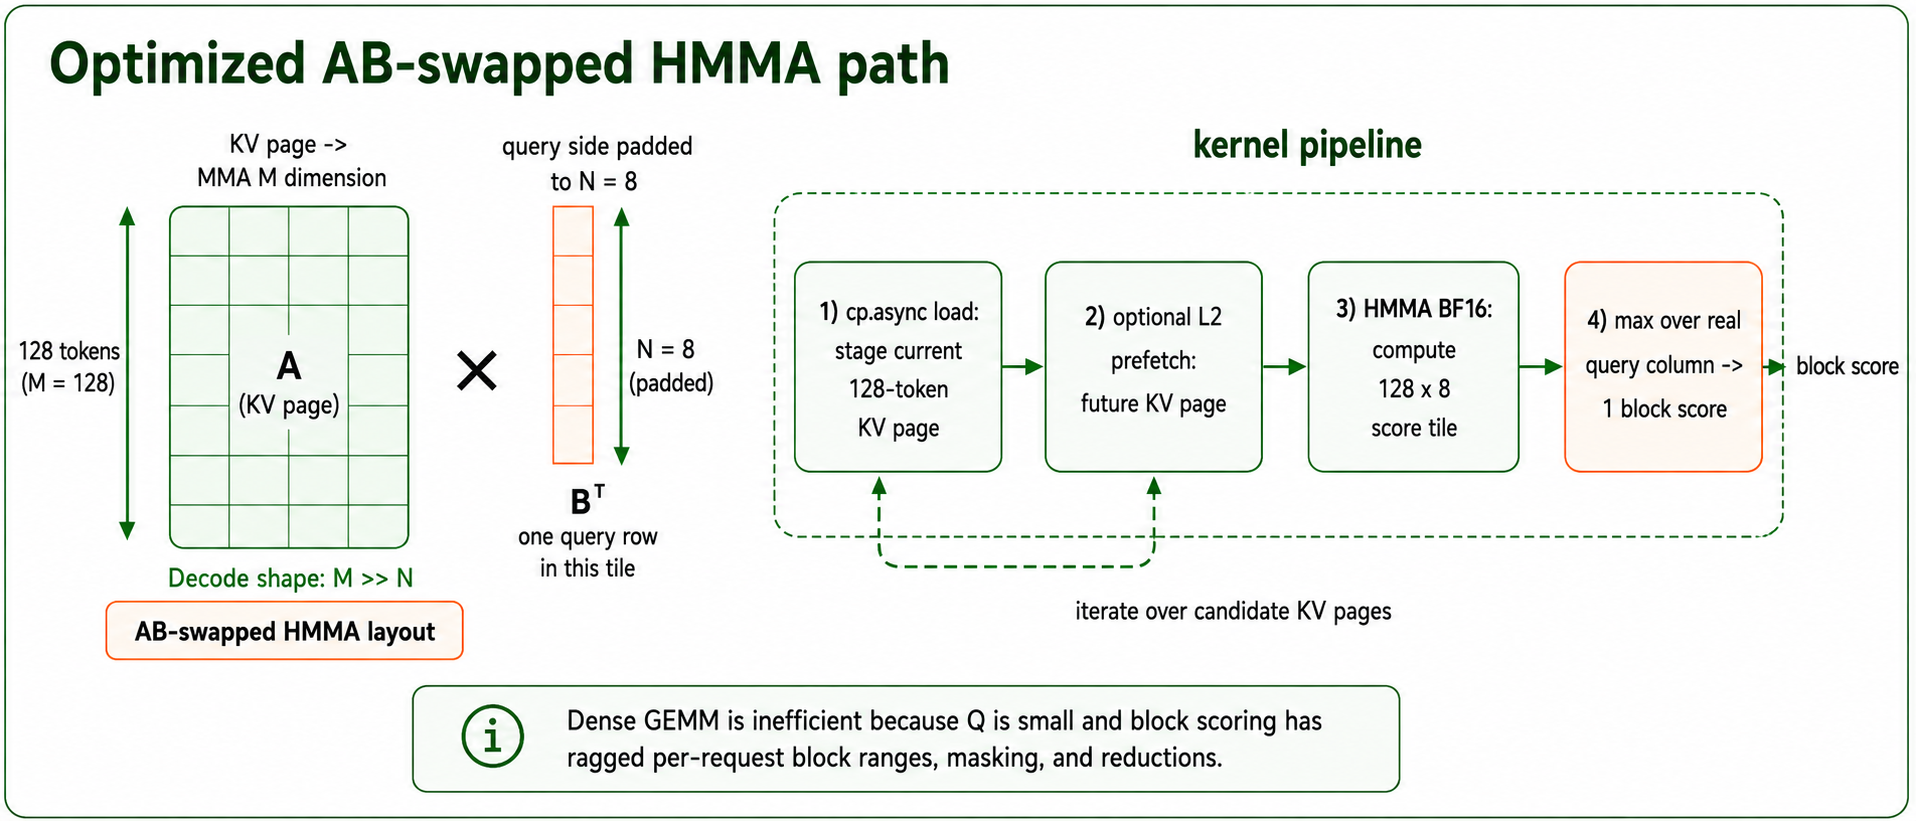
在解码阶段,MSA 把相当一部分成本从稠密注意力转移到了打分 / top-k 索引器上。对每个解码查询,引擎都要把查询侧的索引向量与候选的键侧索引向量进行比较,将每个 128 token 的 KV 块归约为一个分数,并只保留得分最高的若干块交给真正的注意力内核。这一扫描位于每个生成 token 的关键路径上,而且在长上下文下,候选块的数量随上下文长度增长。解码打分具有“查询索引小、键索引长”的形状。把一批解码查询当作一个更大的 GEMM 来处理看起来很诱人,但打分 / 索引步骤并不只是稠密矩阵乘法:每个请求和每个 K 组都有各自的候选块范围、掩码、逐块归约以及 top-k 边界。把查询拼接在一起,GEMM 周围仍然是一个参差不齐的 gather-and-reduce 问题,还会迫使关键路径上增加填充和额外的记账开销。因此,我们优化后的路径采用了 AB 互换的 HMMA 布局:128 token 的键索引块成为 MMA 的 M 维度,而查询侧只被填充到较小的 N 维度。该内核用异步拷贝暂存 128 token 的 K 索引,预取下一页,用 HMMA 以 bfloat16 计算点积,并把每页归约为一个块分数。
网关层的多模态预处理
SMG(Serving Model Gateway)是一个基于 Rust 的模型网关,位于兼容 OpenAI 的 API 与推理引擎之间。除了路由和分词之外,SMG 还承担了对多模态模型尤为重要的一个角色:在请求到达 GPU worker 之前,在 CPU 上完成全部视觉预处理。
图像和视频输入在能被视觉编码器使用之前,需要相当多的 CPU 工作:下载、解码、帧采样、缩放,以及转换为 patch 张量。如果在推理引擎内部完成这些工作,就会占用本应用于生成的资源。SMG 改为在网关中处理这一切,这样请求到达 GPU 时,张量已经准备就绪。
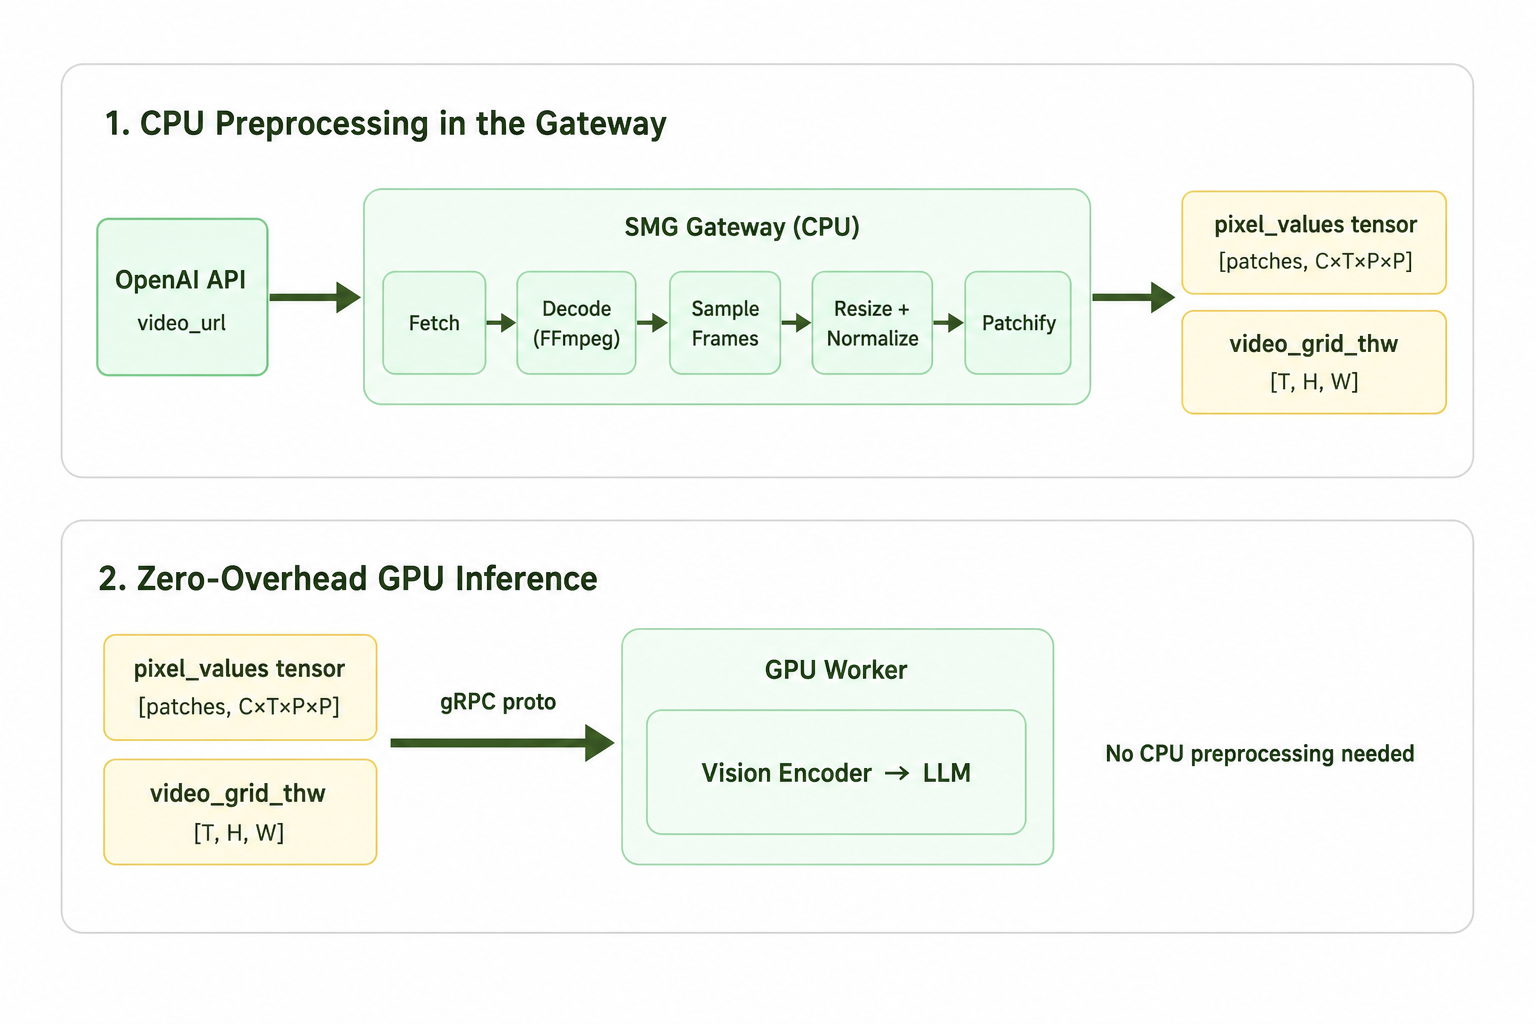
对 M3 而言,这意味着:获取视频,用 FFmpeg 抽取帧,按 FPS(每秒帧数)选取其中一个子集,缩放并归一化,然后在 patch 化时把时间维度一并纳入。最终输出的是一个扁平的 patch 张量和一个很小的网格元数据张量,并被打包进一条 gRPC 消息。worker 直接运行视觉编码器即可,自身无需任何预处理。
此外,SMG 的多模态流水线围绕 Rust trait 构建,把模型特定的预处理逻辑与流水线的底层管线分离开来。为 M3 增加多模态支持,只需用 M3 特有的常量实现这些 trait,流水线本身无需改动。同样的架构适用于大多数具备视觉能力的开源模型,并可推广到各种推理引擎运行时。
性能结果
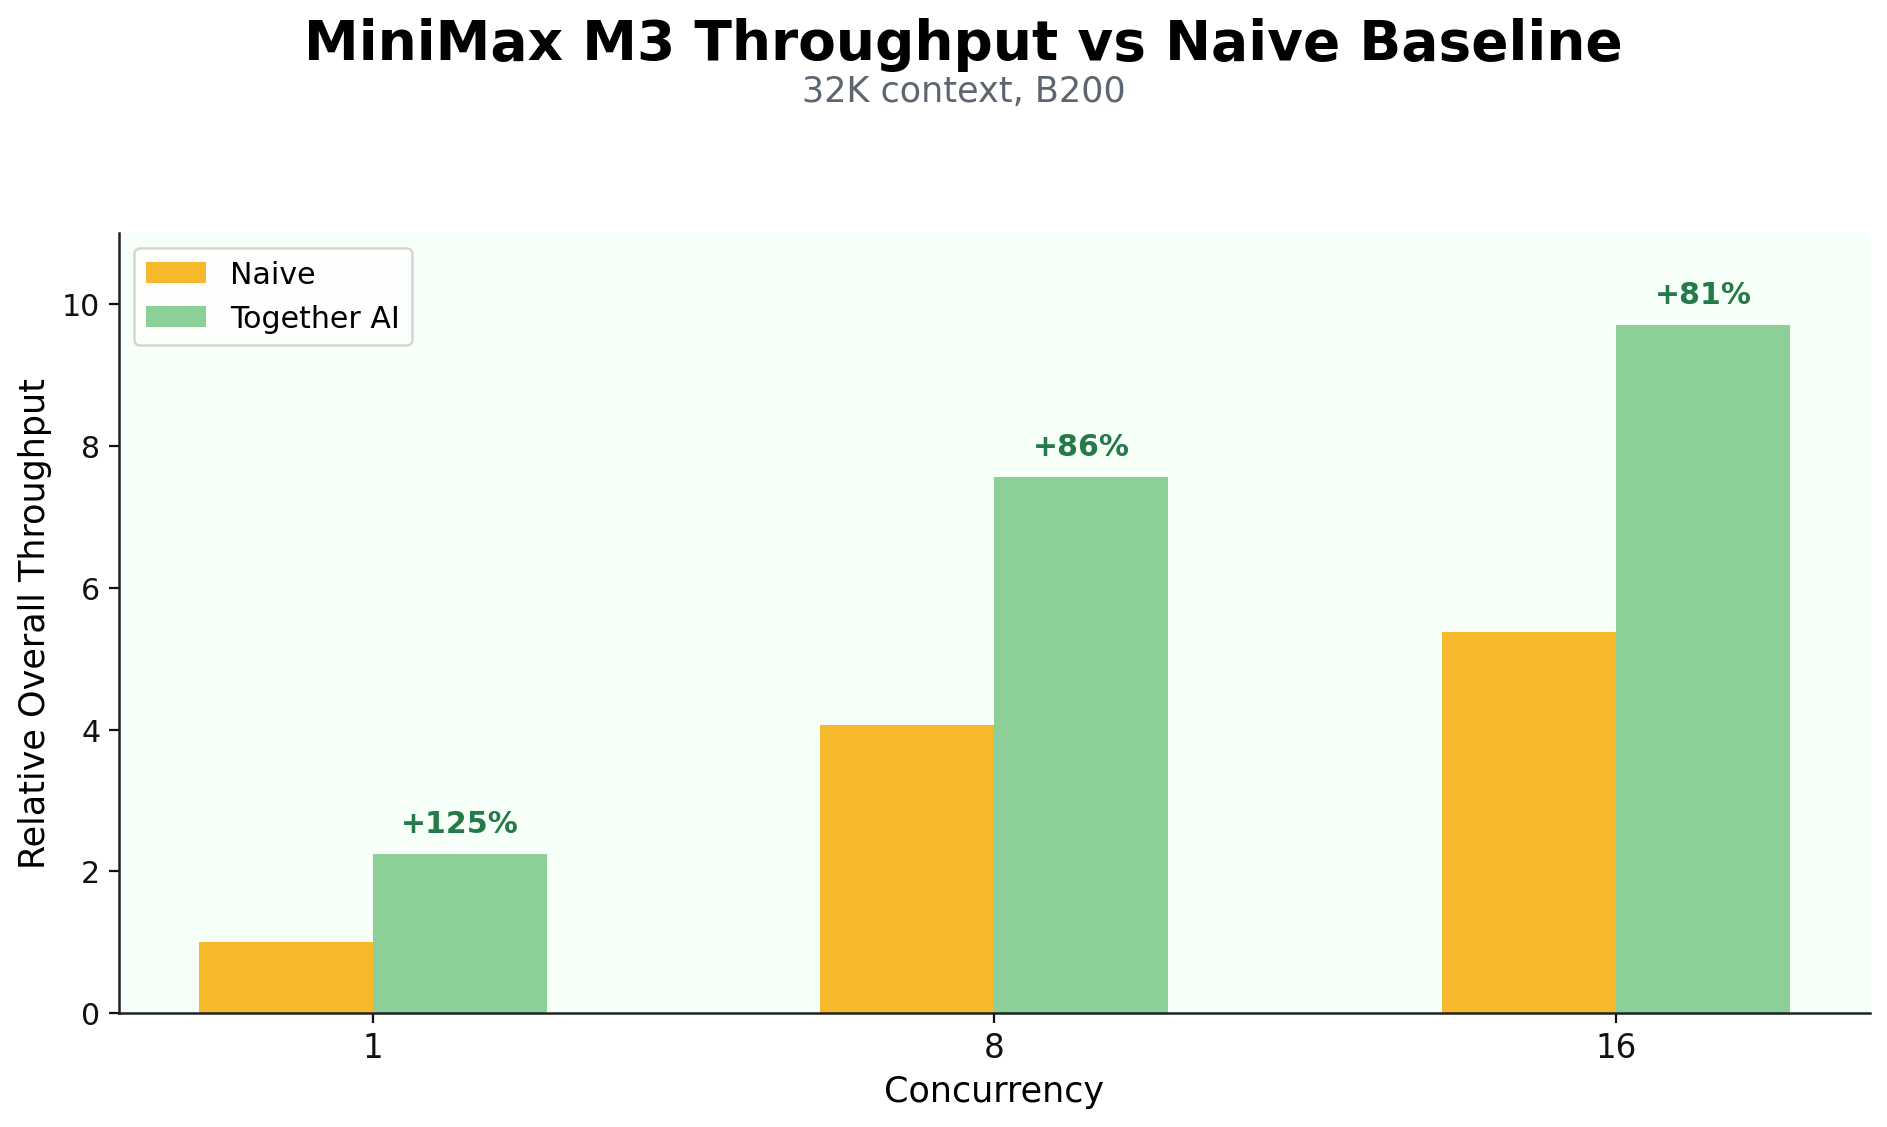
自拿到 MiniMax M3 的权重和模型架构以来,我们一直致力于提升推理性能。在常见的智能体式流量形态下,我们在不同并发水平上实现了 81%–125% 的提升。
未来工作
新架构带来了新的基础设施和工程挑战。在 Together AI,我们的目标是提供最佳的推理性能。我们正在积极推进的、与 M3 相关的几个课题如下:
1. 稀疏注意力架构引入了更多更小的内核,例如对 kv 块做 topk、把 q-kv 映射重映射为 kv-q 等,因此存在更多内核融合的机会。我们的内核智能体研究团队正在积极开发能够编写生产级内核的智能体。
2. k-index 与实际 kv cache 的 CPU 缓存卸载现在可以解耦。我们正在研究加载完整的 k-index,并根据 topk 选择结果按需加载 kv cache。
后续步骤
加入候补名单,以便在 M3 开放权重登陆 Together AI 时收到通知。
查看 MiniMax 模型设计者与 Together 推理团队的深度解析。