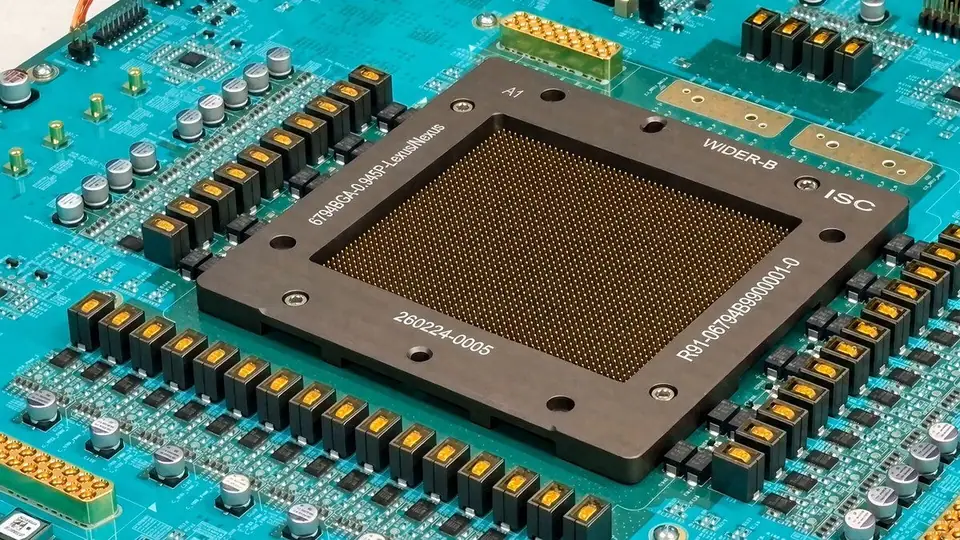
在第 37 届 Hot Chips 大会上,迄今最重磅的发布,是 OpenAI 在自研芯片上取得的惊人进展:距离与 Broadcom 的合作公告还不到一年,而且它并不是一颗 ASIC,而是一个足以超越 Blackwell 的完整替代方案。
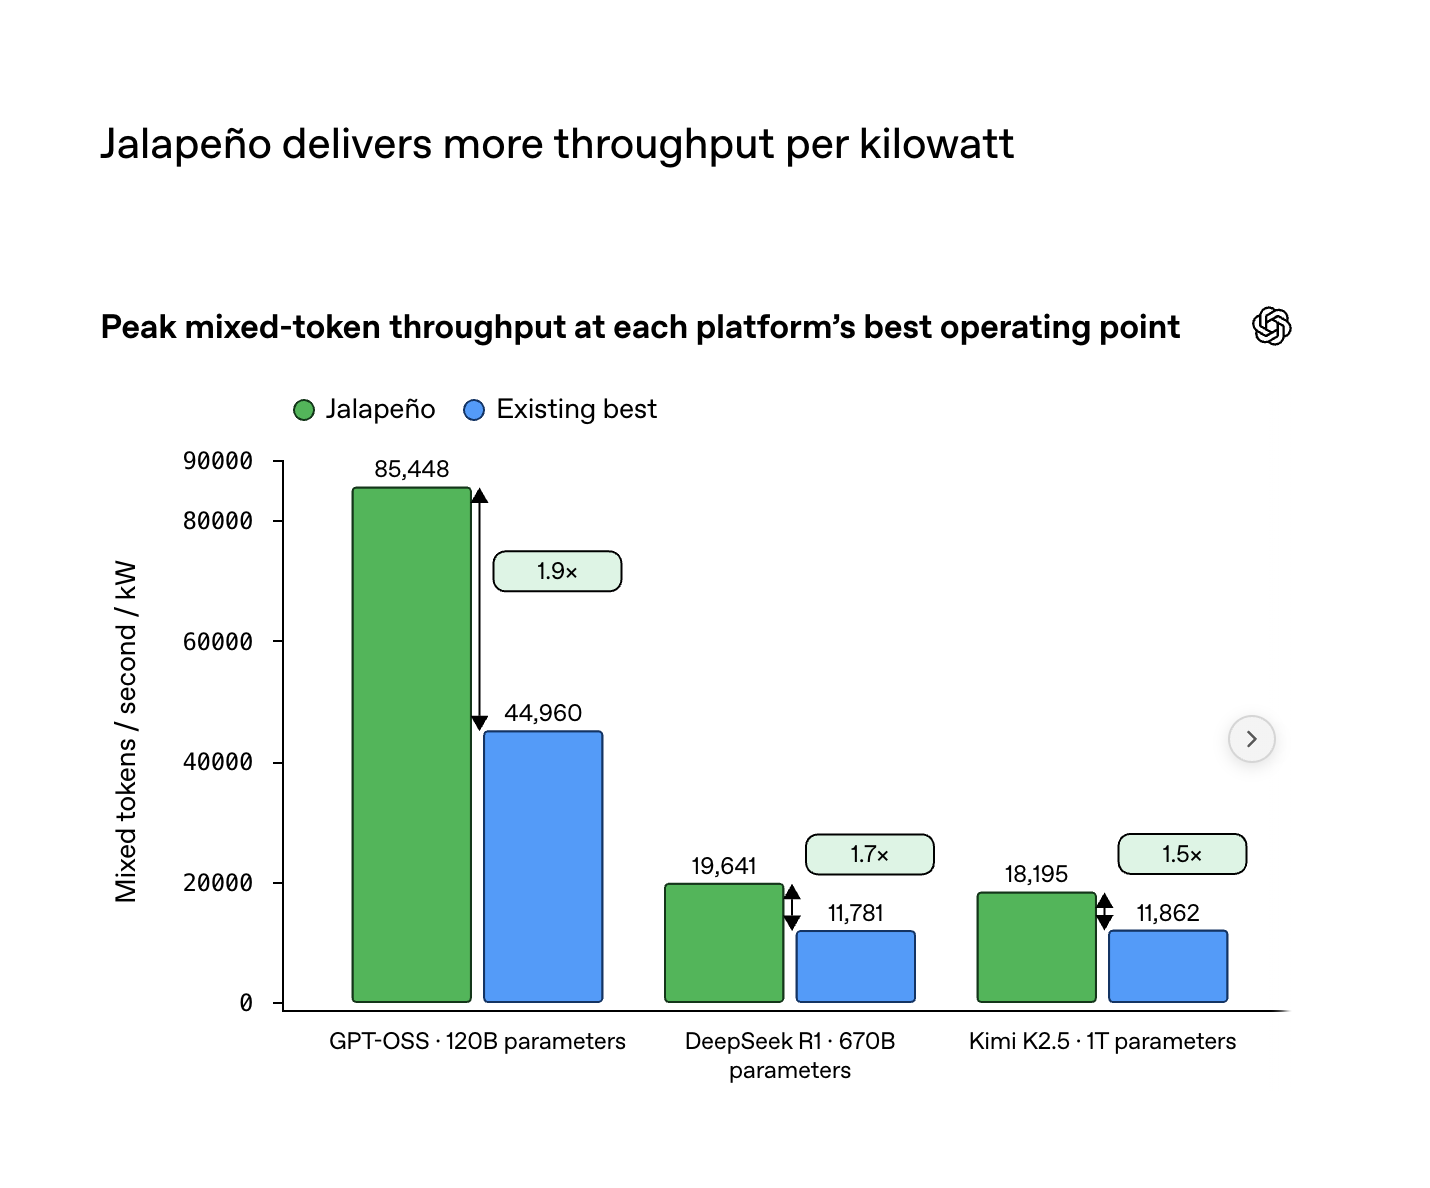
如今的关键指标正在转向每瓦性能,而 Jalapeno 交出了答卷:
Hot Chips 的完整演讲尚未公开,下面是各方的解读。想看更完整的拆解,可以和 OpenAI 其他人一起观看:
▶ https://www.youtube.com/watch?v=Ic0kYWjffjI
AI News,时间范围 2026 年 8 月 24 日至 8 月 25 日。我们查看了 12 个 subreddit、544 个 Twitter 账号,没有再查看 Discord。AINews 网站支持搜索所有往期内容。再提醒一下,AINews 现已成为 Latent Space 的一个栏目。你可以选择开启或关闭邮件频率!
AI Twitter 回顾
OpenAI 的 Jalapeño 推理芯片与推理栈的转变
- Jalapeño 公布的数据是当天最大的技术新闻:OpenAI 首次公布了其自研推理芯片 Jalapeño 的基准测试细节,称在真实模型负载上,其效率和延迟明显优于 NVIDIA GB200/GB300 系统。在 OpenAI 的测试中,Jalapeño 在峰值吞吐量下每瓦完成的工作量高出 1.5–1.9 倍,端到端延迟低 1.7–3.6 倍,在高交互性负载下性能高出 2.1–4.1 倍;该芯片额定功耗为 700W,但据称在测试运行中始终不超过 550W。OpenAI 表示,将在年底前开始在自家基础设施中部署,第二代已进入深度研发,第三代也已启动(OpenAI 公告、部署路线图、Sam Altman)。
- 工程师为何关注:这一说法不只在于原始性能,更在于一种更均衡的推理架构,缓解了常见的吞吐量与延迟之间的取舍。多条技术点评指出,有些对比项尤其值得注意:据称 Jalapeño 在某些配置下即使没有采用激进的 prefill/decode 分离或推测解码等手段,表现依然出色,同时还胜过了采用这些手段的系统(gdb、kimmonismus 的总结、eliebakouch 的分析、You Jiacheng)。SemiAnalysis 认为,对于第一代 ASIC 而言,这一表现异常强劲,并将其直接与 Blackwell 和 Rubin 级别的系统作了对比(SemiAnalysis、dylan522p)。
- 其次是模型辅助的系统优化:OpenAI 的文章还提到,GPT-Astra + Codex 协助编写并优化了底层内核,在大约两个月内让三个原先没有计划支持的开源权重模型在 Jalapeño 上跑出了高性能;对于选定的注意力和 MoE 模块,这些实现据称比现有的人类专家手写代码快 1.5–1.8 倍(kimmonismus、eliebakouch)。这是一个有意义的信号:编译器和内核工作正越来越多地被纳入模型改进的闭环,而不仅仅是应用层的编码。
- 更广泛的基础设施影响:多篇帖子把 Jalapeño 与一个更大的行业转变联系起来,即前沿实验室在推理经济性上可能不再完全受制于 NVIDIA,尽管封装和晶圆代工产能仍是硬瓶颈(Liam Fedus、teortaxesTex 的反应、LearnOpenCV 对 TSMC/CoWoS 产能的提醒)。
智能体 Harness、记忆系统与评测工程成为一等公民
- Harness 的质量越来越与模型选择同等重要:多篇论文和多个发布指向同一主题,即智能体的表现在很大程度上取决于周边系统。微软牵头的一篇关于 AutoSaddler 的新论文把 harness 视为代码,利用失败轨迹离线修补提示词、工具配置和控制逻辑,报告称相比基础 harness,在 GAIA2 上提升 9.0,在 SWE-Bench Pro 上提升 9.6,在 Terminal-Bench 2.0 上提升 10.0(论文总结)。与此同时,另一篇论文直接量化了 harness 带来的方差,发现更换 harness 对分数的影响可能远大于更换模型,模型对的排名还会随脚手架不同而翻转;提出的补救办法是一套结构化的 Harness Card 披露标准(分析、《不存在中立的 Harness》)。
- 长周期软件工程仍远未解决:SWE Refactor Bench 衡量的是整个代码仓库级别的迁移任务,如 C→Rust、Maven→Gradle 和 POSIX→WebAssembly,涉及 SQLite、zlib、libsodium 等真实项目。在 520 次运行中,只有 28 次通过了全部三个阶段,存活率仅为 5.4%,20 个任务中有 13 个无人解出(EinsiaAI)。这对那些更局部的编码基准上亮眼的修 bug 成绩是一剂有益的纠偏。
- 记忆系统正被重新设计为可编程的状态,而不是压缩后的聊天历史:DAIR 总结的一篇阿里巴巴论文,用仅追加的事件日志加持久的 Python 内核来支撑智能体会话,把工具输出和派生状态绑定到带类型的变量上,而不是不断地把它们序列化进提示词。报告的结果包括:LongMemEval_S 上 94.8%,BEAM_10M 上 73.1%(比此前公开的最佳记忆系统高 5.1),以及使用 Qwen3.8-Max 在 LOCA_256K 上 86.7%(总结)。关于 Knowledge Triage 的相关工作表明,朴素的上下文压缩会破坏对确切规则的保留;经过五轮压缩后,某个配置只保留了 10% 的安全规则,而类型感知的保留策略能多保留 2–4 倍(总结)。
- 实用的评测工程正从临时拼凑走向产品化的工作流:LangChain 及合作伙伴分享了一个具体的闭环,把轨迹和人工反馈转化为任务规范、合成环境和评测,可用于长期衡量并对智能体做后训练(Vtrivedy10、hwchase17)。LangSmith Engine 也发布了更新,在关键内部基准上的表现提升了 >2 倍,问题检测和聚类更好,支持 SaaS 和自托管,集成了 Slack/Linear,并提供按成本分级的分析模式(LangChain)。
本地优先的智能体、端侧推理与新的个人计算栈
- Perplexity 的 Portable Computer 是当天最清晰的本地智能体产品发布:Perplexity 在 NVIDIA DGX Spark 上推出了 Portable Computer,将其定位为 Perplexity Computer 的完全本地版本,其中编排器 LLM、子智能体 LLM 和智能体 harness 全部运行在本地硬件上,不依赖云(Perplexity 发布、模型详情、NVIDIA、Arav Srinivas)。初始的本地栈使用经过后训练的 PPLX 27B,同时也提供 Qwen 3.8 27B;对 Nemotron 3.5 Lightning 的支持即将到来。
- 更深层的趋势是持久、常驻的本地智能体:Srinivas 明确勾勒了这样一个未来:后台进程持续从连接器摄取上下文,在永不停歇的循环中进行多跳推理,并运行在你自己的硬件上(Arav Srinivas)。社区的反应分成两派,一边是对隐私和掌控权的兴奋,另一边则质疑“本地优先”是否应该意味着一台 5000 美元的 DGX Spark,而不是普通的消费级设备(theo 的批评、theo 的后续)。
- Apple/macOS 的本地 AI 工具链也在成熟:exo 表示,Apple 在新的 M5 Ultra Mac Studio 和 M6/M5 Pro Mac Mini 页面上展示了它,强调通过 Thunderbolt 5 上的低延迟 RDMA 将多台 Mac 组成集群,以接近 API 的速度运行 Kimi K3 和 GLM-5.3 等模型,4 台 M5 Ultra 可扩展到约 4.8 TB/s 的聚合内存带宽(exo)。相关帖子指出,Apple 更快的 PCIe 存储和基于 ANE 的视觉流水线,让小型本地集群以及 CPU/ANE/GPU 混合推理更加实用(anemll、onirenaud)。
- 围绕本地运行时的工具链仍在不断补全:Ollama v0.33 新增了一键开关集成,让 Claude Desktop 可以把 Ollama 当作第三方网关,访问云端和本地模型(Ollama);OpenCode v2 被演示运行在 Cloudflare Durable Object 内,说明小型智能体运行时正变得可以嵌入边缘环境(fayazara)。
模型、检索与搜索基础设施
- Qwen 3.8 正在整个技术栈中出现:围绕 Qwen3.8 发布的热情,在部署和评测类帖子中都清晰可见,Together 为 Qwen3.8-27B 增加了微调和专用推理支持(Together),Unsloth 则称借助优化后的内核,可以在免费的 2× Tesla T4 Kaggle 实例上对这个 27B 模型进行完整的 QLoRA 微调(danielhanchen)。在应用层面,Qwen3.8-27B 在 Image-to-WebDev Arena 中位列开源模型第 1、总榜第 7,定价为每百万输入/输出 token 0.40 / 3 美元(arena)。
- 搜索与检索基础设施迎来多项实质性更新:Hugging Face 发布了 Papers with Code 搜索引擎的详细架构文章:采用 PostgreSQL + pgvector、Qwen 3 Embedding 0.6B、混合检索,嵌入通过 Hugging Face Jobs 在 NVIDIA L4 上生成,产物存放在 bucket 中,并通过 Inference Endpoints 提供在线服务;同一套技术栈也支撑着论文页面上的“相关论文”(Niels Rogge)。Keenable 走出隐身模式,推出面向 AI 的 Web Search API 和 Web Query Language,由前 Yandex Search 负责人打造,获得 2600 万美元种子轮融资,明确瞄准智能体规模的网页检索(styskin)。
- 检索模型设计仍是活跃领域:关于后期交互 / 多向量检索的讨论再度升温,有观点认为其扩展规律终于在检索负载中显现出来,并且模型与数据库的协同设计至少与存储格式同样重要(mixedbread 的观点、Silvio Martinico)。
机器人、物理世界模型与具身数据
- Figure 的“Index”是一项重要的机器人数据发布:Figure 推出了 Index,称其为全球最大、最多样的机器人数据集,据报道摄取速度为每秒 30 分钟的视频上传,累计 1600 万次视频上传,已为数据支付 1500 万美元,26.4 万次下载。该公司还表示,将在未来 12 个月内投入 10 亿美元用于数据和算力(Brett Adcock、后续)。这个规模之所以重要,是因为许多机器人实验室的瓶颈似乎仍在示范数据和感知数据,而不是架构创新。
- 大规模物理/世界建模持续突破上下文极限:Anima Anandkumar 重点介绍了 Accelerated Understanding,这家初创公司构建用于跨模态和 4D 时空物理仿真的大型 AI 模型,称预训练时有 1T 参数,训练时有 1T 上下文,推理时可达 >5T 上下文,且无需子采样或分块(Anima Anandkumar)。细节很少,但这条帖子值得注意,因为它表明了部分前沿的非语言建模工作的走向:大规模上下文的多模态仿真,而不仅仅是文本/视频生成。
- 具身策略的泛化仍是活跃的基准目标:另一篇机器人帖子介绍了 S1,这是一个操作模型,能够在训练分布之外,仅凭一次示范就完成任务(anag004)。Google Research 还分享了 AgentHands,这是一个 XR 系统,通过同步的手势来增强对话智能体,在实体任务中提供空间指引(Google Research)。
热门推文(按互动量)
- OpenAI 芯片发布:@sama 谈 Jalapeño、@OpenAI 的基准测试公告引发了迄今最大规模的技术讨论。
- 本地智能体发布:@perplexity_ai 发布 Portable Computer,是芯片话题之外最大的产品发布。
- 开发者平台 / 面向智能体的 Web:@OpenAIDevs 宣布 WebMCP Challenge 以及 ChatGPT 桌面端支持 WebMCP,标志着 OpenAI 在推动网站提供明确的智能体接口。
- 开源本地任务智能体:@AndrewYNg 谈 OpenWorker 脱颖而出,因为它把开放的 harness、本地模型和注重安全的工作流结合在一起。
- 编码智能体基准的真实性:@EinsiaAI 谈 SWE Refactor Bench 是这批发布中更有用的基准之一,因为它针对的是整个仓库的迁移,而不是局部修改。