今天,Thinking Machines Lab 发布了 Inkling,这是一款全新的多模态混合专家(MoE)模型,主打词元高效的推理、原生多模态理解和广泛的任务通用性。Together AI 很高兴与 Thinking Machines Lab 团队合作,在我们的推理平台上向开发者提供 Inkling。
Inkling 接受文本、图像和音频输入,并通过统一的解码器架构输出文本。它支持可控的推理力度,开发者可以根据每项任务的需要,调整模型投入多少推理。它的后训练也覆盖了广泛的能力,包括科学推理、编码、智能体工作流、预测以及校准预测。
在底层,Inkling 在传统的纯解码器 Transformer 之外引入了多项架构创新,包括查询条件相对注意力(query-conditioned relative attention)、贯穿整个模型的短因果卷积,以及带共享专家汇(shared expert sink)的混合专家架构。这些组件共同作用,旨在支撑强大的推理与多模态能力,同时保持高效的模型执行。大规模高效地部署它并非易事,而这恰恰是 Together AI 推理栈擅长优化的那类工作负载,因此你在生产推理中能够真正获得该模型的效率收益。在 Together AI 上,Inkling 运行时使用优化过的基于 FlashAttention-4 的注意力内核,用于在生产环境中高效支持其查询条件相对注意力机制。
祝贺 Thinking Machines Lab 团队顺利发布。
Inkling 一览
- 词元高效、可控的推理:开发者可以调整推理力度,在不同工作负载下平衡推理深度、词元用量和延迟。
- 原生多模态输入:Inkling 接受音频、图像和文本输入,并通过单一模型生成文本输出。
- 广泛的任务通用性:该模型在推理、编码、智能体、预测和校准预测等任务上都经过后训练。
- 差异化的架构:Inkling 结合了分组查询注意力、学习得到的相对位置偏置、短因果卷积以及共享汇 MoE 路由。
- 初步评估结果出色:在评估过的最高力度设置下,Inkling 在科学推理、数学、编码、智能体、视觉和音频基准测试中均表现强劲。
- 已在 Together AI 上线:开发者可以通过 serverless 方式使用 Inkling,支持 1M 上下文窗口和兼容 OpenAI 的 API。
在高难度推理任务上表现强劲
对当前 Inkling 检查点的初步评估显示,它在研究生水平的科学推理和竞赛数学上表现强劲:
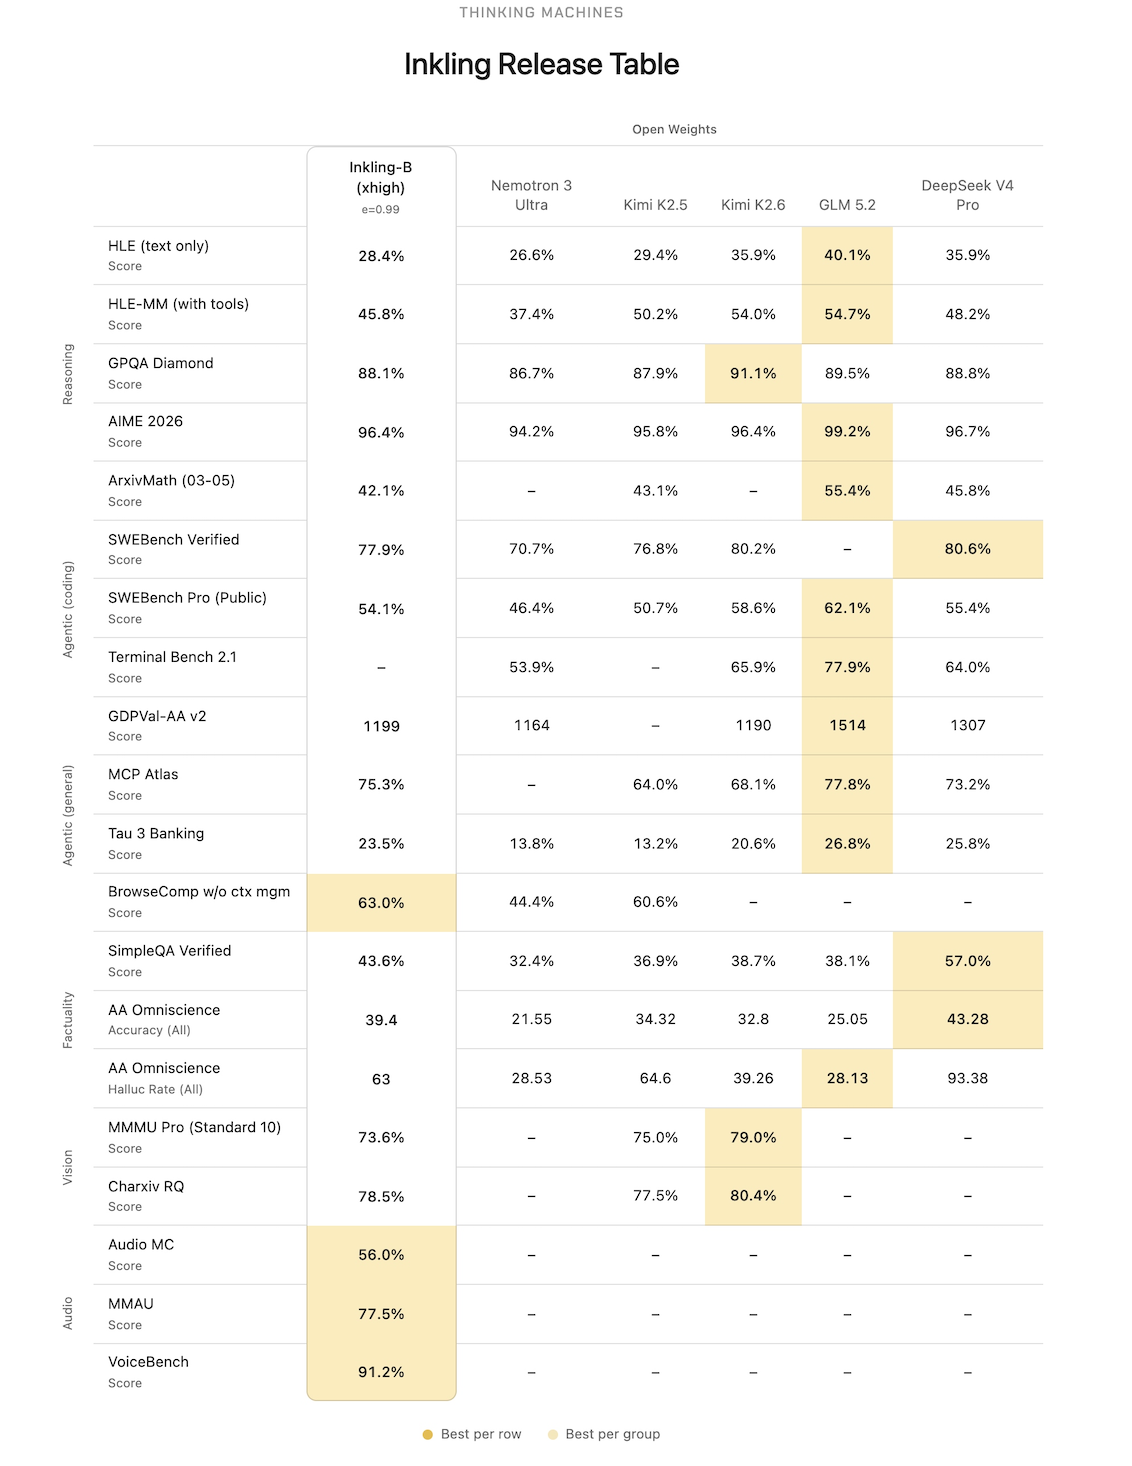
这些结果指向 Inkling 的一大特点:通用性。同一个模型在知识密集型推理、数学解题、软件工程、基于浏览器的任务、视觉文档理解和音频理解上都表现出色。
Inkling 还在预测和校准预测任务上做了后训练。这使模型的用途不再局限于传统的问答,而是扩展到那些需要表达不确定性、给出校准良好的估计的应用。
为什么在 Together 上运行 Inkling?
首日可用,零配置:Inkling 今天就已在 Together AI Serverless 上线。无需等待容量,无需配置基础设施,也无需管理 GPU。
完整的多模态输入支持,一个端点搞定:由于 Inkling 原生接受文本、图像和音频,你不需要单独的流水线或预处理服务,Together AI Serverless 通过一次 API 调用就能处理这三类输入。Together 的统一方案消除了延迟、速度与运维稳定性之间的取舍,这一点很有价值。
可控的推理力度,无需自管基础设施:Inkling 可调节的推理力度设置,让你按每次请求在深度、延迟和词元花费之间权衡。在 Together AI 上,你直接通过 API 来调这个旋钮,因此成本和速度的调优发生在请求层面,而不是基础设施层面。
面向推理和多模态的全新架构
Inkling 是一个纯解码器的混合专家模型,总参数量为 975B,每个词元的激活参数量为 40B,上下文窗口为 1M 词元。
Inkling 没有使用 RoPE 或绝对位置嵌入,而是通过一个学习得到的、以查询为条件的相对偏置,将词元位置直接纳入注意力计算。每个注意力层都把传统的查询-键相似度得分,与一个基于词元间相对距离的附加得分结合起来。这为模型提供了一种灵活的机制,用来表示词元顺序和邻近上下文。
Inkling 在整个网络中混合使用滑动窗口注意力和完整因果注意力。标准架构采用五个局部注意力层后接一个完整注意力层,使大部分层能高效地聚焦于近期上下文,同时周期性地整合整个序列的信息。
该模型还引入了 sconv,这是一种轻量的逐通道因果卷积,感受野为四个词元。Sconv 作用于注意力之前的键流和值流,也作用于注意力子层和前馈子层的输出。这些短卷积为每一层提供了一种额外的机制,用来整合相邻词元之间的信息,而无需再付出一次完整注意力运算的代价。
Inkling 的前馈层采用带共享专家汇的混合专家架构。对每个词元,路由器会选出少量路由专家,同时也给共享专家分配权重。与传统的共享专家 MoE 设计不同,Inkling 把共享专家和选中的路由专家放在一起做归一化,使共享路径能在每个词元上动态地争夺混合权重。
Inkling 也支持图像和音频输入。轻量的嵌入塔(embedding tower)把图像块和量化后的音频特征转换成与文本词元同样宽度的嵌入。这些嵌入被直接插入模型的输入序列,由同一个解码器栈处理。
统一的文本、图像和音频输入
Inkling 接受三种输入模态:文本、图像、音频。三种模态都由同一个解码器栈处理,输出为生成的文本。
轻量的嵌入塔把图像块和量化后的音频特征转换成与文本词元嵌入同样宽度的嵌入。这些表示被直接插入模型的输入序列,使语言模型能够对文本、视觉和音频信息进行联合推理。
这种统一的设计使以下应用成为可能:视觉问答、文档分析、音频理解、多模态智能体,以及在同一场对话中组合多种输入类型的工作流。
在 Together Serverless 上开始用 Inkling 构建
Inkling 今天即可通过 Together AI Serverless 使用。
开发者可以:
- 使用统一的模型构建文本、图像和音频应用
- 从最初的实验扩展到专用的生产容量
from together import Together client = Together() response = client.chat.completions.create( model="[INKLING MODEL ID]", messages=[ { "role": "user", "content": "Analyze this problem carefully and provide the answer." } ], # Replace with the final supported API parameter. reasoning_effort="[SUPPORTED VALUE]", ) print(response.choices[0].message.content)