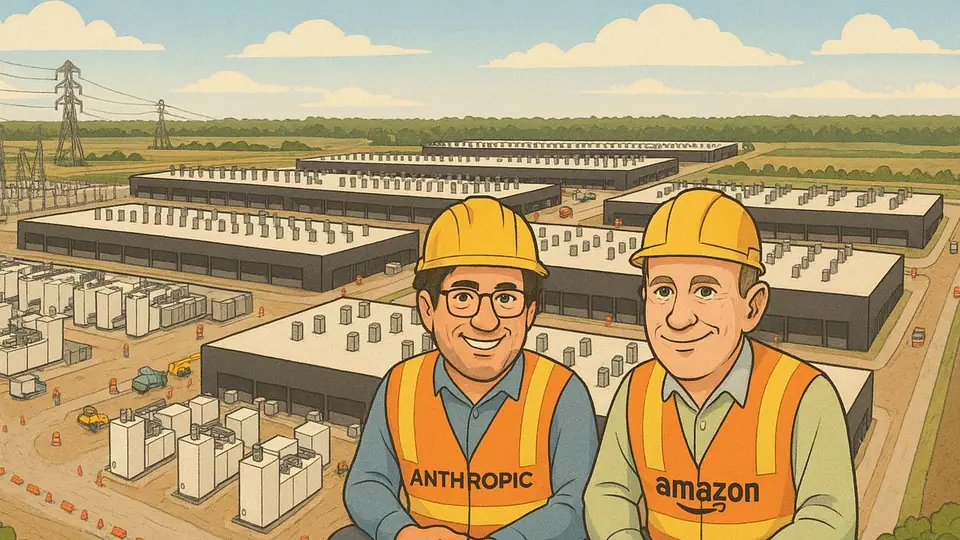
两年半前,我们就指出 AWS 面临迫近的“云危机”。如今,证据越积越多。AWS 是亚马逊帝国的皇冠明珠,贡献了集团约 60% 的利润,并主宰着利润丰厚的云计算市场。但它难以把这一优势转化到新的 GPU/XPU 云时代。
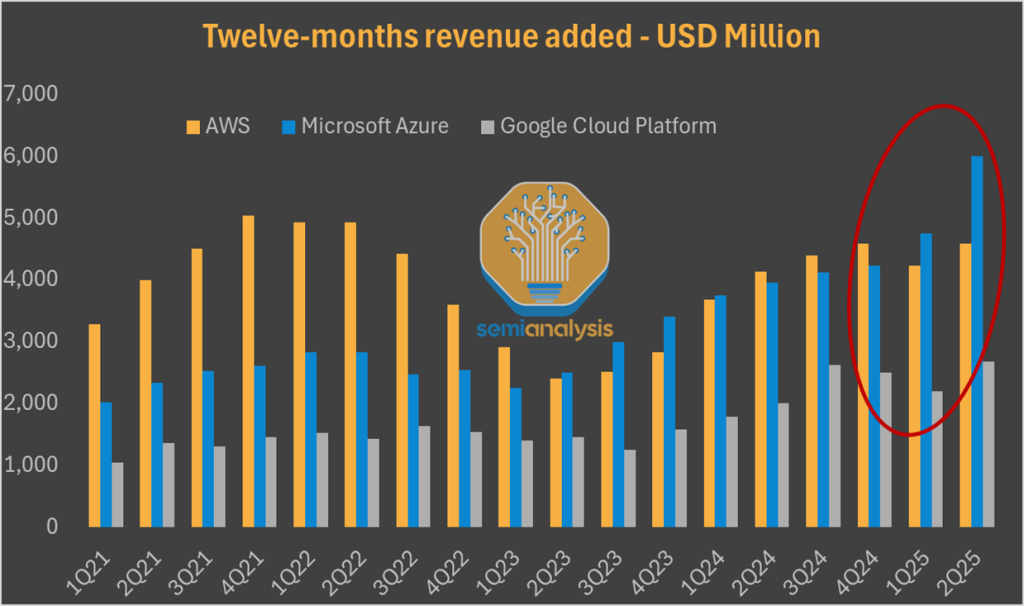
微软 Azure 如今在季度新增云收入上领跑市场,Google Cloud 与 AWS 之间的差距也已明显缩小,尤其是在谷歌在 TPU 上的大动作(我们已就此连续发文一个多月)之后。市场已经注意到了这一点。年初至今,亚马逊明显落后于四大科技与 AI 巨头,投资者对它的估值下调最多,因为它在 AI 上失去了势头。
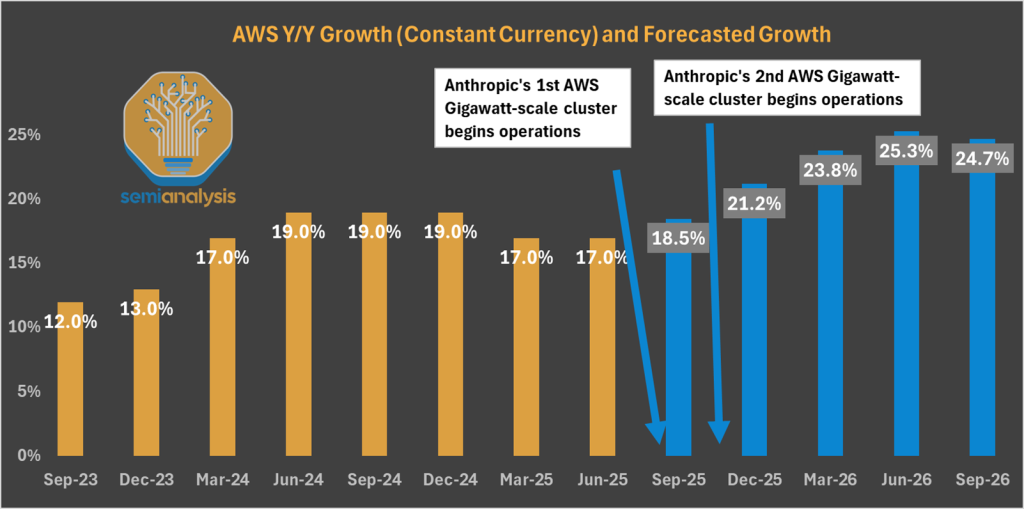
今天,SemiAnalysis 带着又一个非共识判断回来了。当市场过度渲染“云危机”这一主题时,我们认为 AWS 将迎来 AI 复兴。一个月前,我们已向 Core Research 订阅用户阐述了这一论点,预测到 2025 年底,增速将加速突破 20% 的同比增长。
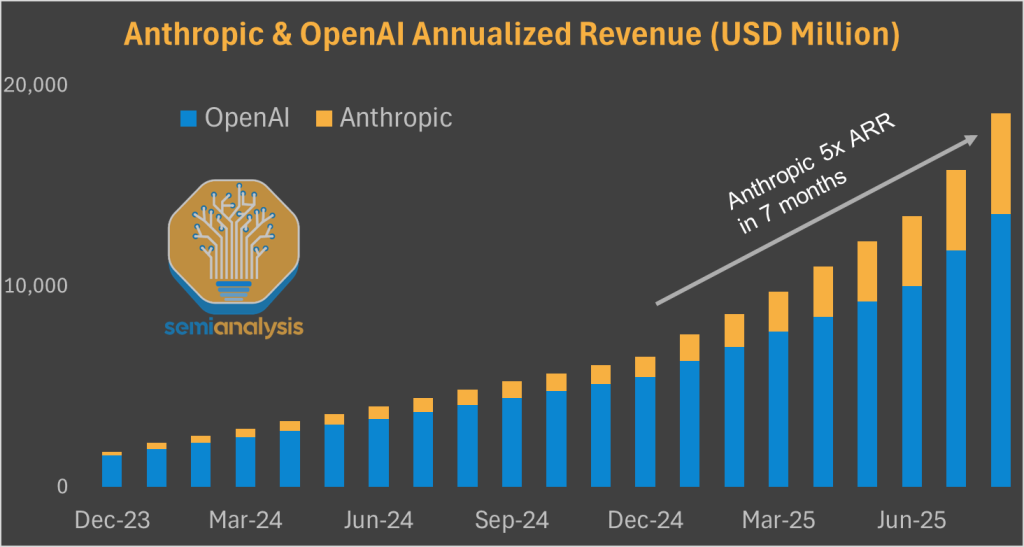
亚马逊的救星有一个名字:Anthropic。这家初创公司是 2025 年生成式 AI 市场中毫无疑问的领跑者,年初至今营收增长了五倍,达到 50 亿美元的年化水平。
为了保持这一增长轨迹,Anthropic 正在重注押宝缩放定律(Scaling Laws)。尽管 Dario 的这家初创公司的新闻头条不如 OpenAI、xAI 和 Meta Superintelligence 多,但它在投入上毫不含糊。AWS 正为其核心客户建设远超一吉瓦、已处于建设最后阶段的数据中心容量。AWS 目前的数据中心建设速度,是其历史上最快的。而且未来还有更多。
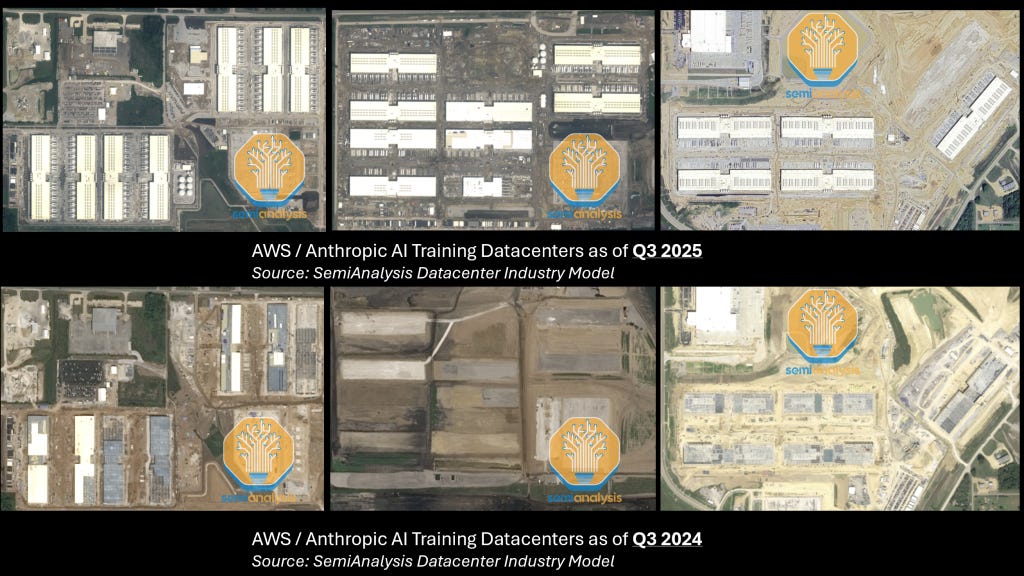
为了理解并预测各 AI 实验室在不同云服务商上的 GPU/XPU 电力容量,我们依靠由实时卫星图像驱动的自有 Datacenter Industry Model。该模型受到所有超大规模云厂商、AI 实验室和全球最大投资者的信赖,为 OpenAI、Anthropic、xAI、Meta Superintelligence、Google DeepMind 等提供按季度、逐栋建筑的数据中心预测。欲了解更多信息,请联系我们。
Trainium 与 GPU
尽管亚马逊的 AI 数据中心在规模和速度上令人印象深刻,但单栋建筑的设计平平无奇。这套蓝图针对风冷做了极致优化,与 5 年前的传统 AWS 云数据中心完全相同。
这些设施的独特之处在于其内部:它们将承载全球最大的非 Nvidia AI 芯片集群,其中最大的园区将部署近一百万颗 Trainium2。要全面了解 Trainium2 系统,请阅读我们 2024 年 12 月的技术深度解析。
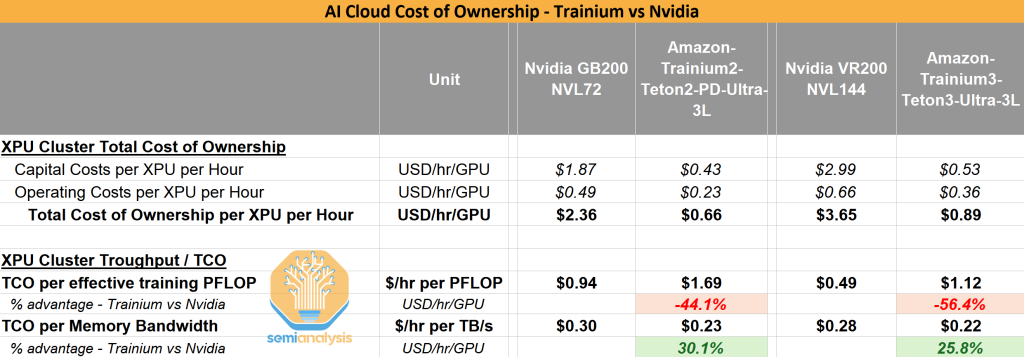
Trainium2 在许多方面落后于 Nvidia 的系统,但它对多吉瓦的 AWS/Anthropic 交易至关重要。其单位 TCO 的内存带宽优势,恰好契合 Anthropic 激进的强化学习路线图。Dario Amodei 的这家初创公司深度参与了设计过程,其对 Trainium 路线图的影响只会越来越大。
直白地说:Trainium2 正在向Anthropic 定制芯片计划靠拢。这将使 Anthropic 与 Google DeepMind 一道,成为近期内仅有的受益于软硬件紧密协同设计的 AI 实验室。
本报告将深入探讨亚马逊 AI 复兴的方方面面:与 Anthropic 的合作、数据中心和 Trainium。在报告末尾,我们将给出对 Anthropic、AWS Bedrock 和内部模型的长期展望,并解释为何一切并非都一片光明。
首先,退一步看看为什么 AWS 迄今表现不及其他 AI 云。
AWS 在生成式 AI 上的表现不佳
要理解亚马逊在生成式 AI 时代表现不佳的原因,我们可以分析 GPU/XPU 云市场的成功驱动因素。最简单地说,我们看到 GPU/XPU 算力有两大主要客户群:
- 批发式裸金属用户:OpenAI、Anthropic、ByteDance 等大规模客户,以及其他超大规模云厂商。
- 托管式 SLURM/Kubernetes:规模较小的客户,如初创公司、研究机构和企业试点项目。
云危机与 ClusterMAX 表现不佳
对于第二类客户,我们的 ClusterMax AI 云评级是比较相对优劣的最佳方式。获得铂金和金牌评级的 AI 云获得了比其他云更多的关注,也拥有高于平均水平的定价权。因此,CoreWeave、Oracle、Nebius、Crusoe 和 Azure 等在多租户 GPU 集群(需要高性能和先进的软件层)上跑赢了市场。
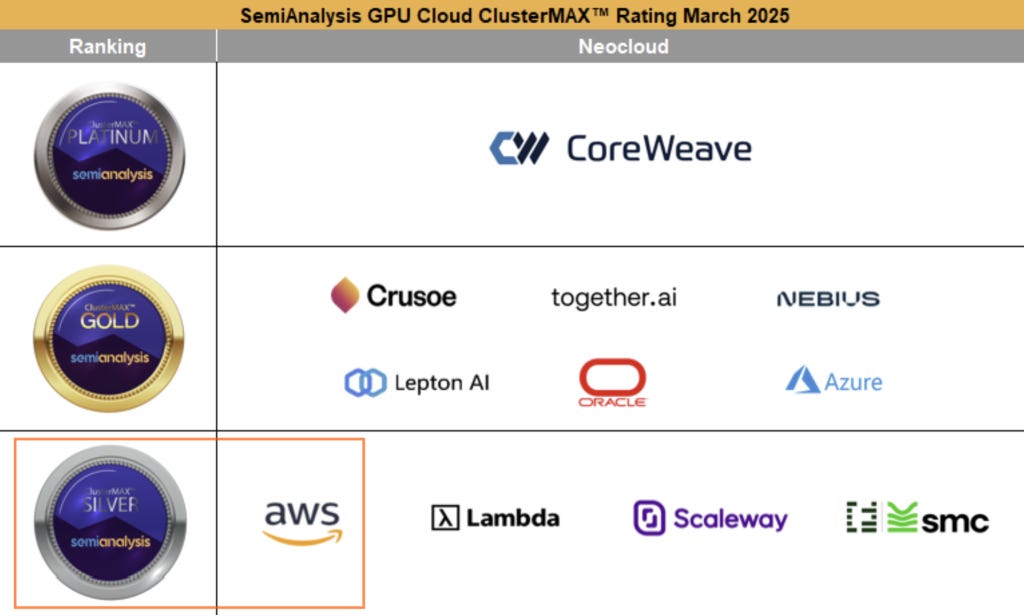
正如两年前所预测的,亚马逊表现不佳的关键在于使用了自研网络架构 EFA。AWS 在前端网络上采用 ENA 的成功,尚未转化为后端网络上 EFA 的成功。EFA 在性能上仍落后于其他网络方案:NVIDIA 的 InfiniBand 和 Spectrum-X,以及 Cisco、Arista 和 Juniper 的 RoCEv2 方案。原始性能并非唯一指标,EFA 的用户体验也不及 InfiniBand & RoCEv2。话虽如此,随着亚马逊最新的 EFAv4,在真实消息大小下的性能正在改善,尽管仍落后于竞争对手。
亚马逊的自研网络还因 Nvidia 系统所需的定制化而延长了上市时间。其他方面,如先进的被动和主动自动化每周定期健康检查策略,也不如金牌 & 铂金评级的云那样扎实。
我们即将发布的 ClusterMAXv2 评级将基于我们自有的测试,更新所有主要云服务商的情况。敬请期待!
寻找核心客户
对 AWS 的 XPU 业务增长而言,更重要的是拿下核心客户,也就是第一波生成式 AI 需求中的造市者。规模、上市时间、深度合作关系和定价,是赢得这些客户的关键,其重要性超过先进的软件层。
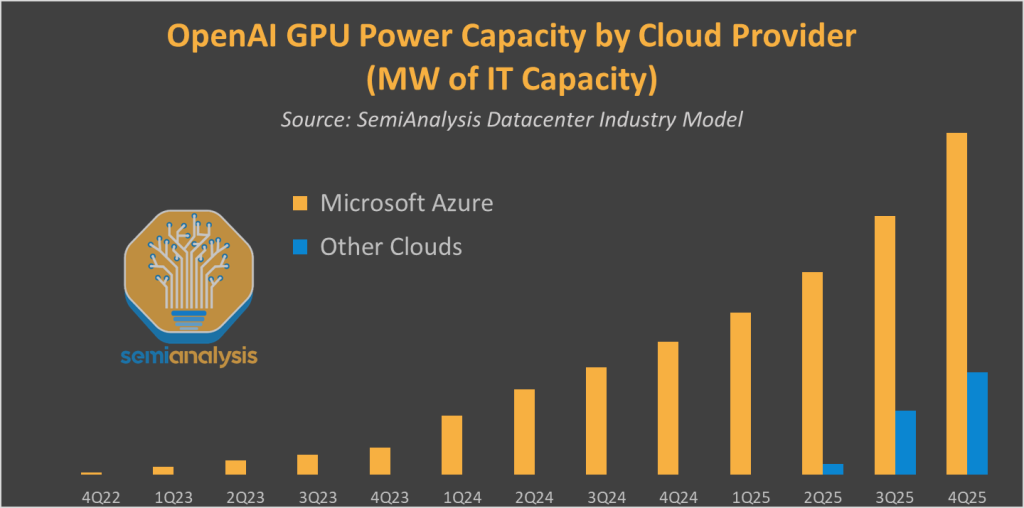
没有哪家公司比微软更能说明这一点。Azure 在 AI 上超越同行,完全由其与 OpenAI 的合作驱动。截至 2025 年第二季度(2025 年 6 月),OpenAI >100 亿美元的云支出全部由 Azure 承接。
亚马逊很早就意识到需要一个核心客户,并于 2023 年 9 月向 Anthropic 投资了 12.5 亿美元,最高可追加至 40 亿美元。2024 年 3 月,合作进一步扩大,Anthropic 承诺使用 Tranium 和 Inferentia 芯片。2024 年 11 月,亚马逊又向 Anthropic 追加投资 40 亿美元,后者将 AWS 指定为其主要的 LLM 训练合作伙伴。
Anthropic 表现出色,AWS 表现不佳?
亚马逊的押注是正确的。Anthropic 是 2025 年生成式 AI 市场中毫无疑问的领跑者,年化营收从 10 亿美元飙升至 50 亿美元。在这种背景下,AWS 的表现不佳令投资者感到沮丧是可以理解的,但他们误解了 Anthropic 在训练和推理上的支出构成。
有两个明确的原因可以解释,为何亚马逊尚未真正从与 Anthropic 的关系中获益:
- 截至 2025 年第二季度,Anthropic 的云支出不到 OpenAI 的一半。
- Anthropic 的很大一部分支出流向了 Google Cloud。后者是 Anthropic 最早的主要投资者之一(2022 年末的 3 亿美元一轮融资),也是其在 2023 年和 2024 年(AWS 扩大合作之前)的首选云合作伙伴。
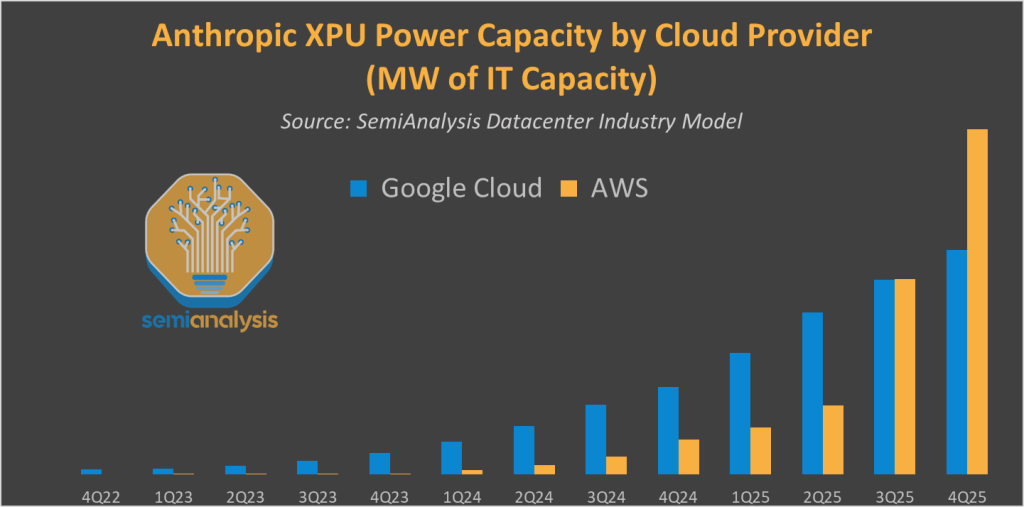
Anthropic & AWS 的多吉瓦 AI 训练基础设施
具体来说,我们认为 Anthropic 迅猛增长的推理需求,大部分由 Google Cloud 承接。拥有全球最好的推理系统(TPU)是一项关键的竞争优势。
AWS 的基础设施建设旨在为其关键客户夺取其中的一部分,同时也聚焦于训练。尽管 Anthropic 的新闻头条不如 OpenAI、xAI 和 Meta 等同行多,但它在 AGI 竞赛中全力以赴,也不打算在训练支出上手软。Anthropic 的领导层真心相信面向 RL 的扩展。
他们的信念最早将在今年兑现。下图展示了三个处于建设最后阶段的 AWS 园区,IT 容量超过 1.3GW,唯一目的就是满足 Anthropic 的训练需求。建设速度令人惊叹。
虽然从空中看这些数据中心已经建成,但我们认为它们尚未产生任何可观的收入。Trainium 在组装阶段遇到了一些良率问题,这对新系统来说相当常见。我们认为,这三个大型 AWS 园区将在 2025 年底前对 AWS 的营收做出实质性贡献,并将增速推高至 20% 同比增长的门槛之上。
Anthropic 并未止步于此。其约 130 亿美元、估值 1830 亿美元的融资将提供资金,用于与 AWS、Google 等签署更多交易。AWS 也没有坐等,已经在为即将到来的 GW 级数据中心破土动工,以抓住这一增长。
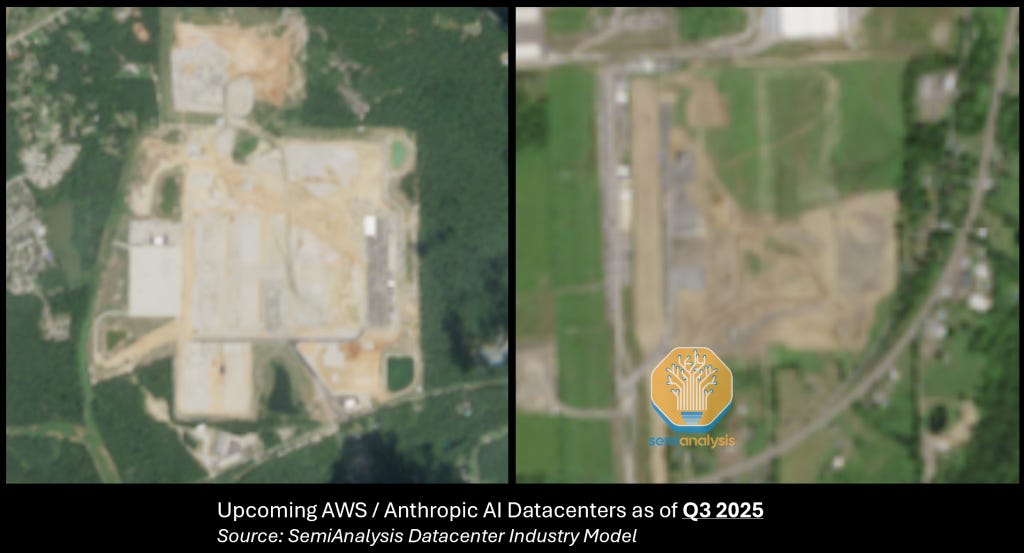
如前所述,这些数据中心将主要部署 AWS 的自研芯片 Trainium。考虑到其庞大的规模,我们怎么强调 Anthropic 这场押注的大胆程度都不为过。他们不仅承诺投入数百亿美元,而且是押在一颗基本未经验证的芯片上!
让我们通过深入研究 Trainium 的 TCO 和路线图,来理解他们的这场押注。
Trainium2 TCO 分析:Anthropic 的大赌注如何能够获得回报
Trainium2 的供应链信号目前极为强劲。我们业内领先的 AI Accelerator Model 同时追踪封装出货量和系统/机架出货量,二者自年初以来都大幅攀升。该模型为构成 Trainium2 和 Trainium3 产品家族的 10 多个 SKU 提供季度出货量预测,并指出将不成比例地受益于特定 SKU 的供应商。欲了解更多信息,请联系我们。
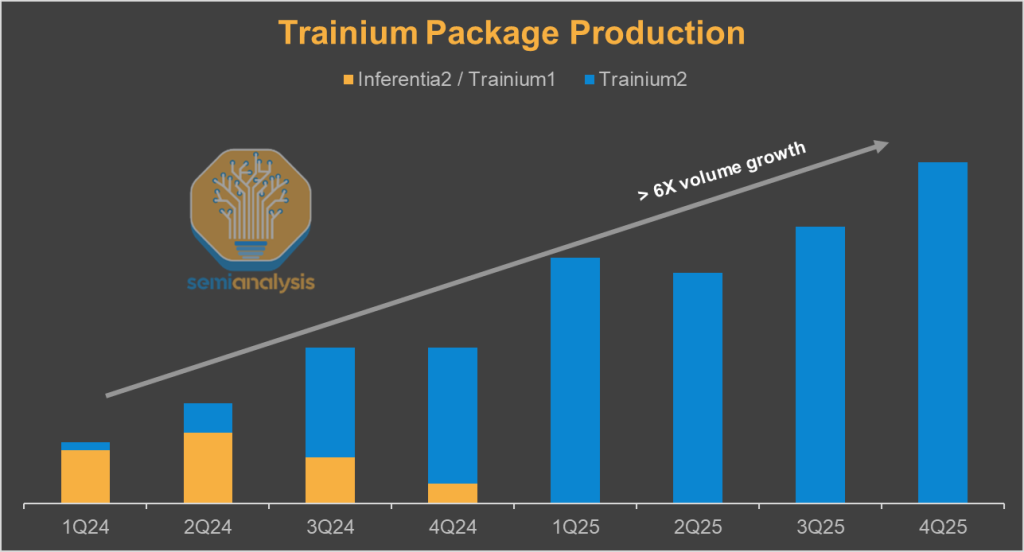
注意,这是芯片产量,机架产量有所滞后,但我们同样在追踪。
与 Nvidia 和谷歌的 TPU 竞争,当然绝非易事。谷歌正在推出第七代 TPU Ironwood,而 Trainim2 仅仅是亚马逊的第三代 AI 加速器。
芯片规格:Trainium2 在各方面都处于劣势,但是……
简单看一下芯片规格,就能发现 Trainium 相对 Nvidia 明显落后:
- Nvidia 的 GB200 拥有 3.85 倍的 FP16 FLOPs 优势,每颗芯片 2500 TFLOP/s,而 Trainium2 为每颗芯片 667 TFLOP/s。请注意,规格表上的数字相比实际可达到的 FLOPs 是被夸大的。
- 在内存带宽方面,差距缩小到 2.75 倍,即每颗 GPU 8000GB/s,对比每颗 Trn2 2900GB/s
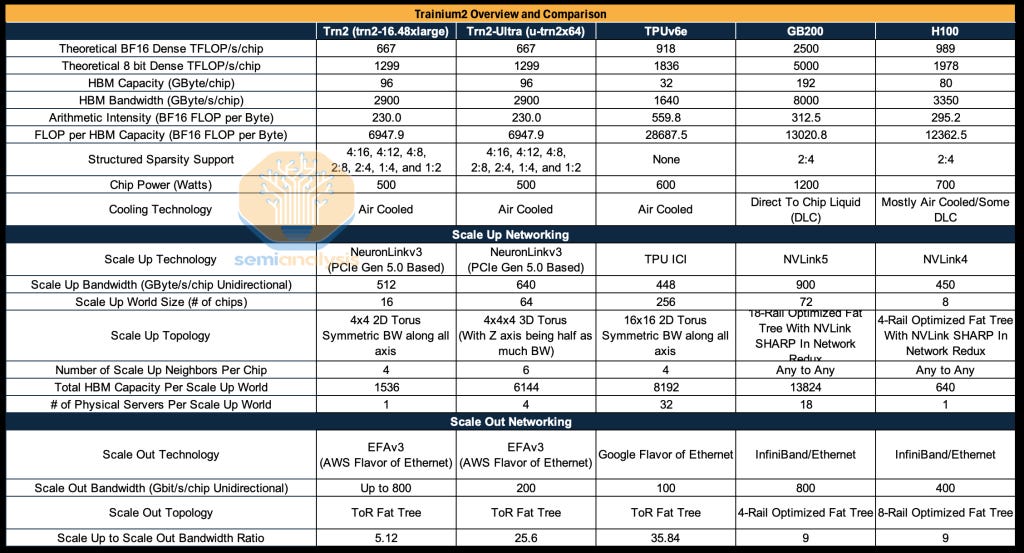
评估 scale-up 网络带宽是另一个关键项目。我们已多次阐述scale-up 网络对推理模型推理的重要性。我们对强化学习的深度解析强调了 RL 与推理工作负载的相似性,使内存带宽成为扩展后训练的关键要素。
- Nvidia 的 GB200 NVL72 在整个 World Size 上拥有 576TB/s 的聚合内存带宽。
- 这相对于 Trainium2(Teton2-PD-Ultra-3L SKU)的 186 TB/s 是 3.1 倍的优势,但需要注意,不同 SKU 之间有所差异。
虽然 Trainium 看起来明显落后,但一旦把总拥有成本(TCO)考虑进来,情况就变了。
Trainium 单位 TCO 的内存带宽优势
在下表中,我们把 TCO 纳入比较。虽然 Nvidia 在每有效训练 PFLOP 的 TCO 上有明显领先,但 Trainium2 在每百万 token 的 TCO 以及每 TB/s 内存带宽的 TCO 上极具竞争力。
而且我们认为,Nvidia 即将推出的 VR200 NVL144 不会改变其相对 AWS Trainium3 的格局。需要说明的是,TCO 还有许多其他变量。AWS 还有其他系统级架构部署,更适合某些使用场景。再往后,Nvidia 的 Kyber 机架将拥有全球最先进的 scale-up 网络架构。
要全面了解 50 多个 Nvidia SKU 的 TCO,以及与所有 AMD、Trainium 和 TPU SKU 的详细 TCO 对比,请查看我们的 AI Cloud TCO Model。最大的超大规模云厂商、Neocloud 及其财务出资方都依靠我们的模型来把握投资决策的时机。
Anthropic 押注软硬件协同设计
Trainium2 单位 TCO 的内存带宽优势,是理解 Anthropic 选择的关键。虽然 Nvidia 的芯片和系统在大多数方面更胜一筹,但 Trainium2 与 Anthropic 的路线图完美契合。他们是在扩展强化学习等后训练技术上最激进的 AI 实验室。其路线图受内存带宽制约的程度,超过受 FLOPs 制约的程度。我们近期的 HBM 报告深入解释了哪些 AI 工作负载往往受内存制约。
Anthropic 的爬坡不仅会使其成为 Trainium2 唯一的大型外部终端用户,其规模还将远大于亚马逊的内部需求(例如 Bedrock、Alexa 等)。他们现在深度参与 Trainium 的所有设计决策,实质上是把亚马逊的 Annapurna Labs 当作定制芯片合作伙伴!这使 Anthropic 与 Google DeepMind 一道,成为仅有的受益于软硬件紧密协同设计的 AI 实验室。
Trainium 的路线图:加倍押注系统
亚马逊正在为其核心客户推出新的系统级架构。目前 AWS 部署的两种系统是 Teton PD 和 Teton PD Ultra。明年,新的 Teton PDS 和 Teton Max 将大批量出货。我们的 AI Accelerator Model 按季度提供确切的出货量和逐 SKU 的拆分。
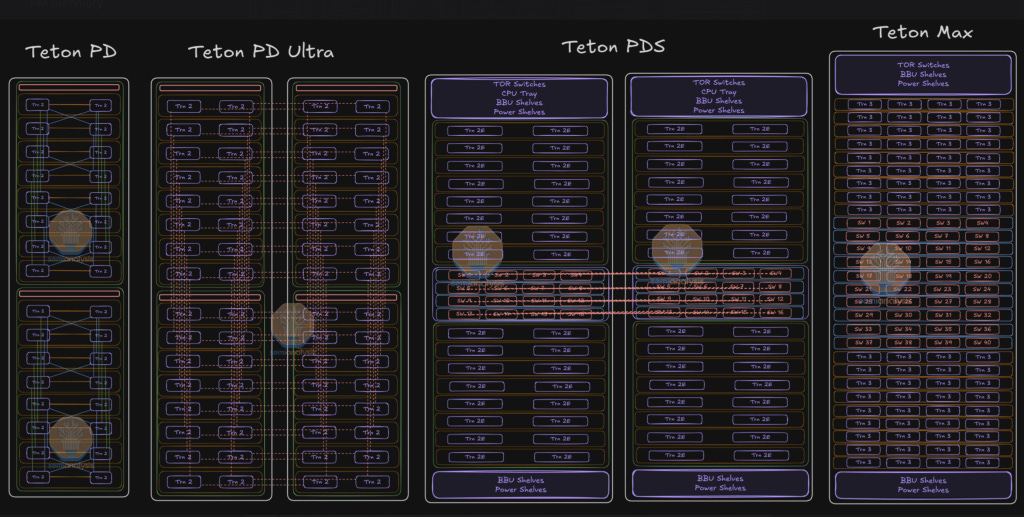
关键区别在于引入了一种名为 NeuronLinkv3 的全互联 scale-up 网络。因此,Trainium 的架构正在向 Nvidia 的 NVL72 NVLink 靠拢。
四个 NeuronLinkv3 交换机托盘将放置在机架中间,上下各平分 16 个计算托盘。某些供应链厂商将不成比例地受益,我们在两个月前的 Core Research 中已有强调,这是受全球最大对冲基金信赖的机构研究服务。该厂商自我们发文以来已上涨 73%。我们认为 PDS 的引入是 Trainium 追赶 Nvidia 道路上的一个中间步骤。我们还认为,Anthropic 深度参与了这一新系统级架构的推出。
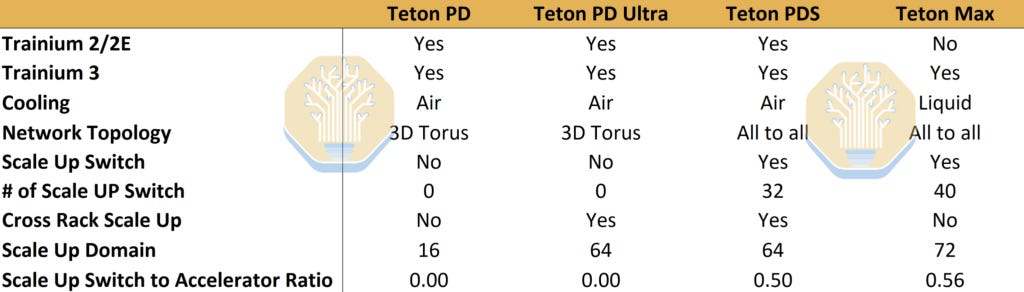
Anthropic 对设计决策参与度的提高,预示着未来出货量向好。但他们也没有放弃 TPU 和 Nvidia GPU。我们的 Accelerator Model 按精确的 SKU 预测亚马逊和 Google Cloud 的芯片采购,我们的 Datacenter model 则用于了解哪些数据中心和云合作伙伴支持 Anthropic 的爬坡。Anthropic 在 2026 年的 TPU 爬坡规模巨大,其交易也有独特之处,我们已就此连续发文一个多月。
现在让我们着眼更长远,评估 AWS 的未来可能是什么样子。在付费墙后,我们讨论以下内容:
- 亚马逊关键客户 Anthropic 的前景。
- 亚马逊在 Anthropic 之外的生成式 AI 业务:Bedrock 和内部 LLM 工作。
- Trainium 在 2026 & 2027 年的爬坡、潜在的新外部客户,以及这可能如何影响亚马逊未来几年的财务状况。