太长不看
- 简而言之:每一档可靠性对应一个特定的故障域,每一档都需要各自的架构才能扛住。大致来说:
- 99% 意味着你的架构能扛住节点级故障:GPU 硬件故障、驱动崩溃、过热事件。要做到这一点,通常需要自动化的健康检查、节点排空(draining),以及在单个数据中心内快速替换副本。
- 99.9% 意味着你的架构能扛住整个数据中心的故障。这通常意味着模型权重部署在两个机房,每一侧都有足够的容量承接全部负载,并且实时流量同时路由到两侧,而不是冷备份。
- 99.99% 意味着你的架构能扛住区域级故障。这通常需要带可用区(AZ)冗余的多区域部署,以及预留的故障转移容量。
可靠性数字很容易发布,难的是解释这些数字意味着什么:架构究竟覆盖了哪些故障域,供应商是否掌控这些层级的基础设施,以及凌晨 3 点出了问题会发生什么。
Together 为 Cursor、Decagon、Cartesia 和 Yutori 等团队运行推理服务。下文提到的大多数情况,我们都曾被半夜呼叫过;以下是我们总结的经验。
可靠性数字的问题
推理一旦宕机,某个人的产品也会随之宕机。GPU 推理的故障方式与传统服务不同:硬件有自己的故障模式,而 CPU 基础设施没有,并且这些系统为追求性能做了深度调优。要在每块 GPU 上以 200 TPS 达到每分钟 100 万 token,或者用定制内核让语音模型的 TTFT 低于 50 毫秒,留给冗余的余地非常有限。在这样的系统上增加可靠性,每多一个 9,难度都呈指数级上升。
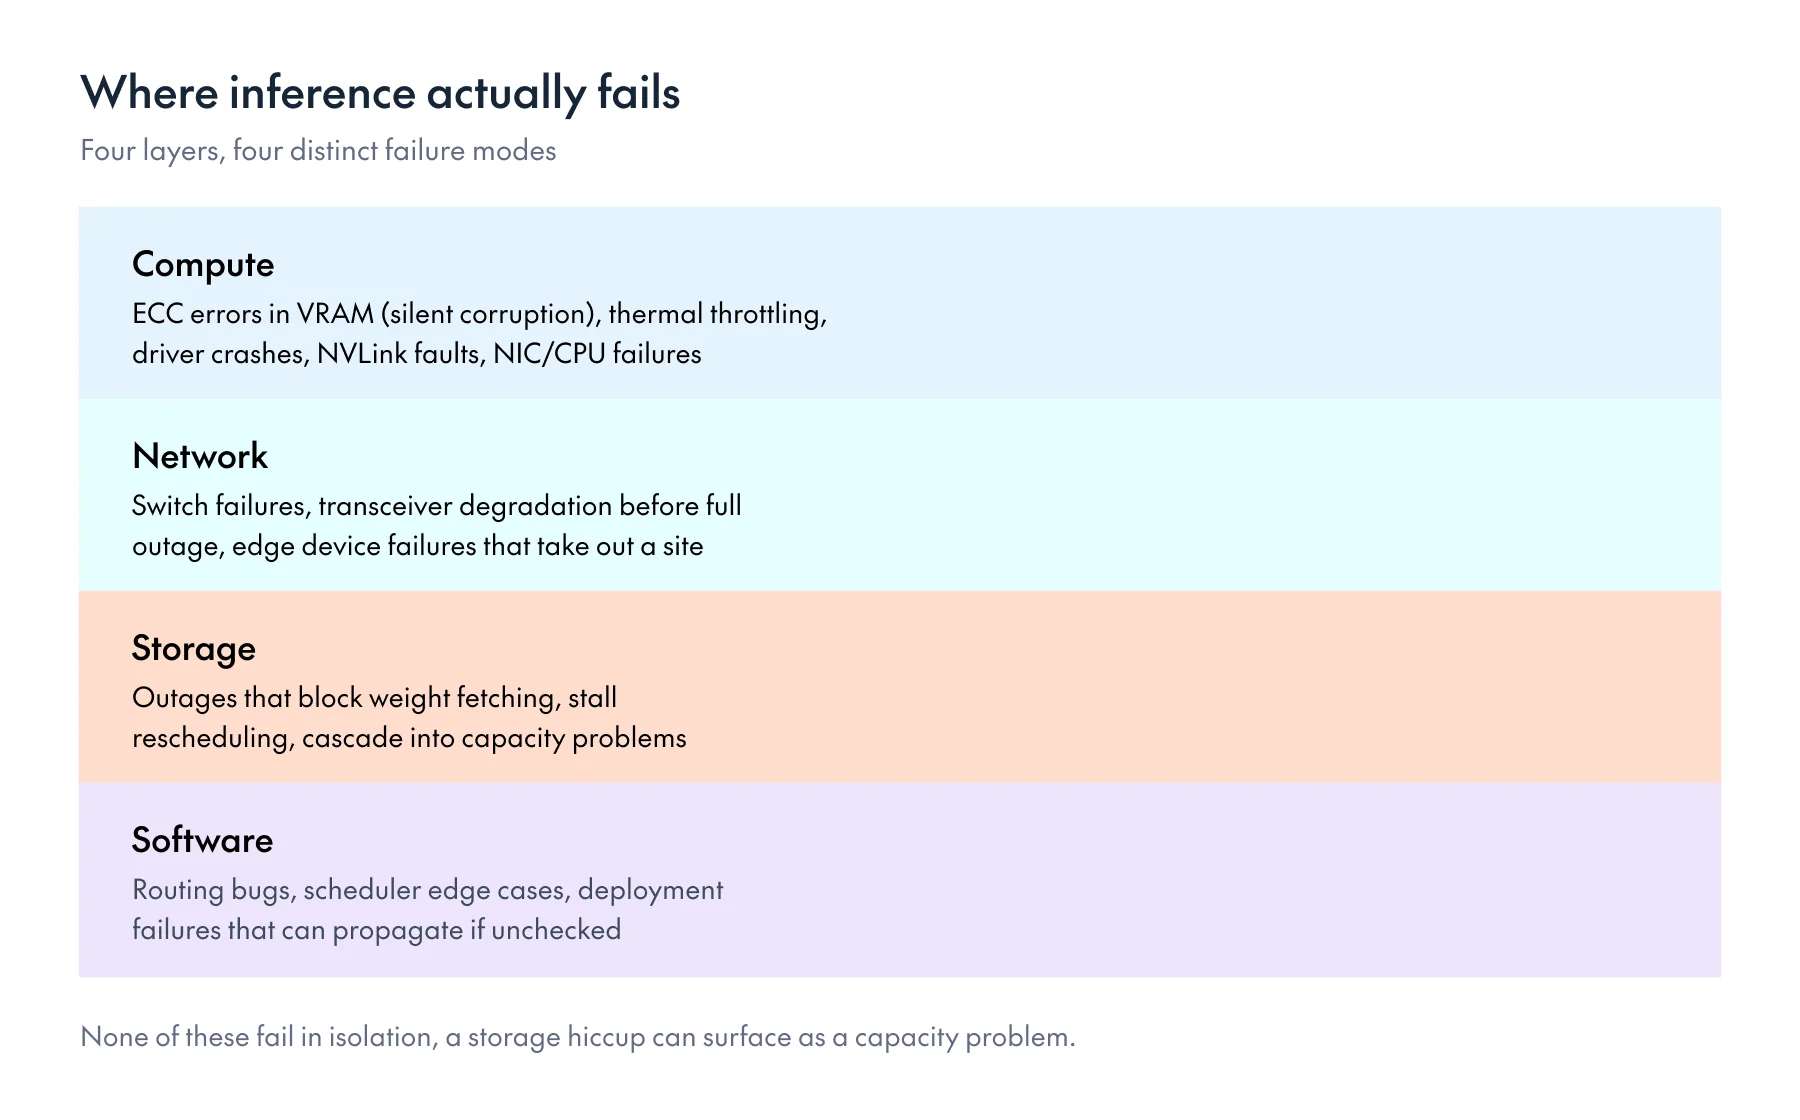
有用的思维模型是分层,每一层的故障模式各不相同:
- 计算:显存中的 ECC 错误(我们见得最多的问题;它们会悄无声息地损坏权重,因此请求仍有返回,但输出不可信)、过热降频、驱动崩溃、NVLink 故障,以及不论 GPU 状态如何都会让整台机器瘫痪的网卡或 CPU 故障。
- 网络:交换机故障、在完全不可用之前就会先拖垮性能的光模块问题,以及会让整个站点瘫痪的边缘设备故障。
- 存储:阻碍权重拉取、使重新调度停滞,并连锁引发容量问题的故障。
- 软件:路由缺陷、调度器的边缘情况,以及稍不留神就会扩散的部署故障。
这些故障没有一个是孤立发生的。存储的一次抖动会表现为容量问题,过热事件在任何健康告警触发之前,很早就会体现为输出质量下降。要在这方面做到出色,就得学会从具有误导性的表象中读出真正的信号。
每多一个 9 究竟需要什么
每一档都是不同的工程问题,而不只是同一个问题的更难版本。下面介绍每一档实际需要什么,以及我们围绕它构建了什么。
99%:扛住节点故障
目标是在请求到达之前,就发现正在劣化的节点。快速检测、排空、替换。其中有意思的工程问题是可观测性。
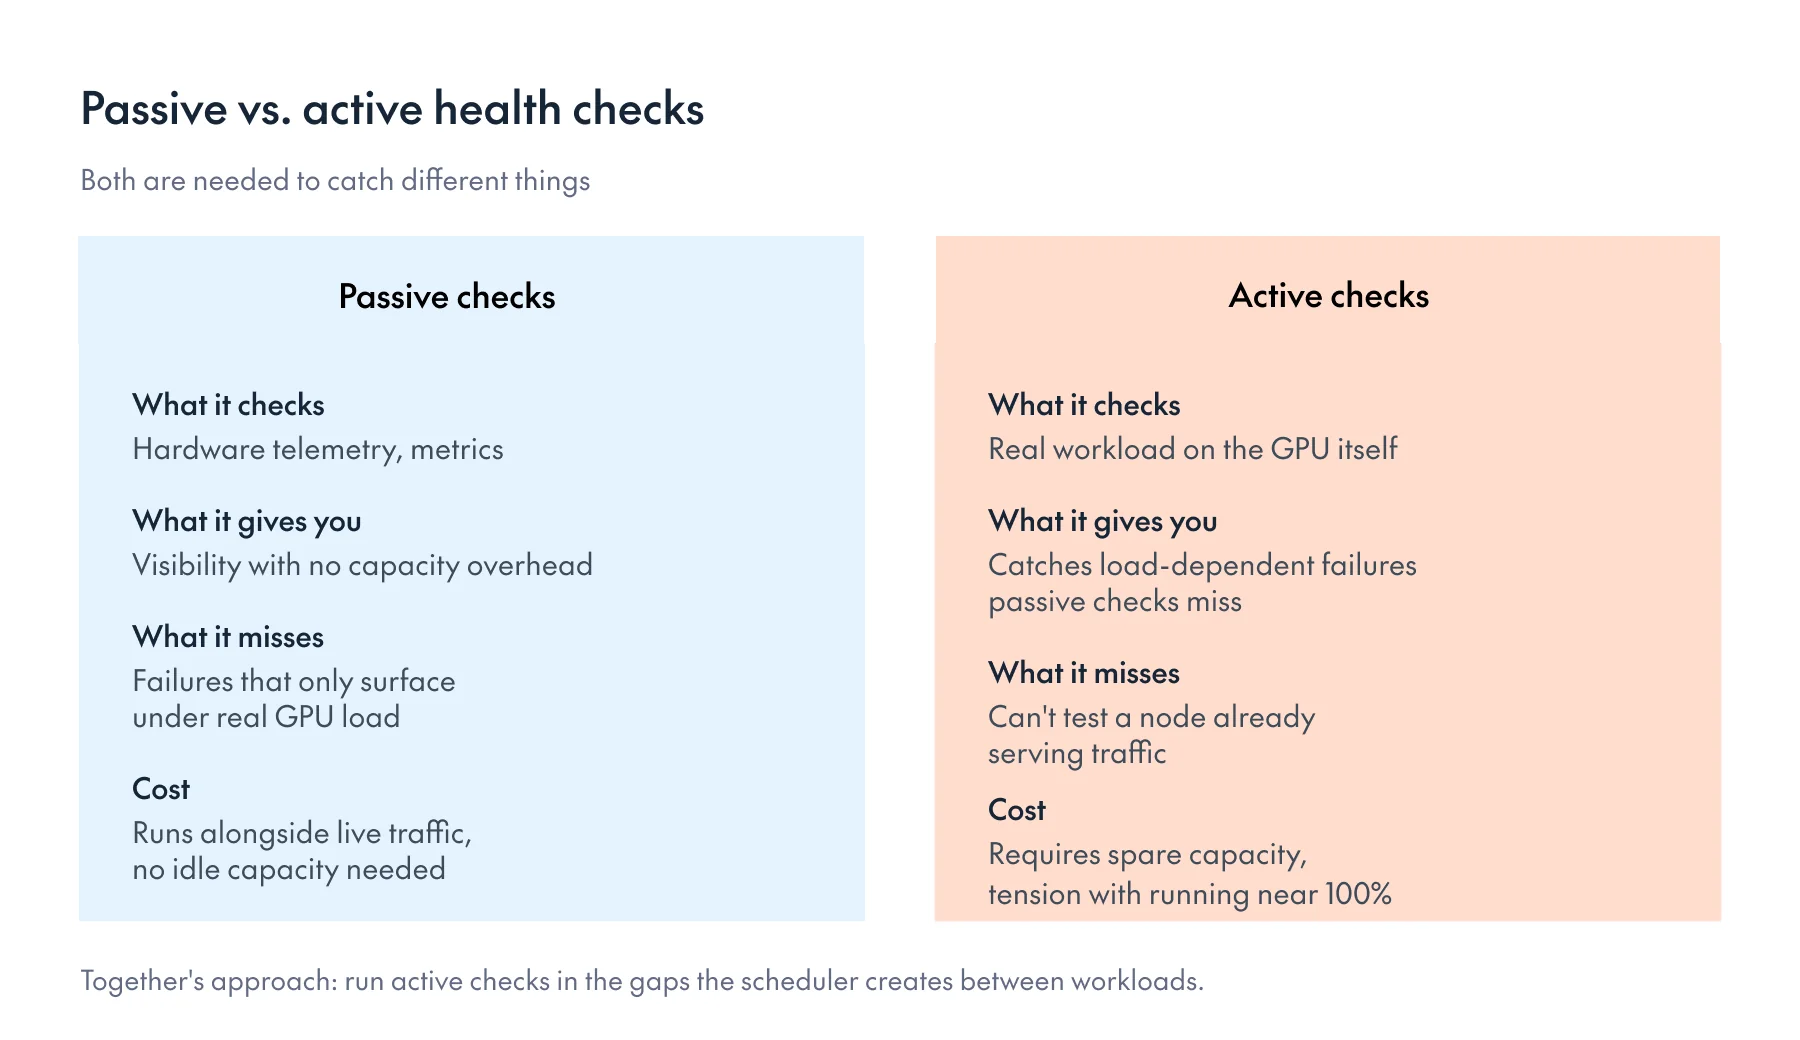
被动健康检查(硬件遥测、指标)无需额外占用容量就能提供可见性,但会漏掉只在真实 GPU 负载下才会出现的一类故障。主动健康检查可以发现这类故障,但需要有容量来运行。你无法对一块正在处理流量的 GPU 做探测,这显然会产生矛盾。每个人都希望把利用率压到接近 100%,而为健康检查保留多余的容量,只是在用效率换可靠性。我们选择的路径是加快重新调度的速度:把检查与调度器集成,让检查在工作负载的间隙运行,并让检查本身尽可能快。这仍然是我们在持续调优的地方。
这一档的天花板是机房本身。过热问题、变电站事件、边缘路由器故障,其中任何一个都会让单数据中心部署宕机,不论机房内部有多少冗余。大多数供应商对此有备份系统,但一个没有在真实条件下定期测试的冗余系统,就像是叫一名六周没练过球的替补球员上场。故障转移在纸面上也许存在,但它是否真的有效,则是另一回事。
99.9%:扛住整个数据中心的故障
这里的故障域是整个设施:电力、制冷、网络入口、边缘网络。要扛住这类故障,需要把权重部署在两个机房,每一侧都有足够的容量承接全部负载,并且流量路由能够平滑切换。
决定一家供应商能否真正做到这一档的架构选择是:它是持续向两个机房同时导入实时流量,还是只维护一个冷备份。我们选择的是持续导流。大多数 99.9% 的 SLA 声明都隐含地承诺了这一档。问题在于,这个声明背后的架构是否真的为此而建。
基础设施的所有权在这里也有具体的意义。一家从超大规模云厂商或新兴云(neocloud)那里租用容量的供应商,并不拥有自己的故障域。当电力或制冷层出了问题,他们只能向相关方提交工单。他们说不清自己的 SLA 在这一层究竟能扛住什么,因为他们并不掌控这一层。如果你用的是 Together AI,一张工单就覆盖硬件、网络、存储和软件,因为我们在整个全球基础设施范围内拥有从芯片到 token 的可见性。反过来的情况则是:先向供应商提工单,供应商再向超大规模云厂商或新兴云提工单,然后排队。我们见识过这在凌晨 3 点是什么样子。
99.99%:扛住区域级故障
这一档的根本挑战在于,我们是在本质上不可靠的硬件上构建可靠的基础设施。GPU 的故障率明显高于 CPU,每一种故障模式都必须考虑在内。四个 9 需要:带可用区冗余的多区域部署,以及在故障转移区域中按能承接整个区域故障来规划的预留容量。这里的关键词是“预留”。不是“我们可以把流量路由过去”,而是“那边现在就有闲置的空间”。
选择供应商之前该问什么
SLA 只是起点。下面这些问题能触及它背后的架构、出问题时谁负责什么,以及恢复有多快。我们也希望你以同样的问题来问我们:
- 关于基础设施所有权:
- 模型托管在哪里,是单区域还是多区域?
- 你们拥有自己的基础设施,还是从超大规模云厂商或第三方租用容量?
- 数据中心的电力、制冷、网络出口由谁负责?你们有物理访问权限,还是要走工单队列?
- 如果某个数据中心发生故障,你们能多快把部署迁到别处?是否专门为此保留了备用容量,还是精简运行?
- 关于全栈专业能力:
- 你们是否拥有贯穿整个技术栈、从芯片到 token 的可见性,还是推理与硬件之间的可观测性存在缺口?
- 出问题时,你们的团队能直接接触硬件,还是要依赖第三方来诊断和响应?
- 除了推理软件之外,你们在 GPU 硬件方面的专业深度有多深?
- 关于容量和故障转移:
- 故障转移如何测试:持续使用实时流量,还是定期演练?
- 真正需要执行故障转移时,你们实际的 RTO(恢复时间目标)是多少?
- 关于 SLA 的衡量:
- 每一档 SLA 究竟覆盖哪个故障域:节点、数据中心,还是区域?
- 你们的 SLA 是在负载均衡器处衡量,还是在推理成功完成时衡量?
- 客户端的重试是否计入你们的可用性统计?
我们的数字定义
含糊的 SLA 定义,正是承诺与交付之间出现落差的地方。下面是我们确切衡量的内容,以及我们对每个术语的定义。
| 衡量内容 | 定义 | 我们的数字 |
|---|---|---|
| 实际交付的可用性 | 推理端点成功处理请求的时间占比(在推理完成时衡量,而非在负载均衡器处) | 99.9%(持续达成) |
| 保证的 SLA:单数据中心 | 单数据中心部署的合同 SLA | 99% |
| 保证的 SLA:多数据中心 | 多数据中心部署的合同 SLA | 99.9% |
| 故障转移时间 | 设施发生故障后,把流量切换到健康容量上所需的时间 | 秒级 |
| 请求量 | 衡量窗口内处理的推理请求数 | 2B TPM 以上 |
我们在推理完成时衡量,而不是在网关处。一个到达了负载均衡器但在 GPU 上失败的请求,在我们的统计中算作宕机。还有一点:可用性与性能是两份不同的合约。在预置吞吐量(Provisioned Throughput)模式下,你付费购买的是能达到特定 TPS 的 GPU 配额,而不只是端点能够响应。一个在线但只交付了合约吞吐量 30% 的服务,并没有履行约定。
来看看我们的架构
每家供应商都会给你一个数字。重要的是,这个数字背后的架构是否真有能力支撑它,以及他们是否拥有这项保证必须成立的那一层基础设施。
这些都是可以回答的问题。请让任何一家供应商讲解每一档 SLA 背后的架构。问问他们是自己拥有基础设施,还是建立在别人的基础设施之上。问问故障转移路径是否在实时流量下运行。真正了解自己基础设施的供应商,能很快回答这些问题。
我们随时可以为你讲解我们的架构。如果你想深入了解,我们随时恭候。