AI 正在改变网络安全的节奏。智能体系统可以协调工作,并在长时间跨度内追求复杂目标。安全团队已开始在安全运营中应用智能体,但许多实现仍然局限于现有告警、预定义工作流和已知攻击行为。更难的问题在于识别防御所遗漏的部分,并把这些缺口转化为可靠的覆盖。这需要在组织独特的环境中反复测试自适应攻击,并用正常的企业活动来验证候选检测规则。
持续的攻防测试构成了这一反馈闭环。受控攻击会产生防御智能体所需的遥测数据和真实标注(ground truth),用来暴露缺口、改进覆盖并重新测试。然而,端到端的整个周期仍需要大量人工投入。由开源模型和专用 harness 驱动的红队与蓝队智能体,能否以机器速度和规模运转这一闭环?
NVIDIA 和 CrowdStrike 在一个以 NVIDIA 加速计算基础设施为原型的隔离环境中,评估了一套智能体攻防系统。在防御侧,针对网络安全定制的 NVIDIA Nemotron 模型运行在 CrowdStrike SafeMind 内,后者是 CrowdStrike 的智能体网络安全系统。CrowdStrike 称,在其内部评估中,其 Blue Solano 防御模型比所测试的领先专有前沿模型更准确,成本却低 99%。在本次评估中,优化后的开源模型配置以 NVIDIA Nemotron 3 Ultra 负责防御编排,并搭配微调后的 Nemotron 3 Super 负责检测规则生成。
本文将分享 Nemotron 模型和专用智能体 harness 如何与 CrowdStrike 的智能体系统协同工作,该系统如何部署和评估,以及生成的检测规则在独立设定随机种子的各次攻击运行中表现如何。
把攻击与防御变成持续学习的闭环
传统的红蓝队演练依赖人工交接:红队执行攻击,蓝队审查产生的遥测数据,检测工程师开发或更新检测规则,红队再对其重新测试。每次交接都要花时间,限制了团队能评估的迭代次数和攻击变体数量。攻防智能体系统把这些活动连接成一个可重复的闭环,能够以机器速度运行。在隔离的代表性环境中,每次运行都会产生攻击轨迹和传感器遥测数据,用于创建或优化检测规则。得到的上下文会回到红队智能体 harness,后者会调整并测试其他攻击或规避路径,直到在该代表性环境中找不到更多可行的路线。
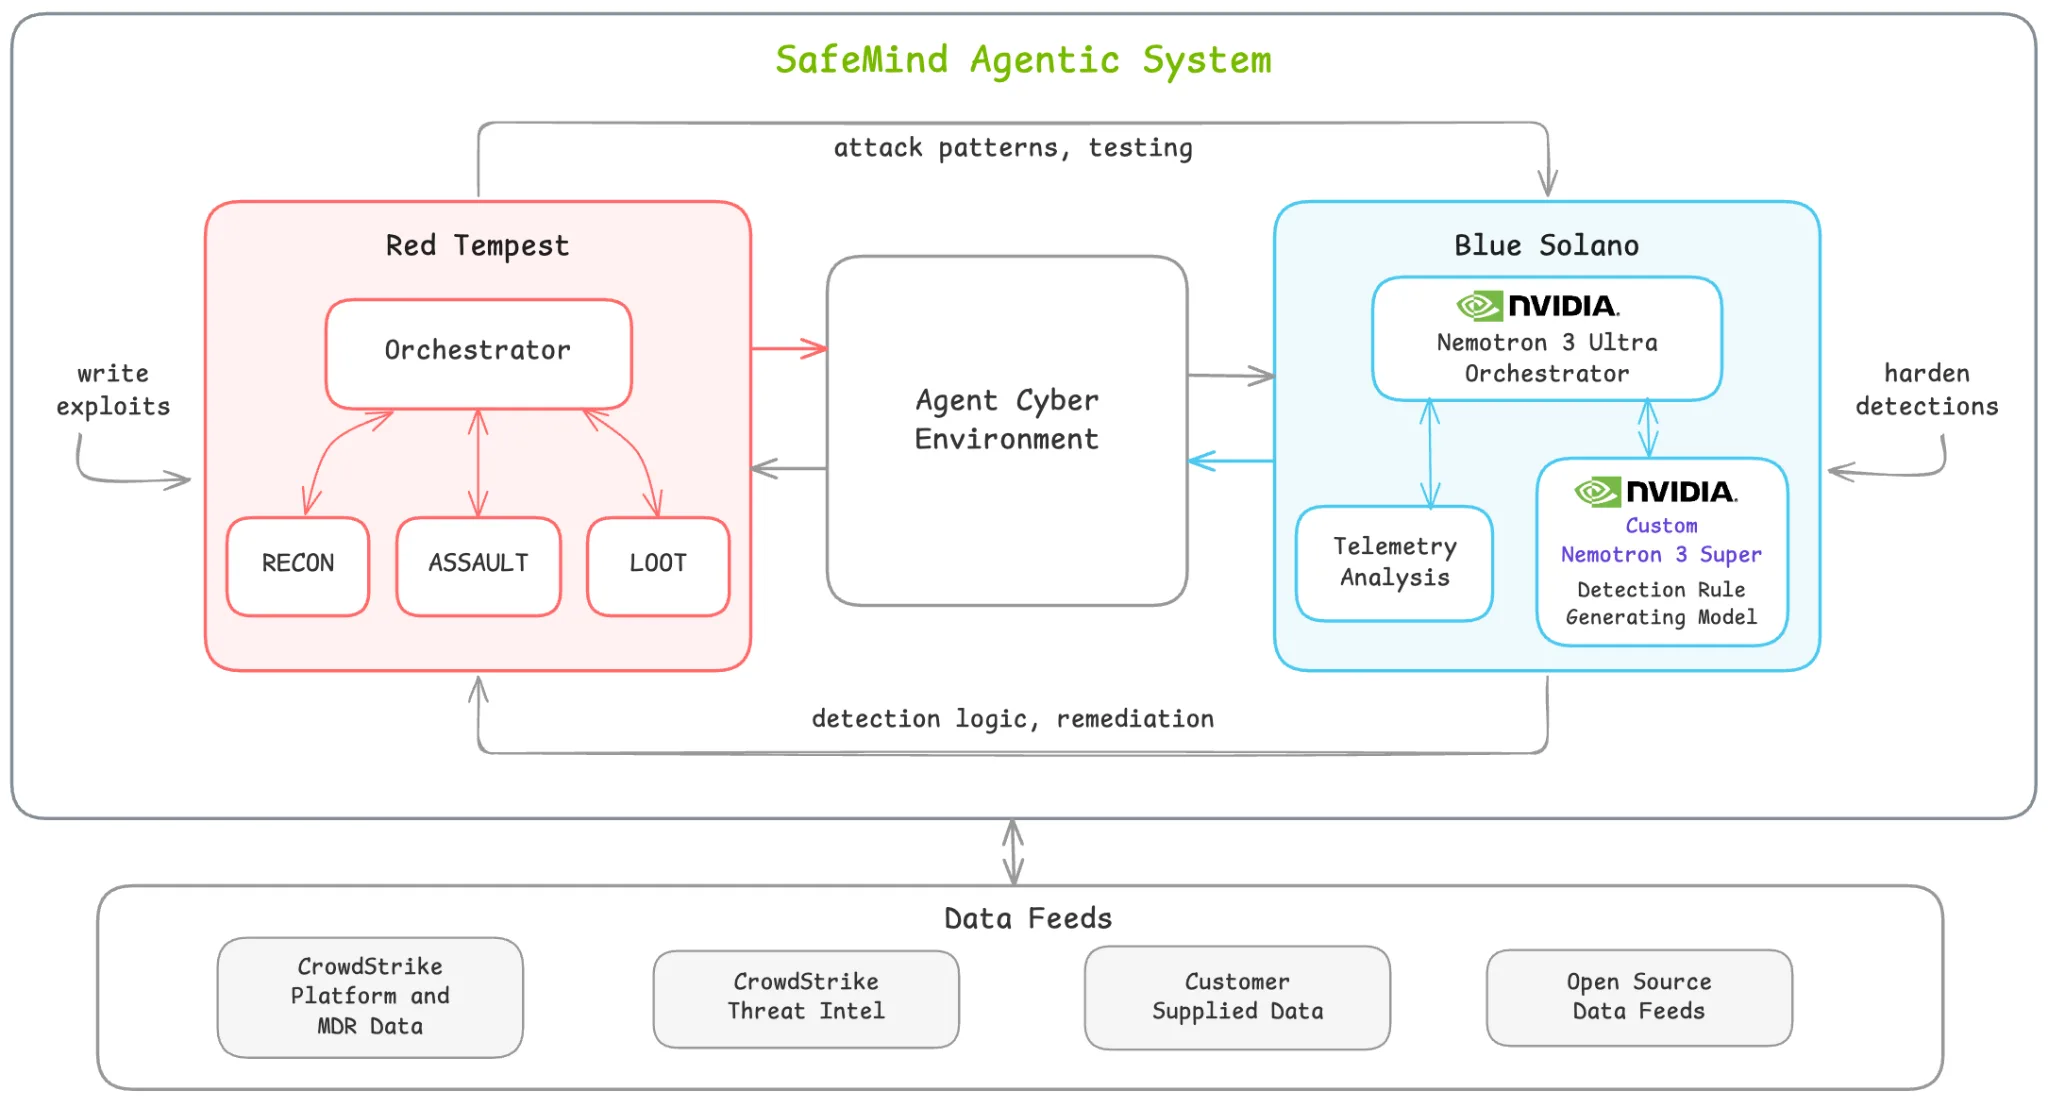
该工作流包含四个相互衔接的阶段:
- 执行与捕获。红队智能体 harness 从一个基于威胁情报的目标出发,在代表性环境中选择并执行一条攻击路径。其动作轨迹记录了每一步,同时 CrowdStrike Falcon 终端传感器捕获了相应的遥测数据。
- 处理与重建。随后,蓝队智能体 harness 接收动作轨迹、传感器遥测数据和更广泛的攻击上下文。它以可用数据源的信息和 CrowdStrike 的检测工程专业知识作为依据,判断事件序列的哪些部分可以重建、哪些现有检测规则被触发,以及哪里仍存在可见性或检测缺口。
- 生成与验证。基于这一分析,蓝队智能体 harness 生成候选检测规则。验证 harness 检查每个候选规则,用捕获的遥测数据对其回测,将失败的规则返回修正,并把通过验证的规则送入检测引擎。
- 重新测试、调整并重复。在通过验证的检测规则部署之后,一次独立设定随机种子的攻击会针对同一目标重新测试。检测和告警上下文返回给红队智能体 harness,后者调整并探索其他攻击或规避路径,为蓝队智能体 harness 生成新的轨迹和遥测数据。
每个周期都旨在加强防御覆盖,同时迫使攻击方在完全了解防御的情况下寻找更难走的路径。这个循环会持续到在建模环境中不再有可行路径为止。
构建具有代表性的测试环境
为了实现安全而真实的测试,NVIDIA 提供了一份经过脱敏处理、以自然语言写成的规格说明,用来表示其加速计算基础设施。一个由智能体辅助的工作流将该规格说明转化为隔离的目标网络智能体环境,并部署了 Falcon 平台传感器。
评估使用攻击路径和可观察的里程碑,依据动作轨迹和传感器遥测数据来衡量进展,而不是依赖智能体自己的说法。NVIDIA 安全专家审查了环境和威胁路径是否真实。同一个经过审查的环境支撑了每一次攻击运行、检测测试和评估指标,从而能在不同配置之间进行一致的比较。
定制防御 harness
下一个挑战是把得到的攻击轨迹和遥测数据转化为能够通过技术和行为验证的检测规则。开放的智能体 harness 已经具备规划、工具使用、上下文管理和迭代纠错等能力。Open Secure AI Alliance 正在帮助扩展网络安全领域更广泛的开放模型、harness 和工具生态。
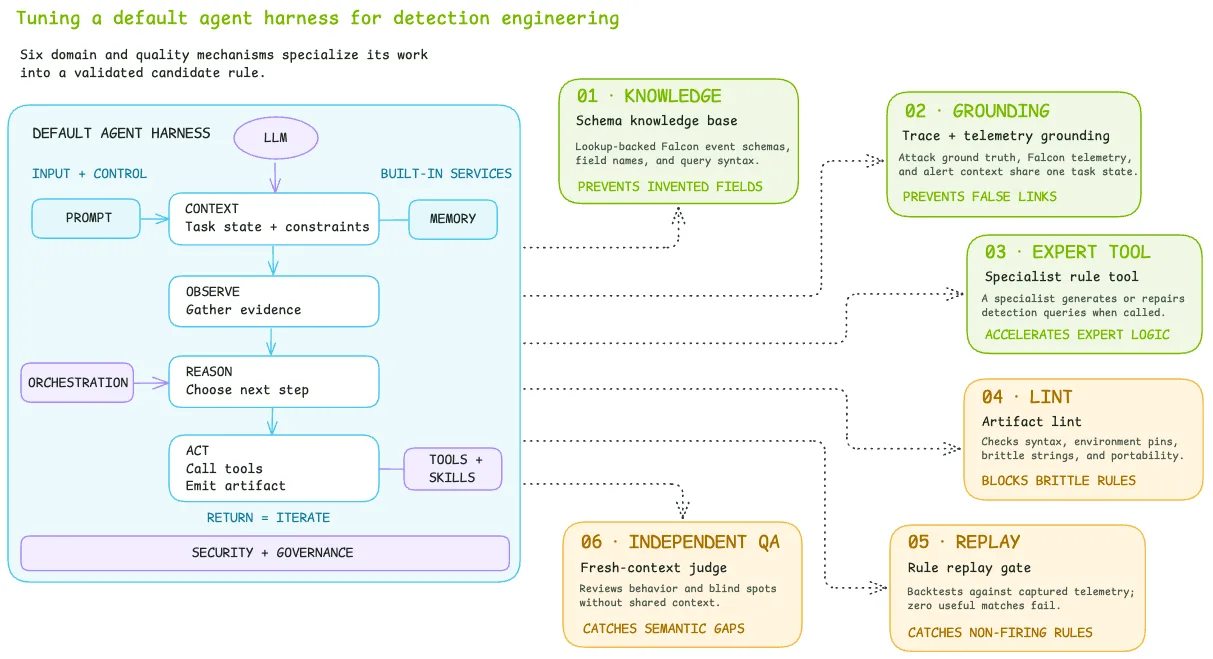
防御 harness 结合了六种机制:
- 模式知识库。一个工具允许智能体枚举受支持的 Falcon 传感器模式、字段和查询语法,避免凭空捏造字段和无效查询。
- 遥测落地。红队智能体轨迹、Falcon 遥测数据和更广泛的攻击上下文,让工作流锚定在观察到的事件和关系上,减少缺乏依据或幻觉出来的关联。
- 专用检测规则编写。一个定制的 Nemotron 3 Super 作为有边界的专家,负责生成和修复检测规则,把这项专门任务与较长的编排上下文分离开来。
- 产物 lint。自动检查会拒绝语法错误、不受支持的字段,以及绑定到特定 IP 地址、主机、用户或子网的检测规则。失败时会返回指导,让规则围绕行为信号而不是特定环境的字符串来重写。
- 检测回放。每个候选规则都会针对捕获的攻击遥测数据回放。没有产生匹配的检测规则会被拒绝并退回修正,从而发现那些看似有效、却无法检测到所记录活动的候选规则。
- 独立评审。一个上下文全新的独立裁判,会从行为一致性、稳健性以及是否恰当使用多种信号等方面评估每条检测规则,找出 lint 和回放遗漏的质量缺陷。
未通过的检查会向蓝队智能体工作流返回结构化反馈,以便修正并再次尝试。这些机制共同将通常通过人工检测工程评审来落实的做法固化下来,使检测规则的生成有依据、可测试、可纠正,而不仅仅是看起来合理。
为防御编排和检测规则生成定制 Nemotron
像 Nemotron 这样的开源模型,可以用领域数据进行后训练,带着专有上下文部署在受控环境中,并针对成本和规模进行优化。在所评估的开源模型配置中,Nemotron 3 Ultra 负责重建攻击序列、规划检测工程步骤并调用工具。当检测规则需要编写或修复时,一个定制的 Nemotron 3 Super 作为有边界的专家来承担。这种分工使工作流编排与专门的检测规则编写相互分离。
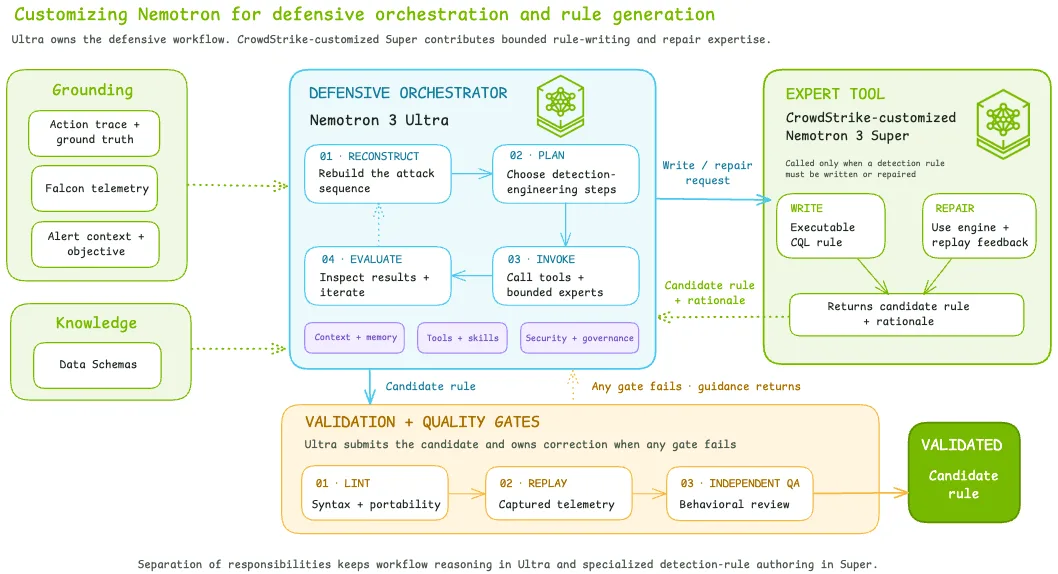
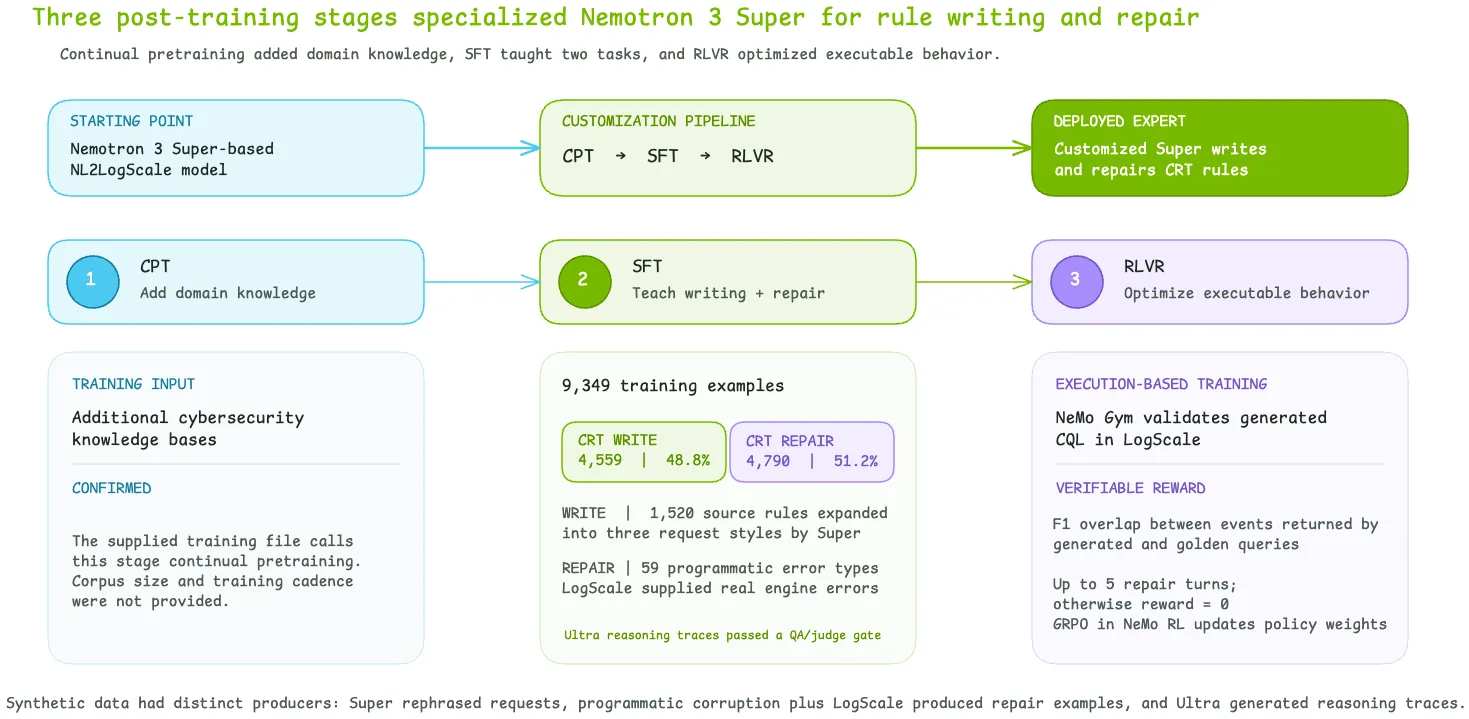
为了打造这位专门的专家,CrowdStrike 以 Nemotron 3 Super 作为其 NL2LogScale 模型的基座,随后依次进行网络安全知识的持续预训练、监督微调,以及基于可验证奖励的强化学习。微调使用了 9,349 条检测规则生成与多步修复样本,涵盖 59 种以程序方式生成的错误类型。训练数据结合了 Nemotron 3 Super 对请求的改写、真实的 Falcon LogScale 执行错误,以及经过质量审查的、来自 Nemotron 3 Ultra 的推理轨迹。
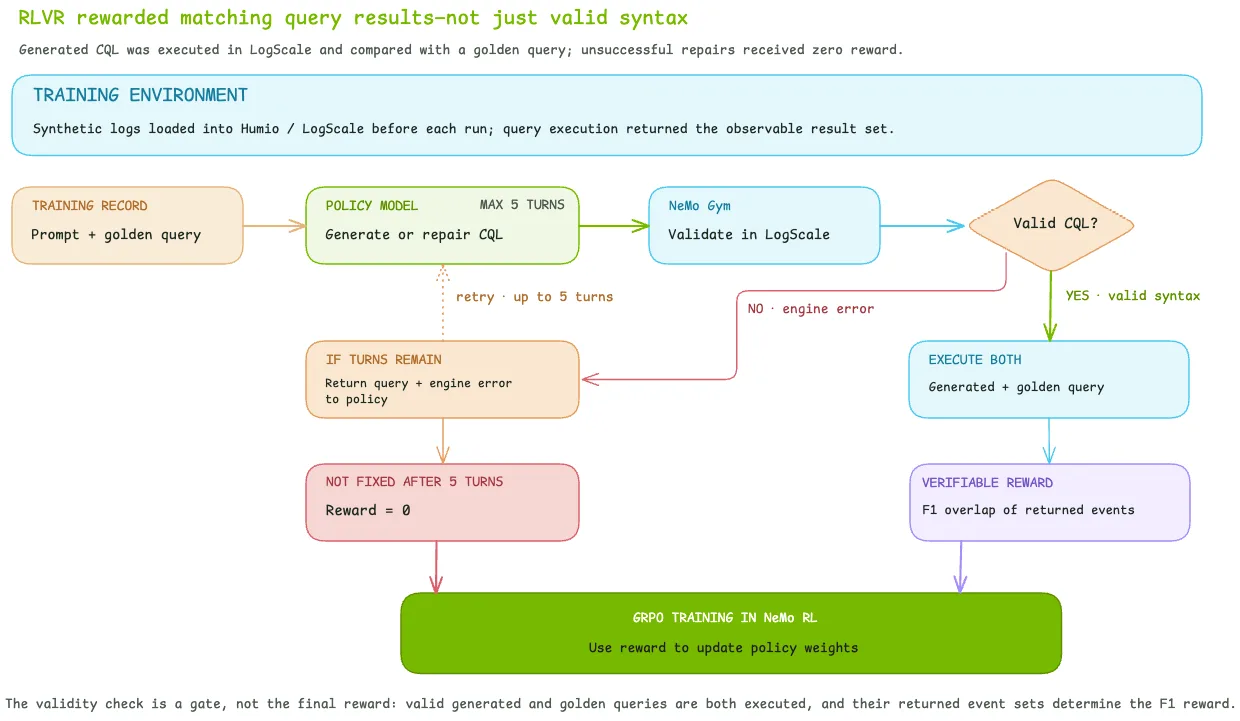
在强化学习环节,训练工作流使用 NVIDIA NeMo Gym 在 Falcon LogScale 中验证并执行生成的查询。无效查询会收到真实的引擎错误,并有最多五次修复尝试,仍未解决的尝试奖励为零。有效的生成查询和参考查询会在同一批合成日志上运行,二者返回事件之间的 F1 重合度即为奖励。NVIDIA NeMo RL 支持用组相对策略优化(group relative policy optimization)来更新模型。在强化学习中,该工作流使用 NeMo Gym 验证生成的查询,并使用 NeMo RL 根据可验证的结果更新模型。
从回测到实战演练,评估完整的智能体系统
一条检测规则可能检测得出用来创建它的那次已记录攻击,却在同一行为的新一次执行中失效。因此,我们分两个阶段评估每个系统:先针对已记录的攻击回测,再针对同一场景系列中的八次新攻击进行实战演练(live-fire)测试。每条通过的检测规则都原样部署到线上检测引擎。一个独立的第三方模型判断每次匹配是否代表了预期的攻击行为,结果在独立设定随机种子的各次编写会话之间取平均。
针对已记录的攻击进行回测
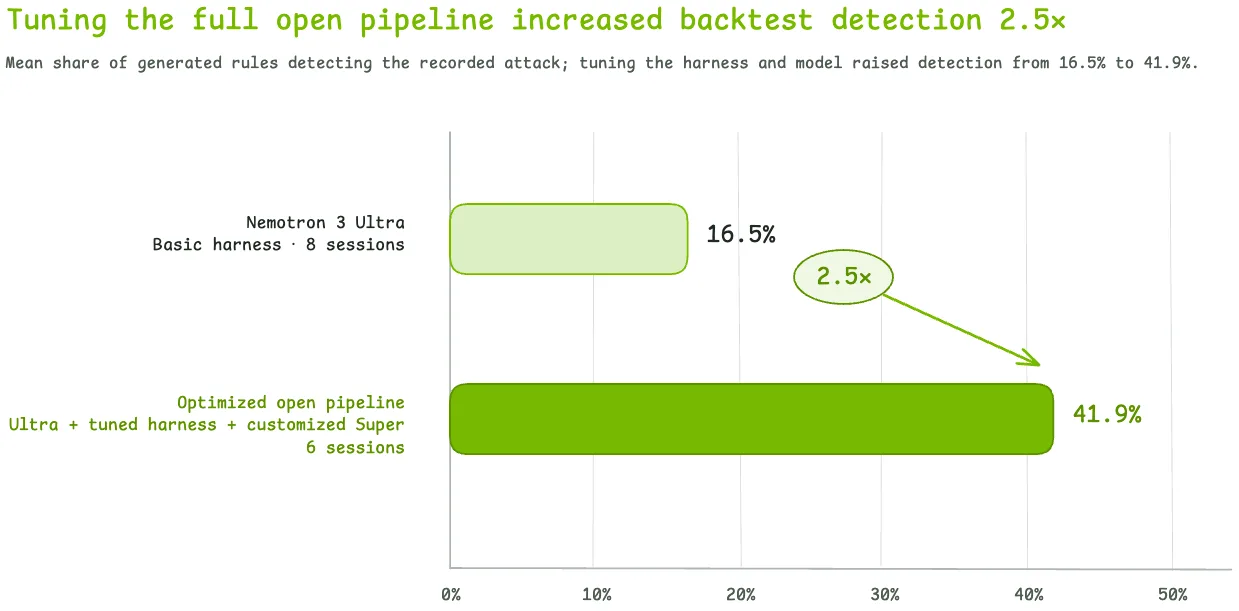
使用 Nemotron 3 Ultra 和默认 harness 时,在八次独立设定随机种子的会话中,平均有 16.5% 的生成检测规则检测到了已记录的攻击。保留 Ultra,同时加入调优后的 harness、定制的 Nemotron 3 Super、领域上下文、工具和验证,六次会话的均值升至 41.9%,提升了 2.5 倍。由于优化后的配置同时改变了 harness 和模型栈,这一增益反映的是完整的开源流水线,而不是单独的模型消融结果。
通过实战演练测试评估泛化能力
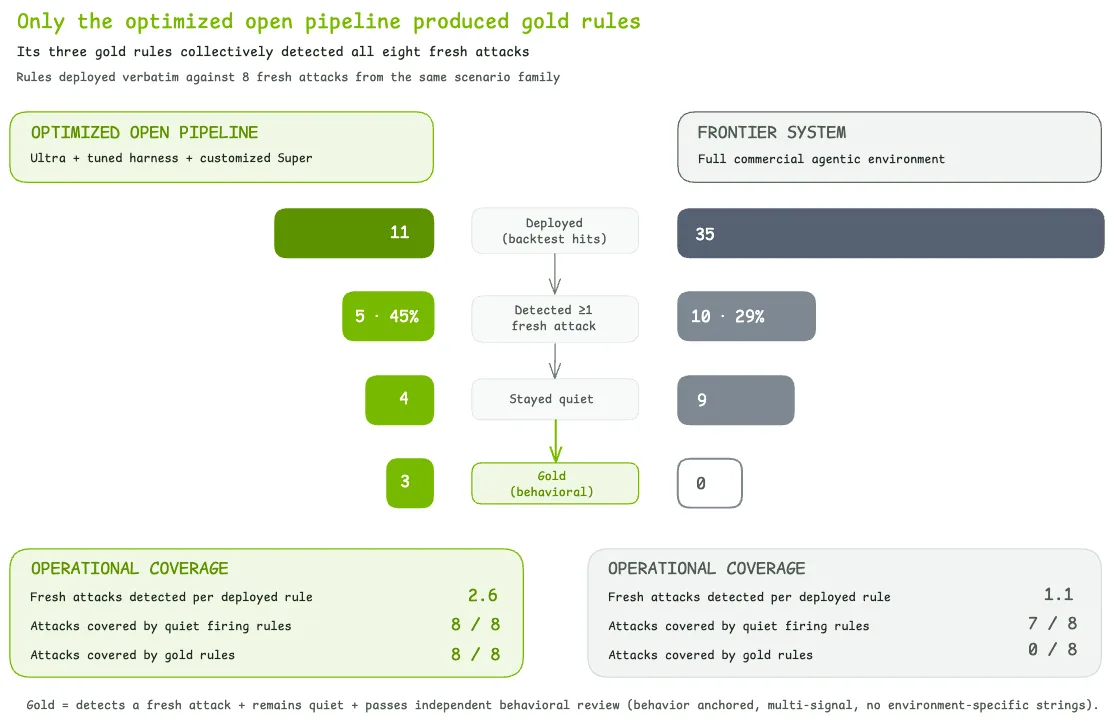
在实战演练测试中,由 Nemotron 驱动的优化开源流水线产出的 11 条通过回测的检测规则,以及完整前沿系统产出的 35 条,被部署用于应对八次未见过的攻击。11 条开源检测规则中有五条(45%)至少检测到了一次攻击,前沿系统则是 10 条(29%)。开源流水线平均每条检测规则命中 2.6 次,前沿系统为 1.1 次。
不过,检测到攻击只是第一道质量关。要达到黄金级(gold),检测规则还必须在现有测试流量上保持安静(不产生误报),并通过独立评审,确认其具备行为依据、使用多种信号,且不含特定环境的字符串。触发的五条开源检测规则中有四条、触发的 10 条前沿检测规则中有九条保持了安静,分别覆盖了八次攻击中的八次和七次。评审之后,有三条开源检测规则达到黄金级,前沿检测规则则一条也没有。这三条开源检测规则仍然覆盖了全部八次攻击。
如何解读这些结果
前沿系统产出了更多通过回测的检测规则,但经过优化的 Nemotron 开源模型流水线,其中能够泛化的比例更高,平均每条检测规则命中的次数更多,并且是唯一产出黄金级检测规则的系统。此次评估只覆盖一个场景系列和较小的检测规则集合,因此跨场景的泛化能力仍未得到检验。良性流量有限,也意味着噪声测试并不代表生产环境中的误报表现。八次实战演练中有三次出现了 harness 故障,但产生了完整的遥测数据,因此予以保留。这些发现只是方向性的系统级案例研究,而不是通用的基准测试。
将这一模式应用于专用智能体
这次评估展示了用 NVIDIA Nemotron 构建专用智能体的一种更广泛的模式:推理模型负责编排防御工作流,经过后训练的开源模型承担有边界的专家任务,智能体 harness 则管理上下文、工具和验证。由此可以归纳出四条设计原则:
- 定义可衡量的任务,并为每个模型分配明确的职责。
- 用领域数据和可验证奖励对专用模型进行后训练。
- 让输出以权威上下文为依据,并通过确定性检查、真实回放和独立评审加以验证。
- 在真实条件下评估完整的工作流,由安全专家掌控场景、护栏以及对已验证输出的使用。
CrowdStrike 正通过其智能体网络安全系统 SafeMind 推进这一方法,该系统将攻击与防御 AI 汇聚到一个持续协同演化的闭环中。欢迎了解 NVIDIA Nemotron 3、NeMo Megatron Bridge、NeMo Gym 和 NeMo RL,为其他有边界的领域定制和评估专用智能体。