核心结论
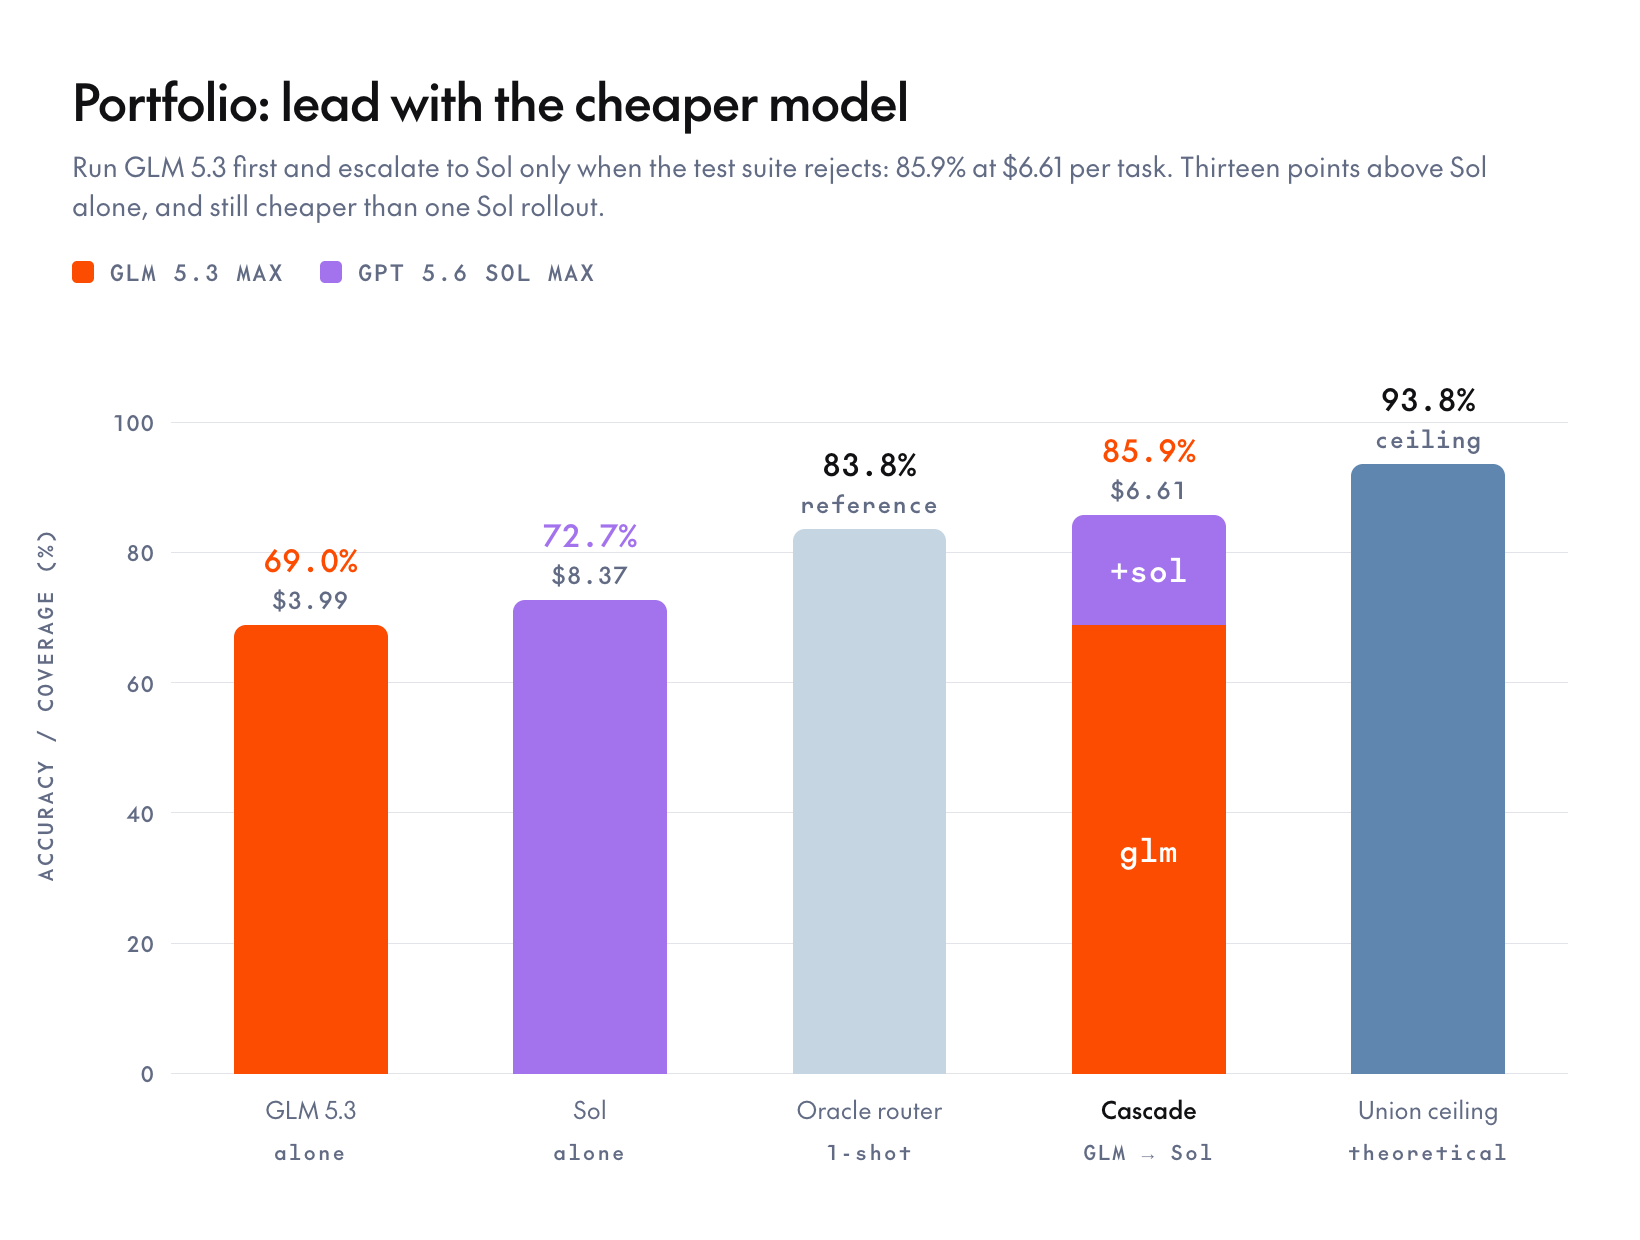
别二选一。先跑 GLM-5.3,测试不通过时再升级到 GPT-5.6 Sol。这套级联方案能以每题 \$6.61 的成本解决 85.9% 的 DeepSWE 任务;单用 Sol 只能以 \$8.37 解决 72.7%。准确率高出 13 个百分点,成本低 21%。
- 单次尝试,Sol 小胜。pass@1 为 72.7%,GLM-5.3 为 69.0%,3.7 个百分点的差距落在两个左右标准差之内。
- 此后的每一次重试,都是 GLM-5.3 占优。pass@2 时两者持平(81.1 对 81.0),pass@4 时 GLM-5.3 领先(87.6% 对 85.8%)。
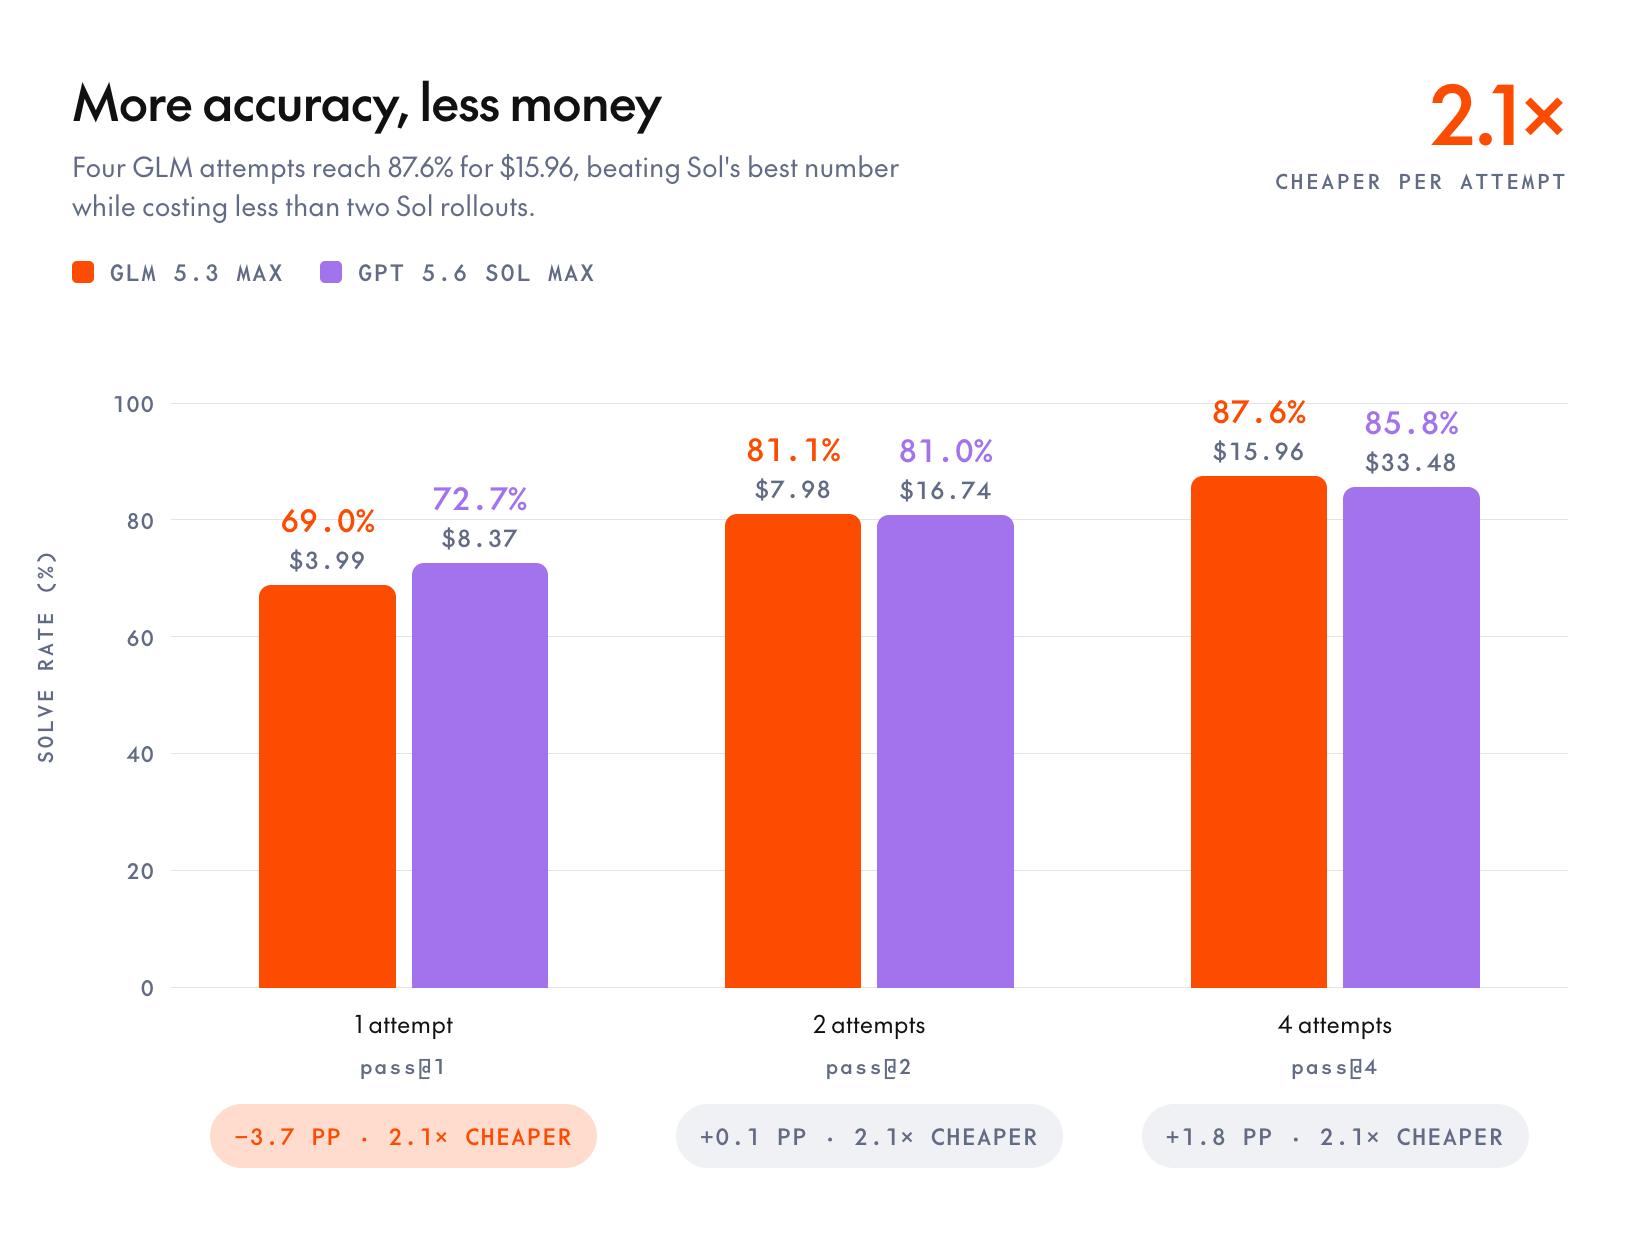
- 价格差是 2.1 倍:每次 rollout \$3.99 对 \$8.37。每花 \$100,GLM-5.3 能解决 17 个任务,Sol 能解决 9 个。
- Sol 更快也更稳:每次 rollout 平均 19 分钟、61 步,而 GLM 是 35 分钟、124 步;四次全对的任务 Sol 有 61 个,GLM 为 48 个。
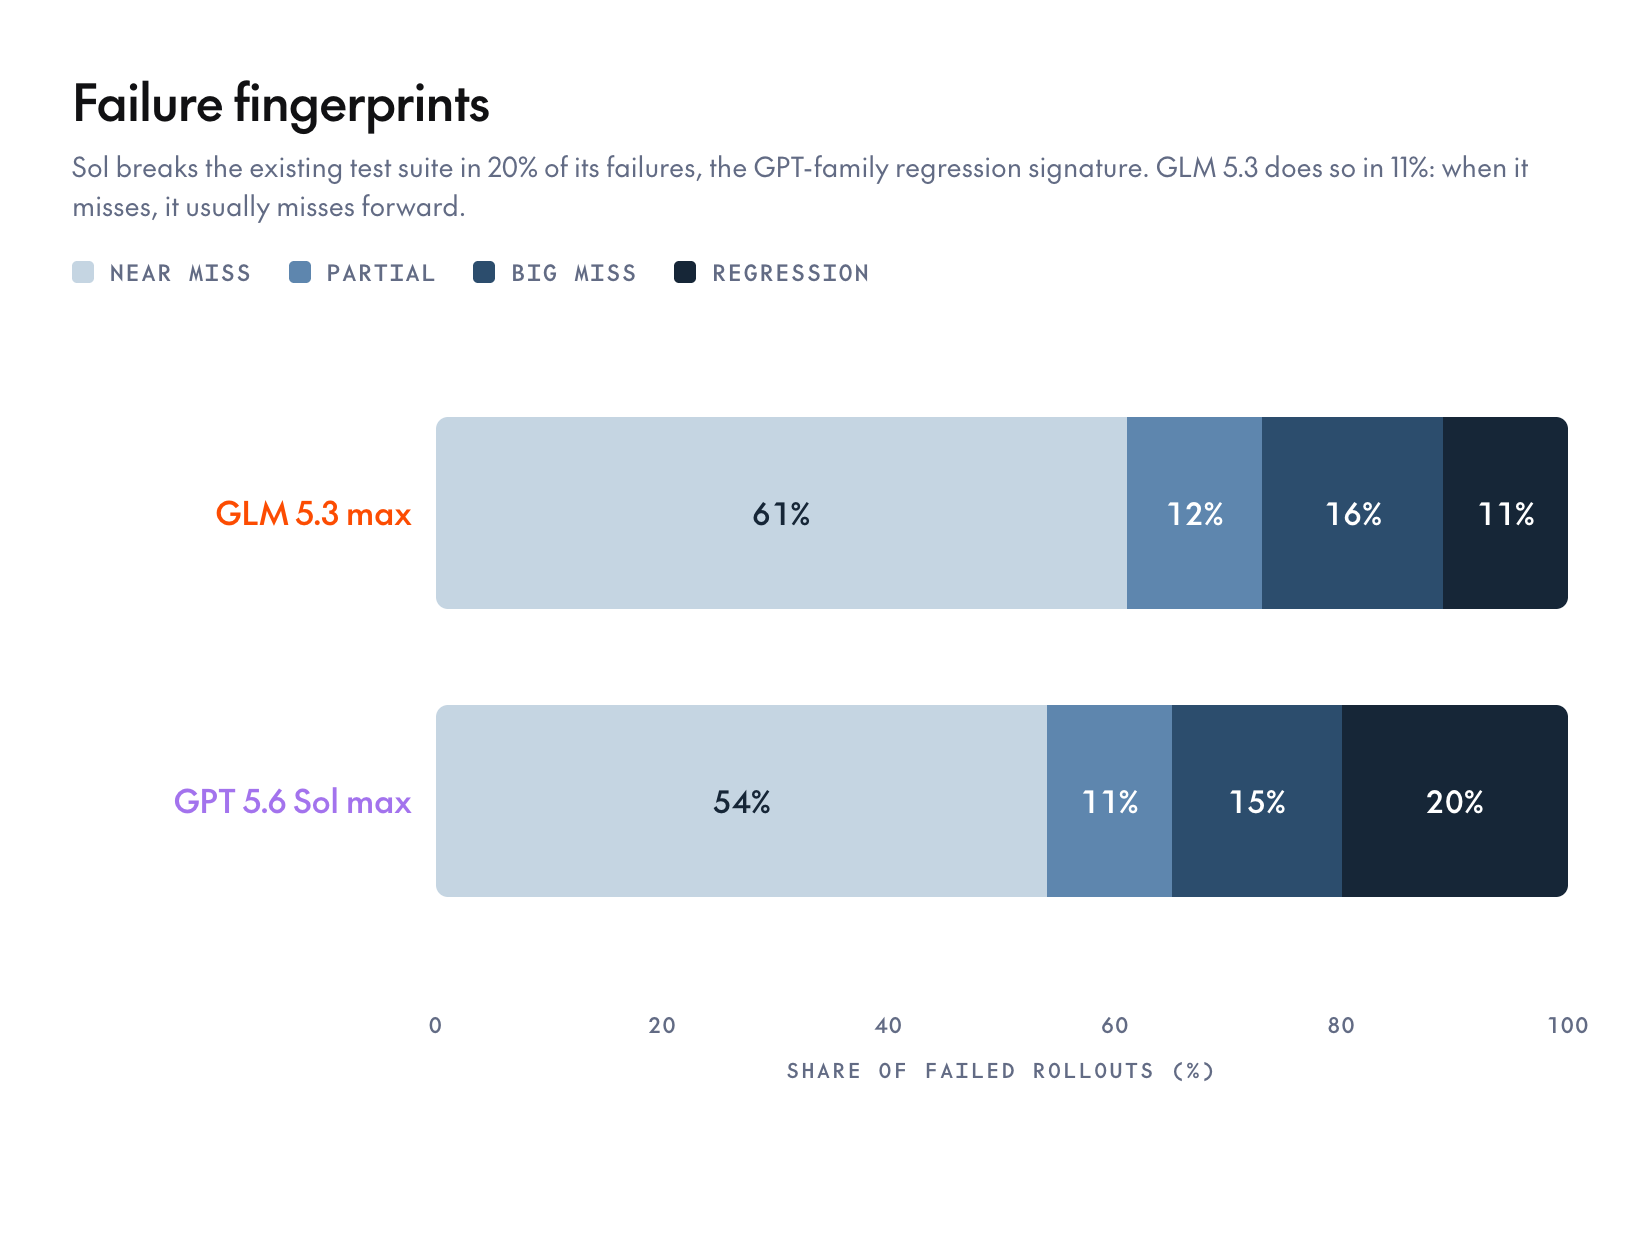
- GLM-5.3 的失败更“干净”。在它的失败案例中,有 11% 会破坏原本已通过的测试,Sol 则是 20%。对 Sol 的 diff,应以回归测试作为准入关卡。
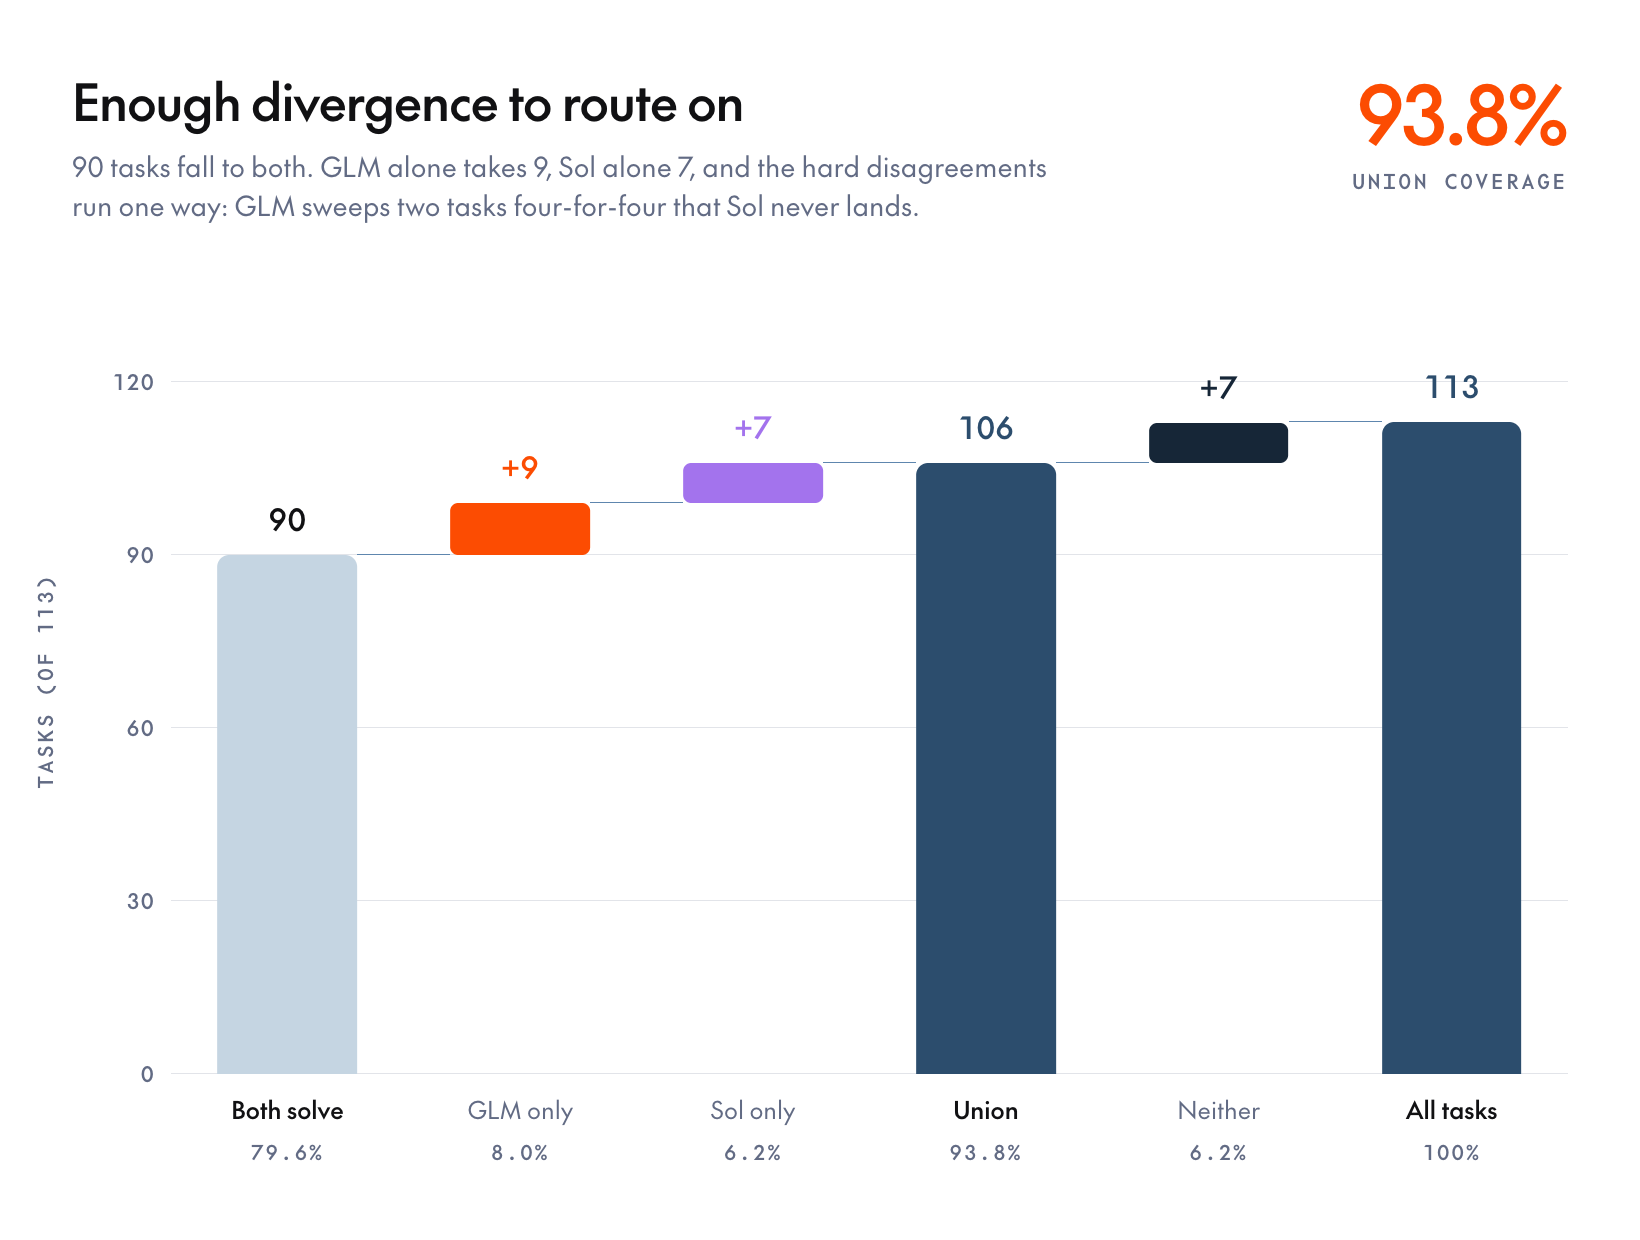
- 两者表现分化(逐任务相关性 0.43),合计覆盖 113 个任务中的 106 个,这正是级联方案奏效的原因。
我们让 GLM-5.3(max)与 GPT-5.6 Sol(max)在全部 113 个 DeepSWE 任务上对比,每个任务跑四次试验,数据来自公开发布的逐次试验记录:共 904 次 rollout,每方 452 次。Sol 是主打精度的旗舰模型,GLM-5.3 是缩小了差距的开放权重挑战者。下文所有数字均来自本次运行,因此可能与其他公开的 GLM-5.3 对 GPT-5.6 Sol 成绩单有出入。
DeepSWE · 正面对决
GLM 5.3 与 GPT 5.6 Sol 一览
| 模型 | Pass@1 | 平均成本 | 每 $100 解决数 | 输出 token | 步数 |
|---|---|---|---|---|---|
| glm-5.3 [max] | 69.0% ± 2.7% | $3.99 | 17 | 80k | 124 |
| gpt-5.6-sol [max] | 72.7% ± 2.2% | $8.37 | 9 | 60k | 61 |
在 DeepSWE 上,GPT-5.6 Sol 仍保有单次尝试的冠军位置。DeepSWE 是一项跨多种任务类型和编程语言、考察模型软件工程能力的基准测试。GLM-5.3 以一半的价格落后它不到四个百分点,而一旦允许多次尝试,便立刻反超。这是开放模型阵营迄今最接近前沿水平的一次,值得回答的问题是:Sol 剩下的溢价到底买到了什么。
DeepSWE 记分牌:pass@1 与 pass@k
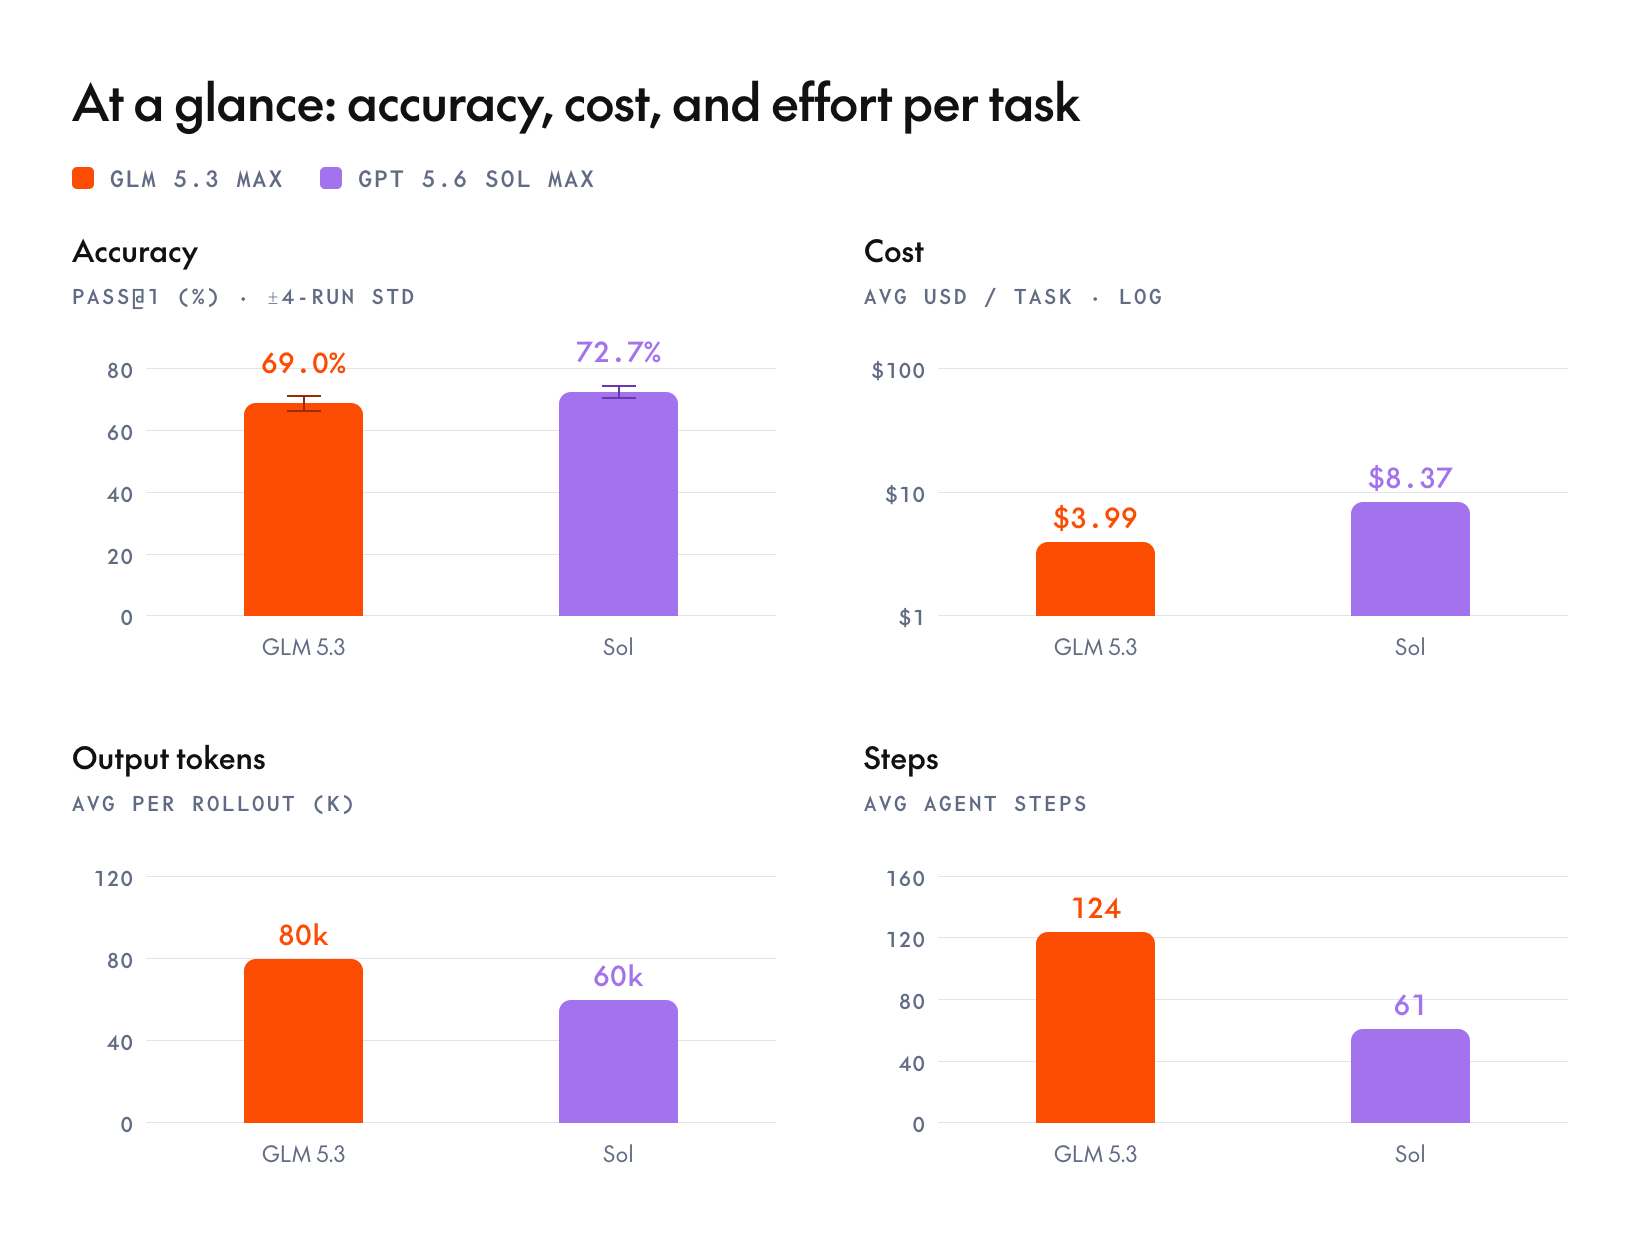
单次尝试时 Sol 略占上风:按 DeepSWE 官方计分,pass@1 为 72.7% 对 GLM-5.3 的 69.0%。允许重试后,次序随即反转。两次尝试时,GLM-5.3(81.1%)已与 Sol(81.0%)持平;四次尝试时,GLM-5.3 的 pass@4 为 87.6%,领先 85.8%。开放模型的覆盖面更广,因此在任何 best-of-k 的设置下,它都是更准确的选择,而且它多出来的尝试,成本只有 Sol 的一半。
成本对比:GLM-5.3 与 GPT-5.6 Sol 的定价
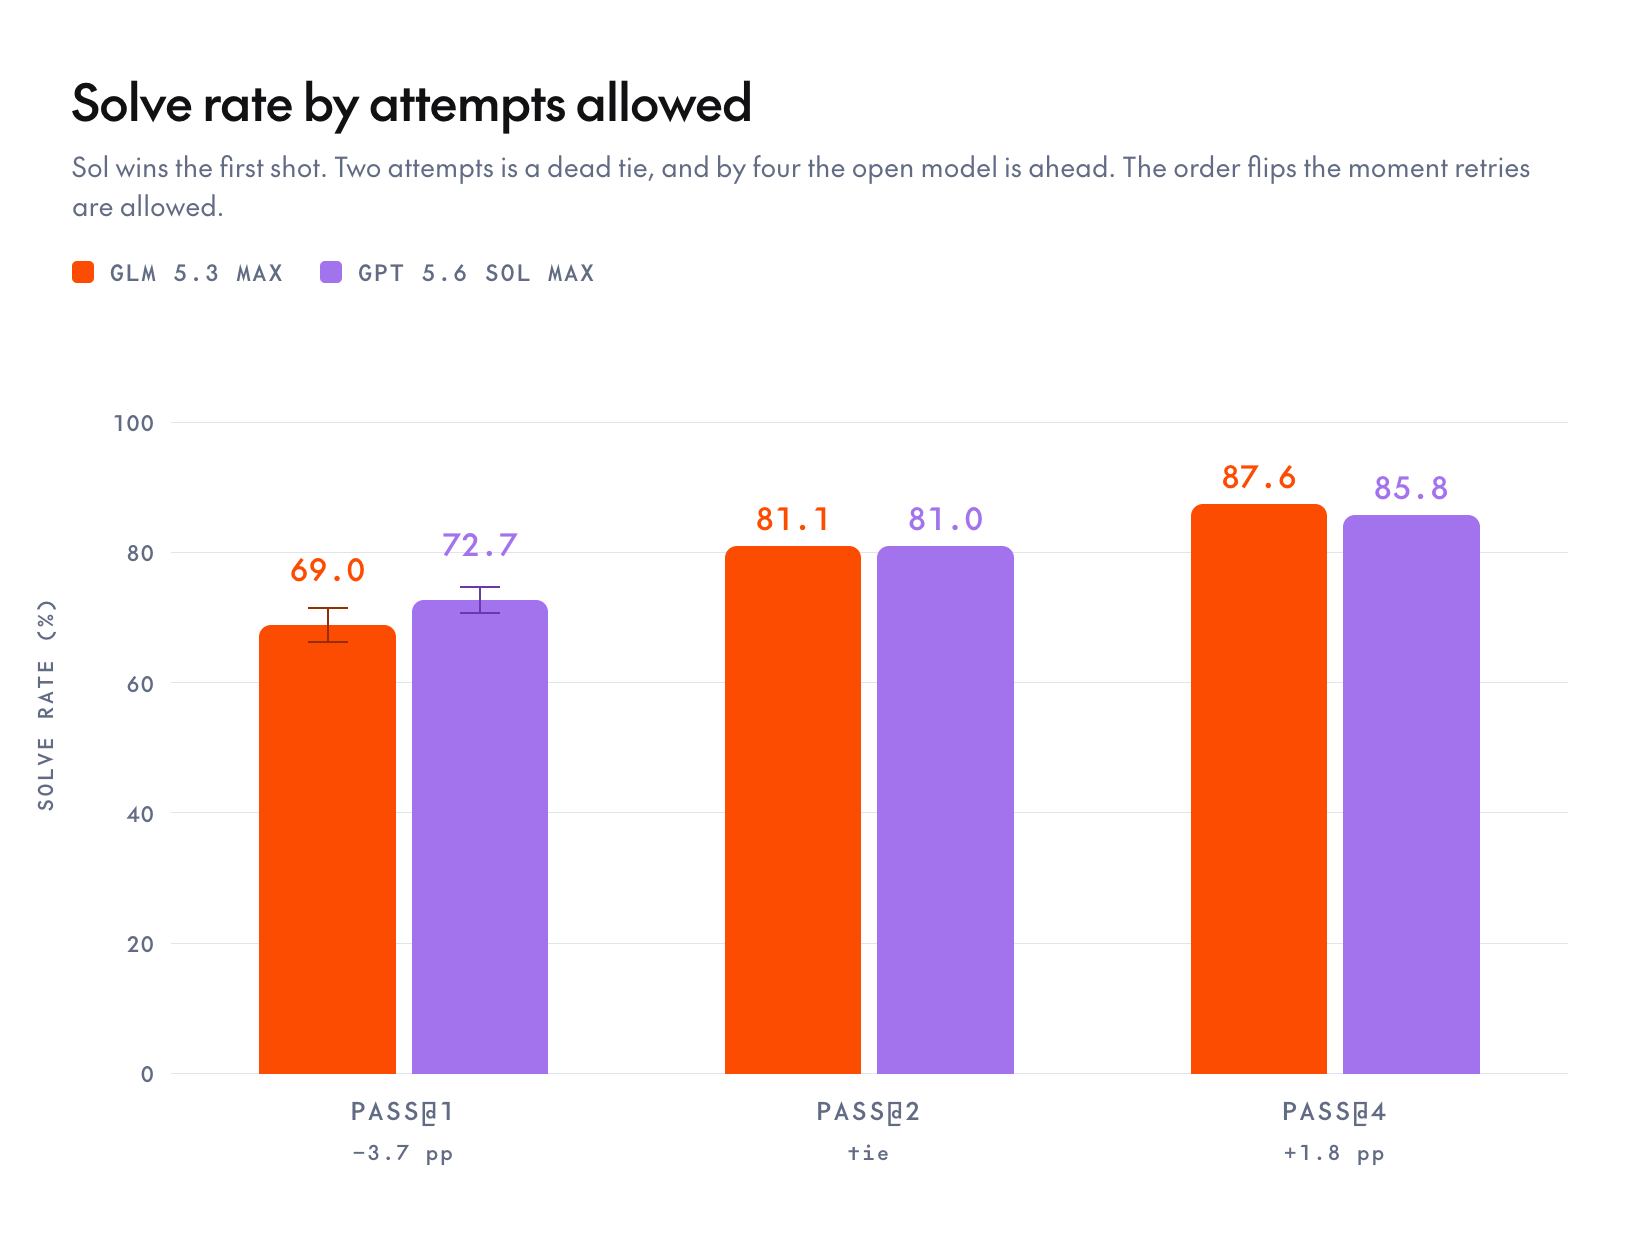
每次 rollout \$3.99,GLM-5.3 比 Sol(\$8.37)便宜 2.1 倍,换算成性价比,就是每 \$100 解决 17 个任务,Sol 为 9 个。Sol 的溢价在延迟上找了回来:平均 19 分钟、61 步,对比 GLM 的 35 分钟、124 步;输出 token 为 60k,GLM 为 80k。这一权衡异常清晰:Sol 是更快、更简练的执行者;GLM-5.3 是成本更低、但要绕远路的那个。如果有人在等结果,光凭延迟,Sol 就配得上它的溢价;如果等着的是预算或批处理队列,GLM-5.3 更划算。
覆盖率与可靠性:精度对比广度
把 pass@1 和 pass@4 拆解为覆盖率(四次尝试中至少解出一次的任务)和可靠性(四次全部解出的任务),分野十分清楚。Sol 是精度一极:可靠性 84.5%,有 61 个任务四次全对,这是“出手即得手”的模型特征。GLM-5.3 则偏向另一条轴线:覆盖率更广,为 87.6% 对 85.8%,但可靠性较低,为 78.8%,扎实解出的任务也更少,48 个对 61 个。覆盖率上的优势与它在 pass@4 上的领先是同一件事。GLM-5.3 触及的基准范围比 Sol 更大,但每次出手的转化率略低一些。
失败模式:两个模型各是怎么出错的
两者的失败特征差异明显,而且这种差异对开放模型有利。Sol 的失败案例中有 20% 破坏了代码库原有的测试套件,这是 GPT 系列典型的回归特征。GLM-5.3 为 11%;它失手时,通常是“向前”失手,即基线完好的近似成功,近似成功率为 61%,Sol 为 54%。因此,成本更低的这个模型,在不设严格回归关卡的情况下接受其结果,也更安全。采用 Sol 的 diff 之前,应当围绕它做一次完整的回归测试;GLM-5.3 对这道护栏的需求要小一些。
按任务类型看各自的优势
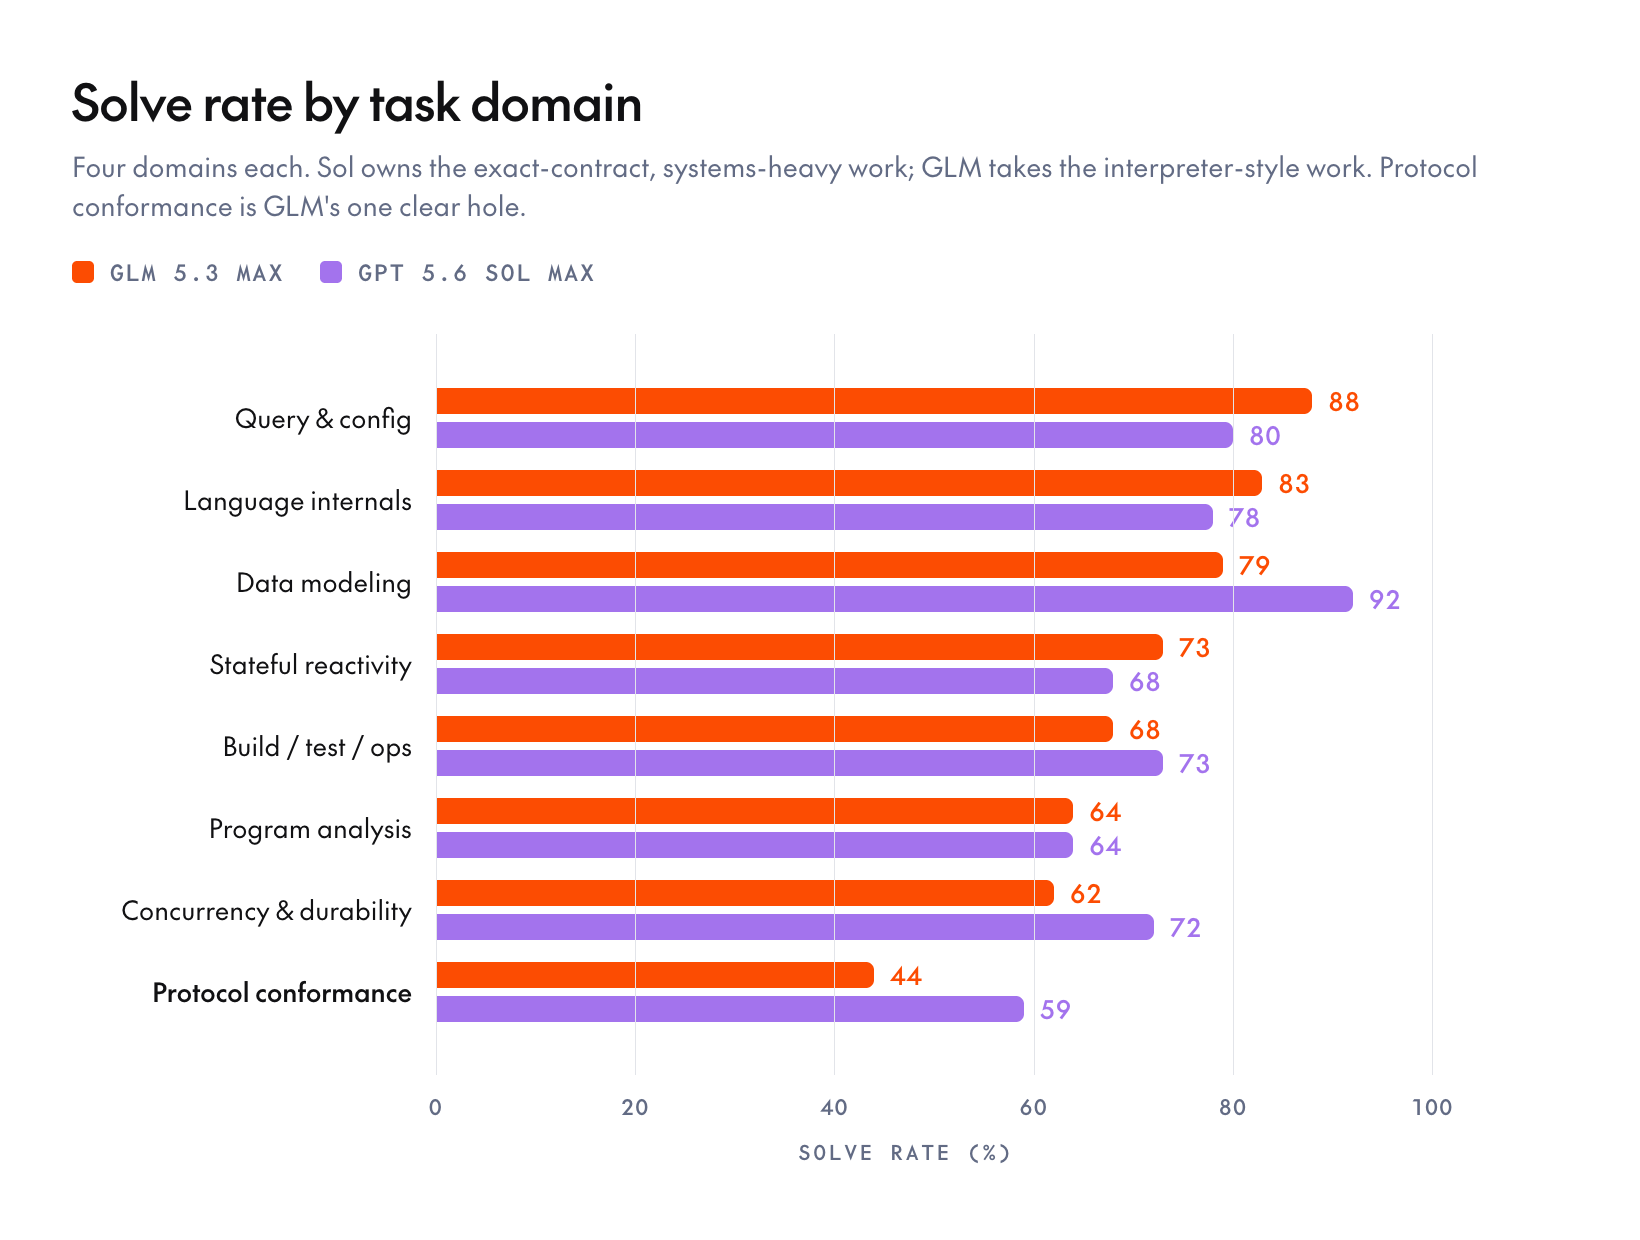
领域图谱上双方打成平手,各占四项。Sol 拿下数据建模与序列化(92%)、构建与运维工具(73%)、并发与持久性(72%)以及协议一致性(59%),这些都是契约精确、偏系统层面的工作。GLM-5.3 拿下查询与配置语言(88%,是全表中最高的单个格子)、语言与运行时内部机制(83%)、有状态响应式(73%),以及程序分析(64 比 64 打平,靠任务量取得),这些是结构化、解释器式的工作。GLM-5.3 唯一明显的短板是协议一致性,只有 44%,比 Sol 低 15 个百分点。Sol 则没有单一的弱项,而是全面强势。此处的任务类型由 LLM 根据每条基准测试提示词归类。
按编程语言对比 GLM-5.3 与 GPT-5.6 Sol
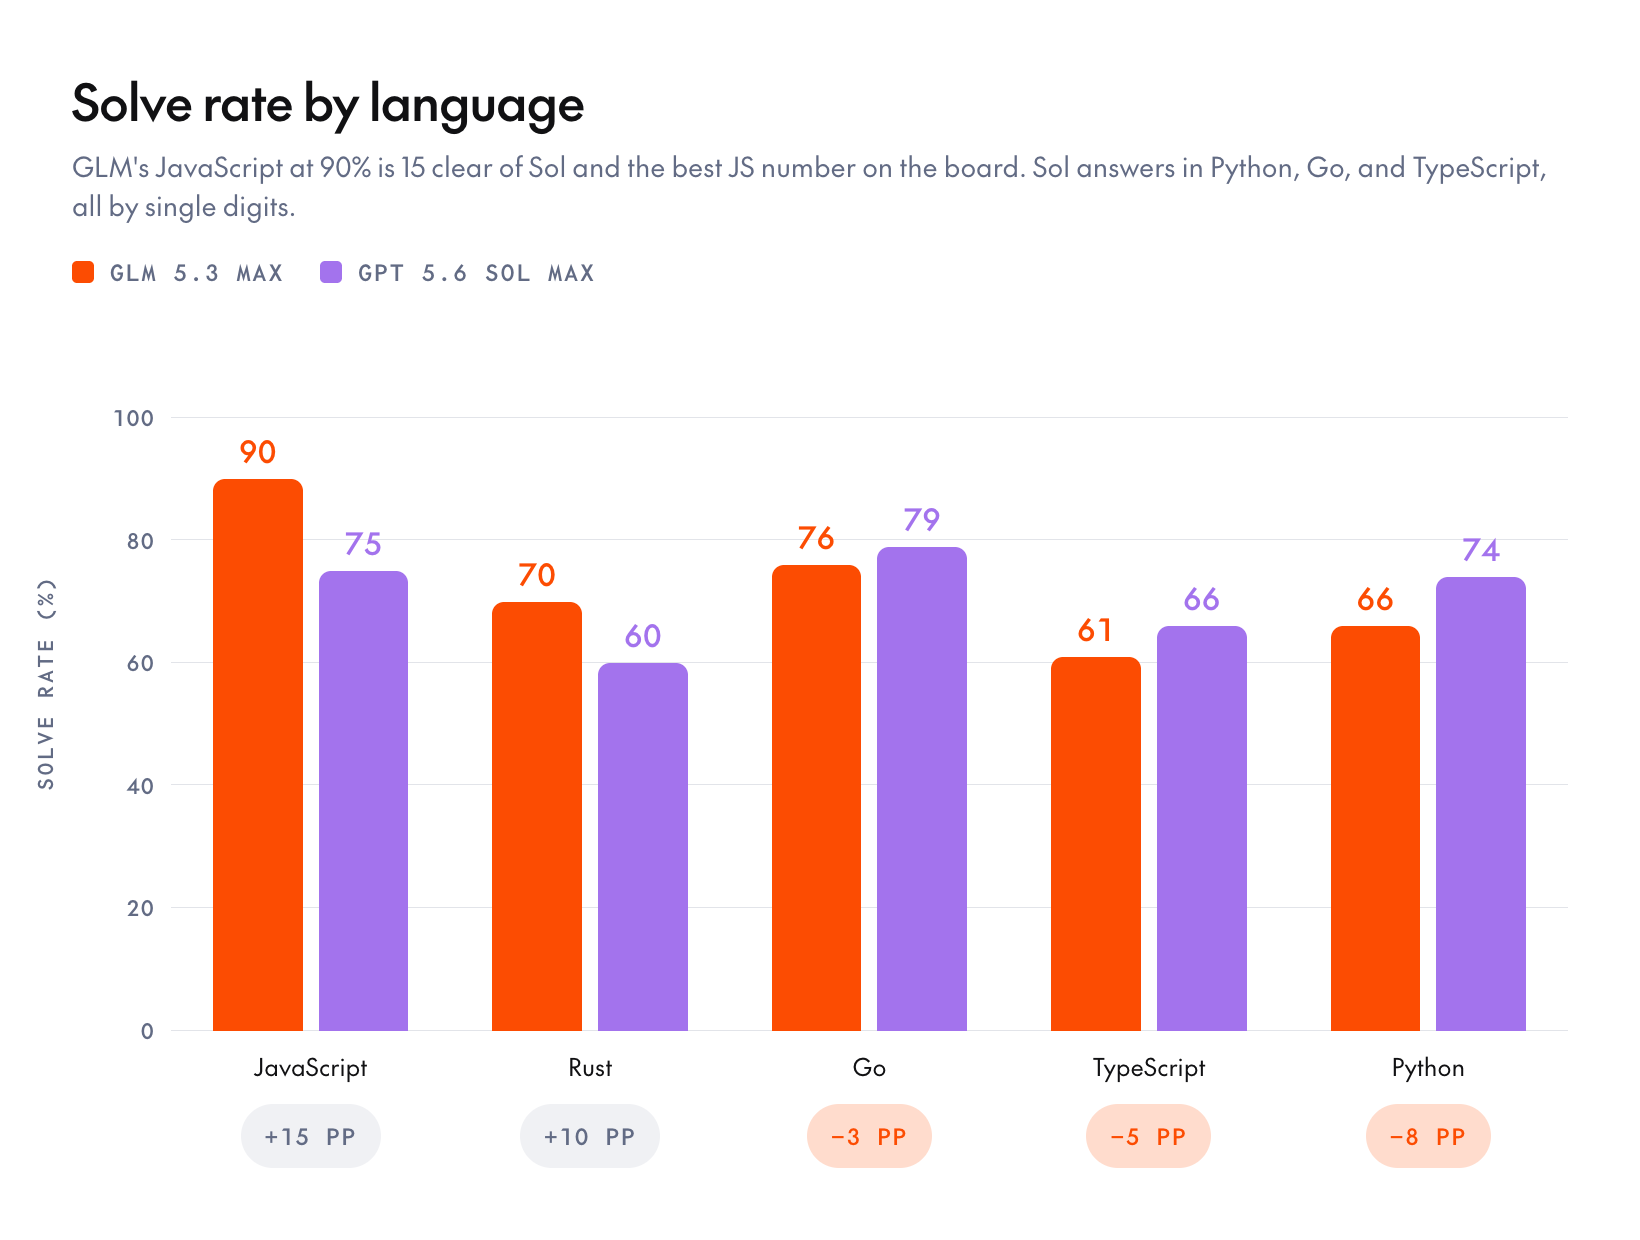
GLM-5.3 最突出的是 JavaScript,达 90%,比 Sol 的 75% 高出 15 个百分点,也是全表所有模型中最好的 JS 成绩。它在 Rust 上也领先,70 比 60。Sol 则在 Python(74 比 66)、Go(79 比 76)和 TypeScript(66 比 61)上扳回。路由规则很简单:JavaScript 和 Rust 交给 GLM-5.3,其余交给 Sol,而 GLM-5.3 在几乎所有语言上都是成本更低、差距很小的第二名。
GLM-5.3 与 GPT-5.6 Sol 有多不一样?
不一样到足以据此做路由。逐任务相关性为 0.43,对两个总成绩如此接近的模型来说,这是真实的分歧。两者都能解决的任务有 90 个;只有 GLM-5.3 解决的有 9 个,只有 Sol 解决的有 7 个,两者都解不出的有 7 个。二者的并集覆盖 113 个任务中的 106 个(93.8%),而且严重分歧只朝一个方向:GLM-5.3 有两个任务四次全对而 Sol 一次也没解出(koota-pair-relation-tracking、participle-grammar-conflict-analysis),反过来,Sol 没有一个任务四次全对而 GLM-5.3 全部失败。开放模型能到达旗舰模型到不了的地方。
在两者之间做路由:组合策略
这种分化加上价格差,使级联成为全表最优的一行。先跑 GLM-5.3,仅当测试套件否决其答案时才升级到 Sol:85.9% 的任务被解决,每题成本 \$6.61。这比单用 Sol(72.7%)高出 13 个百分点,成本还低于一次 Sol rollout(\$8.37),因为开放模型以 Sol 一半的价格清掉了队列中的大部分任务,剩下的硬骨头则获得第二次独立尝试。该级联方案甚至胜过完美的单次预知路由(83.8%),因为两次独立尝试强过一次完美的挑选。无论谁打头阵,预期准确率相同,但 GLM 打头阵更便宜(\$6.61 对 \$9.47),所以应当让成本更低的模型打头阵。
这意味着什么
GPT-5.6 Sol 保住了单次尝试的冠军,以及随之而来的一切:最高的首次通过率、最高的可靠性,以及遥遥领先的最快、最简洁的运行。为此你要付出大约两倍的价格,还必须为它 20% 的回归率设置护栏。GLM-5.3 则是性价比与 best-of-k 的首选:首次尝试差距在四个百分点以内,在 pass@2、pass@4 和覆盖率上领先,价格只有一半,失败特征更干净,并拥有全表最好的 JavaScript 成绩。相对于 Sol,它真正的弱点是协议一致性和原始速度。而由于两者确实表现分化,最锋利的部署方式是两者都不单用,而是让 GLM-5.3 充当成本更低的前端,让 Sol 作为由验证器把关的升级兜底,用低于旗舰模型自身单题价格的成本,拿到超过旗舰模型的覆盖率。欢迎试用全新的 GLM 5.3 Flash API。
DeepSWE · 完整结果
GLM 5.3 与 GPT 5.6 Sol 逐项指标对比
| 指标 | GLM 5.3 [max] | GPT 5.6 Sol [max] |
|---|---|---|
| pass@1(官方计分) | 69.0% | 72.7% |
| pass@1(错误计为失败) | 68.8% | 72.3% |
| pass@2 / pass@4 | 81.1 / 87.6% | 81.0 / 85.8% |
| 覆盖率 / 可靠性 | 87.6 / 78.8% | 85.8 / 84.5% |
| 扎实(4/4)/ 死磕不动(0/4) | 48 / 14 | 61 / 16 |
| 单次 rollout 成本 / 总成本 | $3.99 / $1,806 | $8.37 / $3,783 |
| 每 $100 解决数 | 17 | 9 |
| 平均分钟数 / 步数 | 35 / 124 | 19 / 61 |
| 平均峰值上下文 / 输出 token | 155k / 80k | 187k / 60k |
| 失败剖析(近似成功 / 回归) | 61% / 11% | 54% / 20% |
| 领先的领域数(共 8 个) | 4 | 4 |
| 领先的语言 | 2(JavaScript、Rust) | 3(Python、Go、TypeScript) |
| 逐任务相关性 / 并集 | 0.43 / 113 个中的 106 个(93.8%) | |
| 级联 GLM → Sol(准确率 / 成本) | 85.9% / $6.61(单用 Sol 为 72.7% / $8.37) | |
| 预知式单次路由器 | 83.8% | |
| 基础设施错误 | 1 | 2 |
113 个 DeepSWE 任务 · 每种配置 4 次试验 · 均为 max 强度 · 共 904 次 rollout
常见问题
GLM-5.3 比 GPT-5.6 Sol 更好吗?
要看指标。GPT-5.6 Sol 在 DeepSWE 上赢在单次尝试质量(pass@1 为 72.7% 对 69.0%),四次全对的任务更多(61 个对 48 个),每次 rollout 的速度也大约快一倍。GLM-5.3 在 pass@2 上持平,在 pass@4 上领先(87.6% 对 85.8%),而每次 rollout 的成本只有一半,因此对高吞吐量或能容忍重试的智能体工作来说,它是性价比更高的选择。
GLM-5.3 比 GPT-5.6 Sol 便宜多少?
在我们的运行中,max 强度下 GLM-5.3 每次 rollout 成本 \$3.99,GPT-5.6 Sol 为 \$8.37,低约 2.1 倍。按每个已解决任务计算,GLM-5.3 每 \$100 可解决 17 个,Sol 为 9 个,每美元完成的有效工作量大约是后者的两倍。
做编码,GLM-5.3 和 GPT-5.6 Sol 哪个更好?
两者各占半壁江山。GLM-5.3 拿下 JavaScript(90 对 75)和 Rust(70 对 60);Sol 拿下 Python(74 对 66)、Go(79 对 76)和 TypeScript(66 对 61)。按任务领域看,双方各赢四项:Sol 领先于契约精确的任务和系统层面的工作,GLM-5.3 则领先于查询与配置语言、运行时内部机制和有状态响应式。
我应该在 GLM-5.3 和 GPT-5.6 Sol 之间做路由吗?
如果你能验证结果,就应该。两者表现分化(相关性 0.43),失败方式也不同,所以先跑 GLM-5.3,在测试套件否决其输出时再升级到 Sol,可以达到 85.9% 的准确率,每题成本 \$6.61,优于单用 Sol(72.7%,\$8.37),也优于完美的单次预知路由器(83.8%)。两者合计覆盖 113 个任务中的 106 个。
DeepSWE 上的 pass@k 是什么?
pass@k 衡量对某个任务的 k 次尝试中,是否至少有一次通过隐藏的测试套件。pass@1 奖励一次就做对;k 越大,越奖励那些能在多次尝试中最终找到解法的模型。随着 k 增大,GLM-5.3 的优势也在扩大。
方法与注意事项
- 数据:DeepSWE v1.1 导出数据,113 个任务,每种配置 4 次试验,均为 max 强度,来自公开发布的逐次试验记录。每方 452 次试验。
- 计分:主要通过率采用 DeepSWE 官方计分(included_in_score,排除基础设施错误)。GLM-5.3 有 1 个基础设施错误,Sol 有 2 个,因此官方计分与严格计分几乎一致。pass@2、pass@4、覆盖率、并集和相关性使用逐任务的通过次数。
- 成本采用索引中公布的逐次试验 cost_usd。分析时,GLM-5.3 这批试验的逐轮轨迹 JSON 尚未上传到公开 CDN,因此本分析仅到索引层面。
- 失败剖析使用公布的逐测试通过比例。近似成功指新增测试至少 80% 通过且基线完好;回归指有基线测试被破坏。领域采用基于产物的任务分类体系。
- 级联方案假设由验证器决定是否升级,并且在给定任务的条件下两次尝试相互独立。预期准确率与顺序无关,成本则不然,所以应让成本更低的模型打头阵。预知路由器是逐任务选取的最佳单次结果,是任何单次路由器的上界。